Wir stellen den neuen Risk Score von Snyk für eine risikobasierte Priorisierung vor


17. August 2023
0 Min. LesezeitWir freuen uns, die offene Beta-Version des neuen Risk Score von Snyk anzukündigen! Der neue Risk Score ersetzt den bisherigen Priority Score und wurde entwickelt, damit Sie effektiver priorisieren können, indem er Ihnen ein präzises und ganzheitliches Verständnis des Risikos einer bestimmten Sicherheitslücke vermittelt.
Der Risk Score basiert auf einem neuen Risikobewertungsmodell, das mehrere objektive und kontextbezogene Risikofaktoren nutzt, um sowohl die Wahrscheinlichkeit auszuwerten, dass eine Schwachstelle ausgenutzt wird, als auch die möglichen Auswirkungen einer Ausnutzung. Der neue Risk Score berücksichtigt mehr Risikofaktoren als zuvor – darunter Erreichbarkeit, Reifegrad des Exploits, EPSS, soziale Trends, CVSS, transitive Tiefe, geschäftliche Kritikalität und mehr. So erhalten Sie umfassendere und präzisere Sicherheitsinformationen.
Nach der Aktivierung wird der neue Risk Score auf den Snyk-Issue-Karten angezeigt. Dort finden Sie auch eine ausführliche Erläuterung, wie der berechnete Score Ihnen helfen kann, das von einem Issue ausgehende Risiko zu verstehen. Der Score ist außerdem in den Snyk-Berichten und über unsere API verfügbar.
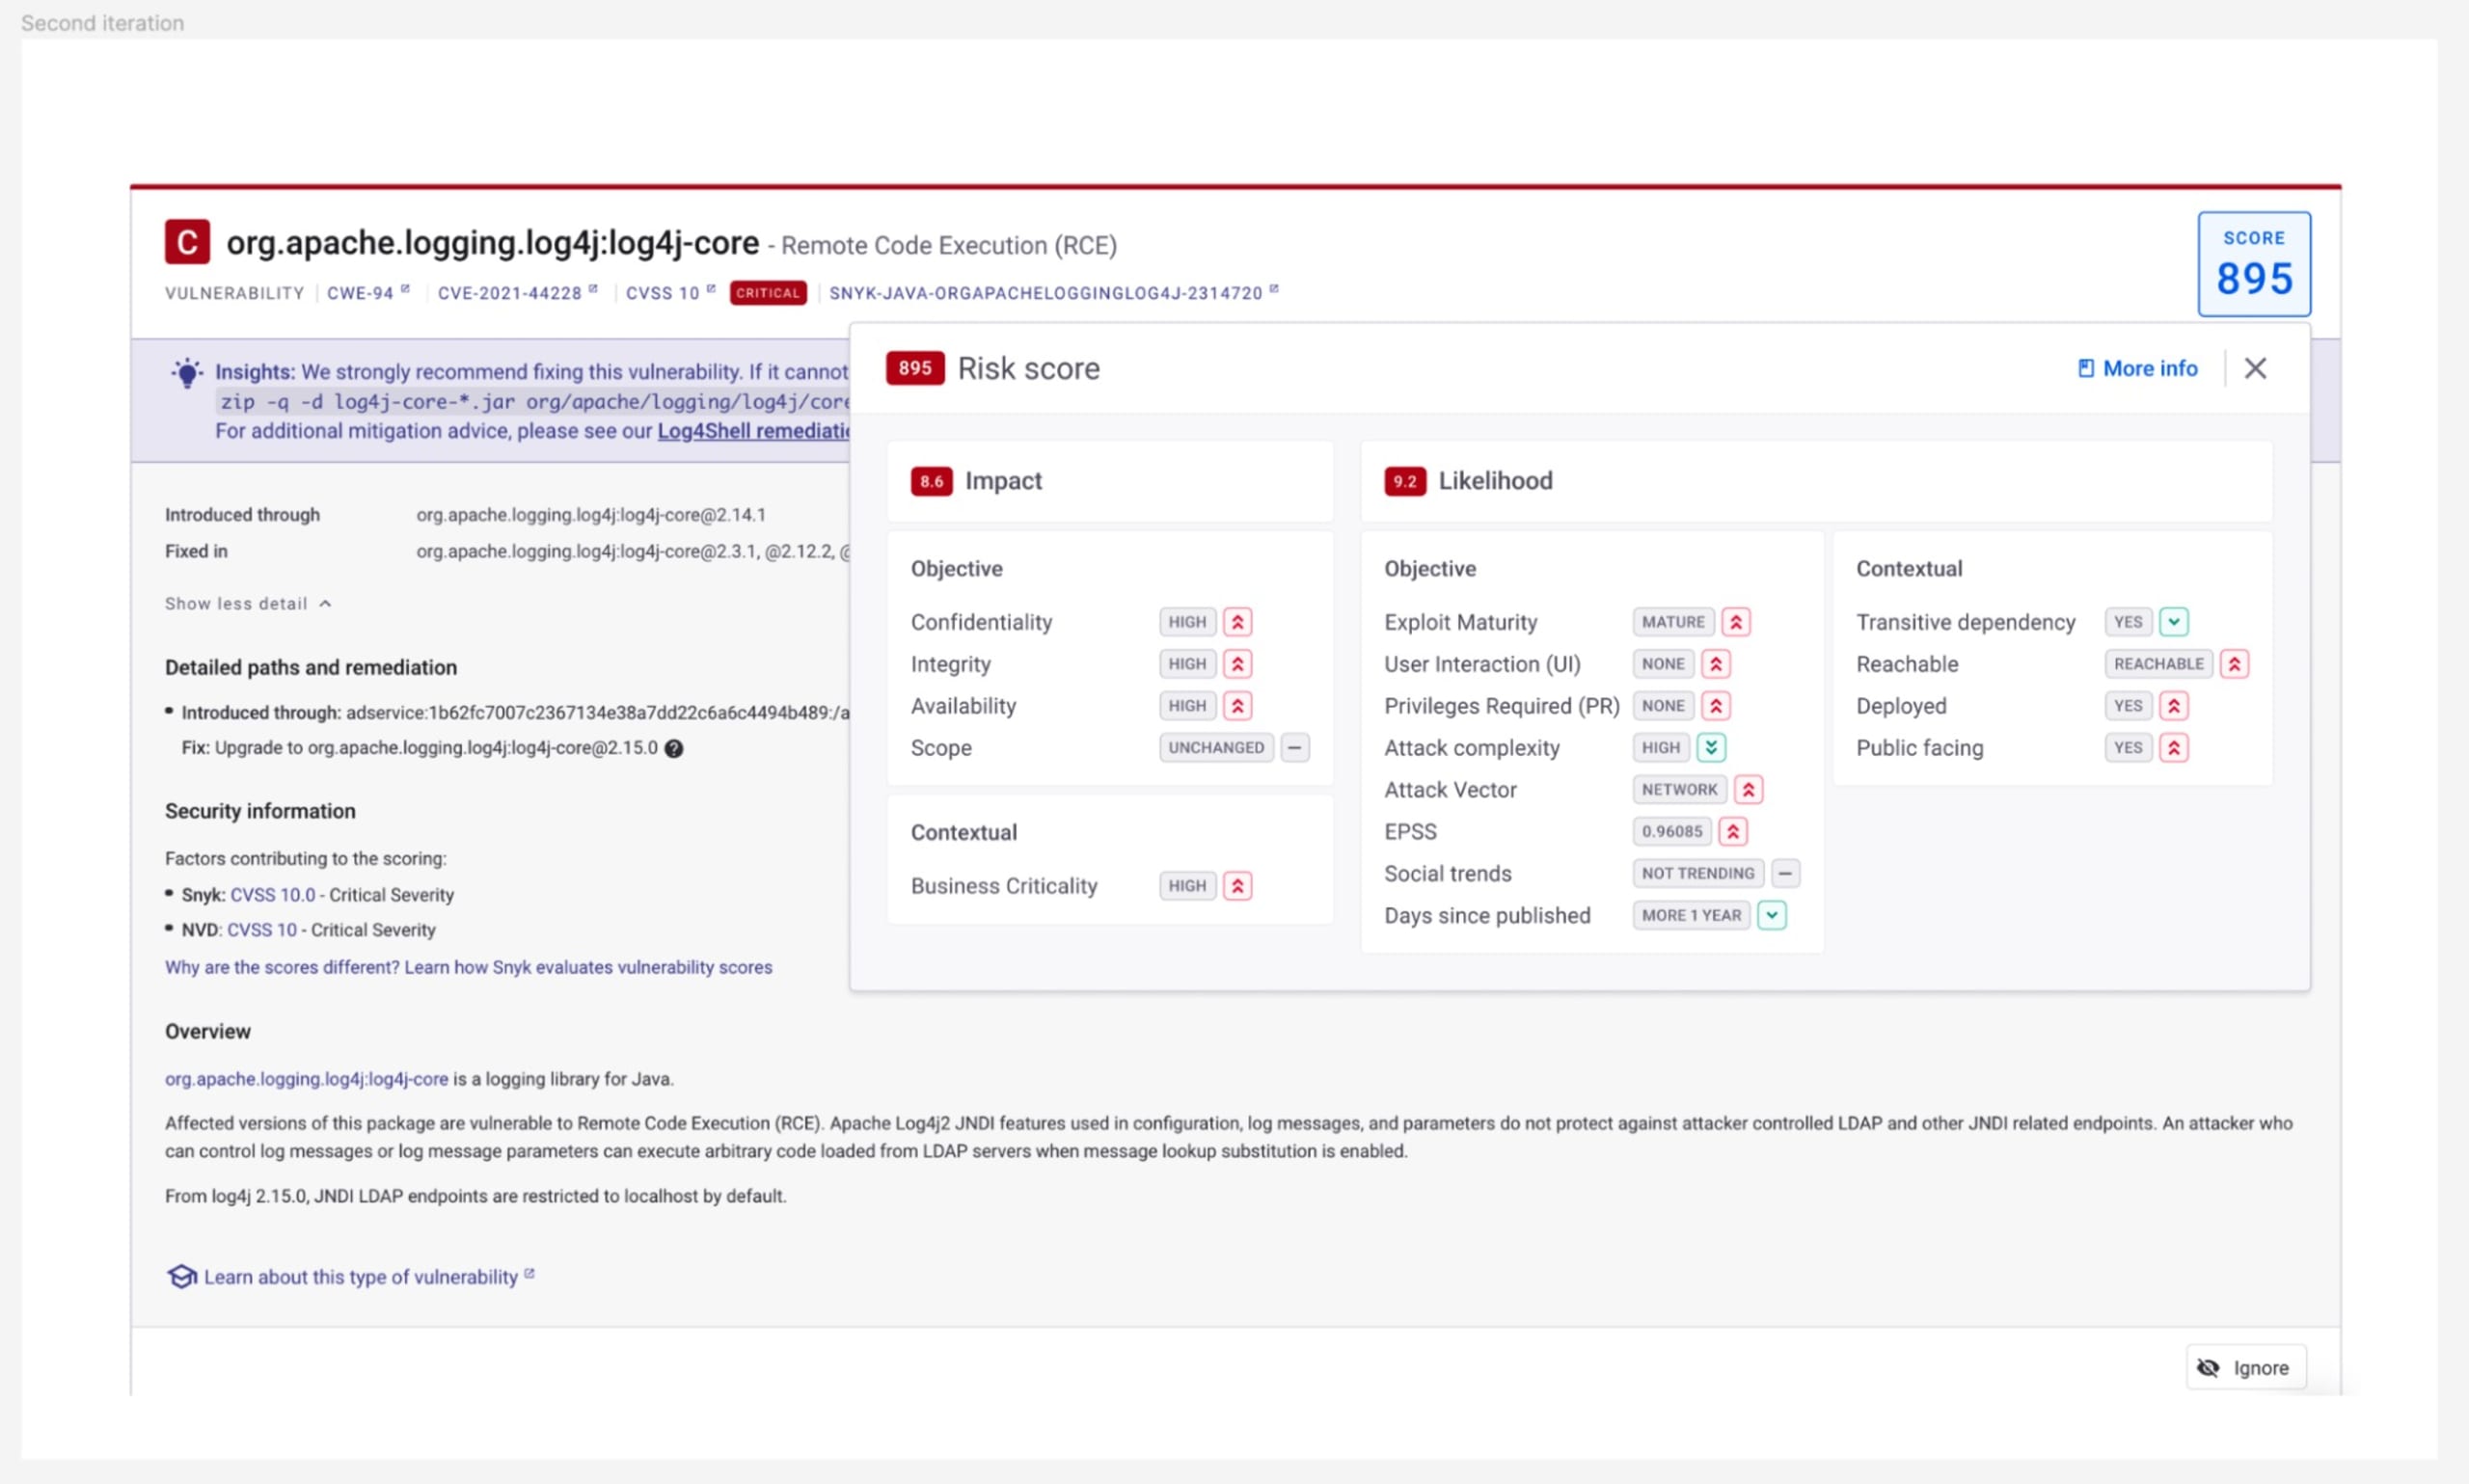
Der Risk Score lässt sich über Snyk Preview aktivieren und ist in der offenen Beta für Issues in Snyk Open Source und Snyk Container in allen Snyk-Plänen verfügbar – auch im Free-Plan. Weitere Informationen zum Risk Score und seiner Verwendung finden Sie in unserer Online-Dokumentation.
Das Problem: überladene Security-Backlogs
Eines der größten Probleme, mit denen Sicherheits- und Entwicklungsteams heute bei dem Versuch konfrontiert sind, ihre Software entlang der Software-Supply-Chain abzusichern, ist das Verhältnis von Signal zu Rauschen.
Einerseits scheint die Zahl der in ihrem Code entdeckten Schwachstellen endlos:
Sicherheitstools sind entlang der Software-Supply-Chain mittlerweile nahezu allgegenwärtig. Dadurch wird die zu schützende Angriffsfläche erheblich erweitert und es entstehen mehr Probleme als je zuvor.
In beliebten Open-Source-Bibliotheken und Drittanbieter-Software werden täglich neue Schwachstellen entdeckt. Dadurch wächst die Zahl der Bedrohungen, die analysiert, priorisiert und behoben werden müssen, ständig.
Die Komplexität von Software nimmt weiter zu. Upgrades oder Fixes lassen sich nicht immer automatisieren, ohne Breaking Changes im Code zu verursachen. Dadurch wird es schwieriger, Issues zu analysieren und zu beheben.
Andererseits stellen Nutzer fest, dass nicht alle Bedrohungen gleich schwer wiegen und die überwiegende Mehrheit der erkannten Issues ein weitaus geringeres Risiko darstellt als zunächst angenommen. Ein Beispiel dafür ist das EPSS-Bedrohungsmodellierungssystem von FIRST, das die Wahrscheinlichkeit vorhersagen soll, dass eine bestimmte erkannte CVE in freier Wildbahn ausgenutzt wird:
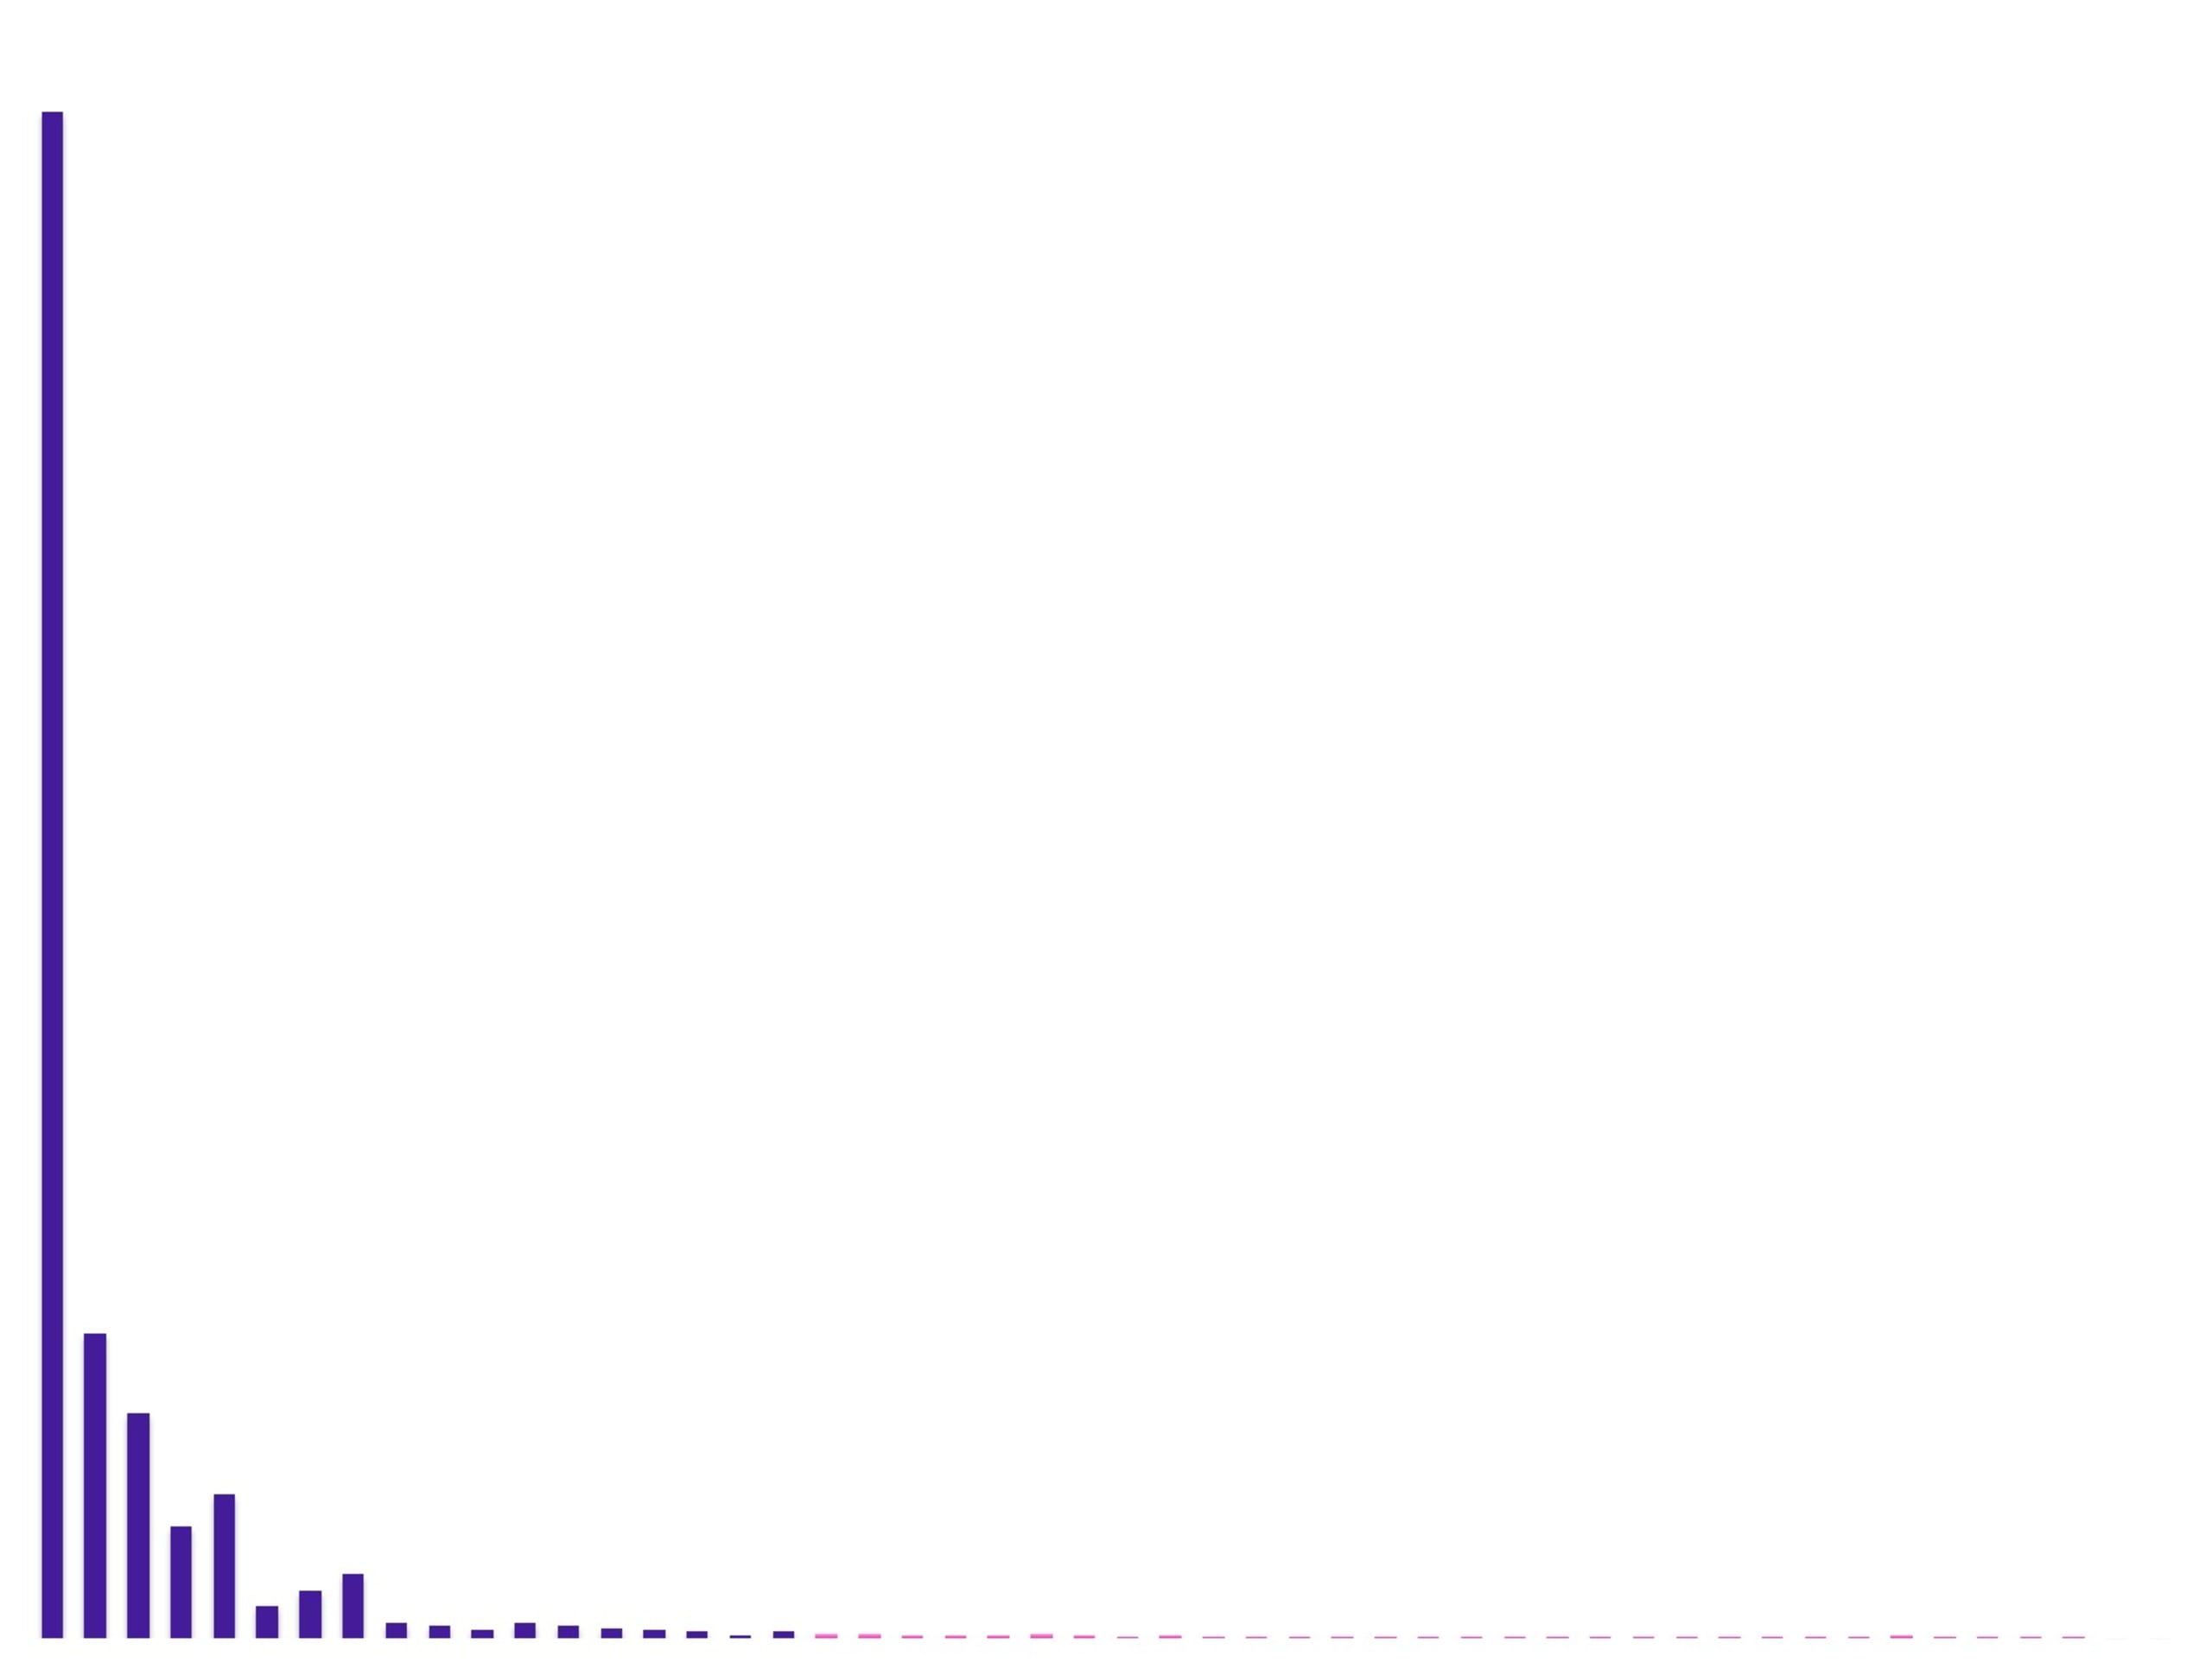
Wie wir sehen, ist es höchst unwahrscheinlich, dass mehr als 95 % der Schwachstellen jemals ausgenutzt werden. Die wirklich gefährlichen Bedrohungen konzentrieren sich im Bereich des 99. Perzentils.
Vergleichen Sie dies mit einer Aufschlüsselung der Schwachstellen nach CVSS-3.1-Schweregrad, dem am häufigsten von Sicherheitsexperten verwendeten Maßstab zur Risikobewertung. Hier konzentriert sich ein deutlich höherer Anteil der Schwachstellen im Bereich „High“ bis „Critical“:
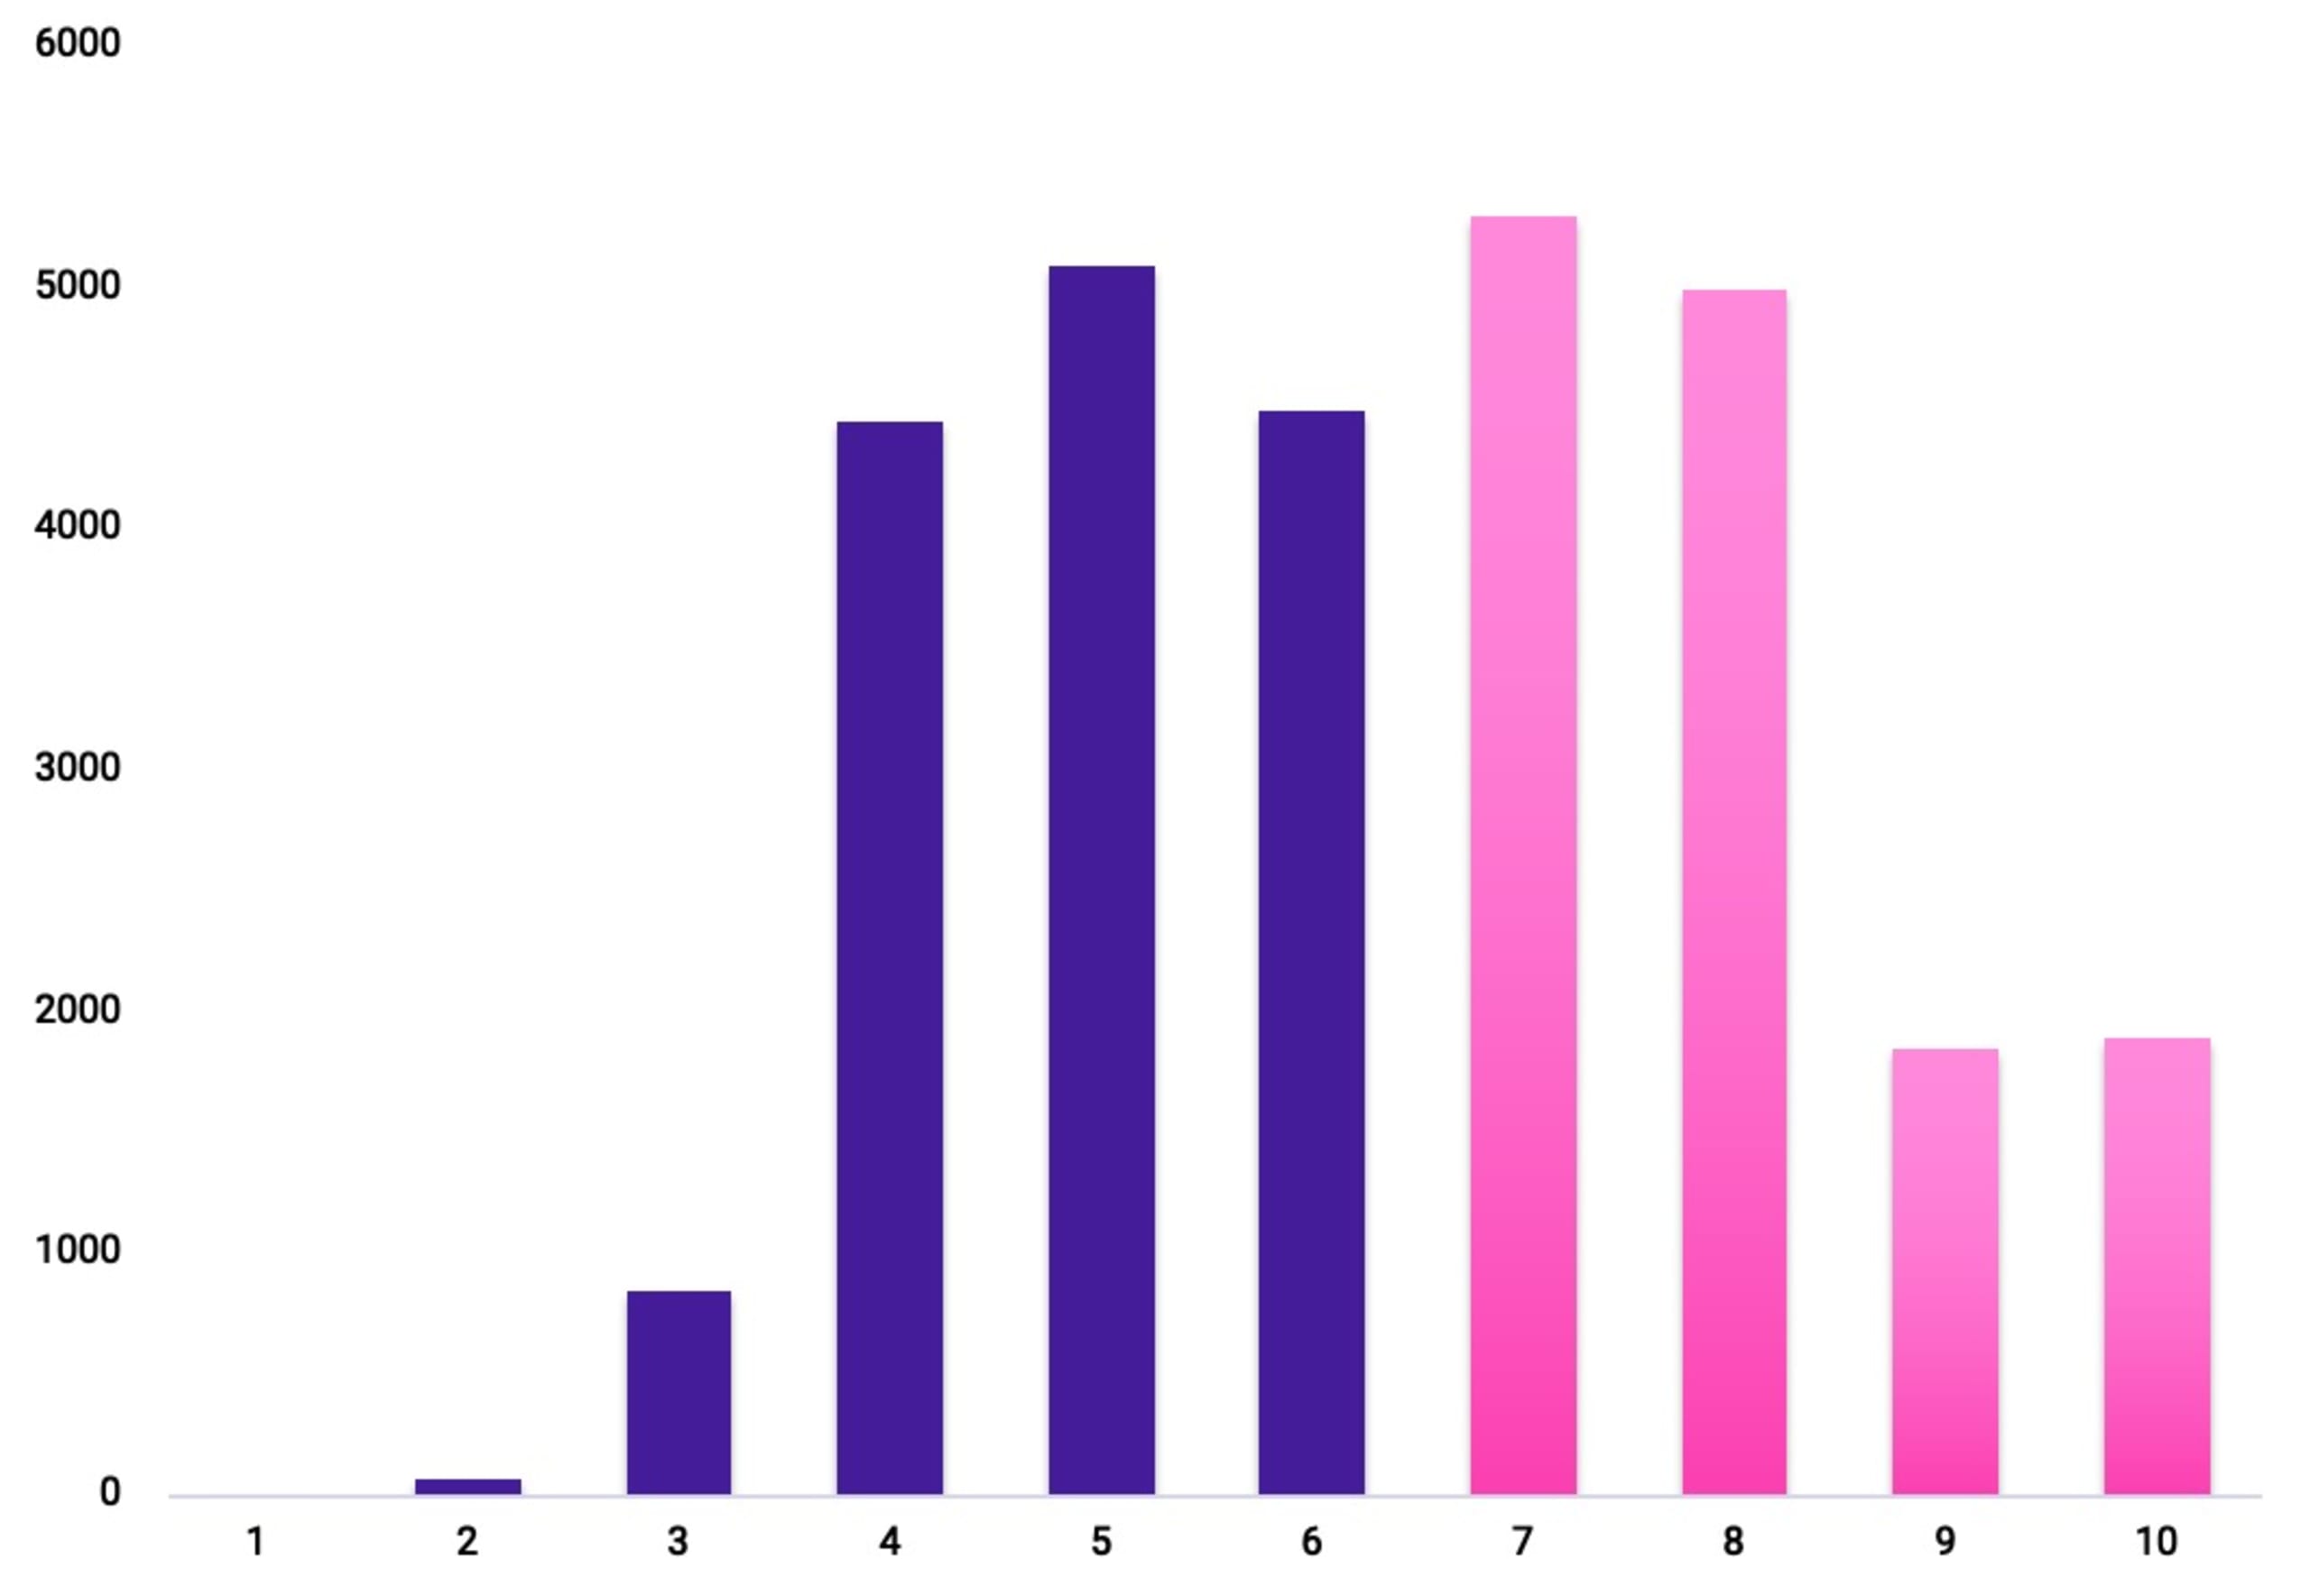
Auch ein Blick auf CVSS v4.0 hilft nicht weiter. Per Definition verlangt das CVSS-Framework weiterhin, dass Sie Issues manuell im Kontext Ihrer Umgebung analysieren. Das bedeutet für Sie einen erheblichen Arbeitsaufwand.
Risikopriorisierung: die Suche nach der Patentlösung
Die naheliegende Frage lautet: Wie kommen wir von einer Welt, in der wir Tausende äußerst unwahrscheinliche Risiken analysieren und bearbeiten müssen, zu einer Welt, in der wir uns vor allem auf die riskantesten Issues konzentrieren können? In diesem Bereich wurden verschiedene Patentlösungen vorgeschlagen – einzelne Risikofaktoren, mit denen sich beispielsweise jedes Risiko bestimmter Schwachstellen sofort ausschließen ließe:
Reifegrad des Exploits oder EPSS – Versucht objektiv vorherzusagen, ob ein Angriff unternommen wird und erfolgreich ist. Der Ansatz ist prädiktiv und berücksichtigt Ihre Umgebung nicht.
Statische Code-Erreichbarkeit – Versucht, verwendete von nicht verwendeten Komponenten abzugrenzen. Das hilft dabei, verwendete Komponenten hervorzuheben, erlaubt aber nicht, die übrigen zu ignorieren. Sich allein auf diesen Risikofaktor zu verlassen, reicht ebenfalls nicht aus, da zusätzliche Kontexte wie die Erreichbarkeit über das Netzwerk und andere ausnutzbare Bedingungen unberücksichtigt bleiben.
Transitivität – Eine Denkrichtung besagt, dass Issues in transitiven Abhängigkeiten nicht berücksichtigt werden müssen. Log4Shell (und unzählige weitere Schwachstellen) hat diese Annahme widerlegt.
Ein einfaches binäres Risikomodell ist natürlich verlockend: Es ist leicht zu verstehen und würde unseren Arbeitsaufwand erheblich verringern, wenn es tatsächlich funktionieren würde. Doch Sicherheit und Code lassen sich nicht auf simple Ja-Nein-Entscheidungen reduzieren. Solche vereinfachten Modelle setzen uns gefährlichen Risiken aus, die sie ausblenden, und lassen uns gleichzeitig auf eine Teilmenge von Schwachstellen konzentrieren, von denen viele keine echte Bedrohung darstellen. Wer sich ausschließlich auf einen dieser Faktoren oder eine Kombination davon verlässt, muss den verfügbaren Informationen – und ebenso den nicht verfügbaren – uneingeschränkt vertrauen.
Entwicklung eines neuen Risikobewertungsmodells für den Risk Score
Da wir die Herausforderungen verstehen, vor denen unsere Kunden bei der Priorisierung stehen, haben wir ein neues Risikobewertungsmodell mit drei Hauptzielen entwickelt:
Ein echtes probabilistisches Risikomodell statt eines binären Modells entwickeln.
Ein Modell entwickeln, das die inhärente Komplexität der Risikobewertung berücksichtigt und abbildet, dessen Ergebnisse Menschen aber dennoch verstehen und überprüfen können.
Kontextbezogene Eingaben einzelner Nutzer ermöglichen und diesen kontextbezogenen Faktor künftig erweitern können.
Das Bewertungsmodell des neuen Risk Score von Snyk berücksichtigt zwei Risikodimensionen:
Wahrscheinlichkeit – Wie wahrscheinlich ist es, dass ein bestimmtes Risiko eintritt? Anders gesagt: Wie wahrscheinlich ist es, dass eine Schwachstelle im Code eines Nutzers ausgenutzt wird?
Auswirkungen – Welche Auswirkungen hätte eine erfolgreiche Ausnutzung für unsere Nutzer?
Jede dieser Dimensionen wird in zwei Kategorien von Risikofaktoren unterteilt:
Objektiv – Die objektiv definierten Risikofaktoren für das jeweilige Issue, die für jede anfällige Umgebung relevant sind.
Kontextbezogen – Die Risikofaktoren, die im Kontext der Umgebung der anfälligen Anwendung definiert werden.
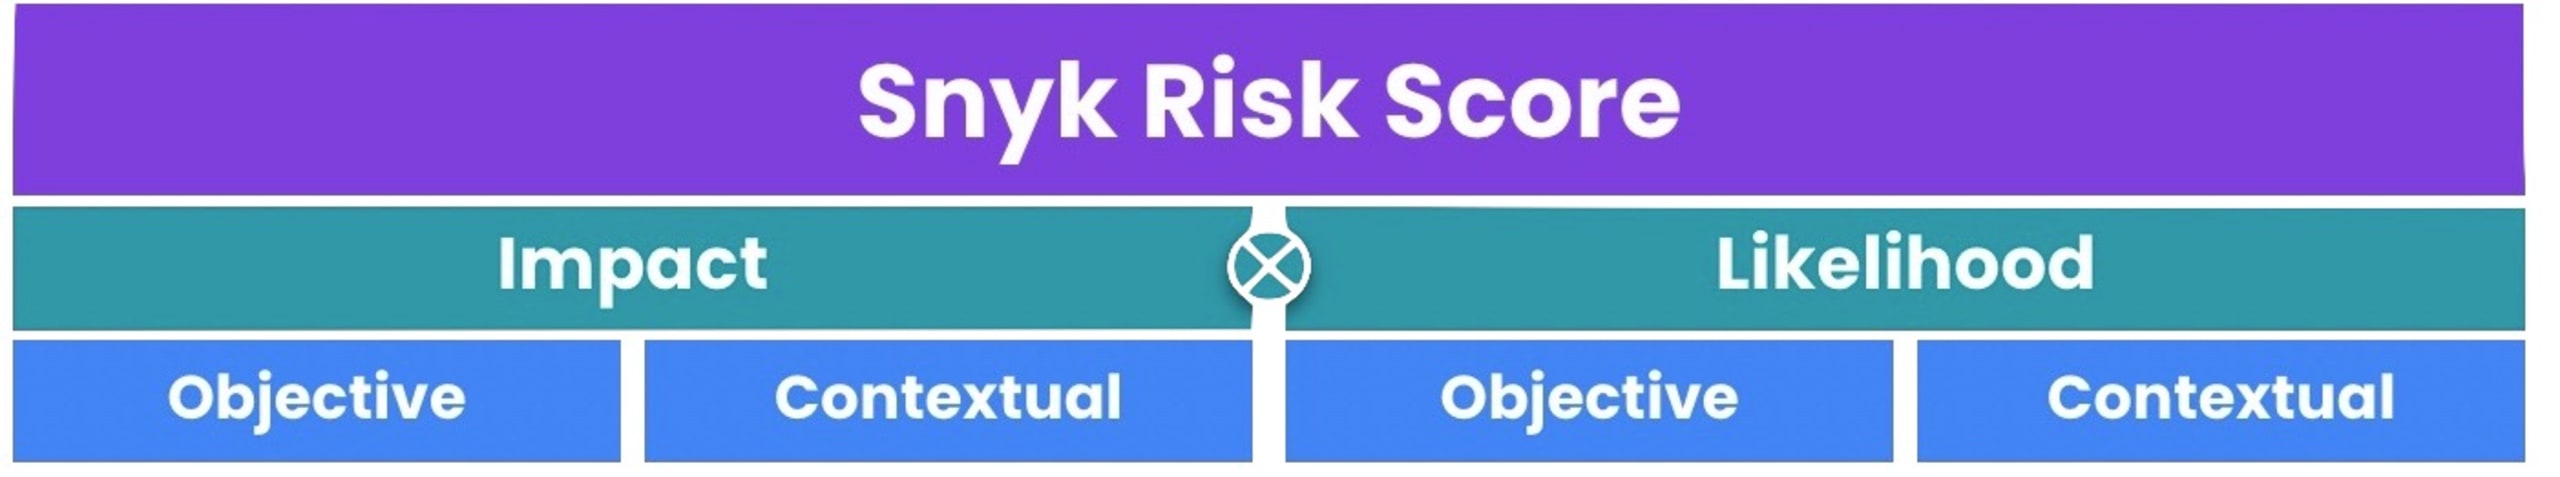
Die Algorithmen unseres Risikobewertungsmodells berechnen diese Risikofaktoren gemeinsam und ermitteln so einen Risk Score für jedes Issue.
Wie lässt sich die Ausnutzbarkeit objektiv bewerten?
Für jeden in unser Modell aufgenommenen Risikofaktor haben wir zwei Experimente durchgeführt, um sowohl seine Eignung für unseren Algorithmus als auch sein relatives Vorhersagegewicht zu überprüfen. Zunächst ermittelten wir einen Ausgangswert dafür, wie wahrscheinlich es ist, dass eine zufällige Schwachstelle ausgenutzt wird. Dazu glichen wir die interne Schwachstellendatenbank von Snyk mit den bekannten, von CISA veröffentlichten, in freier Wildbahn ausgenutzten Schwachstellen ab. Anschließend überprüften wir, wie stark jeder von uns als möglicherweise relevant für die Ausnutzbarkeit angenommene Risikofaktor mit diesem Ausgangswert korrelierte.
Korrelation bedeutet jedoch nicht Kausalität. Daher begannen wir in diesem Schritt, mit verschiedenen ML-Modellen zu experimentieren, um genau zu ermitteln, welche Risikofaktoren tatsächlich zur Vorhersage der Ausnutzbarkeit beitrugen. Nach mehreren Experimentierphasen verwendeten wir ein Regressionsmodell, um die Risikofaktoren mit einem statistisch signifikanten Einfluss auf die Ausnutzbarkeit zu identifizieren. Die Ergebnisse dieses Modells flossen in unseren Algorithmus ein.
Abschließend testeten wir die Ergebnisse unserer Modelle anhand Hunderter anonymisierter Projekte. So wollten wir prüfen, ob die Aufschlüsselung der Ausnutzbarkeit durch unser Modell mit den Erwartungen übereinstimmte, die sich aus realen Daten zu Sicherheitsverletzungen ergeben, wie oben beschrieben.
Alles hängt vom Kontext ab
Wir freuen uns, dass unsere Vorhersagen offenbar ein präzises globales Bild der Ausnutzbarkeit ergeben. Dennoch sind die kontextbezogenen Risiken in der Umgebung des einzelnen Nutzers weiterhin entscheidend. Dafür haben wir unsere interne, proprietäre Sicherheitsforschung herangezogen und versucht, bestimmte Schwachstellen unter verschiedenen Bedingungen auszunutzen. So konnten wir scheinbar „binäre“ Bedingungen wie Erreichbarkeit oder Transitivität einbeziehen und sie als probabilistische Eingaben in unserem Algorithmus verwenden, statt weitreichende (und unzutreffende) Behauptungen aufzustellen.
Bei Snyk stehen Transparenz und Vertrauen im Mittelpunkt unserer Arbeit. Deshalb legen wir alle Faktoren und Überlegungen offen, die in den Score einfließen – sowohl in den betroffenen Issues als auch in unserer öffentlichen Dokumentation.
Die Zukunft der Risikobewertung bei Snyk
Wir bei Snyk sind überzeugt, dass AppSec- und Entwicklungsteams in der Lage sein sollten, ihre Priorisierungsmethoden selbst festzulegen. Wir beobachten, dass Unternehmen dabei unterschiedliche Ansätze verfolgen:
Risikoorientiert – Issues nach einem Score filtern und sortieren, der auf einem Risikobewertungsmodell wie dem Snyk Risk Score basiert.
Compliance-orientiert – Wenn Compliance für Sie eine hohe Priorität hat, müssen Sie sich um jedes Issue mit dem CVSS-Schweregrad „High“ oder „Critical“ kümmern. Wie bereits erwähnt, führt das zu einer großen Anzahl von Issues. Mit einem Risk Score können Sie sie sortieren und nach Wichtigkeit filtern.
Aufwand-orientiert – Issues danach aufschlüsseln, wie viel Aufwand ihre Behebung erfordert. Der Aufwand sollte nicht in den Risk Score einfließen, aber als zusätzliche Dimension ist er wichtig, um zu entscheiden, welche Issues Sie angehen.
Vielleicht haben Sie auch Ihre eigene Risikobereitschaft und möchten eigene Einschätzungen einbringen. Deshalb wird der Risk Score von Snyk künftig anpassbar sein: Nutzer können ihr Wissen über ihre Umgebung einfließen lassen und das Vorhersagemodell zur Priorisierung nutzen, statt Issues auszuschließen.
Aktivieren Sie Risk Score noch heute über Snyk Preview und legen Sie los!