Benchmarking sicherer und funktionaler Fehlerbehebungen: Wie Snyk Agent Fix die Erfolgsquote von Frontier-Modellen um über 14 % steigert


18. August 2026
0 Min. LesezeitZusammenfassung
Wir haben untersucht, wie gut führende Modelle Schwachstellen sicher und funktional beheben – anhand von rund 150 realen anfälligen Codebeispielen in JavaScript, Java und Python. Jedes Modell wurde einzeln und mit Snyk Intelligence (der neuen agentischen Agent-Fix-Architektur) getestet. Die wichtigsten Ergebnisse:
Frontier-Modelle erreichen ohne zusätzliche Unterstützung 72–75 %. Gemini 3.1 Pro, Claude Sonnet 4.6 und Claude Opus 4.6 liegen nur wenige Prozentpunkte auseinander. Bei sicheren und funktionalen Fehlerbehebungen macht die Wahl des Modells kaum einen Unterschied.
Snyk Intelligence hebt dieselben Modelle deutlich über dieses Niveau. Opus 4.6 steigt von 74,6 % auf 85,4 %, ein Zuwachs von 10,8 Prozentpunkten (14,48 % mehr behobene Beispiele). Entscheidend ist der Sicherheitskontext, nicht das Modell.
Am größten ist der Leistungszuwachs dort, wo das Modell am schwächsten ist. Opus allein behebt nur 64 % der Python-Beispiele; mit Snyk Intelligence sind es 88 %.
Einführung
Es gibt Benchmarks für Coding-Agenten, die Unit-Test-Generierung, Fehlerbehebung im Stil von SWE-bench und Codevervollständigung bewerten. Was fehlt, ist ein weithin genutzter öffentlicher Benchmark für die Aufgabe, die Sicherheitsteams wirklich interessiert: Code mit einer bekannten Schwachstelle so zu beheben, dass die Schwachstelle beseitigt wird und der Code weiterhin funktioniert. Das sind zwei unabhängige Anforderungen. Nur eine davon zu erfüllen, ist ein häufiges und kostspieliges Problem. Eine Behebung, die eine SQL-Injection entfernt, aber das Ergebnis einer Abfrage verändert, hilft niemandem. Eine scheinbar saubere Behebung, bei der die Injection bestehen bleibt, ist noch schlimmer, denn sie sieht nach einer Lösung aus.
Deshalb haben wir einen Benchmark entwickelt, der beide Anforderungen für jede Behebung bewertet, und Frontier-Modelle damit zweimal getestet: einmal allein und einmal mit Snyks Sicherheitsintelligenz. Die Frage, die wir beantworten wollten, ganz einfach formuliert: Wie stark verändert Snyks Sicherheitskontext, was ein Frontier-Modell beheben kann – und in welchen Fällen?
Die Kurzfassung: Modelle ohne zusätzliche Unterstützung stagnieren bei etwa 72–75 %. Snyk Intelligence bringt sie darüber hinaus. Im restlichen Beitrag stellen wir die Daten und die Methodik vor.
So messen wir: der Golden-Test-Benchmark
Die meisten Code-Benchmarks prüfen, ob der Code ausgeführt wird oder ob er einen Fehlerbericht behebt. Für die Behebung von Sicherheitsproblemen reicht weder das eine noch das andere: Sie muss gleichzeitig Sicherheits- und Funktionsanforderungen erfüllen. Unser Evaluierungsdatensatz, die Golden Tests, wurde entwickelt, um beides zu messen. Das Design orientiert sich an SWE-bench und wurde für den Sicherheitsbereich angepasst.
Die Testfälle
Der Datensatz umfasst rund 150 reale Codebeispiele mit Schwachstellen: 50 in Python, 54 in JavaScript und 39 in Java. Jedes Beispiel enthält genau eine Schwachstelle, die von Snyk Code gefunden und von einem menschlichen Sicherheitsexperten bestätigt wurde. Die Beispiele wurden so ausgewählt, dass sich die Schwachstelle anhand des vorliegenden Codes beheben lässt – ohne fehlenden externen Kontext.
Die Bewertung
Zu jedem Beispiel gehören zwei von Menschen überprüfte Unit-Tests:
Ein Test, der fehlschlägt, weil die Schwachstelle vorhanden ist, und
ein Test, der bestanden wird, wenn die ursprüngliche Funktionalität des Codes erhalten bleibt (zum Beispiel gibt eine Hilfsfunktion nach der Behebung weiterhin „hello world“ zurück).
Damit ein Modell den Test besteht, muss es den Code so beheben, dass beide Tests beim ersten Versuch bestanden werden, ohne dass das Modell zuvor einen der Tests gesehen hat. Das Modell bekommt die Unit-Tests nie zu sehen. Ein bestandenes Ergebnis steht also für eine wirklich sichere und funktionierende Behebung, nicht für eine Ausgabe, die auf einen bekannten Test zugeschnitten wurde.
Betrachten wir ein Python-Beispiel mit einer SQL-Injection: Der Code erstellt eine Abfrage, indem er Benutzereingaben aneinanderreiht. Der Sicherheitstest sendet eine SQL-Injection-Nutzlast und prüft, dass die Datenbank nicht sämtliche Zeilen preisgibt; der anfällige Code besteht den Test nicht. Der Funktionstest sendet einen gewöhnlichen Benutzernamen und prüft, ob der richtige Datensatz zurückgegeben wird; der ursprüngliche Code besteht ihn. Die Behebung zählt nur dann, wenn die vom Modell umgeschriebene Version den Sicherheitstest besteht und zugleich den Funktionstest besteht – beim ersten Versuch und ohne dass die Tests zuvor bekannt waren.
Was wir evaluiert haben
Sechs Konfigurationen: Snyks vorheriges, internes, auf StarCoder basierendes Agent-Fix-Modell, drei Frontier-Modelle ohne zusätzliche Unterstützung (Gemini 3.1 Pro, Claude Sonnet 4.6, Claude Opus 4.6) sowie Sonnet 4.6 und Opus 4.6 mit Snyk Intelligence unter der neuen agentischen Agent-Fix-Architektur. „Snyk Intelligence“ bezeichnet hier dynamisches Few-Shot-Prompting: Zum Zeitpunkt der Behebung fügen wir die relevantesten von Experten verfassten Behebungen für die jeweilige Schwachstelle ein. Sie stammen aus Snyks Datenbank mit mehr als 35.000 Schwachstellen. (Das baut auf früheren Arbeiten auf, in denen derselbe Ansatz die Leistung handelsüblicher LLMs verbesserte.)
Wie schneidet der Snyk-Agent-Fix-Benchmark im Vergleich zu früheren Benchmarks ab?
Die Golden Tests stehen in einer Reihe von Arbeiten, die den Maßstab für die Evaluierung von KI für Code kontinuierlich erhöht haben. SWE-bench etablierte die Praxis, Modelle anhand verborgener, realer Tests statt anhand selbst eingeschätzter Plausibilität zu bewerten. Im Sicherheitsbereich führte Vul4J reproduzierbare Schwachstellen ein, die mit Tests zum Nachweis der Schwachstellen sowie einer funktionalen Regressionssuite kombiniert wurden. Das ist der bisher engste Vorläufer unseres FAIL-to-PASS- plus PASS-to-PASS-Designs. Neuere Arbeiten wie BaxBench und SEC-bench bekräftigen die Grundannahme, auf der unser Ansatz beruht: Funktional korrekter Code ist häufig trotzdem unsicher. Ein aussagekräftiger Benchmark für die Behebung von Schwachstellen muss daher beide Eigenschaften gleichzeitig bewerten. Das Besondere an den Golden Tests ist, dass beide Hürden gemeinsam geprüft werden – anhand realer, von Menschen verifizierter Beispiele, mit vor dem Modell verborgenen Tests und in drei Programmiersprachen, die in der Praxis eingesetzt werden.
Ergebnisse
Die zentrale Kennzahl ist der Anteil der Golden Tests, bei denen die Behebung sowohl sicher als auch funktional war.
Konfiguration | Rate sicherer und funktionaler Behebungen |
|---|---|
StarCoder (vorheriges Agent-Fix-Modell) | 72,4 % |
Gemini 3.1 Pro | 74,2 % |
Claude Sonnet 4.6 | 72,4 % |
Claude Opus 4.6 | 74,6 % |
Claude Sonnet 4.6 + Snyk Intelligence | 82,5 % |
Claude Opus 4.6 + Snyk Intelligence | 85,4 % |
DIAGRAMM 1: Rate sicherer und funktionaler Behebungen.
Die Modelle ohne zusätzliche Unterstützung liegen innerhalb einer Spanne von drei Prozentpunkten. Mit Snyk Intelligence wächst der Abstand beim selben Modell auf 8 bis 11 Prozentpunkte: Opus 4.6 steigt von 74,6 % auf 85,4 %.
Eine Aufschlüsselung des Opus-Vergleichs nach Programmiersprache zeigt, dass der Zuwachs kein Effekt der Mittelwertbildung ist. Er tritt in jeder getesteten Sprache auf und ist dort am größten, wo das Modell ohne zusätzliche Unterstützung am schwächsten ist.
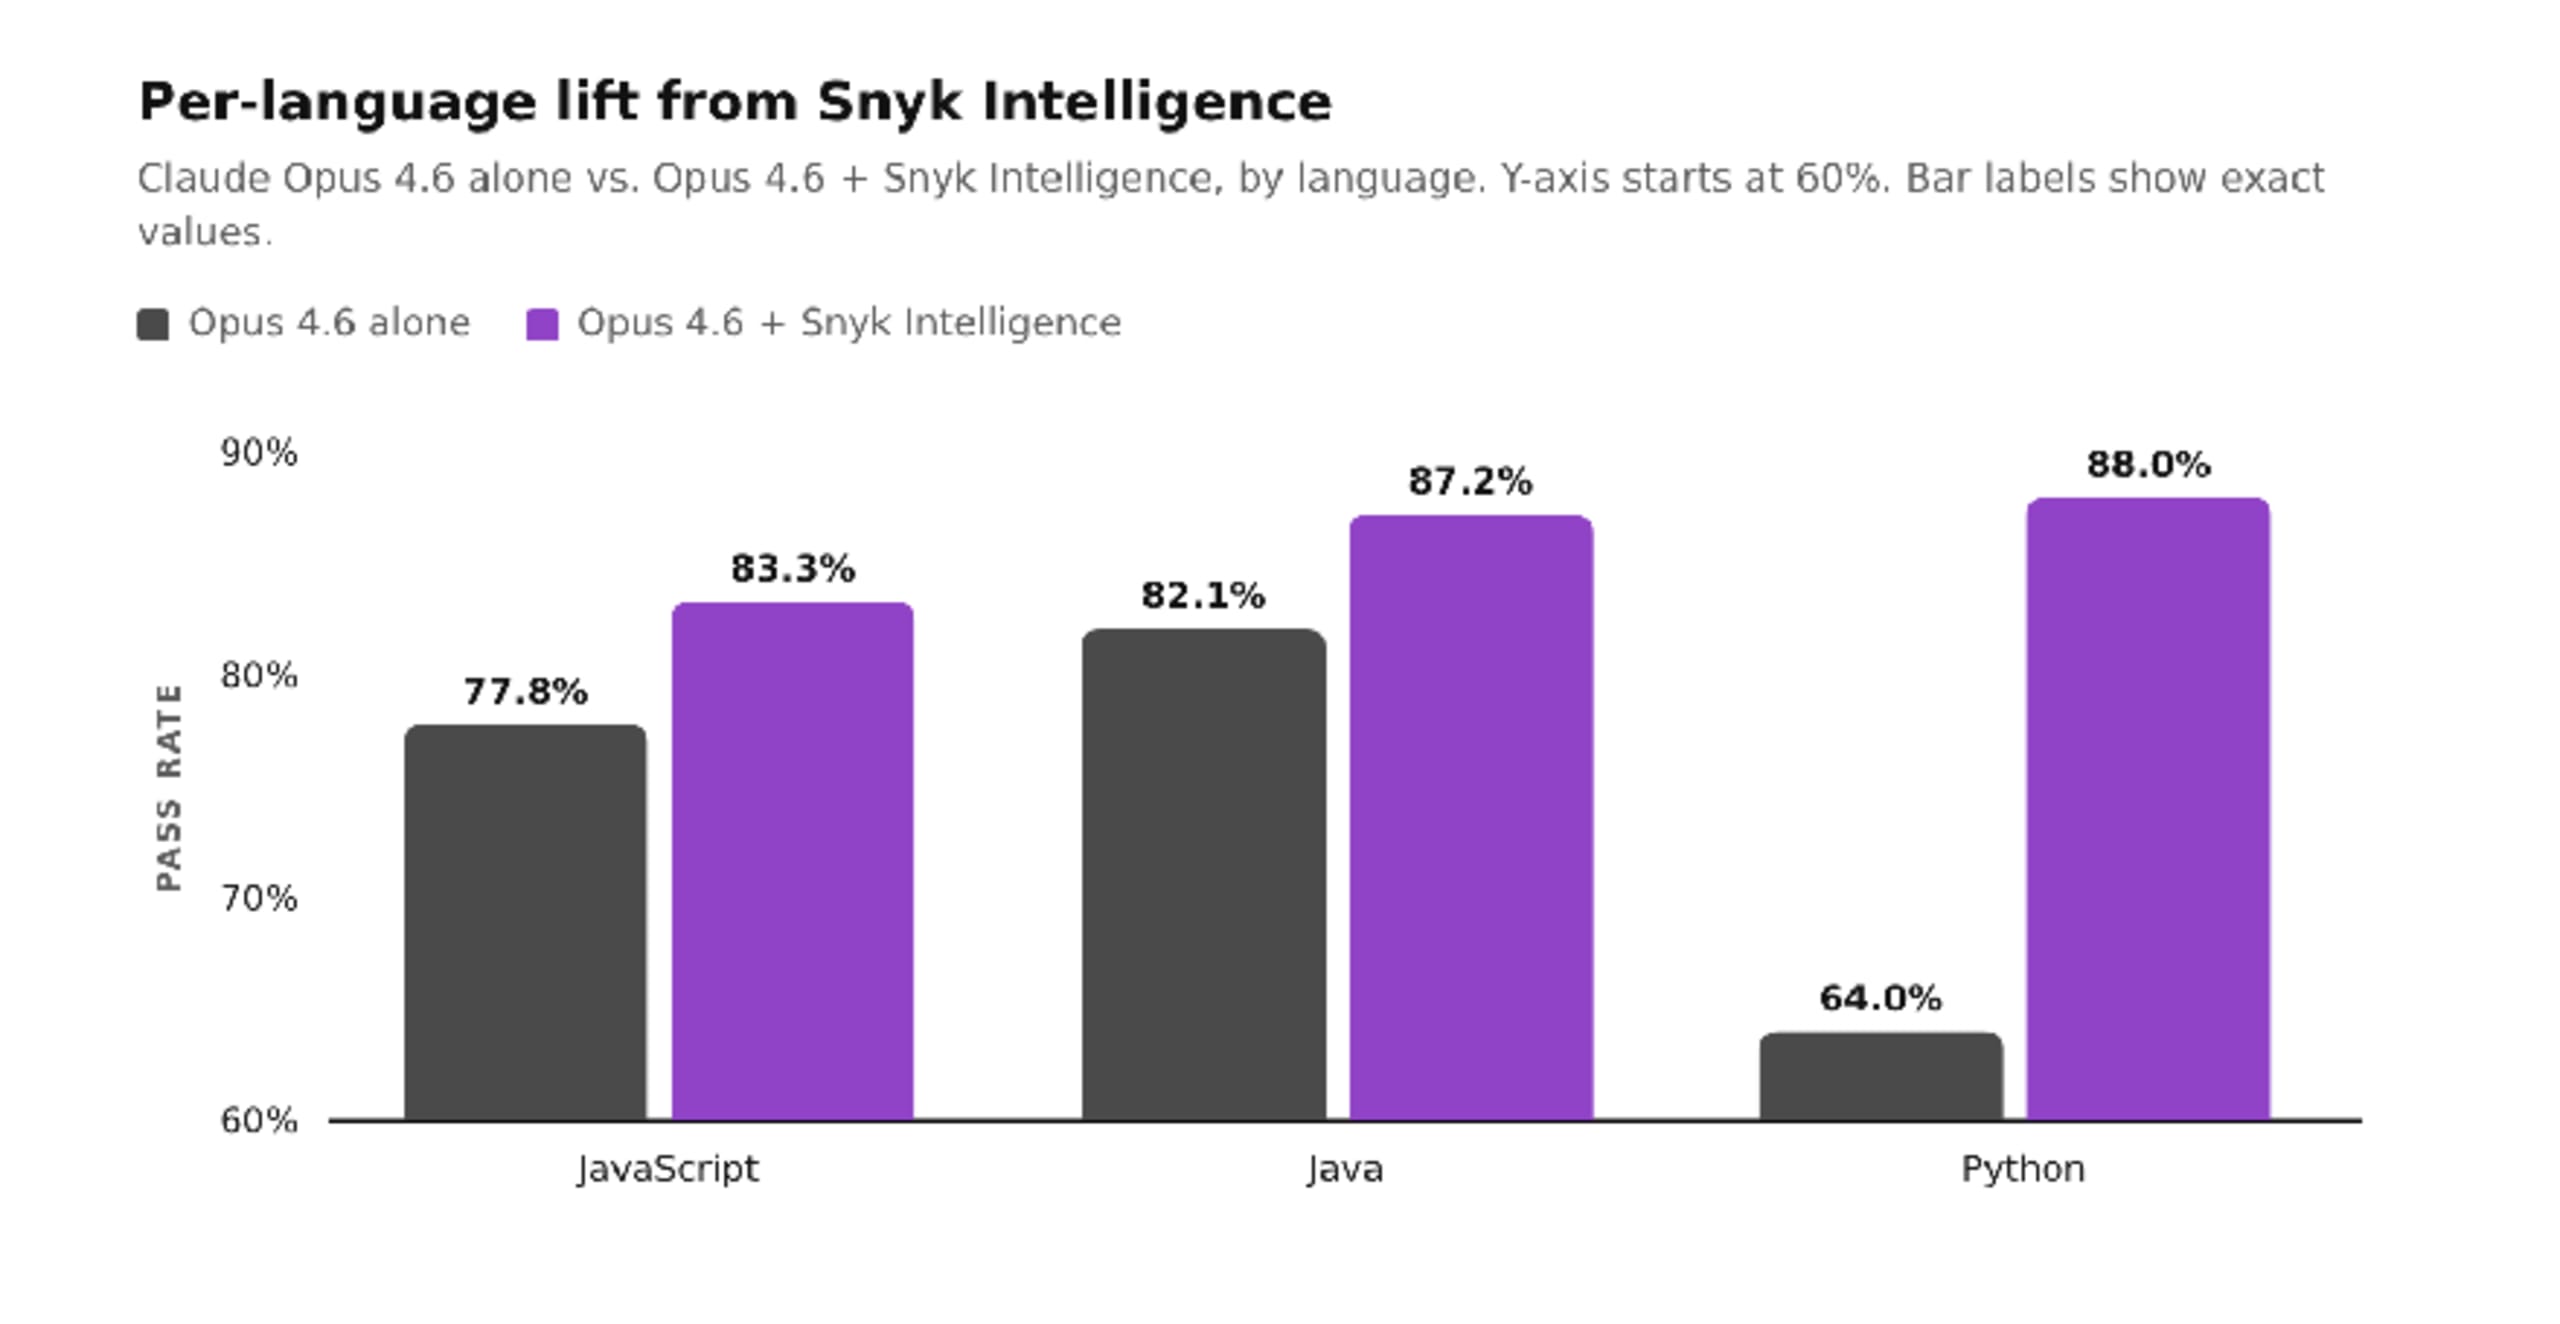
DIAGRAMM 2: Leistungszuwachs nach Programmiersprache
Am deutlichsten zeigt sich das bei Python: Opus allein behebt 64,0 % der Beispiele; mit Snyk Intelligence steigt der Anteil auf 88,0 %. Bei JavaScript und Java, wo Opus bereits stark startet, beträgt der Zuwachs jeweils fünf bis sechs Prozentpunkte.
Was die Zahlen bedeuten
Bei sicheren und funktionalen Behebungen ist die Modellgröße allein kein Hebel mehr
Die drei Modelle ohne zusätzliche Unterstützung erreichen Werte zwischen 72,4 % und 74,6 % – eine Spanne von 2,2 Prozentpunkten über zwei Anbieter hinweg. Wenn ein größeres oder neueres Modell bei dieser Aufgabe den Ausschlag gäbe, müsste sich das hier zeigen. Das tut es nicht. Die Aufgabe ist auf eine Weise schwierig, die allgemeine Leistungsfähigkeit nicht unmittelbar abdeckt: Das Modell muss wissen, wie eine sichere Behebung für diese Schwachstelle aussieht, und nicht nur plausiblen Code schreiben.
Der Hebel ist der Sicherheitskontext, nicht ein größeres Modell
Dasselbe Opus 4.6 gewinnt allein durch die zum Zeitpunkt der Behebung hinzugefügten Sicherheitsbeispiele 10,8 Prozentpunkte (14,48 % mehr behobene Beispiele). Da der Ansatz modellunabhängig ist, verstärkt er jeden Leistungszuwachs der zugrunde liegenden Frontier-Modelle, statt mit ihm zu konkurrieren. Der dauerhafte Vermögenswert sind die mehr als 35.000 Experten-Behebungen. Das Modell ist eine austauschbare Komponente, die wir mit der Weiterentwicklung des Feldes wechseln können. Deshalb kombiniert Agent Fix im Produktivbetrieb jetzt Snyk Intelligence mit Claude Opus 4.7.
Am größten ist der Leistungszuwachs dort, wo das Modell am schwächsten ist
Opus allein behob nur 64 % der Python-Beispiele – sein schwächstes Ergebnis. Mit Snyk Intelligence erreichte es 88 %, den größten Zuwachs der drei Sprachen. Der Sicherheitskontext hebt nicht nur den Durchschnitt, sondern auch die Untergrenze an.
Auch bei genauerem Hinsehen bleibt das Ergebnis bestehen
Der Opus-mit-Snyk-Wert ist ein Mittelwert aus zwei Durchläufen (84,6 % und 86,0 %). Die 85,4 % als Ergebnis spiegeln also eine konsistente Leistung über mehrere Durchläufe wider. Die Schwankung zwischen den Durchläufen beträgt bei diesem Datensatz ungefähr einen Prozentpunkt. Das sollten Sie berücksichtigen, wenn Sie Konfigurationen vergleichen, deren Werte nur ein oder zwei Prozentpunkte auseinanderliegen.
Als Nächstes: Snyk VulnBench und die Erkennung von Schwachstellen mit Coding-Agenten
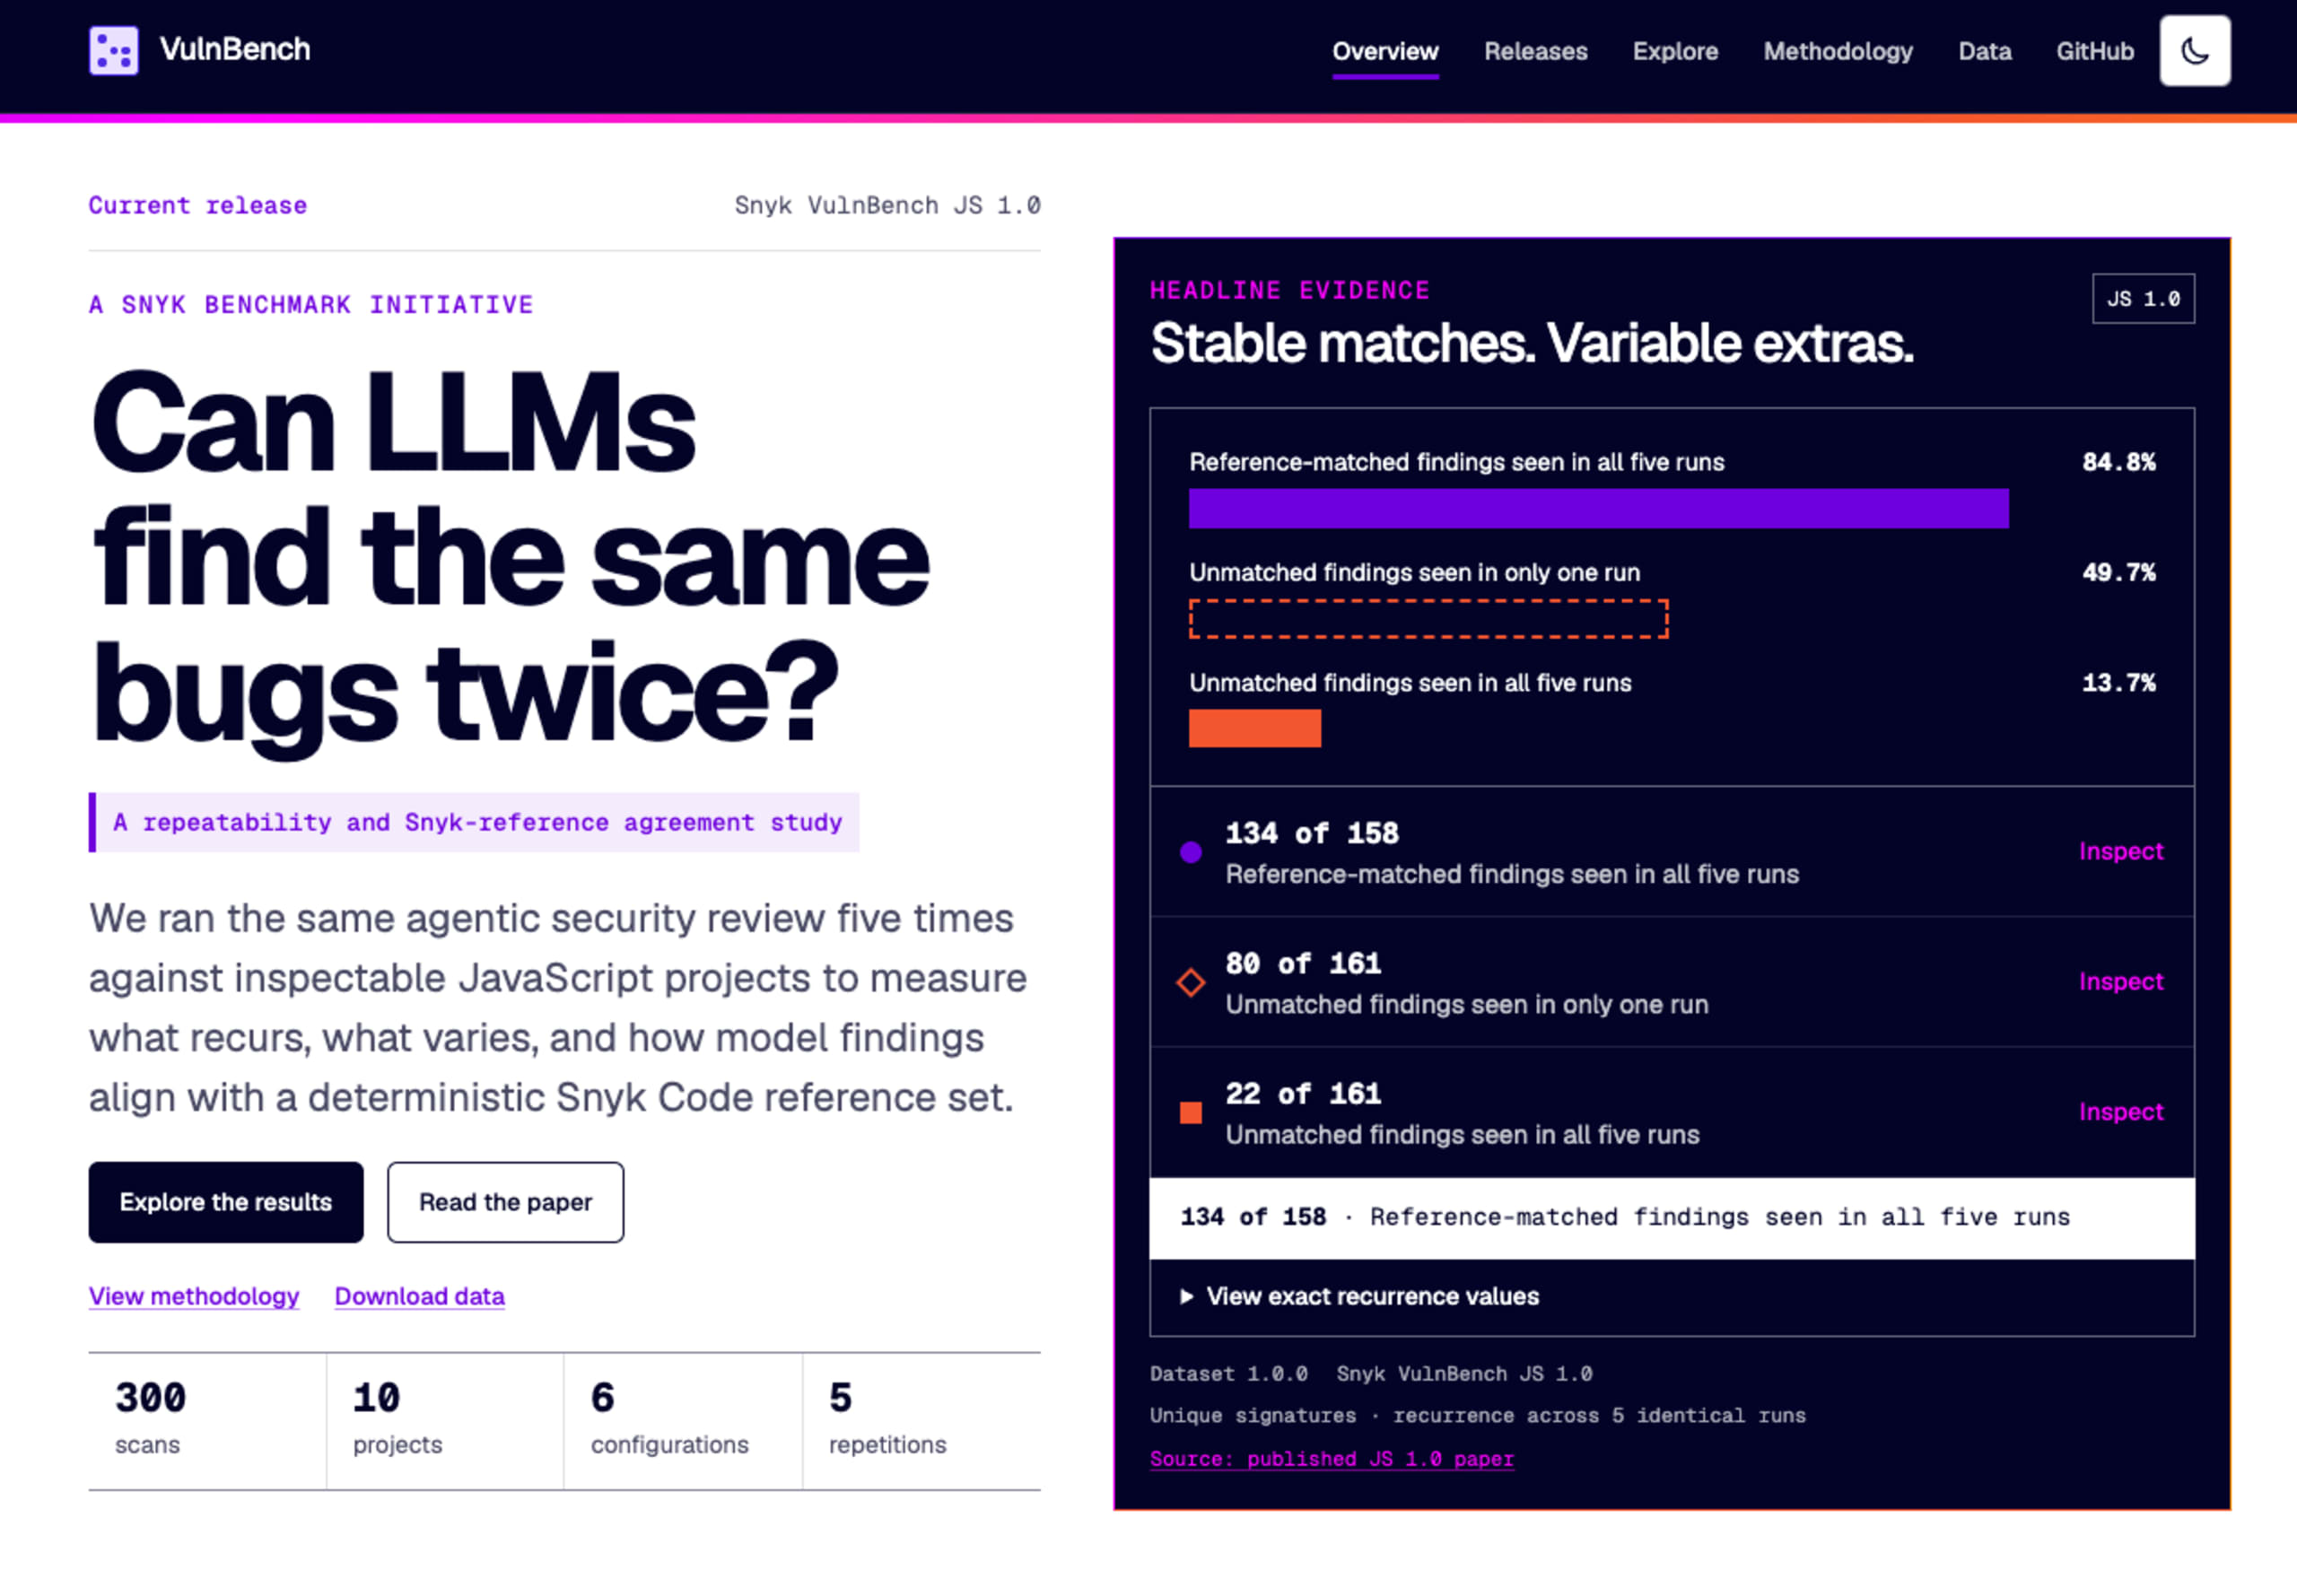
Die Behebung einer Schwachstelle setzt voraus, dass Sie sie gefunden haben. Im Juni 2026 veröffentlichten wir das Paper zu Snyk VulnBench JS 1.0. Darin ging es um den Benchmark-Vergleich von Snyk Code als deterministischer, schneller SAST-Engine mit LLMs, die von Coding-Agenten (dem Claude-Code-Harness) gesteuert werden, um Schwachstellen im Code zu erkennen, bevor sie behoben werden müssen.
Unsere Ergebnisse mit Snyk VulnBench zeigten, dass selbst Frontier-LLMs wie Claude Opus 4.7 auf der höchsten Reasoning-Stufe (auch max genannt) und selbst mit einem fortschrittlichen Coding-Agent-Harness (Claude Code selbst) Schwierigkeiten mit Wiederholbarkeit und Determinismus hatten. Einige zentrale Ergebnisse:
In einem Fall meldeten das Modell und der Coding-Agent rund 50 % der Ergebnisse, die sich in vier der fünf folgenden Ausführungen nicht wiederholten. Das führte zu einem Rückstau an False Positives und zu Vulnerability Fatigue bei agentisch arbeitenden Entwicklern und AI-Security-Engineers.
In anderen Fällen meldeten 13 % der Coding-Agenten Schwachstellen, die nicht übereinstimmten und in allen fünf Ausführungen auftraten. Das sorgte für eine noch verwirrendere Situation und erhöhte die kognitive Belastung, wenn es darum ging, im Sicherheits-Backlog möglicherweise falsche Ergebnisse zu erkennen.
Wir laden Sie ein, den Snyk-VulnBench-Datensatz zu untersuchen. Er ist online und öffentlich verfügbar: https://vulnbench.com/
Einschränkungen
Vor der Interpretation dieser Zahlen sollten Sie vier Einschränkungen berücksichtigen:
Umfang des Datensatzes: Rund 150 Beispiele (50 Python, 54 JavaScript, 39 Java) reichen aus, um klare Muster zu erkennen, nicht aber, um die statistische Signifikanz kleiner Unterschiede zu belegen. Die StarCoder-Baseline wurde anhand eines etwa 20 % kleineren Datensatzes ausgeführt (nur von Agent Fix unterstützte Regeln, für die Trainingsdaten vorlagen); über alle Regeln hinweg liegt der Wert bei 54,9 %. Es handelt sich um Snyks internes, feinabgestimmtes Modell, das zum Vergleich und nicht als Frontier-Baseline aufgenommen wurde.
Codeausschnitte statt vollständiger Anwendungen: Jedes Beispiel besteht aus einer einzelnen Datei mit einer Schwachstelle, die sich anhand des lokalen Kontexts beheben lässt. Reale Codebasen umfassen dateiübergreifende Zusammenhänge und mehrere miteinander interagierende Probleme; dieser Benchmark misst das nicht.
Drei Programmiersprachen: Wir haben JavaScript, Java und Python getestet. Die neue Architektur unterstützt alle von Snyk Code unterstützten Programmiersprachen, doch für die Golden Tests liegen derzeit nur für diese drei Sprachen Daten vor.
Begrenzte Anzahl an Durchläufen zur Messung der Schwankungen: Für die mit Snyk erweiterten Konfigurationen haben wir zwei Durchläufe aggregiert und noch nicht genug Wiederholungen durchgeführt, um für jede Konfiguration formale Fehlerbalken anzugeben. Unterschiede von weniger als zwei Prozentpunkten sollten Sie als Näherungswerte betrachten.
Wir nennen diese Einschränkungen, damit Sie einschätzen können, welchen Ergebnissen Sie wie viel Gewicht beimessen sollten – nicht, um die Ergebnisse zu relativieren. Der Abstand von mehr als zehn Prozentpunkten durch Snyk Intelligence liegt deutlich über den Schwankungen zwischen den Durchläufen; die Rangfolge kleiner Abstände nach Programmiersprache hingegen nicht.
Wie es weitergeht
Mehr Programmiersprachen abdecken: Golden-Test-Datensätze über JavaScript, Java und Python hinaus erweitern, damit der Benchmark die vollständige Sprachunterstützung der Architektur abbildet.
Schwankungen quantifizieren: Jede Konfiguration oft genug ausführen, um aussagekräftige Fehlerbalken statt eines Mittelwerts aus zwei Durchläufen zu veröffentlichen.
Erkennung statt nur Behebung: Dieser Benchmark misst die Behebung. In einem ergänzenden Projekt messen wir, wie gut Agenten Schwachstellen finden – im Vergleich zu Snyk Code. Die Ergebnisse veröffentlichen wir separat.
Der neue agentische Agent Fix ist jetzt ausgerollt und kombiniert Snyk Intelligence mit Claude Opus 4.7. Möchten Sie sichere und funktionale Behebungen mit Ihrem eigenen Code erleben? Starten Sie mit Snyk Code und Agent Fix und erfahren Sie mehr über die technische Entwicklung hinter diesen Zahlen.
Können Sie KI-generiertem Code vertrauen? Ich habe einen Scanner entwickelt, um es herauszufinden
Anhang: Methodik und Aggregation
Eval-Struktur: Jeder Golden Test besteht aus einem Codebeispiel mit genau einer Schwachstelle, einem Sicherheitstest (der beim anfälligen Code fehlschlägt) und einem Funktionstest (der beim Originalcode erfolgreich ist). Eine Konfiguration besteht einen Testfall nur dann, wenn die Behebung beide Tests beim ersten Versuch besteht. Dabei werden die Tests dem Modell vorenthalten.
Aggregation: Die angegebenen Raten zeigen den Anteil der erfolgreich behobenen Testfälle.
Der Wert von 72,4 % für das vorherige Modell (StarCoder) entspricht dem Mittelwert seiner Raten pro Programmiersprache und berücksichtigt nur von Agent Fix unterstützte Regeln. Über alle Regeln hinweg sinkt er auf 54,9 %.
Der Wert von 85,4 % für Opus 4.6 + Snyk Intelligence ist der Durchschnitt über mehrere Durchläufe (Durchlauf 1 = 86,0 %, Durchlauf 2 = 84,6 %). Die Werte pro Programmiersprache in der zweiten Grafik stammen aus einem einzelnen repräsentativen Durchlauf. Deshalb liegen sie im Durchschnitt etwas höher (~86 %) als der Wert für mehrere Durchläufe. Maßgeblich ist der Wert für mehrere Durchläufe.
Konfigurationen: StarCoder (das vorherige Agent-Fix-Modell); Gemini 3.1 Pro; Claude Sonnet 4.6 und Claude Opus 4.6, jeweils ohne zusätzliche Anpassungen und mit Snyk Intelligence in der agentischen Agent-Fix-Architektur. Die hier gezeigten Daten wurden mit Opus 4.6 erhoben; Agent Fix in der Produktionsumgebung ist inzwischen auf Claude Opus 4.7 umgestiegen. Snyk Intelligence fügt zum Zeitpunkt der Generierung von Experten verfasste Behebungen für die jeweilige Schwachstelle hinzu (dynamisches Few-Shot-Prompting).
Erleben Sie Snyk in Aktion
Erfahren Sie, warum Entwickler und Security-Teams gleichermaßen auf Snyk setzen – und was Snyk für Ihr Team leisten kann.