Genauer als GPT-4: Wie Snyks CodeReduce die Leistung anderer LLMs verbessert hat

7. Mai 2024
0 Min. LesezeitSeit dem Start von Snyk Code im Jahr 2021 ist Snyk ein Vorreiter im Bereich KI-gestützter Cybersicherheit. Die DeepCode AI Engine brachte erstmals unübertroffene Genauigkeit und Geschwindigkeit bei der Identifizierung von Sicherheitsproblemen im SAST-Bereich. In den vergangenen drei Jahren haben wir den Aufstieg von KI und LLMs erlebt. Snyk war dabei mit der Einführung neuer KI-basierter Funktionen an vorderster Front, etwa mit Snyk Agent Fix, unserer Funktion zur automatischen Behebung von Schwachstellen, oder unserer Funktion zur Erreichbarkeitsanalyse von Drittanbieterabhängigkeiten.
Wir haben kürzlich große Modellverbesserungen für Snyk Agent Fix angekündigt, eine Beta-Funktion, die von Snyk Code erkannte Sicherheitsprobleme automatisch behebt. Snyk Agent Fix kombiniert die neueste KI-Technologie mit unserer internen Expertise, um zuverlässige Korrekturen zu erstellen. Sicherheitsprobleme zu beheben ist komplex. Erfahren Sie mehr darüber, wie wir dabei vorgehen: Wir werfen einen tiefen Blick in das Forschungspapier, das die wichtigsten Zutaten hinter der Snyk Agent Fix-CodeReduce-Technologie und unserem kuratierten Datensatz für Sicherheitskorrekturen erläutert.
Sicherheitskorrekturen automatisieren – eine komplexe Aufgabe
Entwicklerinnen und Entwickler wenden oft viel Zeit dafür auf, Sicherheitsprobleme selbst zu finden und zu beheben. Vor DeepCode AI unterstützte Snyk Code sie beim ersten Schritt, dem Erkennen der Probleme. Doch selbst dann konnte der nächste Schritt – das Beheben der Sicherheitsprobleme – schwierig und zeitaufwendig sein, da Entwicklerinnen und Entwickler häufig keine Sicherheitsschulungen erhalten hatten und auch heute oft nicht erhalten. Um Sicherheitsprobleme zu beheben, müssen sie den Code manuell überprüfen, herausfinden, wie er funktionieren soll, die Sicherheitsprobleme im Kontext des Codes verstehen und recherchieren, wie sie diese beheben können, bevor sie das Problem tatsächlich korrigieren.
Die automatisierte Behebung von Sicherheitsproblemen, kurz „Auto-Fixing“, steht bei vielen Unternehmen seit Jahren im Fokus. Ziel ist es, den Großteil der Behebungsarbeit zu reduzieren. Trotz vieler Versuche erwies es sich jedoch als schwierig, eine Lösung mit präzisen Korrekturen zu entwickeln. Deshalb konzentrierten sich die meisten Auto-Fixing-Tools darauf, nur eine kleine Auswahl an Problemen zu beheben, triviale Änderungen an wenigen Codezeilen vorzunehmen oder lediglich Formatierungsprobleme zu korrigieren.
Mit dem Aufkommen von LLMs erkannten wir das Potenzial, mit der neuen KI-Generation bessere Funktionen für die automatische Behebung zu entwickeln. Doch auch LLMs sind bei der Behebung von Sicherheitsproblemen eingeschränkt, wenn sie nicht ausreichend auf die gewünschten Ergebnisse ausgelegt sind. Die meisten LLMs wurden mit einer großen Bandbreite an Daten und Code trainiert, aber nicht speziell für die Behebung von Sicherheitsproblemen. Daraus ergaben sich für uns zwei zentrale Probleme:
Für eine so spezifische Aufgabe wie die automatische Behebung von Sicherheitsproblemen benötigen LLMs einen spezialisierten Datensatz mit Sicherheits- und semantischen Codekorrekturen, aus dem sie lernen können, um relevante und präzise Korrekturen zu erstellen.
Halluzinationen und die begrenzte Menge an Kontext, die LLMs bei jeder Ausgabe verarbeiten können, bedeuten, dass mehr Code in Prompts nicht immer zu besseren Ergebnissen führt. Das gilt auch dann, wenn damit ein „Allzweck“-LLM – im Gegensatz zu einem speziell für Sicherheit trainierten Modell – zu präziseren Ausgaben angeleitet werden soll.
Die Einschränkungen von LLMs überwinden, um bessere Korrekturen zu erzielen
Wir kamen zu dem Schluss, dass die Vorteile von LLMs den Aufwand zur Behebung der erkannten Probleme überwogen. Deshalb machten wir uns selbst daran, diese Probleme zu lösen.
Datensatz für Korrekturen
Wir haben einen umfassenden Datensatz mit Sicherheitskorrekturen für Open-Source-Software erstellt, um bestmögliche Ergebnisse zu erzielen. Zunächst haben wir umfangreiche Labels für Open-Source-Commits erstellt und einen bereinigten Datensatz mit Problemen und Korrekturen für JavaScript aufgebaut. (Inzwischen haben wir dasselbe für weitere Programmiersprachen wie Java, Python, C/C++, C#, Go und APEX getan.) Anstatt anschließend manuell weitere gelabelte Daten hinzuzufügen, nutzten wir die Programmanalyse-Funktionen von Snyk Code aus unserer DeepCode AI Engine, um denselben quantitativen Effekt wie beim Labeln von Daten zu erzielen und bereinigte Datensätze zu erstellen.
CodeReduce-Technologie (Patent angemeldet)
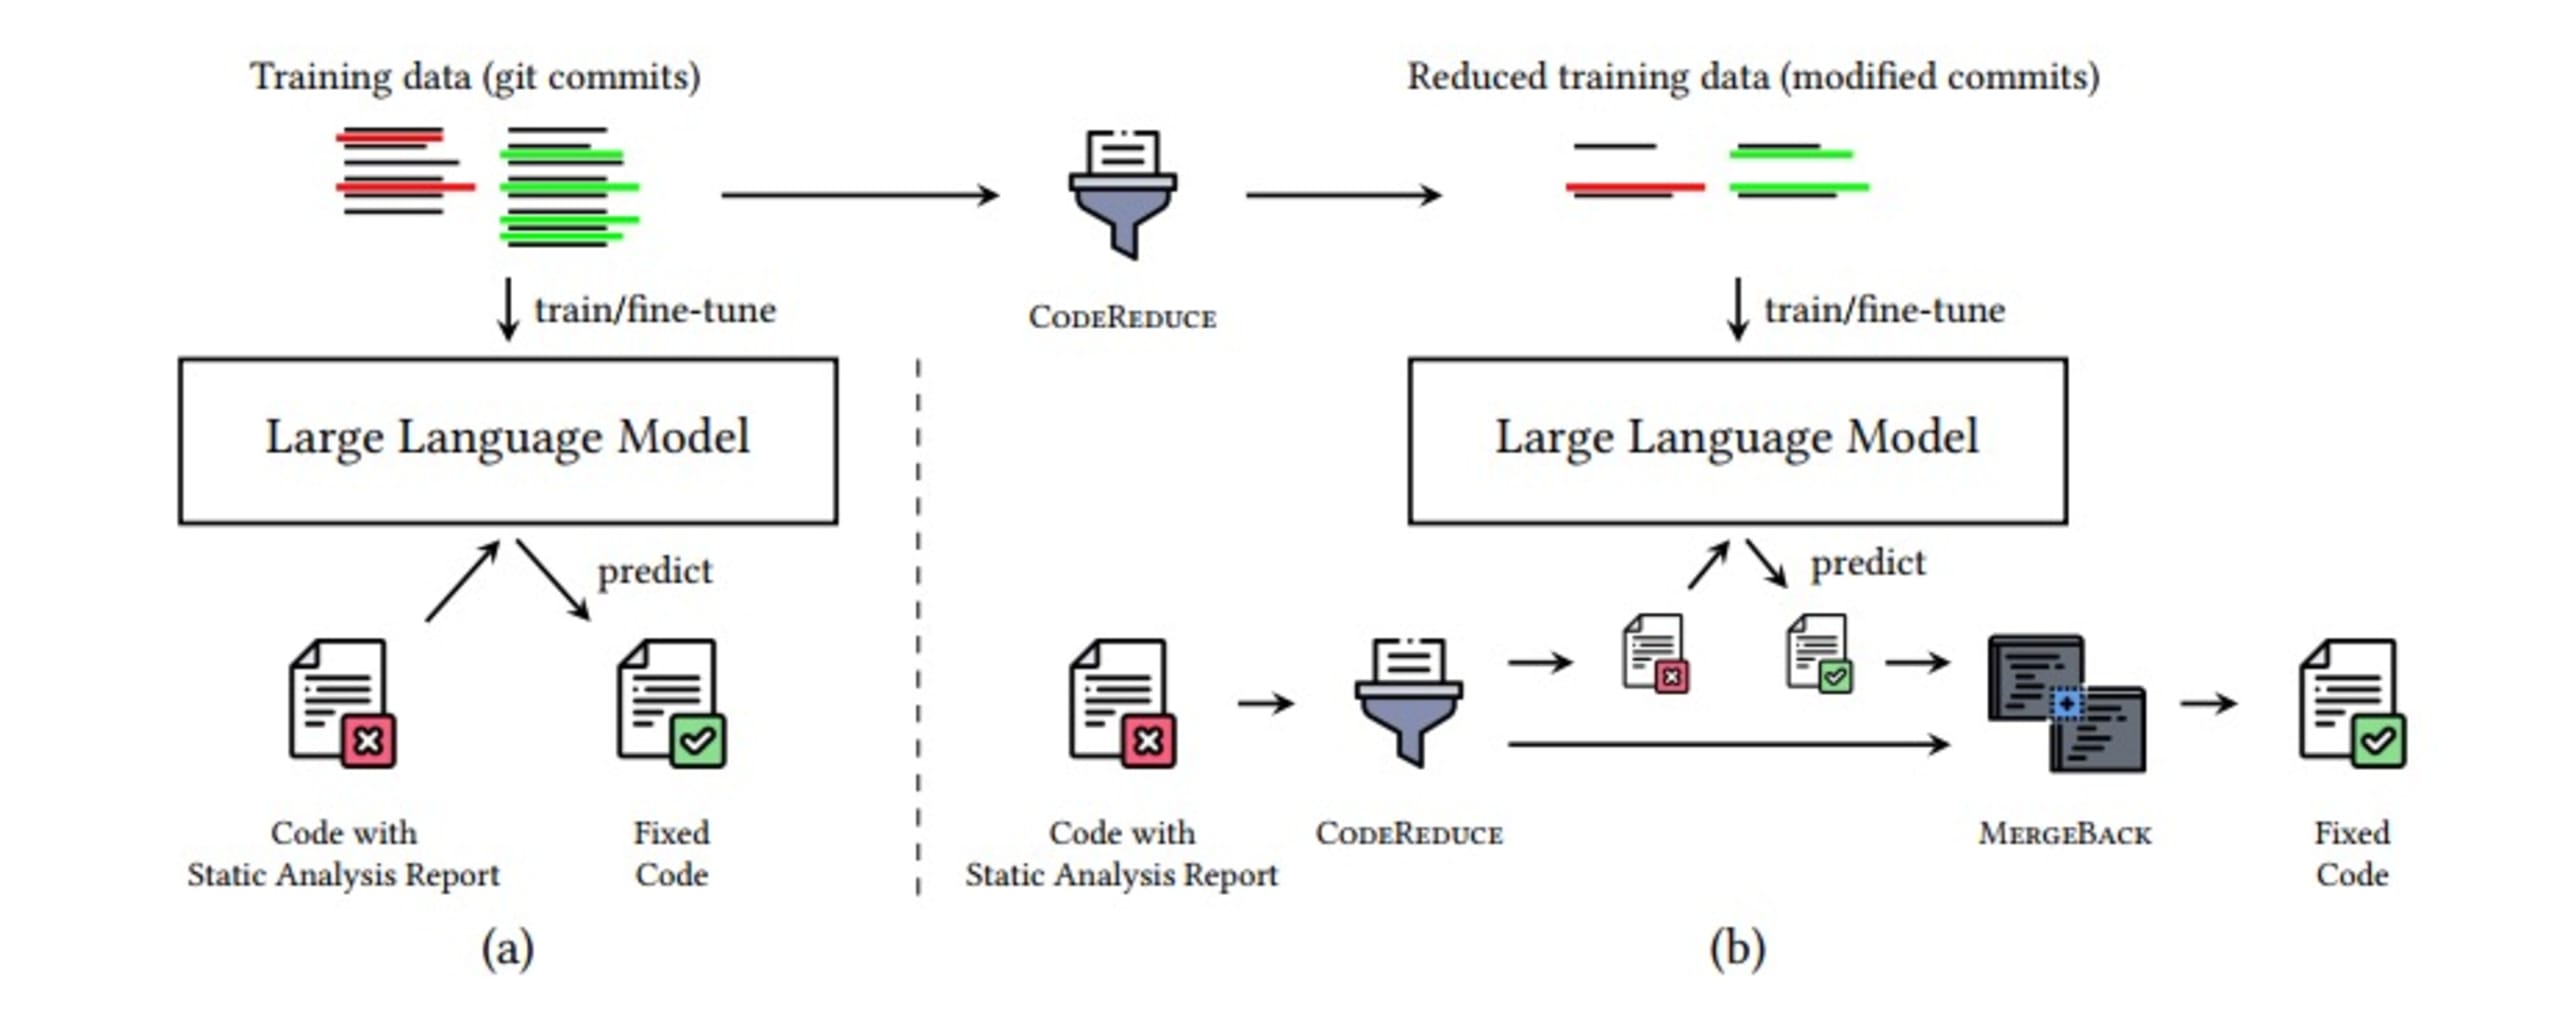
CodeReduce nutzt Programmanalyse, um den Aufmerksamkeitsmechanismus des LLM auf die Codeabschnitte zu beschränken, die für die Korrektur benötigt werden. Dazu wird der Fokus des LLM auf einen kürzeren Codeausschnitt mit dem gemeldeten Fehler und dem erforderlichen Kontext gelenkt. Dadurch muss das LLM deutlich weniger Code verarbeiten. Das verbessert die Qualität der Korrekturen bei allen getesteten KI-Modellen und reduziert Halluzinationen. Außerdem verarbeitet das Modell weniger Informationen und arbeitet dadurch schneller. So lassen sich Korrekturen in Echtzeit erstellen – präziser und relevanter, aber auch schneller.
Der CodeReduce-Prozess umfasst die folgenden Schritte:
Sicherheitsproblem identifizieren
Mit CodeReduce auf den erforderlichen Mindestumfang an Code samt Kontext reduzieren
Den mit CodeReduce reduzierten Code in den LLM-Prompt einfügen und eine Korrektur erstellen
Korrektur anwenden
Mit den Scan-Funktionen von Snyk Code erneut überprüfen, ob Snyk Agent Fix die Schwachstelle behoben und die Korrektur(en) keine neuen Schwachstellen verursacht haben
Die Korrektur mit MergeBack in den ursprünglichen Code übernehmen
Die folgende Abbildung zeigt die Pipeline zur automatischen Behebung von Sicherheitsproblemen. Dank zusätzlicher Optimierungen, die Sie im Forschungspapier zu CodeReduce nachlesen können, läuft der gesamte Prozess in Sekundenschnelle ab.
Welche Ergebnisse wurden erzielt?
Nachdem wir diese Probleme gelöst hatten, mussten wir testen, wie gut unsere automatischen Sicherheitskorrekturen funktionierten. Deshalb entwickelten wir einen Benchmark, der sich mit verschiedenen LLMs verwenden lässt.
Wir führten unsere Auswertungen anhand der Metriken „Pass@𝑘“ und „ExactMatch@𝑘“ für Modelle mit CodeReduce durch (in der folgenden Tabelle mit dem Symbol ‡ gekennzeichnet) und verglichen die Ergebnisse mit den Baselines TFix, einem fensterbasierten Modell, sowie verschiedenen Modellen mit großem Kontextfenster wie GPT-3.5 und GPT-4.
Die Variable „k“ in „Pass@k“ gibt an, wie viele der jeweils fünf erstellten Korrekturen – von mindestens einer bis hin zu allen fünf – das betreffende Sicherheitsproblem beheben, ohne neue Sicherheitsprobleme zu verursachen.
Außerdem haben wir fünf Kategorien von Sicherheitsproblemen für die Tests festgelegt:
AST: Schwachstellen, für deren Behebung ein abstrakter Syntaxbaum, aber kein spezieller Datenfluss erforderlich ist
Local: Falsche Werte, die an Methoden übergeben werden, die diese nicht akzeptieren
FileWide: Probleme mit Signaturen oder Implementierungen
SecurityLocal: API-Nutzung und Nachverfolgung von Methodenaufrufen
SecurityFlow: Komplexe Taint-Analysen, die einen komplexen Datenfluss erfordern
Zum Vergleich haben wir außerdem verschiedene LLMs ausgewählt: StarCoder, Mixtral, T5, GPT-3.5 und GPT-4. Die Ergebnisse:
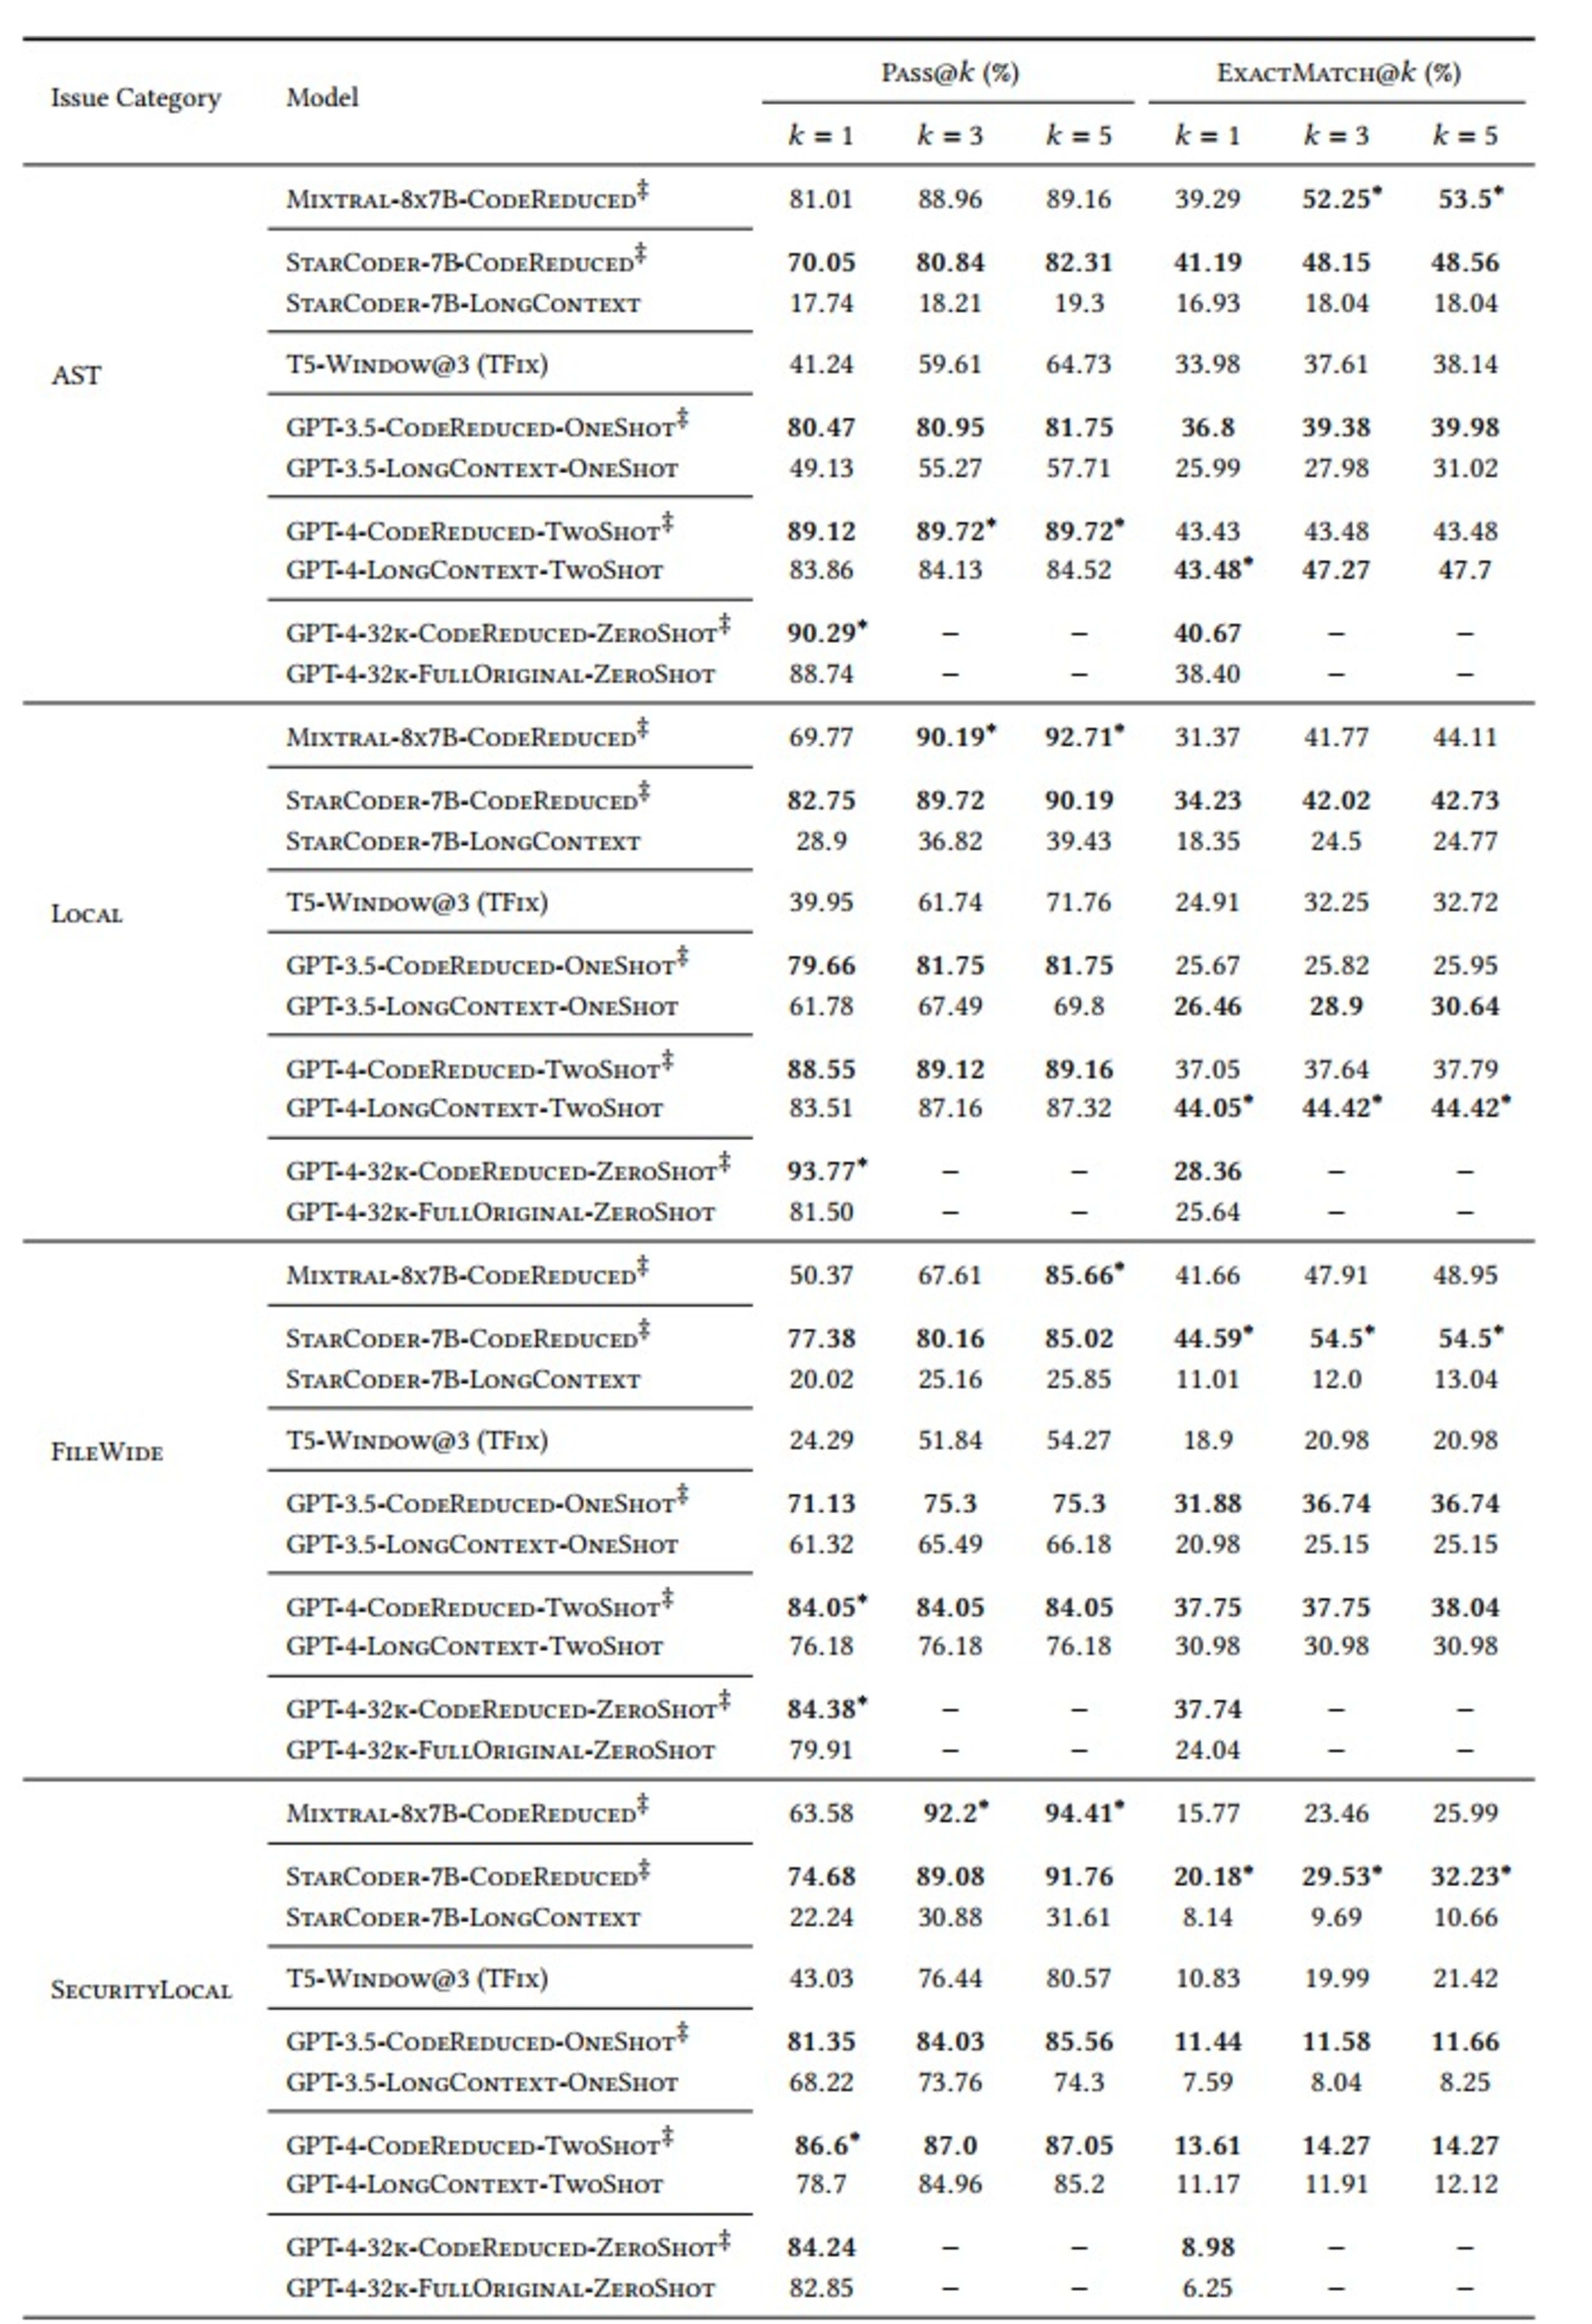
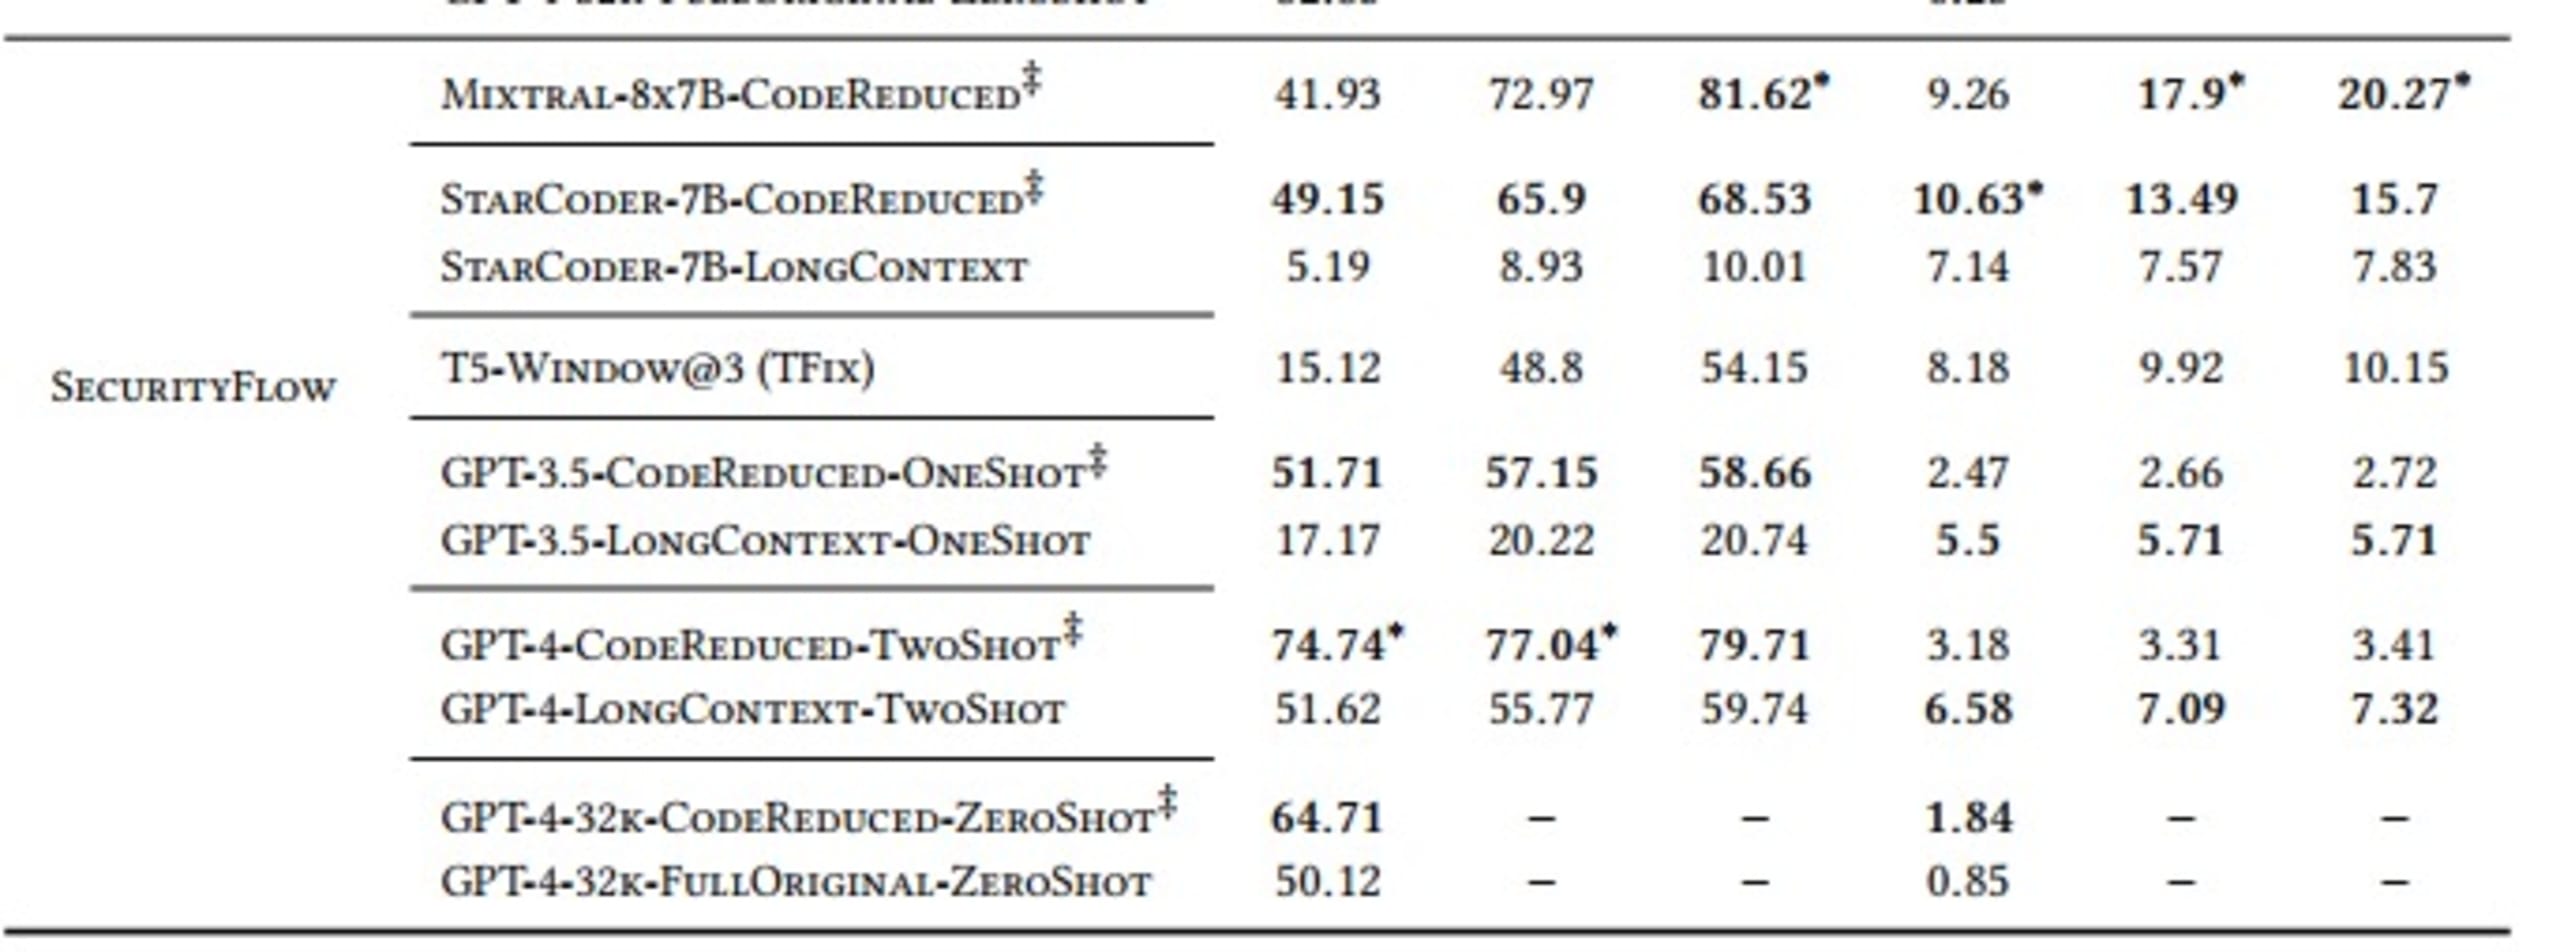
Wie die Tabelle zeigt, erzielen Modelle, die normalerweise komplexe Abhängigkeiten über größere Distanzen erlernen müssten, um eine korrekte Korrektur zu erstellen, deutlich bessere Ergebnisse, wenn sie den von CodeReduce extrahierten Codekontext nutzen, als wenn sie Korrekturen ohne CodeReduce erstellen. Ein gutes Beispiel ist die deutliche Verbesserung des Pass@5-Ergebnisses bei der Behebung von AST-Problemen mit StarCoder: Die Erfolgsquote steigt von 19,3 % (ohne CodeReduce) auf 82,31 % (mit CodeReduce).
Die wichtigsten Erkenntnisse
Insgesamt übertraf Snyk Agent Fix die bisherige Bestleistung von TFix und verbesserte die Leistung mehrerer beliebter KI-Modelle in unterschiedlichen Konfigurationen. Das liegt daran, dass Snyk Agent Fix mithilfe der proprietären CodeReduce-Technologie von Snyk Programmanalyse nutzt, um Abhängigkeiten über größere Distanzen und Datenflüsse zu berücksichtigen. Dadurch wird die Aufgabe für Snyk Agent Fix deutlich vereinfacht: Das Modell kann sich gezielter auf die relevanten Sicherheitsprobleme konzentrieren und so präzisere und relevantere Korrekturen erstellen.
Sie können die leistungsstarken Funktionen von Snyk Agent Fix jetzt direkt in Ihrer IDE ausprobieren. Registrieren Sie sich für Snyk Code und aktivieren Sie in den Snyk Preview-Einstellungen die Option „Snyk Code Fix Suggestions“. Weitere Informationen finden Sie in unserer Dokumentation. Mit Ihrem Feedback zu unseren Korrekturen in Snyk Code können Sie außerdem die Zukunft von Snyk Agent Fix mitgestalten.
Starten Sie mit Capture the Flag
Erfahren Sie in unserem virtuellen On-Demand-Workshop für Einsteiger, wie Sie Capture-the-Flag-Herausforderungen lösen.


