Frontier-Modelle fanden die Schwachstellen. Nur der Angreifer fand die Angriffsketten.



7. Oktober 2026
0 Min. LesezeitAngreifer lesen Ihr Repository nicht – sie rufen Ihre URL auf und verknüpfen alles, was sie dort finden. In einer Zeit, in der offensive KI Live-Anwendungen mit Maschinengeschwindigkeit angreift, muss Ihre Sicherheitstechnologie mehr leisten, als Schwachstellen zu finden: Sie muss ihre Ausnutzbarkeit nachweisen – einschließlich der Frage, ob sie sich zu einem Angriff kombinieren lassen.
Also haben wir einen Test durchgeführt. Wir haben Evo Continuous Offensive Security (COS) und Claude Security mit Mythos auf dieselbe Anwendung angesetzt: TaintedPort. Dabei handelt es sich um eine absichtlich verwundbare Web-App, die praxisnahe Fehlerklassen und eine Reihe registrierter Exploit-Ketten abdeckt. Es sind unterschiedliche Arten von Tools: COS greift die laufende Anwendung an, während die beiden Claude-Produkte den Quellcode lesen. Wir haben sie auf dasselbe Ziel angesetzt, um zu sehen, was die jeweiligen Ansätze nachweisen.
Evo COS bestätigte 10 von 15 Exploit-Ketten.
Das ist keine Kritik an den Modellen – wir setzen sie selbst ein
Claude Security mit Mythos ist ein echter Fortschritt bei der KI-gestützten Schwachstellensuche. Das Tool analysiert Quellcode wie ein erfahrener menschlicher Reviewer und erkennt Fehlerklassen, die musterbasierte Tools übersehen. Doch einen Fehler im Code zu finden und nachzuweisen, dass Angreifer diese Schwachstellen ausnutzen können, sind zwei unterschiedliche Aufgaben.
Der von COS nachgewiesene Angriffspfad
Jedes Tool in diesem Test fand die SSRF-Schwachstelle (Server-Side Request Forgery) und erkannte, dass das JWT-Signaturgeheimnis der Anwendung fest im Code hinterlegt war. Evo COS ging noch weiter: Es nutzte die SSRF-Schwachstelle, um das Signaturgeheimnis aus der laufenden Anwendung auszulesen, erstellte damit ein gültiges Administrator-Token und übernahm den Admin-Bereich. Zwei einzelne Funde wurden zu einem vollständigen Kontoübernahme-Angriffspfad verknüpft – mit einem ausführbaren Proof of Concept, der an der Live-App demonstriert wurde.
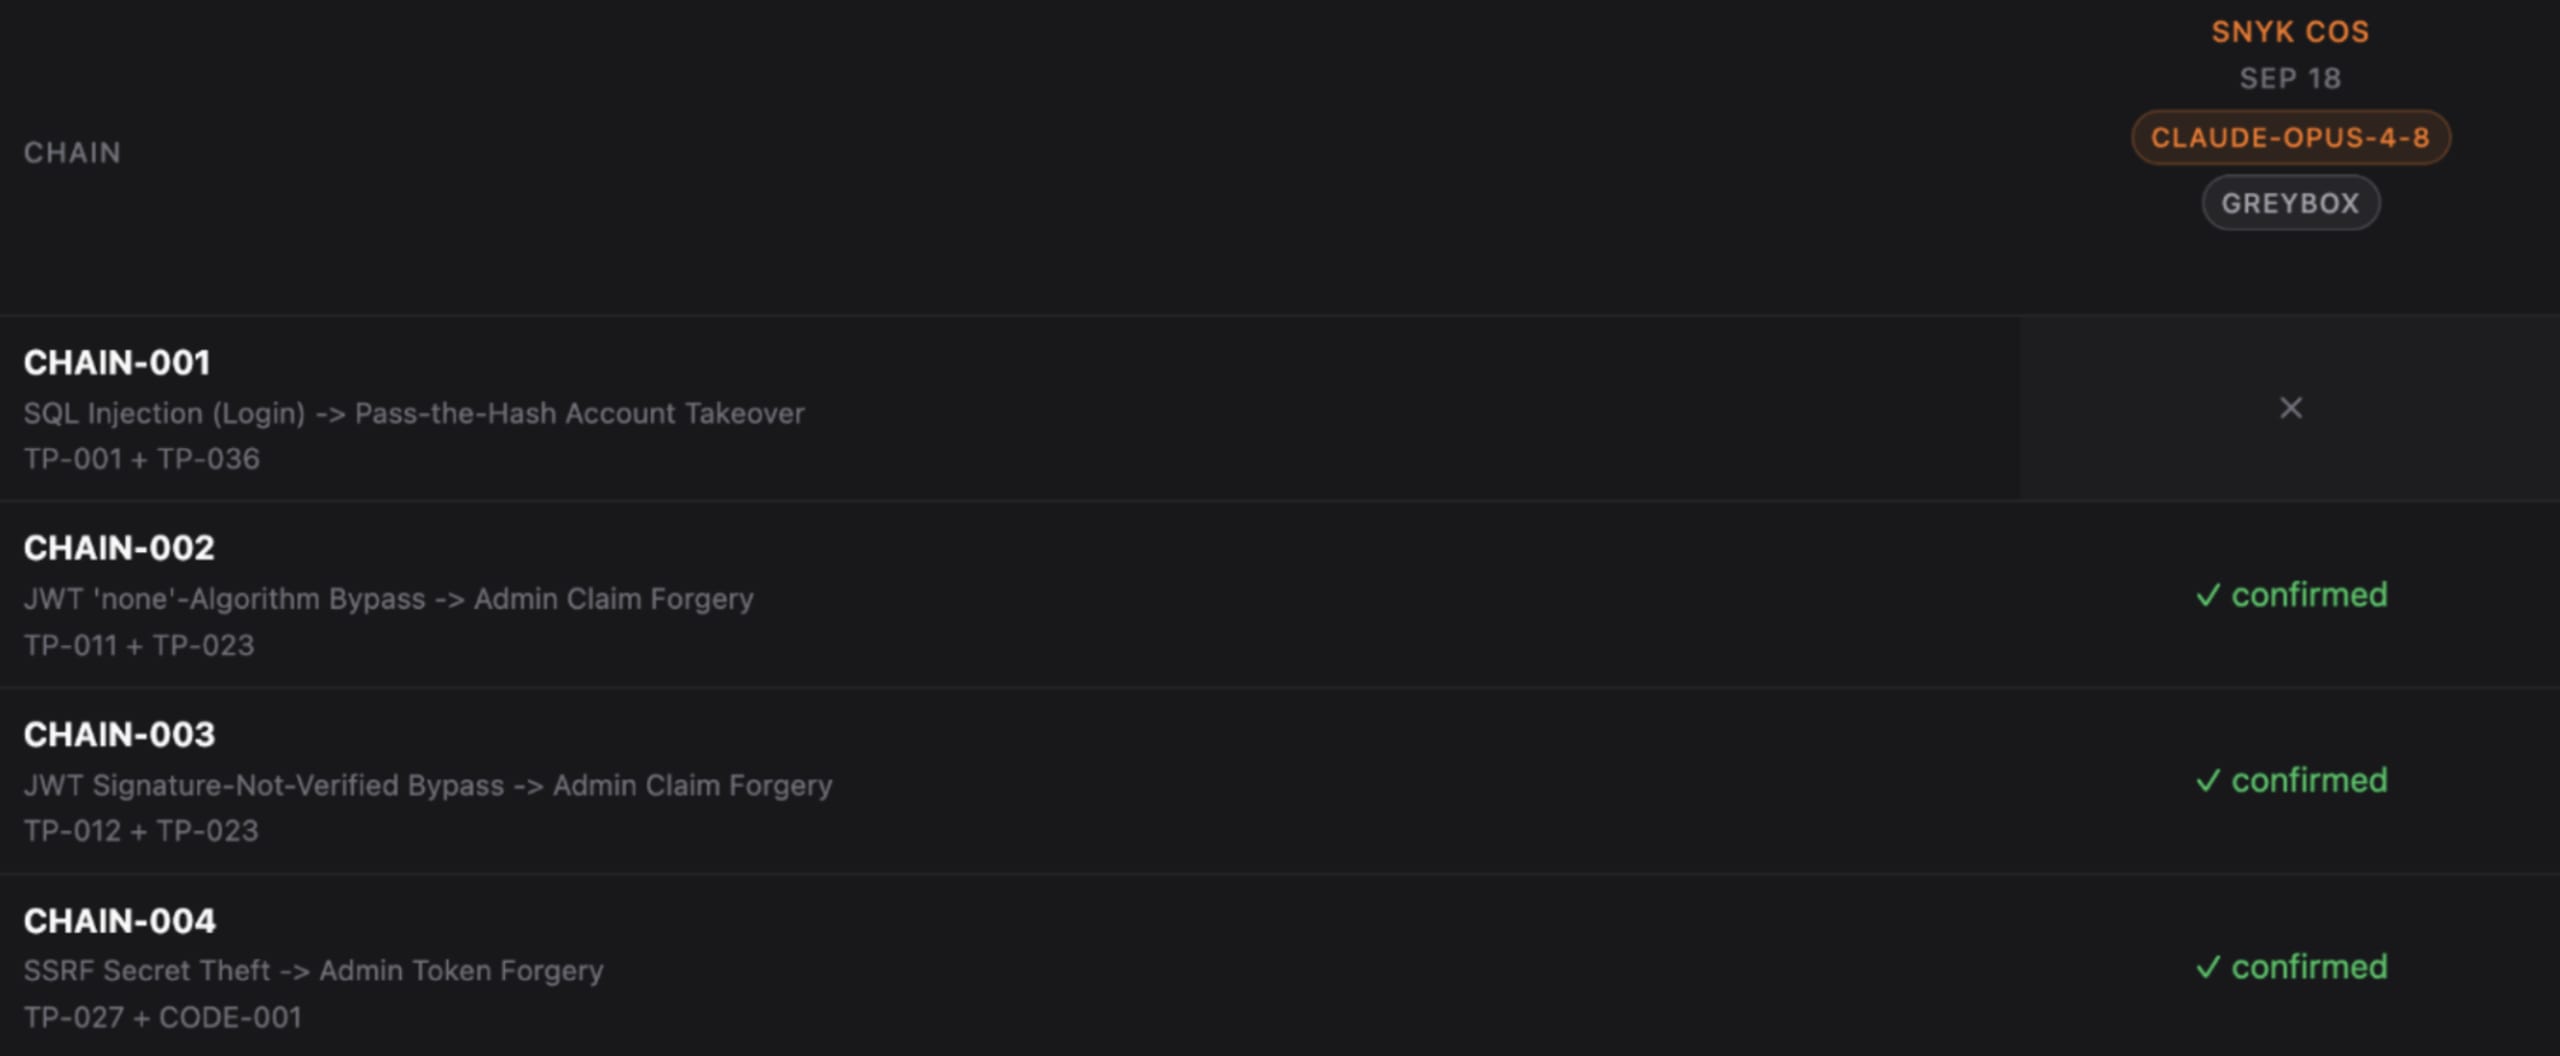
Oben: CHAIN-004 gemäß der COS-Bewertung. Die beiden Einzelfunde – die SSRF-Schwachstelle und das fest hinterlegte Geheimnis – wurden von jedem Tool in diesem Test separat gemeldet. Evo COS bestätigte, dass sie sich zu einer Fälschung von Admin-Tokens kombinieren lassen.
So sieht ein autonomer Angriff in der Praxis aus: erst Fuß fassen, dann von dort aus weitere Schritte verknüpfen. Evo COS zeigt Ihnen den Angriffspfad und fügt für jede bestätigte Kette einen ausführbaren Proof of Concept hinzu.
Die Ergebnisse
TaintedPort v1.35, bewertet anhand eines festgelegten Lösungsschlüssels mit 57 bekannten Schwachstellen und 15 bekannten Exploit-Ketten, auf einer nach Schweregrad gewichteten Skala (Niedrig 1, Mittel 3, Hoch 9, Kritisch 27; jede bestätigte Kette wurde zusätzlich zu ihren Einzelfunden entsprechend ihrem eigenen Schweregrad bewertet). Die gewichtete Erkennungsrate entspricht den gefundenen Punkten ÷ 938 verfügbaren Punkten: 587 für die 57 Schwachstellen und 351 für die 15 Ketten.
Evo COS | Claude Security (Mythos) | |
|---|---|---|
Nach Schweregrad gewichtete Erkennungsrate | 75,7 % | 49,6 % |
Bestätigte Exploit-Ketten (von 15) | 10 | X |
Gefundene Schwachstellen (von 57) | 50 | 37 |
F1 | 91,7 % | 75,5 % |
Claude Security fand eine weitere Schwachstelle mit kritischem Schweregrad (10 statt 9). Evo COS fand die meisten Schwachstellen, erzielte die höchste Präzision (96,2 % gegenüber 90,2 %) bei weniger False Positives und konnte Exploit-Ketten identifizieren und nachweisen.
Warum die bereitgestellte Anwendung angreifen?
Evo COS ist ein dynamisches System: Das Ziel ist immer eine Live-URL. Optional kann Quellcode eingegeben werden, um einen Lauf von einer Black-Box- zu einer Gray-Box-Analyse zu erweitern. Evo COS läuft niemals ausschließlich auf Code. Claude Security wurde als White-Box-Analyse ausgeführt (nur Code).
Damit ist dies ein Vergleich über verschiedene Disziplinen hinweg: Evo COS führt einen offensiven Penetrationstest durch, bei dem die laufende Anwendung untersucht und angegriffen wird – ein grundlegend aufwendigerer Prozess als ein einzelner Durchgang beim Lesen des Codes. Es ist dieselbe sich ergänzende Aufgabenteilung, die es in der Branche schon immer zwischen DAST und SAST gab. Hier zeigen wir, was Tests der Live-Anwendung nachweisen können – und was sich durch das reine Lesen des Codes nicht belegen lässt: dass diese Schwachstellen tatsächlich bestehen und sich zu Angriffsketten verknüpfen lassen.
Bei den ausschließlich von Evo COS gemeldeten Funden handelt es sich überwiegend um Laufzeitverhalten: reflektierte und falsch konfigurierte Antworten, fehlende Transportschutzmaßnahmen, nach der Abmeldung weiterhin gültige Tokens und eine unzureichende Sitzungsverwaltung. Evo COS konnte mehrere kontextabhängige Fehler in der Geschäftslogik bestätigen: Broken Object-Level Authorization bei Profiländerungen, eine Rechteausweitung über gefälschte JWT-Claims und eine kritische Schwachstelle, bei der das einmalige Auslesen eines gespeicherten TOTP-Geheimnisses die Zwei-Faktor-Authentifizierung unwirksam macht. Um die Ketten nachzuweisen, muss jeder Schritt über die laufende App erreicht und bestätigt werden, dass der nächste tatsächlich zugänglich ist. Ein Modell, das den Quellcode analysiert, muss erst darauf schließen, dass eine Schwachstelle ausführbar ist – und übersieht die Kette.
Sie können einen Testaufbau erstellen, aber nicht den Kontext
Die Benchmarking-Debatte dieses Jahres hat einen wichtigen Punkt auf den Tisch gebracht: Das System rund um ein Modell ist wichtiger als das Modell selbst. Wir gehen noch weiter: Die Frage „Welcher Testaufbau?“ ist nicht neutral – und genau in der Antwort liegt der eigentliche Vorteil.
Evo COS orchestriert mehrere Modelle, darunter Claude-Frontier-Modelle, und weist jedem die Aufgabe zu, für die es am besten geeignet ist. Bei diesem Ergebnis geht es also nicht um die Modellqualität. Dieselbe Modellklasse, die eine fortschrittliche Codeprüfung ermöglicht, steckt auch in Evo COS. Der Unterschied liegt im System darum herum: Evo COS stützt sich auf das Wissen, das die Snyk-Plattform bereits über das Ziel hat, statt ohne Kontext zu analysieren. Es besteht aus einer Gruppe von Agents, die jeweils für einen bestimmten Zweck orchestriert werden. Jeder Fund durchläuft eine unabhängige Validierung, bevor er angezeigt wird – denn das System, das einen Fund erzeugt, sollte ihn nicht selbst bewerten.
Jeder kann noch heute Abend ein Frontier-Modell mit einem Coding-Agent verbinden und auf ein Repository ansetzen. Was sich damit nicht nachbilden lässt, sind der gesammelte, validierte Kontext, mit dem Evo COS startet, der unabhängige Validator und die Prüfung der Live-Anwendung.
Dynamische und statische Tests ergänzen sich
Claude Security erkannte mehrere Schwachstellen, die Evo COS nicht fand – vor allem logische und kryptografische Fehler, die im Quellcode sichtbar sind, aber nicht immer in der laufenden App zutage treten. Keiner der beiden Ansätze ist für sich allein vollständig. Genau deshalb braucht es eine Plattform statt eines Einzellösungs-Tools. Beim Lesen des Codes und beim Angriff auf die laufende App findet jeder Ansatz Dinge, die dem anderen entgehen.
Methodik
TaintedPort ist Snyks eigene absichtlich verwundbare Anwendung. Sie wurde von unserem Team entwickelt, wird von ihm gepflegt und ist öffentlich zugänglich. Evo COS wurde nicht speziell darauf abgestimmt.
Ziel: TaintedPort: 57 bekannte Schwachstellen (34 allgemeine, 23 Schwachstellen in der Geschäftslogik) und 15 bekannte Exploit-Ketten.
Tools und Eingaben:
Evo COS: Gray-Box (Live-URL + Quellcode), 18. Sept.
Claude Security: White-Box (Quellcode), Mythos mit erweitertem Denkmodus, 18. Sept.
Durchläufe: ein Durchlauf pro Tool. Die Ergebnisse sind die Ausgaben dieses einzelnen Durchlaufs, keine Medianwerte.
Erkennung nach Kategorie
Kategorie | Bekannt | Evo COS | Claude Security (Mythos) |
Allgemein | 34 | 33 | 21 |
Geschäftslogik | 23 | 17 | 16 |
Exploit-Ketten | 15 | 10 | X |
Erkennung nach Schweregrad (gefunden/bekannt)
Schweregrad | Bekannt | Evo COS | Claude Security (Mythos) |
Kritisch | 11 | 9 | 10 |
Hoch | 26 | 22 | 19 |
Mittel | 18 | 17 | 8 |
Niedrig | 2 | 2 | 0 |
False Positives und F1
Metrik | Evo COS | Claude Security (Mythos) |
False Positives | 2 | 4 |
F1-Score | 91,7 % | 75,5 % |
Nachstellen: TaintedPort finden Sie unter taintedport.com.
Möchten Sie wissen, welche Funde sich in Ihren eigenen Anwendungen zu einem Angriff verknüpfen lassen? Erfahren Sie, wie Evo Continuous Offensive Security Ihre Live-URL testet.
LIVE-DEMO BUCHEN
KI-Einsatz sicher skalieren
Evo unterstützt Unternehmen dabei, KI sicher einzuführen und zu skalieren – mit Transparenz, Governance und Sicherheit für KI-gestützte Entwicklung und KI-Anwendungen.