Snyk-Schwachstellen ganz einfach Cortex-Services zuordnen

Cristina Buenahora Bustamante

14. Juni 2021
0 Min. LesezeitSnyk ist eine cloudnative Sicherheitsplattform, bei der Entwicklerinnen und Entwickler im Mittelpunkt stehen. Sie scannt Code, Abhängigkeiten, Container und Infrastructure as Code auf Schwachstellen. Snyk findet Schwachstellen in Ihrer Codebasis zuverlässig. Doch diese konkreten Services und ihren Verantwortlichen zuzuordnen, kann eine Herausforderung sein. Glücklicherweise lässt sich die leistungsstarke API von Snyk nutzen, um Snyk in Lösungen zu integrieren, die Engineering-Teams dabei unterstützen, ihre serviceorientierte Architektur zu verstehen und zu verbessern.
Cortex ist ein solches Tool. Es katalogisiert interne Services samt ihren Abhängigkeiten automatisch und lässt sich außerdem in Tools von Drittanbietern wie Snyk integrieren. So bietet es einen zentralen Überblick über Ihre Architektur. Mit Cortex und Snyk erhalten Unternehmen nicht nur einen vollständigen Überblick über ihre Microservice-Architektur, sondern erfahren auch, welche Sicherheitslücken sie aufweist.
Cortex erweitert die Snyk-Plattform durch folgende Funktionen:
Automatische Zuordnung von Schwachstellen zu vorhandenen Microservices
Snyk-Schwachstellen werden in der Service-Zeitleiste zusammengeführt und lassen sich so im Kontext anderer wichtiger Service-Metriken wie On-Call-Vorfällen betrachten.
Servicequalität anhand der Snyk-Daten und weiterer Integrationen mit Scorecards messen und verbessern
Schwachstellen einem Service zuordnen
Wie funktioniert das?
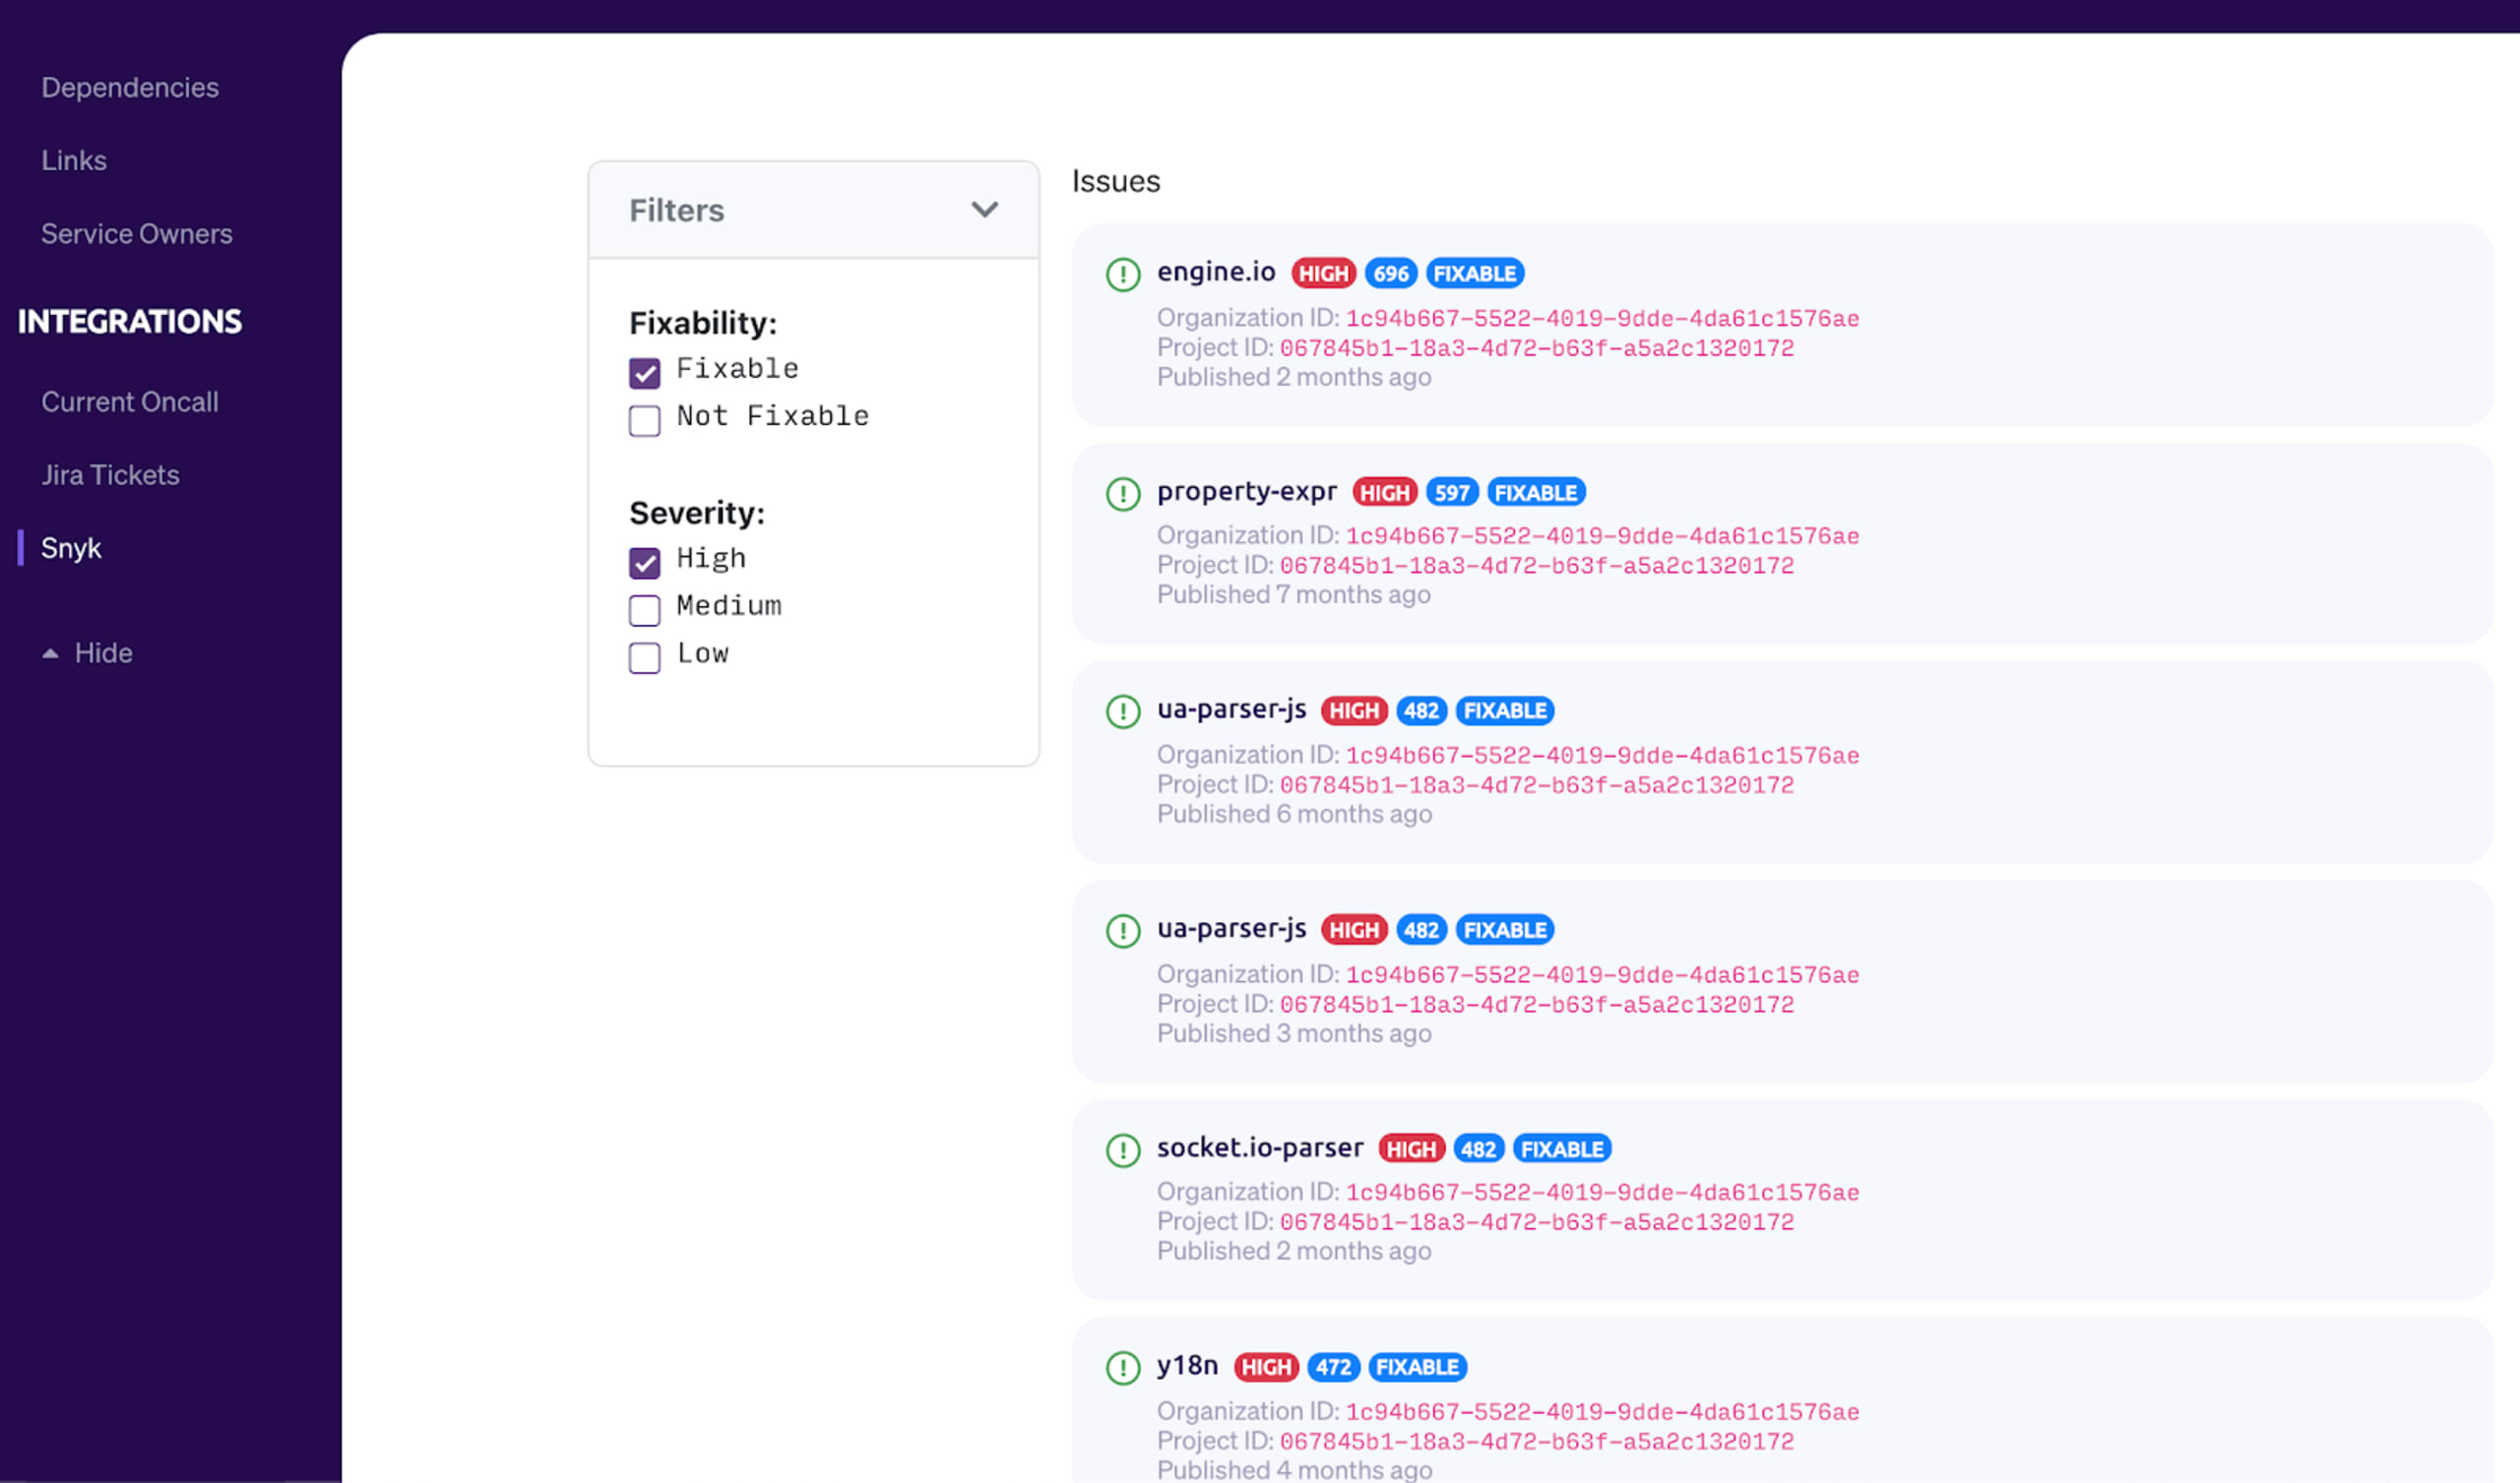
Nachdem Sie Snyk in Cortex eingerichtet haben, rufen wir über die Reporting-API von Snyk die neuesten Probleme für den Service ab. Diese werden anschließend im Snyk-Tab des Services angezeigt, wo Sie auch weitere Service-Informationen einsehen können. Mithilfe zusätzlicher Filter finden Sie schnell, wonach Sie suchen.
Warum ist das wichtig?
Engineering-Teams können schnell die Snyk-Probleme eines Services einsehen und kritische Probleme bei der Behebung priorisieren.
Snyk in der Service-Zeitleiste
Neben den Snyk-Problemen eines Services sehen Sie dort auch andere Service-Ereignisse wie Kubernetes-Änderungen, Git-Commits, Deployments und On-Call-Vorfälle – alles in einer einzigen Service-Zeitleiste. Das ist besonders bei einem Vorfall hilfreich, wenn Sie schnell die Ursache des Problems finden müssen.

Scorecard-Integration
Mit den Snyk-Daten für jeden Service können Sie jetzt Scorecards erstellen. Damit legen Sie Best Practices für eine Gruppe von Services fest und bewerten, ob Ihre Services diese Regeln erfüllen. Dank der Snyk-Integration können Sie Folgendes überprüfen:
Ob für einen Service Snyk-Projekte vorhanden sind (automatische Erkennung anhand des Repository-Namens wird versucht)
Die Anzahl aller Probleme (nicht ignoriert und nicht behoben)
Die Anzahl aller Probleme, optional gefiltert nach Schweregrad und danach, ob sie behoben werden können

Sie können diese Regeln mit weiteren kombinieren, um die Betriebsbereitschaft eines Services zu messen. Eine entsprechende Scorecard zeigt Ihnen, wann ein Service für den Produktivbetrieb bereit ist. Sie können prüfen, ob Runbooks, Dashboards, Logs, Eskalationsrichtlinien für den On-Call-Dienst und verantwortliche Owner vorhanden sind und ob es Schwachstellen gibt:
owners.count > 2– Für den Service sind Owner definiert. Im Falle eines Vorfalls ist somit klar, welches Team die Verantwortung trägt.oncall escalations count > 1– Die Eskalationsrichtlinie umfasst mindestens zwei Ebenen. Reagiert die erste On-Call-Person nicht, gibt es eine Vertretung.runbooks count >= 1– Für den Service sind Runbooks vorhanden. Das fördert eine Kultur der Vorbereitung.number of links (type = logs) > 1– Im Falle eines Vorfalls finden die zuständigen Personen schnell die richtigen Logs (in der Regel Load-Balancer- und Anwendungs-Logs).dashboards count >= 1– Für den Service ist ein Standard-Grafana-Dashboard definiert.Compare custom data to boolean: "pre-prod-enabled" = true– Prüfen Sie asynchron, ob es eine aktive Pre-Prod-Umgebung für den Service gibt, und übermitteln Sie Cortex über die API für benutzerdefinierte Metadaten einen Wahr/Falsch-Wert.Snyk issues with HIGH severity = 0– Stellen Sie sicher, dass keine Produktionsservices mit Sicherheitslücken bereitgestellt werden.
Wenn Sie eine solche Scorecard eingerichtet haben, sehen Sie eine nach Rang sortierte Liste der Services, die anhand dieser Regeln bewertet werden.
Jetzt loslegen
Der Einstieg ist einfach: Fügen Sie einfach Ihre Organisations-ID und Ihren API-Schlüssel auf Ihrer Einstellungsseite hinzu. Anschließend ordnen wir im Servicekatalog die Services direkt dem Snyk-Projekt zu, das mit dem Repository verknüpft ist.
Danach können Sie zu Ihren Scorecards wechseln und einige der oben genannten Regeln hinzufügen. Nun bewerten Sie die Qualität Ihrer Services anhand der in Ihrer Codebasis gefundenen Schwachstellen. Wenn Sie Fragen haben oder Hilfe bei der Einrichtung dieser Integration benötigen, schreiben Sie bitte an team@getcortexapp.com.
Cristina Buenahora Bustamante ist Founding Engineer bei Cortex
Von Entwicklern geschätzt. Von der Security vertraut.
Die Developer-first-Tools von Snyk bieten integrierte und automatisierte Security, die Ihren Governance- und Compliance-Anforderungen gerecht wird.


