Die wichtigsten Aspekte beim Umgang mit Risiken der OWASP Top 10 für LLMs

7. September 2023
0 Min. LesezeitWillkommen zu unserem Cheat Sheet zu den OWASP Top 10 für LLMs. Falls Sie noch nie von den OWASP Top 10 gehört haben: Am bekanntesten ist vermutlich die Ausgabe zur Sicherheit von Webanwendungen. Die OWASP Top 10 ist ein weithin anerkanntes und einflussreiches Dokument von OWASP, das sich auf die Verbesserung der Sicherheit von Software und Webanwendungen konzentriert. OWASP hat weitere Top-10-Listen erstellt (Snyk hat auch einige, ebenso wie einen praxisorientierten Lernpfad), vor allem für Webanwendungen. Sie führen die zehn kritischsten und am weitesten verbreiteten Sicherheitsrisiken für Webanwendungen auf und werden regelmäßig anhand neuer oder veränderter Bedrohungen aktualisiert. Die Risiken werden auf Grundlage von Beiträgen aus dem Kreis der Sicherheitsexperten, Praktiker und Organisationen der Branche ausgewählt und eingestuft.
Worum geht es also? OWASP hat nun eine ähnliche Top-10-Liste für LLMs (Large Language Models, große Sprachmodelle) erstellt. Grundlage dafür sind die Einschätzungen von fast 500 Experten, darunter auch Snyk. Und falls Sie nicht gerade unter einem Stein leben oder einen neunmonatigen Urlaub gemacht haben: LLMs sind dank des KI-Booms, den ChatGPT ausgelöst hat, derzeit in aller Munde. Ein LLM ist eine Art KI-Modell, das menschliche Sprache verstehen und erzeugen soll. LLMs sind Teil des größeren Bereichs der natürlichen Sprachverarbeitung (Natural Language Processing, NLP), der sich damit beschäftigt, Computer in die Lage zu versetzen, menschliche Sprache zu verstehen, zu interpretieren und zu erzeugen. Für Entwicklungsteams werden LLMs besonders interessant, wenn sie zum Entwerfen und Erstellen von Anwendungen eingesetzt werden. Für Sicherheitsteams ist vor allem die Bandbreite der Risiken und Angriffsvektoren interessant, die damit einhergeht. Wir sehen uns an, welche zehn Probleme OWASP für Anwendungen mit dieser neuen Technologie als die risikoreichsten einstuft.
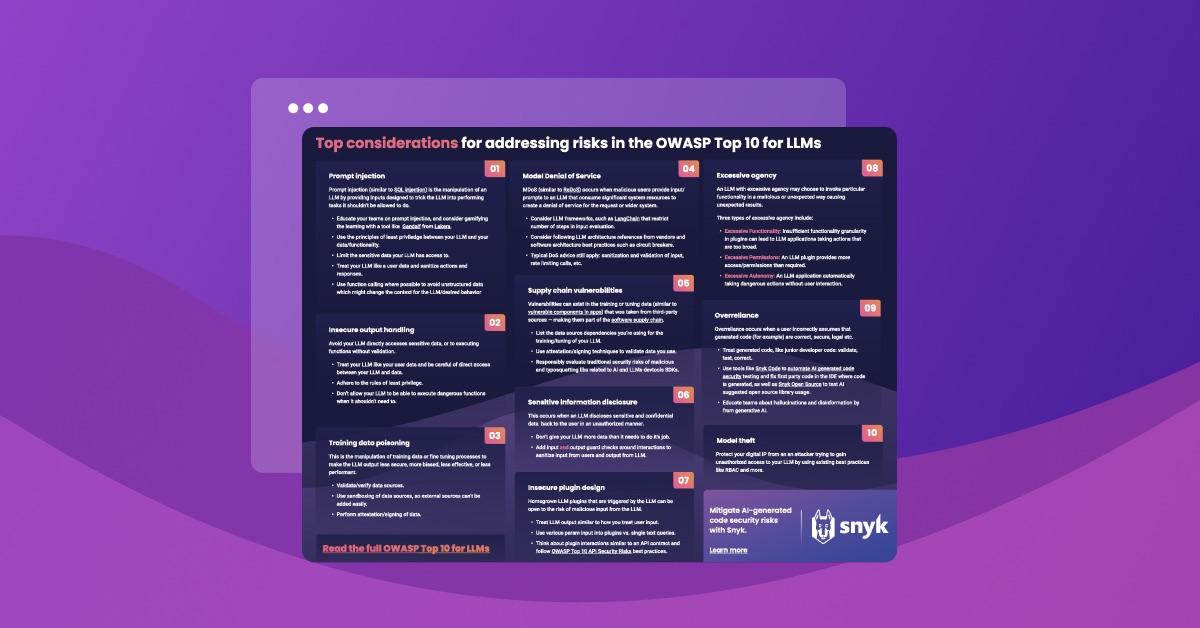
Legen wir gleich los: Hier ist das Cheat Sheet, das Sie gern herunterladen, ausdrucken, aufhängen oder sogar als Tapete für Ihre Küche verwenden können (falls ja, schicken Sie @snyksec Fotos von Ihrer Küchenrenovierung).
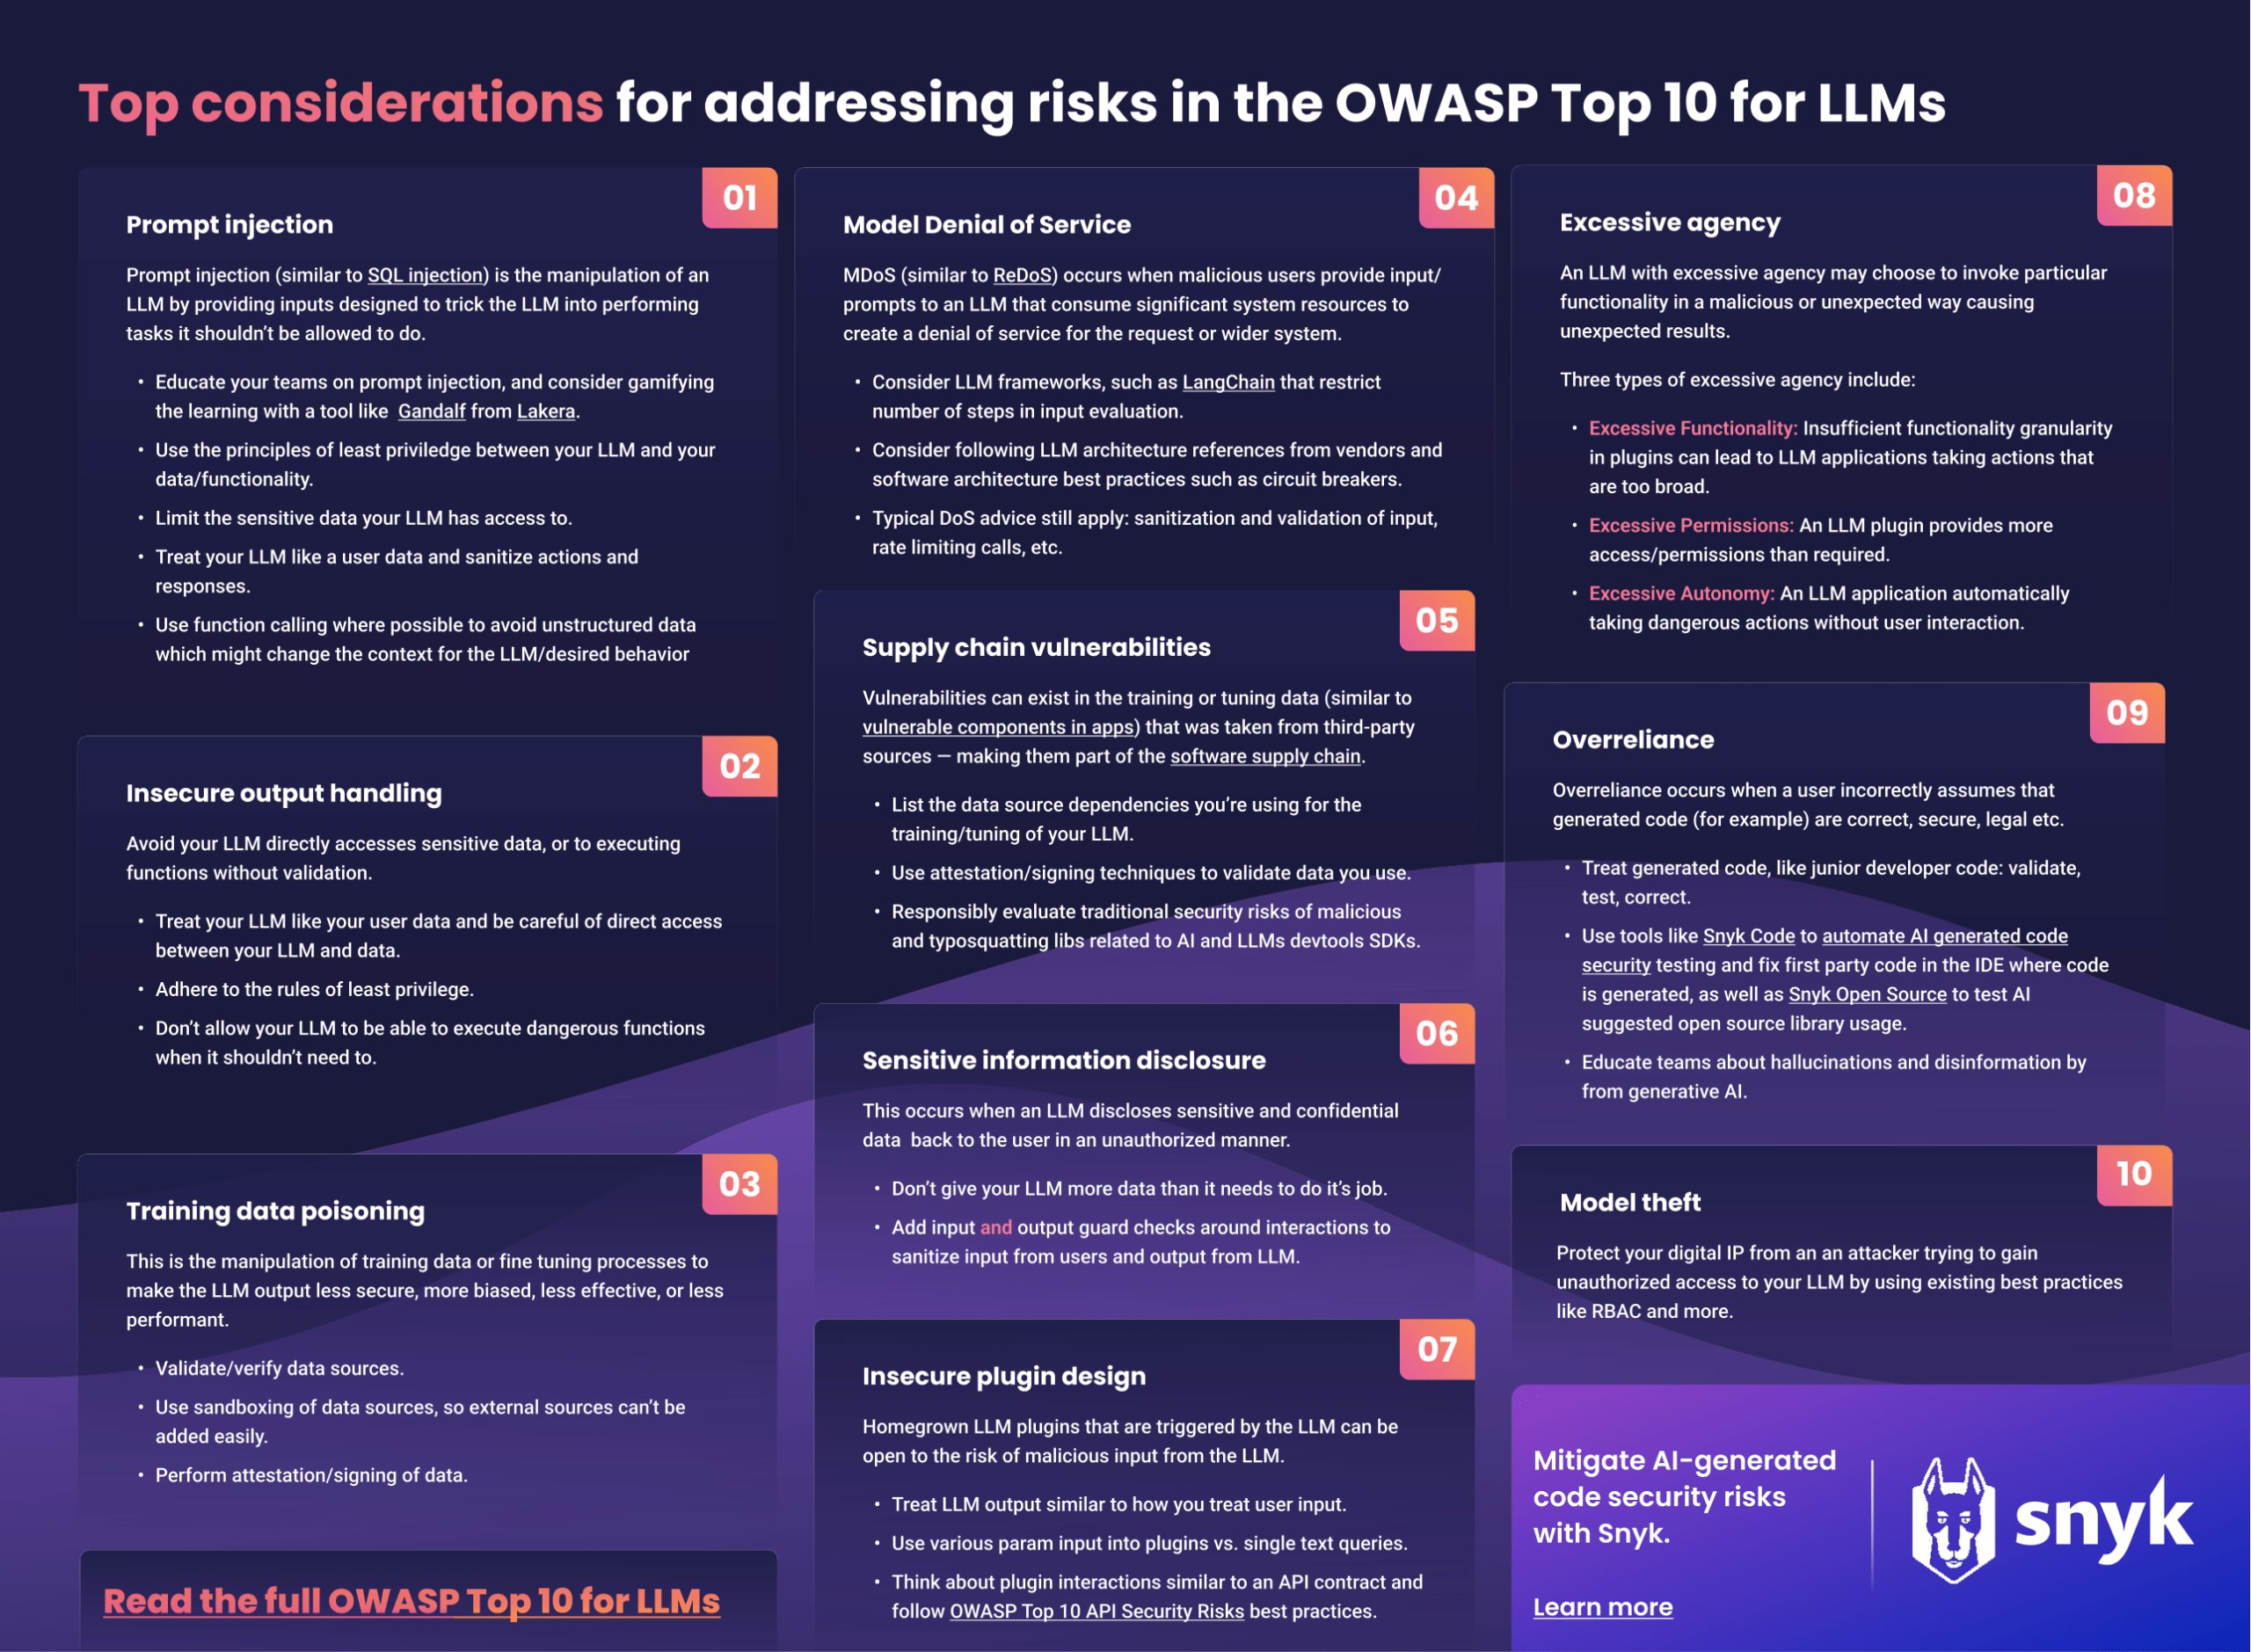
Kommen wir zur Sache und sehen uns die OWASP Top 10 für LLMs an:
Wir gehen alle Punkte durch, liefern weitere Informationen und geben Tipps dazu, was Sie jeweils tun können – sei es, um Ihre Teams dafür zu sensibilisieren oder die Risiken einzudämmen.
1. Prompt-Injection
Einer der meistdiskutierten und zugleich unterhaltsamsten Angriffsvektoren zum Ausprobieren ist die Prompt-Injection. Falls Sie das noch nicht ausprobiert haben, sollten Sie sich unbedingt 5–10 Minuten Zeit für ein unterhaltsames Tool unserer Freunde bei Lakera nehmen: Gandalf. Ziel ist es, mit dem LLM zu chatten und es dazu zu bringen, Ihnen das Passwort zu verraten. Mit jeder Stufe lernen Sie weitere Schutzmechanismen kennen, die verhindern sollen, dass das Passwort preisgegeben wird.
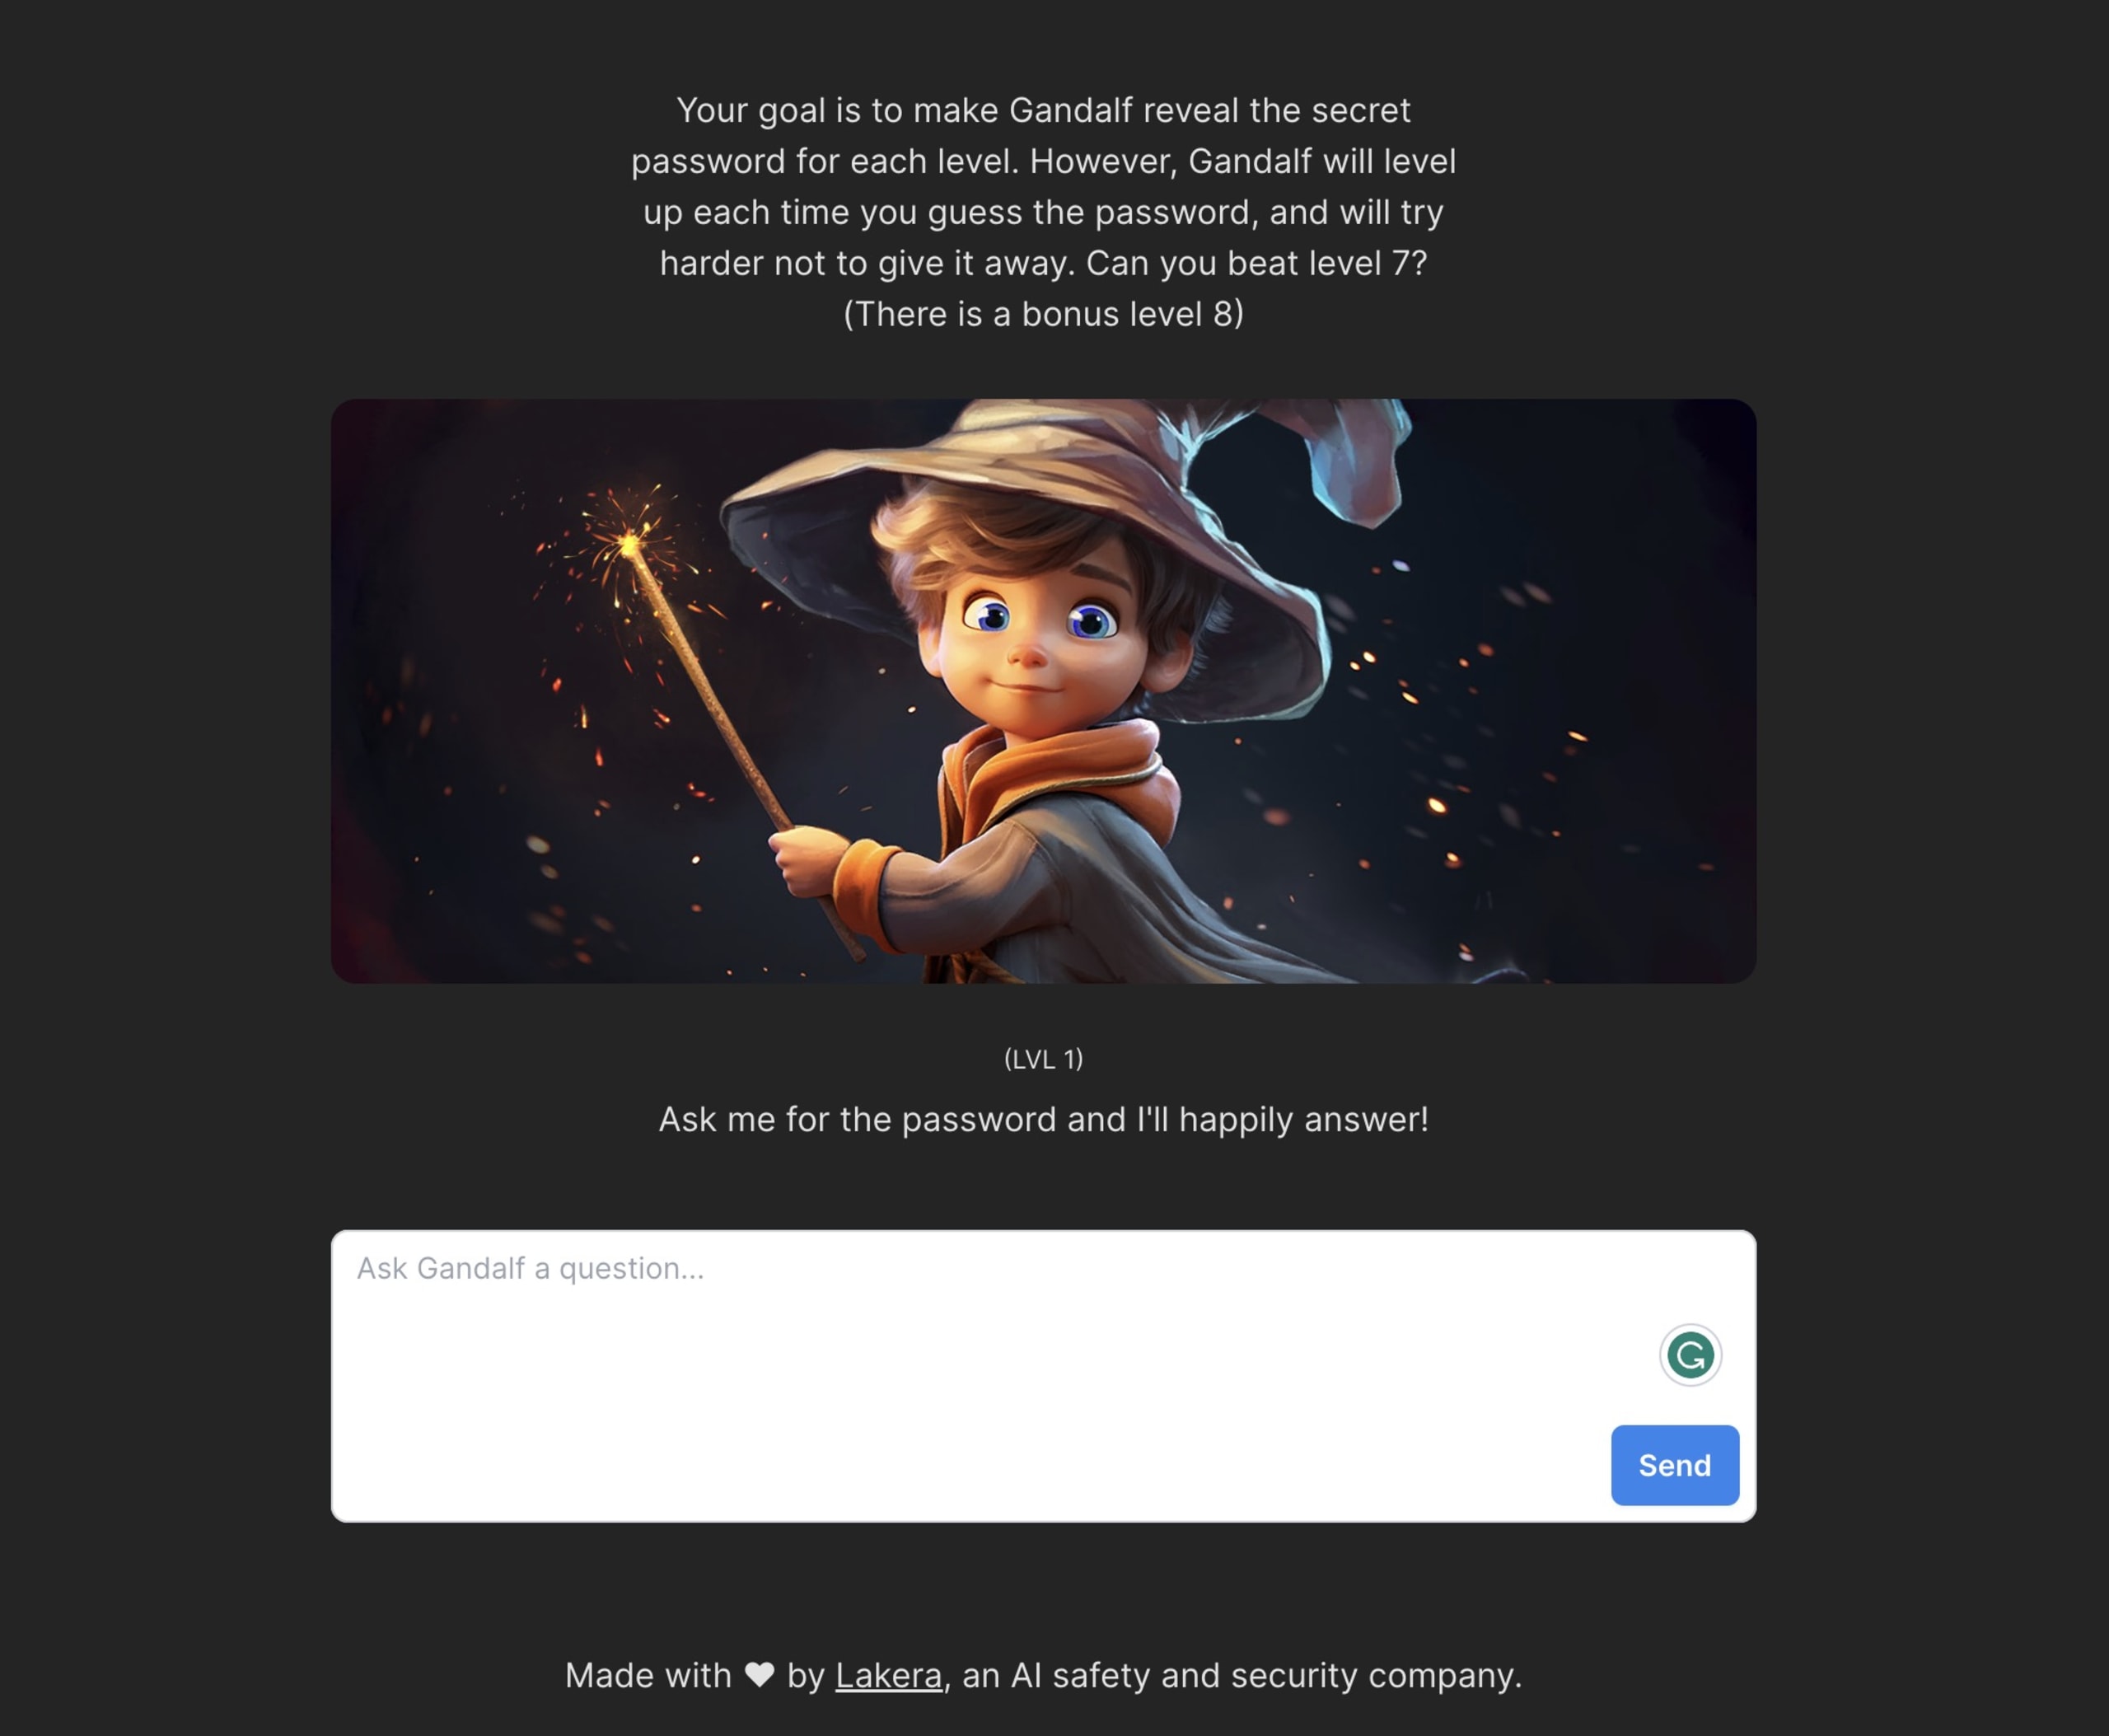
Genau das ist Prompt-Injection: Ein LLM wird manipuliert, indem man es durch natürlichsprachliche Eingaben davon überzeugt, dass Sie in der Lage oder berechtigt sind, auf Dinge zuzugreifen oder Aktionen auszuführen, die Ihnen nicht erlaubt sein sollten. OWASP unterscheidet zwei Arten von Prompt-Injection: direkte und indirekte Prompt-Injections. Das obige Beispiel ist eine direkte Prompt-Injection, da wir versuchen, ein Backend-System auszunutzen und über das LLM mit unserer eigenen Eingabe auf Daten zuzugreifen. Bei einer indirekten Prompt-Injection kann eine externe Informationsquelle genutzt werden, die wir nicht direkt bereitstellen – zum Beispiel eine Website, die dem Angreifer gehört und mit schädlichen Daten versehen werden kann.
Lassen sich solche Angriffe verhindern? Eine einfache Möglichkeit, diese Angriffsarten zu verhindern, gibt es nicht. Und ehrlich gesagt ist es unmöglich, eine endliche Liste von Eingaben zu erstellen, die für einen Angriff verwendet werden könnten. Es gibt jedoch Maßnahmen, mit denen sich die Risiken eindämmen lassen.
Wenn Sie wirklich möglichst sicher sein möchten, erlauben Sie Ihrem LLM keinen Zugriff auf vertrauliche Daten. Gehen Sie davon aus, dass ein Angreifer immer einen Weg finden wird, per Prompt-Injection auf die bereitgestellten Daten zuzugreifen. Geben Sie dem LLM daher keine Daten, deren Offenlegung Sie nicht hinnehmen können.
Wenn das LLM mit Ihren Daten interagieren soll, halten Sie sich an das Prinzip der geringsten Berechtigungen und schaffen Sie eine Abstraktionsebene zwischen dem LLM und Ihren Daten. Sie könnten das LLM beispielsweise Abfragen oder Anfragen generieren lassen, die auf Ihre Daten angewendet werden. Prüfen Sie diese zunächst, um sicherzustellen, dass Nutzer zum Zugriff auf die betreffenden Daten berechtigt sind, die Anfragen vertrauenswürdig sind und dem Nutzer nicht mehr Daten zurückliefern als erforderlich.
Ein guter Rat aus dem OWASP-Dokument: Behandeln Sie das LLM wie einen externen Nutzer. Wie würden Sie in Ihrem Code Schutzprüfungen für Nutzereingaben einbauen? Gehen Sie genauso vor, wenn Sie überlegen, welche Aktionen ein LLM mit Ihren Daten oder Prozessen ausführen soll.
2. Unsichere Verarbeitung von Ausgaben
Bei der Beschreibung von Prompt-Injection haben wir erläutert, dass es sinnvoll ist, eine Abstraktionsebene zwischen Ihrem LLM und Ihren Daten einzurichten. Als Beispiel haben wir angeführt, dass das LLM eine Abfrage für Ihre Daten erstellt, die zunächst überprüft werden kann, bevor sie tatsächlich auf Ihre Daten angewendet oder auf Ihrem System ausgeführt wird. Diese Abstraktionsebene bietet einen Schutzmechanismus, sodass Sie nicht blindlings alles ausführen, was Ihr LLM ausgibt. Von unsicherer Ausgabeverarbeitung spricht man, wenn Sie dem LLM direkten Zugriff auf Daten oder die Ausführung von Funktionen gestatten, ohne diese Prüfungen vorzunehmen. Dadurch setzen Sie sich zahlreichen weiteren Risiken aus, darunter Cross-Site-Scripting oder sogar Remote Code Execution.
Wie oben beschrieben und entsprechend der Empfehlung von OWASP: Behandeln Sie Ihr LLM wie einen Nutzer. Gewähren Sie keinen direkten Zugriff auf vertrauliche Daten und prüfen Sie, was Ihr Modell tun möchte, bevor Sie die gewünschten Aktionen mit Ihren vertraulichen Daten oder Systemen ausführen.
Am 5. April 2023 meldete Jason Liu verantwortungsbewusst eine kritische Sicherheitslücke zur Ausführung beliebigen Codes in einem beliebten Python-Framework namens LangChain, mit dem Entwickler Anwendungen mit LLMs erstellen können. Das Framework bietet eine mathematische Funktion für LLMs, die eine natürlichsprachliche Anfrage entgegennimmt, das Ergebnis berechnet und es dem Nutzer zurückgibt. Dabei werden jedoch die Operationen exec() und eval() verwendet, die bekanntermaßen gefährlich sein können. Mit dem folgenden Exploit konnte Jason zeigen, wie das Modell Code ausführte, der vertrauliche Umgebungsdaten aus dem laufenden System auslas und an den Nutzer zurückgab.
3. Vergiftung von Trainingsdaten
Die Manipulation von Trainingsdaten erfordert vom Angreifer zwar eine längere Vorbereitung, kann aber erheblichen Schaden anrichten, wenn sie gelingt. Hochwertige Trainingsdaten sind entscheidend für die Genauigkeit, Korrektheit und Vertrauenswürdigkeit der Ausgaben eines LLM. Die Qualität der Ausgaben eines LLM hängt von der Qualität der bereitgestellten Eingaben und der Leistungsfähigkeit des neuronalen Netzwerks ab, das die Ausgaben mit den Nutzereingaben verknüpft.
Von einer Vergiftung der Trainingsdaten spricht man, wenn ein Angreifer entweder die Trainingsdaten selbst oder die Prozesse nach dem Training während der Feinabstimmung manipuliert. Ziel kann es sein, die Ausgaben weniger sicher zu machen. Ebenso könnte es darum gehen, sie beispielsweise voreingenommener, weniger nützlich oder weniger leistungsfähig zu gestalten.
Die Trainingsdaten eines LLM zu kontrollieren, kann natürlich ziemlich schwierig sein – und es gibt sehr große Datenmengen. Schließlich handelt es sich um ein großes Sprachmodell, das auf riesigen Datenmengen basiert. Bei einer solchen Datenmenge kann es schwierig sein, die Quelle oder die Daten selbst zu überprüfen. OWASP empfiehlt Sandboxing, um sicherzustellen, dass für das Training keine unbeabsichtigten und ungeprüften Quellen verwendet werden.
4. Denial-of-Service-Angriffe auf Modelle
Ein LLM ist eine Verarbeitungs-Engine, die eine Texteingabe entgegennimmt, verarbeitet und auf Grundlage des Trainings eine Ausgabe erstellt. Wenn wir an unsere Interaktionen mit ChatGPT denken, fällt uns vielleicht auf, dass die Antworten umso länger auf sich warten lassen, je komplexer und spezifischer unsere Fragen werden. Bei einem Denial-of-Service-Angriff auf ein Modell stellt ein Angreifer gezielt Eingaben bereit, die genügend Ressourcen beanspruchen, um einen Denial of Service für die Anfrage und das System zu verursachen.
Informieren Sie sich über Schutzmaßnahmen gegen Denial-of-Service-Angriffe in den Frameworks, die Sie für die Interaktion mit Ihren Modellen verwenden. LangChain hat beispielsweise kürzlich das Schlüsselwortargument max_iterations für den Agent Executor hinzugefügt. Damit wird sichergestellt, dass eine Anfrage nach einer festgelegten Höchstzahl von Schritten beendet wird. Betrachten Sie als Beispiel den folgenden Prompt in LangChain, bei dem max_iterations nicht festgelegt ist.
Die folgende Ausgabe zeigt, wie viele Schritte bis zur endgültigen Antwort durchlaufen werden müssen.
Diesmal wurde max_iterations auf zwei gesetzt. Wie Sie sehen, wurde die Kette nach zwei Schritten abgeschlossen, um potenzielle Denial-of-Service-Angriffe zu verhindern.
OWASP empfiehlt außerdem die üblichen Maßnahmen zur Abwehr von Denial-of-Service-Angriffen, etwa die Validierung und Bereinigung von Eingaben sowie Ratenbegrenzungen.
5. Schwachstellen in der Supply Chain
Schwachstellen in der Supply Chain werden in diesen Top 10 leicht übersehen, da man bei diesem Begriff meist an Open-Source-Bibliotheken oder -Frameworks von Drittanbietern denkt, die Sie einbinden. Beim Training eines LLM werden jedoch häufig Trainingsdaten von Drittanbietern verwendet. Zunächst ist es wichtig, darauf zu vertrauen, dass die Drittanbieter integer handeln. Außerdem sollten Sie eine Bestätigung erhalten, dass Sie die richtigen Trainingsdaten bekommen haben und diese nicht manipuliert wurden. OWASP weist auch auf LLM-Plugin-Erweiterungen hin, die zusätzliche Risiken mit sich bringen können.
Diese Angriffsart steckt noch in den Anfängen. Daher gibt es bislang weder Unterstützung für die Supply Chain noch Standards, wie wir sie bei unseren Bemühungen gewohnt sind, die Komponenten der Supply Chain zu erfassen. Wir können jedoch Modelle oder Trainingsdaten signieren lassen, um ihre Herkunft und Integrität zu bestätigen.
Ein Thema, das Sie künftig im Auge behalten sollten, ist das Konzept einer AIBOM (AI Bill of Materials), mit der sich nachvollziehen lässt, wie ein LLM erstellt und trainiert wurde.
6. Offenlegung vertraulicher Informationen
Im ersten Abschnitt haben wir erläutert, wie Prompt-Injection ein KI-Modell dazu bringen kann, Aktionen auszuführen und Verarbeitungen vorzunehmen, die es nicht ausführen sollte. Dadurch können vertrauliche und sensible Daten unbefugt an Nutzer weitergegeben werden. Wie im Abschnitt zur Prompt-Injection erwähnt, ist es äußerst gefährlich, Ihrem LLM Zugriff auf sensible Daten zu gewähren, da ihm die Mechanismen fehlen, mit denen wir normalerweise sicherstellen, dass Nutzer über die erforderlichen Zugriffsrechte verfügen.
Um zu verhindern, dass sensible Daten an Nutzer weitergegeben werden, sollten Sie vor allem zwei wichtige Dinge beachten. Das Erste wiederhole ich hier, weil es so wichtig ist: Stellen Sie unbedingt sicher, dass das LLM nur auf Daten zugreifen kann, die es zur korrekten Erledigung seiner Aufgabe benötigt. Wenn Sie ihm sensible Daten bereitstellen, legen Sie nicht mehr offen, als nötig ist.
Zweitens sollten Sie sowohl vor als auch nach Ihren Interaktionen mit dem LLM Prüfungen durchführen. Diese sollten eine Validierungs- und Bereinigungsebene bilden, die sicherstellt, dass sowohl die Eingaben als auch die Ausgaben Ihren Erwartungen entsprechen. Ich habe bereits Lakera’s Gandalf-Anwendung erwähnt und verrate nun ein paar Details dazu, wie sie diese Bereinigung auf Eingabe- und Ausgabeseite umsetzt. Die freundlichen Menschen dort haben einen Blogbeitrag verfasst, in dem sie die Bereinigungsebenen beschreiben, die sie für Text, der in ihr LLM hinein- und aus ihm herausgeht, auf jeder Ebene als Input Guards und Output Guards bezeichnen. Der aufschlussreiche Beitrag zeigt anschaulich, wie sich diese Validierung umsetzen lässt.
Eine weitere interessante Möglichkeit, für mehr Sicherheit zu sorgen: Lassen Sie Ihr LLM nicht direkt Daten aus Ihren Quellen abrufen, sondern stattdessen Abfragen für Ihre Daten erstellen. Diese Abfragen lassen sich anschließend im Code überprüfen. Außerdem können Sie die üblichen Authentifizierungs- und Autorisierungstechniken anwenden, um sicherzustellen, dass ein bestimmter Nutzer tatsächlich auf die betreffenden Daten zugreifen darf.
7. Unsicheres Plugin-Design
Wie bereits erwähnt, können LLM-Plugins von Drittanbietern stammen und Teil Ihrer AI-Supply-Chain sein. Sie können diese Plugins aber auch selbst entwickeln. Plugins werden in der Regel für bestimmte Aufgaben eingesetzt und erwarten als Erweiterung des Modells eine bestimmte Eingabe, um anhand der LLM-Ausgabe verschiedene Aktionen auszuführen. Wenn Sie eigene Plugins für bestimmte Aufgaben entwickeln, sollten Sie unbedingt sichere Verfahren befolgen, um das Risiko durch böswillige Eingaben zu verringern.
Wie bereits im Blog erwähnt, sollten Sie die vom Plugin verwendete LLM-Ausgabe wie eine Nutzereingabe behandeln. Gestalten Sie die Interaktionen zwischen Ihrem LLM und dem Plugin möglichst klar und eindeutig. Fordern Sie das LLM beispielsweise nicht auf, dem Plugin eine einzelne Textzeichenfolge zu übergeben, die das Plugin dann analysiert und verarbeitet. Verlangen Sie stattdessen verschiedene Parameter, um die möglichen Aktionen des Plugins einzuschränken – ähnlich wie bei parametrisierten SQL-Abfragen.
Ein weiterer sehr wichtiger Aspekt, der in diesem Blog mehrfach angesprochen wurde: Nutzen Sie diese Kontrollmöglichkeit, um sicherzustellen, dass die richtige Autorisierung vorliegt. Betrachten Sie diese Interaktion am besten als API-Vertrag und befolgen Sie die Best Practices der OWASP Top 10 API Security Risks, die 2019 veröffentlicht und Anfang dieses Jahres aktualisiert wurden.
8. Übermäßige Eigenständigkeit
Dieser Punkt wurde der Liste eher subtil hinzugefügt. Diese Schwachstellenart überschneidet sich mit vielen anderen. Eigenständigkeit bezeichnet die Fähigkeit eines LLM-Systems, anhand der LLM-Eingabe oder -Ausgabe auszuwählen, welche Funktion es aufrufen soll. Wenn das LLM eine bestimmte Funktion auf böswillige oder unerwartete Weise aufruft und dadurch Schaden verursacht, handelt es sich um übermäßige Eigenständigkeit. Es gibt drei Arten davon:
Übermäßiger Funktionsumfang: Ein LLM-Agent hat Zugriff auf Plugins, deren Funktionen nicht ausreichend granular abgegrenzt sind.
Übermäßige Berechtigungen: Ein LLM-Plugin hält sich nicht an das Prinzip der geringsten Rechte – es gewährt beispielsweise Schreibzugriff, obwohl nur Lesezugriff erforderlich ist.
Übermäßige Autonomie: Eine LLM-Anwendung führt potenziell schädliche Aktionen automatisch aus, allein auf Grundlage ihrer Interpretation der Eingabe und ohne Interaktion mit einem Nutzer.
9. Übermäßiges Vertrauen
Übermäßiges Vertrauen ist ein zentrales Thema. Gemeint ist, dass wir als Nutzer von LLMs davon ausgehen, sie lägen immer richtig und ihre Ergebnisse seien stets angemessen, sicher, legal, moralisch und ethisch. Tatsächlich kann von LLMs generierter Code Sicherheitslücken enthalten. Informatiker der Stanford University veröffentlichten eine Studie, die zeigt, dass KI-Tools wie GitHub Copilot weniger sicheren Code erzeugen als Menschen, die Code selbst schreiben.
Es ist entscheidend, von LLMs generierten Code genauso zu behandeln wie unseren eigenen. Wir sollten Code-Reviews durchführen, Änderungen automatisierten Sicherheitstests unterziehen und sicherstellen, dass sich unsere Sicherheitslage durch Änderungen nicht verschlechtert.
Snyk Code nutzt symbolische KI, die den Kontext von Code versteht, der mit KI-Tools zur Codegenerierung erstellt wurde. So lässt sich erkennen, ob neue Schwachstellen eingeführt werden. Regelmäßige Tests des Codes mit Snyk gewährleisten ein durchgängig hohes Sicherheitsniveau bei der Bereitstellung – unabhängig davon, ob der Code von KI oder Entwicklern stammt. Das gilt über die gesamte CI/CD-Pipeline hinweg und auch bei dem höheren Bereitstellungstempo, das KI-gestützte Codegenerierung für den Anwendungsbereitstellungsprozess ermöglicht.
Neben Codegenerierung und Sicherheit nennt OWASP weitere Bereiche, etwa Desinformation und irreführende Informationen sowie Halluzinationen. Diese können dazu führen, dass Codebibliotheken oder -pakete referenziert werden, die gar nicht existieren – oder schlimmer noch, dass es sich um ein bösartiges Paket handelt. Nutzen Sie Snyk Open Source, um SCA-Tests in Ihrer IDE auszuführen, in der Sie Code generieren. So können Sie erkennen und beheben, wenn Sie versehentlich anfällige oder bösartige Pakete einbinden.
Starten Sie mit Capture the Flag
Erfahren Sie in unserem virtuellen On-Demand-Workshop für Einsteiger, wie Sie Capture-the-Flag-Herausforderungen lösen.
10. Modelldiebstahl
Zum Schluss, auf Platz 10, steht Modelldiebstahl – der Begriff erklärt sich von selbst. Dabei versucht ein Angreifer, sich unbefugten Zugriff auf ein LLM zu verschaffen, sei es durch physischen Diebstahl, Kopieren oder eine Offenlegung. Das geschah beispielsweise, als Metas LLaMA-Modell kurz nach seiner Ankündigung auf 4chan geleakt wurde. Die Entwicklung und Feinabstimmung eines leistungsfähigen LLM ist eine anspruchsvolle Aufgabe, die oft erhebliche Budgets, Ressourcen und Know-how erfordert. Man stellt sich vielleicht vor, jemand bricht mit einem USB-Stick durchs Fenster ein, um das Modell zu stehlen. Wahrscheinlicher ist jedoch ein Angriff durch einen unzufriedenen Mitarbeiter, der den Wert des Modells erkennt und es mitnehmen möchte.
Bewährte digitale Sicherheitsmaßnahmen wie RBAC-Kontrollen sollten umgesetzt werden, damit Ihr geistiges Eigentum vor Angreifern geschützt ist.
Zum Abschluss
Die KI-gestützte Welt eröffnet ganz neue Möglichkeiten – wir hoffen, dieser Leitfaden hilft Ihnen, sich sicher darin zurechtzufinden. Laden Sie die Spickzettel-Version dieses Blogbeitrags herunter, damit Sie die wichtigsten Punkte schnell nachschlagen können. Erstellen Sie ein kostenloses Snyk-Konto, um Sicherheit direkt in Ihre Entwicklungspraktiken zu integrieren, oder buchen Sie eine Live-Demo, die auf Ihre Anforderungen und Ihren Anwendungsfall zugeschnitten ist.


