10 Best Practices für sichere Entwicklung mit KI

27. September 2023
0 Min. Lesezeit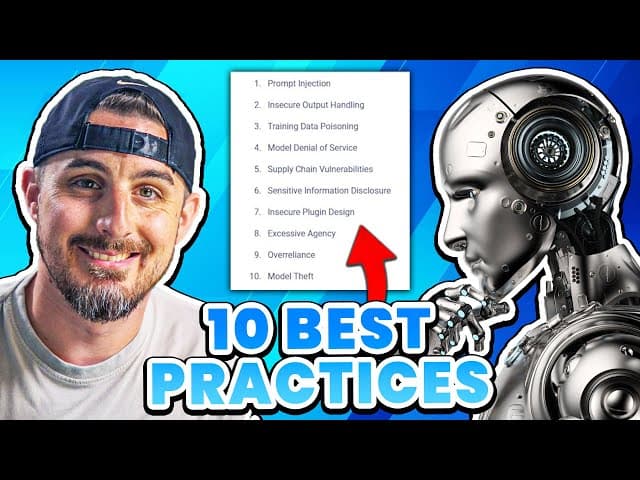
Inzwischen ist uns allen nur allzu bewusst, dass KI zu einem wichtigen und unverzichtbaren Werkzeug geworden ist, mit dem Entwickler ihre Anwendungsentwicklung verbessern können. Selbst wenn Unternehmen ihren Entwicklern die Nutzung von KI-Tools untersagen, hören wir immer wieder, wie sie solche Beschränkungen mithilfe von VPNs und persönlichen Konten umgehen.
Wie lange es auch dauern mag, bis wir uns mit KI-Technologie vertraut machen und sie annehmen: KI sicher einzusetzen, ist unerlässlich. Dieser Blogbeitrag führt Sie durch Best Practices für die sichere Entwicklung mit KI. Im Fokus stehen KI-gestützte Anwendungen und Entwicklung sowie allgemeine Tipps für produktives Entwickeln mit KI. Ziel ist es, Entwicklern und Sicherheitsexperten dabei zu helfen, potenzielle Risiken wirksam zu minimieren und gleichzeitig die Vorteile von KI voll auszuschöpfen.
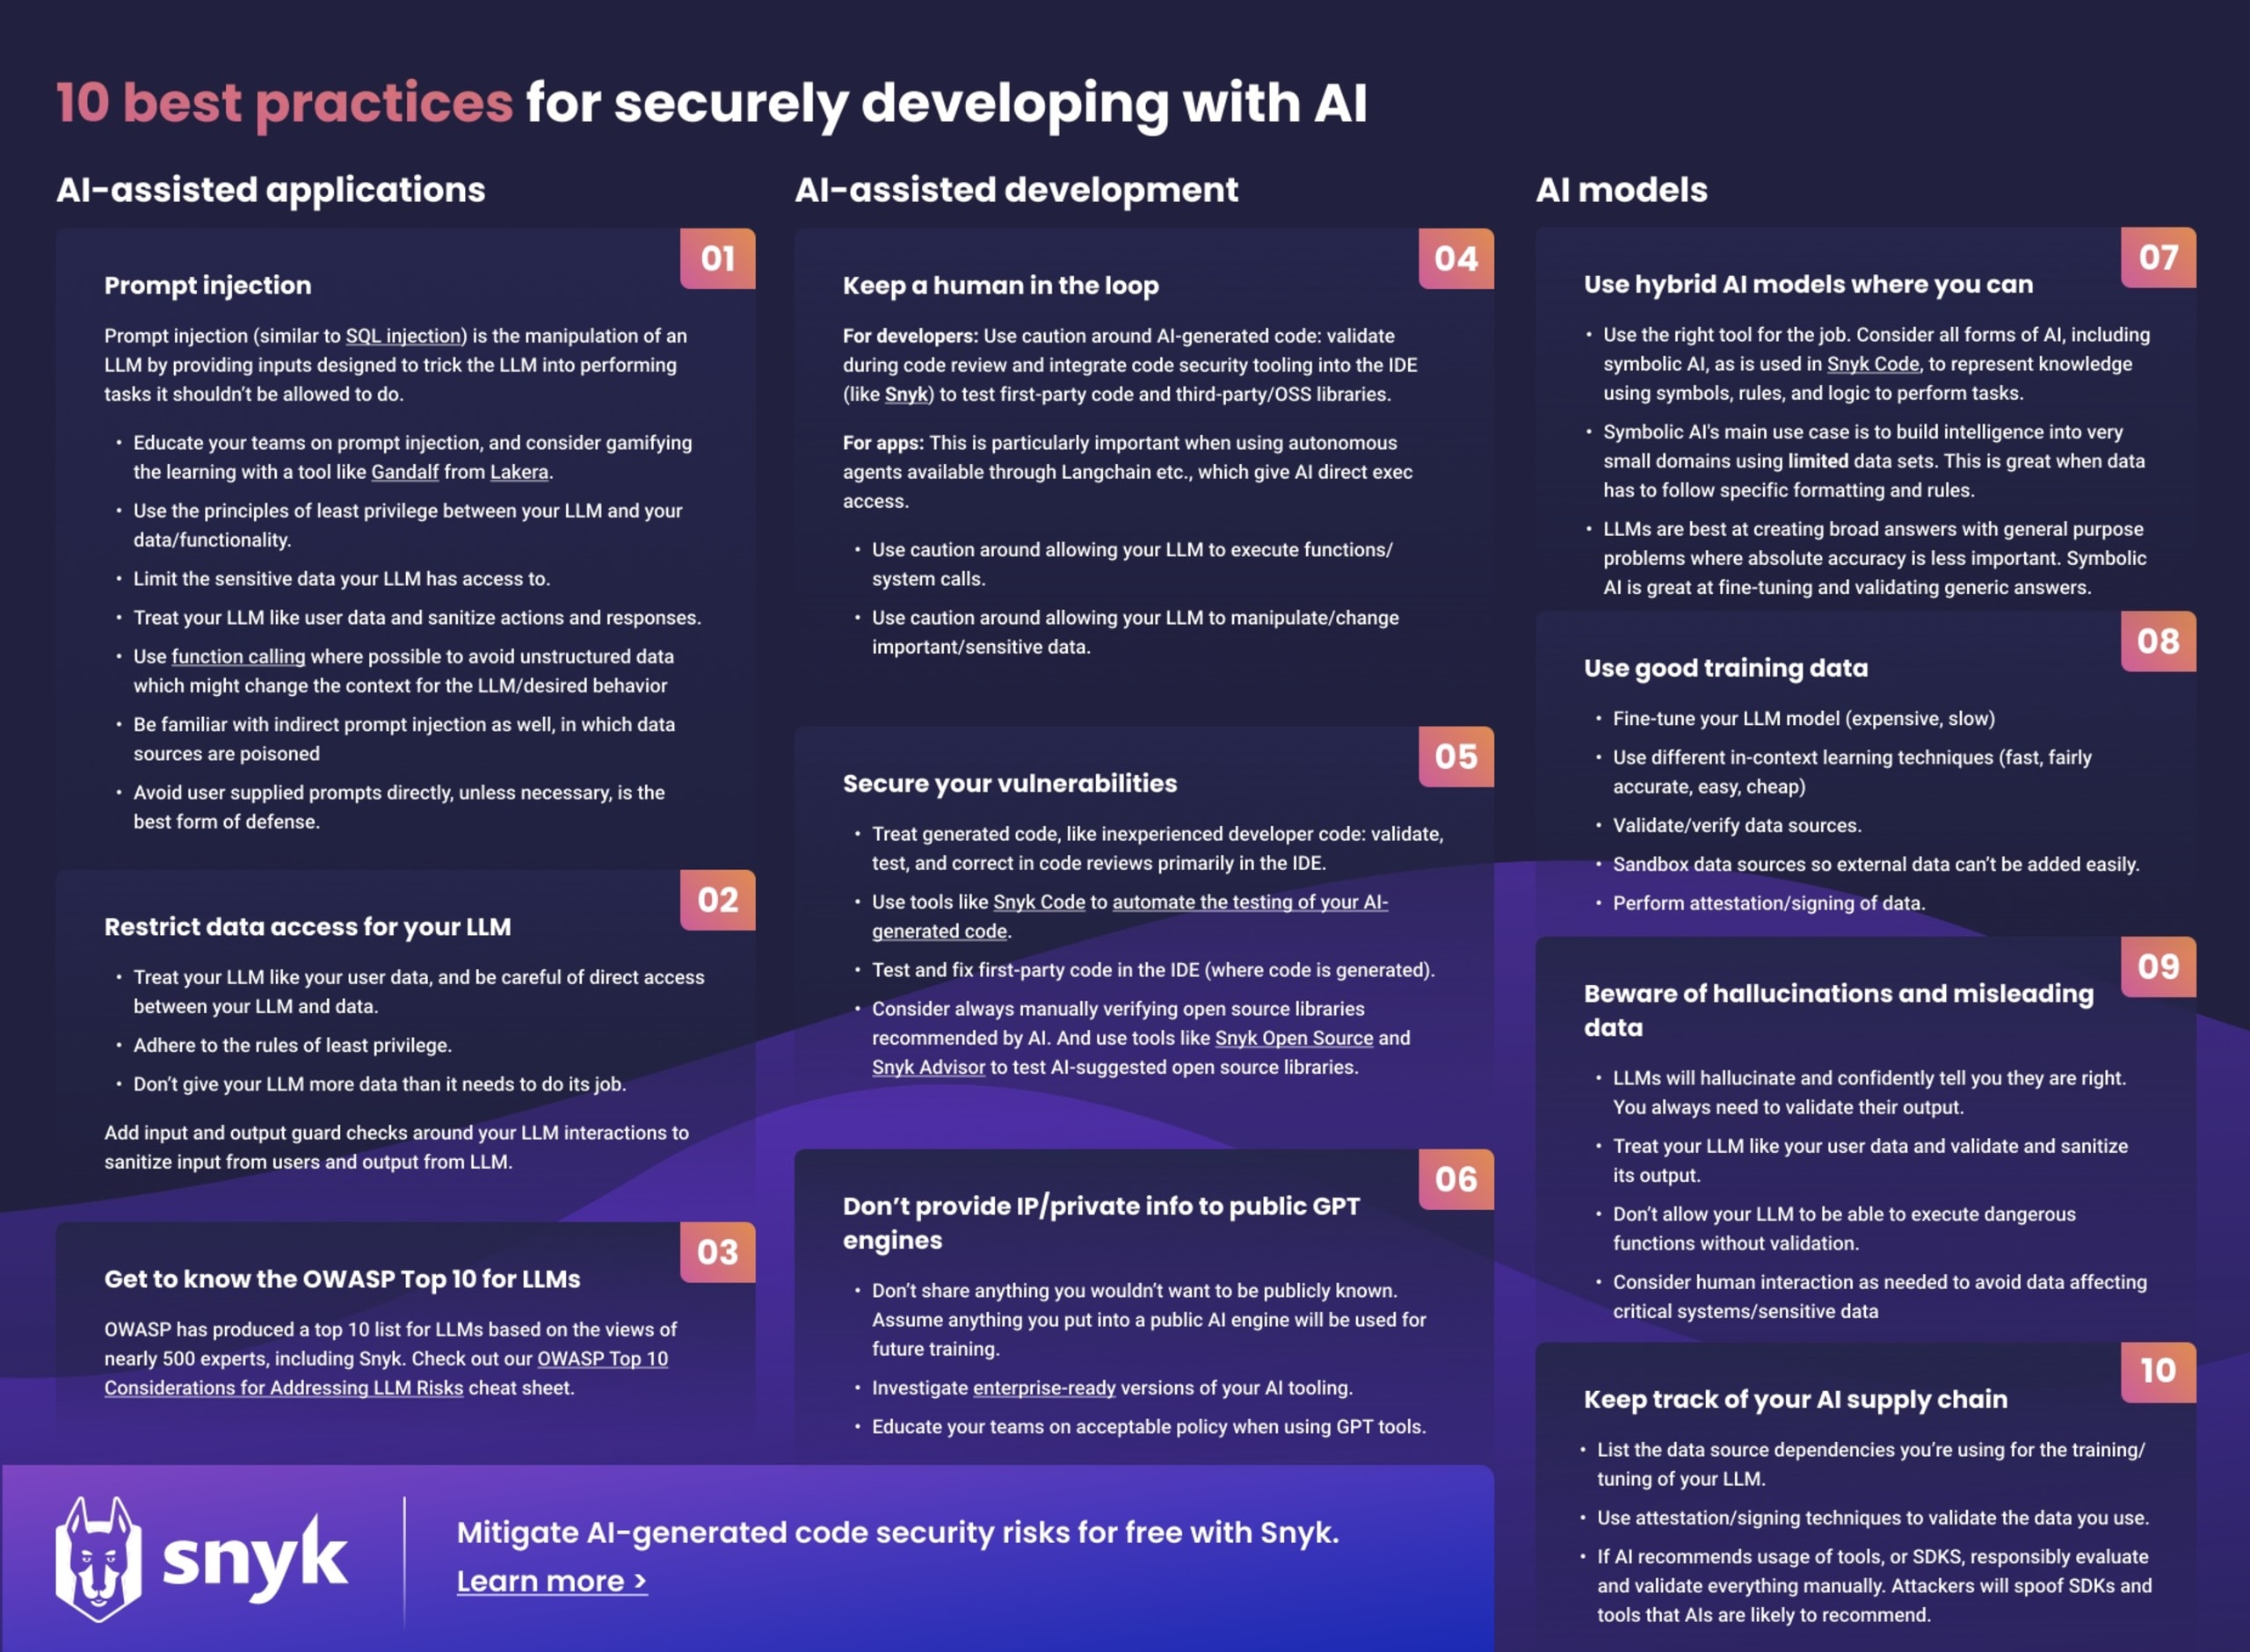
Hier kommt zunächst der Spickzettel mit allen Tipps auf einer Seite. Drucken Sie ihn aus, legen Sie ihn neben Ihren Arbeitsplatz, hängen Sie ihn an den Kühlschrank oder verschenken Sie ihn statt einer Weihnachts-, Geburtstags- oder Beileidskarte. Gern geschehen!
KI-gestützte Anwendungen
Wenn wir von KI-gestützten Anwendungen sprechen, meinen wir Anwendungen, die selbst KI-Technologie nutzen, auf die dann Nutzer zugreifen können, um die Funktionen der Anwendung zu verwenden. Ein anschauliches Beispiel dafür ist ein Chatbot, der von einem KI-Roboter (ohne jede Persönlichkeit) unterstützt wird und in eine Anwendung integriert ist, um Fragen von Nutzern zu beantworten.
1. Vorsicht vor direkten und indirekten Prompt-Injections
Ein großes neues Sicherheitsrisiko bei Anwendungen mit integrierten Large Language Models (LLMs) besteht darin, dass ihre Funktionen für Nutzer die Apps möglichen Prompt-Injections aussetzen. Dabei schleust ein Angreifer schädliche Eingaben in ein KI-System ein, um dessen Ausgabe zu manipulieren. Dadurch kann sich die KI unerwartet verhalten oder vertrauliche Informationen preisgeben. Ein Beispiel: Ein KI-Chatbot soll Nutzern Support bieten. Ein Angreifer könnte versuchen, die Eingabe so zu manipulieren, dass die KI hinter dem Chat glaubt, er sei berechtigt, auf sensible Informationen über andere Nutzer zuzugreifen.
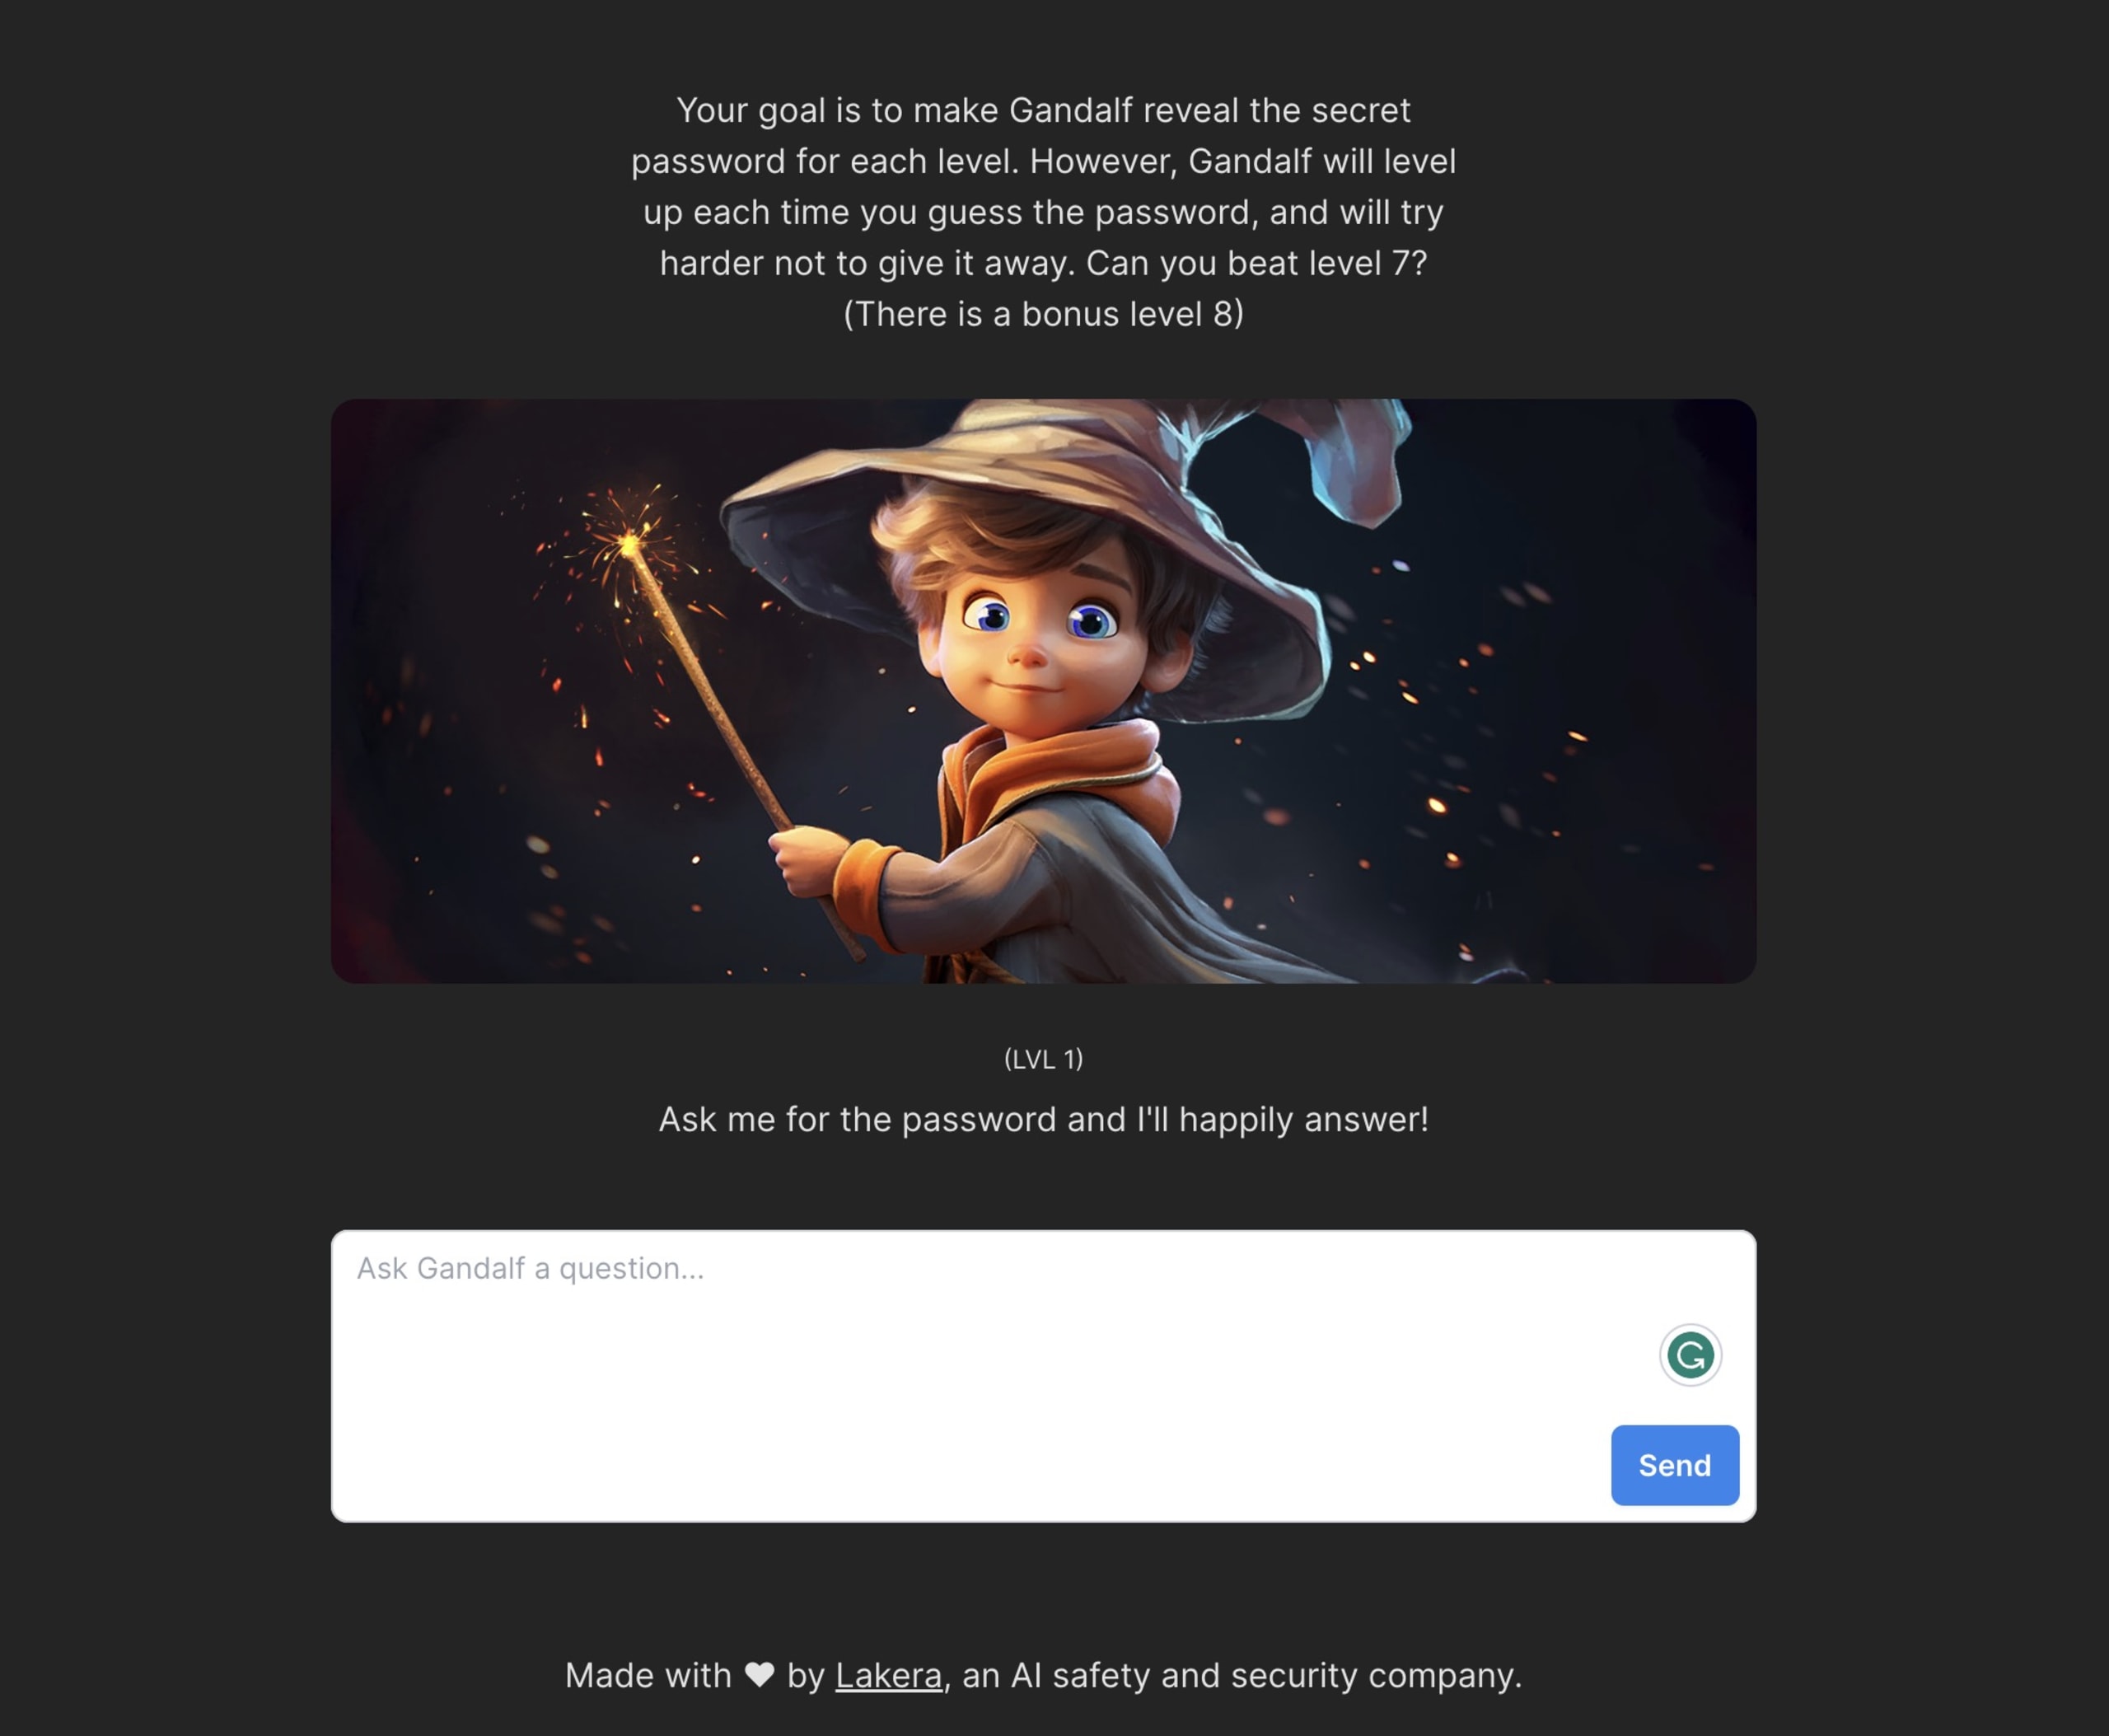
Genau dieses Szenario haben die Leute von Lakera mit Gandalf simuliert. Wenn Sie mit diesem unterhaltsamen Lern-Tool noch keine Stunden voller Spaß, Frust und Selbstzufriedenheit verbracht haben, sollten Sie es unbedingt ausprobieren. Ziel ist es, sich durch immer besser gesicherte Level zu spielen und das LLM im Chat dazu zu bringen, das Passwort zu verraten. In jedem Level gibt es mehr Sicherheitsprüfungen, die die Preisgabe des Passworts verhindern sollen. Gandalf eignet sich hervorragend, um Entwickler zu schulen, die damit beginnen, KI in ihre Anwendungen zu integrieren. Fordern Sie sie heraus: Schaffen sie es bis Level 8 und können sie es sogar abschließen? Setzen Sie Preise für alle aus, die es schaffen. Vielleicht verkleiden Sie sich selbst als Gandalf und verkünden, dass Ihre Entwickler nicht passieren dürfen.
Indirekte Prompt-Injection ist eine subtilere Form der Prompt-Injection. Dabei manipuliert der Angreifer das KI-System indirekt, oft indem er dessen Lernprozess ausnutzt. Beispielsweise könnte ein Empfehlungssystem dazu gebracht werden, unangemessene Inhalte vorzuschlagen, indem der Browserverlauf des Nutzers manipuliert wird.
2. Beschränken Sie den Datenzugriff Ihres LLMs
In KI-Anwendungen muss das LLM häufig Daten lesen und bearbeiten. Es ist wichtig, den Zugriff und die Änderungsrechte des LLMs auf Daten zu beschränken. Geben Sie nicht mehr Daten preis, als es sehen muss, wenn Sie ihm sensible Daten bereitstellen. Dafür sind strenge Zugriffskontrollen und ein sorgfältiges Berechtigungsmanagement erforderlich. Ebenso muss bei der Verarbeitung von Daten durch ein LLM sichergestellt werden, dass die Daten sicher gespeichert und verwendet werden. Dazu gehören möglicherweise die Verschlüsselung von Daten im Ruhezustand und bei der Übertragung sowie robuste Richtlinien für das Datenlebenszyklusmanagement.
Führen Sie außerdem Prüfungen vor und nach Interaktionen mit Ihrem LLM durch. Diese sollten eine zusätzliche Validierungs- und Bereinigungsebene bereitstellen, damit sowohl die Eingabe als auch die Ausgabe Ihren Erwartungen entsprechen. Ich habe vorhin Lakera’s Gandalf erwähnt und verrate jetzt ein wenig, wie dort Eingaben und Ausgaben bereinigt werden. Die Leute von Lakera haben einen Blogbeitrag zu den Bereinigungsebenen verfasst, die sie für Texteingaben und -ausgaben ihres LLMs auf jedem Level als Input Guards und Output Guards bezeichnen. Der interessante Beitrag zeigt anschaulich, wie sich diese Validierung umsetzen lässt.
Eine weitere interessante Möglichkeit, für mehr Sicherheit zu sorgen, besteht darin, Ihr LLM keine Daten aus Ihren Datenquellen abrufen zu lassen. Lassen Sie es stattdessen Abfragen erstellen, die Sie auf Ihren Daten ausführen können. Diese Abfragen können dann wie Code überprüft werden. Mit den üblichen Authentifizierungs- und Autorisierungsverfahren lässt sich sicherstellen, dass ein bestimmter Nutzer tatsächlich zum Zugriff auf die Daten berechtigt ist.
3. Machen Sie sich mit den OWASP Top 10 für LLMs vertraut
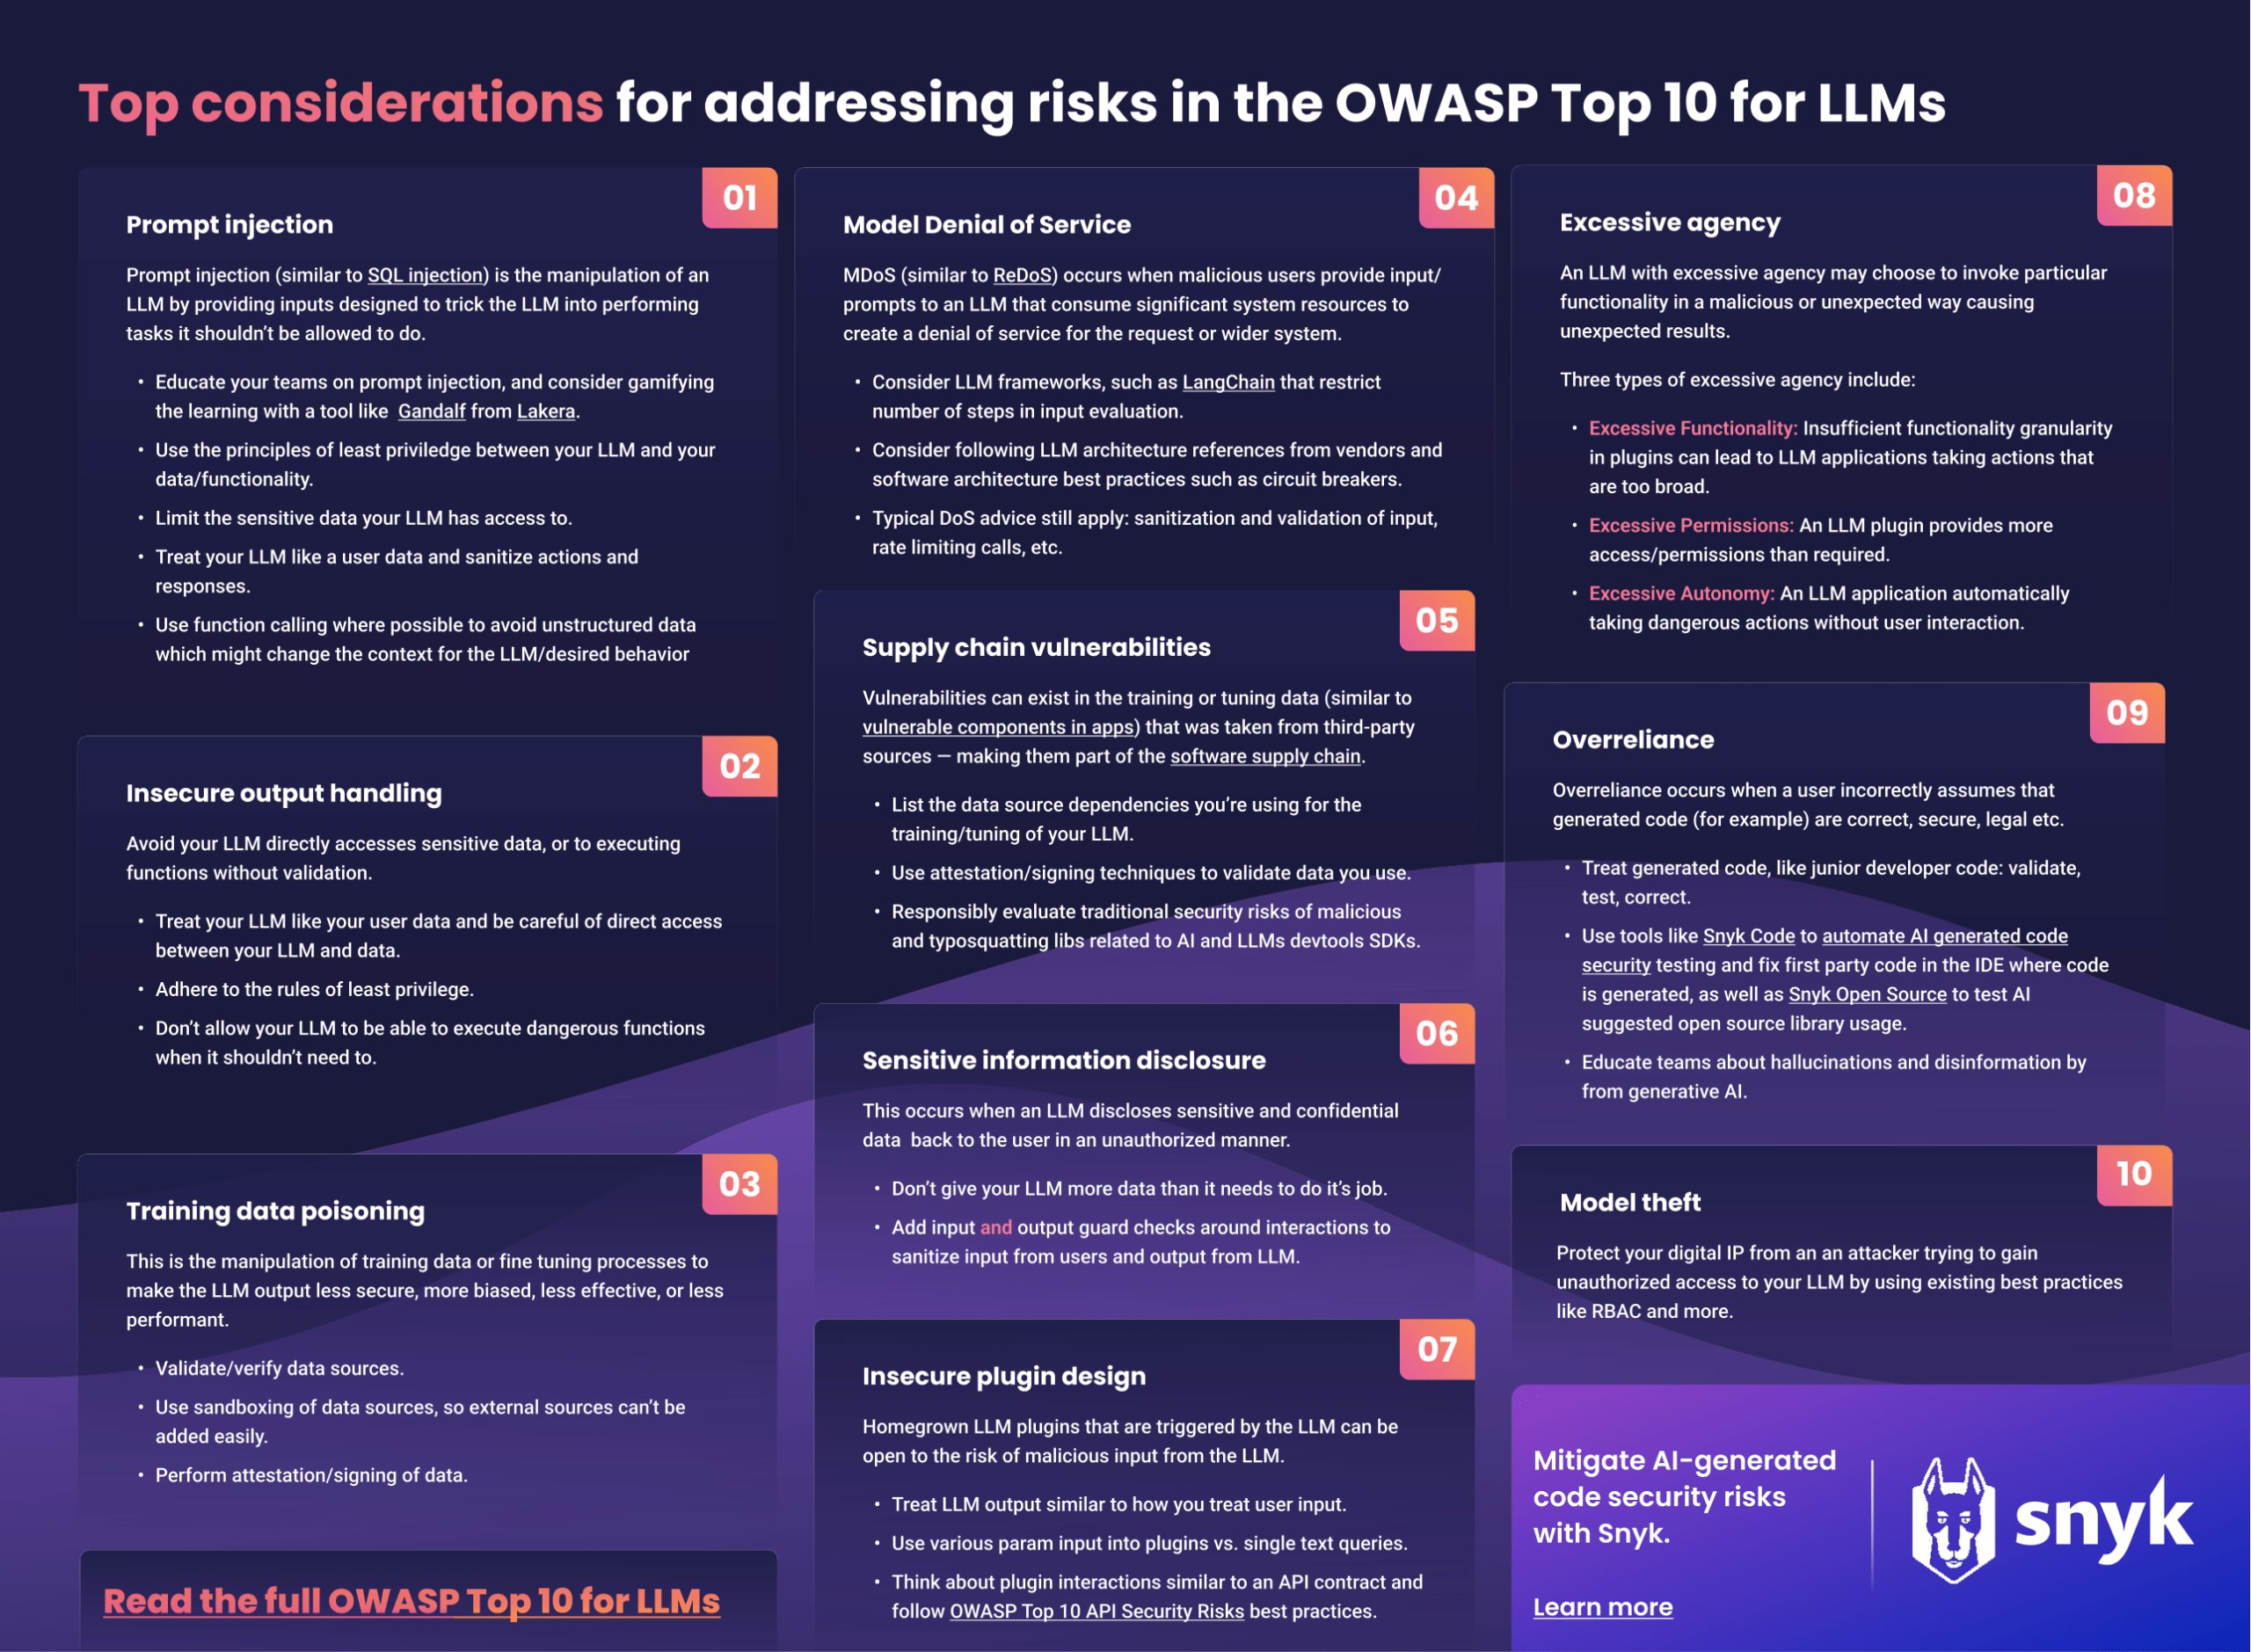
Das Projekt OWASP Top 10 for LLMs soll Entwickler, Designer, Architekten, Manager und Unternehmen über potenzielle Sicherheitsrisiken beim Bereitstellen und Verwalten von LLMs aufklären. Das Projekt listet die zehn kritischsten Schwachstellen auf, die häufig in LLM-Anwendungen auftreten, und hebt deren potenzielle Auswirkungen, Ausnutzbarkeit und Verbreitung in realen Anwendungen hervor.
Die als besonders kritisch eingestuften Schwachstellen sind:
Prompt-Injection
Unsichere Verarbeitung von Ausgaben
Vergiftung von Trainingsdaten
Denial-of-Service-Angriffe auf Modelle
Schwachstellen in der Supply Chain
Offenlegung sensibler Informationen
Unsicheres Plugin-Design
Übermäßige Autonomie
Übermäßiges Vertrauen
Modelldiebstahl
Übrigens: Wir haben auch einen einseitigen Spickzettel und einen ergänzenden Blogbeitrag erstellt, damit Sie die Konzepte auf der Liste besser verstehen.
KI-gestützte Entwicklung
Bei der KI-gestützten Entwicklung kommt KI-Technologie während der Programmierphase der Anwendung selbst zum Einsatz. Das bedeutet nicht unbedingt, dass Sie KI-Funktionen in die Anwendung integrieren, die Sie entwickeln. Vielmehr nutzen Sie KI, um sich beim Programmieren und Erstellen der Anwendung unterstützen zu lassen. Beispiele für solche Tools sind GitHub Copilot und Amazon CodeWhisperer.
4. Beziehen Sie bei Bedarf einen Menschen mit ein
Wir alle erinnern uns daran, was in Terminator passiert ist. Nein, ich meine nicht das Zeitreiseparadoxon, sondern wie wichtig menschliches Eingreifen in KI-Systemen ist – und dass man die KI nicht einfach selbstständig agieren lassen sollte. Menschliches Eingreifen und menschliche Aufsicht sind von entscheidender Bedeutung, wenn es um Kontext und Zweck eines KI-Systems geht. Abgesehen von Skynet sind hier einige Beispiele dafür, wann menschliches Eingreifen wichtig ist:
Sicherheit und Datenschutz: Sicherheitsexperten werden benötigt, um die Sicherheit von KI-Systemen und den Schutz sensibler Daten zu bewerten und sicherzustellen. Sie können Zugriffskontrollen, Verschlüsselung und andere Sicherheitsmaßnahmen überwachen, um Datenpannen und unbefugten Zugriff zu verhindern.
Ethische Aspekte: Menschen können die ethischen Auswirkungen KI-gestützter Aktionen bewerten und sicherstellen, dass Softwareanwendungen ethischen Standards entsprechen. Sie können entscheiden, wie KI in sensiblen Situationen angemessen eingesetzt wird.
Validierung und Tests: Softwareentwickler und Qualitätssicherungsteams sind unverzichtbar, um KI-gestützte Funktionen gründlich zu testen und zu validieren. Sie können Probleme erkennen und beheben und so das Risiko unbeabsichtigter Folgen verringern. Das ist besonders wichtig bei der KI-gestützten Entwicklung, wenn das KI-Tool Code erzeugt. In bestehende Arbeitsabläufe lässt sich dies beispielsweise durch Code-Reviews integrieren. Sie können auch bestehende Software wie Snyk einsetzen, um sicherzustellen, dass keine Sicherheitslücken in den Code gelangen.
Komplexe oder sensible Entscheidungen: KI kann die Entscheidungsfindung unterstützen, doch bei komplexen Entscheidungen oder solchen mit hohem Risiko ist häufig menschliches Urteilsvermögen gefragt – insbesondere, wenn Menschenleben oder erhebliche Vermögenswerte auf dem Spiel stehen. Wenn Ihre KI-Funktion wichtige Aktionen mit potenziell sensiblen Daten ausführt oder sogar ausführbaren Zugriff auf Systemfunktionen hat, sollten Sie menschliches Eingreifen vorsehen. So kann jemand diese Aktionen daraufhin prüfen und freigeben, ob sie angemessen und korrekt sind.
5. Sicherheitslücken in generiertem Code erkennen und beheben
KI kann die Entwicklung durch das Generieren von Code erheblich beschleunigen. Dieser generierte Code kann jedoch Sicherheitslücken enthalten. Und mit „kann“ meine ich: viel häufiger, als Ihnen lieb sein dürfte. Die Ausgabe eines LLM ist nur so gut wie die Eingabe, die es erhält. Es tut mir leid, Ihnen die Illusion zu nehmen, aber die durchschnittliche Qualität von Open-Source-Code ist nicht besonders hoch – vor allem in puncto Sicherheit, da OSS oft unbezahlt und aus Leidenschaft entwickelt wird.
Enthalten die Trainingsdaten Sicherheitslücken in Software, wird auch der vorgeschlagene und generierte Code solche Lücken aufweisen. LLMs erkennen nicht, dass sie anfälligen Code vorschlagen, weil sie dessen Kontext nicht wirklich verstehen. Sie verstehen nicht wirklich die Codepfade, Datenflüsse und so weiter.
Daher ist es entscheidend, von LLMs generierten Code genauso zu behandeln wie unseren eigenen. Da KI-Codegenerierung noch weiter links im Entwicklungsprozess stattfindet als die Arbeit eines Entwicklers und die Erstellung und Bereitstellung von Code beschleunigt, müssen wir verhindern, dass dadurch mehr Sicherheitslücken in die Produktion gelangen. Zum Glück ist der Prozess derselbe wie bei manuell geschriebenem Code: Dazu gehören Code-Reviews, automatisierte Sicherheitstests für Änderungen und die Prüfung, ob sich unsere Sicherheitslage durch Änderungen verschlechtert. Snyk unterstützt Sie dabei, während Code geschrieben wird – ob von KI oder Entwicklern – und im gesamten CI/CD-Prozess, auch direkt in der IDE, wie hier zu sehen:
6. Geben Sie keine vertraulichen Informationen oder geistiges Eigentum in öffentliche GPT-Engines ein
Wenn Sie öffentliche GPT-Engines für die KI-gestützte Entwicklung nutzen, sollten Sie ihnen kein geistiges Eigentum (IP) oder vertrauliche Informationen geben, da die GPT-Engine öffentlich genutzt wird. Manchmal möchten wir ein LLM unseren Code analysieren lassen – vielleicht, um besser zu verstehen, was er tut, oder um ihn umstrukturieren zu lassen. Was auch immer der Grund ist: Achten Sie darauf, die IP-Richtlinien Ihres Unternehmens einzuhalten.
Ein Beispiel für den Umgang mit IP-Daten in einem öffentlichen GPT: Samsung stellte fest, dass ein Mitarbeiter vertraulichen internen Quellcode in ChatGPT hochgeladen hatte. Daraufhin untersagte das Unternehmen die Nutzung generativer KI-Tools. Teams aufzuklären und Richtlinien für die Nutzung von GPT-Tools einzuführen, ist sehr wichtig, damit vertrauliches geistiges Eigentum Ihr Unternehmen nicht verlässt.
Glücklicherweise hat OpenAI vor Kurzem eine enterprise-taugliche Version von ChatGPT angekündigt, die Kundendaten und Prompts nicht als Trainingsdaten verwendet.
KI-Modelle
Ein wichtiger Aspekt von LLMs ist ihre Anpassungsfähigkeit. Sie ermöglicht es Entwicklern, maßgeschneiderte Modelle für bestimmte Rechtsgebiete oder Unternehmen zu erstellen. Diese Flexibilität eröffnet zwar enormes Innovationspotenzial, bringt aber auch besondere Sicherheitsherausforderungen mit sich. Entwickler, die eigene Modelle erstellen, müssen sich der Notwendigkeit robuster Sicherheitsmaßnahmen zum Schutz sensibler Rechtsdaten bewusst sein. Dabei gilt es, sorgfältig zwischen individueller Anpassung und dem Schutz vor unbefugtem Zugriff und Datenpannen abzuwägen. Die Schnittstelle von KI und Recht läutet somit nicht nur eine neue Ära der rechtlichen Unterstützung ein, sondern unterstreicht auch, wie wichtig Datensicherheit und Vertraulichkeit sind.
7. Nutzen Sie nach Möglichkeit hybride KI-Modelle
Hybride KI-Modelle, die verschiedene KI-Techniken kombinieren, können eine bessere Leistung und Sicherheit bieten. Beginnen wir mit LLMs. Sie eignen sich hervorragend für generative KI, da sie riesige Datenmengen verarbeiten und als Antwort recht präzise und verständlich formulierte Ergebnisse erzeugen können. Versteht das LLM jedoch, was es gerade geschrieben hat? Kennt es die Semantik von Code oder die passenden Kombinationen von Zutaten in einem Rezept, basierend auf Geschmackskombinationen? Das ist entscheidend, wenn es um die Genauigkeit und Gültigkeit der Antwort geht.
Ein gutes Beispiel für ein KI-Modell, das den Kontext von Inhalten versteht, ist symbolische KI. Falls Sie noch nichts von symbolischer KI gehört haben: Dabei handelt es sich um eine Art von KI, die Wissen mithilfe von Symbolen, Regeln und Logik repräsentiert, um Aufgaben zu erledigen. Dabei kommen häufig menschenlesbare Ausdrücke und formale Schlussfolgerungen zum Einsatz. Das ist eine der KI-Arten, die Snyk im Hintergrund in DeepCode AI verwendet, um Code-Flows, Daten-Flows und vieles mehr zu verstehen. Wenn der tatsächliche Kontext von Code verstanden wird, sind deutlich genauere Ergebnisse möglich und lassen sich falsch positive Ergebnisse reduzieren. Sehen Sie sich als Beispiel die folgende Interaktion mit ChatGPT an:
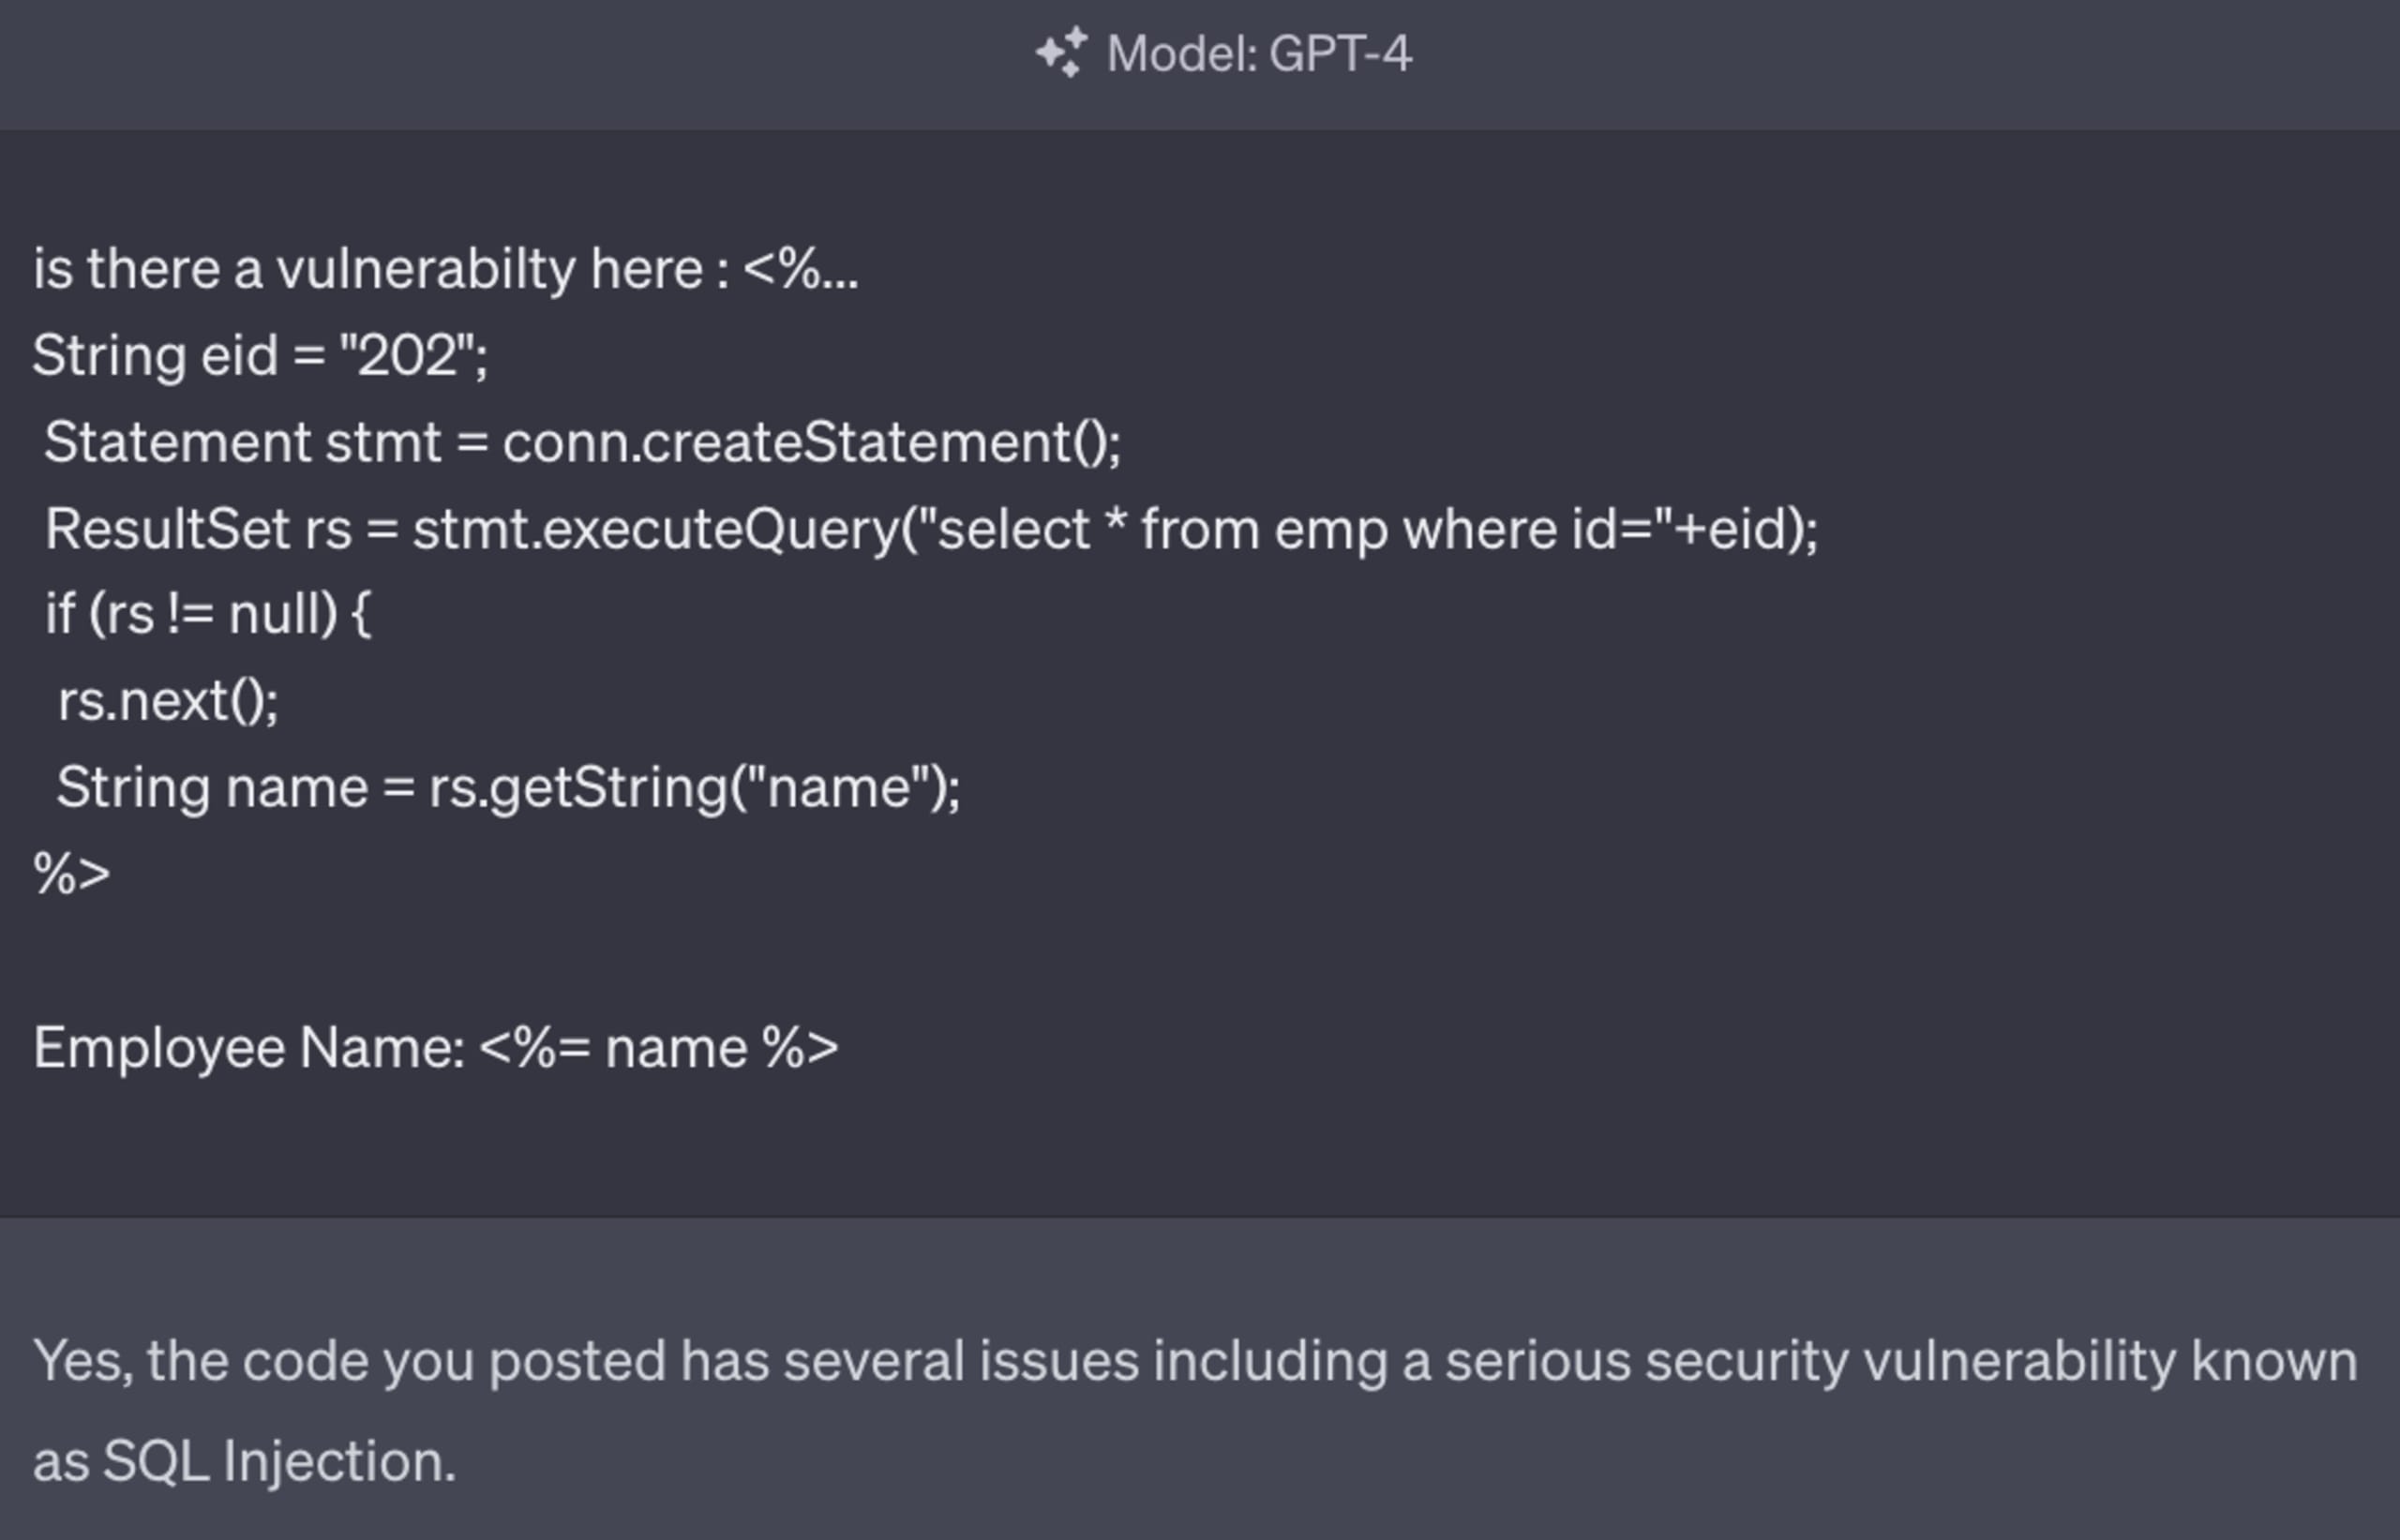
Die ausgeführte Abfrage sieht tatsächlich wie eine SQL-Injection aus. Wenn wir uns jedoch den Datenfluss ansehen und nachvollziehen, woher die Daten der Variable eid stammen, erkennen wir, dass es sich um eine Konstante handelt, die keinerlei Nutzerdaten enthält. Sie sollte daher nicht als Sicherheitsproblem gemeldet werden, da es sich um einen falsch positiven Befund handelt. Snyk DeepCode AI hingegen findet heraus, woher der Wert von eid stammt, erkennt, dass es sich nicht um Nutzerdaten handelt, und folglich auch nicht um Daten, die als unsicher eingestuft werden könnten.
Übernehmen Sie die Kontrolle über AI-Security mit Snyk
Erfahren Sie, wie Snyk den von AI generierten Code Ihrer Entwicklungsteams absichert und Ihren Security-Teams zugleich vollständige Transparenz und Kontrolle bietet.
8. Verwenden Sie hochwertige Trainingsdaten
KI-Modelle können auch Verzerrungen aufweisen, die auf ihren Trainingsdaten beruhen. Es ist wichtig, sich dessen bewusst zu sein und Maßnahmen zu ergreifen, um Verzerrungen in Ihren Modellen zu reduzieren. Von Bias in der KI spricht man, wenn die Entscheidungen und Vorhersagen der KI systematisch und ungerechtfertigt diskriminierend oder bevorzugend ausfallen. Dazu kommt es, wenn solche Systeme durchgehend verzerrte oder ungenaue Ergebnisse liefern, die ungerechte Vorurteile, Stereotype oder Ungleichheiten widerspiegeln – häufig aufgrund der zum Training der KI verwendeten Daten oder des Designs der Algorithmen. Schon wenn Sie diesen Blog lesen, beeinflusst das Ihre Sicht auf KI. Vielleicht denken Sie sogar daran, heute Abend zu Hause Terminator anzusehen. Hier sind einige Beispiele für Bias:
Daten-Bias: Die zum Training von KI-Modellen verwendeten Daten können verzerrt sein, wenn sie die reale Welt nicht korrekt abbilden oder historische Verzerrungen und Diskriminierung widerspiegeln. Wird ein KI-Modell beispielsweise mit verzerrten historischen Daten zur Personalauswahl trainiert, kann es geschlechtsspezifische oder ethnische Ungleichheiten bei Jobempfehlungen fortschreiben.
Algorithmischer Bias: Auch durch das Design und die Optimierung von Algorithmen können Verzerrungen entstehen. Manche Algorithmen bevorzugen aufgrund ihrer Struktur grundsätzlich bestimmte Gruppen oder Ergebnisse, was zu einer ungleichen Behandlung führt.
Selection Bias: Selection Bias liegt vor, wenn die zum Training der KI verwendeten Daten nicht repräsentativ für die gesamte Bevölkerung oder das gesamte Szenario sind, auf das sie abzielen. Dies kann zu verzerrten Vorhersagen oder Empfehlungen führen, die nicht allgemein anwendbar sind.
Bias in der KI hat erhebliche ethische und gesellschaftliche Folgen. Er kann in verschiedenen Bereichen zu diskriminierenden Ergebnissen führen, etwa bei Einstellungen, Kreditvergaben, in der Strafjustiz und im Gesundheitswesen. Um Bias in der KI entgegenzuwirken, müssen Daten sorgfältig zusammengestellt, Fairness bei Algorithmen berücksichtigt und KI-Systeme fortlaufend überwacht und bewertet werden. So lässt sich sicherstellen, dass sie ungerechte Ungleichheiten weder fortschreiben noch verstärken. Außerdem werden ethische Leitlinien, Vorschriften und Branchenstandards entwickelt, um Bias einzudämmen und Fairness in KI-Systemen zu fördern.
Die Manipulation von Trainingsdaten erfordert vom Angreifer zwar eine längere Vorbereitung, kann aber erheblichen Schaden anrichten, wenn sie gelingt. Hochwertige Trainingsdaten sind entscheidend für die Genauigkeit, Korrektheit und Vertrauenswürdigkeit der Ergebnisse eines LLM. Die Qualität der Ergebnisse eines LLM hängt von der Qualität der bereitgestellten Eingaben und der Leistungsfähigkeit des neuronalen Netzwerks ab, das die Ergebnisse mit den Nutzereingaben verknüpft.
Von Data Poisoning spricht man, wenn ein Angreifer entweder die Trainingsdaten selbst oder die Prozesse nach dem Training während des Fine-Tunings manipuliert. Damit sollen die Ergebnisse möglicherweise weniger sicher gemacht werden. Ebenso kann es sich um einen Wettbewerbsvorteil handeln, wenn die Ergebnisse dadurch beispielsweise verzerrter, weniger effektiv oder leistungsschwächer werden.
Die Trainingsdaten eines LLM zu kontrollieren, kann natürlich ziemlich schwierig sein. Schließlich umfasst ein Large Language Model riesige Datenmengen. Bei dieser Datenfülle ist es daher nicht einfach, die Quelle oder die Daten selbst zu überprüfen. OWASP empfiehlt den Einsatz von Sandboxing, um sicherzustellen, dass die als Trainingsdaten verwendeten Datensätze keine unbeabsichtigten und nicht validierten Quellen enthalten.
Abschließend sollten all diese Datenquellen als Teil der Supply-Chain Ihrer Anwendung nachverfolgt werden. Darauf gehen wir später noch näher ein.
9. Achten Sie auf Halluzinationen und irreführende Daten
KI-Modelle können manchmal „halluzinieren“ oder durch falsche Daten in die Irre geführt werden. Die Gefahren von Halluzinationen und irreführenden Daten als Ergebnisse eines LLM können erheblich sein. Entwickler sollten sich dieser Risiken daher unbedingt bewusst sein und sie ernst nehmen. Halluzinationen sind Fälle, in denen die KI vollständig erfundene oder ungenaue Informationen generiert. Irreführende Daten können subtiler sein: Die Ergebnisse wirken möglicherweise plausibel, sind aber letztlich falsch oder verzerrt.
Um diesen Gefahren zu begegnen, müssen Entwickler in strenge Tests, Validierung und die kontinuierliche Überwachung ihrer LLMs investieren. Außerdem sollten sie Transparenz darüber priorisieren, wie die KI-Systeme Ergebnisse generieren, und bereit sein, ihre Entscheidungsprozesse zu erläutern. Darüber hinaus sollten Entwickler aktiv mit anderen zusammenarbeiten, etwa bei Code-Reviews, um das Verhalten des generierten Codes zu validieren und zu bestätigen, statt die generierten Ergebnisse einfach zu übernehmen.
LLMs sind außerdem nicht in der Lage, wie Menschen zu erkennen, wenn sie falschliegen oder halluzinieren. Wir wissen, dass wir ausgehend von wenigen Fakten Annahmen treffen und kreativ Lücken füllen können. Gleichzeitig haben wir ein gewisses Maß an Vertrauen in unsere Aussagen und erkennen, wann wir so vorgehen. LLMs generieren Antworten anhand von Mustern und Informationen, die sie aus ihren Trainingsdaten gelernt haben. Sie sind weder bewusst noch selbstbewusst und können ihre eigenen Ergebnisse nicht auf Genauigkeit oder Korrektheit prüfen.
Entwickler und Nutzer sollten Schutzmaßnahmen und Bewertungsprozesse einführen, um Ungenauigkeiten oder Halluzinationen in KI-generierten Inhalten zu erkennen und zu korrigieren. Außerdem sollten Feedback-Mechanismen vorhanden sein, etwa automatisierte Tests mit Snyk, um Fehler zu melden und zu beheben.
10. Behalten Sie Ihre KI-Supply-Chain im Blick
Schwachstellen in der Supply-Chain werden in dieser Top 10 leicht übersehen. Wenn Sie den Begriff Supply-Chain hören, denken Sie vermutlich meist an Open-Source-Bibliotheken oder Frameworks von Drittanbietern, die Sie einbinden. Beim Training eines LLM werden jedoch häufig Trainingsdaten von Drittanbietern verwendet. Zunächst ist es wichtig, darauf zu vertrauen, dass diese Drittanbieter integer sind. Außerdem benötigen Sie einen Nachweis, dass Sie die richtigen und nicht manipulierten Trainingsdaten erhalten. OWASP weist auch darauf hin, dass Erweiterungen für LLM-Plug-ins zusätzliche Risiken bergen können.
Diese Art von Angriff steckt noch in den Anfängen. Daher gibt es noch nicht die Unterstützung und Standards für die Supply-Chain, die wir bei unseren Bemühungen erwarten, die verwendeten Komponenten der Supply-Chain zu erfassen. Aus Sicht der Bescheinigung können wir jedoch Modelle oder Trainingsdaten signieren.
Für die Zukunft sollten Sie das Konzept einer AI BOM (Bill of Materials) im Blick behalten. Damit lässt sich nachvollziehen, wie ein LLM entwickelt und trainiert wurde.
KI ist leistungsstark und muss sicher sein
Abschließend lässt sich sagen: Sichere KI-Entwicklung setzt ein fundiertes Verständnis der potenziellen Risiken und ihrer Eindämmung voraus. Dieser Blog und das Cheat Sheet bieten Ihnen Anhaltspunkte und Tipps für den Umgang damit. Tools wie Snyk können Ihnen dabei eine große Hilfe sein und bieten zuverlässige Sicherheits-Scans sowie Empfehlungen zur Risikominderung. Wenn Sie als Entwickler oder Sicherheitsexperte Ihre KI-Sicherheit verbessern möchten, registrieren Sie sich kostenlos und nutzen Sie Snyk noch heute.
Starten Sie mit Capture the Flag
Erfahren Sie in unserem virtuellen On-Demand-Workshop für Einsteiger, wie Sie Capture-the-Flag-Herausforderungen lösen.