URL-Verwirrungsschwachstellen in freier Wildbahn: Parser-Inkonsistenzen im Fokus

Snyk Security Research Team
Claroty Team82
10. Januar 2022
0 Min. LesezeitURLs haben die Art und Weise, wie wir mit Computern interagieren, grundlegend verändert. 1992 konzipiert und 1994 definiert, ist der Uniform Resource Locator (URL) nach wie vor ein zentraler Bestandteil des Internets. Er ermöglicht es Menschen, mithilfe beschreibender, verständlicher Adressen im Web zu navigieren. Damit sie für Menschen lesbar sind, müssen URLs jedoch in maschinenlesbare Komponenten zerlegt werden. Dafür sorgen URL-Parser.
Angesichts der jahrzehntelangen Allgegenwart von URLs könnte man annehmen, dass sich die heute verwendeten URL-Parser darauf geeinigt haben, wie ähnliche (oder sogar identische) URLs zu parsen sind. Das wäre zwar ideal, entspricht aber keineswegs der Realität. Dieser fehlende Konsens hat eine Schwachstellenklasse begünstigt, die als URL-Verwirrung bezeichnet wird und die wir in diesem Beitrag untersuchen.
Hinweis: Für die Entwicklung von Internetprotokollen (HTTP, HTML, URL usw.) werden Dokumente verwendet, die als Requests for Comment oder RFCs bezeichnet werden. Auf diese Dokumente werden wir in diesem Beitrag häufig Bezug nehmen.
Im Rahmen unserer gemeinsamen Forschung haben wir zahlreiche URL-Parsing-Bibliotheken in verschiedenen Programmiersprachen untersucht und dabei Inkonsistenzen darin festgestellt, wie sie URLs jeweils in ihre grundlegenden Komponenten zerlegen. Wir haben die Arten von Inkonsistenzen in vier Kategorien eingeteilt und in Webanwendungen sowie Open-Source-Bibliotheken nach problematischen Codepfaden gesucht. Dabei haben wir zahlreiche Schwachstellen aufgedeckt, die meist eine dieser Ursachen hatten:
Es werden mehrere URL-Parser verwendet
Im Laufe der Zeit gab es mehrere URL-bezogene RFCs, und verschiedene Parser implementierten unterschiedliche RFCs
In diesem Beitrag werfen wir einen Blick auf die Geschichte von URLs, untersuchen mögliche Ursachen für Verwirrung bei URL-Parsern, führen einen Exploit-Proof-of-Concept durch und geben anschließend Empfehlungen, wie Sie sich vor Angriffen schützen, die URL-Verwirrung ausnutzen. Über das folgende Inhaltsverzeichnis können Sie direkt zu einem Abschnitt springen:
Die gemeinsame Forschungsarbeit der Sicherheitsteams von Claroty und Snyk wurde von früheren Arbeiten von Orange Tsai mit dem Titel „A New Era of SSRF“ sowie einem Vergleich von WHATWG und RFC 3986 durch Daniel Stenberg, den Entwickler von cURL, inspiriert. Wir möchten ihnen für ihre innovative Forschung danken.
Was sind URLs und wie kam es dazu?
Wenn wir an eine URL denken, fällt uns etwas wie https://snyk.io ein. Im Grunde gibt sie an, wohin es gehen soll (my-site.com) und wie wir dorthin gelangen (über HTTPS). Zusätzlich gibt es weitere Bestandteile wie Pfade (https://my-site.com/about), Rautezeichen gefolgt von einer Zeichenfolge (Fragmente, z. B. https://my-site.com#contact) oder Fragezeichen gefolgt von Parametern (Abfragen, z. B. https://my-site.com?source=li&device=mobile).
Verallgemeinert und zusammengefasst lässt sich eine URL-Zeichenfolge in die folgenden Kernkomponenten zerlegen:
scheme://authority/path?query#fragment
Eine URL kann zum Beispiel so aussehen: https://example.com:8042/over/there?name=ferret#nose
Im Rahmen unserer Recherche haben wir untersucht, wie verschiedene Parser unterschiedliche RFCs implementiert haben. Die oben dargestellte URL-Form wirkt zwar relativ einfach, doch die RFCs, in denen sie definiert wurde, haben sich seit 1994 stark verändert. Diese Ergänzungen und Überarbeitungen haben nach und nach zu der URL-Form geführt, die wir heute kennen.
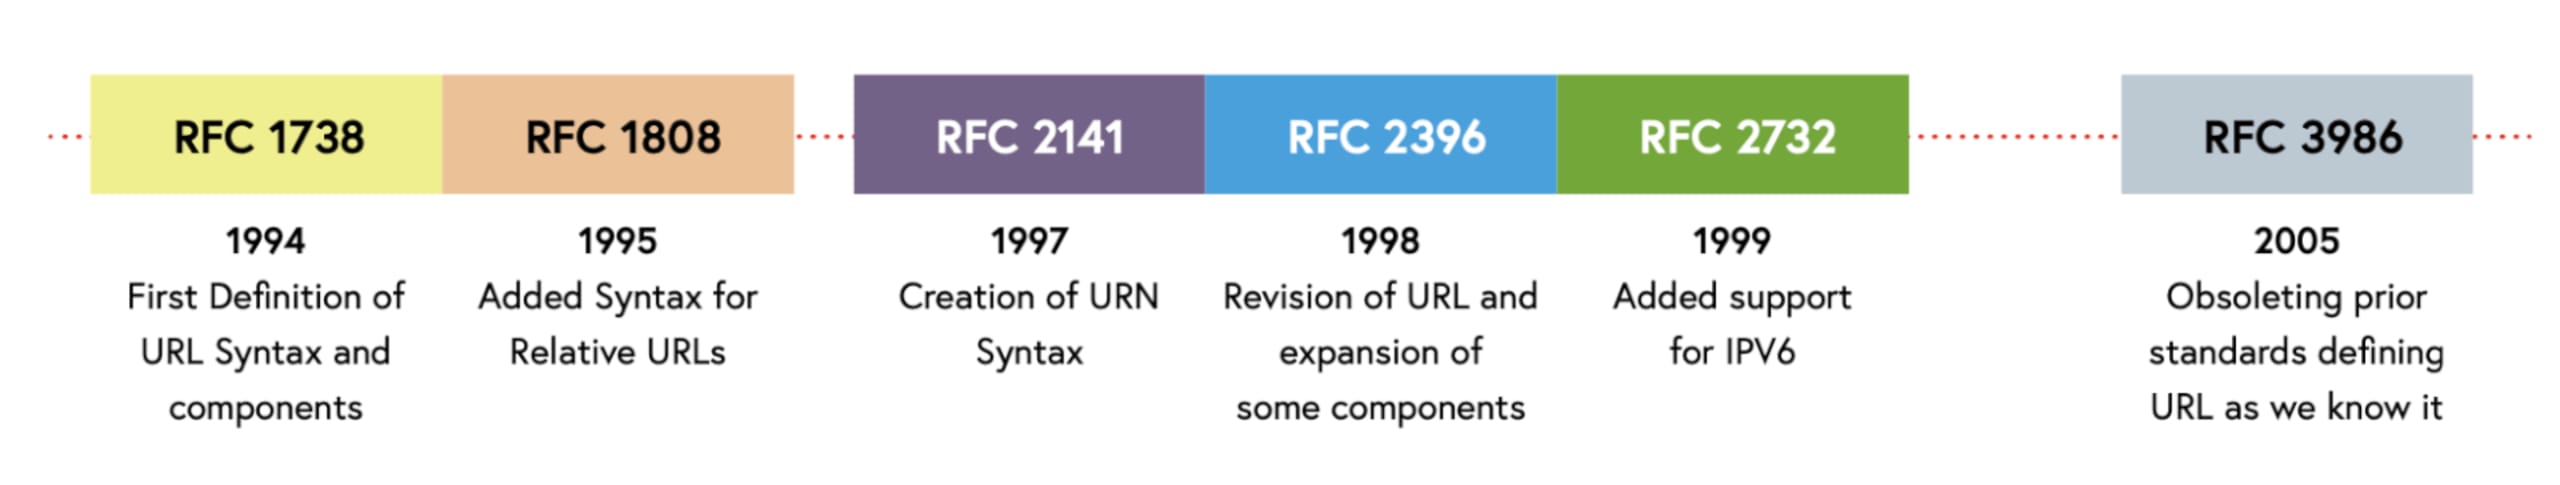
Weitere Informationen: RFC 1738, RFC 1808, RFC 2141, RFC 2396, RFC 2732, RFC 3986
Um zu verstehen, wo es bei Parsern zu Verwirrung kommt, müssen wir uns zunächst (kurz) damit befassen, was die einzelnen Komponenten einer vollständigen URL bedeuten und wie sie definiert sind.
Schema
Im Schema-Abschnitt wird das Protokoll festgelegt (z. B. HTTP, HTTPS, FTP, Gopher usw.). Die RFCs definieren, welche Zeichen in dieser Komponente zulässig sind und dass das aktuelle Schema dem Muster ALPHA *( ALPHA / DIGIT / "+" / "-" / "." ) entsprechen muss. Sehen wir uns an, was das bedeutet:
Erstes Zeichen:
a–ZAlle weiteren Zeichen:
a–Z,0–9,+,-,.
Das bedeutet, dass 1http kein gültiges Schema ist (da es mit einer Zahl beginnt), h2ttp hingegen schon (da das erste Zeichen ein Buchstabe sein muss). Außerdem ist das Schema im Gegensatz zu den anderen URL-Komponenten die einzige erforderliche Komponente.
Authority (früher Netloc)
Diese Komponente wurde früher „Netloc“ (Network Location) genannt und in Authority umbenannt. Sie besteht aus drei Unterkomponenten: Userinfo, Host und Port. Zusammengenommen sieht ein allgemeines Beispiel für eine Authority etwa so aus: authority = [ userinfo "@" ] host [ ":" port ]. Die Unterkomponente userinfo lässt sich wiederum in ihre Hauptbestandteile zerlegen: username[:password]. Damit werden URLs der Form scheme://user:password@domain:port/ abgedeckt. Beachten Sie, dass die Verwendung von Klartext-user:password seit RFC-2396 nicht mehr empfohlen und mit RFC-3986 als veraltet eingestuft wurde.
Pfad
Diese Komponente gibt an, auf welche Ressourcen auf dem Server die anfragende Partei zugreifen möchte. Sie darf eine beliebige Zeichenfolge enthalten (außer /,;,=,?), die in Segmente unterteilt ist (getrennt durch /).
Obwohl dies die unkomplizierteste Komponente zu sein scheint, wurde sie im Laufe der Jahre am häufigsten geändert. RFC-1738 und RFC-1808 knüpften die Struktur und Regeln der Pfadkomponente an die Schema-Komponente. Anschließend legte RFC-2396 fest, dass jedes Pfadsegment das Semikolon (;) zur Definition von Parametern verwenden darf. Doch schon kurze Zeit nach RFC-2396 wurde mit RFC-3986 die Semikolon-Parametersyntax als veraltet eingestuft.
Verwirrt? Den Parsern geht es genauso!
Abfrage
Abfragen sind Schlüssel-Wert-Paare, die über die URL an die angeforderte Ressource übermittelt werden. Die Abfrageparameter stehen nach dem ersten Fragezeichen (?) und enden an einer Raute (#).
Innerhalb einer Abfragekomponente sind Semikolon (;), Schrägstrich (/), Fragezeichen (?), Doppelpunkt (:), At-Zeichen (@), kaufmännisches Und (&), Gleichheitszeichen (=), Pluszeichen (+), Komma (,) und Dollarzeichen ($) reservierte Zeichen und werden bei Verwendung URL-kodiert.
Hier ein Beispiel für die URL-Kodierung von Sonderzeichen:
Fragment
Das Fragment dient dazu, eine zweite Ressource innerhalb der zuerst abgerufenen, durch die Pfadkomponente angegebenen Ressource zu identifizieren und aufzurufen. Eine Fragmentkomponente wird durch eine Raute (#) eingeleitet und endet am Ende der URI.
... und damit sind alle Komponenten abgedeckt!
Relative URLs
Als Letztes befassen wir uns in diesem Abschnitt mit relativen Referenzen in URLs. Da URLs hierarchisch aufgebaut sind, kann eine URL relativ zu einer anderen sein. Bei einer „Basis“-URL wie https://example.com/ und einem URL-Zeichenfolgenabschnitt, der mit einem Pfad beginnt, beispielsweise /foo/bar, löst der Parser beide zu https://example.com/foo/bar auf. Dazu muss ihm jedoch zuerst die „Basis“-URL übergeben werden.
Das bedeutet, dass Parser relative Referenzen verarbeiten können müssen. RFC-3986 definiert drei Typen relativer Referenzen:
Netzwerkpfad-Referenz – beginnt mit
//, z. B.//example.comAbsoluter Pfad – beginnt mit
/, z. B./etc/passwdRelativer Pfad – beginnt nicht mit
/, z. B.foo/bar
Referenztyp | Beispiel |
|---|---|
Netzwerkpfad | //snyk.io |
Absoluter Pfad | /etc/passwd |
Relativer Pfad | app/login.js |
Für die Auflösung der beiden letzten Referenztypen ist eine Basis-URL erforderlich. Bei der Netzwerkpfad-Referenz muss hingegen nur das Schema angegeben sein. Wenn ein Parser also HTTPS als Standardschema verwendet, wird aus //example.com die URL https://example.com.
Wo kommt es bei URL-Parsern zu Verwirrung?
Nachdem wir uns mit den verschiedenen Bestandteilen einer URL-Zeichenfolge und den Änderungen an den RFCs im Laufe der Jahre befasst hatten, beschlossen wir, URL-Parser zu untersuchen und nach Grenzfällen zu suchen, die zu falschen oder unerwarteten Parsing-Ergebnissen führen.
Im Rahmen unserer Recherche haben wir 15 Bibliotheken (in verschiedenen Programmiersprachen geschrieben), URL-Abrufprogramme (z. B. curl und wget) sowie Browser untersucht.
Wir haben zahlreiche Inkonsistenzen zwischen den Parsern festgestellt und sie in vier Hauptkategorien eingeteilt. Anhand der nachfolgend beschriebenen Kategorien können wir die meisten Parser überlisten und eine Vielzahl unvorhersehbarer Verhaltensweisen hervorrufen, die zahlreiche Schwachstellen ermöglichen.
Unsere Kategorien sind:
Sehen wir uns die Kategorien ohne Umschweife an!
Schema-Verwirrung
Fast jeder verfügbare URL-Parser ist verwirrt, wenn die Schema-Komponente fehlt. Der Grund dafür ist, dass RFC 3986 das Schema als den einzigen obligatorischen Bestandteil einer URL bezeichnet, während RFC 2396 und frühere Versionen dies nicht tun. Parser zu implementieren und dabei diese Feinheiten rückwärtskompatibel zu berücksichtigen, ist nicht trivial – und führt zu Verwirrung.
Zur Veranschaulichung haben wir vier verschiedene Python-Bibliotheken die URL google.com/abc parsen lassen.

Wie oben dargestellt, gehen die meisten Parser davon aus, dass die Host-Komponente leer ist, wenn sie die Zeichenfolge google.com/abc erhalten. Urllib3 gibt hingegen google.com als Host und /abc als Pfad an. httptools wiederum stuft diese URL von vornherein als ungültig ein. Unterm Strich parsen fast alle Parser diese URL nicht korrekt, da sie nicht den RFC-Spezifikationen entspricht.
Einige Parser greifen jedoch auf das Standardschema zurück, wie in diesem Fall curl:

In diesem Fall können Angreifer den Unterschied zwischen Parsern ausnutzen, um eine Validierung zu umgehen. Wenn ein URL-Parser bestimmte Hosts validieren soll, die URL aber nicht korrekt parsen kann, um den Host zu ermitteln, während die zugrunde liegende Bibliothek die URL gleichzeitig korrekt parsen (oder auf ein Standardschema zurückgreifen) kann, lässt sich die Prüfung umgehen. Zum Beispiel:

Im obigen Beispiel parst urllib (genauer gesagt die Funktion urlsplit) die URL so, dass kein netloc vorhanden ist, und die Prüfung wird bestanden. urllib3 greift jedoch auf das Standardprotokoll http zurück und ruft so die verbotene Ressource ab.
Schrägstrich-Verwirrung
Bei der nächsten Art von Verwirrung geht es um eine nicht standardmäßige Anzahl von Schrägstrichen in der URL. RFC 3986 besagt, dass die Authority-Komponente in der URL nach einem Doppelpunkt und zwei Schrägstrichen, ://, stehen sollte. Sie reicht bis zum Zeilenende (EOL) oder bis ein Trennzeichen gelesen wird. Ein Trennzeichen kann hier ein Schrägstrich (der eine Pfadkomponente einleitet), ein Fragezeichen (Abfragekomponente) oder eine Raute (Fragmentkomponente) sein.
Im Rahmen unserer Recherche haben wir beim Parsen von URLs, die nicht der oben beschriebenen Syntax entsprechen, verschiedene Verhaltensweisen beobachtet. Bei der folgenden URL http:///google.com verhielten sich die Parser auf interessante Weise:

Wie Sie sehen, gaben die meisten Parser an, dass diese URL keinen Host hat, und interpretierten stattdessen /google.com als Pfad einer URL ohne Host – was gemäß RFC 3986 dem gewünschten Verhalten entspricht. Wir konnten dieses Verhalten bei beliebig vielen Schrägstrichen nach dem Schema reproduzieren. Bei einer Gruppe von Parsern stellten wir jedoch fest, dass sie versuchten, die URL zu „korrigieren“ und zusätzliche oder fehlende Schrägstriche teilweise ignorierten. Die native Javascript-Funktion fetch behandelt solche URLs beispielsweise so, als wären sie korrekt:

Und das gilt auch für curl:

Solche Unterschiede bei den Parsing-Ergebnissen schaffen eine große Angriffsfläche. Wie bei der vorherigen Angriffsmöglichkeit (bei der Scheme-Verwechslung): Was wäre, wenn wir Prüfungen umgehen könnten, weil der erste Parser die URL anders parst als der Fetcher? Betrachten wir folgendes Beispiel:

Auch hier sehen wir eine Netloc-Prüfung auf eine blockierte Domain. Wieder ist netloc aufgrund des Parsings leer und die Prüfung wird bestanden. Später im Code interpretiert curl die URL anders und versucht, die Ressource unerwartet abzurufen. Das kann zu SSRF-Angriffen und Zugriff auf andere nicht zugelassene Hosts führen.
Backslash-Verwechslung
Eine Variante der Slash-Verwechslung ist die Backslash-Verwechslung. Sie kann auftreten, wenn eine URL einen Backslash (\) statt eines Slashes (/) verwendet und dadurch eine fehlerhafte URL entsteht. Laut RFC 396 unterscheidet sich ein Backslash von einem Slash und muss anders interpretiert werden. Daher sind http://google.com und http:\\google.com nicht gleich. Getreu dem RFC behandeln die meisten programmgesteuerten URL-Parser die beiden URLs tatsächlich unterschiedlich:

Chrome interpretiert den Backslash jedoch wie einen Slash:

Chrome ruft die URL auf, als wäre sie gültig. Auf die Spitze getrieben tritt dieses Verhalten auch bei https:/\google.com auf, und Chrome stellt die Ressource wie (un)erwartet bereit.
URL-Encoding-Verwechslung
Die letzte Kategorie ist die URL-Encoding-Verwechslung. Sie tritt auf, wenn eine URL eine URL-kodierte Teilzeichenfolge enthält, wo sie nicht erwartet wird.
URL-Encoding ermöglicht generell, nicht druckbare Zeichen in URL-Zeichenfolgen zu verwenden. Dazu wird der hexadezimale Wert des Zeichens mit einem vorangestellten %-Symbol angegeben. Ein g wird beispielsweise URL-kodiert zu %67. So bleiben URL-Zeichenfolgen unabhängig von den enthaltenen Zeichen vollständig textbasiert und lesbar. Obwohl dieses Verfahren für nicht druckbare Zeichen gedacht ist, lassen sich auch druckbare Zeichen URL-kodieren – und genau dabei entsteht die Verwechslung.
RFC 3986 besagt, dass alle URL-Komponenten außer dem Scheme URL-kodiert werden können. In der Praxis parsen viele Parser die netloc-Komponente jedoch nicht.
Dies sind die Parsing-Ergebnisse, wenn wir den Parsern die URL http://google.com in URL-kodierter Form übergeben:

Die obigen Ergebnisse wirken zwar erwartungsgemäß, doch sowohl urllib als auch requests für Python zeigten ein interessantes Verhalten, als sie eine URL-kodierte URL erhielten:

In beiden obigen Fällen wurde unerwartet eine Anfrage an 127.0.0.1 gesendet.
Diese Abweichung schafft eine weitere Angriffsfläche: Einfache Regex-Muster erkennen solche Zeichenfolgen nicht, sodass wir Prüfungen möglicherweise erneut umgehen können.
Proof of Concept zur Ausnutzung (und gemeldete CVEs)
Nachdem wir nun wissen, worin die Verwechslung besteht, sehen wir uns an, wie sich diese Probleme ausnutzen lassen und welche Schwachstellen wir gefunden haben. Wir gehen eine CVE genauer durch. Die vollständige CVE-Liste finden Sie weiter unten.
Clearance (Ruby): CVE-2021-23435: Open-Redirect-Schwachstelle
Open-Redirect-Schwachstellen entstehen, wenn eine Webanwendung eine vom Nutzer kontrollierte Eingabe akzeptiert, die eine URL angibt, zu der der Nutzer nach einer bestimmten Aktion (etwa einer Anmeldung) weitergeleitet wird. Zur Veranschaulichung zeigt das folgende Diagramm, wie der Angriff funktioniert:
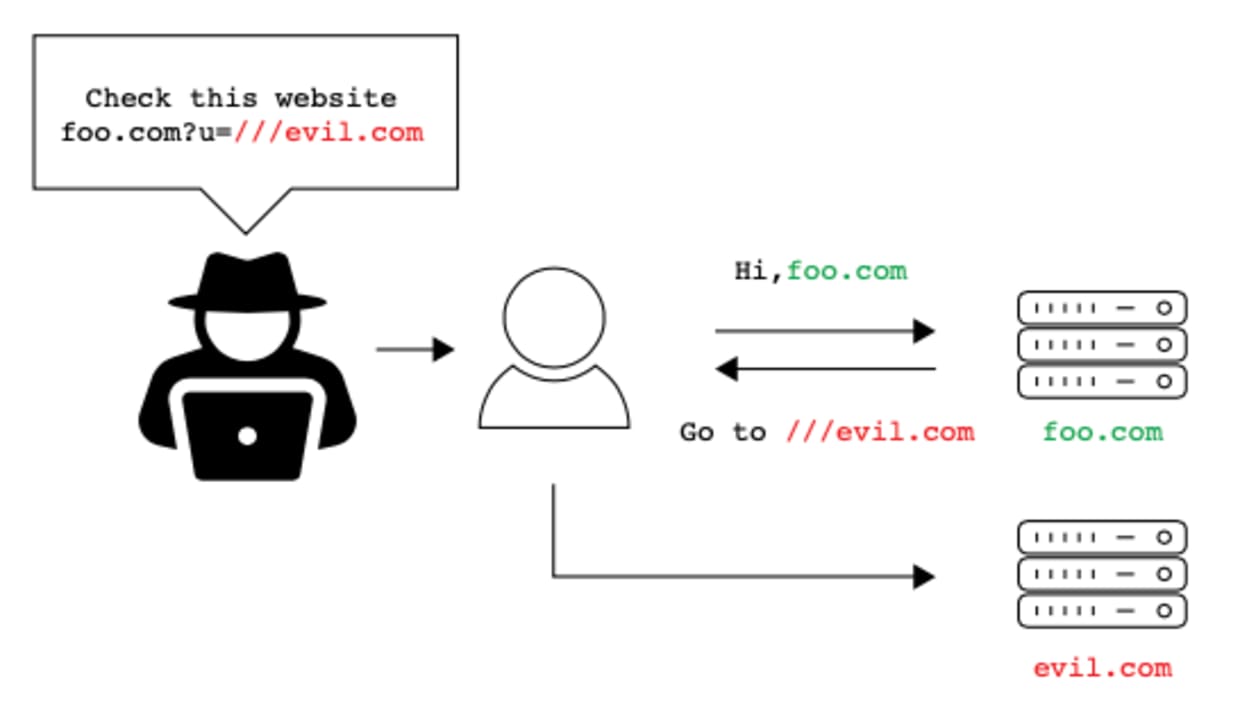
Wie Sie sehen, stellt der Angreifer dem Opfer eine URL bereit, die dieses aufrufen soll. Bei entsprechender Konfiguration leitet der Server den Nutzer dann zu einer vom Angreifer kontrollierten Website weiter.
Clearance ist ein Ruby-Gem, das den Authentifizierungsmechanismus des Rails-Frameworks um eine email-and-password-Authentifizierung erweitert. Nach der An- oder Abmeldung leitet es den Nutzer mithilfe einer URL weiter, die aus einer vorherigen Nutzeranfrage stammt (also der Ressource, die der Anfragende vor dem Aufruf der Anmeldeseite angefordert hat).
Der verwundbare Code befindet sich in der Funktion return_to (dem Callback nach der An- oder Abmeldung):
Mit Blick auf Open Redirects erlaubt return_to Nutzern nicht, beliebige return_to-URLs anzugeben. Wenn ein Nutzer jedoch ohne Anmeldung eine auth-required-Ressource anfordert, ruft das System store_location auf und leitet den Browser zur Anmeldeseite weiter. Kann ein Angreifer ein Opfer dazu bringen, auf einen Link wie http://target.com/////evil.com zu klicken, wird die Schwachstelle ausgelöst.
Warum kommt es zu einem Open Redirect? Wegen mehrerer Parser!
Wie wir gesehen haben, speichert store_location den vollständigen URL-Pfad (auch weil Ruby mehrere Slashes in URLs ignoriert). Dadurch wird /////evil.com im Cache gespeichert. Beim Aufruf von URI.parse werden zwei zusätzliche Slashes entfernt, sodass ///evil.com übrig bleibt. Wenn ein Browser (etwa Chrome) diese URL erhält, behandelt er sie als netzwerkpfadbezogene Referenz und leitet den Client zu http://evil.com weiter.
Der Grund, weshalb Browser solche URL-Fehler heutzutage oft „verzeihen“ und zu korrigieren versuchen, liegt darin, dass sie sich über die Jahre mit vielen unvollkommenen und nicht RFC-konformen URLs auseinandersetzen mussten. Um Fehler von Clients und Entwicklern abzufangen, haben Browser im Laufe der Zeit gelernt, bei häufigen Fehlern Slashes wegzulassen oder hinzuzufügen.
Ein Ausschnitt aus dem Quellcode des Chromium-Projekts:
Weitere Schwachstellen
Hier sind einige weitere Schwachstellen, die durch Unterschiede zwischen Parsern entstanden sind:
Flask-security (Python, CVE-2021-23385)
Flask-security-too (Python, CVE-2021-32618)
Flask-User (Python, CVE-2021-23401)
Flask-unchained (Python, CVE-2021-23393)
Belledonnes SIP-Stack (C, CVE-2021-33056)
Video.js (JavaScript, CVE-2021-23414)
Nagios XI (PHP, CVE-2021-37352)
Clearance (Ruby, CVE-2021-23435)
Empfehlungen zur Vermeidung von URL-Verwechslungen
Da die in diesem Beitrag besprochenen Probleme auf mehrere Parser und deren Vorgehensweisen zurückzuführen sind, sollten Sie wissen, welche Parser in Ihrer Anwendung zum Einsatz kommen. Bei modernen Architekturen wie Microservices und Service-Meshes wird das schnell komplex und es kann einige Zeit dauern, die Parsing-Komponenten Ihrer Anwendung sowie den Weg einer Anfrage durch das System vollständig zu verstehen.
Sobald die Liste der Parser erstellt ist, müssen Entwickler die Unterschiede zwischen den Parsing-Logiken genau verstehen, damit sie produktiv arbeiten können, ohne die Anwendung zu gefährden.
Allgemein empfehlen wir Folgendes:
Verwenden Sie möglichst wenige verschiedene Parser. So minimieren Sie die Angriffsfläche für „Verwechslungen“ und verringern die Zahl möglicher Parsing-Probleme.
Ein zentraler Parsing-Punkt für dezentrale Systeme. Wenn eine Anfrage in Ihrem System immer wieder zwischen verschiedenen Komponenten weitergereicht wird, kommen wahrscheinlich unterschiedliche Parser zum Einsatz (etwa aufgrund verschiedener Dienste in verschiedenen Programmiersprachen). Um das zu verhindern, können Sie die URL einmal am Eingangspunkt Ihrer Systemanfragen parsen und die geparste Anfrage weitergeben. So wird während des gesamten Anfrageverlaufs nur ein Parser verwendet.
Verstehen Sie die Unterschiede zwischen den Parsern Ihrer Geschäftslogik. Da URLs mitunter im Code oder im Rahmen von Geschäftsprozessen geparst werden müssen, sollten die Entwickler, die an der Funktion arbeiten, die Unterschiede zwischen den Parsern kennen (wie oben beschrieben).
Lesen Sie das Whitepaper zu URL-Verwirrung
Erfahren Sie mehr über die verschiedenen Arten von URL-Verwirrung im Whitepaper.