Erreichbare Schwachstellen: Open-Source-Sicherheit effektiv priorisieren

Krysztof Huszcza
18. August 2020
0 Min. LesezeitEin häufiges Problem, von dem unsere Kunden berichten, ist die überwältigende Zahl an Schwachstellen.
Bei kleinen Projekten sind Sie möglicherweise auf Dutzende oder sogar Hunderte von Open-Source-Bibliotheken angewiesen. Bei großen Unternehmensanwendungen kann es sich anfühlen, als würden Ihre Abhängigkeiten die Hälfte des Ökosystems umfassen. Die zunehmende Verbreitung von Abhängigkeiten von Drittanbietern führt auch zu mehr Schwachstellen in diesen Abhängigkeiten. Die meisten Entwickler akzeptieren zwar widerwillig den Umfang der Drittanbieter-Abhängigkeiten ihres Projekts, doch eine App mit Hunderten oder Tausenden bekannter Schwachstellen auszuliefern, geht meist zu weit.
Wenn Sie von Schwachstellen in Ihrer App überwältigt werden, stellt sich die berechtigte Frage: Sind all diese Probleme überhaupt ausnutzbar? Was, wenn sich einige Schwachstellen in Drittanbieter-Code befinden, der von Ihrer App nie ausgeführt wird? Anders gesagt: Was, wenn manche Schwachstellen von Ihrem Anwendungscode aus nie erreichbar sind? Wenn Sie das wüssten, könnten Sie die Behebung nicht erreichbarer Schwachstellen zurückstellen und sich stattdessen auf die erreichbaren konzentrieren – also auf diejenigen, die Sie derzeit tatsächlich in der Produktion betreffen. Letztendlich müssten Sie zwar alle Schwachstellen beheben, aber zumindest wüssten Sie, wo Sie anfangen sollten.
Klingt perfekt – aber wie stellen Sie tatsächlich fest, welche Schwachstellen erreichbar sind und welche nicht? Bei Snyk lösen wir dieses Problem, indem wir fundierte Sicherheitsforschung mit automatisierter statischer Analyse kombinieren. Sehen wir uns diese Lösung genauer an.
Verwundbare Funktionen
Sehen wir uns zunächst den Teil der Sicherheitsforschung an, der eine wichtige Frage beantworten soll: Welcher Code ist tatsächlich verwundbar?
Für jede Schwachstelle möchten wir wissen, welche Codezeilen, Funktionen, Klassen oder Module in einer bestimmten Bibliothek das Sicherheitsrisiko darstellen. Das ist entscheidend: Ohne genau anzugeben, welcher Code verwundbar ist, können wir nicht feststellen, ob er erreichbar ist. Leider enthalten öffentlich verfügbare Schwachstellendatenbanken diese Informationen nicht.
Wie identifizieren Sie also den verwundbaren Code? Eine Methode, die sich in der Praxis bewährt hat, ist die manuelle Prüfung durch Sicherheitsexperten. Bei Snyk analysiert ein Team aus Sicherheitsanalysten und Forschern kontinuierlich Schwachstellen, die unsere Kunden betreffen. Bevor sie eine Schwachstelle in unsere Datenbank aufnehmen, untersuchen sie diese und versehen sie mit Metadaten, die auf den tatsächlich verwundbaren Code verweisen.
Um zu beschreiben, welcher Code verwundbar ist, haben wir uns für Programmfunktionen entschieden. Für jede Schwachstelle speichern wir eine Reihe von Funktionsnamen und -signaturen. Diese Funktionen enthalten manchmal direkt den verwundbaren Code, während andere Funktionen das verwundbare Verhalten ermöglichen. Unabhängig von ihrer tatsächlichen Beziehung zur Schwachstelle bezeichnen wir sie als „verwundbare Funktionen“. Welche Funktionen wir für eine bestimmte Schwachstelle als verwundbar einstufen, entscheiden wir von Fall zu Fall.
Erreichbarkeitsanalyse anhand des Aufrufgraphen
Nachdem wir die verwundbaren Funktionen für jede Bibliothek identifiziert haben, müssen wir feststellen, ob die Anwendung diese Funktionen verwendet. Hier kommt der zweite Teil unserer Lösung ins Spiel: die statische Analyse. Damit erstellen wir den Aufrufgraphen des Eingabeprogramms und ermitteln anhand dieses Graphen, ob verwundbare Funktionen erreichbar sind.
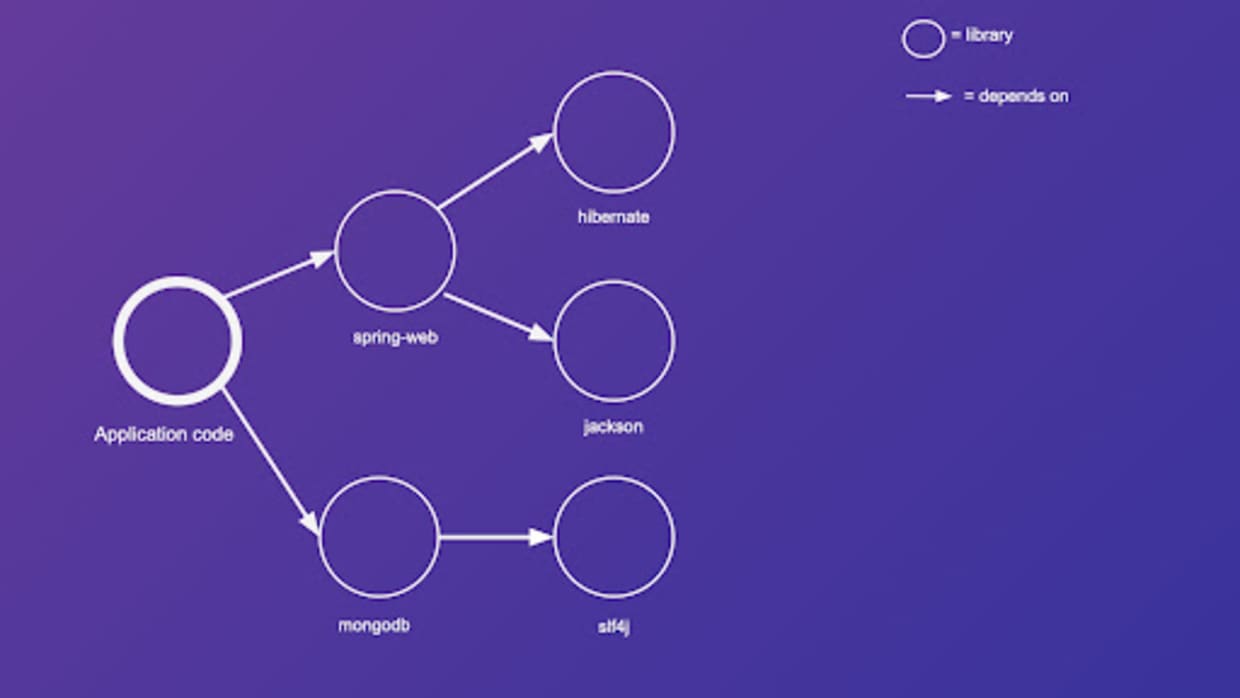
Bevor wir uns mit statischer Analyse befassen, veranschaulichen wir anhand eines Beispiels, wie sich mithilfe eines Aufrufgraphen feststellen lässt, ob verwundbarer Code erreichbar ist. Nehmen wir an, wir haben eine Java-Webanwendung mit zwei direkten Abhängigkeiten: spring-web und mongodb. spring-web hängt wiederum von zwei weiteren Bibliotheken ab: hibernate und jackson. mongodb hängt von slf4j ab. Diese Beziehungen lassen sich als Abhängigkeitsgraph darstellen.
Ergänzen wir den Graphen nun um weitere Details, indem wir Funktionsaufrufe berücksichtigen. Vereinfachen wir unsere Komponenten stark und nehmen wir an, dass der Anwendungscode und alle Drittanbieter-Bibliotheken jeweils nur zwei Funktionen haben – mit Ausnahme von spring-web, das drei Funktionen besitzt. Fügen wir alle Funktionen als Knoten zum Graphen hinzu und verbinden wir Funktion A genau dann mit einem Pfeil zu Funktion B, wenn Funktion A Funktion B aufruft.
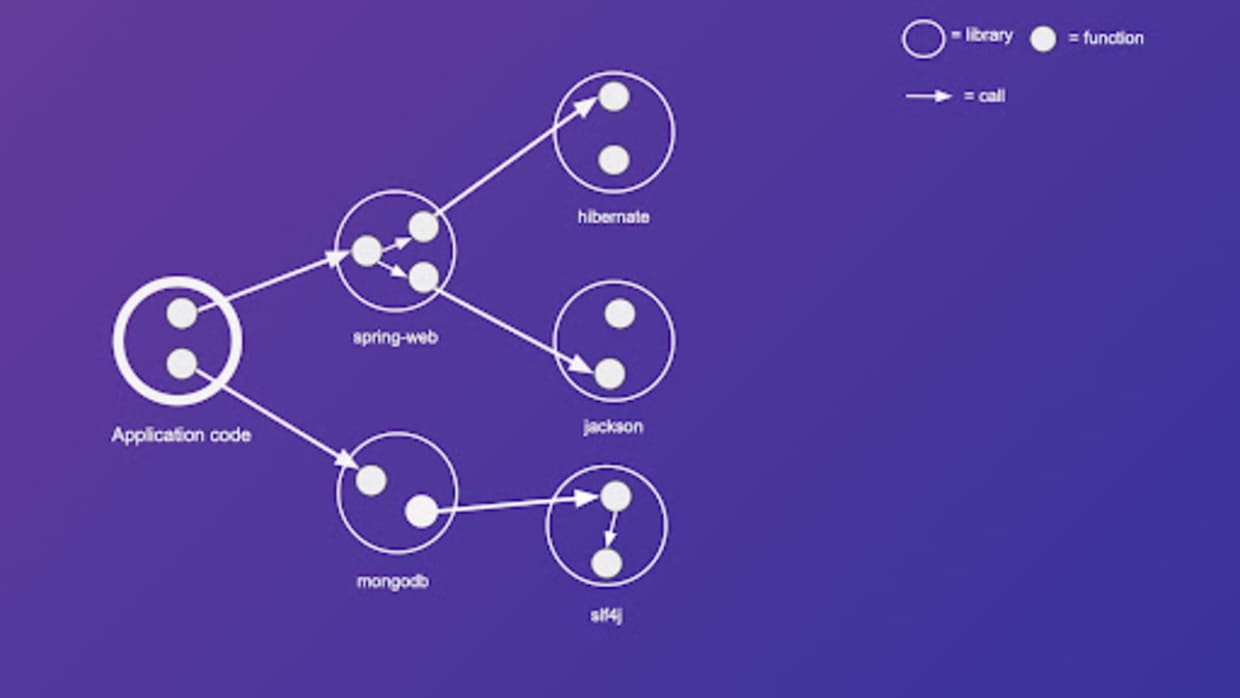
Das Ergebnis ist eine weithin bekannte Datenstruktur namens Aufrufgraph. Fügen wir diesem Graphen nun die verwundbaren Funktionen hinzu. Wir stellen sie als Krümelmonster dar.
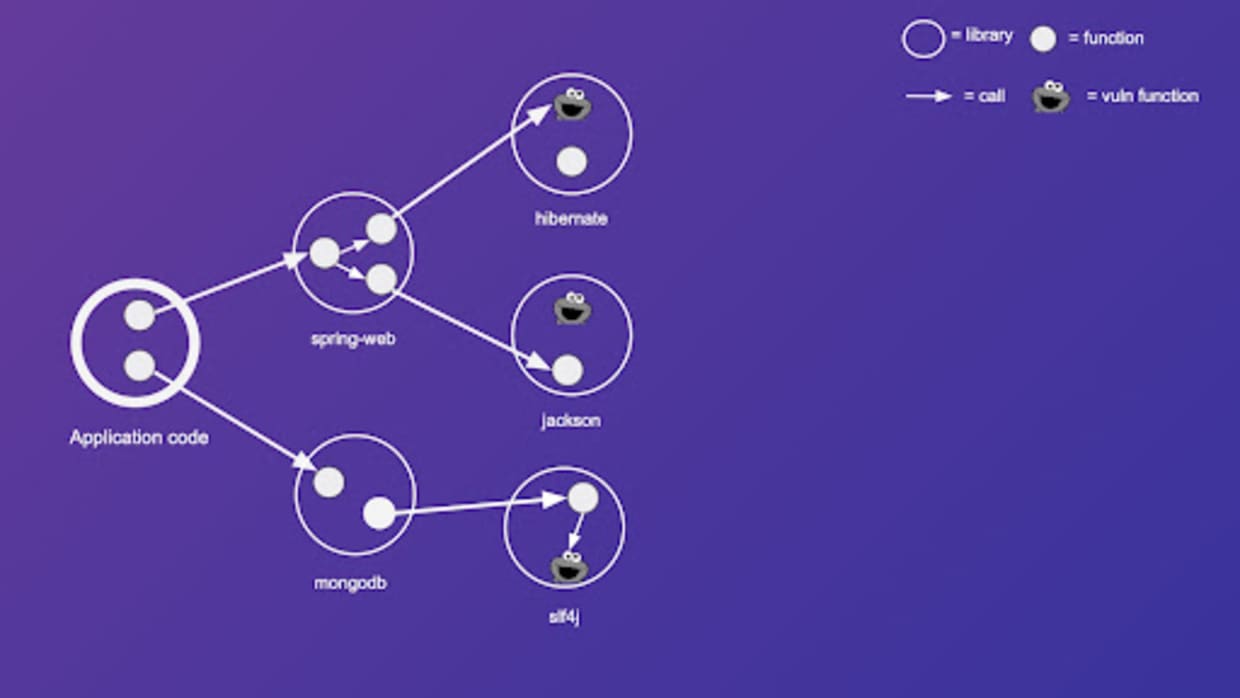
Definieren wir zum Schluss eine einfache Erreichbarkeitsregel für unseren Aufrufgraphen: Eine Funktion X ist genau dann vom Anwendungscode aus erreichbar, wenn es im Aufrufgraphen einen Pfad gibt, der bei einem beliebigen Knoten des Anwendungscodes beginnt und bei Funktion X endet. Nach dieser Regel färben wir alle erreichbaren Funktionen rot und nicht erreichbare Funktionen grün.
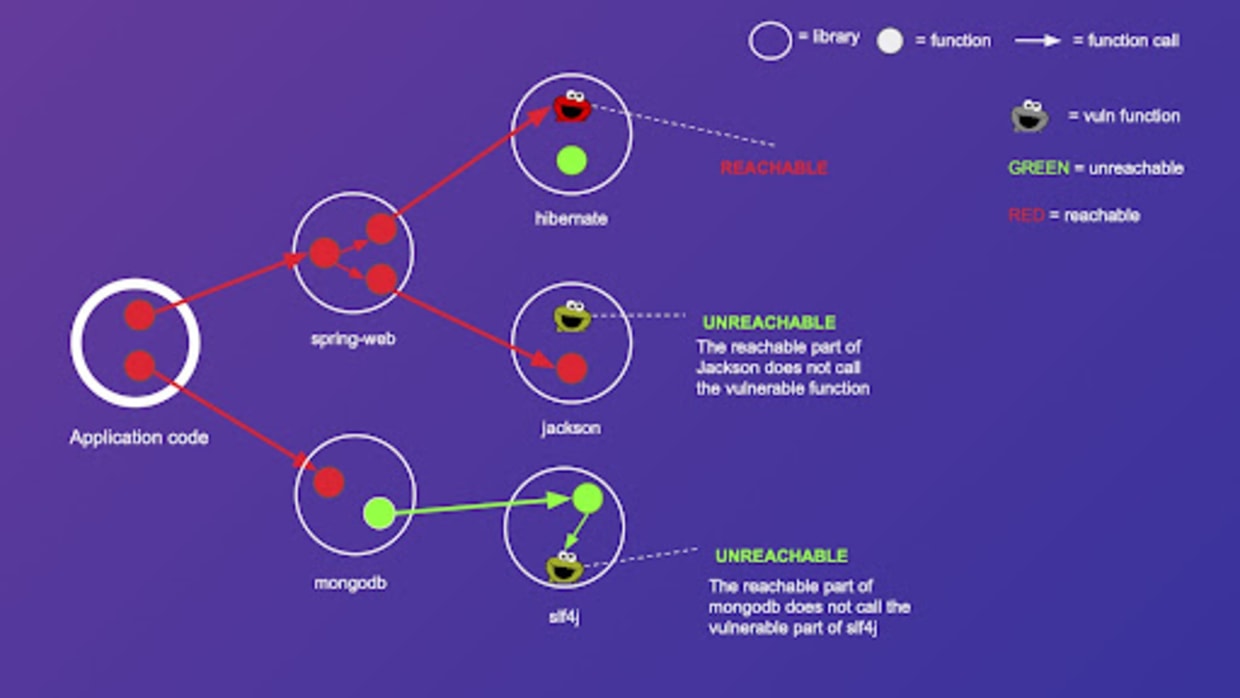
Wie wir sehen, sind einige Krümelmonster (verwundbare Funktionen) erreichbar und andere nicht. So können wir eine Regel zur Priorisierung von Schwachstellen in den Drittanbieter-Abhängigkeiten unserer App aufstellen. Wenn mindestens eine verwundbare Funktion, die einer bestimmten Schwachstelle zugeordnet ist, erreichbar ist, priorisieren wir die Behebung dieser Schwachstelle. Sind dagegen keine der zugehörigen verwundbaren Funktionen erreichbar, können wir die Behebung dieser Schwachstelle zurückstellen.
Wir haben nun definiert, was die Erreichbarkeitsanalyse anhand des Aufrufgraphen ist und wie sie uns bei der Priorisierung von Schwachstellen helfen kann. Doch wie berechnen wir den Aufrufgraphen tatsächlich?
Aufrufgraphen durch Ausführen der App erstellen
Eine Möglichkeit, den Aufrufgraphen zu erstellen, besteht darin, die App auszuführen und mithilfe eines Runtime-Agenten Daten zur Ausführung von Funktionen zu erfassen. Diese dynamische Lösung zur Laufzeit ist jedoch nicht ideal.
Erstens kommt sie im SDLC-Prozess „zu spät“, da sie Zugriff auf eine laufende Anwendung erfordert. Entwickler möchten erreichbare Schwachstellen jedoch möglichst erkennen und beheben, bevor Änderungen in den Main-Branch übernommen oder in die Produktion gebracht werden. Zweitens ist für die Einrichtung von Runtime-Agenten meist eine individuelle Konfiguration für jede Anwendung erforderlich, was viel Arbeit bedeutet. Schließlich zögern Entwickler, ihre Apps mit solchen Agenten zu ergänzen, weil sie Ausfälle oder Leistungseinbußen befürchten.
Das brachte uns auf eine bessere Lösung, die all diese Probleme des dynamischen Ansatzes behebt: die statische Codeanalyse.
Aufrufgraphen statisch berechnen
Anders als bei einer Lösung zur Laufzeit (dynamischen Lösung) wird bei der statischen Analyse das Programm nicht ausgeführt, um Informationen zu erfassen. Stattdessen analysieren wir den Quellcode der Anwendung. Dazu entwickeln wir einen Algorithmus, der Programmvariablen, Zuweisungen, Funktionsaufrufe, Zeiger und Ähnliches auswertet und auf dieser Grundlage den Aufrufgraphen ableitet.
In der Sicherheitsbranche ist die statische Analyse bereits recht bekannt, vor allem durch Static Application Security Testing (SAST). SAST soll Sicherheitsprobleme im Anwendungscode finden, zum Beispiel SQL-Injection.
Quelle: von einem polnischen Scherzbold veröffentlicht, vermutlich nie in der Praxis eingesetzt
Beachten Sie, dass sich unser Anwendungsfall von SAST unterscheidet. Wir decken keine Sicherheitslücken in Ihrem eigenen Code auf, sondern befassen uns mit Sicherheitslücken in Ihren Drittanbieter-Abhängigkeiten.
Wir nehmen also ein Programm (den Quellcode) und alle seine Abhängigkeiten (deren Quellcode) als Eingabe und geben einen Aufrufgraphen aus. Klingt einfach, oder?
Leider ist statische Analyse nicht einfach. Obwohl es sich um ein dynamisches Forschungsgebiet handelt, ist die Analyse realer Programme für die meisten Programmiersprachen noch immer teilweise ungelöst. Nehmen wir Java als Beispiel: Java scheint leicht analysierbar zu sein – die Sprache ist stark typisiert und im Vergleich etwa zu Javascript nicht sehr dynamisch. Sehen wir uns also genauer an, wie sich Aufrufgraphen für Java-Programme mithilfe statischer Analyse erstellen lassen und welche Herausforderungen dabei auftreten.
Herausforderung 1 bei der statischen Analyse – dynamischer Dispatch
Beim dynamischen Dispatch wird die auszuführende Methode erst zur Laufzeit ausgewählt und hängt vom Ausführungskontext ab. Dieses Verfahren kommt in den meisten Programmiersprachen vor – von objektorientierten Sprachen wie Java (Polymorphismus) bis hin zu funktionalen Sprachen wie Haskell (Funktionen höherer Ordnung und Closures). Dynamischer Dispatch ist eine Herausforderung für die statische Analyse, weil sie den Kontext modellieren muss, der bestimmt, welche Funktionen zur Laufzeit aufgerufen werden.
Betrachten wir das folgende Java-Beispiel. Nehmen wir an, es gibt ein Interface Animal mit einer Methode makeSound sowie drei Klassen, die dieses Interface implementieren: Dog, Cat und GoblinShark. Sehen wir uns das folgende einfache Programm an.
Wenn wir nur diese Methode betrachten (also den Code von createAnimal()) nicht berücksichtigen), können wir nicht feststellen, ob es sich bei animal um einen Dog, eine Cat oder vielleicht einen GoblinShark handelt.
Eine Möglichkeit, mit dieser Situation umzugehen, besteht darin, alle Möglichkeiten anzunehmen. Genau das tut ein Algorithmus zur Erstellung von Aufrufgraphen namens Class Hierarchy Analysis (CHA). Für das obige Beispiel würde CHA den folgenden Aufrufgraphen erstellen:
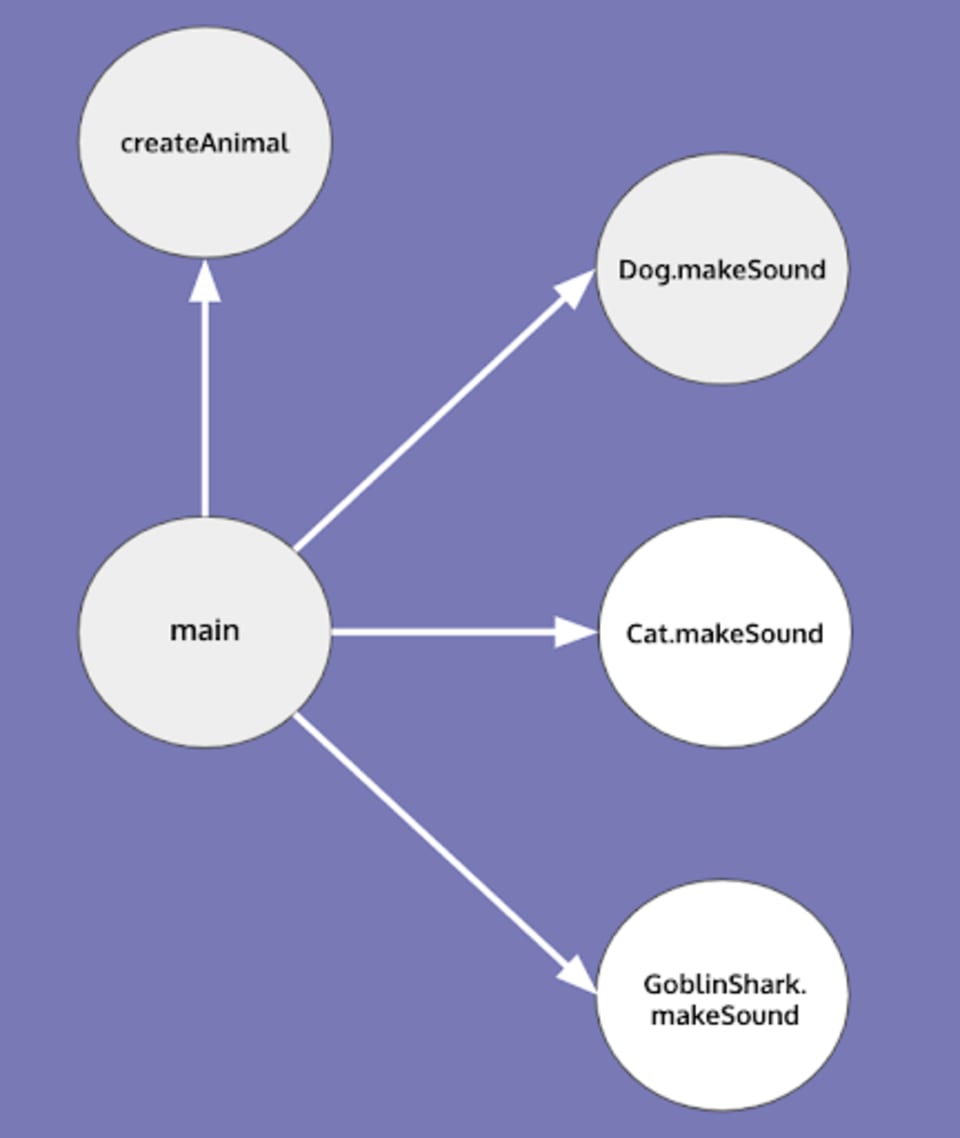
Dieser Aufrufgraph ist sound, aber möglicherweise nicht präzise. Betrachten wir zum Beispiel die zuvor ausgelassene Funktion createAnimal, die, wie sich herausstellt, ausschließlich Hunde erstellt.
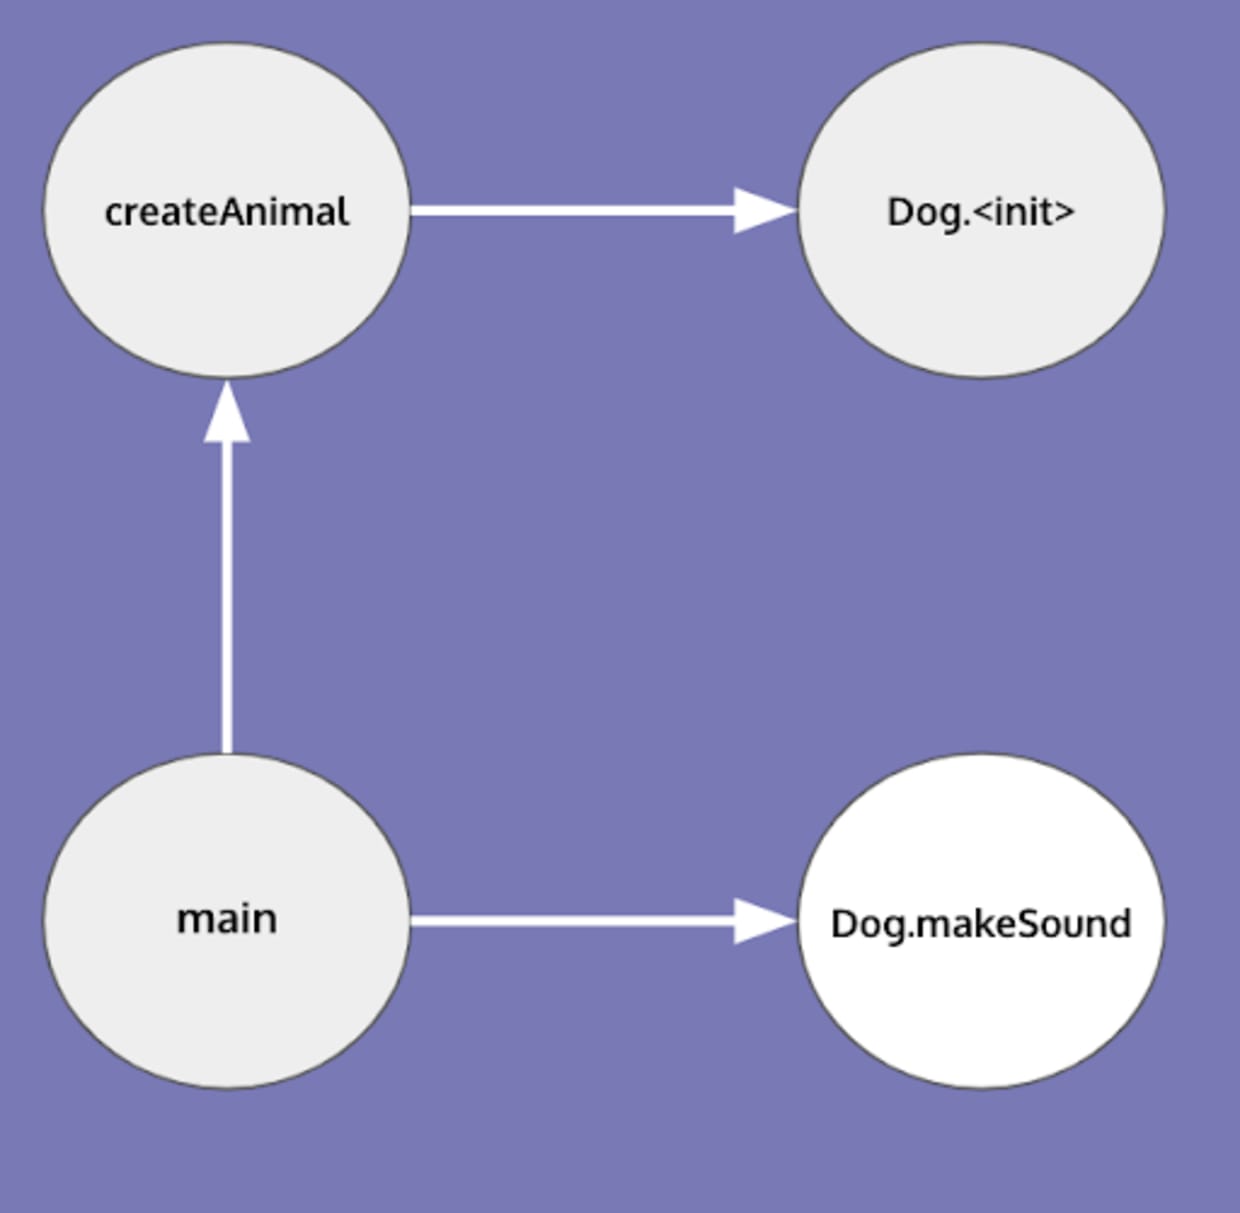
Da CHA alle Möglichkeiten annimmt, ändert sich der Aufrufgraph nicht und ist somit unpräzise. Die Analyse, die dieses Problem löst, heißt Points-to-Analyse. Dafür müssen die möglichen Werte nachverfolgt werden, auf die eine bestimmte Referenz verweist.
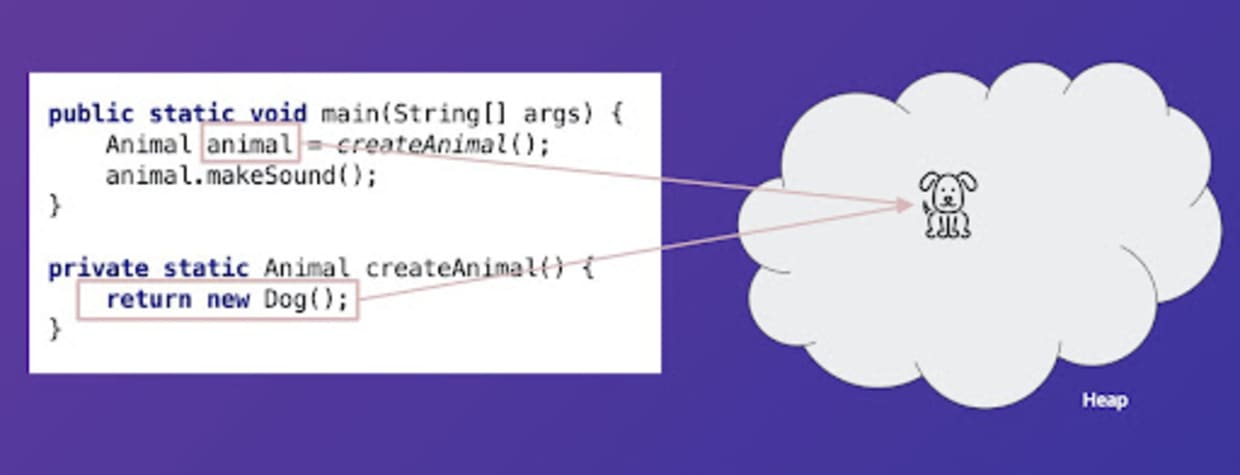
Die Points-to-Analyse von Andersen ist ein Beispiel für eine Analyse, die dies erreicht. Ein Algorithmus zur Erstellung von Aufrufgraphen, der die Points-to-Analyse von Andersen verwendet, würde die folgende Ausgabe erzeugen.
Kontrollfluss
Die Nachverfolgung von Zeigern wird noch schwieriger, wenn wir den Kontrollfluss des Programms berücksichtigen. Sehen wir uns den einfachsten Fall an:
Im obigen Programm gibt ein Hund niemals einen Laut von sich. Damit die statische Analyse dies erfolgreich feststellen kann, muss sie jedoch die Reihenfolge der Anweisungen berücksichtigen. Für einfache Programme wie das obige können wir einen alten Compiler-Trick anwenden und den Code in die statische Single-Assignment-Form (SSA) überführen. Bei SSA wird jede Variable im Programm genau einmal zugewiesen. Damit wäre das obige Problem gelöst.
Im Allgemeinen beeinflusst die Reihenfolge der Anweisungen jedoch den Programmzustand und kann dadurch auch den Aufrufgraphen beeinflussen. Ein gängiges Muster besteht beispielsweise darin, eine init-Funktion für eine Drittanbieter-Bibliothek aufzurufen, bevor ihre öffentlichen Methoden verwendet werden.
Die Methode init kann einen komplexen internen Zustand einrichten. Daher könnte sich der Aufrufgraph für das obige Programm stark von dem für das folgende Programm unterscheiden.
Ein weiterer wichtiger Aspekt sind Kontrollflussanweisungen wie if, while, for, switch usw. Betrachten wir das folgende Programm:
In diesem Fall ist es sinnvoll, die Bedingung zu ignorieren und anzunehmen, dass beide Zweige der if-Anweisung erreichbar sind. Aufgrund dieser Verzweigungen verfolgt die Points-to-Analyse in der Praxis für jede Variable im Programm eine Menge möglicher Zielwerte, statt nur einen einzelnen Wert.
Weitere Aspekte
Bei der Erstellung von Aufrufgraphen für moderne Programmiersprachen gibt es noch viele weitere Herausforderungen. Die obigen Beispiele kratzen nur an der Oberfläche des tatsächlichen Problemumfangs. Weitere Herausforderungen sind:
Collections: nachzuverfolgen, welche Werte an welchen Indizes innerhalb einer Collection gespeichert sind.
Öffentliche Methoden einer Bibliothek analysieren: In Sprachen wie Java verwenden öffentliche Bibliotheksmethoden häufig Interfaces als Eingabe, damit Kunden die Funktionalität anpassen können. Das erschwert die Points-to-Analyse solcher Methoden.
Dynamische Codeausführung: Ein sehr verbreitetes Muster, insbesondere bei Frameworks, besteht darin, den Namen einer Funktion zur Laufzeit zu erzeugen, ihn als Zeichenfolge zu speichern und eine spezielle Bibliothek zu verwenden, die den Funktionsnamen als Eingabe erhält und die Funktion ausführt (z. B. Reflection in Java).
In der Praxis müssen Sie bei der statischen Analyse ausdrücklich festlegen, was unterstützt werden soll, denn alles zu unterstützen wäre rechnerisch nicht machbar. Anders ausgedrückt: Der Einsatz statischer Analyse ist immer ein Kompromiss zwischen Präzision und rechnerischer Machbarkeit (Zeit und Ressourcen, die für die Berechnung des Ergebnisses benötigt werden). Bei der Erreichbarkeitsanalyse von Aufrufgraphen in Java-Programmen könnte ein solcher Kompromiss beispielsweise darin bestehen, eine standardmäßige Andersen-Punkte-Analyse mit SSA auszuführen, bei bedingten Verzweigungen (z. B. if-Anweisungen) immer alle Pfade anzunehmen, alle Collections wie Bags zu analysieren (Indizes spielen keine Rolle) und dynamische Codeausführung zu ignorieren (mit Ausnahme beliebter Frameworks wie Spring).
Fazit
In diesem Blogbeitrag haben wir gezeigt, wie sich erreichbare Schwachstellen durch eine Kombination aus fundierter Sicherheitsforschung und automatisierter statischer Analyse identifizieren lassen. Das Ergebnis einer solchen Analyse ist immer eine Annäherung an die Realität. Diese Annäherung ist jedoch hilfreich, insbesondere wenn Sie als Entwickler:in Schwachstellen ermitteln möchten, die mit hoher Wahrscheinlichkeit ein unmittelbares Risiko für Ihr Unternehmen darstellen.
Bei Snyk tun wir alles, um Entwickler:innen bei der Bewältigung ihrer Sicherheitsprobleme zu unterstützen. Vor Kurzem haben wir mehrere Funktionen veröffentlicht, die Entwickler:innen dabei helfen, Schwachstellen zu priorisieren. Die Erreichbarkeit von Schwachstellen bewerten ist eine davon. Wie Sie die Funktion nutzen, erfahren Sie in der Ankündigung zur Veröffentlichung.
Bleiben Sie sicher und geschützt!
Starten Sie mit Capture the Flag
Erfahren Sie in unserem virtuellen On-Demand-Workshop für Einsteiger, wie Sie Capture-the-Flag-Herausforderungen lösen.