Das 89-%-Problem: Wie LLMs die „schlafende Mehrheit“ von Open Source wiederbeleben


4. März 2026
0 Min. LesezeitKI-Coding-Assistenten beleben unauffällig Millionen verlassener Open-Source-Pakete wieder. In den vergangenen zehn Jahren verließen sich Entwickler auf eine einfache Faustregel für Open-Source-Sicherheit: Verbreitung \= Vertrauen. Wurde ein Paket millionenfach pro Woche heruntergeladen (lodash, react, requests), nahmen wir an, es sei „sicher genug“, weil Tausende von Augen darauf gerichtet waren. Bei wenig bekannten Paketen waren wir vorsichtig.
Menschliche Entwickler orientieren sich an sozialen Vertrauenssignalen wie Beliebtheit, Wartungsaktivität und Akzeptanz in der Community. Dieses Modell der „Weisheit der Vielen“ funktionierte, weil menschliche Entwickler grundsätzlich soziale Wesen sind. Wir bleiben auf den „ausgetretenen Pfaden“, die unsere Kollegen angelegt haben. Generative KI beginnt dieses Modell jedoch aufzubrechen.
KI-Systeme wählen Pakete anhand statistischer Muster in Trainingsdaten aus, die die gesamte Geschichte des Internets umfassen – einschließlich Millionen verlassener Projekte und experimenteller Repositories. LLMs arbeiten probabilistisch. Sie verstehen „Beliebtheit“ oder den „Wartungszustand“ nicht so wie menschliche Architekten oder Entwickler. Stattdessen leiten sie statistische Wahrscheinlichkeiten aus Trainingsdaten ab, die die gesamte Geschichte des Internets umfassen – das Gute, das Schlechte und das Verlassene.
Wir haben Snyk Advisor entwickelt und anschließend in unsere Security DB integriert, um die Lücke zwischen Open-Source-Informationen und dem Zustand von Paketen zu schließen. Entwickler und Agenten erhalten so verschiedene Datenpunkte zu Sicherheit, Beliebtheit, Wartung und Community. Wie kann Snyks Informationen zum Zustand von Paketen KI-Agenten unterstützen? Hier ist unsere Einschätzung.
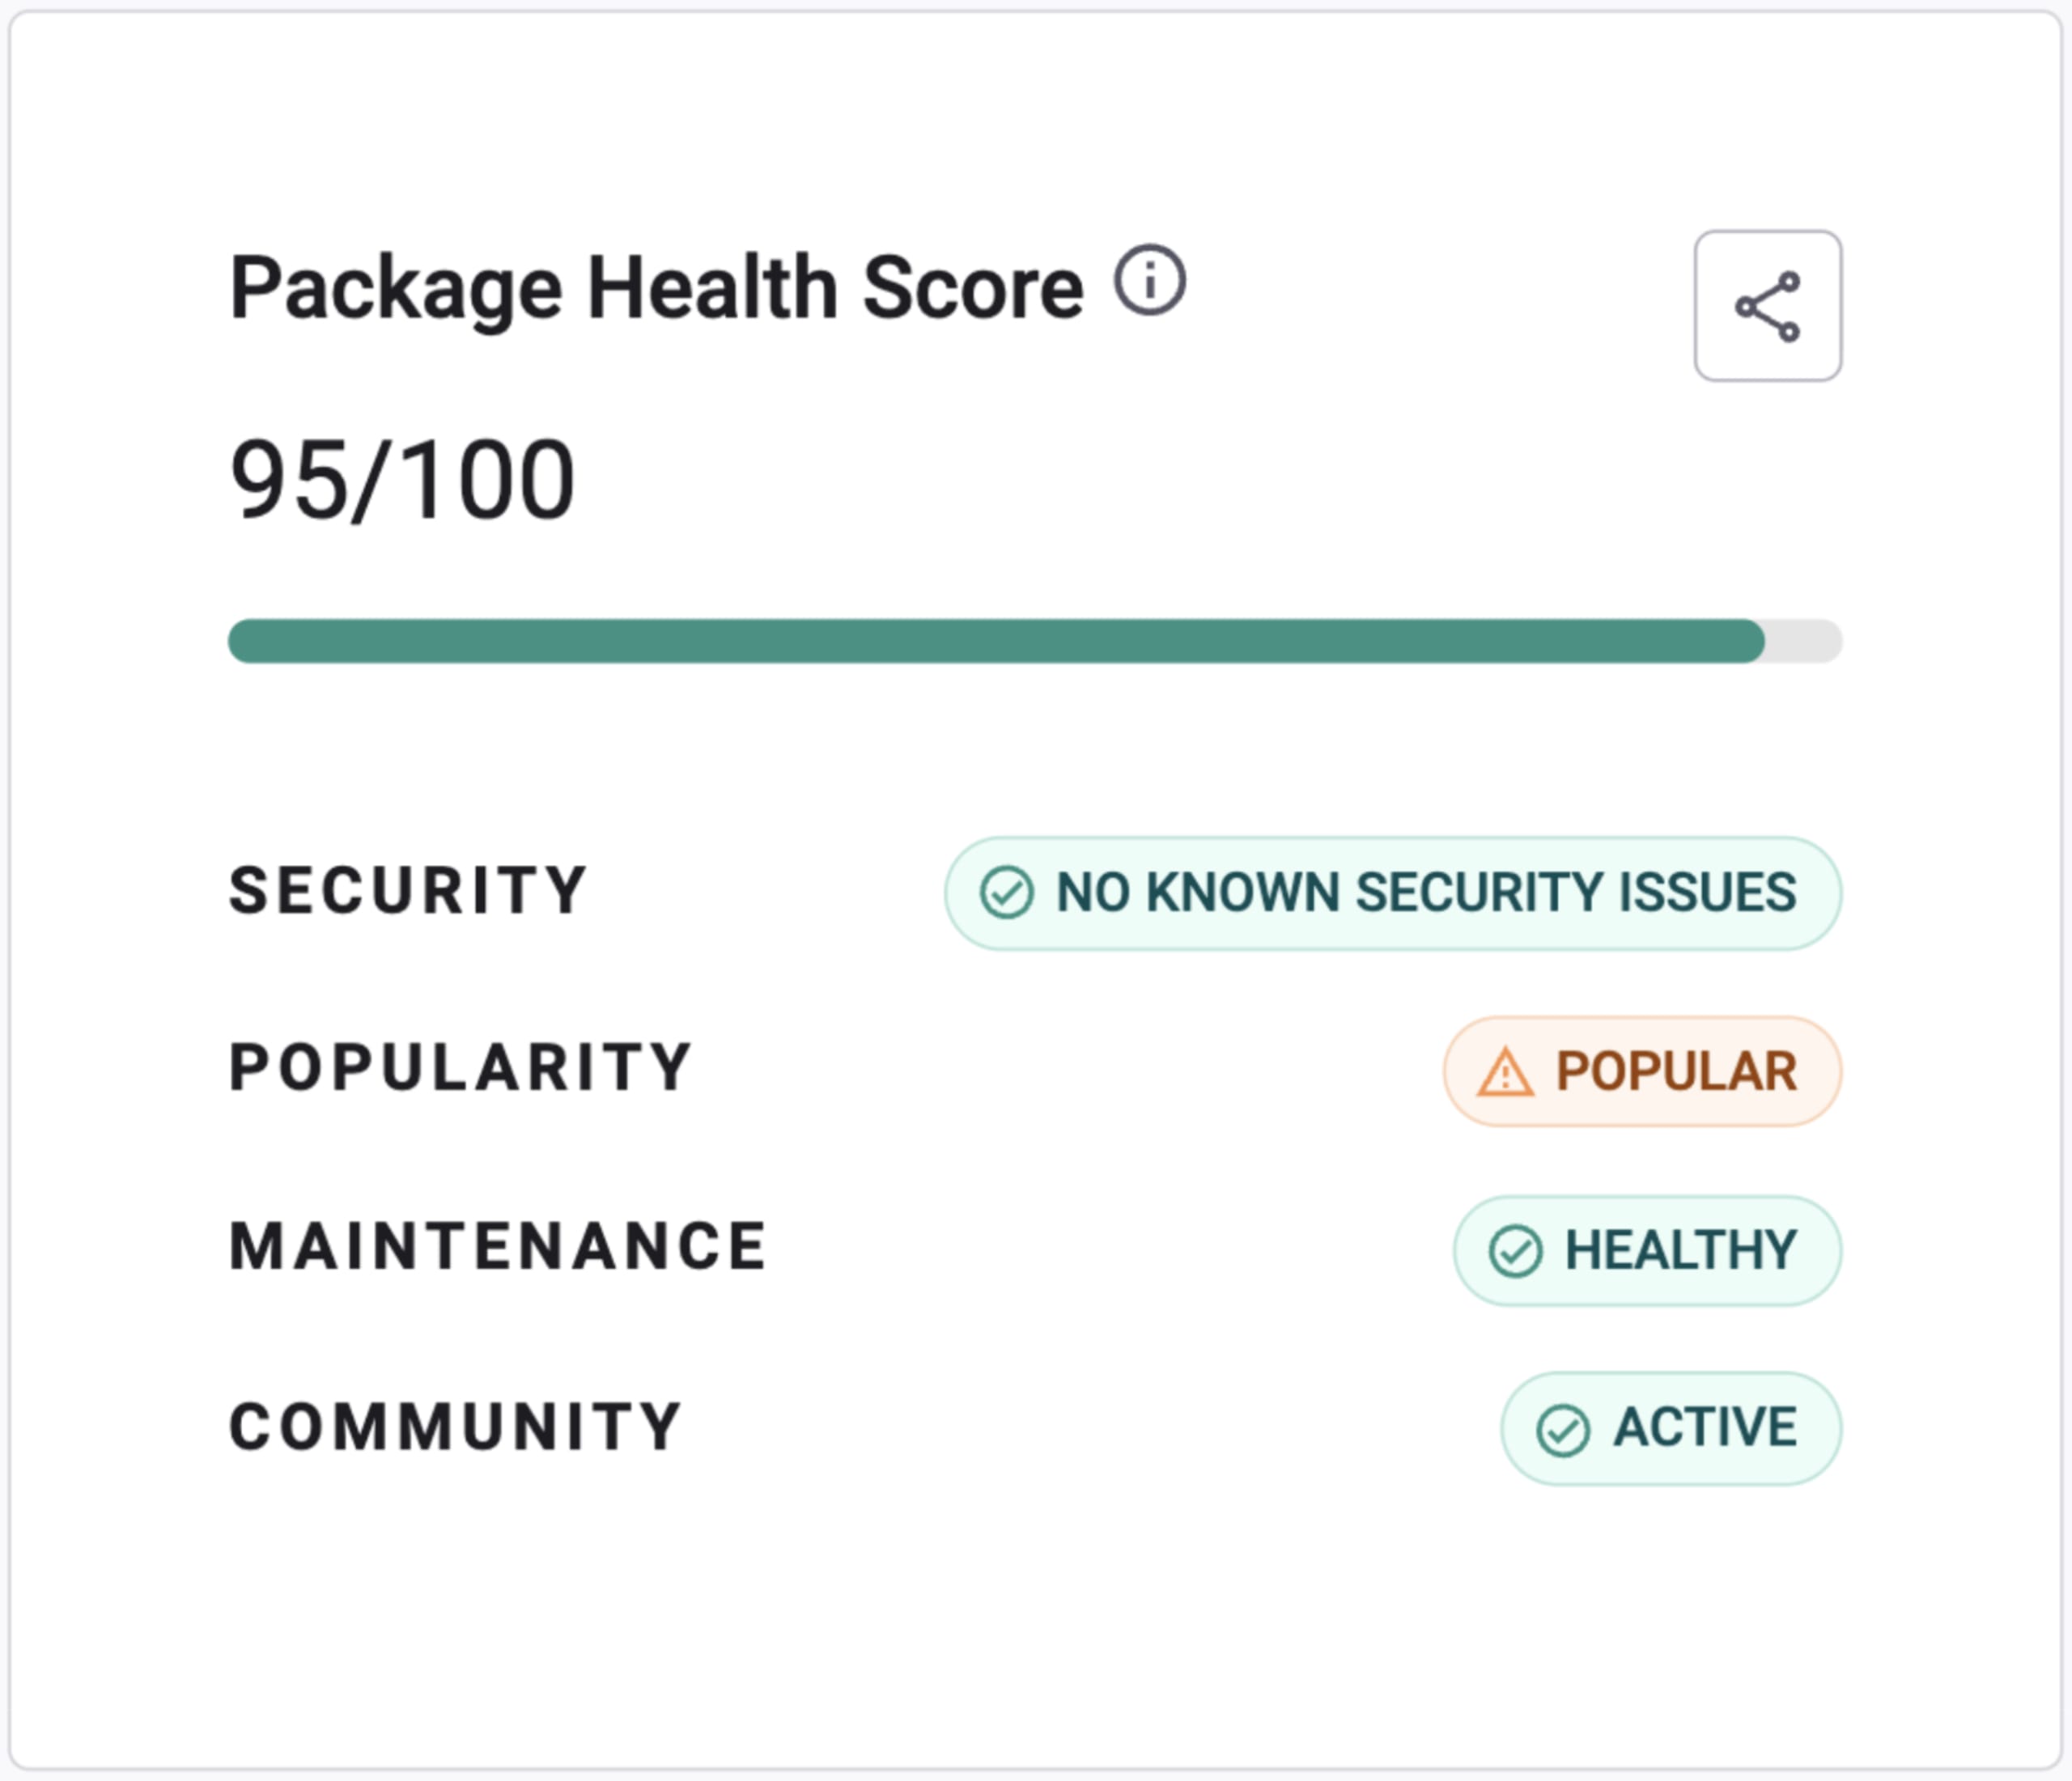
Die Daten: Die „schlafende Mehrheit“ im Überblick
Bei der Analyse des Open-Source-Ökosystems zeigt sich ein auffälliges Muster: Eine sehr kleine Zahl von Paketen bildet die Grundlage für einen Großteil des modernen Internets, während die große Mehrheit selten genutzt oder vollständig aufgegeben wird.
Um das Risiko zu verstehen, müssen wir uns die Struktur des Open-Source-Ökosystems erneut ansehen. Snyk hat wichtige Daten zum Census-II-Bericht der Linux Foundation und Harvard beigetragen, der die Realität der Supply Chain abbildet. Legt man die Daten zum Zustand der Pakete über die Verbreitung, zeigt sich eine deutliche Hierarchie:
Nutzungskategorie | In % der Projekte enthalten | Ungefähre Anzahl | Beschreibung | Zustand der Pakete auf Snyk Advisor | Beispiele |
|---|---|---|---|---|---|
Die globalen Konstanten | 90 %–100 % | \~1.000 Pakete | Die „Infrastruktur“ des Internets. Tiefe transitive Abhängigkeiten, auf die sich fast jede moderne App stützt. |
|
|
Die Branchenstandards | 15 %–50 % | \~20.000 Pakete | Die wichtigsten Frameworks, die Entwickler gezielt für den Aufbau der Kernarchitektur auswählen. |
|
|
Die Spezialisten für bestimmte Bereiche | 1 %–5 % | \~100.000 Pakete | Professionelle Tools für bestimmte Branchen oder komplexe technische Nischen. |
|
|
Der aktive Long Tail | \< 0,1 % | \~600.000+ Pakete | Gültiger, funktionierender Code für sehr spezielle Anwendungsfälle oder eine engagierte Community. |
| |
Die schlafende Mehrheit | \~0 % | \~6,3 Millionen+ Pakete | Die 89,5 %. Verlassene Projekte, „Hello World“-Tests, nicht gepflegte Forks und einmalige Experimente. |
|
Fast 90 % des Open-Source-Ökosystems gehören zur schlafenden Mehrheit – Millionen verlassener Experimente, Forks und nicht gepflegter Projekte. Menschliche Entwickler wählen nur selten Pakete aus dieser Kategorie. KI-Systeme dagegen schon.
Die Diskrepanz bei KI
Menschliche Entwickler bewegen sich ganz natürlich in den oberen Kategorien des Ökosystems – bei weit verbreiteten Frameworks, vertrauenswürdigen Infrastruktur-Bibliotheken und ausgereiften Tools für bestimmte Fachbereiche. Da LLMs mit umfangreichen Code-Repositories aus der gesamten Geschichte des Internets trainiert werden, können sie Pakete aus allen Bereichen des Ökosystems vorschlagen, auch aus der schlafenden Mehrheit.
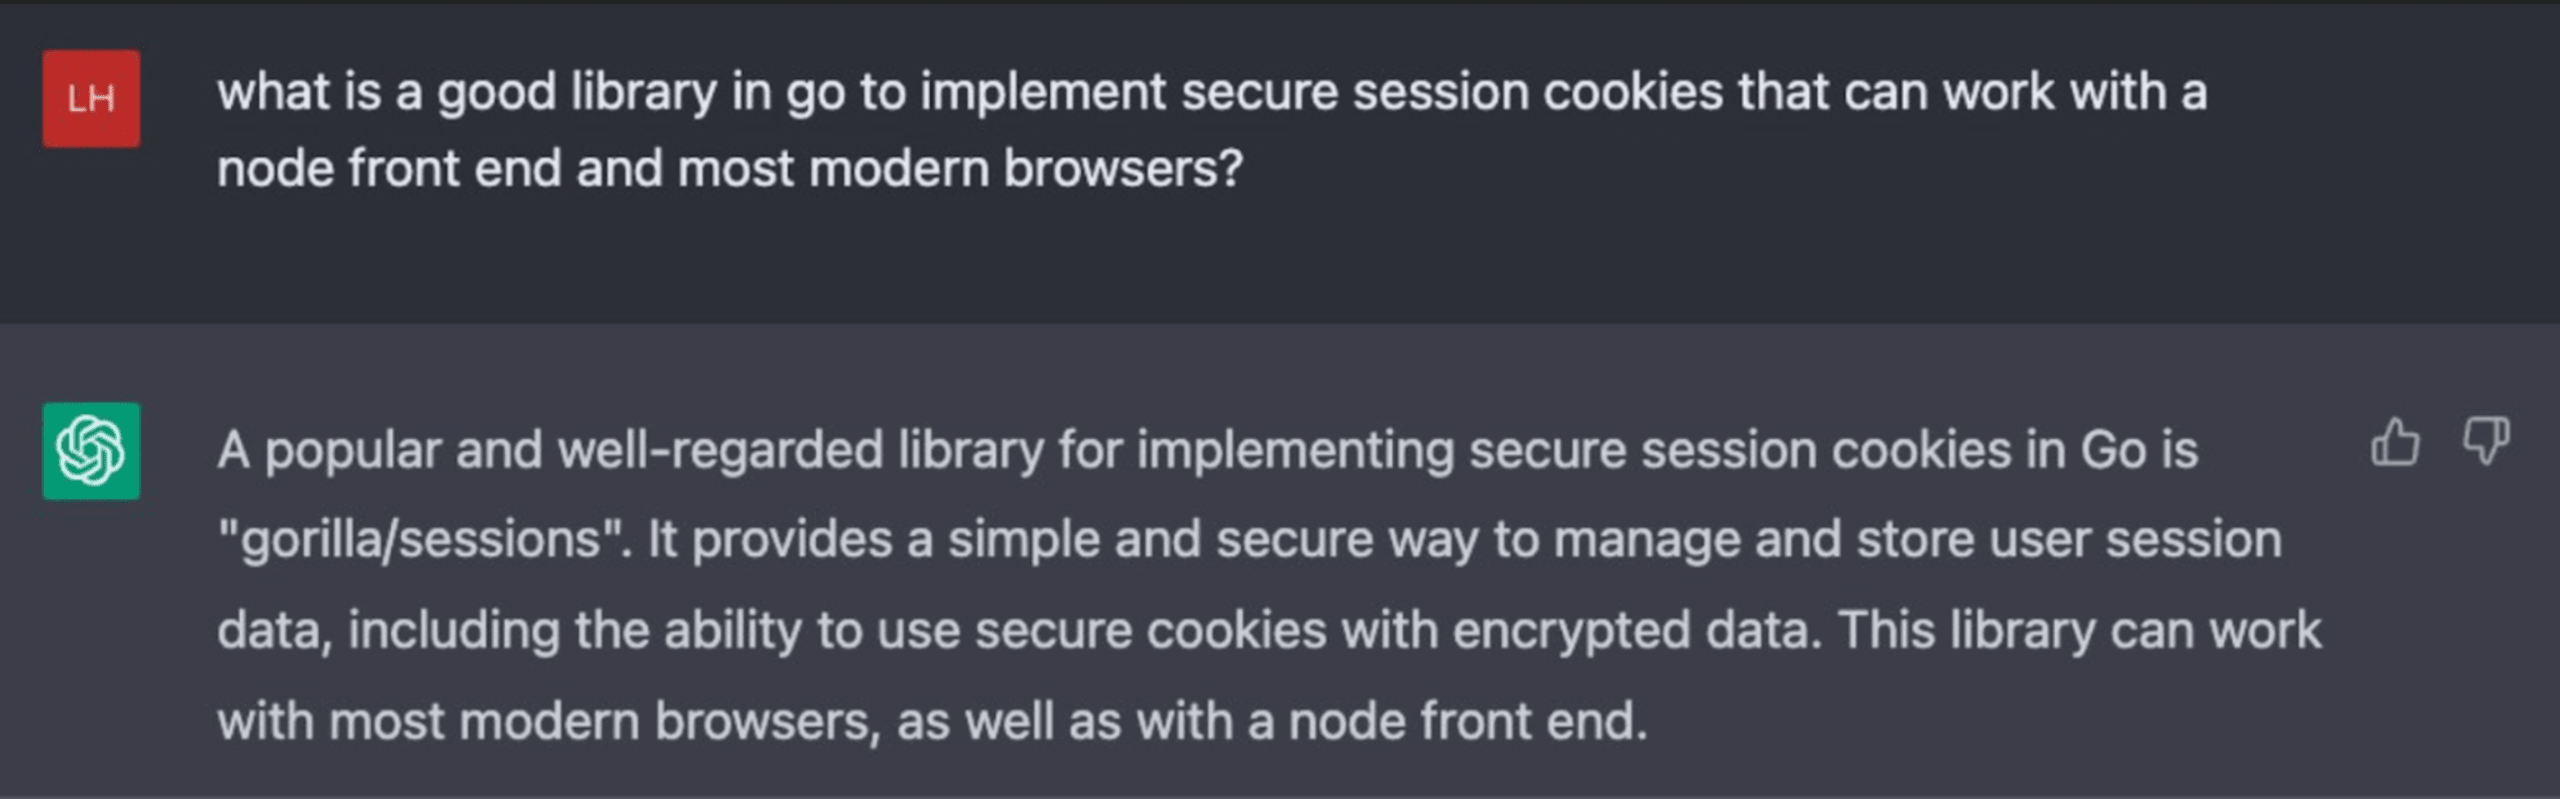
Daher können LLMs Pakete aus den unteren 89,5 % des Ökosystems empfehlen: verlassene Projekte, nicht gepflegte Forks und sogar einfache „Hello World“-Experimente. So berichtete der Sicherheitsforscher Luke Hinds von einer Interaktion, bei der ein LLM das Go-Paket gorilla/sessions empfahl:
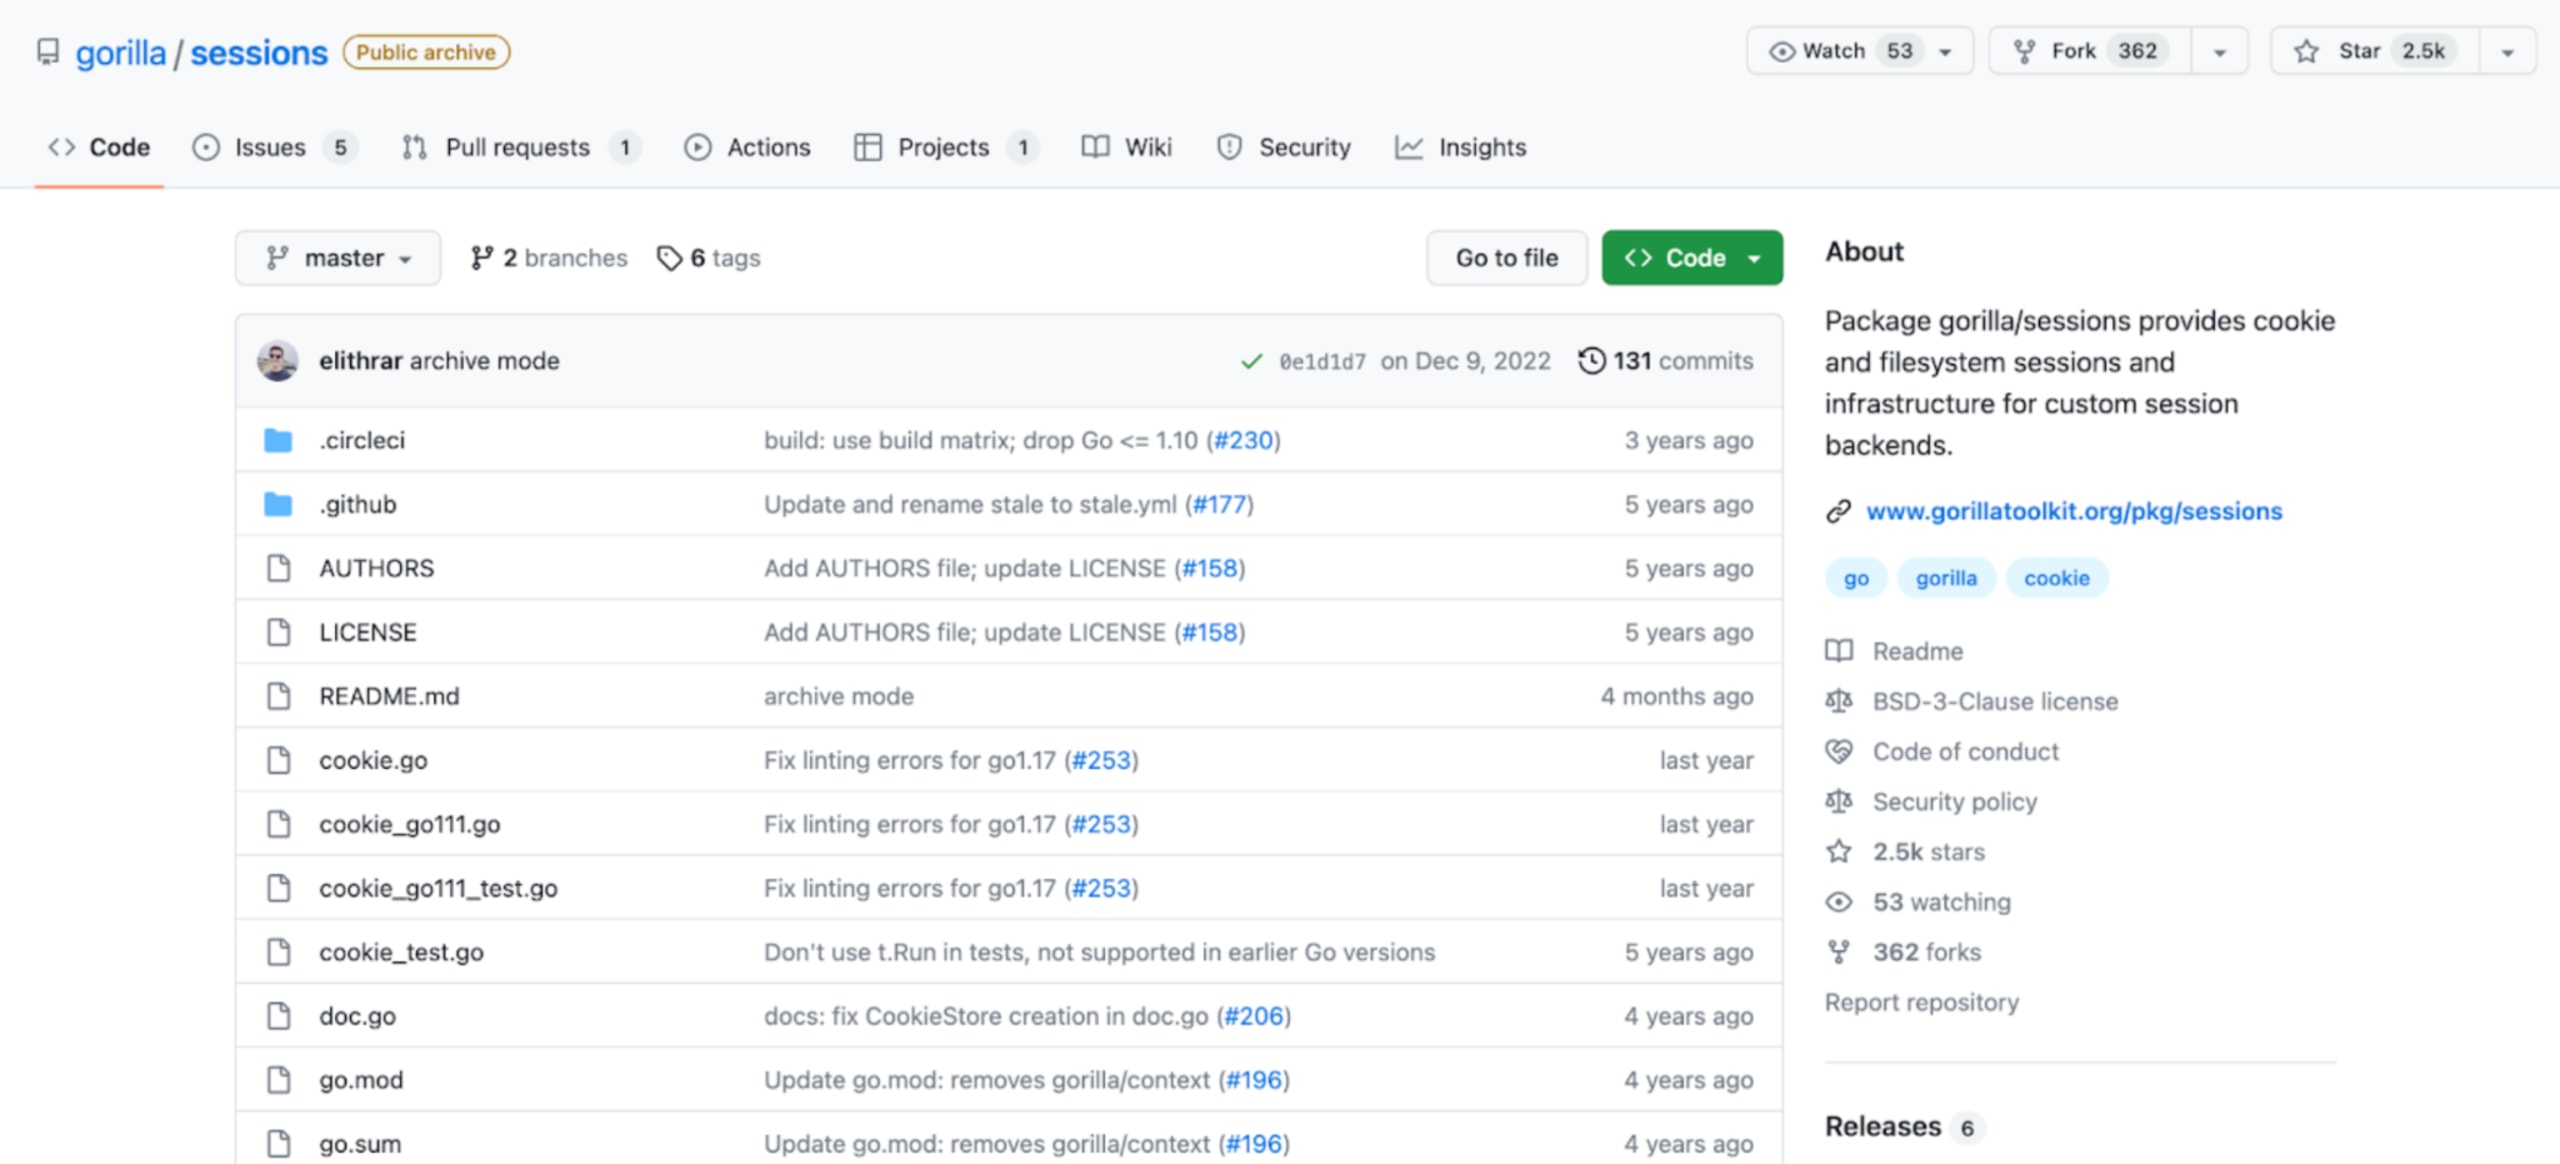
Das Problem mit dieser LLM-Empfehlung: gorilla/sessions wurde archiviert. Da archivierte Repositories keine Updates mehr erhalten, führt die Verwendung dieses Pakets zu langfristigem Wartungsaufwand und ungepatchten Supply-Chain-Risiken.
Noch problematischer sind Halluzinationen von LLMs (oder „KI-Paket-Halluzinationen“): Sie empfehlen mit voller Überzeugung Pakete, die nie existiert haben. Dadurch entstehen zwei neue Angriffsvektoren:
Die Wiederbelebung von Zombie-Paketen: Ein LLM schlägt ein fünf Jahre altes, nicht gepflegtes Paket aus der „schlafenden Mehrheit“ vor, weil es ein spezielles Nischenproblem löst. Es weist 0 CVEs auf (weil niemand danach sucht), enthält aber kritische Schwachstellen.
Slopsquatting (KI-Halluzinationsangriffe): Angreifer sagen häufige Paketnamen voraus, die LLMs halluzinieren (z. B. huggingface-cli-tool statt des echten huggingface-cli), und registrieren diese mit schädlicher Payload. Wenn eine KI dieses „logische“, aber gefälschte Paket vorschlägt, installiert der Entwickler Malware.
Der strategische Kurswechsel: von „Beliebtheit“ zu „Herkunft“
Als CISO können Sie sich nicht darauf verlassen, dass Ihre Entwickler jeden KI-Vorschlag manuell prüfen. Dafür ist das Tempo zu hoch. Sie müssen Ihr Programm darauf ausrichten, nicht nur nach Schädlichem zu suchen, sondern gezielt für Sicherheit zu sorgen. In früheren Beiträgen haben wir die Rollen von CISOs und ihre sich wandelnden Verantwortlichkeiten beleuchtet.
Auch als Entwickler können Sie sich nicht vollständig darauf verlassen, dass KI-Coding-Agenten Pakete von npm oder PyPI auswählen und installieren. Die inhärenten Risiken der Software-Supply-Chain können dazu führen, dass ein schädliches Paket Malware einschleust oder Daten abgreift – etwa über die Paketmanager-Funktion postinstall von npm.
Wie können wir KI-Coding-Agenten und Softwareentwickler mit Faustregeln zum Zustand von Paketen ausstatten, damit sie sicherere, autonome Ergebnisse erzielen? Mit Snyks bewährtem Pfad.
1. Vertrauenswürdige Pakete mit security.snyk.io finden
Bevor sie eine Abhängigkeit auswählen, benötigen Entwickler und KI-Systeme Einblick in den Ruf und die Vertrauenswürdigkeit von Open-Source-Paketen. Die neue Snyk-Security-Database-Erfahrung bietet eine zentrale Übersicht über Vertrauenssignale von Paketen. So können Teams in unterstützten Ökosystemen schnell weit verbreitete, gut gepflegte und renommierte Projekte erkennen.
Strategie: Regen Sie Entwickler und Plattformteams dazu an, bei der Suche nach Paketen die Einblicke der Snyk Security Database zu nutzen, um frühzeitig im Auswahlprozess ausgereifte, vertrauenswürdige Abhängigkeiten zu bevorzugen.
2. Die Snyk Package Health API prüft den Zustand, nicht nur auf Schwachstellen
Ein Paket ohne bekannte Schwachstellen ist nicht zwangsläufig sicher. Es könnte verlassen, nicht gepflegt oder ohne vertrauenswürdige Community sein. Sichere Software-Supply-Chains erfordern eine Bewertung des Paketzustands über CVEs hinaus. Die Snyk Package Health API liefert Informationen zu Paketen und einzelnen Versionen in wichtigen Ökosystemen (npm, PyPI, Maven, NuGet und Go) und macht unter anderem folgende Signale sichtbar:
Sicherheitslage.
Wartungsaktivität und Lebenszyklusindikatoren.
Beliebtheit und Akzeptanz.
Signale zur Beteiligung der Community.
So können Engineering-Plattformen, CI/CD-Pipelines und KI-gestützte Entwicklungstools die Qualität, Nachhaltigkeit und Ökosystemrisiken einer Abhängigkeit automatisch bewerten, wenn sie in Betracht gezogen wird – insbesondere zum Zeitpunkt ihrer Auswahl oder Einführung.
Strategie: Integrieren Sie Informationen zum Zustand von Paketen direkt in Workflows zur Auswahl von Abhängigkeiten und in KI-gestützte Entwicklungsumgebungen. So lässt sich die Eignung eines Pakets bewerten, bevor eine Abhängigkeit hinzugefügt wird – nicht erst nach der Installation.
Tools: Nutzen Sie die Snyk Package Health API als Grundlage für die Paketauswahl, Upgrade-Planung und automatisierte Governance von Abhängigkeiten. Implementierungsdetails finden Sie unter Package level endpoint und Package version level endpoint.
Wenn Sie SCA über CLI, CI oder GitHub-CI-Prüfungen integrieren, erkennt Snyk Open Source diese ungeeigneten LLM-Coding-Vorschläge auch während und vor einem Build (stellen Sie sich vor, der Coding-Agent plant ein npm install … für ein schädliches Paket).
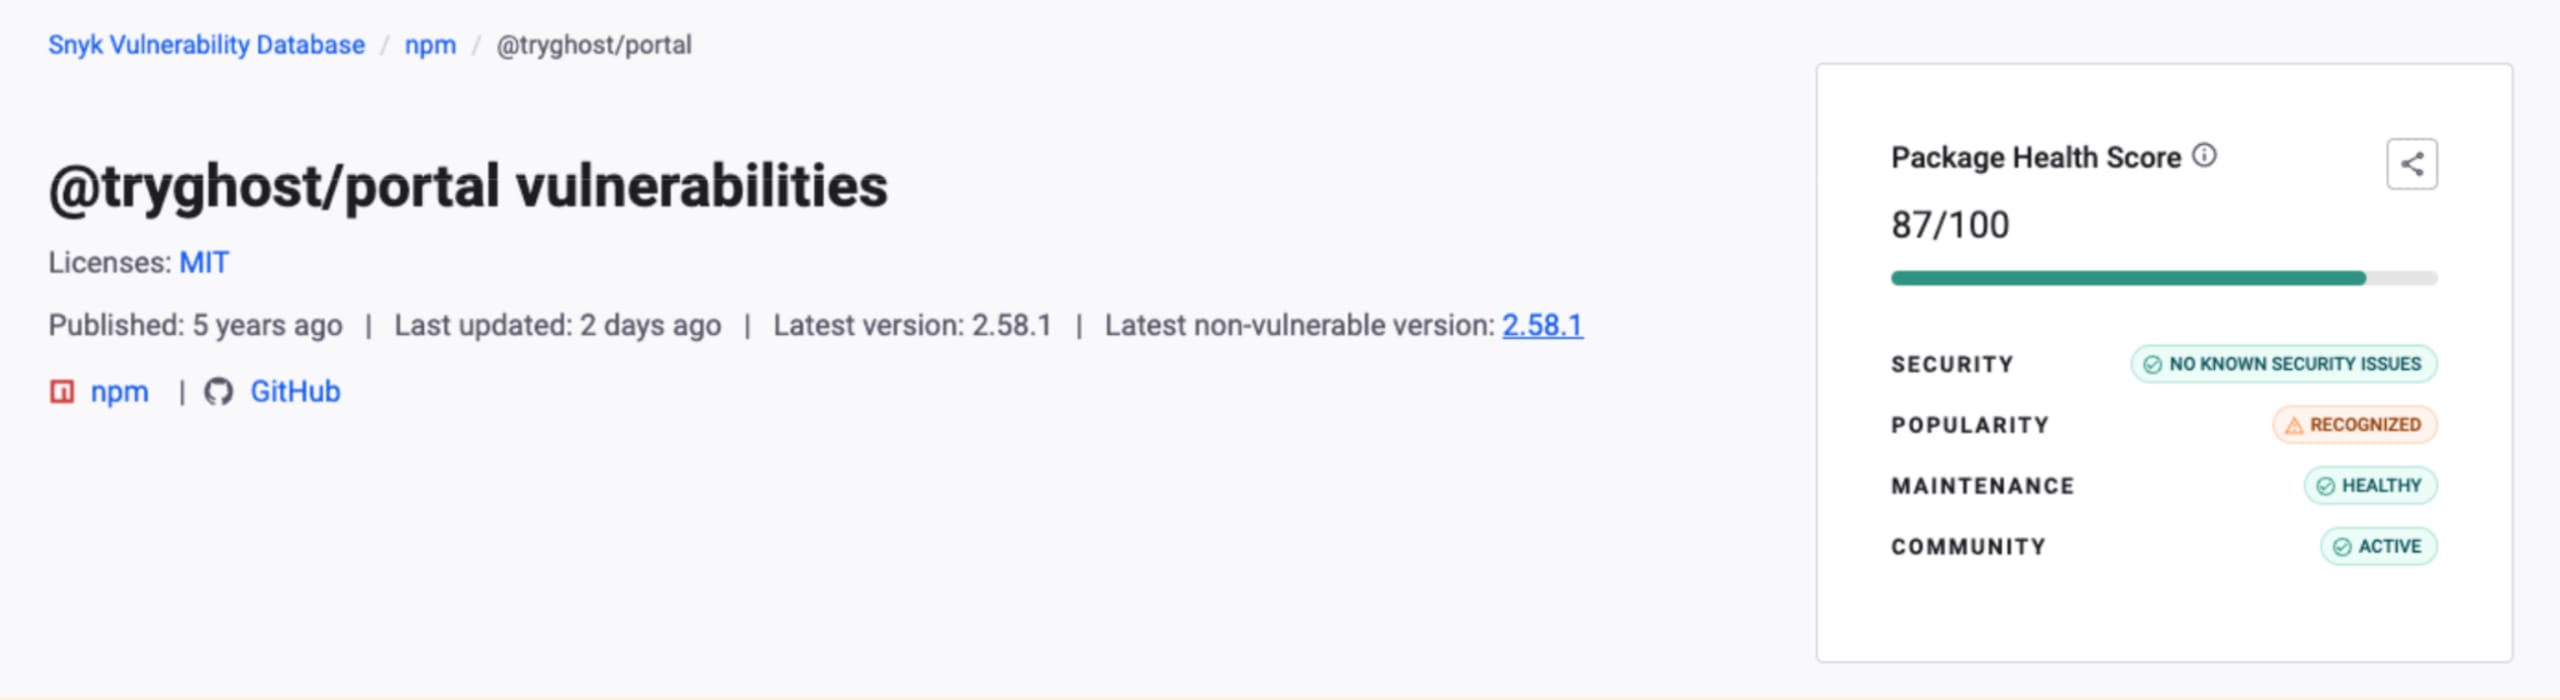
3. Mit Snyk Studio die Sicherheit von Abhängigkeiten bei ihrer Einführung durchsetzen
Selbst wenn entsprechende Informationen verfügbar sind, können Entwickler und KI-Coding-Assistenten weiterhin automatisch Abhängigkeiten einführen. Sicherheit muss daher bereits bei der Auswahl einer Abhängigkeit gewährleistet werden – nicht erst bei CI/CD-Scans.
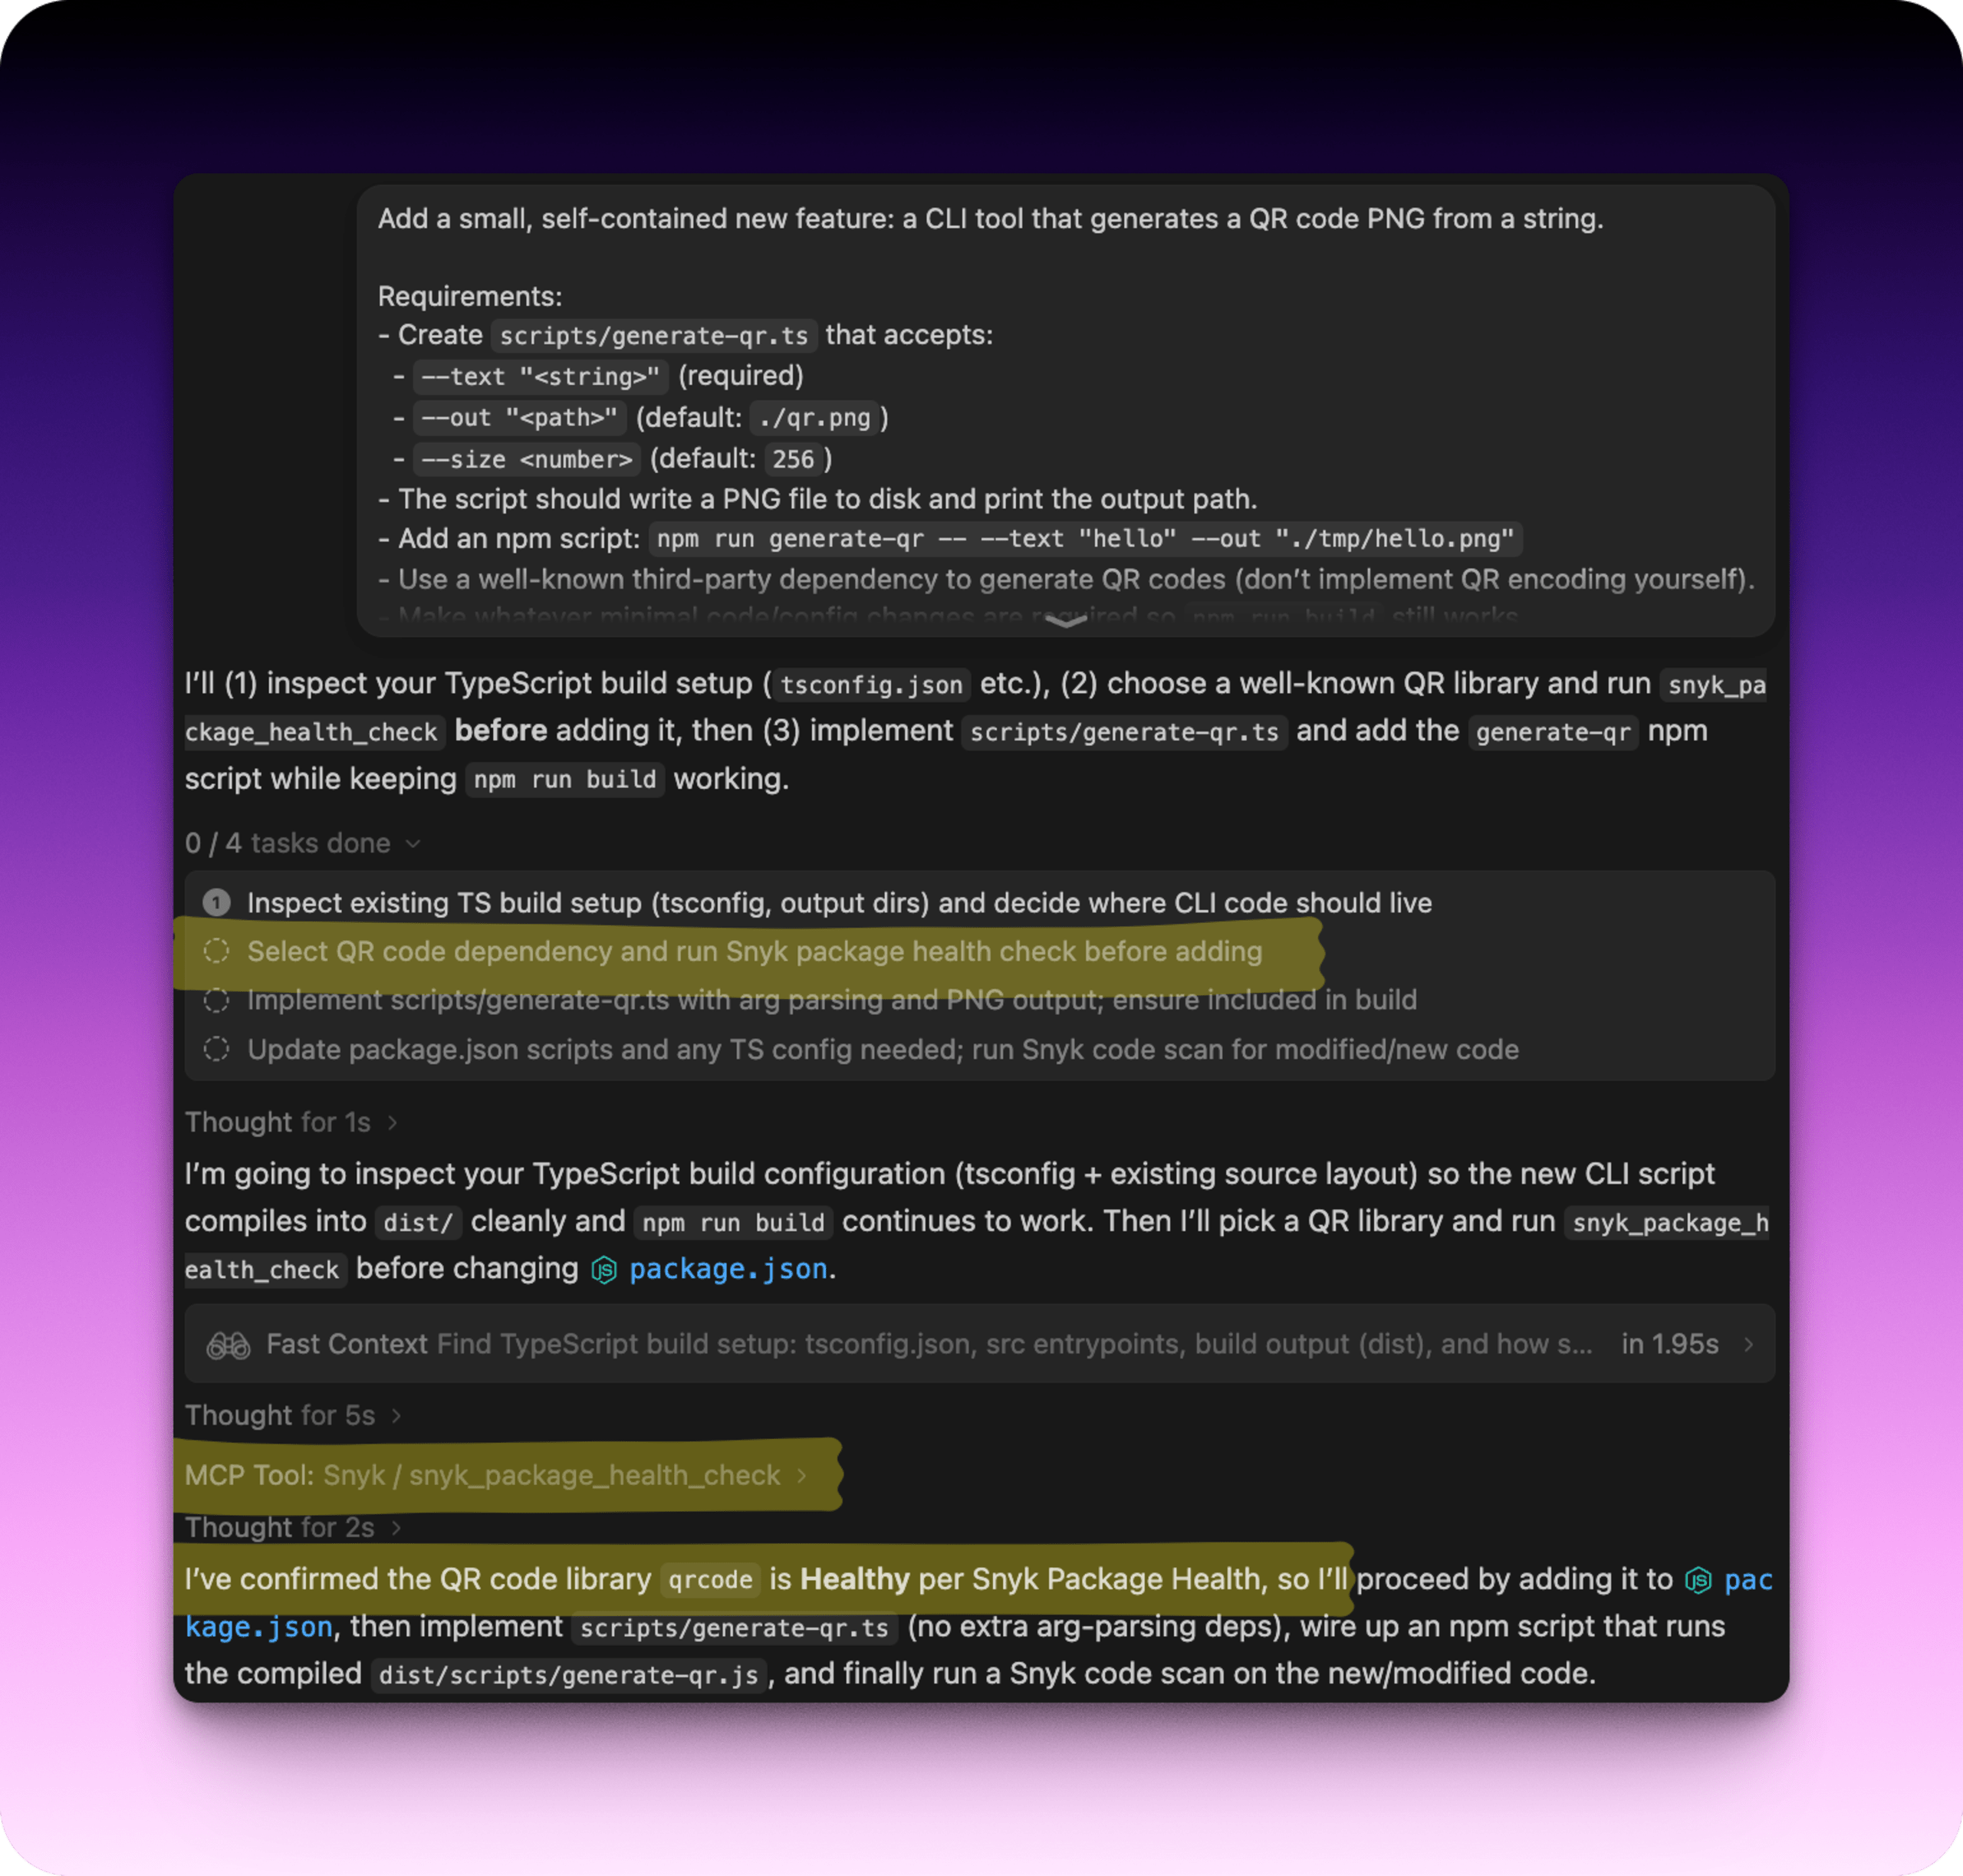
Der Snyk Studio Package Health Flow integriert Informationen zum Zustand von Paketen direkt in KI-gestützte Entwicklungs-Workflows. Wenn ein KI-Coding-Assistent das Hinzufügen oder Aktualisieren einer Abhängigkeit vorschlägt, kann Snyk Studio automatisch vor der Installation eine Zustandsprüfung des Pakets ausführen und so Risiken in Echtzeit bewerten. Dadurch können Unternehmen ungesunde, nicht gepflegte oder riskante Pakete möglichst früh aus ihrer Codebasis fernhalten – beim „Schutz von Anfang an“.
Strategie: Konfigurieren Sie KI-Coding-Assistenten so, dass sie vor der Einführung neuer Abhängigkeiten automatisch eine Package-Health-Prüfung ausführen. Bei erkannten Risikosignalen sollen sie die Installation anhalten oder blockieren und für die Fortsetzung eine ausdrückliche Zustimmung des Nutzers verlangen.
4. Schutz vor Halluzinationen
KI-Coding-Assistenten empfehlen gelegentlich Pakete, die in öffentlichen Registries nicht existieren. Solche Meldungen „Paket nicht gefunden“ sollten als mögliche Signale für Supply-Chain-Sicherheitsrisiken gelten und nicht als einfache Entwicklerfehler. Angreifer könnten später Pakete mit ähnlichen Namen registrieren und diese Fehler ausnutzen.
Strategie: Behandeln Sie Fehler bei der Auflösung von Abhängigkeiten (zum Beispiel „Paket nicht gefunden“) als sicherheitsrelevante Ereignisse. Prüfen Sie, woher der Vorschlag für die Abhängigkeit stammt, und verifizieren Sie vor dem Fortfahren, ob der Paketname legitim ist.
Das folgende Bild zeigt, wie der Windusrf-Coding-Agent Snyk Studio aufruft, um mit dem Tool snyk_package_health_check den Zustand des Pakets zu analysieren. Dieses Tool ist Teil weiterer Sicherheitstools im Snyk-MCP-Server. Mit installiertem Snyk Studio kann der KI-Agent anschließend bestätigen, dass das Paket gepflegt und frei von Sicherheitsproblemen sowie Schadcode ist.
Snyks Mission: KI-generierten Code absichern
Wir haben Snyk in der Überzeugung gegründet, dass Sicherheit, die Entwickler in den Mittelpunkt stellt, der einzige Weg zur Skalierung ist. In der Welt der KI-Coding-Agenten gilt das umso mehr. Die Census-II-Daten zeigen, dass das Open-Source-Ökosystem riesig und größtenteils inaktiv ist.
Unsere Aufgabe ist es, dafür zu sorgen, dass Ihre KI und Ihre Entwickler sich auf die gesunden, dynamischen oberen Kategorien konzentrieren – die 10 %, die die Welt antreiben – und Abwehrmaßnahmen gegen die chaotischen 90 % zu automatisieren. Überlassen Sie Ihrer KI nicht die Prüfung von Vertrauenswürdigkeit. Prüfen Sie, ob Sie der KI vertrauen können.
Möchten Sie mehr darüber erfahren, wie KI-Coding-Assistenten die Risiken für die Software-Supply-Chain verändern? Lesen Sie unseren Leitfaden zur Absicherung von Python im KI-Zeitalter.
WHITEPAPER
Die KI-Sicherheitskrise in Ihrer Python-Umgebung
Angesichts des rasanten Entwicklungstempos: Wissen Sie wirklich, worauf Ihre KI-Umgebung zugreifen kann?