Buffer-Overflow-Angriffe in C++: Ein Leitfaden mit praktischen Beispielen

Snyk Security Research Team
28. Juli 2022
0 Min. LesezeitEin Buffer Overflow ist ein Laufzeitfehler, bei dem ein Programm über das Ende eines Puffers oder Arrays hinaus schreiben kann – daher die Bezeichnung Overflow – und benachbarten Speicher beschädigt. Wie die meisten Fehler tritt auch ein Buffer Overflow nicht bei jeder Programmausführung auf. Stattdessen wird die Schwachstelle unter bestimmten Bedingungen ausgelöst, etwa durch unerwartete Benutzereingaben.
Ein Buffer-Overflow-Angriff nutzt eine Buffer-Overflow-Schwachstelle aus – in der Regel durch einen Angreifer, der sich Zugriff oder Informationen verschaffen möchte. In diesem Beitrag erklären wir, wie ein Buffer Overflow entsteht und wie Sie Ihren C++-Code vor solchen Angriffen schützen.
Beispiel für einen Buffer-Overflow-Angriff
Um zu verstehen, wie ein Buffer Overflow entsteht, sehen wir uns den folgenden Code an. Er führt eine einfache Passwortprüfung durch und ist anfällig für einen Buffer-Overflow-Angriff:
Der Code fordert den Benutzer auf, ein Passwort einzugeben (Zeile 14). Anschließend vergleicht er diese Eingabe mit dem gespeicherten Passwort (Zeile 23), das er zuvor geladen hat (Zeile 12). Stimmen die beiden überein, erhält der Benutzer Zugriff.
In der Praxis würden wir das Passwort mithilfe von std::fscanf aus einer Datei lesen. Um das Beispiel einfach zu halten, lesen wir es stattdessen aus einer Zeichenfolgenkonstante. Außerdem würden wir idealerweise eine gesalzene und gehashte Version unseres Passworts statt des Originals speichern. Der Einfachheit halber verwenden wir jedoch ein Passwort im Klartext.
Ein solcher Mechanismus könnte dazu dienen, die Shareware- bzw. Testversion einer Anwendung freizuschalten oder dem Benutzer durch Eingabe eines Administratorpassworts Zugriff auf Informationen und Funktionen innerhalb der Anwendung zu gewähren.
Führen wir das Programm aus und sehen wir, was passiert:
Wie erwartet, erhalten wir durch die Eingabe des richtigen Passworts Zugriff. Geben wir hingegen ein falsches Passwort ein, wird der Zugriff verweigert:
Bislang funktioniert alles wie erwartet. Das richtige Passwort einzugeben, ist jedoch nicht der einzige Weg, Zugriff auf diese Anwendung zu erhalten. Sehen wir uns an, was passiert, wenn wir stattdessen „sunshinesunshine“ eingeben:
Das ist unerwartet. Wir haben etwas ganz anderes als das richtige Passwort „rictro“ eingegeben – und trotzdem Zugriff erhalten.
Die Erklärung: Wir haben erfolgreich einen Buffer-Overflow-Angriff auf das betreffende Programm ausgeführt. Um zu verstehen, wie das passiert ist, heben wir die Auskommentierung der Debug-Ausgaben in den Zeilen 18–21 auf und führen die Anwendung erneut aus.
Führen wir das Programm zunächst mit der richtigen Eingabe aus:
Die Ausgabe enthält nichts Auffälliges.
Versuchen wir es mit einem falschen Passwort:
Auch hier verhält sich die Anwendung wie erwartet.
Beachten Sie jedoch, was passiert, wenn wir unser spezielles Passwort „sunshinesunshine“ eingeben.
Das Passwort hat nicht mehr den Wert „rictro“, sondern enthält nun „sunshine“.
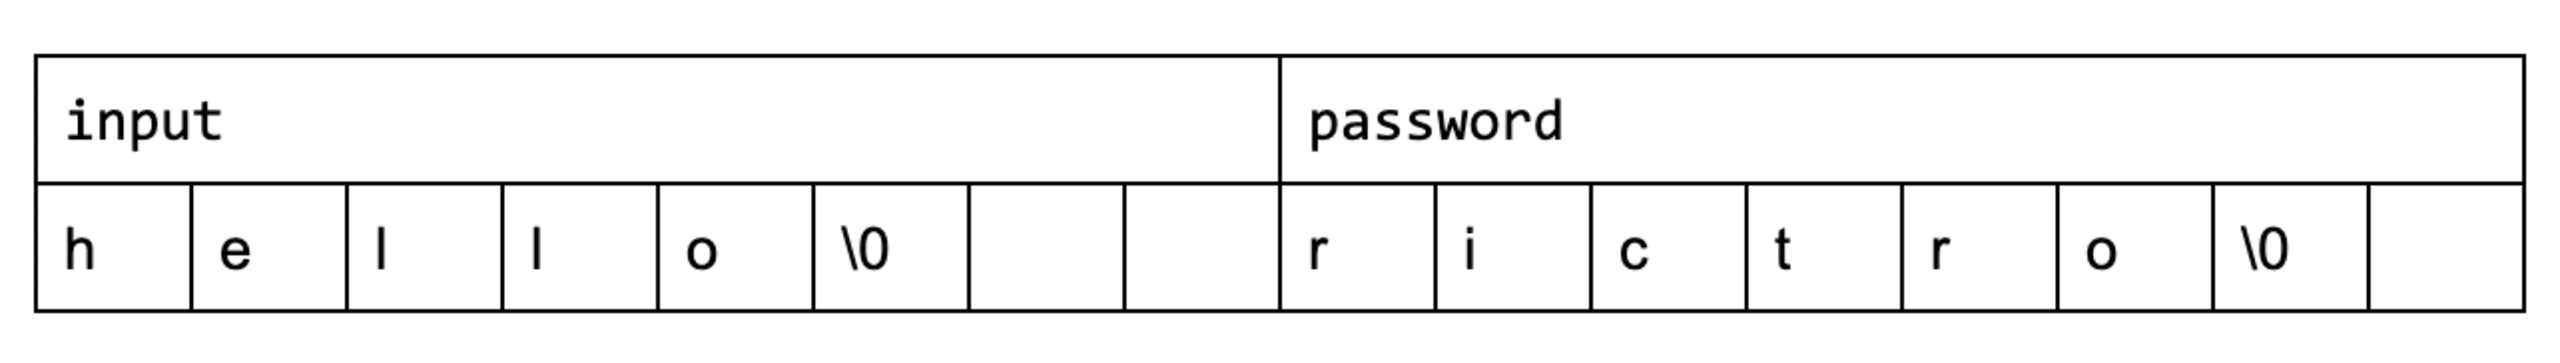
Wir verwenden zwei 8-Byte-Arrays: password speichert das Anwendungspasswort und input die Benutzereingabe. Der in diesem Beispiel verwendete Compiler (GCC 10.3) platziert password acht Byte hinter input (0x7ffc5581e4b0 - 0x7ffc5581e4a8 = 8), sodass sich die Arrays im Speicher direkt nebeneinander befinden. Beachten Sie, dass ein anderer Compiler zu anderen Ergebnissen führen kann.
Bei Passwörtern mit weniger als acht Zeichen sieht der Speicherblock etwa so aus:
Wenn wir jedoch „sunshinesunshine“ eingeben, sieht der Speicher so aus:
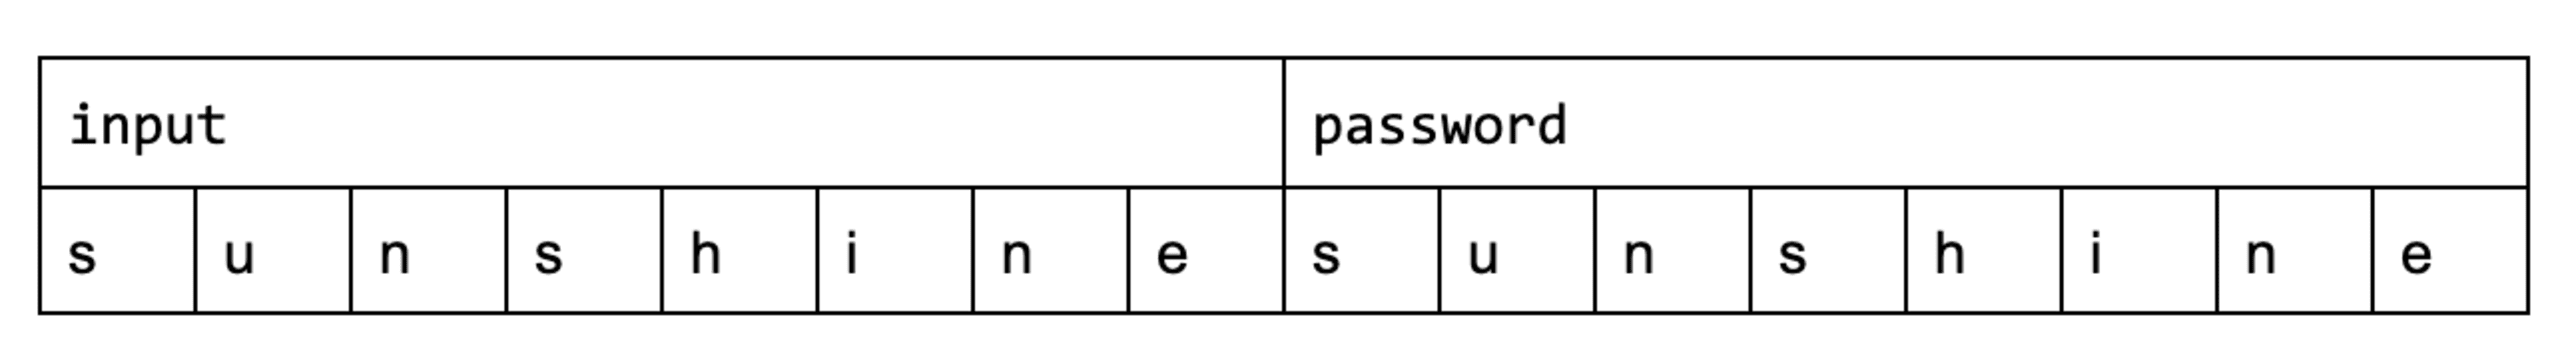
Der Null-Terminator \0 wird hinter das Ende von password geschrieben und überschreibt, was sich zu diesem Zeitpunkt auf dem Stack befindet.
Das liegt daran, dass std::cin (Zeile 15) keine Bereichsprüfungen durchführt. Es liest aus der Konsole, bis es einen Zeilenumbruch erkennt – also bis der Benutzer die Eingabetaste drückt –, ohne sicherzustellen, dass der aufnehmende Puffer groß genug für die Benutzereingabe ist.
Da wir mit std::strncmp (Zeile 23) nur die ersten acht Zeichen von password und input vergleichen, um ein Lesen über das Ende eines der beiden Arrays hinaus zu vermeiden, erhalten wir eine Übereinstimmung, obwohl keine vorliegen sollte.
Buffer Overflows in C++ verhindern
Im Vergleich zu anderen höheren Programmiersprachen ist C++ besonders anfällig für Buffer Overflows, da große Teile des Ökosystems, darunter auch Teile der C++-Standardbibliothek, weiterhin rohe Zeiger verwenden. In unserem eigenen Code können wir verwaltete Puffer wie std::vector oder std::string verwenden. Sobald wir jedoch mit C-APIs arbeiten, die die Übergabe von vector::data oder string::c_str erfordern, verlieren wir die Möglichkeit, Bereichsprüfungen durchzuführen.
Bewährte C++-Programmierpraktiken umsetzen
Buffer Overflows verhindern Sie am besten, indem Sie APIs verwenden, die nicht anfällig dafür sind. In C++ bedeutet das, verwaltete Puffer und Zeichenfolgen statt roher Arrays und Zeiger zu verwenden.
Bevorzugen | Vermeiden |
|---|---|
|
|
|
|
|
|
|
|
Mit std::string können wir unsere Beispielanwendung korrigieren.
Sehen wir uns die korrigierte Version an. Beachten Sie die Änderungen in den Zeilen 4, 10 und 24:
std::string überlädt den Extraktionsoperator (>>) und kann dadurch sicher aus Streams lesen. Dazu fragt er den Stream nach der Größe der Eingabe, reserviert ausreichend Speicher und liest erst dann aus dem Stream. So können wir den Puffer unabhängig von der Länge unserer Eingabe nicht zum Überlaufen bringen. Im schlimmsten Fall kann uns der Speicher ausgehen.
Wenn Sie C-APIs verwenden müssen, sollten Sie nach Möglichkeit deren „sichere“ Varianten nutzen. Dabei handelt es sich um Versionen mit Bereichsprüfung, die einen zusätzlichen size-Parameter entgegennehmen und Lese- oder Schreibvorgänge außerhalb dieses Bereichs ablehnen.
Bevorzugen | Vermeiden |
|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
Adressen prüfen, um Buffer Overflows zu verhindern
Neben guten Programmierpraktiken gibt es automatisierte Tools, die Buffer Overflows erkennen können. AddressSanitizer (ASan) gehört zu den beliebtesten. Er wird von allen großen Compilern unterstützt, darunter Visual Studio (v16.9 und höher), GCC (v4.8 und höher), Clang (v3.1 und höher) und Xcode (v7.0 und höher). Die Adressprüfung lässt sich in Visual Studio mit der Option /fsanitize=address und in GCC/Clang mit der Option -fsanitize=address aktivieren.
ASan erfüllt zwei Funktionen:
Er versieht alle Stack-Objekte und Heap-Allokationen mit einigen Bytes „vergifteten Speichers“, indem er
mallocdurch eine modifizierte Version ersetzt.Der Compiler fügt Ihrer Anwendung Code hinzu, der erkennt, ob sie versucht, auf vergifteten Speicher zuzugreifen.
Wir haben bereits gesehen, wie unsere input- und password-Arrays bei der Kompilierung mit GCC 10.3 im Speicher angeordnet sind. Wenn wir die Adressprüfung aktivieren, kann sich die Anordnung ändern und etwa so aussehen:
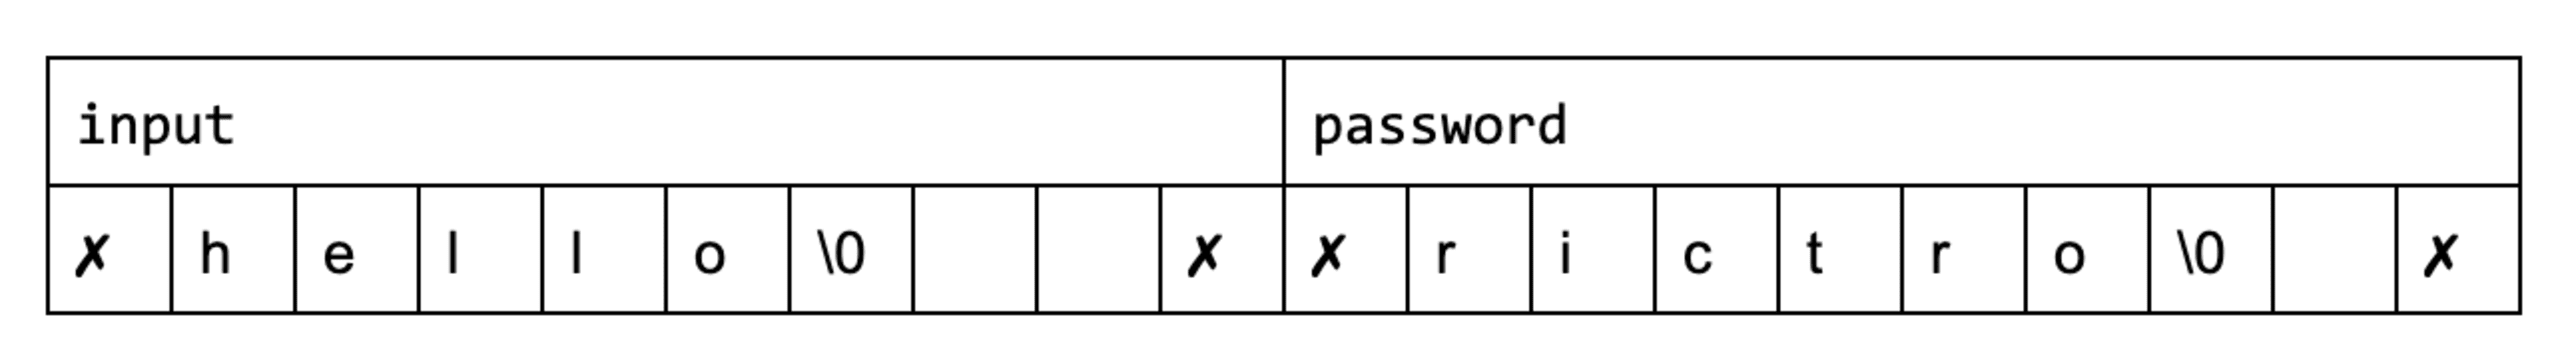
Die ✗-Symbole stehen für den vergifteten Speicher, der um unsere Arrays herum eingefügt wurde.
Der vom Compiler eingefügte Code enthält Logik, die erkennt, ob wir versuchen, auf vergifteten Speicher zuzugreifen. Betrachten Sie vor der Transformation dieses einfache Codebeispiel:
Nach der Verarbeitung durch ASan sieht der Code nun so aus:
Um festzustellen, ob die Anwendung versucht, auf vergifteten Speicher zuzugreifen, implementiert ASan die Funktion is_poisoned und verwendet dafür „Shadow Memory“. Dabei handelt es sich um einen separaten Speicherbereich, der Metadaten zum tatsächlichen Anwendungsspeicher enthält.
In der Praxis berücksichtigt der Algorithmus mehr Faktoren, als sich in diesem Beitrag behandeln lassen. Diese einfache native Implementierung veranschaulicht jedoch das Prinzip.
Stellen Sie sich ein einfaches Bitset vor, in dem zu jedem Byte, auf das die Anwendung zugreift, ein entsprechendes Bit im Shadow Memory angibt, ob dieses Byte vergiftet ist.
Eine einfache Deklaration könnte beispielsweise so aussehen:
Zur Implementierung von Shadow Memory könnte die Deklaration etwa wie folgt umgewandelt werden:
Der Benutzer deklariert ein 6 Byte großes char array auf dem Stack. Stattdessen erstellt der Compiler ein 8 Byte großes Array und gibt einen Zeiger auf dessen Mitte zurück. Auf beiden Seiten fügt er jeweils 1 Byte als Auffüllung hinzu. Anschließend schreibt er das Bitmuster 10000001 in das bitset shadow_memory und verwendet dabei die Adresse von temp als Index. Dadurch wird angegeben, dass die 6 Byte in password sauber sind, während die beiden angrenzenden Bytes als vergiftet markiert werden.
Der Compiler kann nun leicht erkennen, ob wir versuchen, auf vergifteten Speicher zuzugreifen. Sehen wir uns den folgenden Codeausschnitt an:
Nachdem Sie nun die Grundlagen der Adressprüfung kennen, sehen wir uns an, was passiert, wenn wir die schädliche Eingabe „sunshinesunshine“ in unsere ursprüngliche, anfällige Anwendung eingeben – diesmal mit aktivierter Adressprüfung:
Beachten Sie zwei Dinge:
Der Abstand zwischen unseren
input- undpassword-Arrays hat sich von 8 auf 32 Byte vergrößert (0x7ffc5581e4c8-0x7ffc5581e4a8= 32), um Platz für den vergifteten Speicher zu schaffen.Der Compiler erkennt eine Speicherbeschädigung an der Adresse
0x7ffc5581e4b0, genau 8 Byte hinterinput. Das entspricht dem ersten vergifteten Byte, auf das er trifft.
Ihre C++-Projekte schützen
In diesem Beitrag haben wir die Grundlagen von Buffer-Overflow-Angriffen in C++ und die besten Möglichkeiten zum Schutz Ihrer Projekte behandelt. Zur Zusammenfassung: Ein Buffer Overflow ist eine Schwachstelle, durch die ein Programm über das Ende eines Puffers hinaus schreiben kann. Das führt zu Speicherbeschädigung, die anschließend ausgenutzt werden kann, um sich Zugriff auf eingeschränkte Anwendungen oder Informationen zu verschaffen.
Unter den höheren Programmiersprachen ist C++ besonders anfällig für Buffer Overflows, da viele APIs weiterhin rohe Zeiger verwenden und keine Bereichsprüfungen durchführen. Sie können das Risiko verringern, indem Sie verwaltete Puffer und Zeichenfolgen statt C-APIs verwenden. Wenn Sie eine C-API benötigen, nutzen Sie deren sichere Varianten, die einen zusätzlichen Größenparameter entgegennehmen. Buffer-Overflow-Angriffe lassen sich außerdem mit Tools verhindern, die die Adressprüfung aktivieren und Speicherfehler oder Pufferüberschreitungen erkennen.
Weitere Informationen zur C++-Sicherheit finden Sie in unserer unkomplizierten Einführung in C/C++-Schwachstellen und erfahren Sie mehr über Directory-Traversal-Schwachstellen in C/C++.
Starten Sie mit Capture-the-Flag
Erfahren Sie in unserem virtuellen On-Demand-Workshop für Einsteiger, wie Sie Capture-the-Flag-Challenges lösen.