AWS-Schwachstellenscans mit der Snyk-Integration

10. Februar 2021
0 Min. LesezeitWenn Sie die Kubernetes-Tools von AWS nutzen, können Sie Snyk direkt in Ihre Workflows integrieren und damit scannen – dank Integrationen mit Amazon Elastic Container Registry ( ECR ) und Amazon Elastic Kubernetes Service ( EKS ). So legen Sie los!
In diesem Beitrag verwende ich eine unserer Snyk-Testanwendungen, um eine Anwendung zu erstellen und bereitzustellen. Den Code finden Sie hier. Außerdem müssen Sie einige Abhängigkeiten installieren:
Los geht’s
Nachdem alles eingerichtet ist, legen wir los!
Zuerst richten wir ECR ein, damit Snyk auf unsere Repositories zugreifen kann. Dazu müssen wir in AWS Identity and Access Management eine Richtlinie und eine Rolle zuweisen. So erhält das Snyk-Backend die erforderlichen Berechtigungen, um beispielsweise Images aufzulisten und aus unseren ECR-Repositories abzurufen.
Die Schritte zum Konfigurieren der Integration sind in der Snyk-Dokumentation beschrieben. Die erforderliche Konfiguration finden Sie aber auch direkt in der Snyk-Benutzeroberfläche. Navigieren Sie zu Settings/Integrations/ECR/Edit Settings. Als Erstes richten wir anhand des in der Benutzeroberfläche angezeigten JSON eine Richtlinie ein:
- oriDamit erhält Snyk die im Abschnitt Action des JSON definierten Berechtigungen für alle Repositories und Images, die in unserem ECR-Konto eingerichtet sind. Diese Mindestberechtigungen sind erforderlich, um Repositories und Images aufzulisten und Images aus Repositories abzurufen. Folgen Sie der Anleitung, um das JSON Ihrer IAM-Richtlinienkonfiguration in AWS hinzuzufügen.
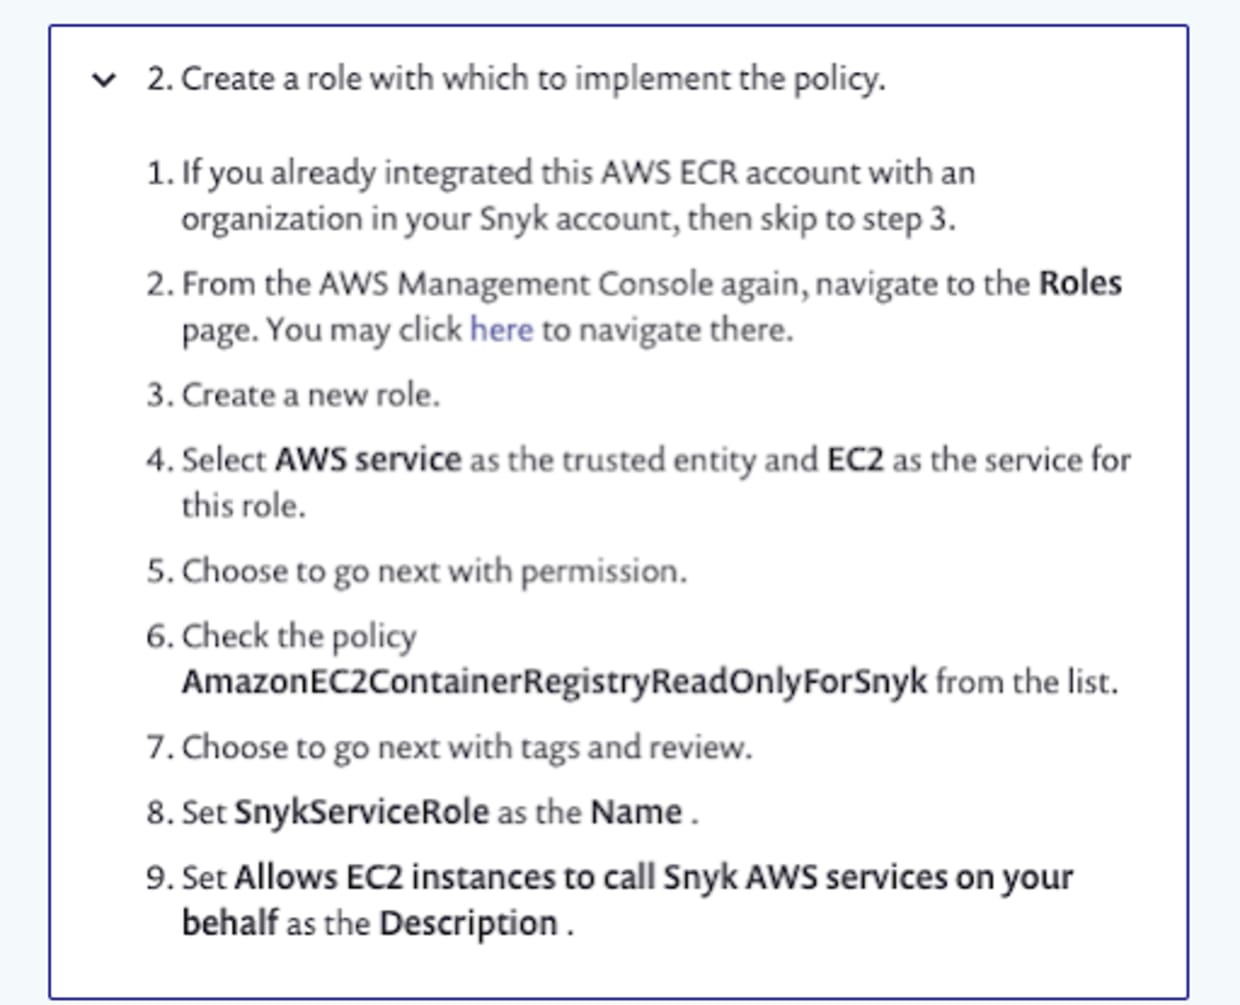
Anschließend müssen wir eine Rolle hinzufügen und ihr die Richtlinie zuweisen, wie in der Anleitung beschrieben:
Außerdem müssen wir den Geltungsbereich der Rolle festlegen, indem wir die Snyk-Organisations-IDs angeben, die sie verwenden dürfen. Bearbeiten Sie dazu die Vertrauensbeziehungen der neu erstellten Rolle mithilfe des in der Dokumentation angegebenen JSON. Der String sts:ExternalId ist Ihre Snyk-Organisations-ID. Dieser JSON-Ausschnitt ermöglicht es dem AWS-Prinzipal, die Rolle anzunehmen, sofern die angegebene ExternalId mit unserer Snyk-Organisations-ID übereinstimmt.
Wie in der Anleitung beschrieben, müssen Sie mehrere Snyk-Organisationen als JSON-Array in eckigen Klammern hinzufügen, wenn Sie sie in diese Richtlinie aufnehmen möchten:
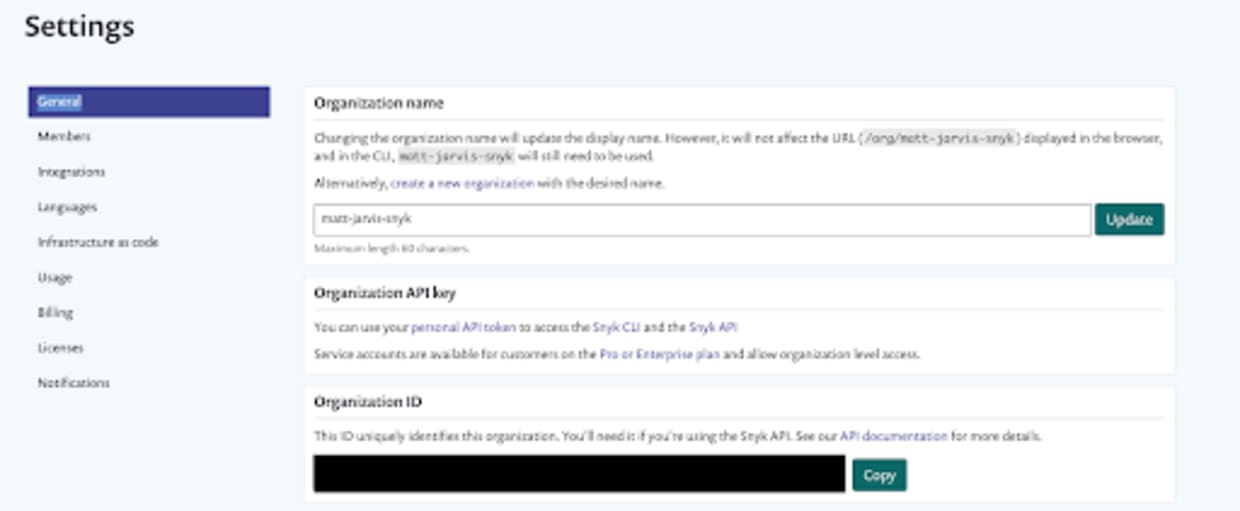
Ihre Snyk-Organisations-ID finden Sie unter Settings > General.
Im letzten Schritt konfigurieren wir die Snyk-Benutzeroberfläche so, dass sie diese Rolle für die Verbindung mit ECR verwendet. Gehen Sie zurück zu Settings/Integrations/ECR/Edit Settings und geben Sie die Region an, in der ECR eingerichtet ist, sowie die zuvor erstellte Rolle:
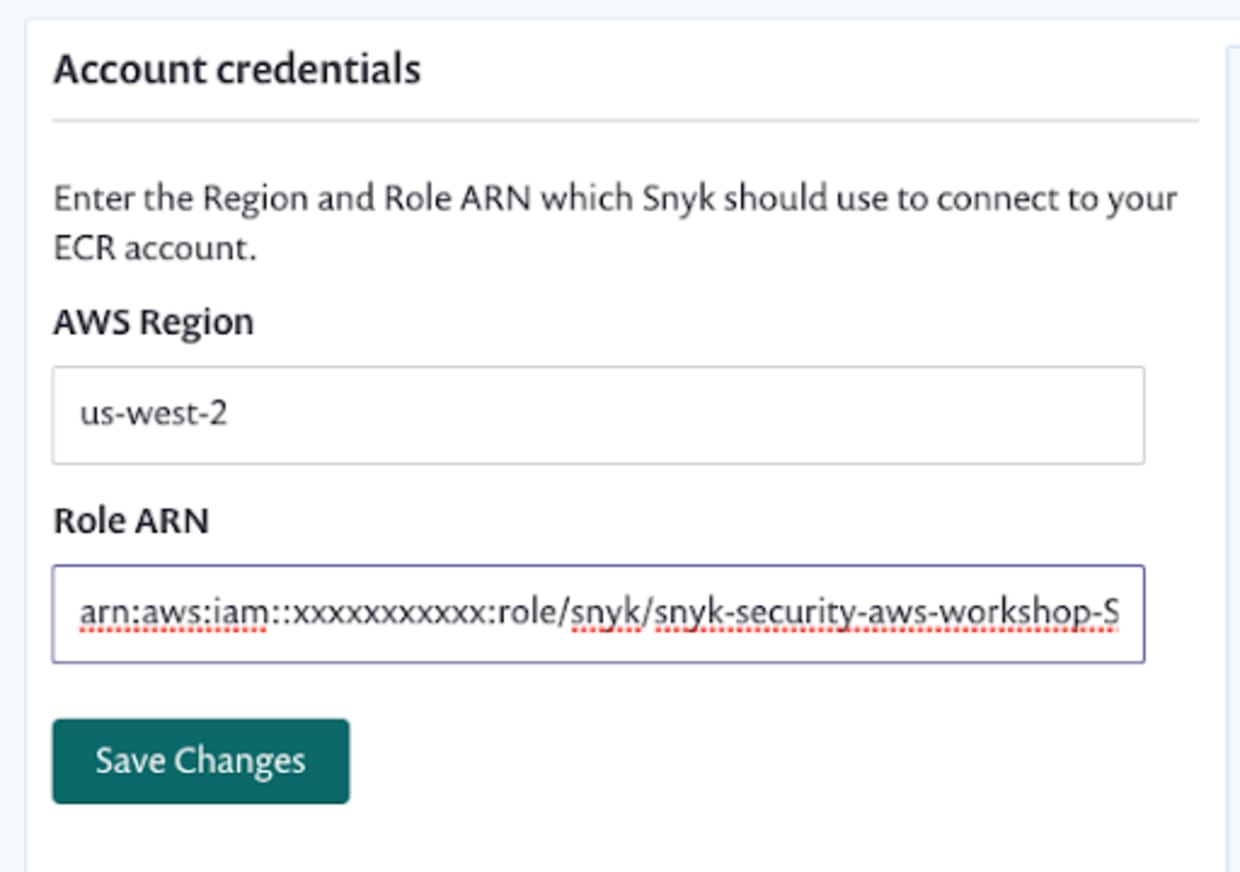
Damit sollte die ECR-Integration vollständig eingerichtet sein. Als Nächstes testen wir sie.
Erstellen wir zunächst mithilfe der AWS CLI ein Repository in ECR:
Nachdem wir nun ein Repository in ECR haben, konfigurieren wir Docker, damit wir Images dorthin übertragen können:
Dieser Befehl gibt Ihr Anmeldepasswort aus und übergibt es anschließend an die Docker CLI, um Sie bei Ihrer AWS ECR-Registry zu authentifizieren. Achten Sie darauf, die richtige Region anzugeben, in der ECR für AWS aktiviert ist.
Sehen wir uns nun unsere Testanwendung an. Es handelt sich um eine einfache Node.js-Anwendung mit zahlreichen Sicherheitslücken und einer Konfiguration zum Erstellen mit Docker und Bereitstellen in Kubernetes.
Als Erstes erstellen wir die Anwendung mit Docker.
Sobald das Image erstellt wurde, sollte es in unserem lokalen Docker-Repository angezeigt werden:
Bevor wir es in unser ECR-Upstream-Repository übertragen, müssen wir es taggen. Ersetzen Sie dazu den Repository-Namen durch den zuvor in ECR eingerichteten Namen:
Jetzt können wir es an ECR übertragen:
Nach Abschluss der Übertragung können wir in unserem ECR-Repository nach dem soeben übertragenen Image suchen:
Sobald sich unser Image in ECR befindet, können wir Snyk so konfigurieren, dass es von dort aus gescannt wird. Wählen Sie in der Snyk-Benutzeroberfläche Add Project aus und navigieren Sie zum ECR-Symbol:
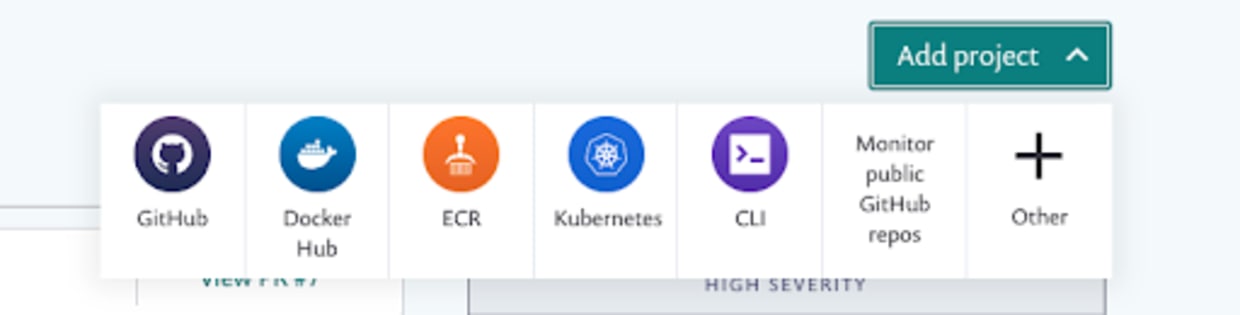
Wenn unsere ECR-Konfiguration korrekt ist, sollte jetzt eine Ansicht mit allen verfügbaren Repositories und den darin enthaltenen Images angezeigt werden:
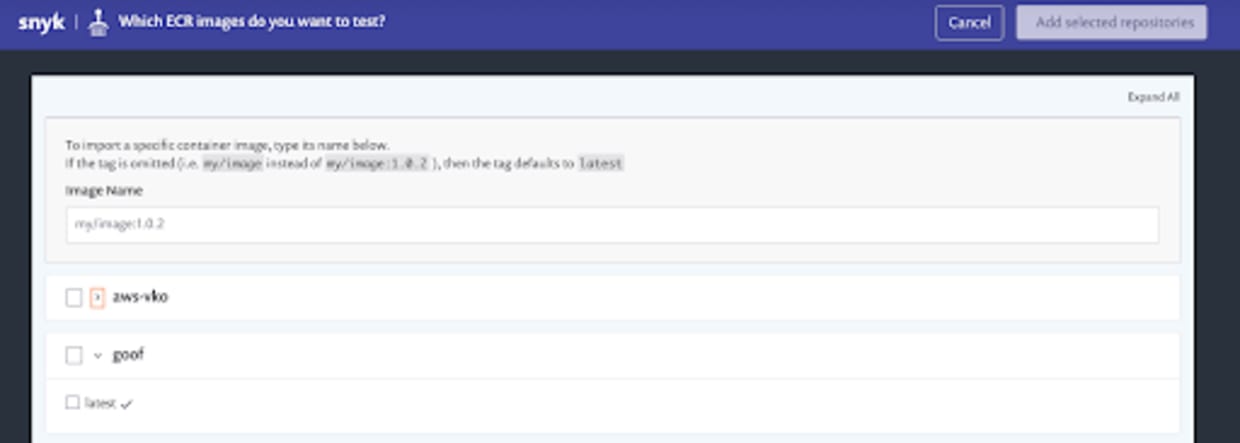
Wir sehen das zuvor erstellte goof-Repository mit einem einzigen Image-Tag. Wählen Sie das Image aus und klicken Sie anschließend auf die Schaltfläche „Add selected repositories“. Snyk importiert nun das Repository aus ECR und beginnt mit dem Scannen und Überwachen.
Nach Abschluss des Imports sollte der Import auf der Snyk-Projektseite angezeigt werden:
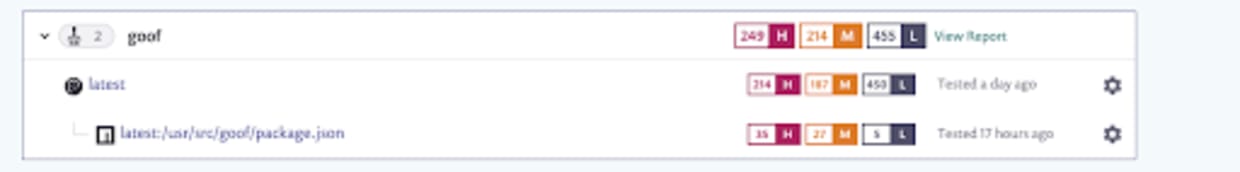
Snyk hat sowohl das Image selbst als auch die package.json erkannt, die von der im Image bereitgestellten Node-Anwendung verwendet wird, und für beide Projekte erstellt.
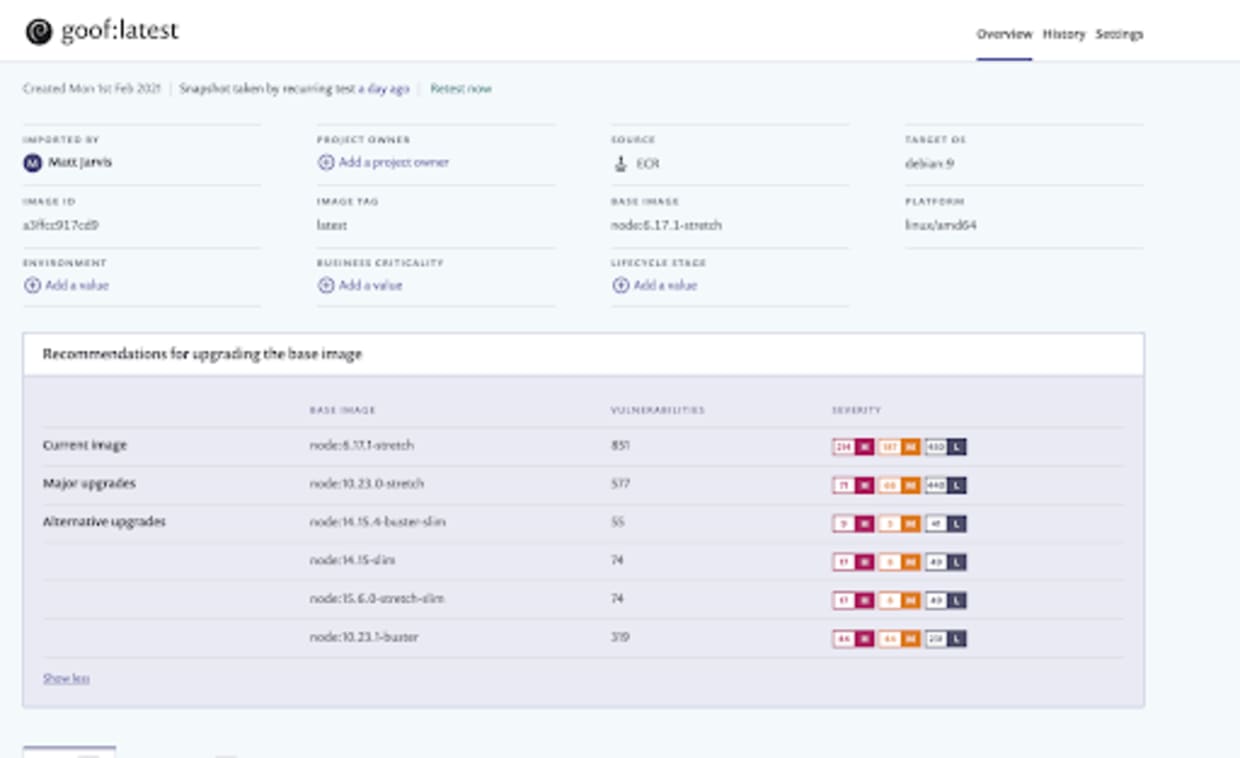
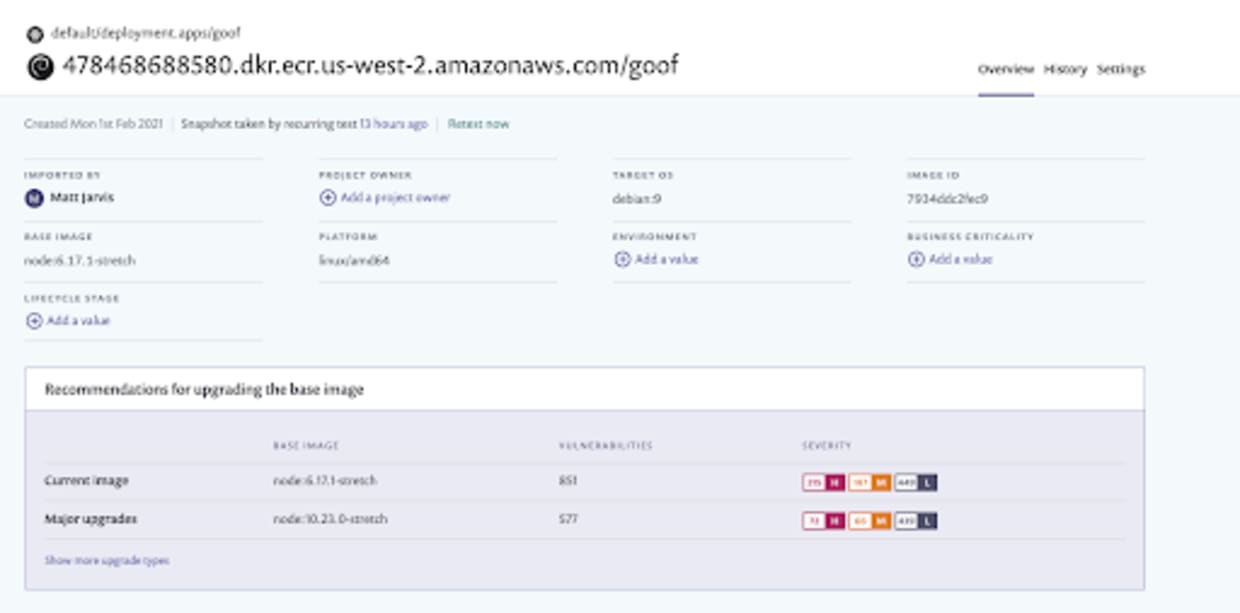
Das Image verwendet ein veraltetes, anfälliges Basis-Image. Snyk hat darin zahlreiche Sicherheitslücken erkannt und Empfehlungen für Basis-Images ausgegeben, mit denen sich die Gesamtzahl der Sicherheitslücken verringern lässt.
In der package.json ist festgelegt, welche Node-Pakete in der Anwendung enthalten sind – sowohl direkt über die in der Datei package.json angegebenen Pakete als auch indirekt als Abhängigkeiten. Snyk hat einen Abhängigkeitsbaum für alle diese Pakete erstellt und die Schwachstellendatenbank nach Sicherheitslücken in den verwendeten Versionen durchsucht. Wie Sie sehen, gibt es viele Treffer, da diese Anwendung absichtlich anfällige Versionen verwendet.
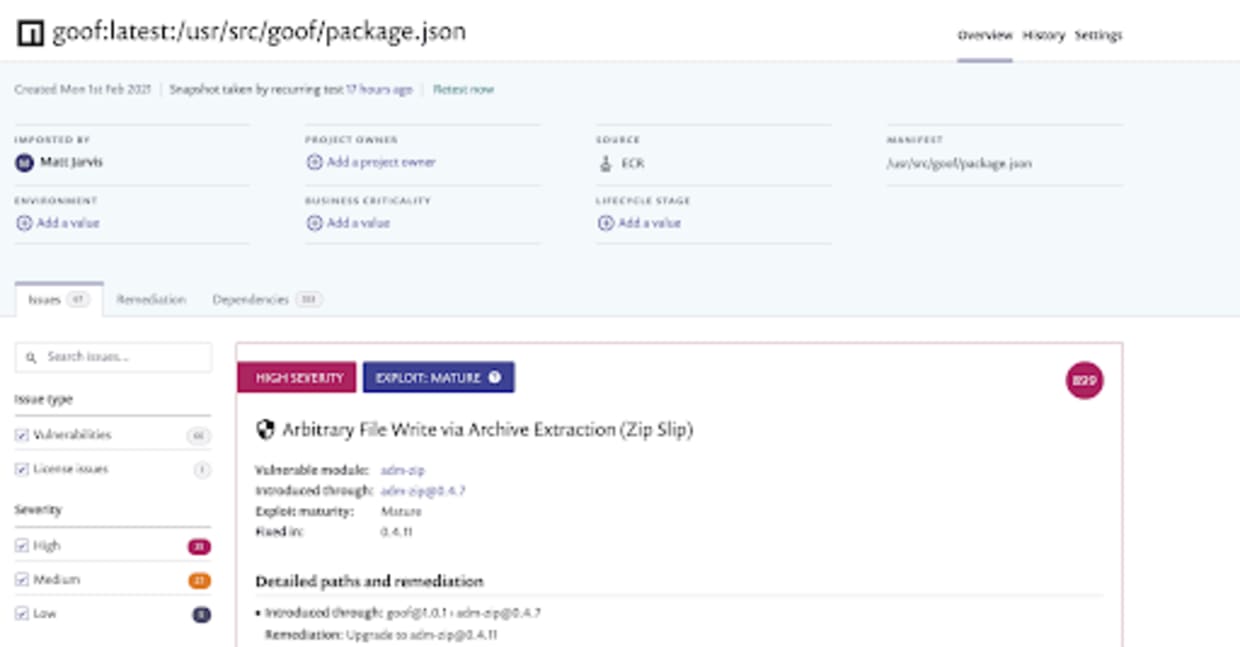
Sie finden außerdem Informationen zu den einzelnen Sicherheitslücken und Empfehlungen zur Behebung, einschließlich der Pakete, die Sie aktualisieren sollten. Nehmen Sie sich also etwas Zeit, um die Informationen in der Snyk-Benutzeroberfläche zu erkunden.
Snyk-Integration mit EKS konfigurieren
Als Nächstes konfigurieren wir die Snyk-Integration mit Elastic Kubernetes Service. Dafür benötigen Sie eine kostenlose Testversion eines der Snyk-Standardtarife, da die Kubernetes-Integration Teil unseres kostenpflichtigen Angebots ist.
Erstellen wir dazu mithilfe von EKS einen Kubernetes-Cluster. Dafür gibt es verschiedene Möglichkeiten. Eine der einfachsten ist das Tool eksctl.
Zuerst verwende ich die AWS CLI, um ein Schlüsselpaar zu erstellen, mit dem ich mich bei Bedarf per SSH mit den Clusterknoten verbinden kann:
Anschließend verwende ich eksctl, um einen Cluster mit dem Namen mattjarvis-sko in der Region us-west-2 zu erstellen. Er verwendet eine verwaltete Knotengruppe mit Linux-Knoten, der ich mein Schlüsselpaar hinzufüge.
% eksctl create cluster --name mattjarvis-sko --region us-west-2 --with-oidc --ssh-access --ssh-public-key SKO_demo --managed
Die Ausführung dieses Befehls dauert eine Weile. Danach verfügen Sie über einen voll funktionsfähigen EKS-Cluster, und kubectl ist für die Kommunikation mit ihm konfiguriert.
Nachdem unser EKS-Cluster nun einsatzbereit ist, sehen wir uns die Kubernetes-Konfiguration für die Bereitstellung der Anwendung an. Im Git-Checkout der goof-Anwendung finden Sie ein Verzeichnis namens manifests. Es enthält zwei Kubernetes-YAML-Dateien.
Die Datei goof-deployment.yaml definiert die goof-Anwendung sowie einen mongodb-Pod, den sie als Abhängigkeit benötigt. Ändern Sie den Image-Abschnitt so, dass er das zuvor konfigurierte ECR-Repository verwendet:
Die Datei goof-service.yaml definiert den Dienst für mongodb und stellt die Verbindung zum mongodb-Pod über Port 27017 her. So verbindet sich unsere goof-Anwendung mit der Datenbank. Außerdem definiert sie einen externen LoadBalancer-Dienst, der für den Zugriff auf die laufende Anwendung bereitgestellt wird. Die Implementierung des LoadBalancers hängt von der Plattform ab, auf der unser Cluster bereitgestellt ist. Bei AWS wird ein Elastic Load Balancer eingerichtet, der extern Port 80 verwendet und auf Port 3001 unseres goof-Pods verweist, auf dem sich die Node.js-Anwendung befindet.
Stellen wir die Anwendung jetzt in unserem Cluster bereit:
Die URL im Feld EXTERNAL-IP wird vom ELB bereitgestellt, der als Teil des LoadBalancer-Dienstes eingerichtet wurde. Damit können wir die laufende Anwendung aufrufen. Wenn wir die URL in einem Browser öffnen, sollte die goof-Anwendung angezeigt werden:
Unsere Anwendung ist also in unserem EKS-Cluster bereitgestellt und läuft. Im letzten Schritt richten wir die Integration zwischen Snyk und unserem EKS-Cluster ein, damit wir laufende Workloads in der Produktionsumgebung scannen können. Die Kubernetes-Integration von Snyk besteht aus einem einzelnen Kubernetes-Operator-Pod, der die Kubernetes-API abfragt, Container-Images im Cluster scannt und mit dem Snyk-Backend kommuniziert.
Wenn wir CloudFormation für die Bereitstellung des EKS-Clusters verwenden würden, könnten wir dafür die von uns entwickelten AWS-Quick Starts nutzen. Da wir für diese Demo jedoch eksctl verwenden, führen wir die Installation manuell durch.
Zuerst fügen wir das Helm-Repository hinzu, das die Helm-Charts für die Bereitstellung des Snyk-Kubernetes-Monitors enthält:
Nun erstellen wir einen separaten Namespace, in dem der Snyk-Monitor ausgeführt wird. Es empfiehlt sich generell, in Kubernetes für Anwendungen eigene Namespaces anzulegen, da sich so Berechtigungen differenzierter steuern lassen.
Als Nächstes erstellen wir in Kubernetes ein Secret mit unserer Snyk-Integration-ID. Der Snyk-Monitor verwendet diese, um mit der Snyk-API zu kommunizieren und Snyk Informationen über die laufenden Pods im Cluster zu übermitteln. Wenn wir private Registries verwenden würden, die Anmeldedaten für das Abrufen von Images erfordern, müssten wir diese außerdem im Abschnitt dockercfg.json angeben. Weitere Informationen dazu finden Sie in der Dokumentation zum Snyk-Monitor.
Sobald das Secret erstellt ist, können wir Helm verwenden, um den Snyk-Monitor im Namespace snyk-monitor zu installieren.
Nach Abschluss des Helm-Charts sollte der snyk-monitor-Pod im Namespace snyk-monitor unseres Clusters ausgeführt werden:
Wir können auch die Protokolle aufrufen und überprüfen, ob snyk-monitor Daten an Snyk sendet:
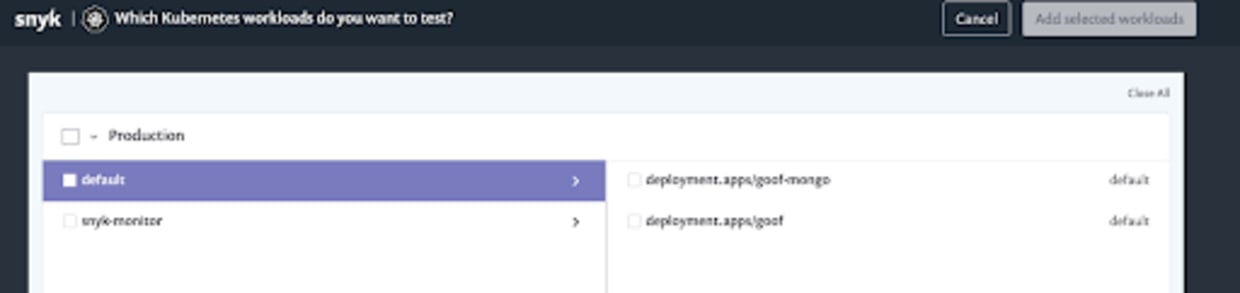
Es kann etwas dauern, bis die Workloads in der Snyk-Benutzeroberfläche erscheinen, da der Monitor die Daten erst an Snyk übermitteln muss. Nach etwa einer Minute sollten Sie die laufenden Workloads im Cluster unter Add Project/Kubernetes aufrufen können:
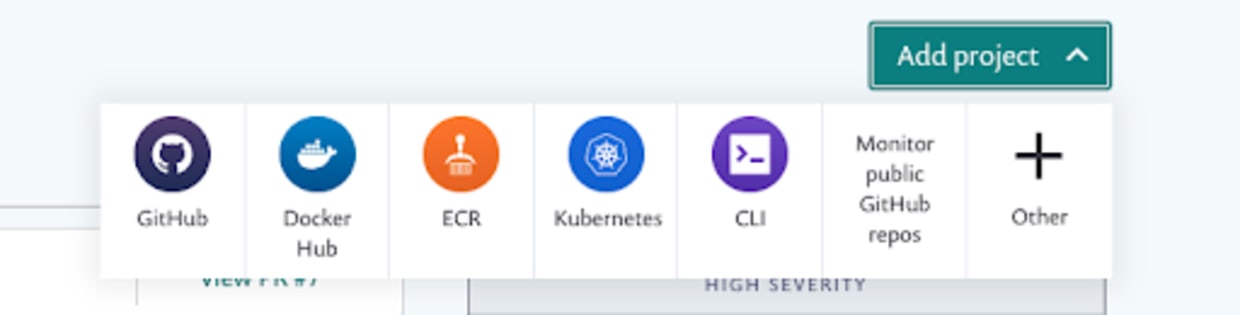
Jetzt sollten die laufenden Workloads angezeigt werden. Um sie hinzuzufügen, markieren wir einfach das Kontrollkästchen, damit Snyk sie importiert und testet.
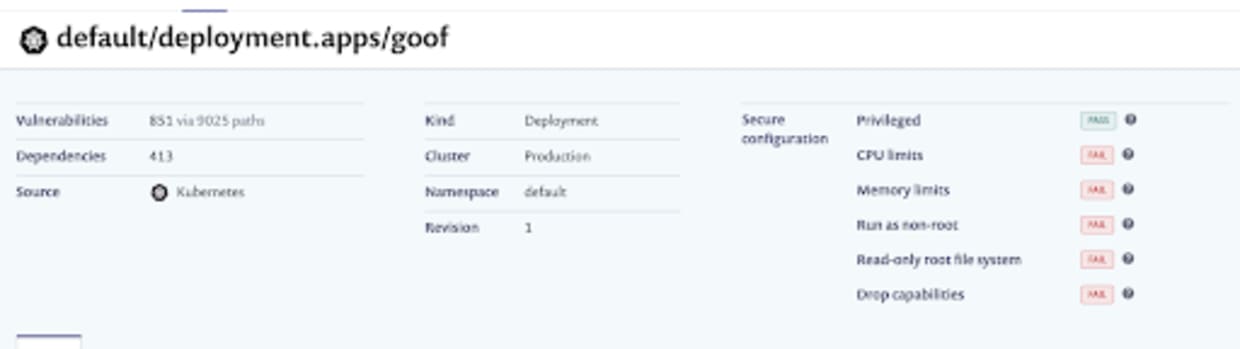
Nach dem Import des Projekts können wir zur Seite Projects navigieren und das importierte Projekt genauer untersuchen. Zunächst fällt auf, dass Snyk die Laufzeitkonfiguration des Workloads erkannt und auf Sicherheitsprobleme überprüft hat. Hier sehen wir, dass mehrere Sicherheitstests fehlgeschlagen sind, unter anderem weil der Workload als Root ausgeführt wird und keine CPU-Limits festgelegt sind:
Wenn wir uns nun den Workload selbst ansehen, erkennen wir, dass Snyk das Basis-Image und alle darin enthaltenen Sicherheitslücken ermittelt und Empfehlungen für alternative Basis-Images mit einem geringeren Risiko ausgegeben hat.
Zum Abschluss
Diese Demonstration hat gezeigt, wie wir Sicherheitstests in den gesamten Softwareentwicklungslebenszyklus integrieren können – eine wichtige Strategie, um die Sicherheit unserer Workloads und Infrastruktur in Cloud-native-Umgebungen zu gewährleisten.
Snyk lässt sich außerdem in zahlreiche integrierte Entwicklungsumgebungen, Quellcodeverwaltungstools und CI/CD-Systeme integrieren. So können Sie Ihre gesamte Bereitstellungspipeline abdecken.
Wenn Sie die Container- und Kubernetes-Dienste von Amazon nutzen, lässt sich Snyk ganz einfach in ECR und EKS integrieren. Außerdem stehen AWS-Quick Starts zur Verfügung, mit denen Sie all dies mithilfe von CloudFormation-Vorlagen bereitstellen können. Erstellen Sie kostenlos ein Snyk-Konto und probieren Sie es aus!
Starten Sie mit Capture the Flag
Erfahren Sie in unserem virtuellen On-Demand-Workshop für Einsteiger, wie Sie Capture-the-Flag-Herausforderungen lösen.