Automatische Quellcodepositionen mit Rego

12. Februar 2024
0 Min. LesezeitBei Snyk sind wir große Fans von Rego von Open Policy Agent. Snyk IaC basiert auf einer umfangreichen Sammlung von Regeln, die in Rego geschrieben sind. Kunden können außerdem eigene benutzerdefinierte Regeln hinzufügen.
Kürzlich haben wir eine Reihe von Verbesserungen an Snyk IaC veröffentlicht. In diesem Blogbeitrag werfen wir einen technischen Blick auf ein besonders interessantes Feature: automatische Quellcodepositionen für Regelverstöße.
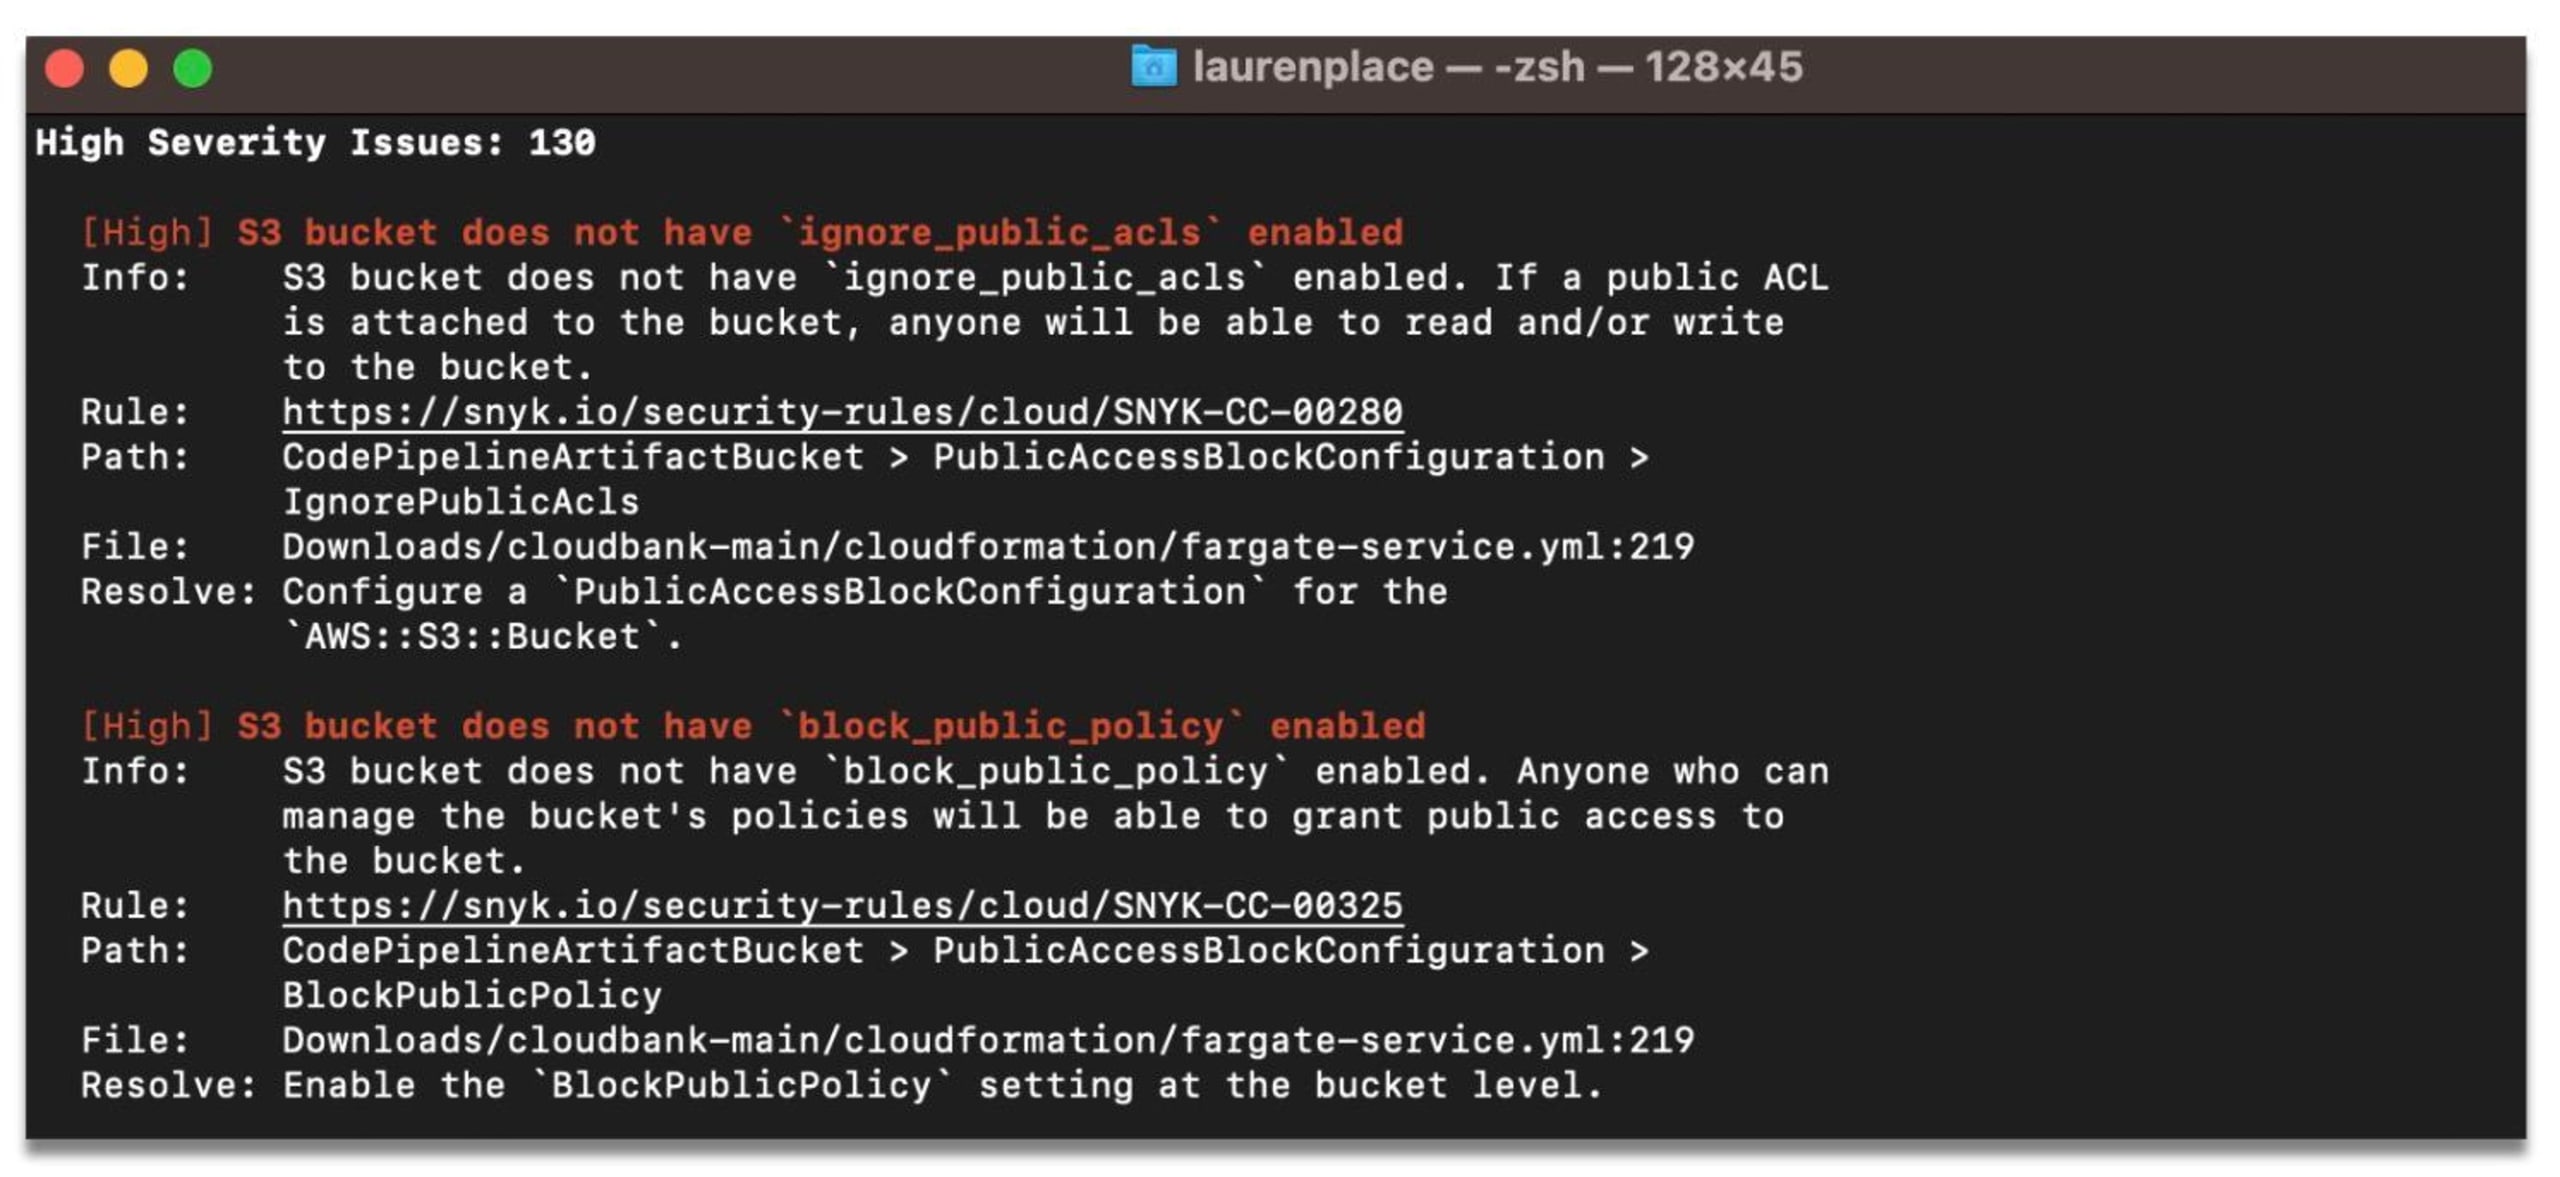
Bei der Prüfung von IaC-Dateien auf bekannte Probleme zeigt der aktualisierte Befehl `snyk iac test` für jeden Regelverstoß präzise Angaben zu Datei, Zeile und Spalte an. Das funktioniert auch für benutzerdefinierte Regeln, ohne dass Sie etwas dafür tun müssen.
Bevor wir einen eigenständigen Proof of Concept für diese Technik bereitstellen, müssen wir jedoch einige Vereinfachungen vornehmen. Die vollständige Implementierung finden Sie in unserer vereinheitlichten Policy-Engine.
Sehen wir uns zunächst ein CloudFormation-Beispiel an. Unsere IaC-Engine unterstützt zwar viele Formate und legt einen starken Schwerpunkt auf Terraform, aber CloudFormation eignet sich gut als Beispiel, da wir es ohne allzu viele Abhängigkeiten parsen können (schließlich ist es einfach YAML).
Wir möchten sicherstellen, dass kein Subnetz einen CIDR-Block verwendet, der größer als `/24` ist. Schreiben wir also eine Rego-Policy, die genau das sicherstellt:
Auf diese Weise gibt `deny` eine Menge abgelehnter Ressourcen zurück. Wir gehen nicht näher darauf ein, wie Rego funktioniert. Wenn Sie mehr erfahren möchten, empfehlen wir den hervorragenden Kurs OPA by Example.
Wir können das Problem in zwei Teile aufteilen:
Wir müssen ableiten, dass unsere Policy das Attribut `CidrBlock` verwendet.
Anschließend rufen wir die Position im Quellcode ab.
Beginnen wir mit (2), denn so können wir uns gut mit dem Code vertraut machen.
Quellcodeposition abrufen
Eine Quellcodeposition sieht so aus:
Außerdem führen wir einen Hilfstyp ein, der Pfade in YAML darstellt. In YAML gibt es zwei Arten verschachtelter Dokumente: Arrays und Objekte.
Um auf jedes beliebige Teildokument verweisen zu können, könnten wir etwas Ähnliches wie JSON-Pfade verwenden. Im obigen Beispiel würde [`"some_array", 1`] dann auf `"word"` verweisen. Da wir Arrays in unserem Proof of Concept jedoch nicht unterstützen, reicht ein Array aus Strings aus.
Ein Pfad könnte beispielsweise so aussehen:
Jetzt können wir einen praktischen Typ bereitstellen, der YAML lädt und uns die `Location` bestimmter `Paths` mitteilt.
Die Quellcodeposition eines `Path` zu ermitteln, bedeutet, einen Baum aus YAML-Knoten zu durchlaufen:
Mengen und Bäume aus Pfaden
Damit haben wir das Problem vereinfacht: Statt automatisch die in einer Policy verwendeten Quellcodepositionen abzuleiten, müssen wir nun nur noch Attributpfade automatisch ableiten.
Das ist auch aus anderen Gründen wichtig: Snyk kann beispielsweise dieselben Policies sowohl auf IaC-Ressourcen als auch auf Ressourcen anwenden, die bei Cloud-Scans gefunden wurden. Letztere haben zwar keine wirklich aussagekräftigen Quellcodepositionen, aber durchaus aussagekräftige Attributpfade!
Wir möchten also Mengen von Attributpfaden definieren. Da Pfade auf Arrays basieren, können wir in Go leider nicht einfach `map[Path]struct{}` als Menge verwenden.
Stattdessen müssen wir sie in einem rekursiven Baum speichern.
Diese Darstellung hat weitere Vorteile. Im Allgemeinen interessieren uns nur die längsten Pfade, die eine Policy verwendet, da sie spezifischer sind. Unsere Beispiel-Policy verwendet sowohl `Path{"Resources", "PrivateSubnet", "Properties"}` als auch `Path{"Resources", "PrivateSubnet", "Properties", "CidrBlock"}` – uns interessiert nur der letztere.
Wir definieren eine rekursive Methode, die einen `Path` in unseren Baum einfügt:
…und außerdem eine Methode, mit der wir eine Liste von Paths abrufen können. Dabei wird etwas unnötig Speicher belegt, aber damit können wir leben.
Jetzt können wir die von einer Policy verwendeten `Paths` übersichtlich speichern und in Quellcodepositionen umwandeln.
Statische Analyse vs. Laufzeitanalyse
Als Nächstes müssen wir herausfinden, welche `Paths` in einer bestimmten Eingabe von einer Policy verwendet werden, und diese dann in den Baum `Insert`-en.
Das ist nicht einfach, da der Code die Eingabe auf verschiedene Weise verändern kann, bevor er die Pfade verwendet. Wir müssen uns sowohl benutzerdefinierte Funktionen ( `has_bad_subnet`) als auch integrierte Funktionen ( `object.get`) ansehen, um nur eines der möglichen Hindernisse zu veranschaulichen:
Zum Glück sind wir damit nicht allein: Schon seit dem ersten Programm fragen sich Menschen, was Programme tun. Im Allgemeinen gibt es zwei Möglichkeiten, eine solche Frage zu einem Codeabschnitt zu beantworten:
Statische Analyse: Wir versuchen, die Frage anhand des Syntaxbaums, der Typen und anderer statischer Informationen zu beantworten, die wir aus dem OPA-Interpreter abrufen (oder ihm hinzufügen) können. Der Vorteil: Wir müssen die Policy nicht ausführen. Das ist hilfreich, wenn wir den Autoren der Policy nicht vertrauen. Der Nachteil: Statische Analysemethoden führen in der Regel sowohl zu falsch negativen als auch zu falsch positiven Ergebnissen.
Laufzeitanalyse: Wir zeichnen die Ausführung bestimmter Policies nach und leiten anhand der Laufzeitinformationen ab, welche `Paths` verwendet werden. Der Nachteil: Wir müssen die Policy tatsächlich ausführen, und diese Analyse kann die Auswertung der Policy verlangsamen.
Wir haben beide Ansätze ausprobiert, uns aber für den zweiten entschieden, da sich dieser deutlich zuverlässiger implementieren ließ und der Leistungsaufwand vernachlässigbar war. Außerdem ist es keine Entweder-oder-Entscheidung: Sie können auch einen hybriden Ansatz wählen und beide Methoden kombinieren.
OPA bietet eine Tracer-Schnittstelle, über die Ereignisse zu den Vorgängen im Interpreter empfangen werden können. Tracer werden häufig verwendet, um Metriken oder Debugging-Informationen an ein zentrales Protokoll zu senden. Heute setzen wir sie jedoch für einen anderen Zweck ein.
Verwendung von Termen nachverfolgen
Rego ist eine ausdrucksstarke Sprache. Auch wenn durch Desugaring einiges in ein einfacheres Format für den Interpreter umgewandelt wird, gibt es immer noch eine ganze Reihe von Ereignissen.
Für uns sind nur zwei davon relevant. Ein Wert gilt als verwendet, wenn:
1. er mit einem anderen Ausdruck vereinheitlicht wird (Sie können sich das wie eine Zuweisung vorstellen; auf die Details gehen wir nicht ein), zum Beispiel:
Das gilt auch für `==` und `:=`. Da dieser Test fehlschlagen kann, können wir sagen, dass sowohl die linke als auch die rechte Seite verwendet wurden.
2. er als Argument an eine integrierte Funktion übergeben wird, zum Beispiel:
Rego übernimmt zwar einige Konzepte aus Lazy Languages, aber Argumente für integrierte Funktionen sind immer vollständig gebunden, bevor die Funktion aufgerufen wird. Daher können wir sagen, dass alle an die Funktion übergebenen Argumente verwendet wurden.
3. er als eigenständiger Ausdruck verwendet wird, zum Beispiel:
Das wird häufig verwendet, um Boolesche Werte auszuwerten und zu prüfen, ob Attribute vorhanden sind.
Jetzt ist es Zeit für die Implementierung. Wir gleichen zwei Ereignisse ab und übergeben sie jeweils an eine bestimmte Funktion, damit der Code besser lesbar ist:
Das Einfügen in unseren `PathTree` behandeln wir später in einer Hilfsfunktion namens `used(*ast.Term)`. Zunächst markieren wir die linke und die rechte Seite der Vereinheitlichung als verwendet:
`event.Plug` ist eine Hilfsfunktion, die Variablen durch ihre tatsächlichen Werte ersetzt.
Ein `EvalOp`-Ereignis deckt die oben genannten Fälle (2) und (3) ab. Bei einer integrierten Funktion erhalten wir ein Array von Termen. Das erste Element ist die Funktion, die übrigen Elemente sind die Argumente. Ob es sich um eine integrierte Funktion handelt, können wir anhand von `ast.BuiltinMap` prüfen.
Der Fall eines eigenständigen Ausdrucks ist einfach.
Terme annotieren
Bei der Implementierung von `used(*ast.Term)` stellt sich die nächste Frage: Wie ordnen wir einen Term einem `Path` in der Eingabe zu?
Eine Möglichkeit wäre, das Eingabedokument nach passenden Termen zu durchsuchen. Das würde aber zu vielen falsch positiven Ergebnissen führen, da eine Zeichenfolge wie `10.0.0.0/24` mehrfach in der Eingabe vorkommen kann!
Stattdessen versehen wir alle Terme mit ihrem Pfad, also wir annotieren sie. Terme in OPA können Metadaten enthalten, darunter die Position in der Rego-Quelldatei. Dieses Feld können wir wiederverwenden, um darin einen Eingabe-`Path` zu speichern. Das ist ein wenig umständlich, aber bei genauerer Betrachtung durchaus vertretbar, da das Feld zum Speichern von Positionen vorgesehen ist.
Der folgende Ausschnitt veranschaulicht, wie wir die ersten Zeilen unserer CloudFormation-Vorlage annotieren möchten:
`annotate` durchläuft den Wert rekursiv, um den `Path` jedes Knotens zu bestimmen. Der Einfachheit halber unterstützen wir nur Objekte und lassen Mengen und Arrays außen vor.
Mit dieser Annotation lässt sich `used(*ast.Term)` ganz einfach schreiben. Dabei müssen Sie nur beachten, dass nicht alle Werte annotiert sind. Wir tun dies nur für Werte aus dem Eingabedokument, nicht etwa für Literale, die im Rego-Quellcode enthalten sind.
Zusammenfassung
Das war’s! Viele Details haben wir ausgelassen, etwa Arrays und die Anwendung auf eine komplexere IaC-Sprache wie HCL.
Zusätzlich markieren wir auch die `Type`-Attribute als verwendet, da wir sie in unserer Policy prüfen. Das ist nicht ideal. Als Alternative versuchen wir, stattdessen eine ressourcenorientierte Rego-API bereitzustellen. Das geht jedoch über den Rahmen dieses Beispiels hinaus.
Wenn Sie mehr über diese Features erfahren möchten, empfehlen wir Ihnen snyk/policy-engine für die Kernimplementierung oder das aktualisierte Snyk IaC. Es bietet dieses und zahlreiche weitere Features, darunter ein umfassendes Regelpaket.
Zum Abschluss folgt eine Hauptfunktion, die alles miteinander verbindet und einige Debugging-Informationen ausgibt. Sie fasst im Wesentlichen die bisher definierten Grundfunktionen zusammen und führt sie anhand eines Beispiels aus. Wir nehmen sie trotzdem auf, damit dieser Beitrag als reproduzierbares, eigenständiges Beispiel funktioniert.
Den vollständigen Code für diesen PoC finden Sie in diesem Gist.
IaC-Sicherheit für Entwickler
Snyk schützt Ihre Infrastructure as Code vom SDLC bis zur Laufzeit in der Cloud mit einer einheitlichen Policy-as-Code-Engine, damit jedes Team sicher entwickeln, bereitstellen und betreiben kann.