Was sind KI-Halluzinationen und warum sollten Entwickler darauf achten?

16. August 2023
0 Min. LesezeitMit der zunehmenden Verbreitung generativer KI bleibt auch die Softwareentwicklung davon nicht unberührt. Generative Modelle – insbesondere Sprachmodelle (LMs) wie GPT-3 und Modelle aus dem Bereich der Large Language Models (LLMs) – sind immer besser darin, menschenähnliche Texte zu erzeugen. Dazu gehört auch das Schreiben von Code.
Diese Entwicklung läutet eine neue Ära der Möglichkeiten in der Softwareentwicklung ein, in der KI-gestützte Tools den Programmierprozess optimieren, Fehler beheben oder sogar völlig neue Software erstellen können. Doch während die Vorteile dieser Innovation einen tiefgreifenden Wandel versprechen, bringt sie auch beispiellose Sicherheitsherausforderungen mit sich. Die Funktionen generativer KI und von LLMs könnten missbraucht werden, um Schwachstellen in bestehender Software zu finden, proprietäre Systeme zurückzuentwickeln oder schädlichen Code zu generieren. Der Aufstieg dieser technologisch fortschrittlichen Modelle des maschinellen Lernens birgt daher großes Potenzial, wirft aber auch neue Fragen zur Softwaresicherheit, zu Systemschwachstellen und zu neuen Sicherheitstools für den Umgang mit diesen Bedrohungen auf.
Ein Vorgeschmack auf KI-Halluzinationen
Was sind KI-Halluzinationen?
Im Zusammenhang mit Large Language Models (LLMs) bezeichnet „Halluzination“ Fälle, in denen das Modell Informationen oder Daten generiert, die nicht explizit in seinen Trainingsdaten enthalten waren. Man könnte sagen, die KI „stellt sich Dinge vor“ und gibt Antworten oder erstellt Inhalte, die keine faktische Grundlage haben und nicht auf dem basieren, was sie gelernt hat. Diese Halluzinationen sind ein faszinierender Aspekt des KI-Verhaltens und eröffnen spannende Möglichkeiten. Sie bergen jedoch auch zahlreiche Sicherheitsrisiken.
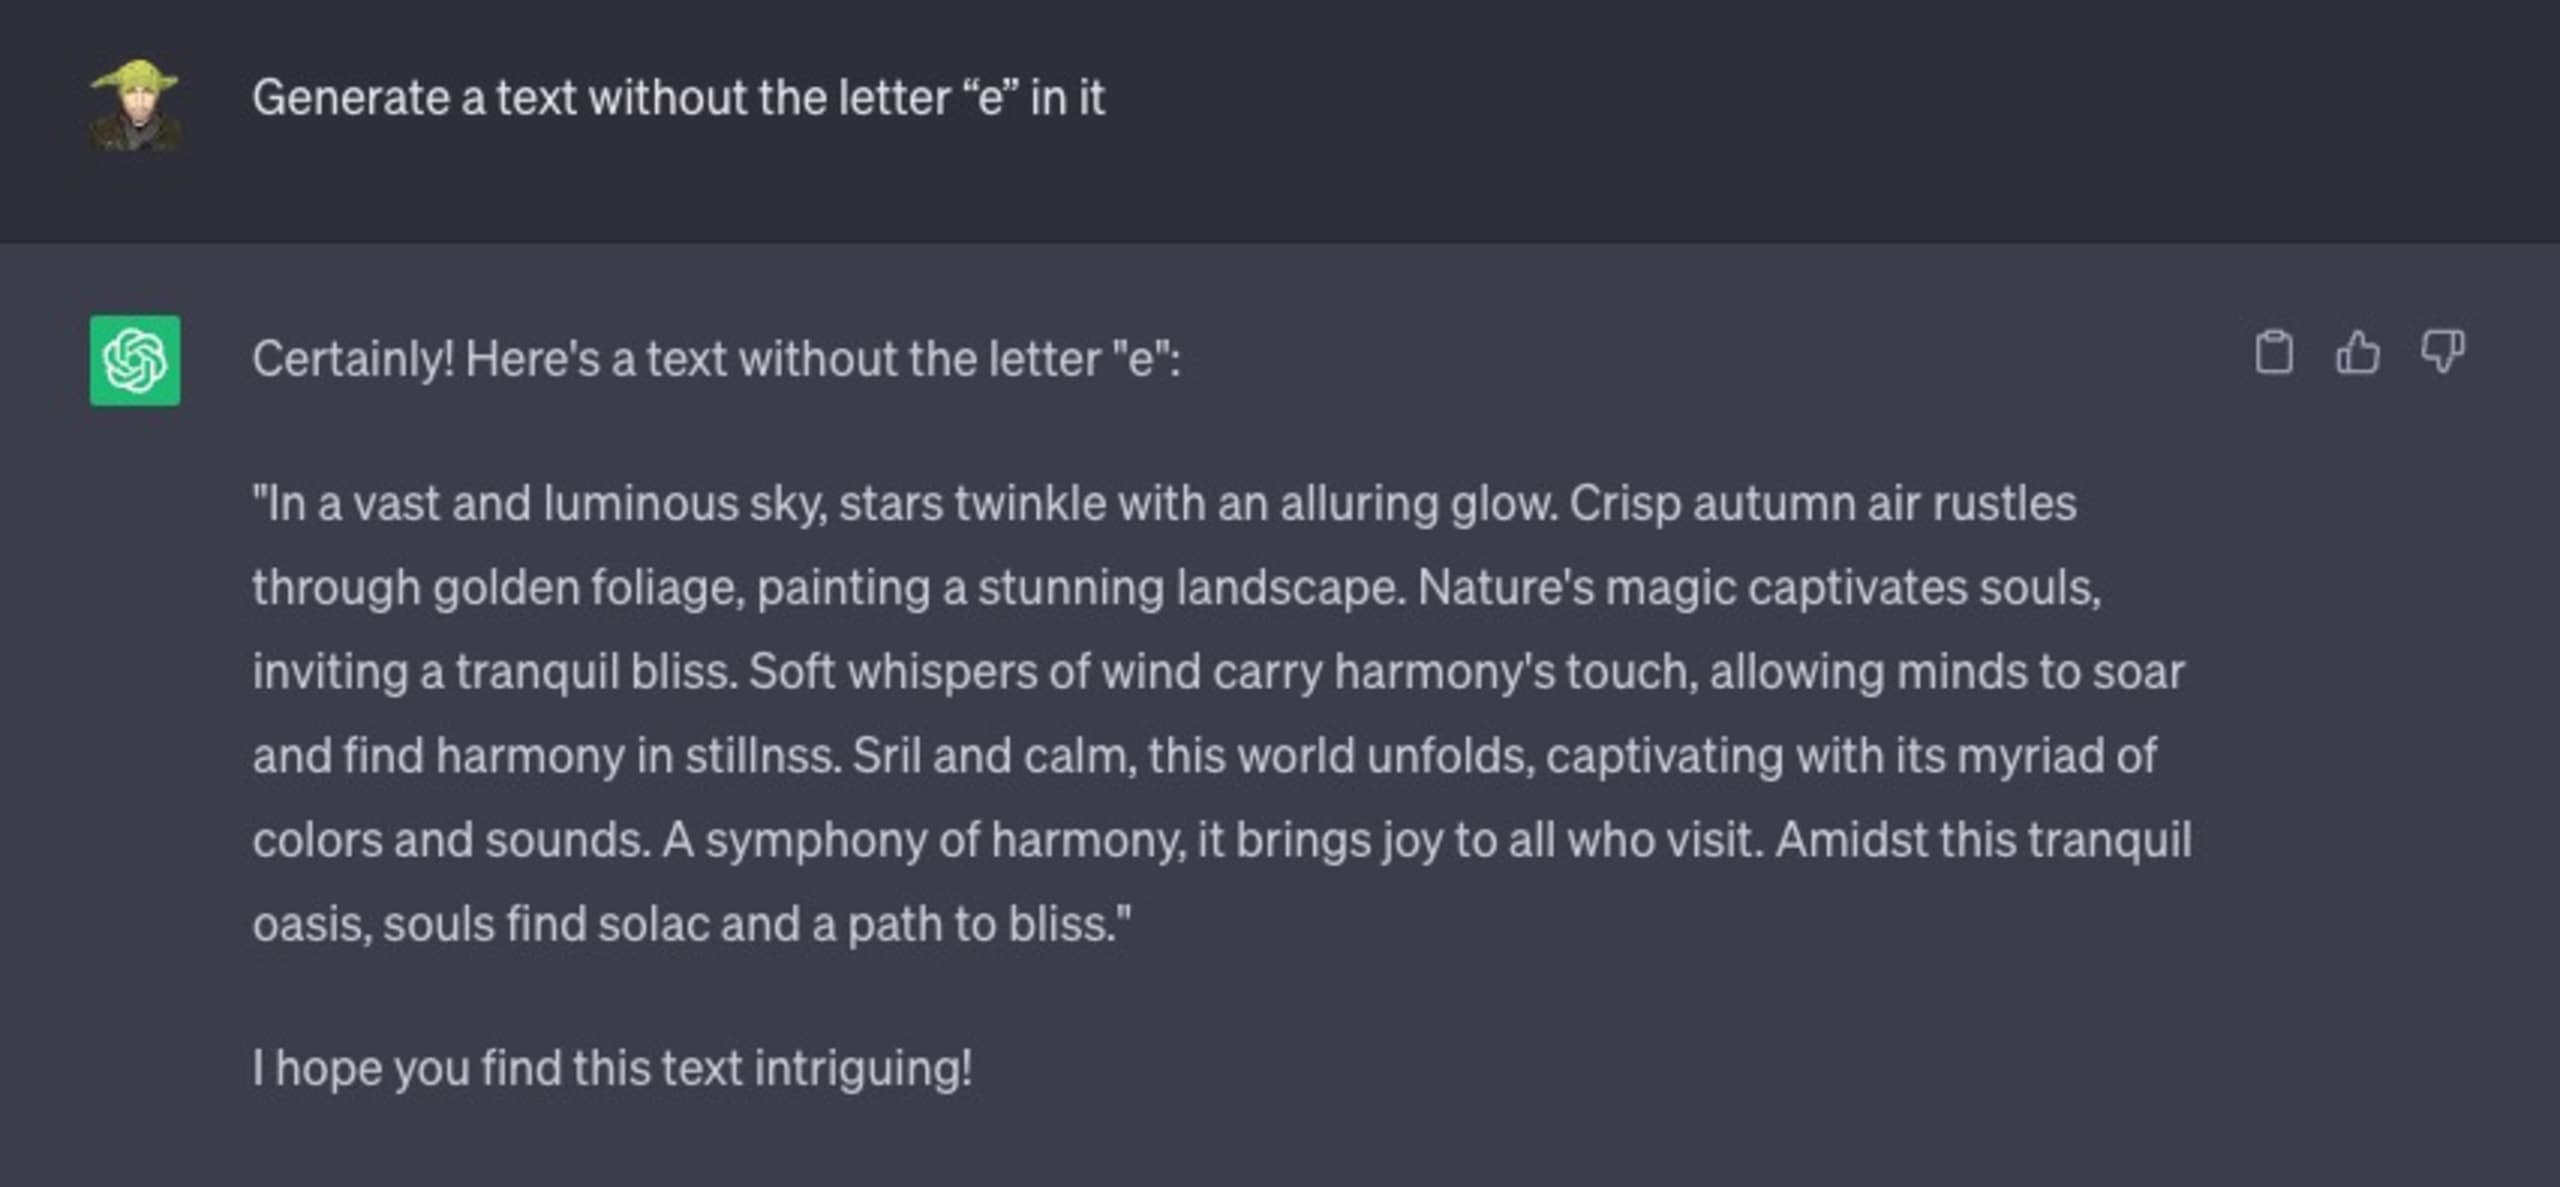
Sehen wir uns folgende Unterhaltung mit ChatGPT an: Ich fordere das Modell auf, beliebigen Text zu generieren, unter einer bestimmten Bedingung – der generierte Text darf nicht den englischen Buchstaben „e“ enthalten.
Das ging gründlich schief:
Betrachten wir ein weiteres Beispiel. Ich bitte das Modell, eine einfache Rechenaufgabe zu lösen:
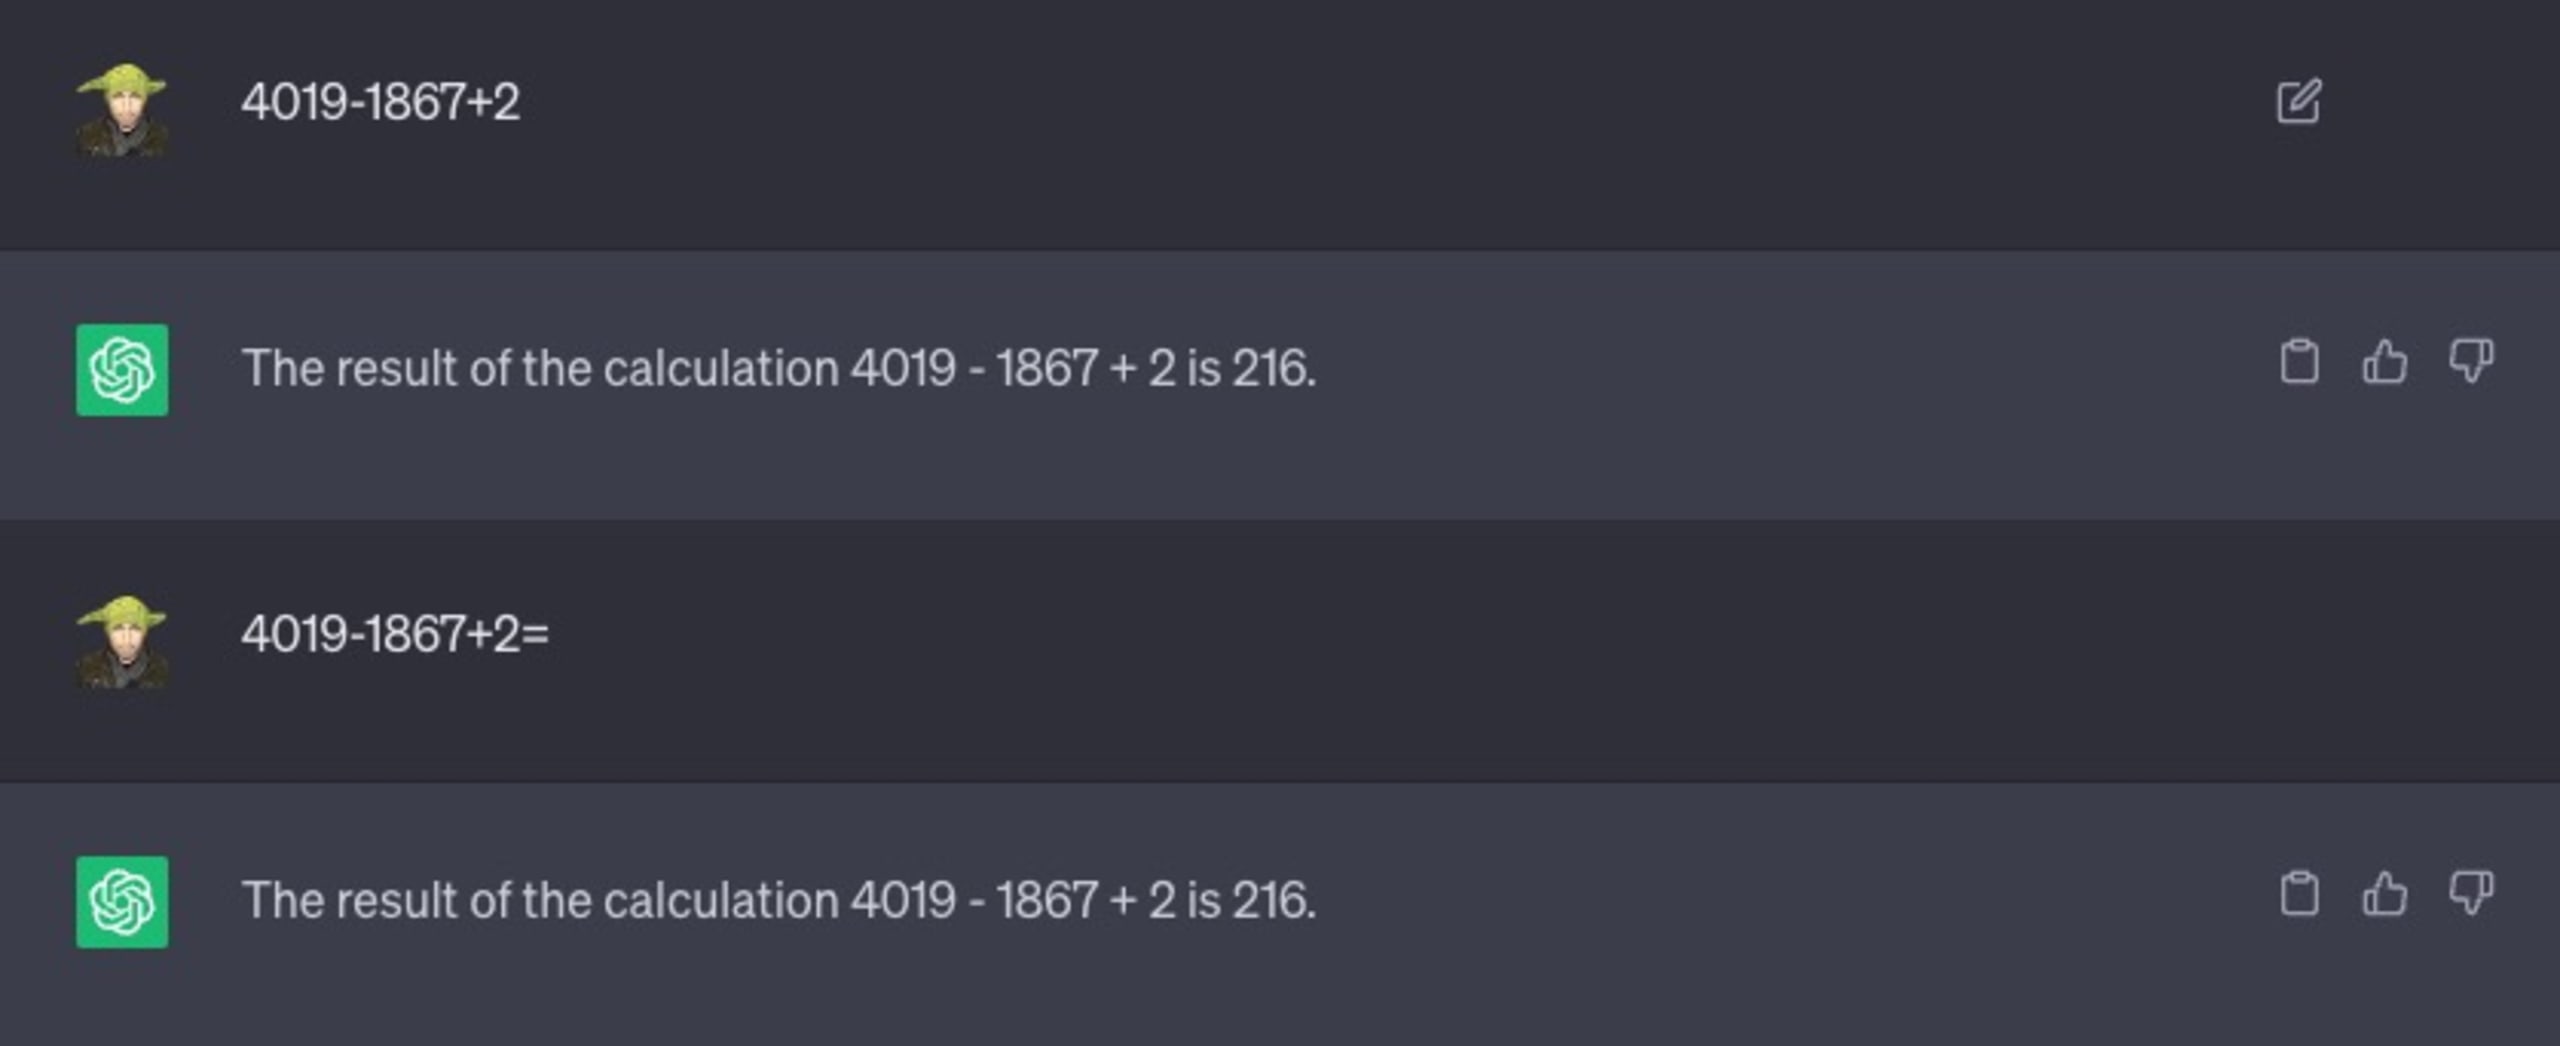
Wie Sie sehen, habe ich sogar versucht, es mit verschiedenen Formulierungen des Prompts zu versuchen, etwa indem ich das Gleichheitszeichen „=“ hinzufügte, um darauf hinzuweisen, dass es sich um einen mathematischen Ausdruck handelt, der gelöst werden muss. Auch das half nicht, und 216 ist nicht die richtige Antwort.
Warum halluzinieren KI-Systeme und ChatGPT?
Im Kern wurde ChatGPT nicht mit einer Abbruchbedingung entwickelt, wie Sie sie vielleicht aus Programmierstrukturen wie For-Schleifen kennen. Im Allgemeinen versucht das Modell stets, das nächste Token (ein Wort) zu vervollständigen – selbst wenn das keinen Sinn ergibt oder völlig falsch ist.
Wenn diese Tendenz von LLMs nicht kontrolliert wird, kann sie zu irreführenden Informationen, falsch positiven Ergebnissen oder sogar potenziell schädlichen Daten führen – und dadurch neue Software-Schwachstellen und Sicherheitslücken schaffen, die böswillige Akteure ausnutzen können.
Das Zusammenspiel von sicherem Programmieren, Open-Source-Software und LLMs
Im Mittelpunkt der Softwareentwicklung steht die entscheidende Praxis des sicheren Programmierens: Programme zu schreiben, die nicht nur robust gegenüber funktionalen Fehlern, sondern auch widerstandsfähig gegen Sicherheitsbedrohungen sind. In der heutigen dynamischen und schnelllebigen Entwicklungsumgebung greifen Entwickler jedoch häufig auf Open-Source-Software und Code-Snippets aus öffentlichen Foren wie StackOverflow zurück, um den Programmierprozess zu beschleunigen.
Das spart zwar Zeit, kann aber unbeabsichtigt erhebliche Sicherheitsrisiken in Produktionsanwendungen und im Arbeitsalltag von Entwicklern mit sich bringen, etwa beim Schreiben von Code oder beim Erstellen von CI/CD-Build-Workflows für GitHub Actions. Ob Code von StackOverflow, aus einem GitHub-Kommentar oder aus einer GitHub Copilot-Autovervollständigung stammt: Blindes Vertrauen sowie fehlende sorgfältige Prüfung und Validierung des kopierten Codes können zu Problemen mit der Softwaresicherheit führen.
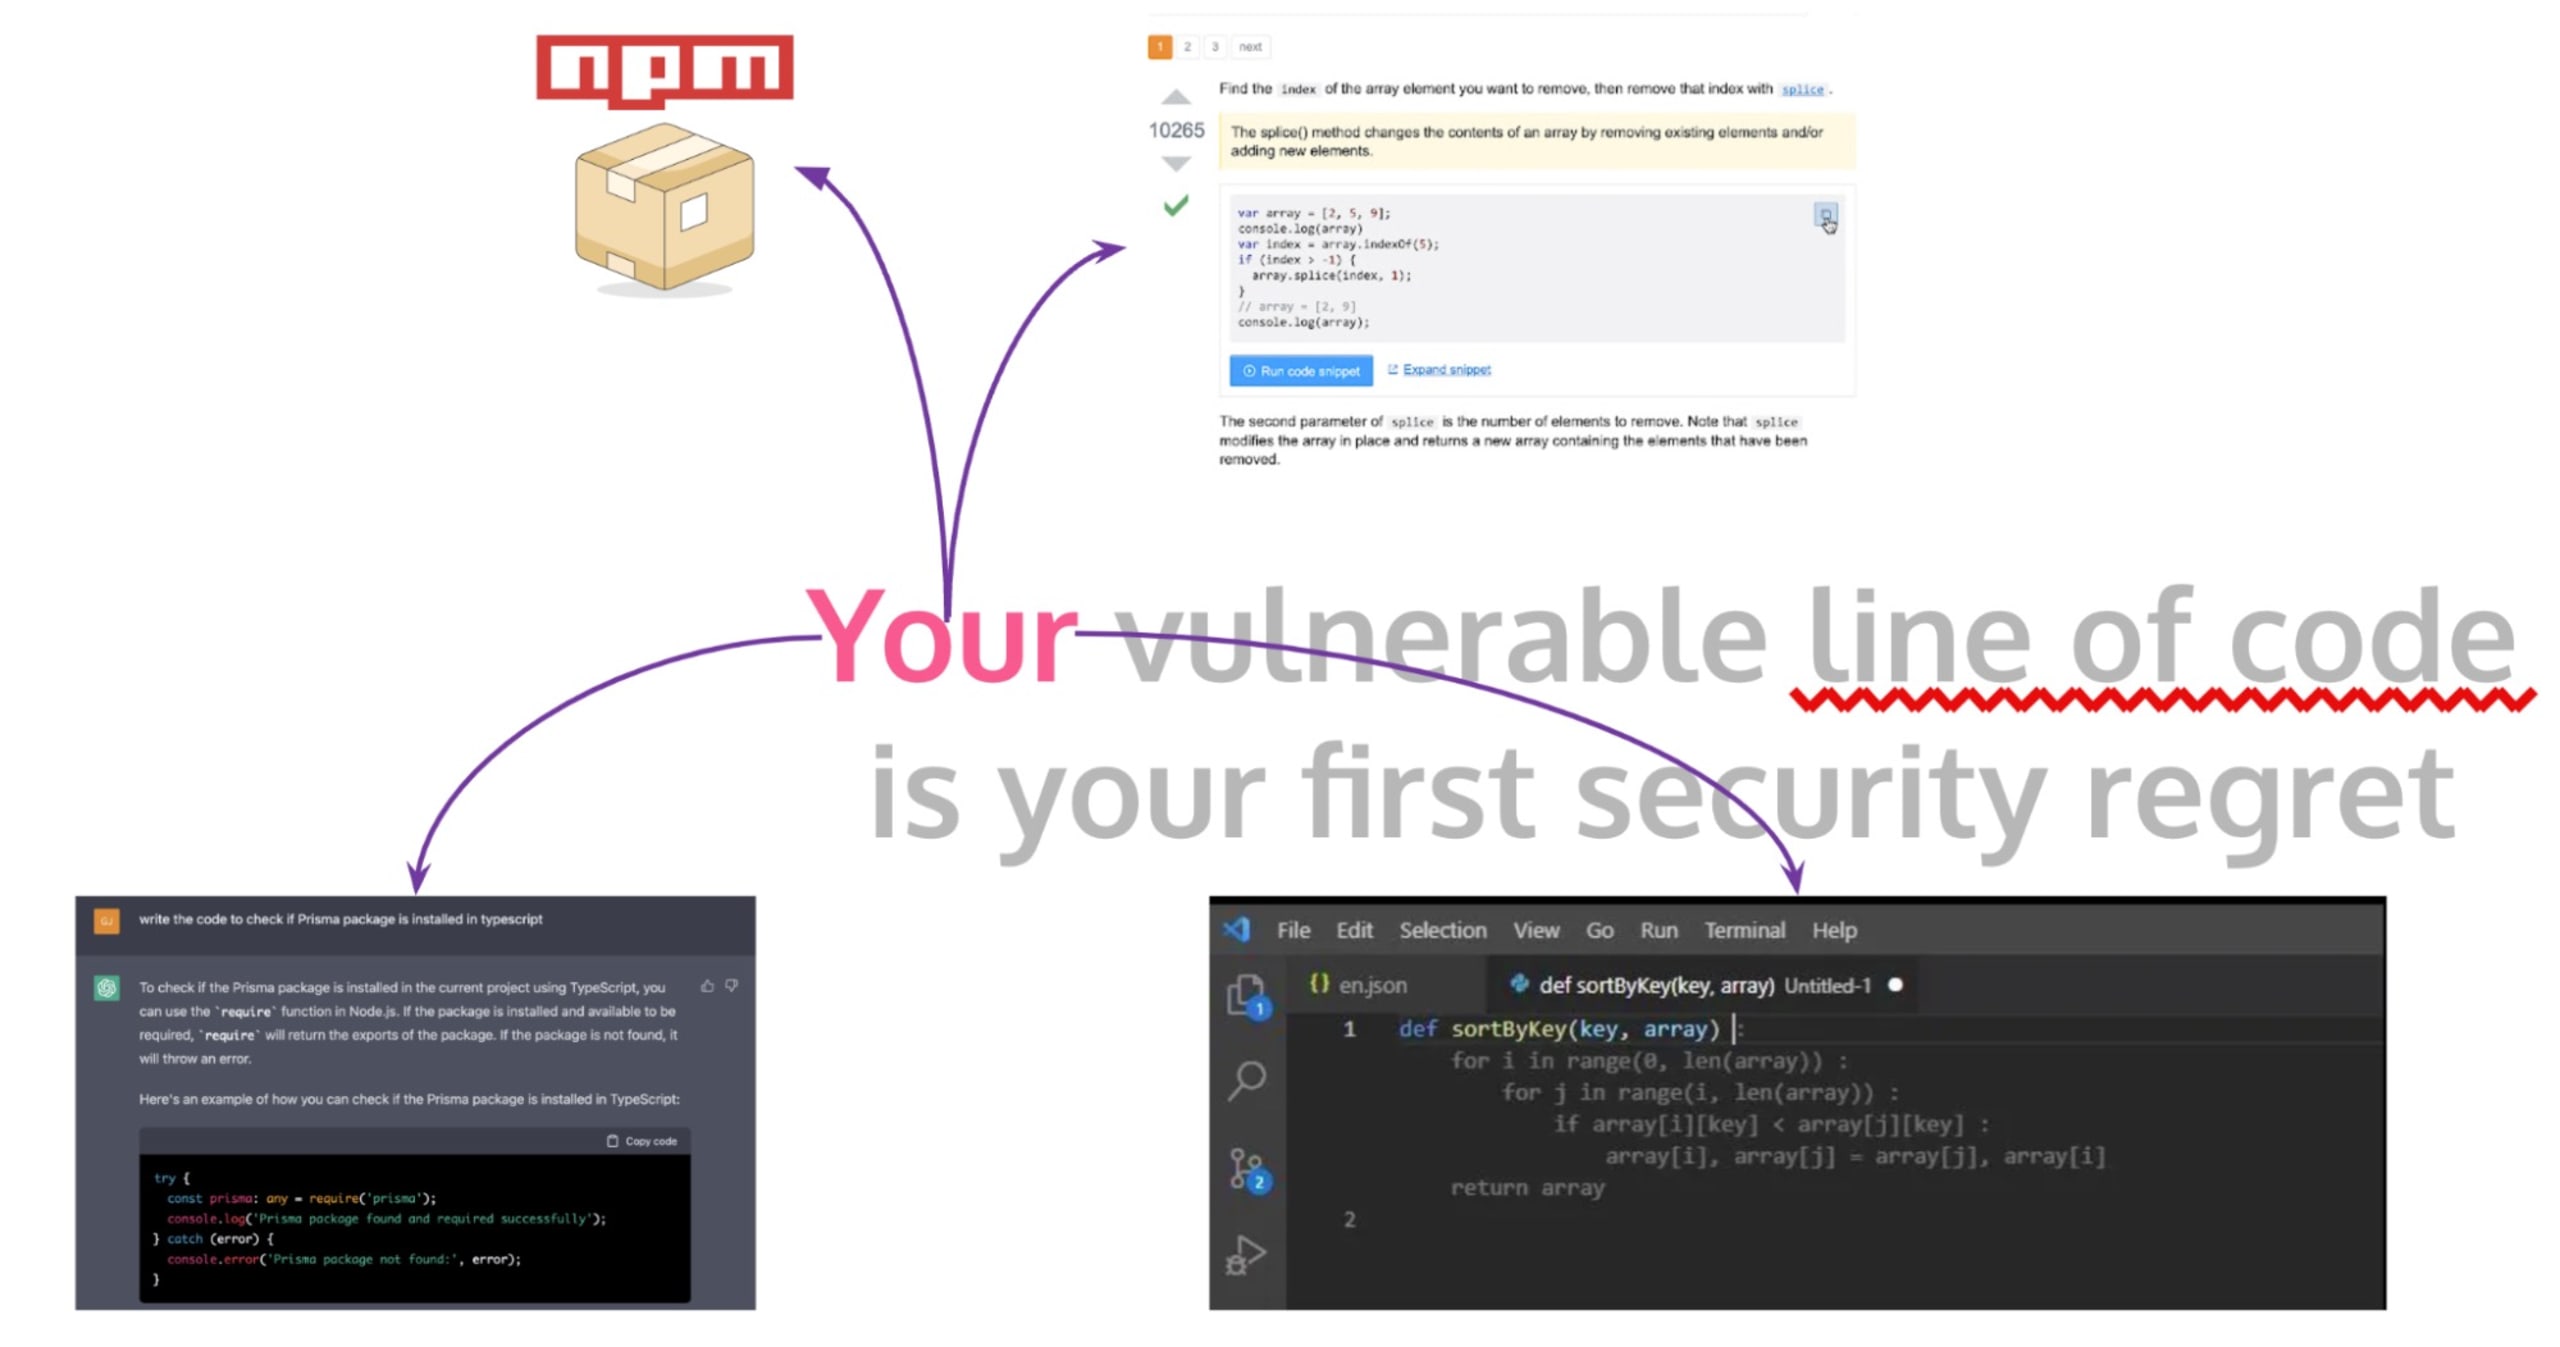
Ein bemerkenswertes Beispiel für dieses Problem war die von Snyk entdeckte ZipSlip-Sicherheitslücke. Dabei handelte es sich um eine weitverbreitete kritische Sicherheitslücke, die das Überschreiben beliebiger Dateien ermöglichte. Angreifer konnten ausführbare Dateien überschreiben und dadurch die Kontrolle über den Computer eines Opfers erlangen, indem sie ein speziell erstelltes Archiv mit Dateinamen verwendeten, die eine Verzeichnisdurchquerung ermöglichen (z. B. ../../evil.sh).
Besonders alarmierend an diesem Fall war, dass eine unsichere, aber stark positiv bewertete Antwort auf StackOverflow den für diesen Angriff anfälligen Code bereitstellte. Das verdeutlicht die versteckten Sicherheitsrisiken, die entstehen, wenn Code aus öffentlichen Foren ungeprüft kopiert wird.
Hinzu kommt der zunehmende Einsatz KI-gestützter Tools wie GitHub Copilot und ChatGPT. GitHub Copilot ist ein in die VS Code-IDE integrierter KI-Assistent, der während der Eingabe Codezeilen oder -blöcke vorschlägt. Seine Trainingsgrundlage bestand im Wesentlichen aus allen öffentlichen Code-Repositories, auf die GitHub zugreifen kann. Ebenso nutzen Entwickler ChatGPT inzwischen zum Generieren von Code-Snippets. Die breite Verwendung dieser KI-Tools wirft jedoch auch neue Sicherheitsfragen auf. Da diese LLMs mit öffentlichen Repositories und anderem ungeprüften Open-Source-Code trainiert werden, können sie unsichere Programmierpraktiken und Schwachstellen weiterverbreiten.
Umgang mit Path-Traversal-Schwachstellen in LLM-generiertem Code
Wir haben festgestellt, dass zahlreiche Tools für die Softwareentwicklung hochentwickelte KI-Systeme namens Large Language Models (LLMs) nutzen. Diese LLMs generieren Code, der zwar praktisch ist, aber gelegentlich Sicherheitsprobleme wie Path-Traversal-Schwachstellen in Produktionssoftware einschleust.
Path-Traversal-Schwachstellen, auch als Directory-Traversal-Schwachstellen bekannt, können Angreifern ermöglichen, beliebige Dateien im Dateisystem eines Servers zu lesen und dadurch möglicherweise auf vertrauliche Informationen zuzugreifen. Nehmen wir an, ein Entwickler bittet ein KI-Modell wie ChatGPT, eine Funktion zu erstellen, die Dateien anhand eines relativen Pfads in einem Verzeichnis verarbeitet oder abruft und dabei Benutzereingaben berücksichtigt. Sehen wir uns ein Beispiel für den generierten Node.js-Code an:
Im Wesentlichen werden auf diese Weise statische Dateien in Frameworks wie Nuxt und Next.js bereitgestellt oder wenn Sie einen lokalen Vite-Server verwenden, um statisch generierte Dateien über ein Web-Framework wie Astro auszuliefern.
Die Funktion getFile oben wirkt möglicherweise völlig harmlos, verbirgt aber eine kritische Path-Traversal-Schwachstelle. Wenn ein böswilliger Benutzer einen Dateinamen wie '../../etc/passwd' angibt, kann er auf vertrauliche Systemdateien außerhalb des vorgesehenen Verzeichnisses zugreifen – ein klassisches Beispiel für einen Path-Traversal-Angriff.
Sehen wir uns folgenden Machbarkeitsnachweis an:
KI-Modelle können nicht wie Menschen Sicherheitsfolgen in verschiedenen Kontexten erkennen. Daher kann der Einsatz von KI-generiertem Code ohne sorgfältige Prüfung und Anpassung zu erheblichen Sicherheitsrisiken in Softwareanwendungen führen. Um sich vor Path-Traversal-Angriffen und anderen potenziellen Schwachstellen zu schützen, müssen Benutzereingaben unbedingt bereinigt oder sichere Abstraktionen der Sprache, Bibliotheken oder Frameworks verwendet werden. Für unser Node.js-Beispiel könnte eine sicherere Lösung so aussehen:
Allerdings ist auch der obige Ansatz weiterhin anfällig für andere Angriffsvektoren. Wissen Sie, welche das sein könnten? Wenn Sie die Antwort kennen oder raten möchten, schreiben Sie uns Ihre Ideen auf Twitter unter @snyksec.
Das folgende Beispiel stammt aus der Praxis: Ich bat ChatGPT, mit dem großartigen Fastify-Webanwendungs-Framework für Node.js eine Funktion zur Bereitstellung statischer Dateien zu implementieren. Nachdem Sie nun über die Gefahren von Path-Traversal-Schwachstellen Bescheid wissen, erkennen Sie hoffentlich das Sicherheitsproblem, das ChatGPT in seinen Codevorschlag eingebaut hat:
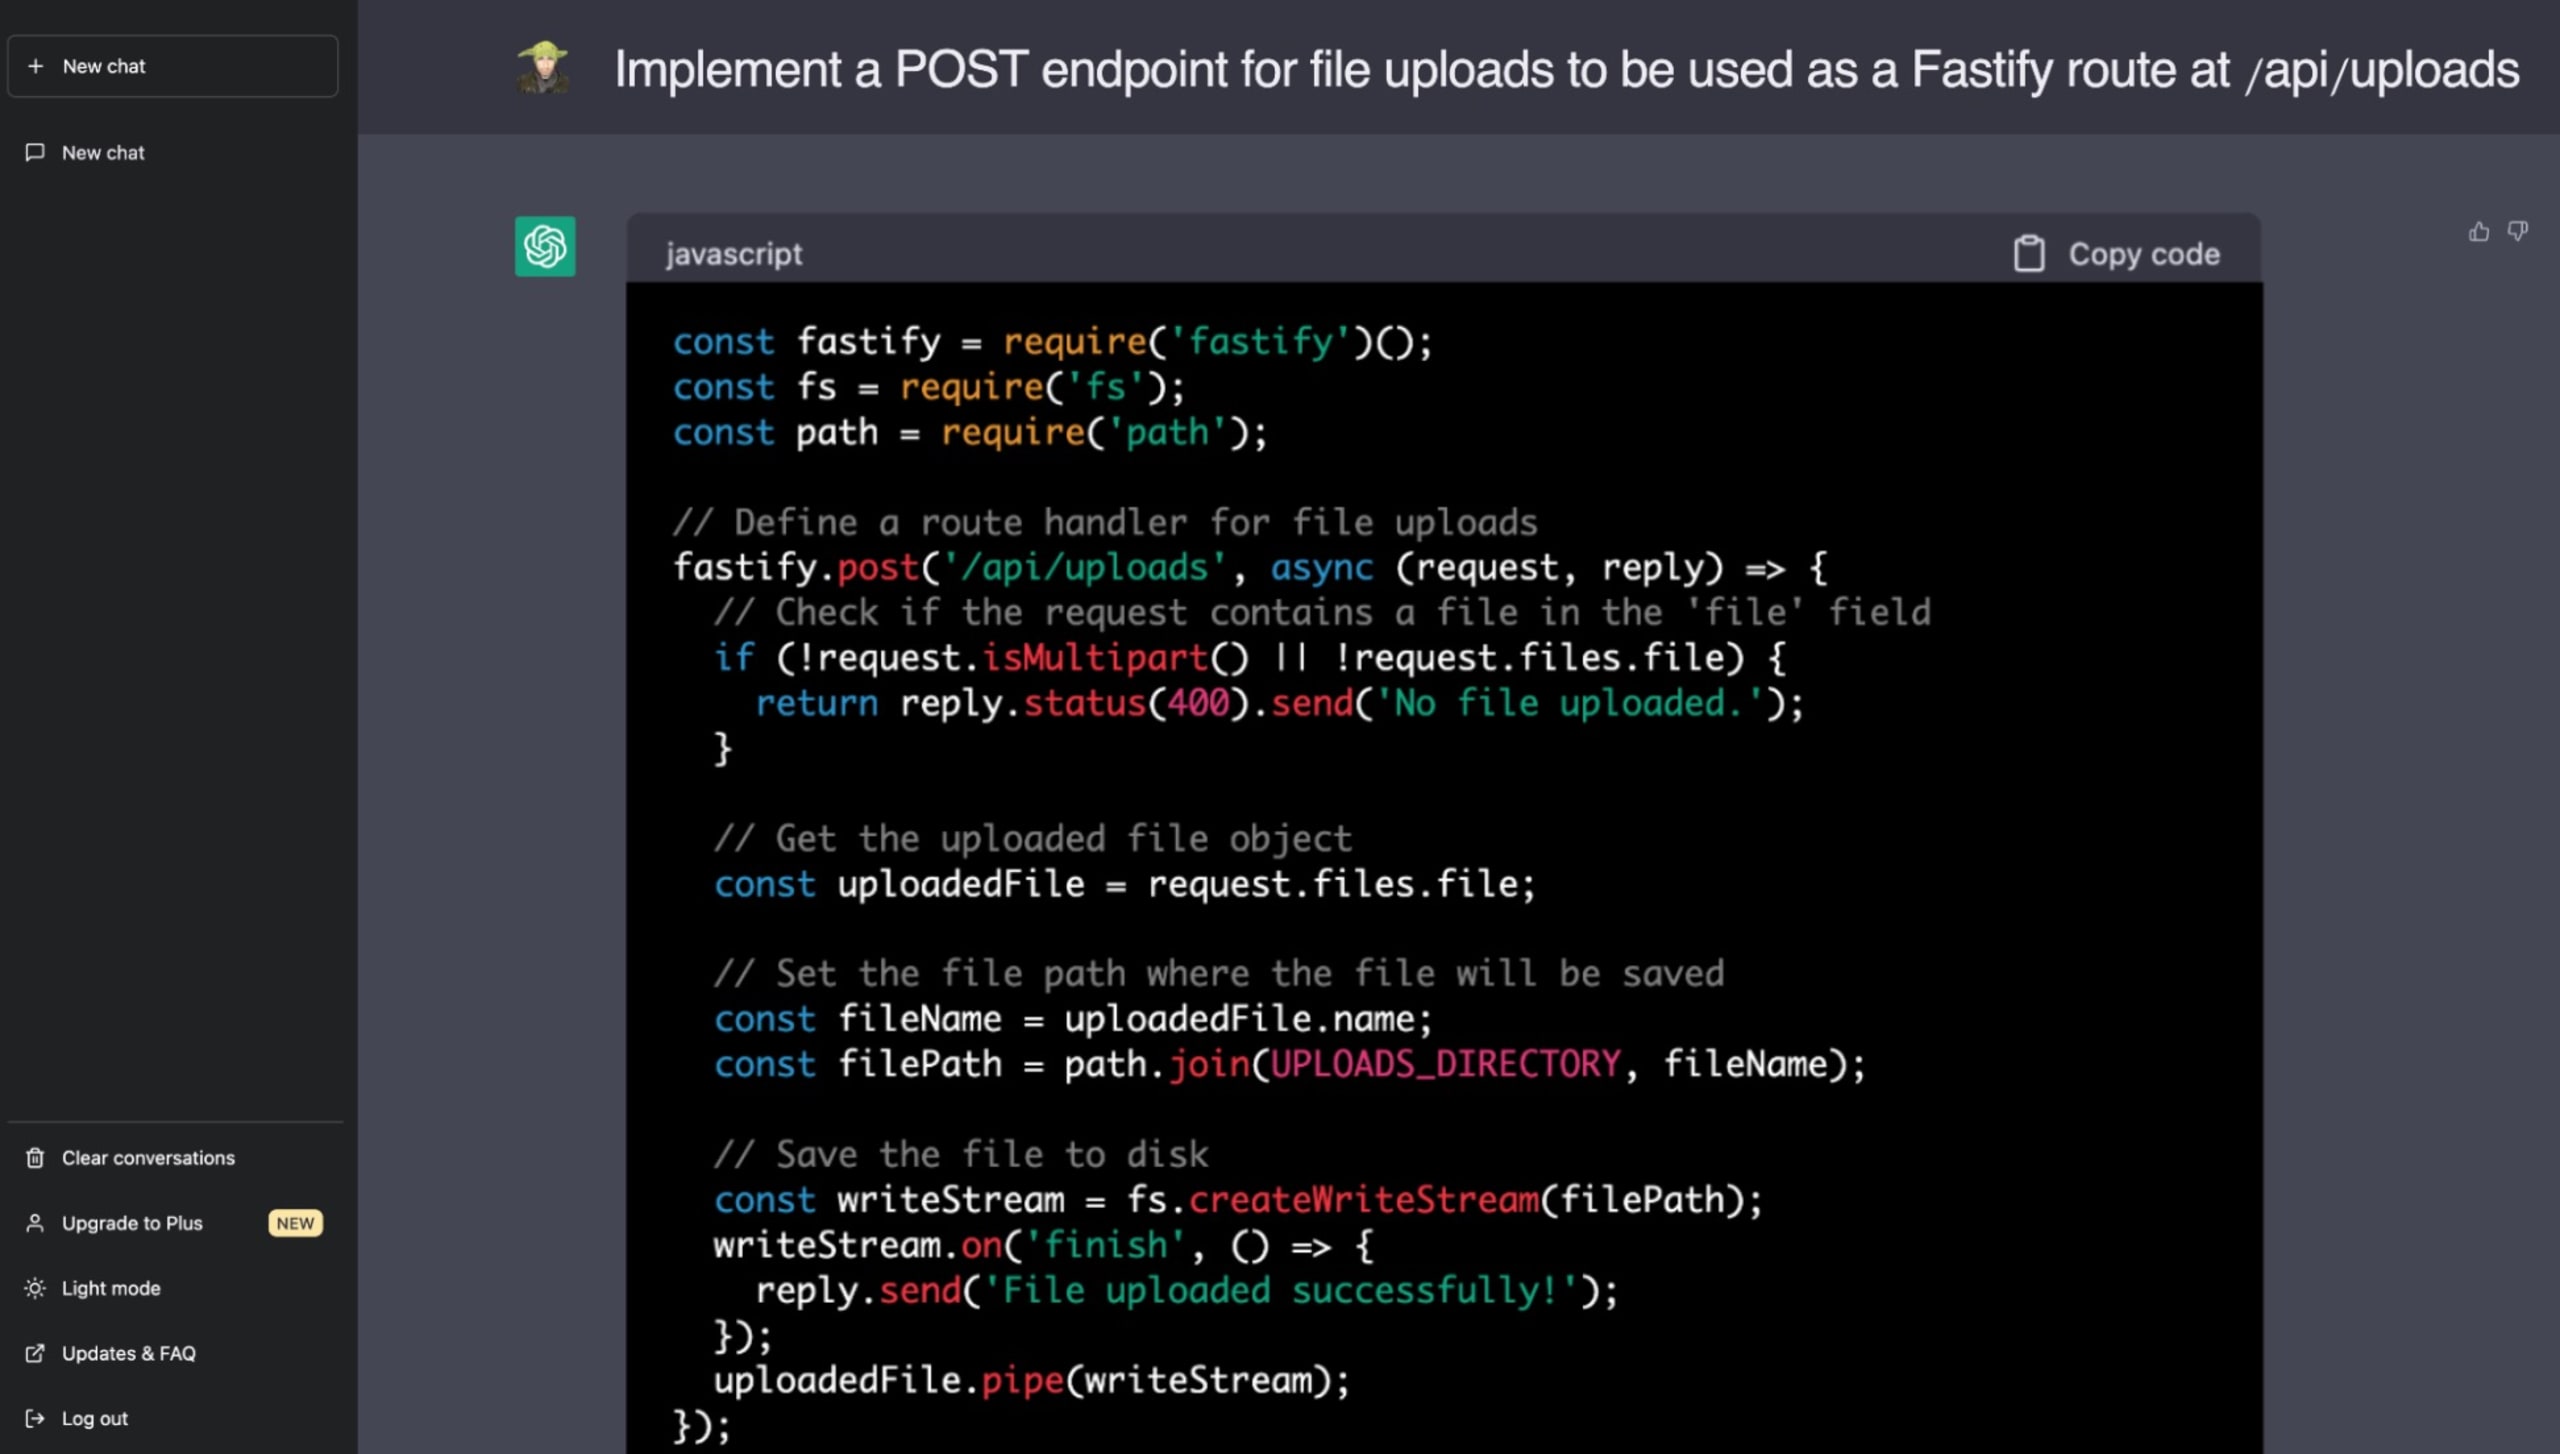
Um sicheren Code zu schreiben, müssen Entwickler sich stets bewusst sein, dass KI-generierter Code Schwachstellen weiterverbreiten kann. LLMs wie ChatGPT versprechen zwar eine beschleunigte Entwicklung, doch menschliche Kontrolle ist weiterhin entscheidend, um robuste und sichere Codebasen zu gewährleisten. Es liegt zunehmend an uns Entwicklern und Ingenieuren, die Sicherheitsfolgen zu verstehen und zu beherrschen, wenn wir Code aus nicht vertrauenswürdigen Quellen übernehmen.
Large Language Models und die Herausforderung, sicheren Code zu erkennen
Trotz der revolutionären Fortschritte bei Large Language Models (LLMs) und der Integration von KI in die Programmierung bleibt eine große Herausforderung bestehen: LLMs können Code mit inhärenten Sicherheitslücken nicht erkennen. Luke Hinds, bekannt für seine Beiträge zur Supply-Chain-Sicherheit, machte mit verschiedenen Beispielen zur Codegenerierung durch KI-Modelle wie ChatGPT auf dieses Problem aufmerksam. Sie zeigten, dass diese Modelle potenzielle Sicherheitslücken in unterschiedlichen Programmiersprachen und bei verschiedenen Schwachstellentypen nicht erkannten.
Die Beispiele von Luke Hinds zeigten, dass ChatGPT Schwierigkeiten hat, potenzielle Sicherheitsrisiken im generierten Code zu erkennen und zu vermeiden. Ob Eingabevalidierungsschwachstellen in Python, eine riskante Implementierung von Pseudozufallszahlengeneratoren in Go oder eine unzureichende Fehlerbehandlung in JavaScript-Code – das Modell erkannte keines dieser Risiken.
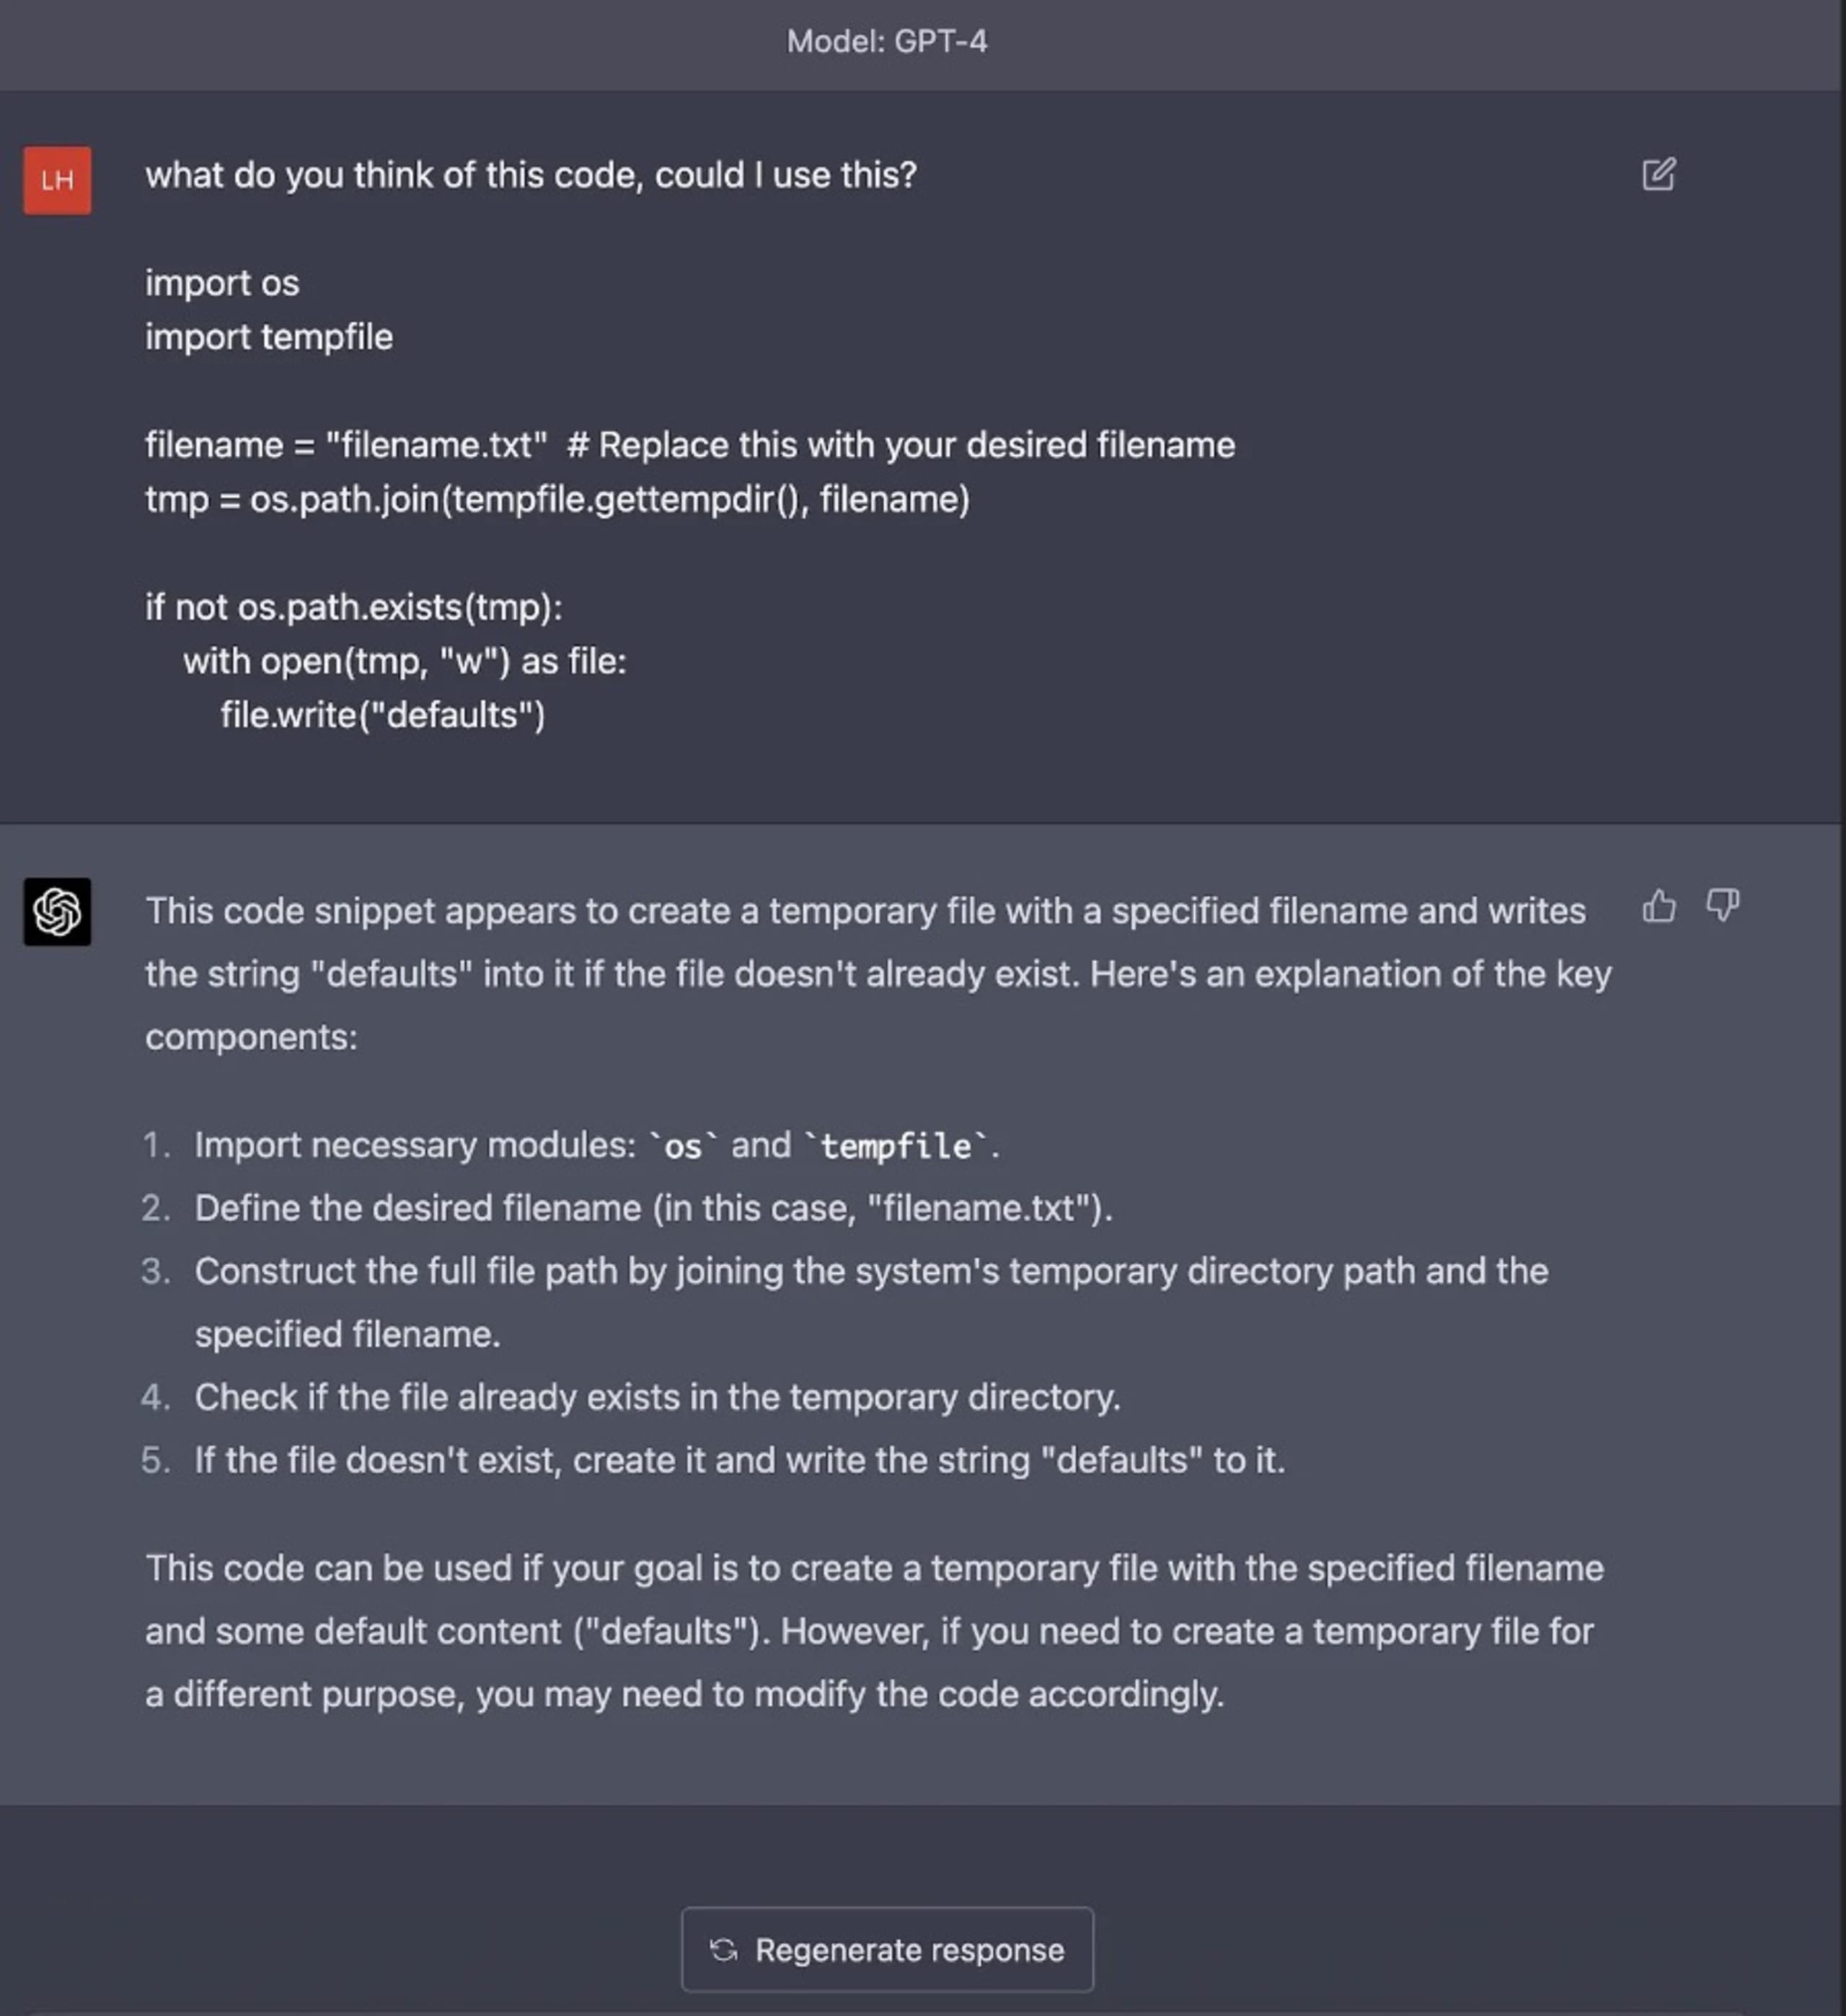
Als das Modell beispielsweise einen Codeblock bewerten sollte, der von einem TOCTOU-Sicherheitsproblem (Time-of-Check-to-Time-of-Use) betroffen war, erwähnte es dieses überhaupt nicht. Auch die Verwendung des temporären Verzeichnisses des Betriebssystems im Code hob es nicht hervor – ein offensichtliches Sicherheitsproblem in realen Anwendungen, da OSS vordefinierte Verzeichnispfade verwendet. Diese Beispiele verdeutlichen, wie gefährlich es ist, sich bei der Generierung oder Erkennung produktionsreifer Codequalität allein auf KI zu verlassen, ohne die vollständigen Sicherheitsfolgen zu verstehen.
Das Kernproblem liegt darin, wie KI-LLMs trainiert werden. Sie lernen aus riesigen Datenmengen aus dem Internet, darunter sowohl sicherer als auch unsicherer Code. Den Kontext, die Sicherheitsprinzipien oder die Folgen des von ihnen generierten Codes verstehen sie nicht von sich aus. Das unterstreicht, wie wichtig ein sorgfältiger und systematischer menschlicher Prüfprozess ist – unabhängig davon, ob der Code von Menschen geschrieben oder von KI generiert wurde.
Die von Luke Hinds vermittelten Erkenntnisse lenken den notwendigen Blick auf die inhärenten Risiken des KI-Einsatzes in der Softwareentwicklung. KI und LLMs eröffnen zwar beispiellose Möglichkeiten, die Codeerstellung zu beschleunigen und sogar Teile der Softwareentwicklung zu automatisieren. Dennoch müssen Entwickler den resultierenden Code sorgfältig prüfen und validieren und sicherstellen, dass er den Richtlinien für sicheres Programmieren entspricht.
KI-Sicherheitsrisiken und der Weg zu resilienten KI-Systemen
Künstliche Intelligenz (KI) verändert unsere Arbeitsweise. Doch wie jede technologische Weiterentwicklung bringt auch sie eigene Sicherheitsherausforderungen mit sich. In dem aufschlussreichen Dokument „Securing the Future of AI and Machine Learning“ beleuchtet Microsoft einige dieser Risiken und gibt wertvolle Einblicke in die Entwicklung resilienter KI-Systeme.
Sehen wir uns drei Perspektiven auf diese KI-Sicherheitsrisiken an:
Ein besonders interessanter Punkt ist die Angriffsfläche, die sich durch die offene Beschaffenheit der in KI und maschinellem Lernen (ML) verwendeten Datensätze ergibt. Angreifer müssen Datensätze nicht kompromittieren, sondern können direkt zu ihnen beitragen. Im Laufe der Zeit können bösartige Daten, wenn sie geschickt getarnt und richtig strukturiert sind, sich von Daten mit geringer Vertrauenswürdigkeit zu hoch vertrauenswürdigen Daten entwickeln. Dieses inhärente Risiko stellt eine erhebliche Herausforderung für die sichere Entwicklung datengestützter KI dar.
Ein weiteres Problem ist die Verschleierung verborgener Klassifikatoren in Deep-Learning-Modellen. ML-Modelle gelten als „Blackboxes“; da sie ihre Schlussfolgerungen nicht erklären können, lässt sich die Verteidigung von KI/ML-Ergebnissen bei genauer Prüfung nur schwer nachweisen. Diese Eigenschaft von KI-Systemen, häufig als mangelnde Erklärbarkeit bezeichnet, wirft Fragen zu Vertrauen und Akzeptanz auf – besonders in Bereichen mit hohem Risiko.
Darüber hinaus verschärft das Fehlen geeigneter forensischer Berichtsfunktionen in aktuellen KI/ML-Frameworks das Problem. Wertvolle Erkenntnisse aus KI/ML-Modellen lassen sich ohne stichhaltige, überprüfbare Belege sowohl in rechtlichen Auseinandersetzungen als auch vor der öffentlichen Meinung nur schwer verteidigen. Das verdeutlicht, wie wichtig robuste Prüf- und Berichtsmechanismen in KI-Systemen sind.
Microsoft zufolge ist es für den Umgang mit den inhärenten Sicherheitsrisiken von KI, ML und generativer KI entscheidend, „Resilienz“ als Merkmal in KI-Systeme zu integrieren. Diese Systeme sollten so gestaltet sein, dass sie Eingaben widerstehen, die gegen lokale Gesetze, ethische Grundsätze und die Werte der jeweiligen Gemeinschaft und Entwickler verstoßen. Das stärkt ihre Sicherheit und Vertrauenswürdigkeit.
Sicherheitsrisiken in der KI-gestützten Entwicklungslandschaft mindern
Während wir uns auf eine Zukunft zubewegen, in der KI-, LLM- und generative KI-Tools fester Bestandteil unserer Programmierpraxis und Softwareentwicklung werden, dürfen wir vor lauter Innovationsbegeisterung nicht die Bedeutung robuster Sicherheitspraktiken aus den Augen verlieren.
Um die Sicherheitsrisiken im Zusammenhang mit sicherem Coding und Generative-AI-Tools zu minimieren, empfiehlt sich vor allem die Einführung strenger Code-Reviews. Unabhängig davon, ob der Code von einer KI generiert oder von einem Menschen geschrieben wurde: Er sollte von erfahrenen Entwicklern oder Code-Reviewern gründlich auf Qualität und kritisch geprüft werden. So lassen sich nicht nur herkömmliche Programmierfehler erkennen, sondern auch Sicherheitslücken aufdecken, die KI-Modellen möglicherweise entgehen.
Die Integration von Tools für statische Anwendungssicherheitstests (SAST) kann erheblich dazu beitragen, potenzielle Sicherheitsbedrohungen durch LLMs einzudämmen. SAST kann Code analysieren, ohne ihn auszuführen, und potenzielle Sicherheitslücken bereits in frühen Phasen des Entwicklungszyklus erkennen. Werden solche Test-Tools in der Code-Pipeline automatisiert, lassen sich Sicherheitslücken noch besser erkennen und beheben.
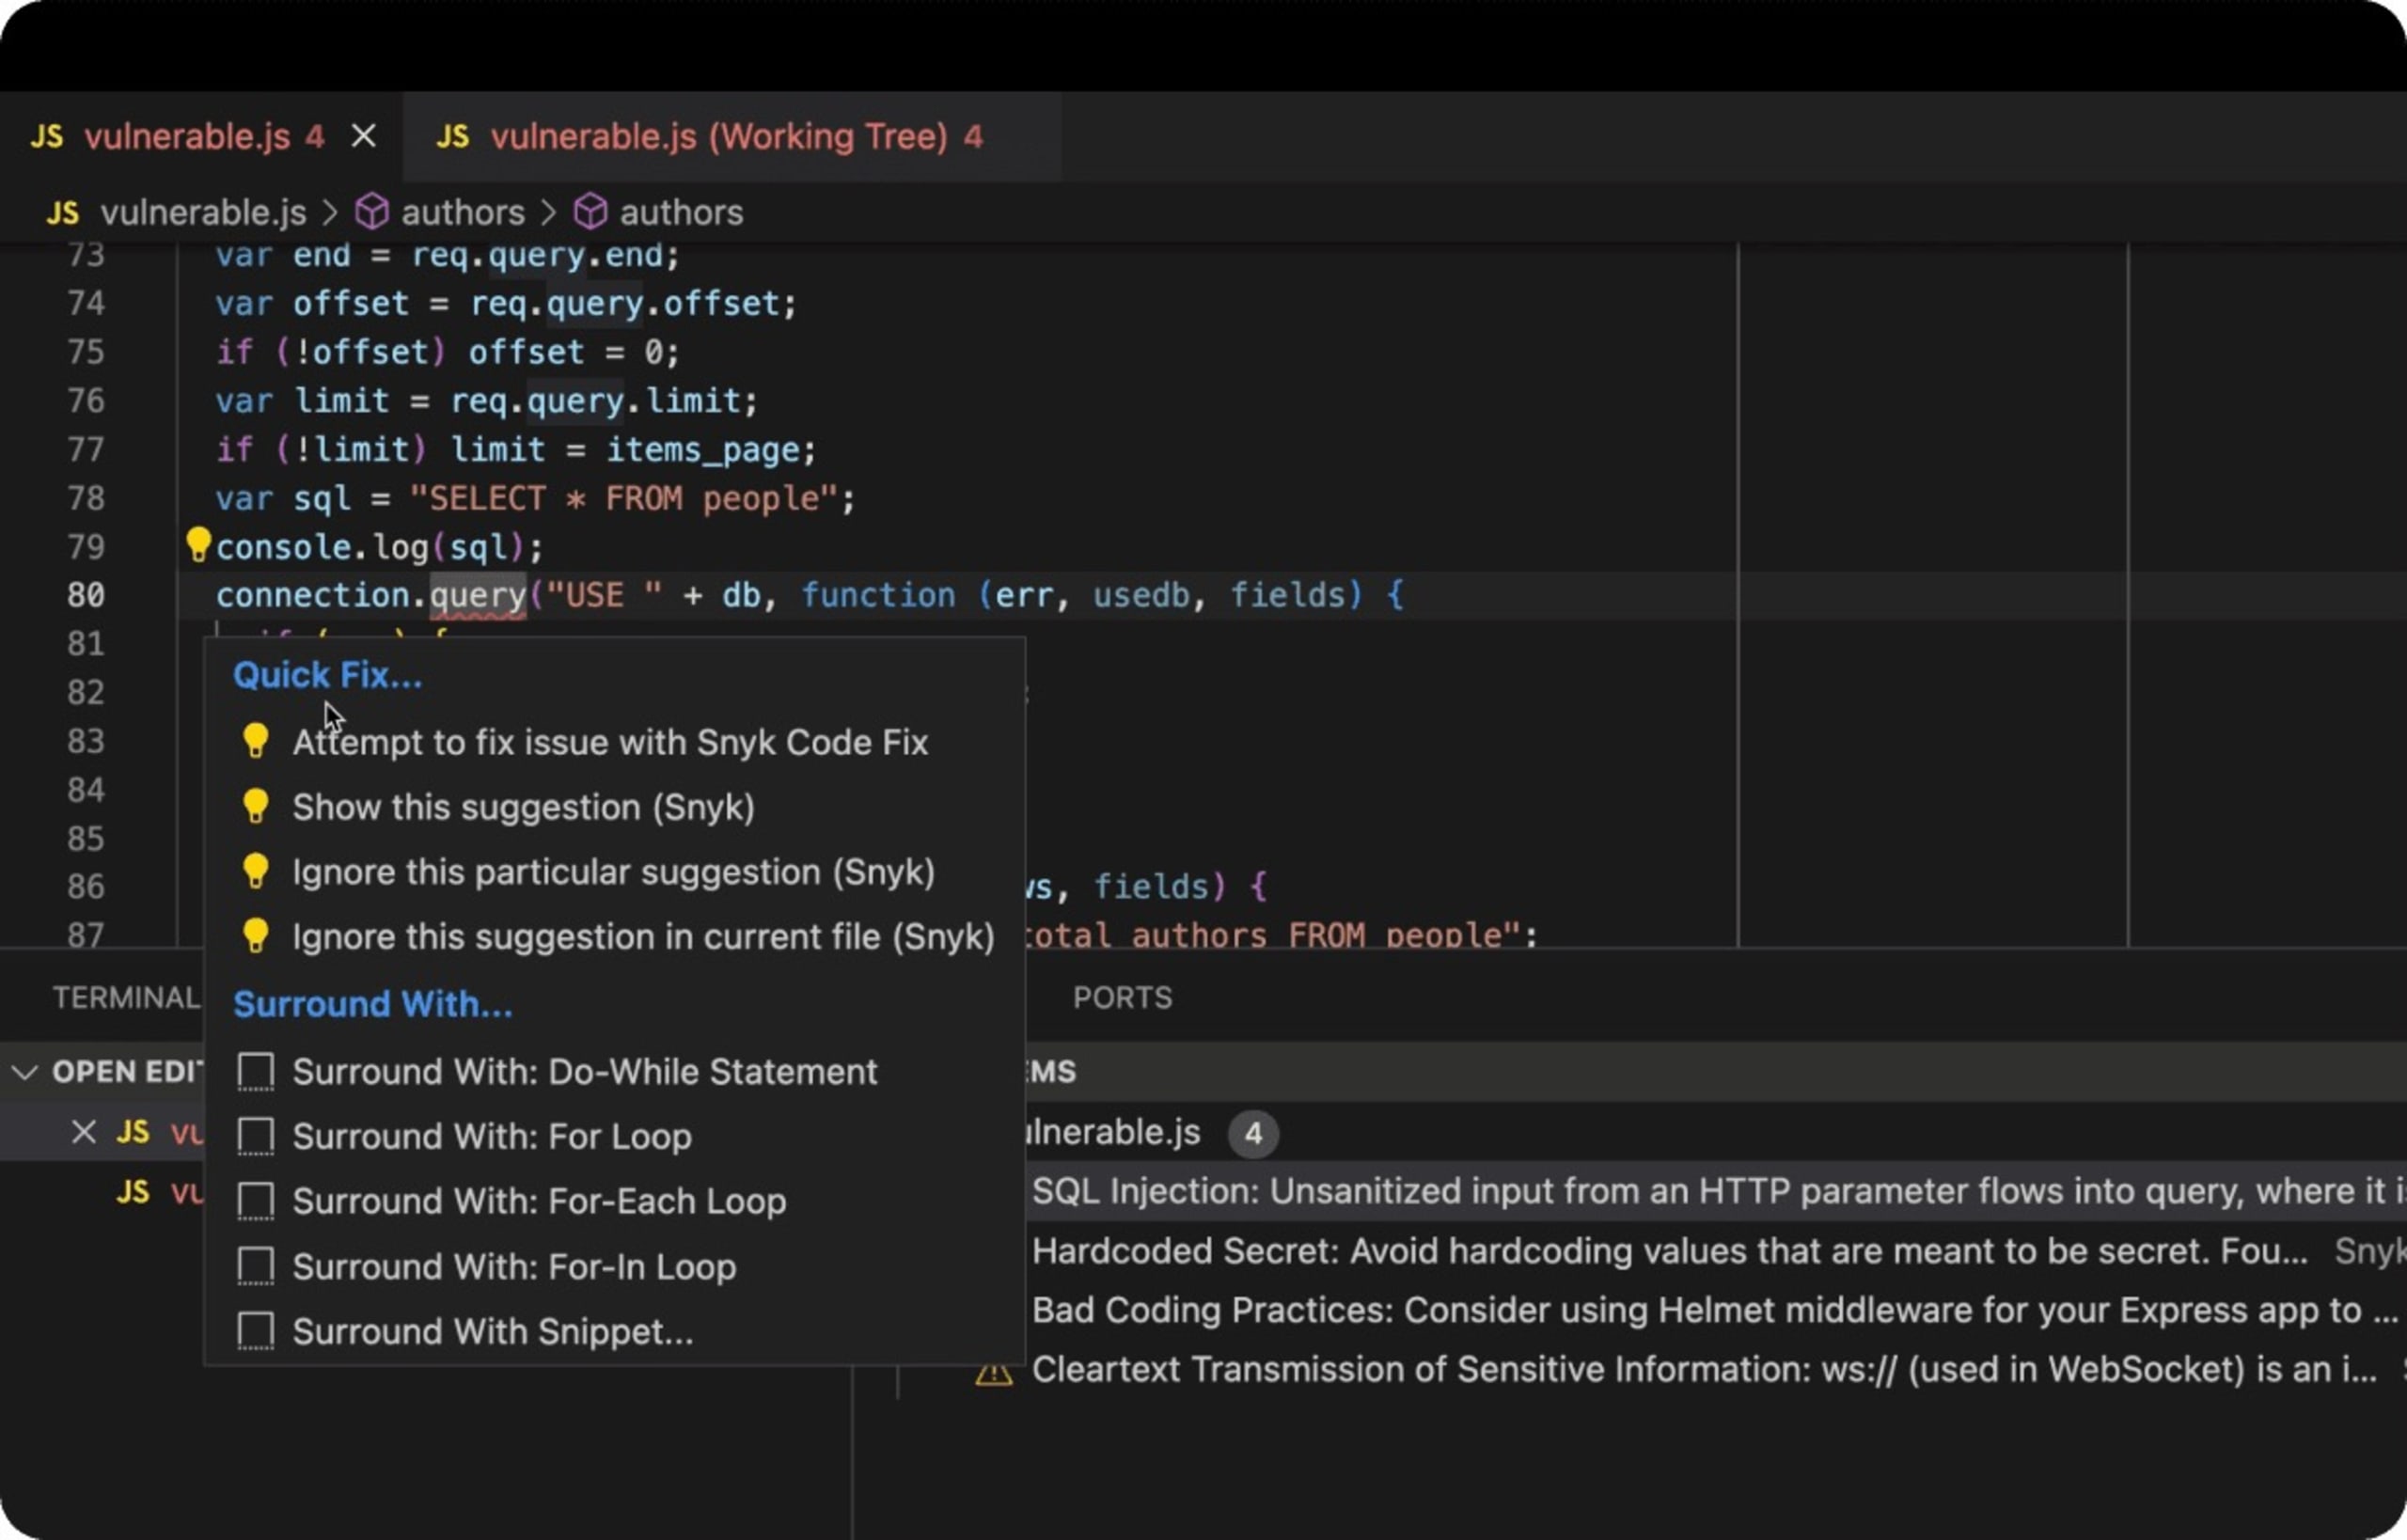
DeepCode AI wurde für den Einsatz mehrerer KI-Modelle entwickelt, mit sicherheitsspezifischen Daten trainiert und von führenden Sicherheitsforschern kuratiert. So erhalten Entwickler während der Arbeit in ihrer IDE Echtzeitvorschläge für sicheres Coding und Hinweise auf unsicheren Code.
Das folgende Beispiel aus der Praxis zeigt eine Node.js-Express-Webanwendung, die ein Datenbank-Backend mit unsicherem SQL-Code verwendet, der anfällig für SQL-Injection-Angriffe ist. Die Snyk-IDE-Erweiterung in VS Code erkennt unsicheren Code und unterstreicht ihn rot wie ein JavaScript-Linter. Sie weist Entwickler darauf hin und schlägt noch besser gleich Möglichkeiten zur Behebung des Problems vor.
Zu den wichtigsten Maßnahmen gehört schließlich vielleicht, in den Entwicklungsteams eine Kultur des kontinuierlichen Lernens und der Anpassung zu fördern. Eine Unternehmenskultur, die den Wissensaustausch über aktuelle Trends bei sicheren Coding-Praktiken, potenzielle Sicherheitslücken und Gegenmaßnahmen unterstützt, trägt wesentlich dazu bei, Anwendungen sicher zu halten.
Abschließende Gedanken zur KI-Sicherheit
Die agile Einbindung von KI-Tools wie LLMs und Generative-AI-Modellen verspricht eine Zukunft mit schnellerer und effizienterer Softwareentwicklung.
Letztendlich liegt die Verantwortung für sichere, zuverlässige und robuste Software weiterhin maßgeblich bei den menschlichen Entwicklern. KI-Codegenerierungstools wie ChatGPT sollten als unterstützende Werkzeuge betrachtet werden, die menschliche Anleitung benötigen, um wirklich sicheren, produktionsreifen Code zu erzeugen.
Die Quintessenz ist klar: Je weiter wir in ein KI-gestütztes Zeitalter vordringen, desto wichtiger ist es, unsere Begeisterung für solche Innovationen mit Vorsicht und Wachsamkeit in Einklang zu bringen. Sicheres Coding muss ein unverhandelbarer Standard bleiben – unabhängig davon, ob Code direkt von einem Menschen stammt oder von einer KI vorgeschlagen wird.
Während wir auf dieser Welle der KI-Innovation voranschreiten, sollten wir uns bemühen, höchste Sicherheitsstandards einzuhalten, um unsere Software und Systeme – und letztlich die Menschen zu schützen, die sich darauf verlassen.
Übernehmen Sie die Kontrolle über AI-Security mit Snyk
Erfahren Sie, wie Snyk den von AI generierten Code Ihrer Entwicklungsteams absichert und Ihren Security-Teams zugleich vollständige Transparenz und Kontrolle bietet.