Eine Zusammenfassung der Sicherheitsnews mit einem CrewAI-KI-Agenten erstellen
Artikel von

0 Min. Lesezeit
Zahlreiche Quellen für Sicherheitsnews und Schwachstellendatenbanken zu durchforsten, ist mühsam. Doch dank agentischer KI-Workflows können wir diese Arbeit an ein LLM delegieren. Dieser Artikel zeigt, wie Sie mit dem Open-Source-Framework CrewAI einen KI-Agenten erstellen, der Sicherheitsnews kuratiert.
KI-Agenten zum Kuratieren von Sicherheitsnews
Bei der Anwendung, die wir erstellen, konzentrieren wir uns darauf, neue Sicherheitslücken aus der Snyk Vulnerability Database als Sicherheitsnews-Feed zu kuratieren.
Unser KI-Agent wird ein Kommandozeilen-Tool sein, das die Webseite der Snyk Vulnerability Database für ein bestimmtes Ökosystem öffnet (wir verwenden das npm-JavaScript-Ökosystem) und die drei relevantesten CVE-Berichte auswählt, die er für besonders wichtig hält.
Erste Schritte mit CrewAI
Im ersten Schritt richten wir in einem Verzeichnis Ihrer Wahl in Ihrer lokalen Entwicklungsumgebung ein neues Projektverzeichnis ein und initialisieren dort das CrewAI-Framework.
Voraussetzungen:
Der uv-Paketmanager ist installiert und lokal verfügbar.
Eine Python-Laufzeitumgebung >= 3.x (kann mit
uvinstalliert werden)
Beginnen wir im Verzeichnis Ihrer Wahl mit der Installation der crewai-Bibliothek und der Tools:
Fügen Sie sie anschließend Ihrer Shell-Umgebung hinzu, damit wir den Befehl crewai wie ein globales ausführbares Programm ausführen können:
Jetzt können wir ein neues crewai-Projekt einrichten:
Installieren Sie anschließend die Abhängigkeiten dieses Projekts mit folgendem Befehl:
Das eingerichtete Projektverzeichnis sollte nun wie folgt aussehen:
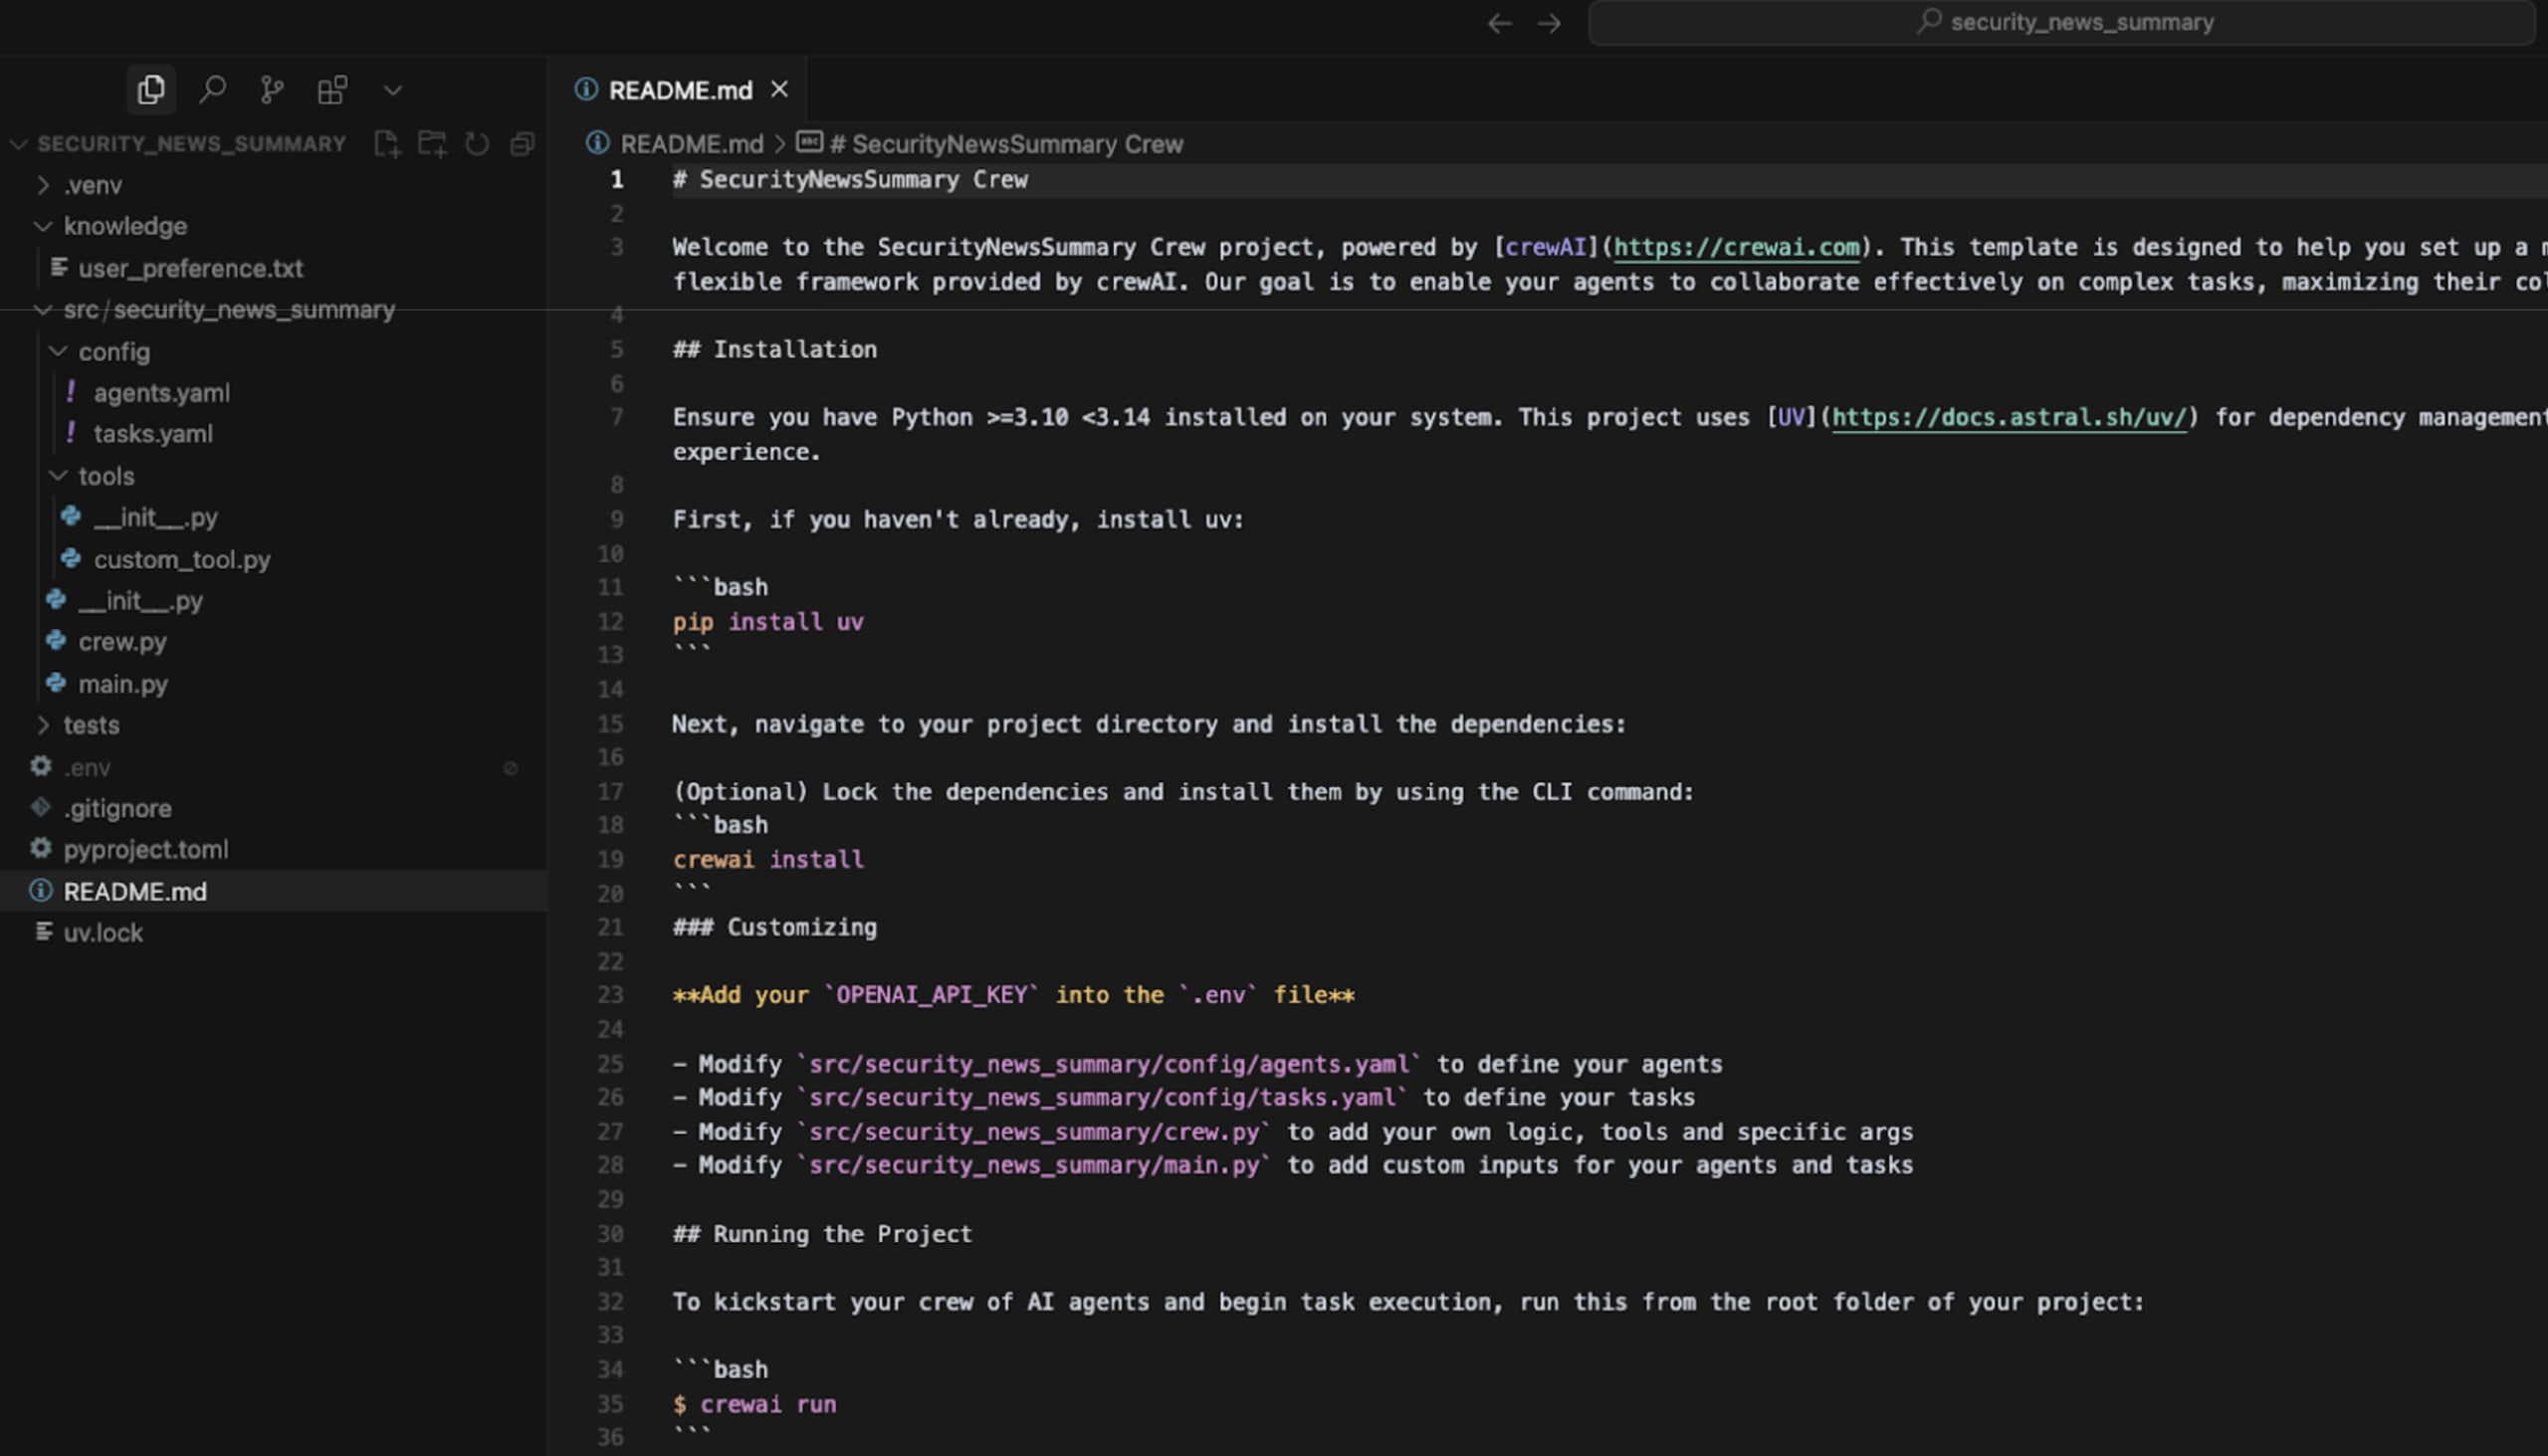
Auf hoher Ebene enthält CrewAI eine crew.py-Datei, in der die Agenten und Aufgaben definiert werden:
Dieselbe Datei enthält auch die Aufgaben, die wir mit diesen Agenten ausführen möchten:
Die Datei main.py enthält mehrere exportierte Funktionen wie run(), train() und weitere, die die Agenten aufrufen und ihnen die benötigten Eingaben für ihre Arbeit bereitstellen.
So sieht der Ablauf zum Starten der Agenten in der Python-Hauptdatei aus:
Das oben Beschriebene entspricht der standardmäßigen Projektverzeichnisstruktur, die CrewAI erstellt. Wir nehmen jedoch Änderungen vor, definieren eigene Agenten und Aufgaben und entwickeln ein eigenes Tool, das die Agenten aufrufen können.
Individuelle agentische Workflows mit CrewAI erstellen
Wir nehmen Änderungen an drei zentralen Bestandteilen des eingerichteten CrewAI-Projektverzeichnisses vor:
Änderungen an den Agenten in
config/agents.yamlÄnderungen an den Aufgaben in
config/tasks.yamlÄnderungen am CrewAI-Python-Hauptprogramm crew.py
Außerdem erstellen wir im Verzeichnis tools/ ein eigenes Tool, das den HTML-Code einer Webseite mit der verbreiteten Python-Bibliothek BeautifulSoup ausliest.
KI-Agenten
Eine gute Faustregel für KI-Agenten lautet, ihre Aufgaben möglichst kleinteilig aufzuschlüsseln. Wie auch beim Software-Engineering und -Design ist es hilfreich, große Probleme in kleinere zu zerlegen.
Dementsprechend definieren wir zwei Agenten:
Einen CVE-Kurator, der auf der Webseite Links zu den seiner Einschätzung nach wichtigsten CVEs findet.
Einen CVE-Rechercheur, der die einzelnen CVE-Links (Webseiten) aufruft und Daten daraus extrahiert.
Öffnen Sie config/agents.yaml und ersetzen Sie die von CrewAI erstellte Agentendefinition durch Folgendes:
Aufgaben
Als Nächstes müssen wir die Aufgaben für die oben genannten Agenten definieren:
Die erste Aufgabe besteht darin, Links zu den CVEs aus dem Verzeichnis der Schwachstellendatenbank zu extrahieren (der Hauptwebseite mit den Suchergebnissen bzw. der Liste der Schwachstellen).
Bei der Folgeaufgabe extrahiert der CVE-Rechercheur die CVE-Schwachstellendaten von der Informationsseite zu jeder CVE.
Öffnen Sie die Datei config/tasks.yaml und ersetzen Sie den von der CrewAI-Bibliothek erstellten Inhalt durch Folgendes:
Sie werden feststellen, dass die Aufgaben für unsere KI-Agenten sorgfältig formuliert sind, damit sie diese interpretieren und einhalten können. Dazu gehören ein Beispiel für die erwartete Ausgabe und Regeln, die zu befolgen sind.
Eigene Tools
Für die erste Aufgabe und unseren ersten Agenten, die CVE-Kuration, müssen wir ein eigenes Tool in Python entwickeln. Das ist nötig, weil das integrierte CrewAI-Tool ScrapeWebsiteTool lediglich Text von einer Webseite extrahiert und den HTML-Quellcode nicht weiter analysieren kann, um Ankerelemente (<a href>) mit Links zu den CVE-Daten auf der Seite auszulesen.
Um ein neues eigenes Tool zu erstellen, das unsere Agenten verwenden können, öffnen Sie zunächst die Datei tools/__init__.py und aktualisieren Sie sie, sodass das neue Tool TableScraperTool wie folgt exportiert wird:
Beachten Sie, dass MyCustomTool bereits im von CrewAI erstellten Beispielprojekt enthalten war.
Als Nächstes erstellen wir das TableScraperTool. Legen Sie dazu die neue Datei tools/table_scraper.py an und fügen Sie den folgenden Python-Code ein:
Zuletzt müssen wir die Python-Bibliothek BeautifulSoup als Projektabhängigkeit hinzufügen. Aktualisieren Sie dazu die Liste dependencies in myproject.toml wie folgt:
Wenden Sie die Änderung anschließend mit folgendem Befehl an:
CrewAI-Hauptdatei für die Ausführung
Sehen wir uns nun die Hauptdatei crew.py an. Sie finden sie unter src/security_news_summary oder in einem anderen Verzeichnis, in dem Sie das CrewAI-Projekt eingerichtet haben.
Bearbeiten Sie die Datei und passen Sie zunächst den Import wie folgt an (wir fügen unser eigenes TableScraperTool hinzu):
Scrollen Sie anschließend nach unten und suchen Sie die Funktionen mit den Annotationen für Agenten (gekennzeichnet durch die Annotation @agent) und Aufgaben (gekennzeichnet durch die Annotation @task). Aktualisieren Sie sie so, dass sie unseren oben definierten Agenten und Aufgaben entsprechen:
KI-Agenten mit CrewAI ausführen
Das war’s. Jetzt können wir unsere KI-Agenten ausführen, die anhand der Snyk Vulnerability Database als Datenquelle neue Sicherheitslücken für uns kuratieren.
Starten Sie die CrewAI-Agenten einfach mit folgendem Befehl im Terminal:
Die KI-Agenten beginnen nun mit ihrer Arbeit:
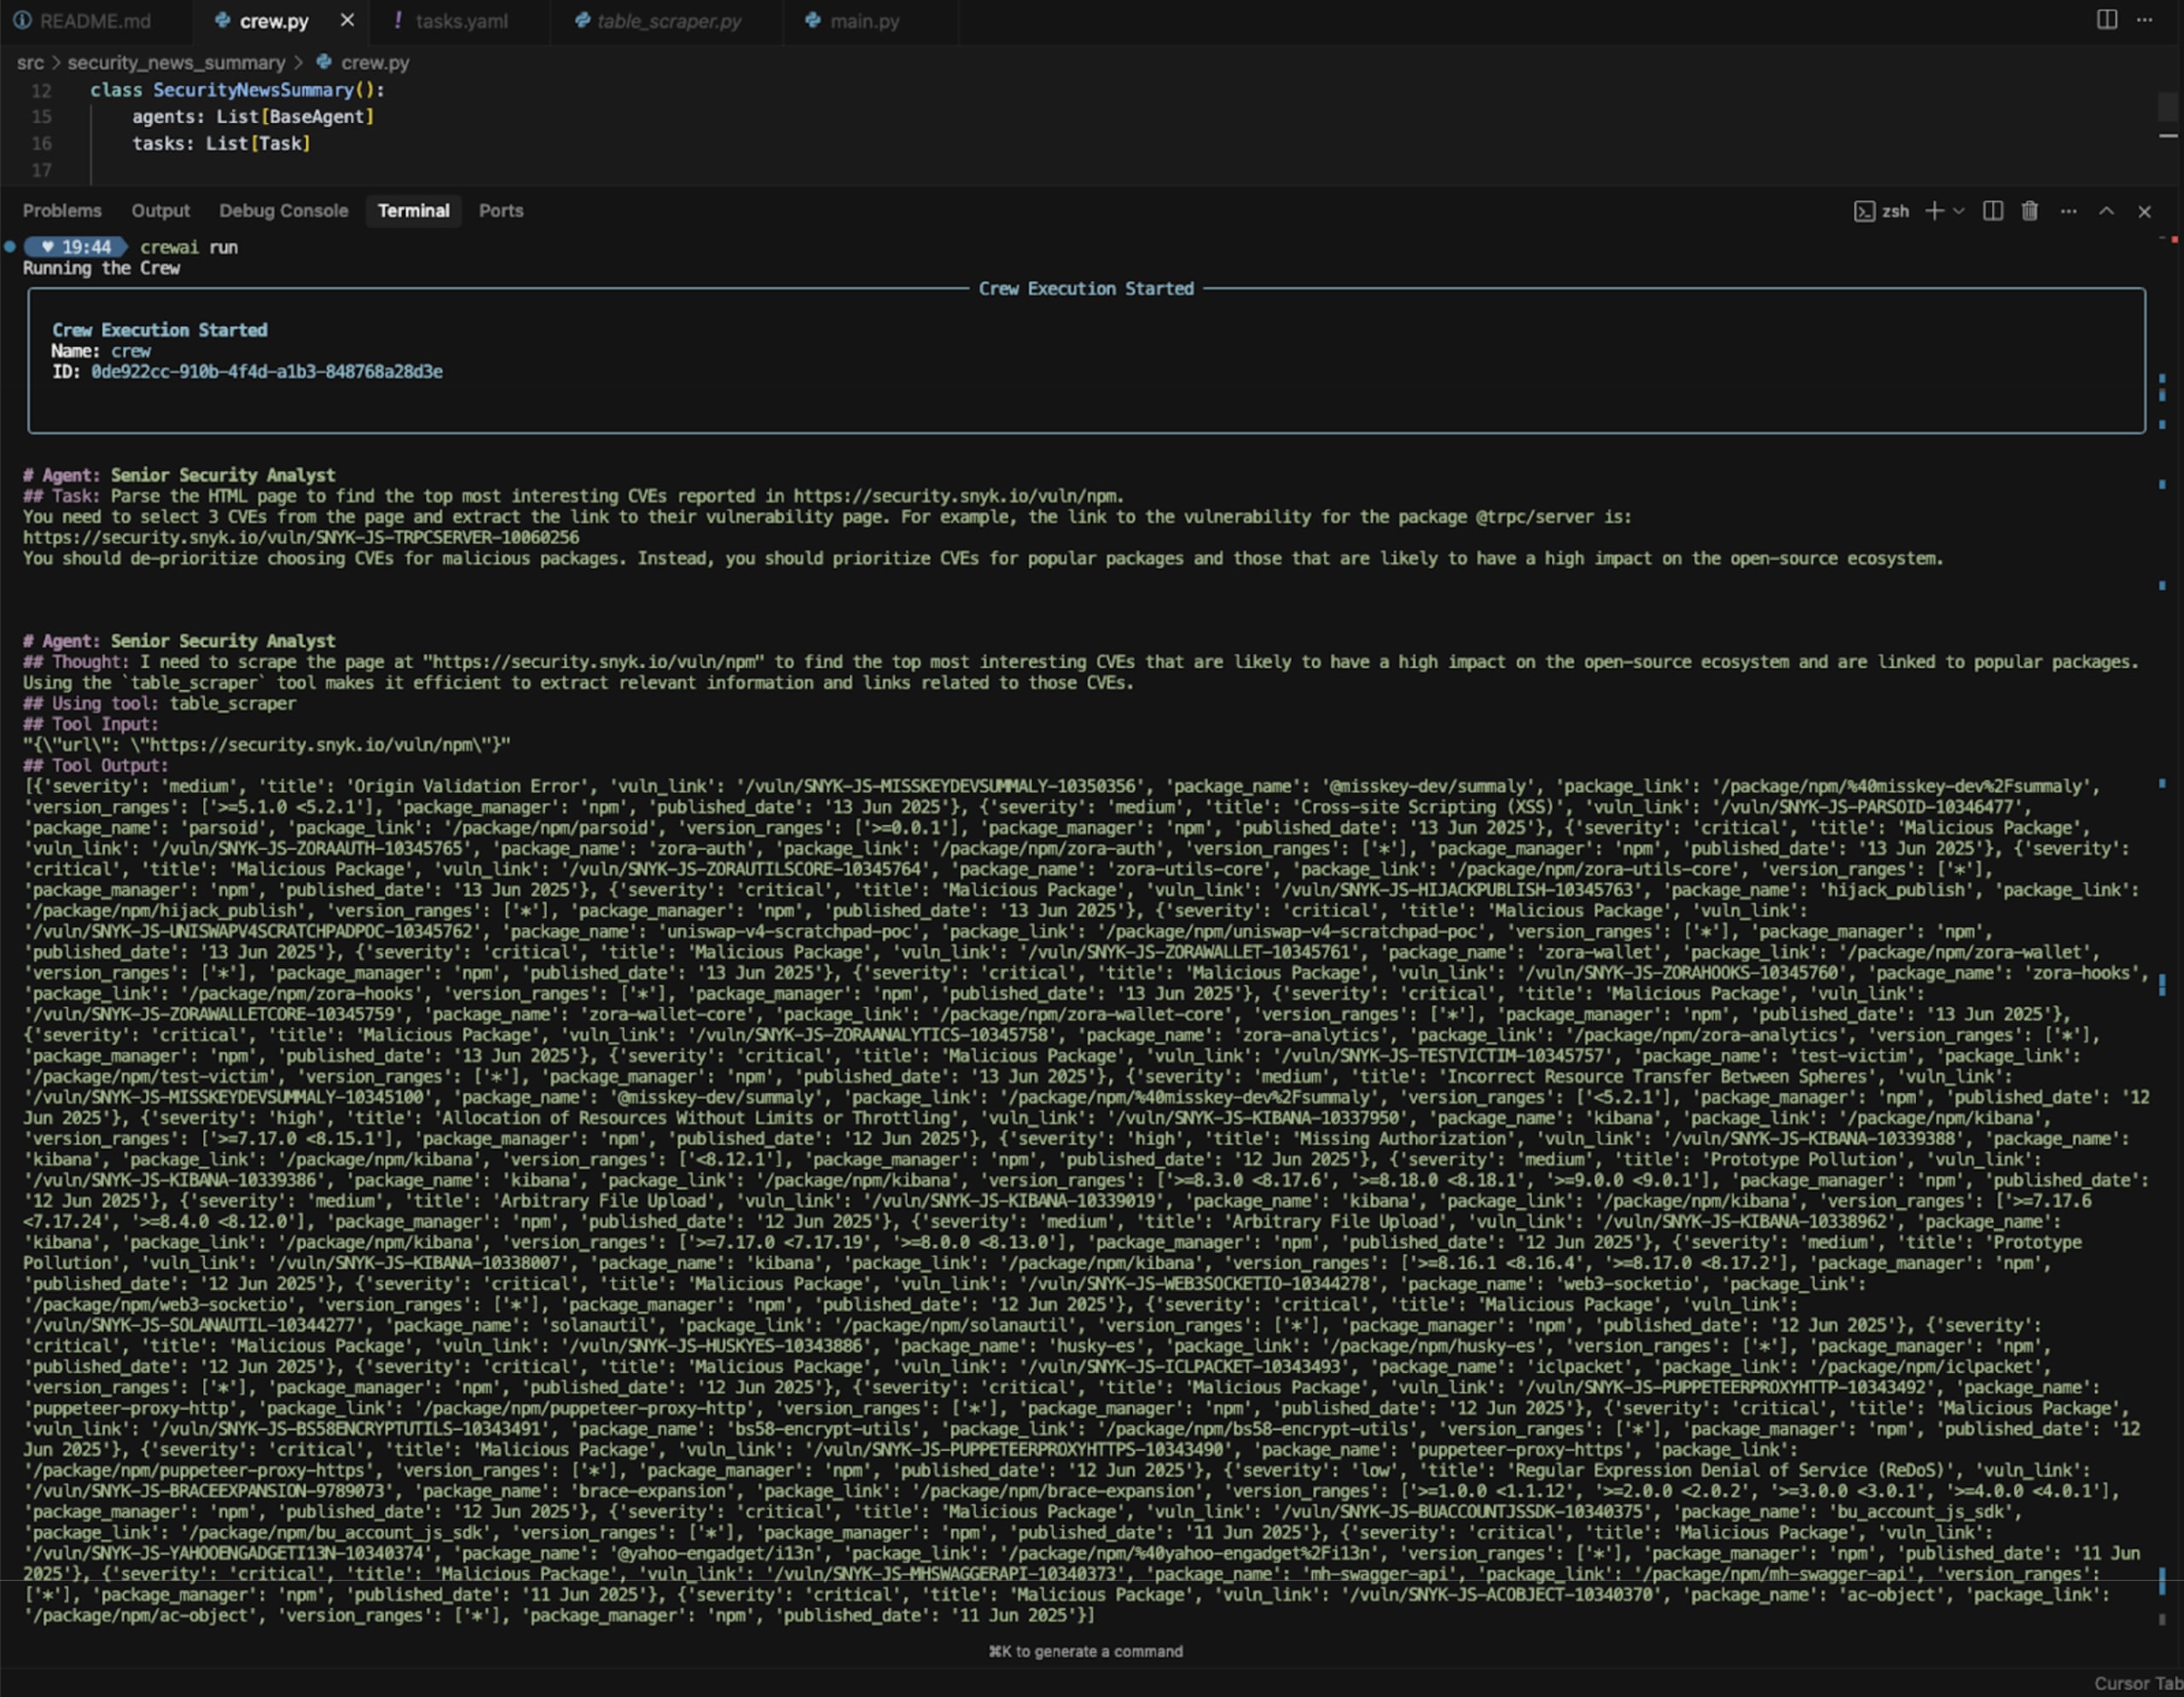
Im weiteren Verlauf werden die Aufgaben und ihr Fortschritt angezeigt:

Über KI-Sicherheit und agentische Workflows
KI-Agenten zu entwickeln, fühlt sich magisch an. Wenn alles funktioniert, laufen sie überraschend gut, und die CrewAI-Bibliothek zur Agenten-Orchestrierung ist einfach zu bedienen.
Da sich KI und agentische Coding-Workflows rasant weiterentwickeln, sollten Sie die Vertrauenswürdigkeit von KI genau im Blick behalten und Sicherheitsvorkehrungen für KI einrichten. So vermeiden Sie Risiken und Sicherheitsprobleme wie unsichere MCP-Server-Bereitstellungen, Prompt-Injection-Angriffe und andere Angriffsflächen für KI-Sicherheitslücken.
Ich empfehle folgende Ressourcen:
Lesen Sie Snyks Leitlinien für KI-Code-Sicherheitsvorkehrungen
Sicheres KI-Coding mit Snyk (und MCP-Servern)
Prompt-Injection verstehen: von Techniken bis hin zu Herausforderungen und Risiken.
Sichere KI-Entwicklung von Anfang an
Erfahren Sie, wie Sie Sicherheit in jeden Schritt Ihres KI-Entwicklungsworkflows integrieren – mit konkreten Umsetzungstipps von Expertinnen und Experten.