5 Best Practices für die Entwicklung von MCP-Servern
Artikel von

0 Min. Lesezeit
MCP-Server haben sich zu einem gängigen Weg entwickelt, Produktfunktionen für KI-Anwendungen und KI-gestützte Workflows verfügbar zu machen. Wenn Sie neu in der Entwicklung von MCP-Servern sind: Wie halten Sie sich an bewährte Vorgehensweisen und Konventionen, um das Beste aus Ihrem MCP-Server herauszuholen? Ich habe eine Liste mit Best Practices zusammengestellt, die auf meinen eigenen Erfahrungen bei der Entwicklung einiger MCP-Server mit Node.js basiert.
Wenn Sie frühere Artikel im Snyk-Ressourcen-Hub gelesen haben, sind Ihnen wahrscheinlich unsere Besprechung von 7 MCP-Servern für Produktmanager, unsere Anleitung für Entwickler dazu, wie sie MCP-Server zu Cursor hinzufügen, und unsere Aufklärung über Sicherheitsrisiken beim Vibe-Coding begegnet, die zu einer Sicherheitslücke in einer Node.js-Anwendung führen können.
Dieser Leitfaden beleuchtet einige Feinheiten und grundlegende Muster, mit denen MCP-Server zuverlässig funktionieren, und geht auf Aspekte der Developer Experience für MCP-Clients sowie auf Debugging-Möglichkeiten ein.
Best Practice 1 für MCP-Server: Halten Sie sich an Namenskonventionen für Tools
MCP-Server stellen Tools mit Namen und Beschreibungen bereit und machen sie in einer Tool-Liste verfügbar, die sie als Antwort an anfragende MCP-Clients senden.
Hier sehen Sie ein Beispiel für eine einfache Tool-Definition, in der der Tool-Name getNpmPackageInfo lautet:
Sicherheitshinweis: Der obige Beispielcode für einen MCP-Server ist absichtlich anfällig für Command Injection und dient als Teil eines Artikels zur Aufklärung über Sicherheitslücken in MCP-Servern.
Sie hätten das Tool beispielsweise auch wie folgt benennen können:
getNpmPackageInfo(wie im obigen Beispiel)get-Npm-Package-Infoget.Npm.Package.Infoget Npm Package Information
Ich habe festgestellt, dass MCP-Clients Tools möglicherweise nicht zur Verwendung anzeigen und das Tool dann aus Sicht der Endnutzer nicht aufgerufen wird, wenn Sie von den etablierten Namenskonventionen abweichen – etwa durch die Verwendung eines Bindestrichs (-), eines Unterstrichs (_) oder von Snake Case (getNpm…).
Meine Empfehlung: Verwenden Sie im Tool-Namen weder Leerzeichen noch einen Punkt als Trennzeichen (.) oder runde bzw. eckige Klammern wie ( oder ). Das sorgt für Verwirrung und verhindert, dass MCP-Tools überhaupt aufgerufen werden. Verwenden Sie für Tool-Namen immer Snake Case. GPT-4o kann diese Konvention am besten tokenisieren. Alternativ können Sie einen Bindestrich oder Unterstrich als Trennzeichen verwenden.
Die Tokenisierung durch LLMs ist für Tool-Namen entscheidend
Warum das passiert, hängt vom verwendeten Modell, der Implementierung der MCP-Clients und den MCP-Hosts ab, die darauf aufbauen. Ein Grund ist jedoch der Tokenisierungsprozess des LLMs.
Sehen wir uns zum Beispiel an, wie OpenAI-Modelle wie GPT-4o die folgenden Texte tokenisieren:
nodeCryptowird in zwei Tokens zerlegt.
node.Cryptowird in drei Tokens zerlegt.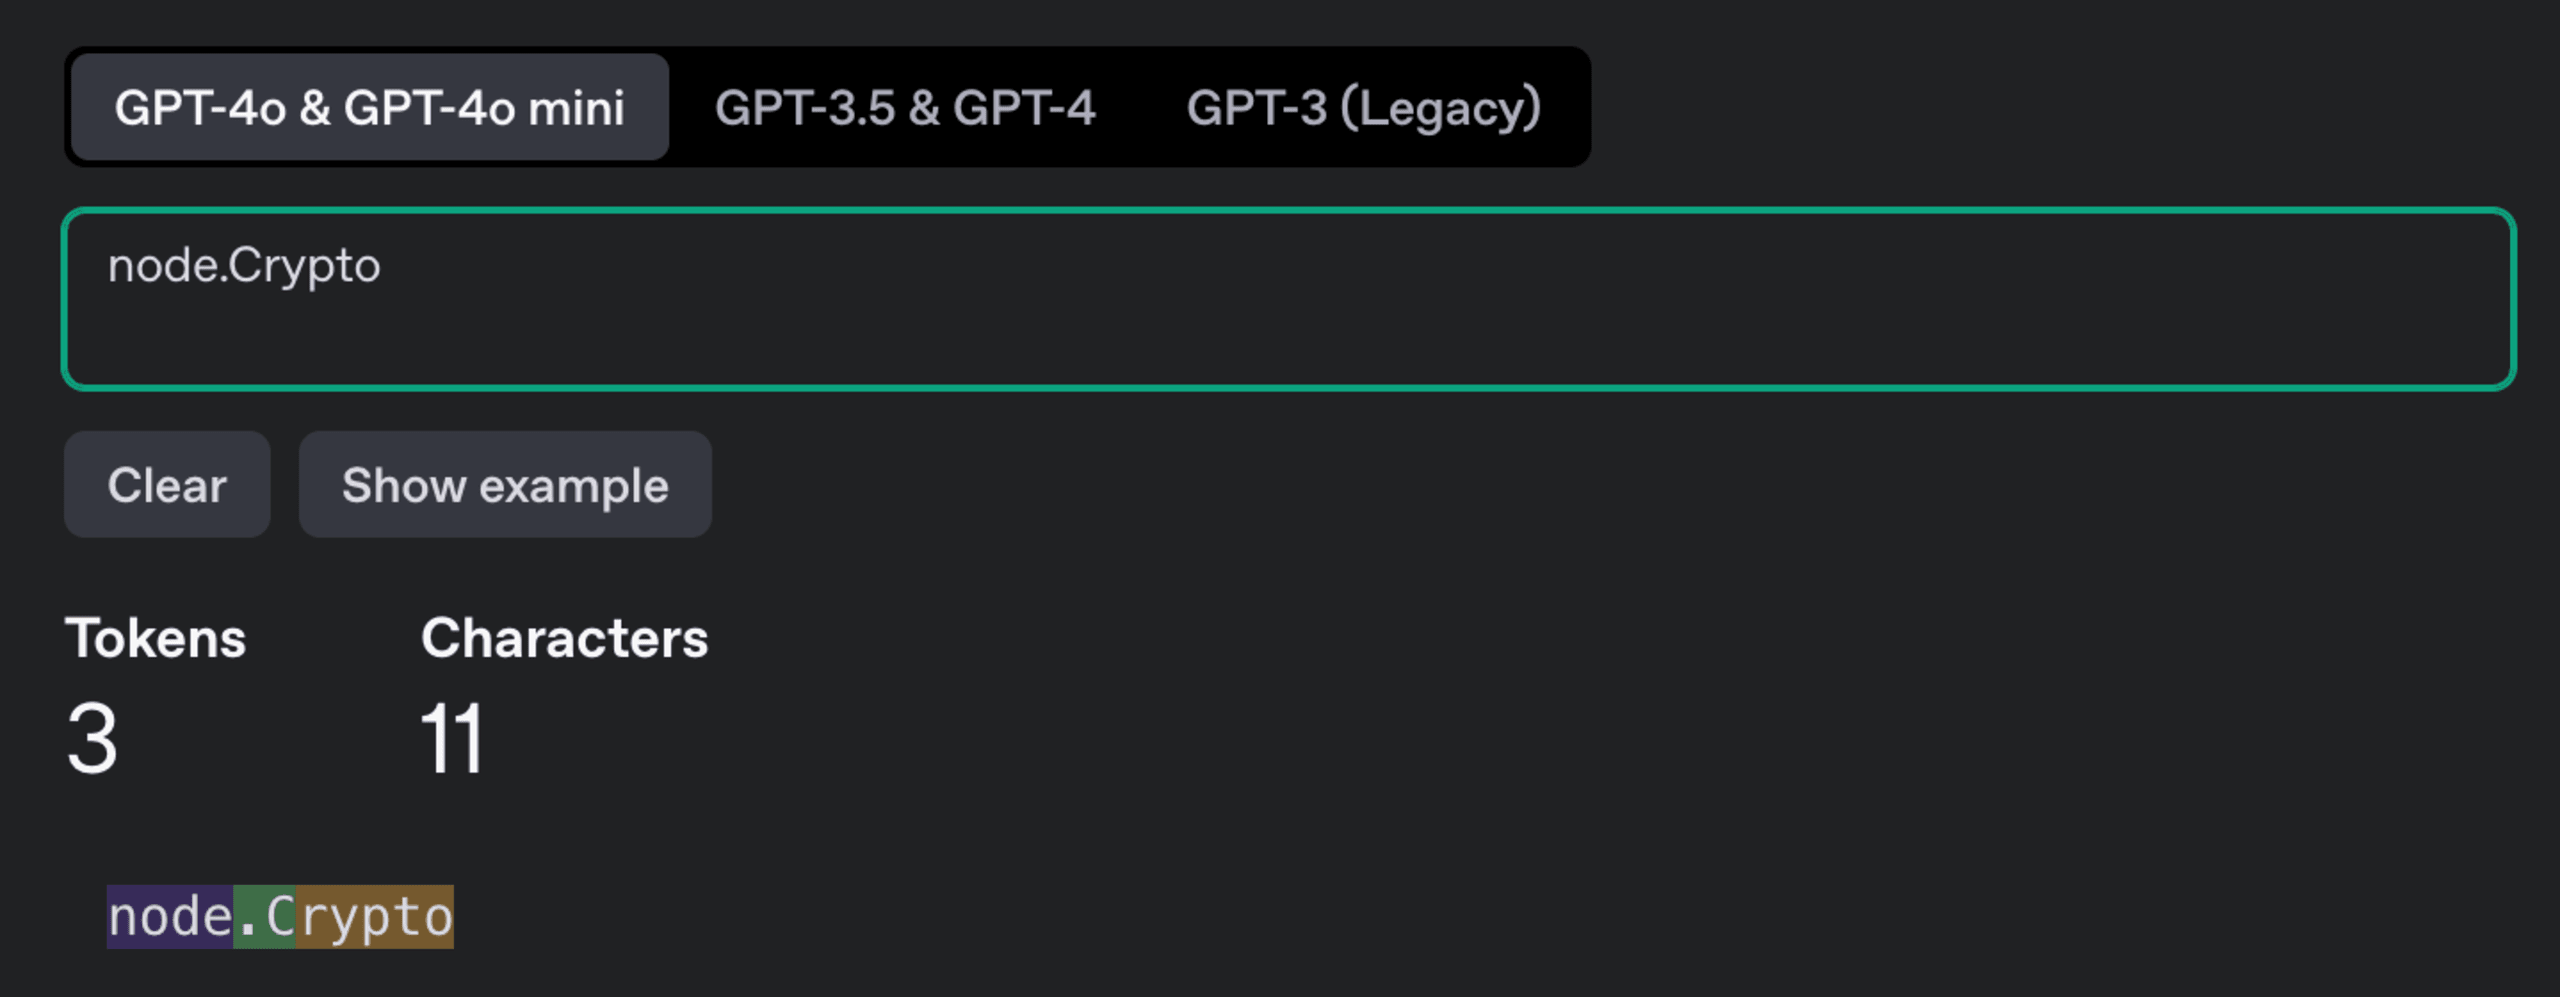
node_cryptowird in zwei Tokens zerlegt.
npm_Utilswird in drei Tokens zerlegt.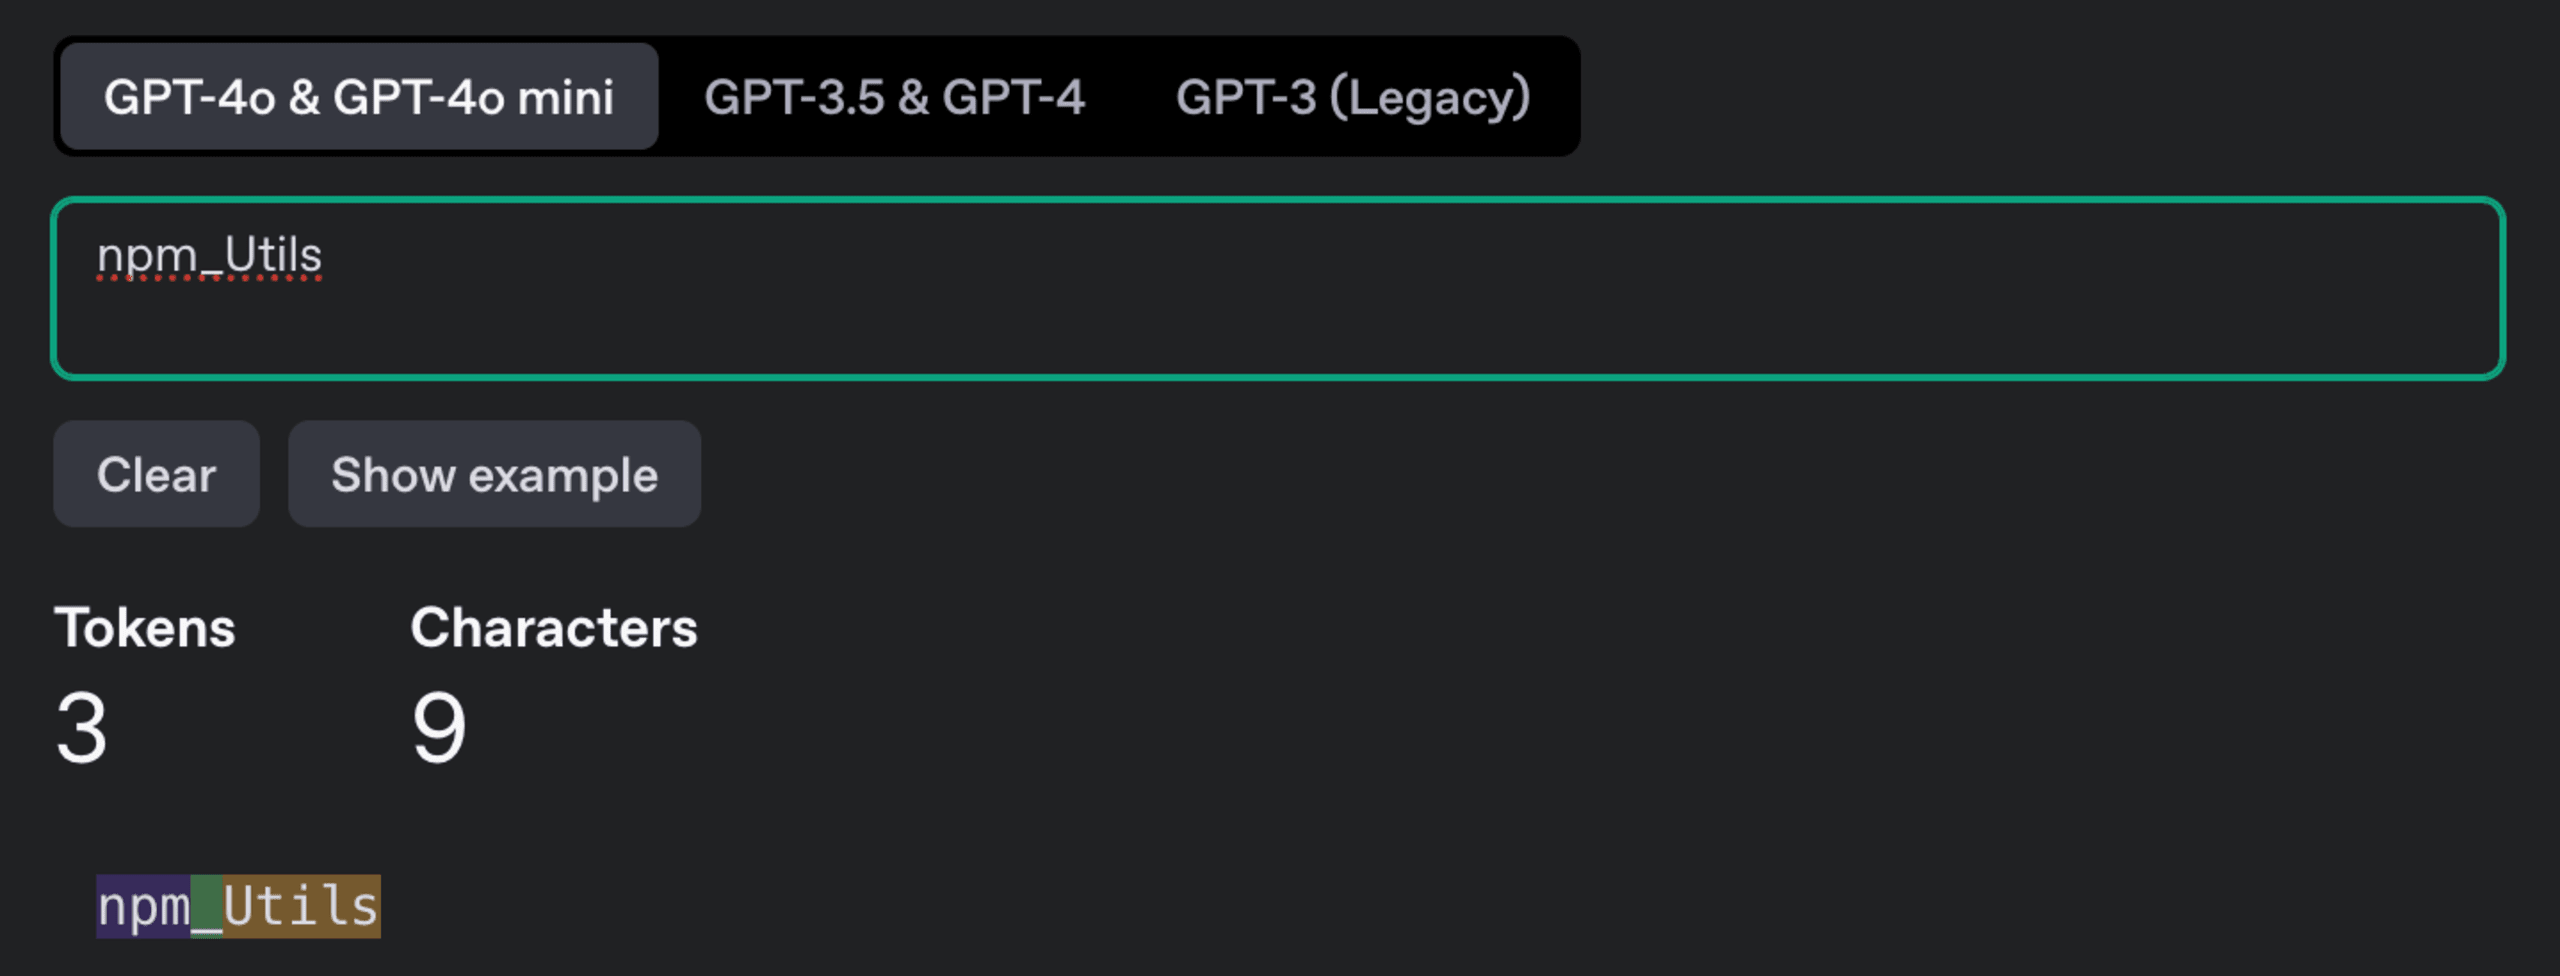
npm_Get_Package_Infowird in fünf Tokens zerlegt.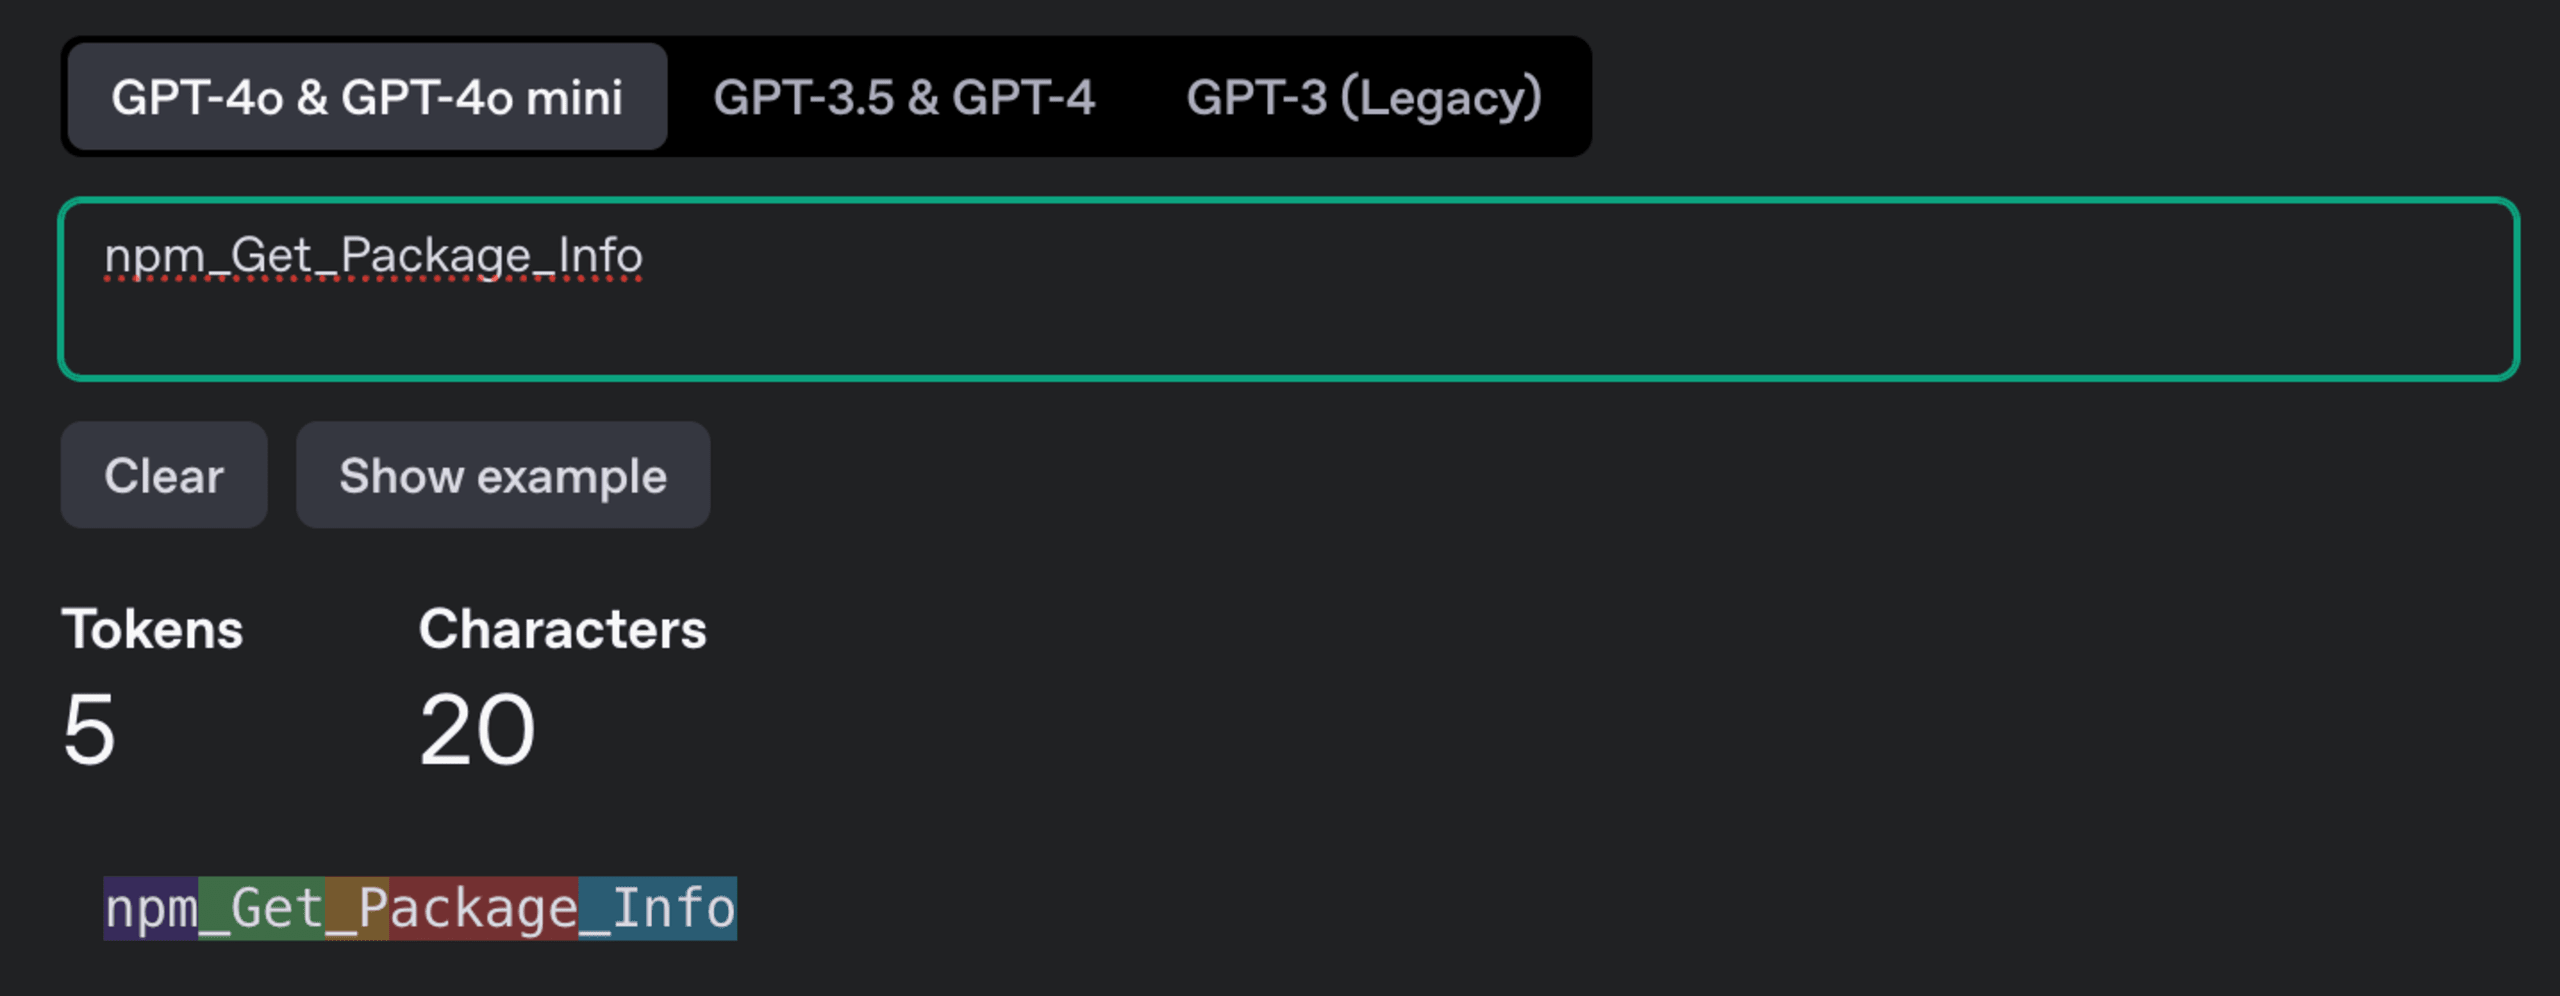
Best Practice 2 für MCP-Server: Logging
Woran erkennen Sie, dass die Kommunikation zwischen MCP-Client und -Server nicht richtig funktioniert? Wird das Tool überhaupt aufgerufen?
Wenn Sie schon einmal einen MCP-Server entwickelt haben – insbesondere einen einfachen, der auf Prozess-STDIO (Standard Input/Output) basiert –, ist Ihnen vielleicht aufgefallen, dass console.log() nicht gut funktioniert.
Das Schreiben von Logs in die Konsole oder das Terminal ist bei MCP-Servern, die STDIO verwenden, nicht ohne Weiteres möglich, da dieser Kommunikationskanal für den Informationsaustausch zwischen MCP-Client und MCP-Server genutzt wird.
Ganz auf Logging zu verzichten, ist jedoch keine Option. Effektives Logging ist für MCP-Server entscheidend: Es schafft die notwendige Transparenz über Programmabläufe, um Tool-Aufrufe und weitere Verarbeitungsschritte innerhalb der Tool-Logik nachvollziehen zu können. Wahrscheinlich müssen Sie MCP-Server effizient debuggen und wichtige Erkenntnisse zur Ausführung von KI-Workflows gewinnen können.
Für MCP-Server, die gemäß der MCP-Spezifikation den Prozess-STDIO-Transporttyp verwenden, ist Datei-Logging daher die einfachste Lösung: Die Ausgaben werden in eine Logdatei geschrieben, und die Logmeldungen lassen sich zur späteren Analyse in einer festgelegten Datei speichern.
Meine Empfehlung: Eine Logging-Bibliothek wie pino vereinfacht die Implementierung in Node.js. Sie ist eine hervorragende Wahl und stammt von langjährigen, vertrauenswürdigen Mitwirkenden am Node.js- und Fastify-Ökosystem.
Hier sehen Sie ein Anwendungsbeispiel für pino:
Dieses Beispiel zeigt, wie Sie mit pino einen Logger erstellen, der Logs in die Datei /tmp/mcp-server.log schreibt.
Log-Einträge wie die Initialisierung des Loggers lassen sich dann systematisch erfassen. So erhalten Sie detaillierte Einblicke in den Programmablauf eines MCP-Servers.
MCP-Server mit HTTP-Transporttyp können Logging anders handhaben; diese Best-Practice-Empfehlung behandelt sie nicht.
Best Practice 3 für MCP-Server: Vermeiden Sie Antworttexte wie „not found“
Diese Empfehlung betrifft vor allem Antworttexte und die Implementierungslogik von Tool-Aufrufen und beruht auf meinen zugegebenermaßen begrenzten Erfahrungen. Meine Beobachtungen und Experimente scheinen diese Empfehlung jedoch zu bestätigen.
Der Grundgedanke ist folgender: Wenn Sie Tool-Aufrufe wie „search“ implementieren, sollten Sie nicht mit einem „not found“-Text antworten. Stellen Sie dem LLM stattdessen möglichst viele allgemeine Daten zur Verfügung.
Ein praktisches Beispiel dafür war die Entwicklung eines MCP-Servers für die Node.js-API-Dokumentation mit einem nodeSearch-Tool. Wenn Nutzer nach einer Methode der Node.js-Laufzeitumgebung fragen, finden sie diese möglicherweise nicht sofort, da die Implementierung des nodeSearch-Tools die Node.js-Kernmodule anhand ihres Namens findet, nicht aber die tatsächlichen Methoden der zugrunde liegenden API.
Zunächst gab ich in diesen Fällen die Antwort Module <xyz> not found. <here is everything I have> zurück. Dabei stellte ich jedoch fest: Selbst wenn ich alle Module und Methoden vollständig bereitstelle, lenkt der „not found“-Text am Anfang der Antwort das LLM in die falsche Richtung. Es sucht dann nicht in den bereitgestellten Daten nach der Methode in einem der unterstützten Node.js-Kernmodule.
Meine Empfehlung: Geben Sie keinen „not found“-Text zurück. Stellen Sie stattdessen andere relevante Daten bereit. Dabei gibt es natürlich Einschränkungen, denn manchmal können Sie nicht einfach alle Daten zurückgeben. Wenn Sie beispielsweise Nutzer suchen, wäre es wahrscheinlich falsch und unsicher und würde gegen den Datenschutz verstoßen.
Möchten Sie sehen, wie sich diese Vorgehensweise vorher und nachher auswirkt? Sehen Sie sich die folgenden Beispiele an.
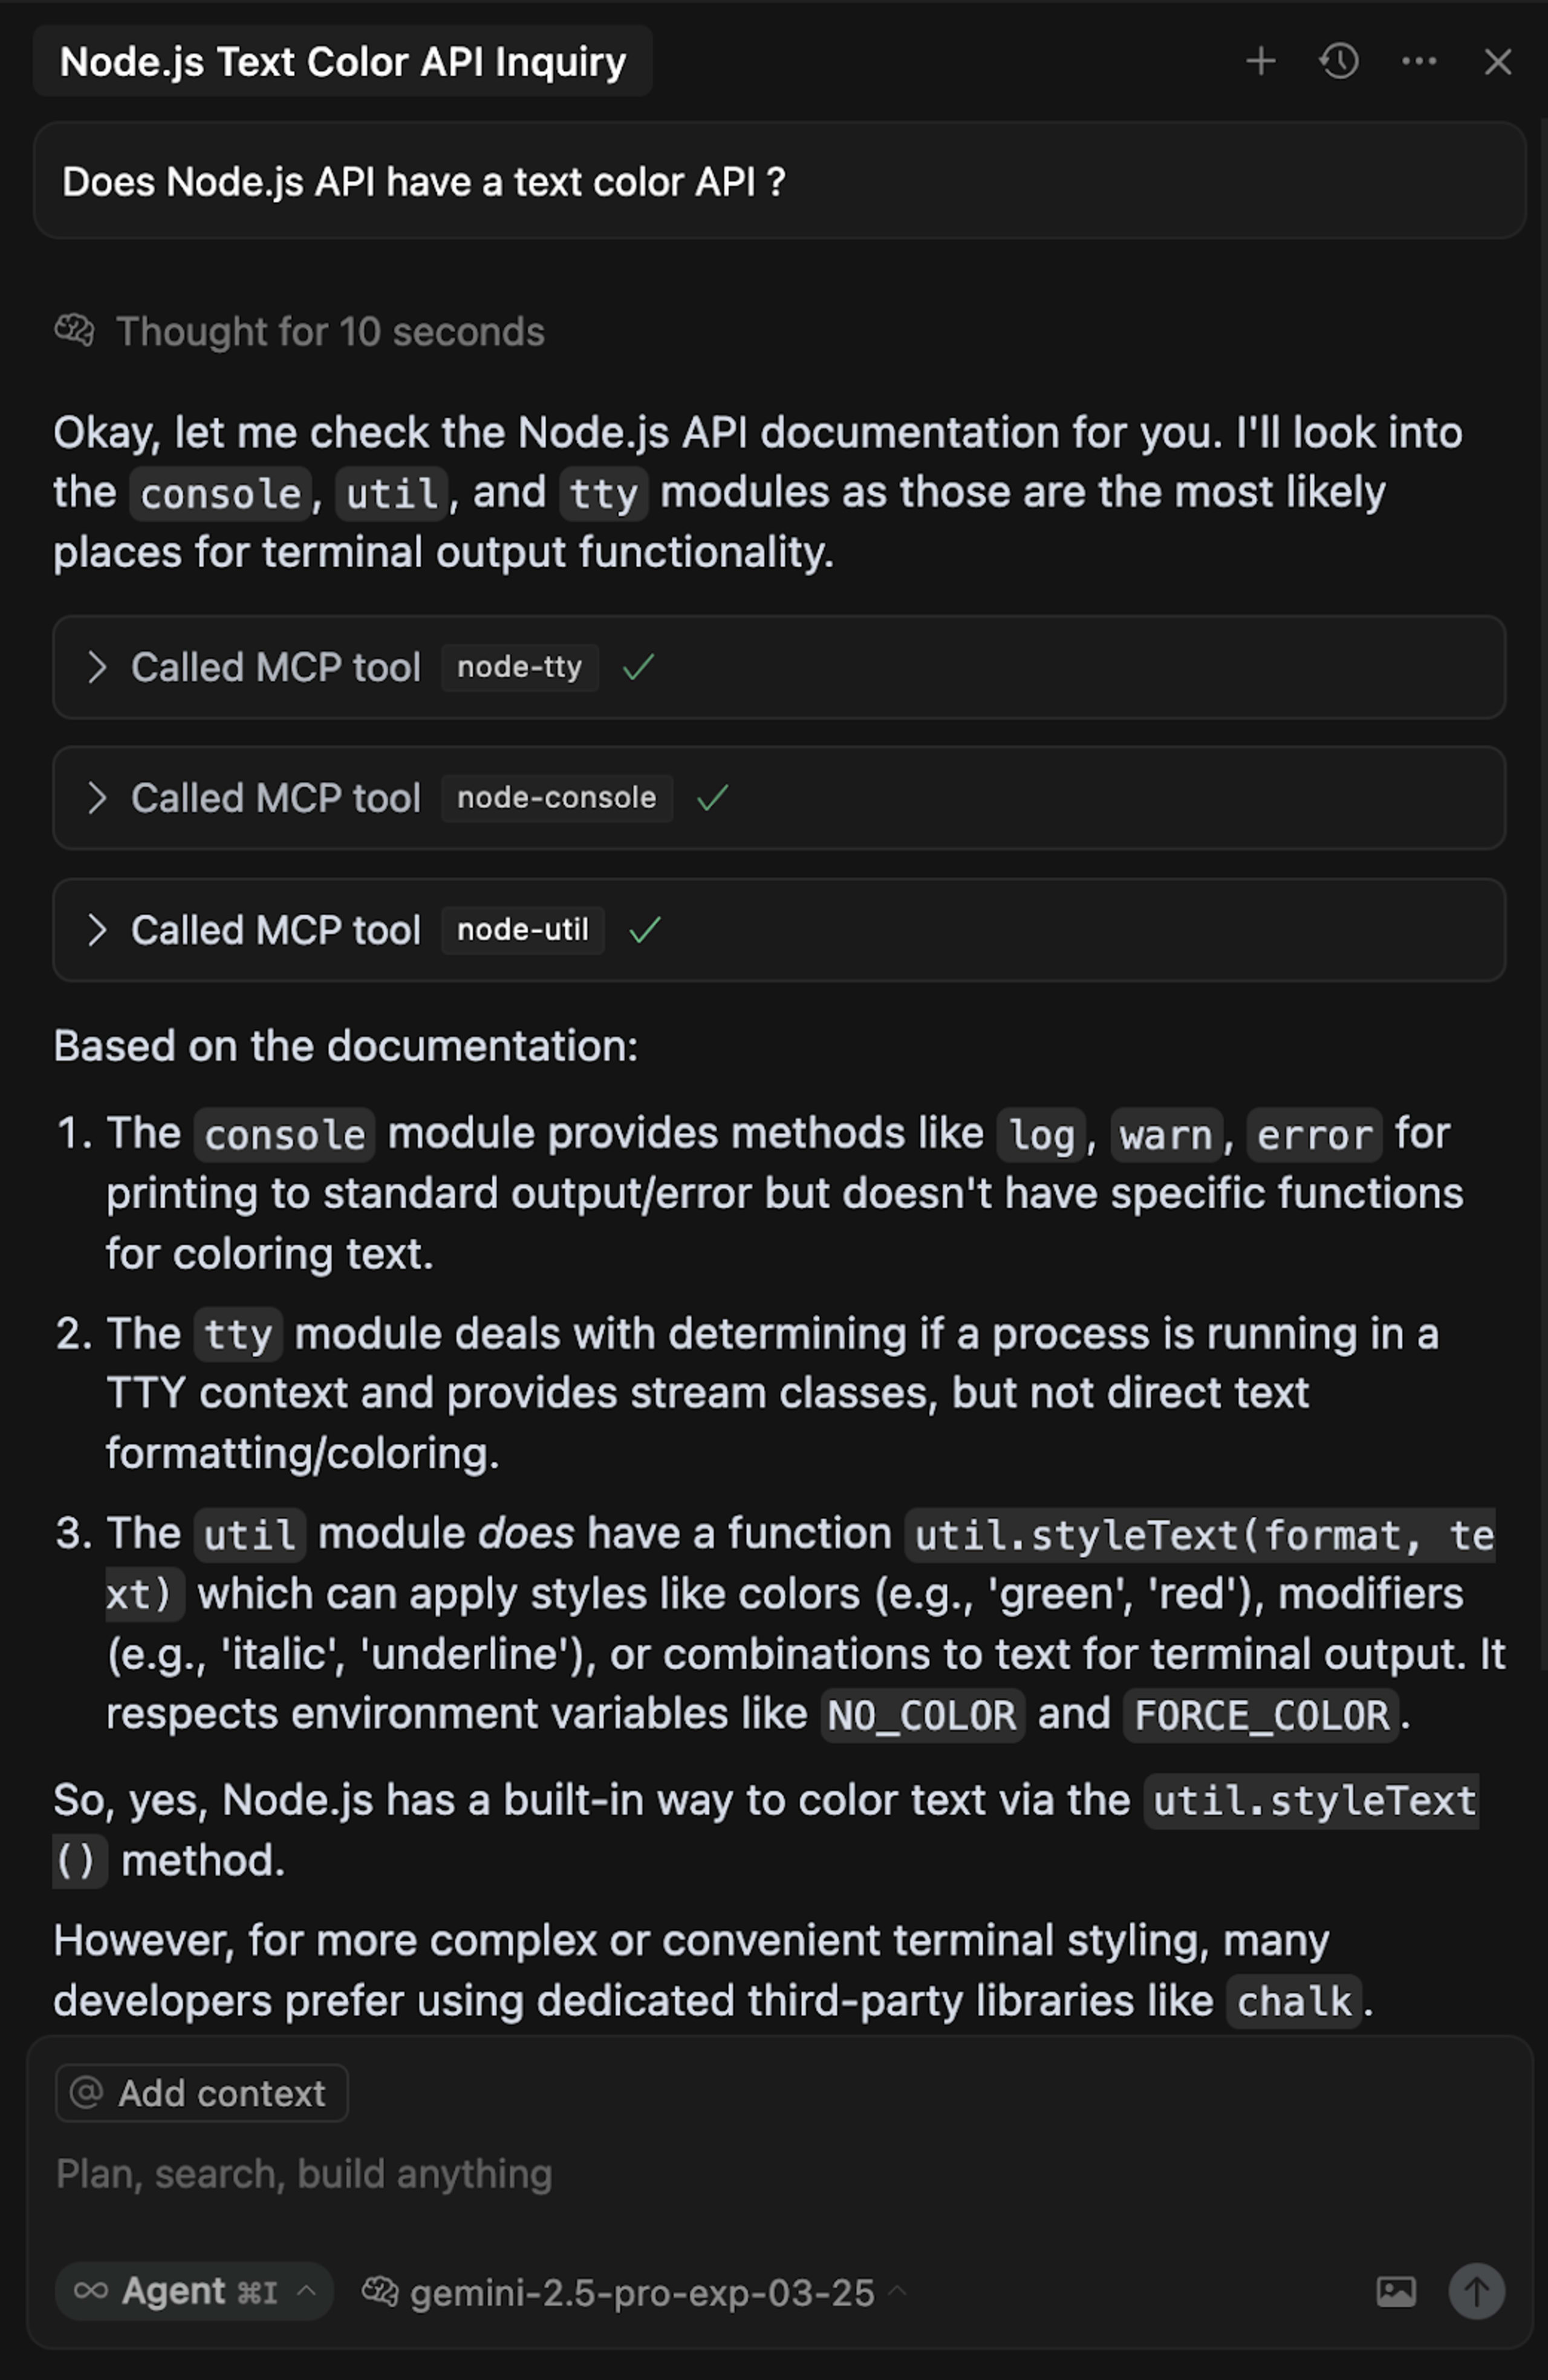
Das folgende Beispiel zeigt eine Interaktion in einem IDE-Chat mit einem MCP-Server, dessen Tool-Aufruf den Text „not found“ zurückgibt. Wie Sie sehen, kann die richtige Antwort nicht gefunden werden:
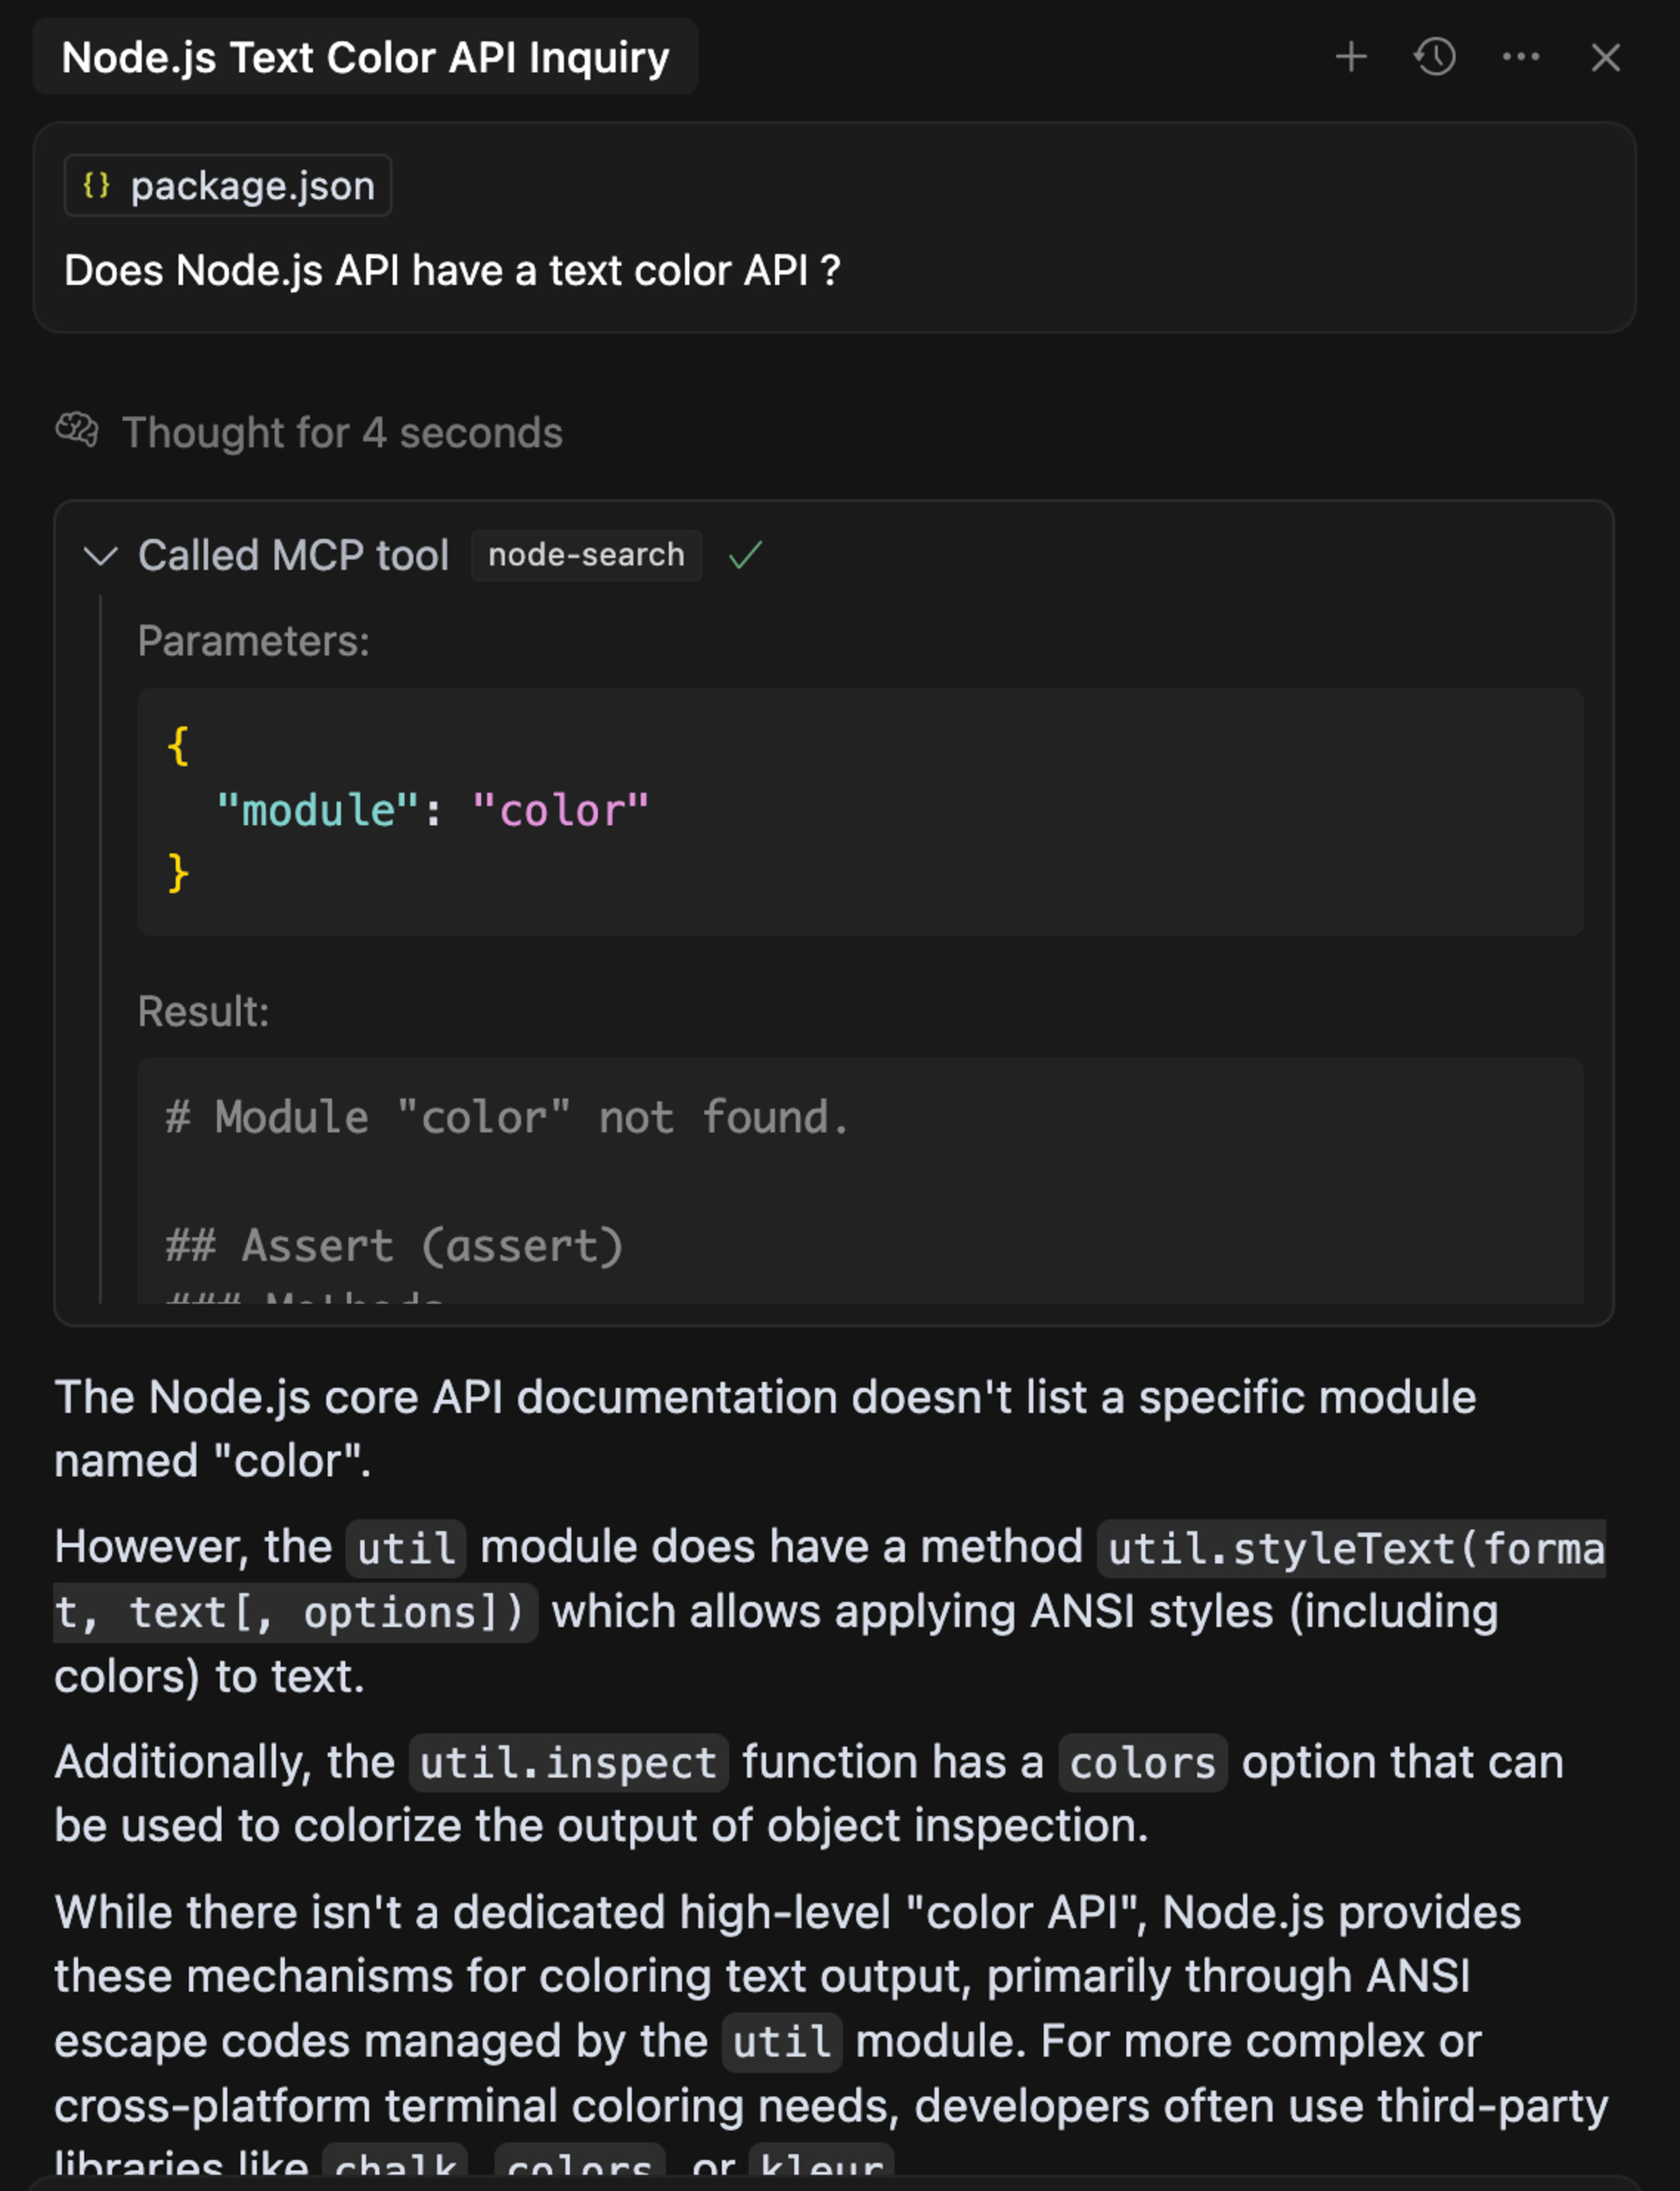
Wenn wir jedoch den Text # Module “color” not found am Anfang der Antwort entfernen und alle verfügbaren Node.js-Kernmodule samt ihren Methoden zurückgeben, kann das LLM mögliche Module durchgehen und eine bessere Lösung finden.
So funktioniert es:
Best Practice 4 für MCP-Server: Vermeiden Sie anfällige Drittanbieterkomponenten
In einer Reihe zu Best Practices eines KI-Sicherheitsunternehmens wie Snyk dürfen wir das Thema Sicherheit natürlich nicht auslassen.
Damit MCP-Server in Unternehmen breite Akzeptanz finden und von internen Infrastrukturteams zugelassen werden, müssen sie strenge Sicherheits- und Compliance-Anforderungen erfüllen. IT- und Produktsicherheitsteams sind sich der Risiken bewusst, die durch potenziell anfällige Abhängigkeiten in ihren Workflows entstehen. Das ist nicht neu und gehört zu den SBOM-Anforderungen, die aus Bidens Executive Order nach den Folgen des SolarWinds-Angriffs hervorgingen.
Anfällige Drittanbieterkomponenten zu vermeiden, ist entscheidend. Software, die auf Drittanbieterbibliotheken angewiesen ist oder bekannten Sicherheitslücken unterliegt, kann Angreifern als Einfallstor dienen. Ein MCP-Server verfügt von seiner Funktion her häufig über weitreichende Zugriffs- und Integrationsmöglichkeiten. Dadurch wird jede Sicherheitslücke zu einem erheblichen Risiko.
MCP-Server frei von Sicherheitslücken zu halten, ist daher nicht nur eine Best Practice, sondern eine Voraussetzung für ihre erfolgreiche Implementierung.
Meine Empfehlung lautet, Snyk zu verwenden. Doch wie können Sie MCP-Server schützen, und wo fangen Sie an?
Code auf Sicherheitslücken untersuchen: Snyk analysiert Ihre Codebasis auf Sicherheitslücken und unsichere Codemuster und stellt Code-Fixes in der IDE oder anderen Entwickler-Workflows bereit.
Abhängigkeiten auf Sicherheitslücken prüfen: Eine der grundlegenden Stärken von Snyk ist die Absicherung von Open-Source-Software. Snyk prüft die Abhängigkeiten Ihres Projekts anhand einer umfassenden Datenbank bekannter Sicherheitslücken und weist Sie auf Risiken sowie geeignete Versionen für ein Upgrade hin.
Compliance sicherstellen: Rechtliche Fragen sind für Entwickler vielleicht nicht besonders spannend, für Unternehmen aber von größter Bedeutung. Snyk hilft Ihnen als Entwickler, rechtliche Haftungsrisiken zu vermeiden, indem es Sicherheitslücken erkennt, die gegen Sicherheits- und Lizenzstandards verstoßen.
Hier sehen Sie anhand eines praktischen Beispiels, wie Sie mit Snyk anfällige Open-Source-Abhängigkeiten finden:

Snyk findet auch anfälligen Code in Ihrer eigenen Codebasis, etwa Command Injection, Path Traversal und andere Arten unsicheren Codes, die Sie geschrieben haben – oder möglicherweise hat das LLM den anfälligen Code für Sie generiert. In jedem Fall scannt Snyk den Code.
Best Practice 5 für MCP-Server: Packen Sie den MCP-Server in einen Docker-Container
MCP-Server zu entwickeln ist nützlich, doch ihre Bereitstellung und Verwaltung kann für Endnutzer zusätzliche Komplexität mit sich bringen.
MCP-Server benötigen häufig eine bestimmte Laufzeitumgebung, etwa Python mit uv oder Node.js mit npm. Diese Abhängigkeit von einer bestimmten Sprachumgebung kann für Endnutzer, die die Server verwenden, Hürden schaffen. Sie müssen ihre Umgebung exakt einrichten, damit der MCP-Server korrekt ausgeführt wird. Das kann zu Inkonsistenzen, Versionskonflikten und Fehlern sowie zu einem komplizierten Einrichtungsprozess führen.
Eine wirksame Lösung für dieses Problem ist, den MCP-Server als Docker-Container zu paketieren. Docker-Container bieten eine standardisierte, isolierte Umgebung mit allen Abhängigkeiten, Bibliotheken und Laufzeitkomponenten, die der MCP-Server für den ordnungsgemäßen Betrieb benötigt. Wird der MCP-Server als Container-Image bereitgestellt, müssen Nutzer lediglich Docker installiert haben, um ihn auszuführen.
Docker hat sogar einen zentralen Hub mit MCP-Servern als Container-Images für beliebte MCP-Server eingerichtet:
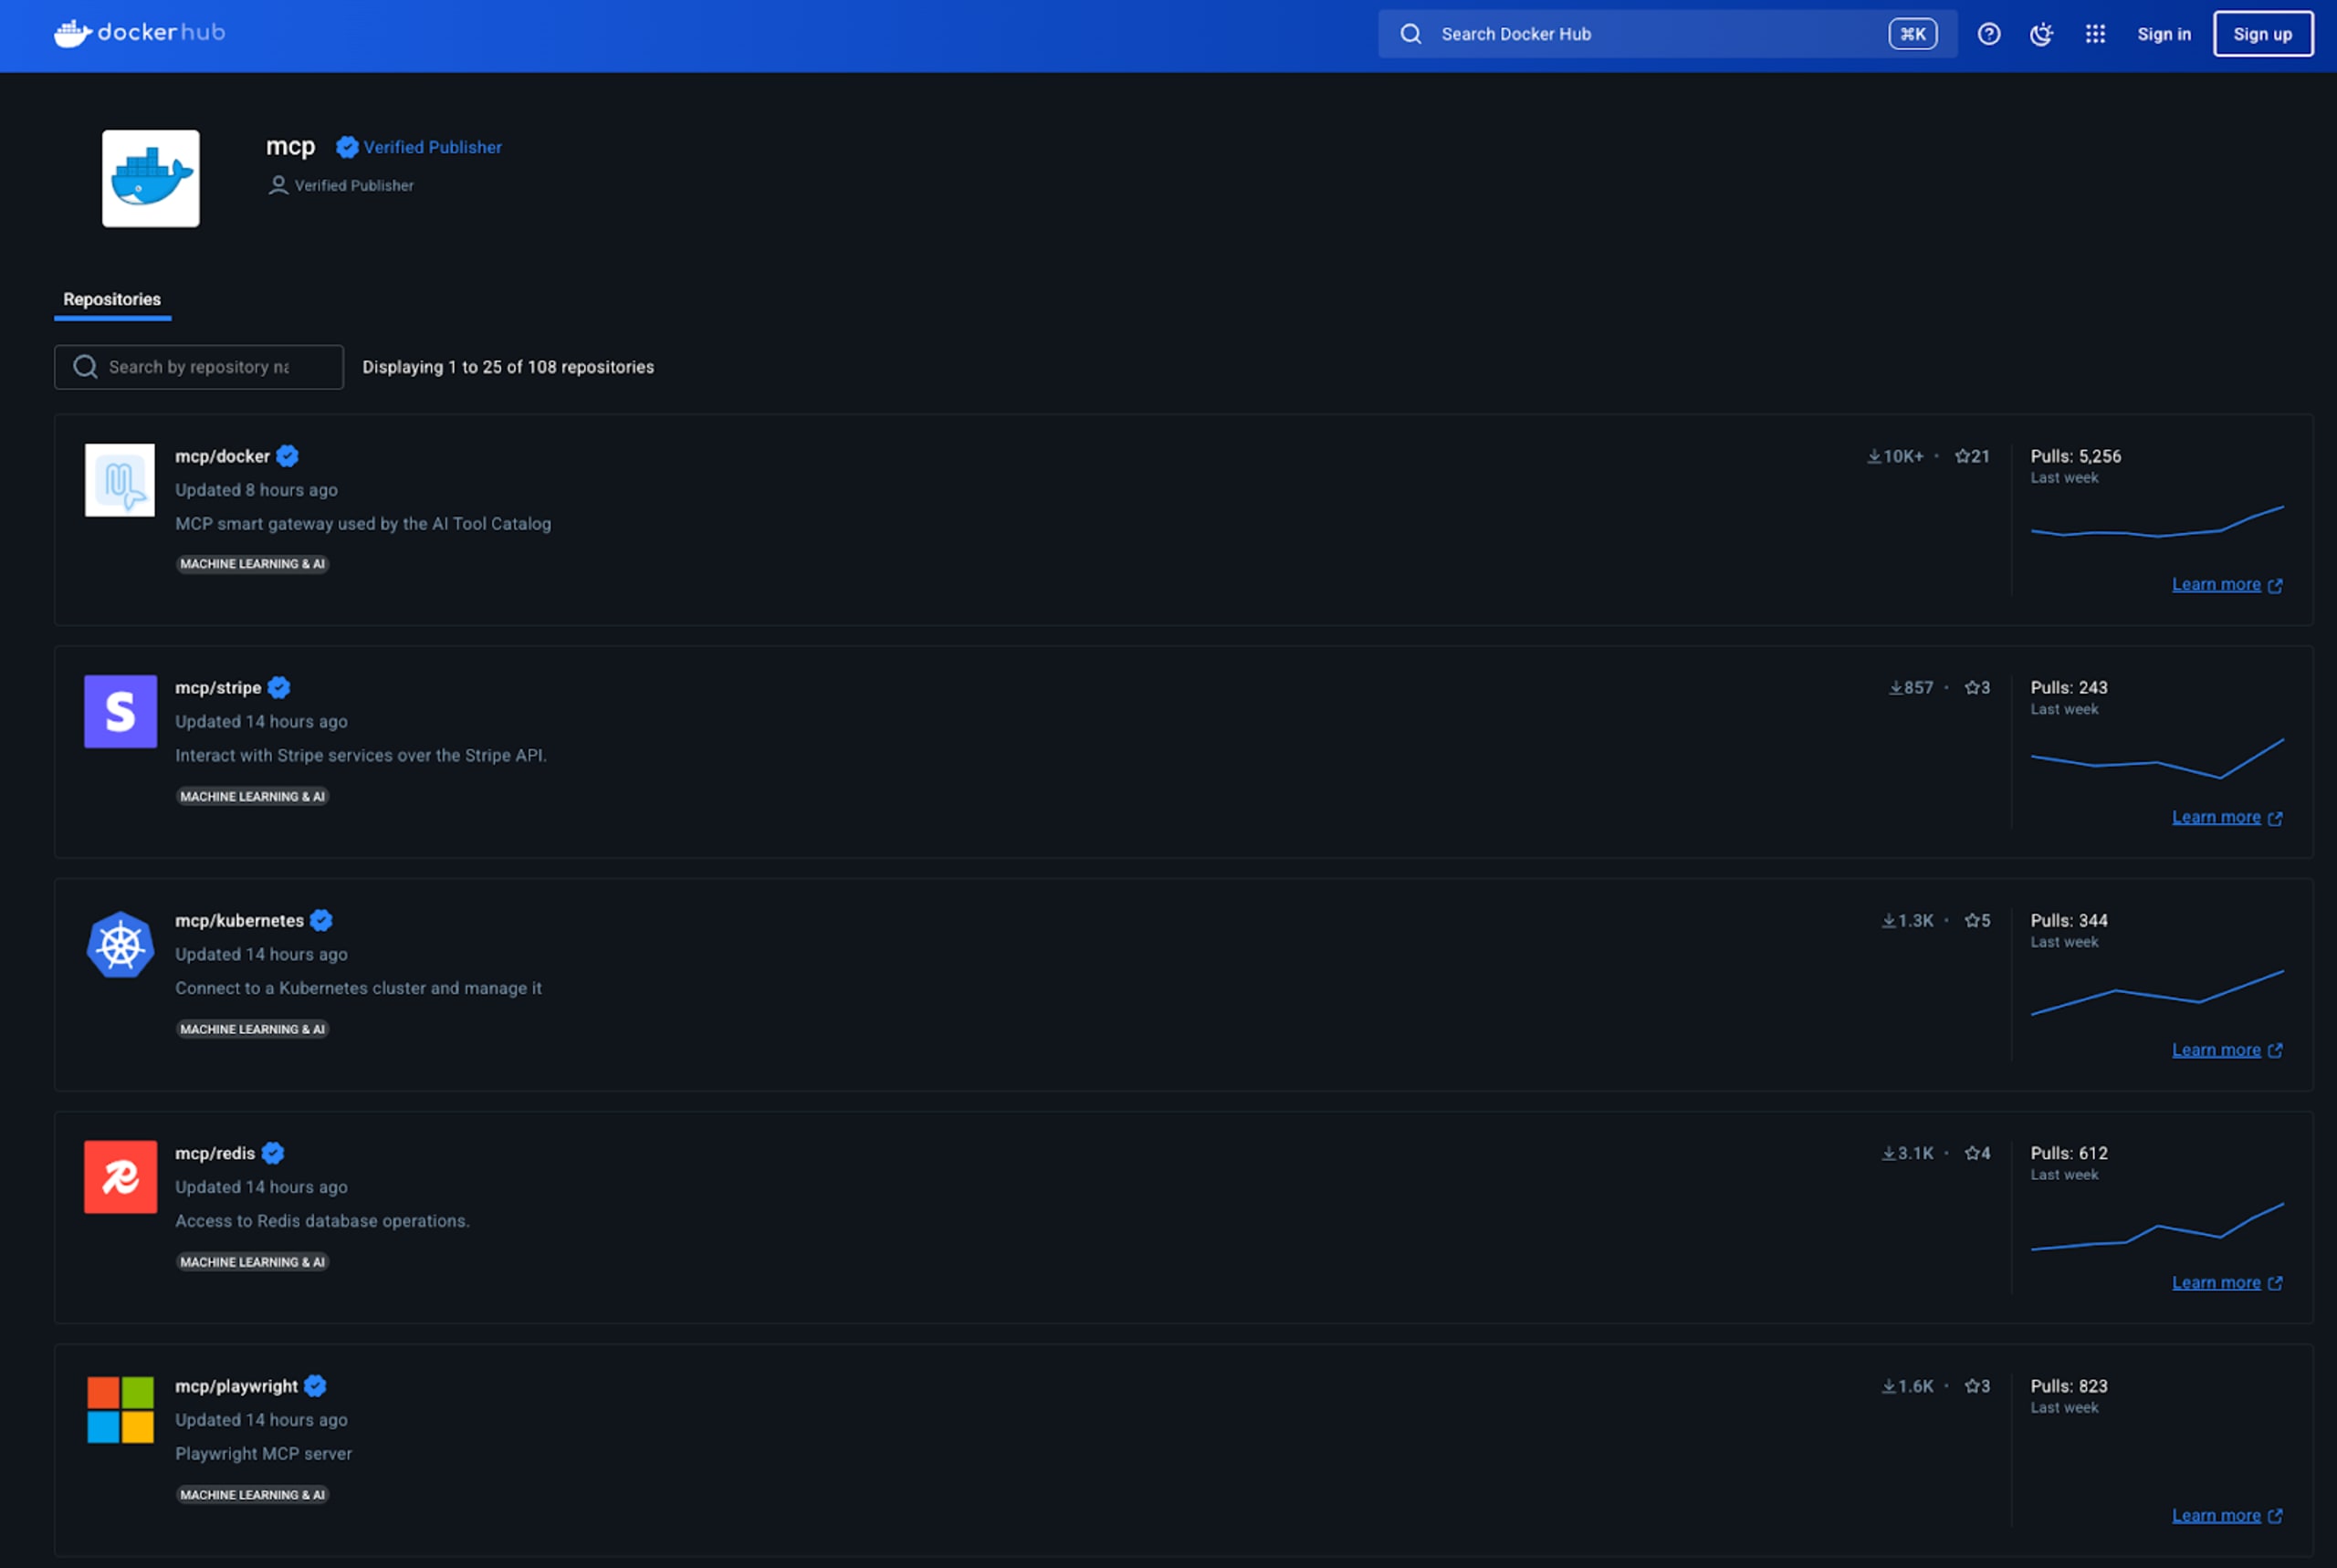
Docker dient als bewährte, branchenweit anerkannte Abstraktionsebene, die Anwendungen samt Abhängigkeiten in portable Container packt. Das vereinfacht die Bereitstellung, gewährleistet konsistente Ergebnisse in unterschiedlichen Umgebungen und beseitigt das Problem „Auf meinem Computer funktioniert es“.
Hier sind einige Vorteile, die Docker-Images für Ihre MCP-Server bieten:
Konsistenz: Gewährleistet, dass der MCP-Server in Entwicklungs-, Test- und Produktionsumgebungen gleich funktioniert.
Isolation: Verhindert Konflikte zwischen den Abhängigkeiten des MCP-Servers und anderen Anwendungen auf dem Hostsystem.
Portabilität: Ermöglicht die einfache Bereitstellung des MCP-Servers auf jedem System, das Docker unterstützt.
Vereinfachte Bereitstellung: Verringert die Anzahl der Schritte, die Endnutzer ausführen müssen, um den MCP-Server einzurichten und zu starten.
Ressourcenverwaltung: Docker bietet Tools zur Verwaltung von Ressourcen wie CPU, Arbeitsspeicher und Netzwerk und sorgt dafür, dass der MCP-Server effizient läuft.
Best Practices für sichere Entwicklung mit KI
10 Tipps, wie Entwickler und Sicherheitsexperten potenzielle Risiken wirksam mindern und gleichzeitig die Vorteile der KI-gestützten Entwicklung voll ausschöpfen können.