Performance in OPA Rego: Bottom-up und Top-down

29. April 2021
0 Min. LesezeitIn diesem Blogbeitrag sprechen wir darüber, wie die Auswertung von Rego funktioniert und wie sie sich auf die Performance auswirkt. Rego ist eine DSL zur Erstellung von Richtlinien. Sie ist nicht auf eine einzelne Art von Richtlinien (z. B. RBAC) beschränkt, sondern vielseitig einsetzbar. Dadurch lassen sich Richtlinien über verschiedene Services und Stacks hinweg gemeinsam nutzen. Wir haben festgestellt, dass Rego sich ideal für die Cloud-Infrastruktursicherheit in Fugue und für Infrastructure-as-Code-Sicherheit in unserem Open-Source-Projekt Regula eignet.
Rego basiert auf Datalog, einer deklarativen Sprache. Das bedeutet vereinfacht gesagt, dass Programmiererinnen und Programmierer die gewünschten Ergebnisse angeben, aber nicht unbedingt, wie diese berechnet werden. Das unterscheidet sich von imperativen Sprachen wie JavaScript und Python, bei denen immer der genaue Algorithmus vorgegeben wird.
Die Unterscheidung ist nicht immer eindeutig: Die meisten deklarativen Sprachen bieten eine Möglichkeit, anzugeben, wie etwas berechnet werden soll (wie wir in diesem Blogbeitrag zeigen werden), und es ist möglich, deklarative DSLs in imperativen Sprachen zu erstellen. In jedem Fall ist Rego eindeutig dem deklarativen Ende des Spektrums zuzuordnen.
Da Programmiererinnen und Programmierer nicht angeben müssen, wie ein Ergebnis berechnet wird, hat der Compiler oder Interpreter hier mehr Spielraum. Für Sprachen wie Rego gibt es zwei wichtige Strategien: Bottom-up und Top-down.
Anhand eines einfachen Beispiels erklären wir die beiden Strategien und sprechen über ihre jeweiligen Vor- und Nachteile.
Ein Beispiel
Stellen Sie sich vor, wir schreiben eine Richtlinie, die sicherstellt, dass Schreibberechtigungen granular vergeben werden. Unsere Eingabe könnte etwa so aussehen:
Einige dieser Rollen haben sogenannte gefährliche Schreibberechtigungen: write: *. In unserer Richtlinie möchten wir für jede Person, der eine gefährliche Rolle zugewiesen wurde, eine Fehlermeldung ausgeben.
Wir definieren zwei Regeln:
dangerous_roles:eine Menge, die alle Richtlinien mitwrite: *enthältdeny: eine Menge mit allen Fehlermeldungen
Hier ist die vollständige Richtlinie:
Mit opa eval können wir überprüfen, ob die erwartete Ausgabe angezeigt wird:
Sehen wir uns mit diesem Beispiel im Hinterkopf die Bottom-up- und Top-down-Auswertung an.
Bottom-up
Am einfachsten lässt sich der Unterschied zwischen diesen beiden Auswertungsstrategien verstehen, wenn man sich den Abhängigkeitsbaum der Regeln vor Augen führt:
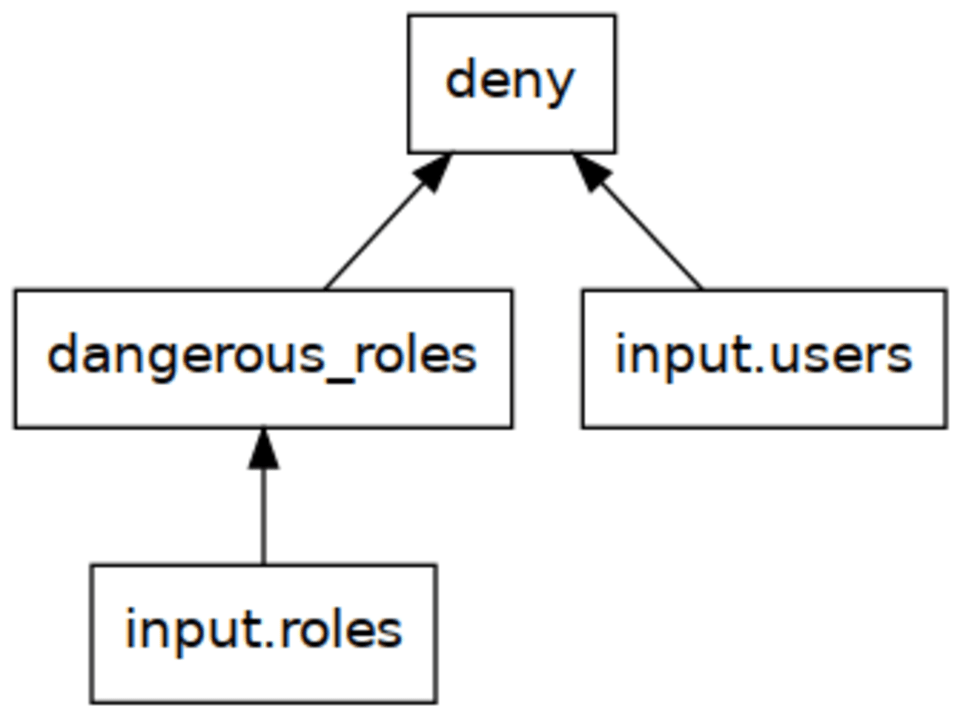
deny hängt von dangerous_roles ab, und beide hängen vom Eingabedokument ab. Bei einer Bottom-up-Strategie wird dieser Baum von unten nach oben ausgewertet.
Das Eingabedokument muss nicht weiter ausgewertet werden. Darüber befindet sich die Menge dangerous_roles: Wir beginnen mit der Berechnung dieser Menge. In unserem Beispiel ergibt sich die Menge {"temporary_hack"}.
Sobald dangerous_roles bekannt ist, sind alle Abhängigkeiten für die Regel deny bekannt. Wir werten also die zweite Menge weiter aus. Das Ergebnis ist {"Please remove role temporary_hack from user bob"}.
Eine Bottom-up-Strategie ist einfach zu implementieren, hat aber einen großen Nachteil: Sie berechnet oft zu viel! Angenommen, statt alle deny-Meldungen aufzulisten, möchten wir nur prüfen, ob temporary_hack eine gefährliche Rolle ist. Bei einer Bottom-up-Strategie würde dangerous_roles["temporary_hack"] die gesamte (möglicherweise sehr große) Menge berechnen, anstatt anzuhalten, sobald klar ist, dass temporary_hack tatsächlich in der Menge enthalten ist.
Eine Top-down-Strategie löst dieses Problem.
Top-down
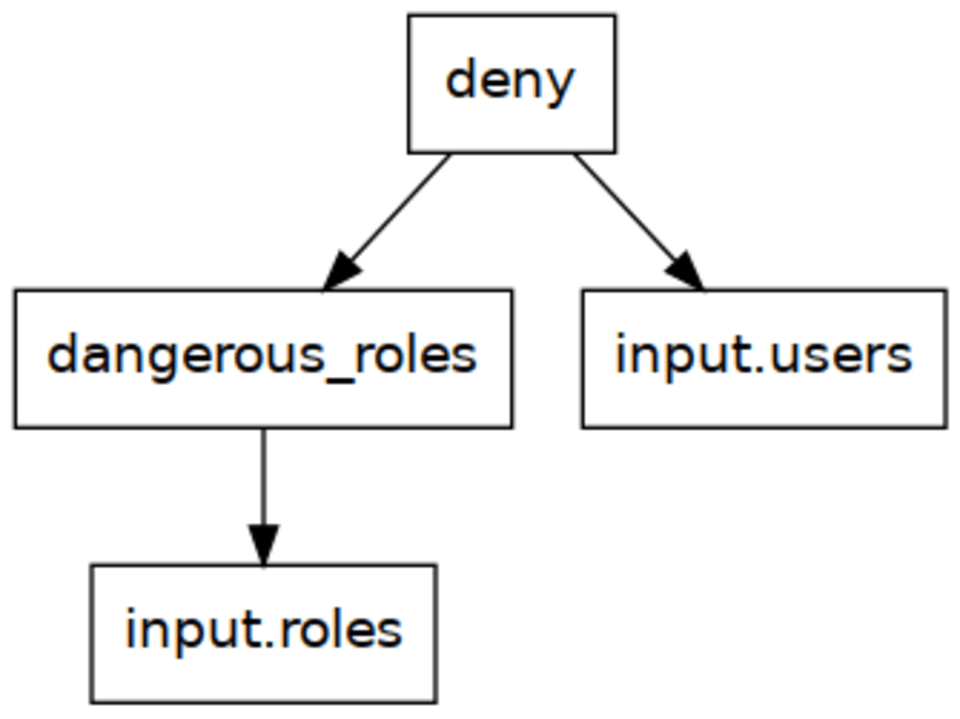
Bei einer Top-down-Strategie läuft die Auswertung genau umgekehrt: Die Regeln werden bei Bedarf von oben nach unten ausgewertet. Das entspricht weitgehend dem Aufruf von Funktionen in den meisten Programmiersprachen.
Wir beginnen mit der Auswertung von deny, da dies der angeforderte Wert ist. Diese Regel durchläuft die Benutzer, weist role_name einen Wert zu und ruft anschließend dangerous_roles[role_name] auf. Als Funktionsaufruf betrachtet, lässt sich das als dangerous_roles(role_name) auffassen.
dangerous_roles ruft keine weiteren „Funktionen“ auf, sondern durchläuft die Richtlinien im Eingabedokument.
So erhalten wir das gewünschte Verhalten bei der Auswertung von dangerous_roles["temporary_hack"]: Statt eine Menge zu erstellen, werden nun die Richtlinien in der Eingabe durchlaufen. Sobald die passende gefährliche Rolle gefunden wird, wird das Ergebnis zurückgegeben.
OPA verwendet für die Auswertung von Rego eine Top-down-Strategie.
Ungewollt quadratisch
Doch auch der Top-down-Ansatz hat Nachteile! In Pseudocode führt die Bottom-up-Auswertung intern zwei Schleifen aus:
Bei der Top-down-Auswertung ist das anders. Betrachten wir dangerous_roles wieder als Funktionsaufruf, ergibt sich:
Das sieht verdächtig nach einer quadratischen Laufzeit aus!
Und tatsächlich: Erzeugen wir eine Eingabe mit 1000 Benutzern und 1000 Richtlinien, benötigt opa für die Auswertung 3,47 Sekunden. Erhöhen wir die Anzahl auf 10000, dauert es bereits etwas mehr als 4 Minuten!
Das mag wie ein konstruiertes Beispiel klingen – es entspricht jedoch einem realen Problem, auf das wir bei Fugue gestoßen sind! Wir analysieren große Mengen an Ressourcen auf Compliance, sodass sich diese Auswertungen summieren können.
Top-down und Bottom-up
War’s das? Müssen wir uns mit langsamen Abfragen abfinden? Zum Glück nicht!
Es gibt eine einfache Lösung: Wenn wir wissen, dass eine Regel „auf einmal“ ausgewertet werden soll, können wir dafür eine Set-Comprehension verwenden. Dadurch wird dangerous_roles zu einer vollständigen Regel mit einem einzigen Wert.
Syntaktisch sieht das so aus:
Mit diesem einfachen Trick (Abfrageanalysten hassen ihn) kommen wir bei 10000 Benutzern auf weniger als 0,4 Sekunden!
Fazit
Mit einer deklarativen Sprache können Sie sich ganz darauf konzentrieren, was Sie berechnen möchten, statt darauf, wie Sie es berechnen. Das tatsächliche Ausführungsmodell sollten Sie dennoch nicht völlig außer Acht lassen – insbesondere dann nicht, wenn die Laufzeit dadurch explodieren und es zu Timeouts kommen kann!
Zum Glück ist die Lösung einfach und schnell umgesetzt. Wenn Sie Rego-Regeln schreiben, sollten Sie sich fragen, ob eine Regel als Funktion oder als einmalig berechnete Menge dargestellt werden sollte, und entsprechend eine Comprehension oder eine inkrementelle Regel verwenden.
In diesem Blogbeitrag ging es ausschließlich um Mengen, doch dasselbe gilt auch für Objekte.
Eine naheliegende Frage, die wir noch nicht beantwortet haben, ist, ob sich das beheben lässt, ohne den Code ändern zu müssen – ganz im Sinne des deklarativen Ansatzes.
Die Ergebnisse von Aufrufen wie dangerous_roles[role] zwischenzuspeichern, klingt nach einem interessanten Ansatz – und genau das habe ich zuerst untersucht. Um Neuberechnungen zu vermeiden, müssten dabei allerdings sowohl die Elemente in der Menge als auch die Elemente außerhalb der Menge zwischengespeichert werden. Das ist problematisch, da Letztere möglicherweise nicht in den Speicher passen. Außerdem ist in beiden Fällen eine LRU-Verdrängung erforderlich, was den Code komplizierter macht.
Es ist schlicht nicht immer möglich, dass ein Compiler automatisch erkennt, ob eine beliebige Regel besser Bottom-up oder Top-down berechnet wird. Das sollte uns aber nicht davon abhalten, es zu versuchen. Ich habe in fregot, unserer experimentellen Rego-Engine, einen Optimierungsschritt prototypisch umgesetzt. Er erkennt Regeln, die sich für eine Bottom-up-Auswertung eignen, indem er Zuweisungsmuster untersucht und prüft, ob sich das Argument für einen Kurzschluss bei der Auswertung nutzen lässt. Dabei wurden alle Fälle erkannt, bei denen es zu Timeouts kam – ein vielversprechender Ansatz!
IaC-Sicherheit für Entwickler
Snyk schützt Ihre Infrastructure as Code vom SDLC bis zur Laufzeit in der Cloud mit einer einheitlichen Policy-as-Code-Engine, damit jedes Team sicher entwickeln, bereitstellen und betreiben kann.