Wie selbst kurze asynchrone Node.js-Funktionen den Event-Loop blockieren können

Michael Gokhman
4. Februar 2019
0 Min. LesezeitEine typische Node.js-App ist im Grunde eine Sammlung von Callbacks, die als Reaktion auf verschiedene Ereignisse ausgeführt werden: eine eingehende Verbindung, der Abschluss einer I/O-Operation, das Ablaufen eines Timeouts, die Auflösung eines Promise usw. Es gibt einen einzelnen Hauptthread (auch Event-Loop genannt), der all diese Callbacks ausführt. Deshalb sollten sie schnell abgeschlossen sein, denn alle anderen ausstehenden Callbacks warten darauf, an die Reihe zu kommen. Diese bekannte Einschränkung von Node ist eine Herausforderung und wird auch in der Dokumentation anschaulich erklärt.
Kürzlich bin ich bei Snyk auf einen realen Fall gestoßen, in dem die Event-Loop blockiert wurde. Als ich versuchte, die Situation zu beheben, wurde mir klar, wie wenig ich tatsächlich über das Verhalten der Event-Loop wusste. Dabei machte ich einige Erkenntnisse, die mich und einige Entwicklerkollegen, mit denen ich sie teilte, zunächst überraschten. Ich finde es wichtig, dass möglichst viele Node-Entwickler dieses Wissen haben – deshalb habe ich diesen Artikel geschrieben.
Über die Node.js-Event-Loop gibt es bereits viele wertvolle Informationen. Es hat jedoch gedauert, bis ich Antworten auf meine konkreten Fragen gefunden habe. Ich werde mein Bestes tun, die verschiedenen Fragen zu teilen, die ich mir gestellt habe, und die Antworten, die ich in verschiedenen großartigen Artikeln sowie durch spannende Experimente und gründliche Recherche gefunden habe.
Blockieren wir zunächst die Node.js-Event-Loop!
Hinweis:
Die folgenden Beispiele verwenden Node 10.9.0 auf einer Ubuntu-18.04-VM mit 4 Kernen, ausgeführt auf einem MacBook Pro von 2017.
Sie können mit dem folgenden Code experimentieren, indem Sie das Repository klonen: https://github.com/michael-go/node-async-block
Beginnen wir mit einem einfachen Express-Server:
Fügen wir nun einen problematischen Endpunkt hinzu, der die Event-Loop blockiert:
Wir erwarten also, dass Anfragen an /healthcheck während der Ausführung des Endpunkts /compute-sync ins Stocken geraten. Den Endpunkt /healthcheck können wir mit diesem einzeiligen bash-Befehl abfragen:
Der Befehl fragt den Endpunkt /healthcheck jede Sekunde ab und bricht mit einem Timeout ab, wenn innerhalb von 5 Sekunden keine Antwort eingeht.
Probieren wir es aus:
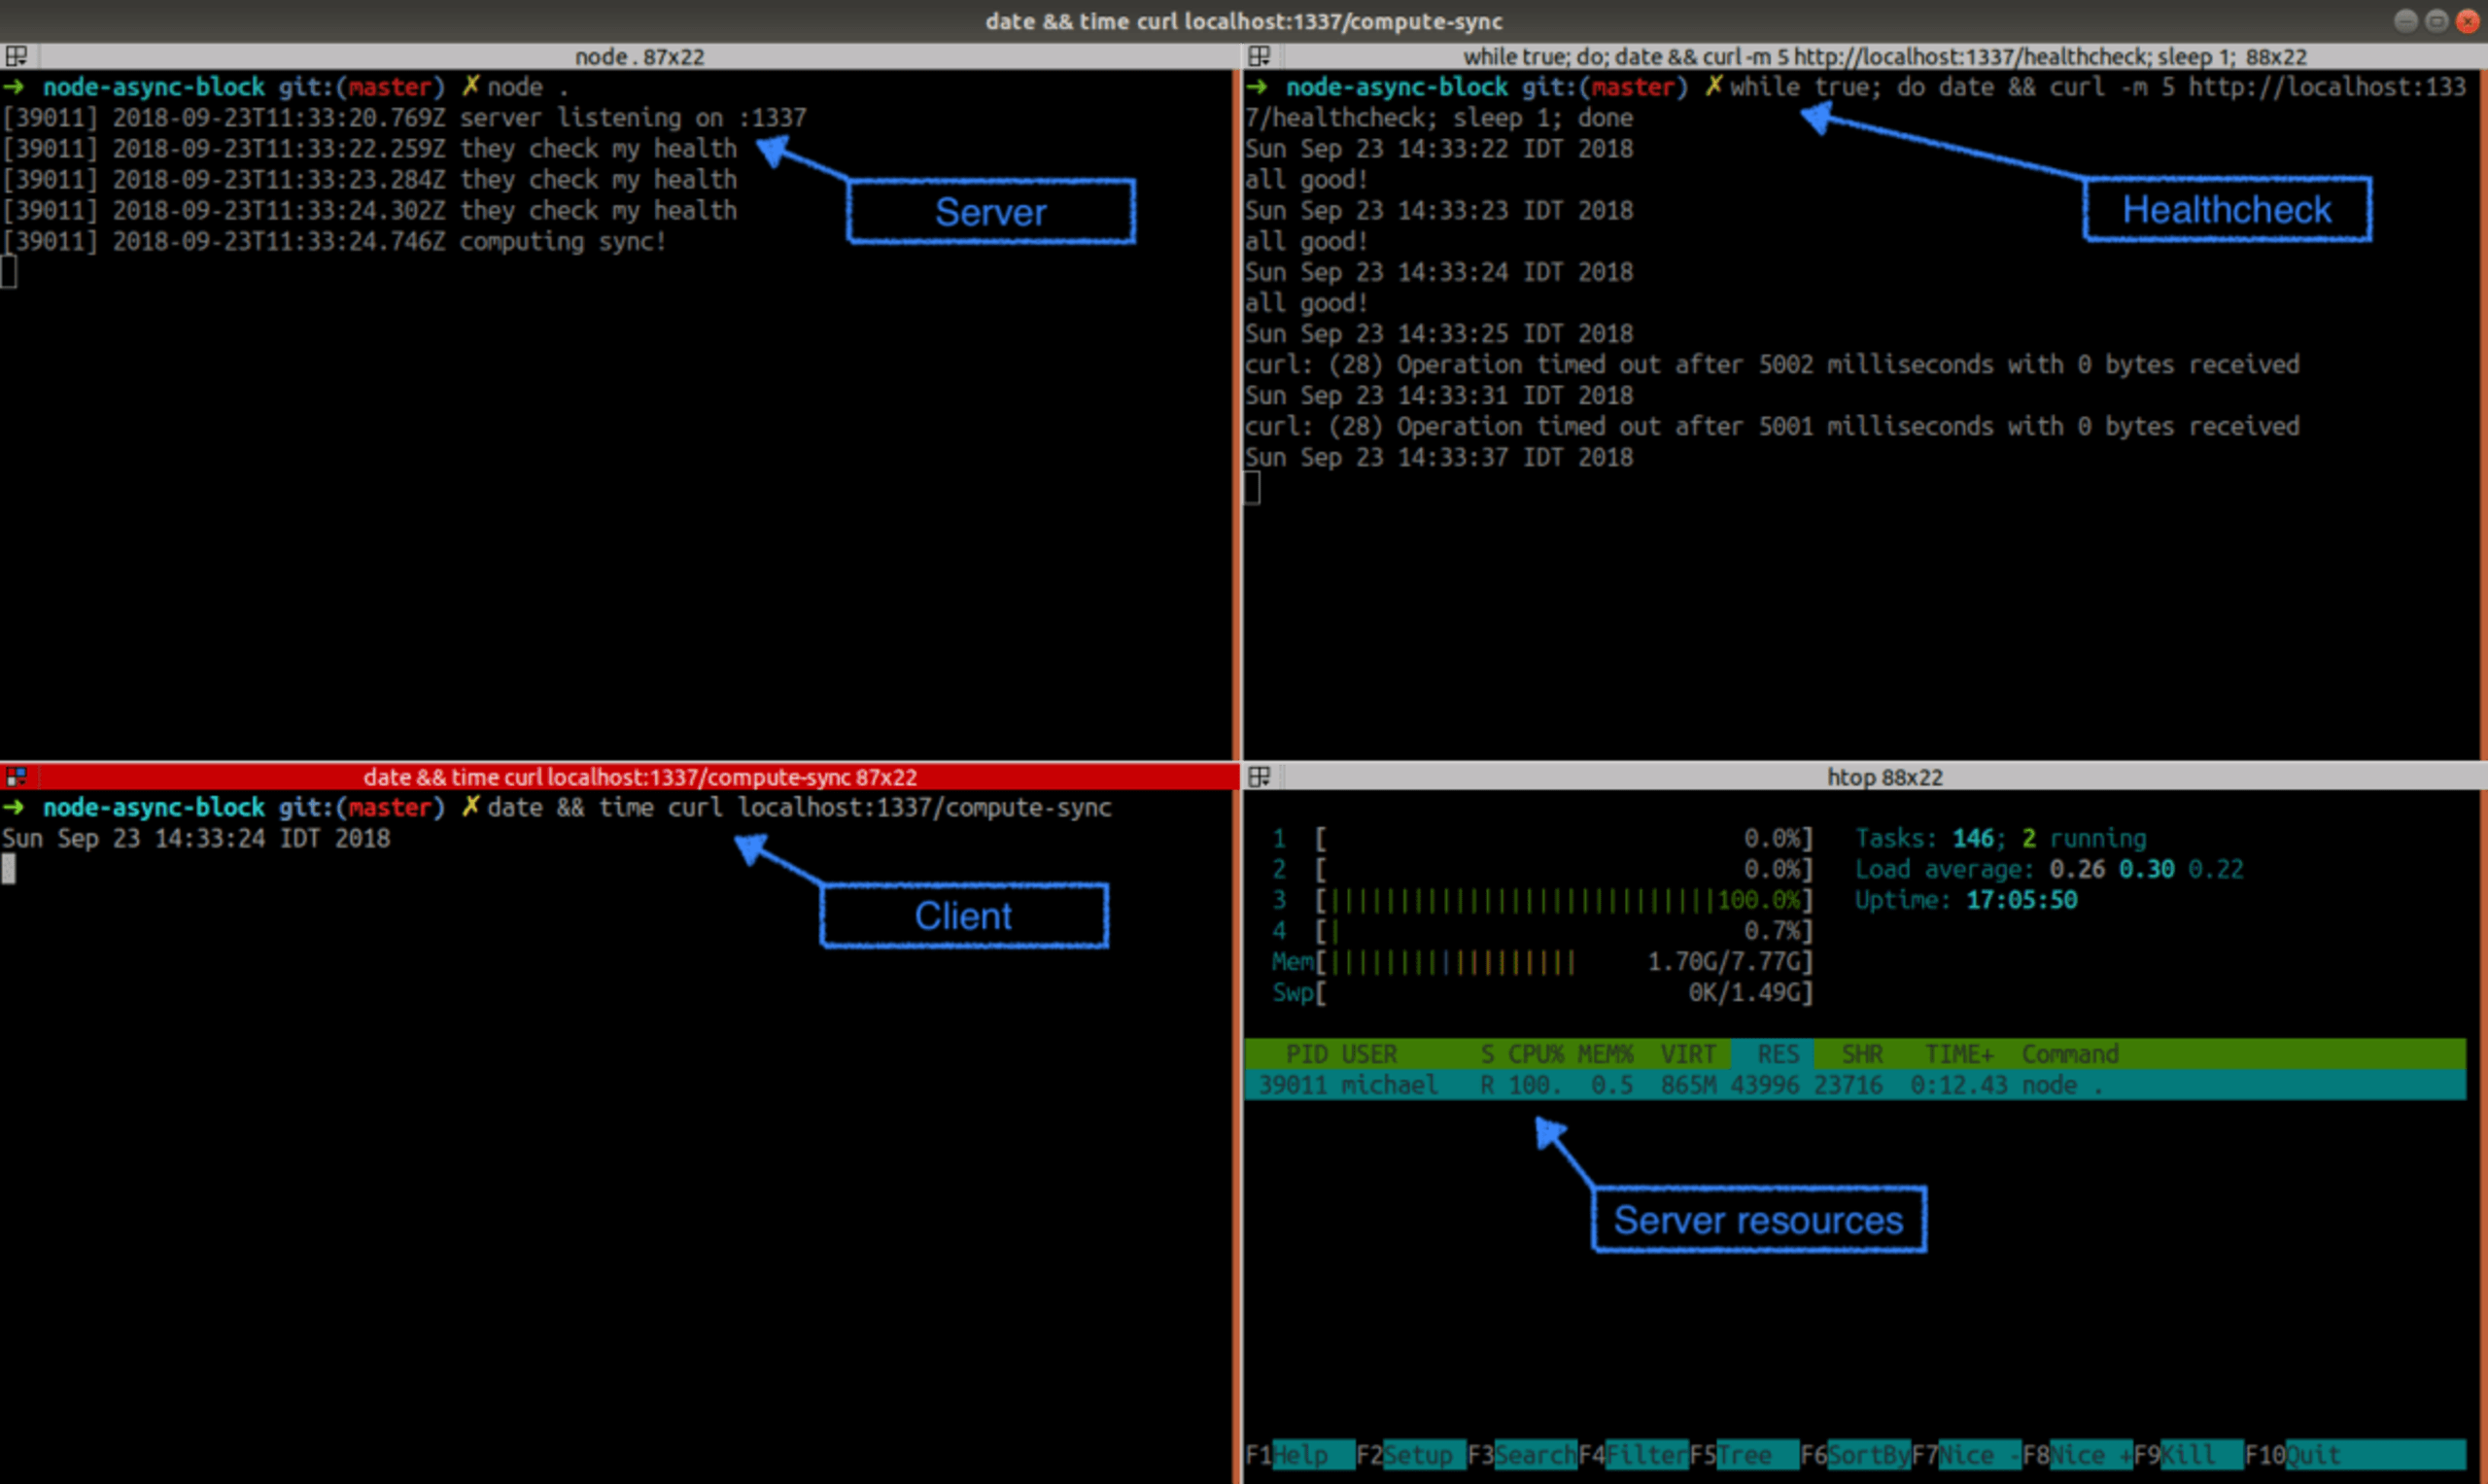
Sobald wir den Endpunkt /compute-sync aufgerufen hatten, liefen die Health-Checks in Timeouts und keiner davon war erfolgreich. Beachten Sie, dass der node-Prozess mit etwa 100 % CPU-Auslastung hart arbeitet.
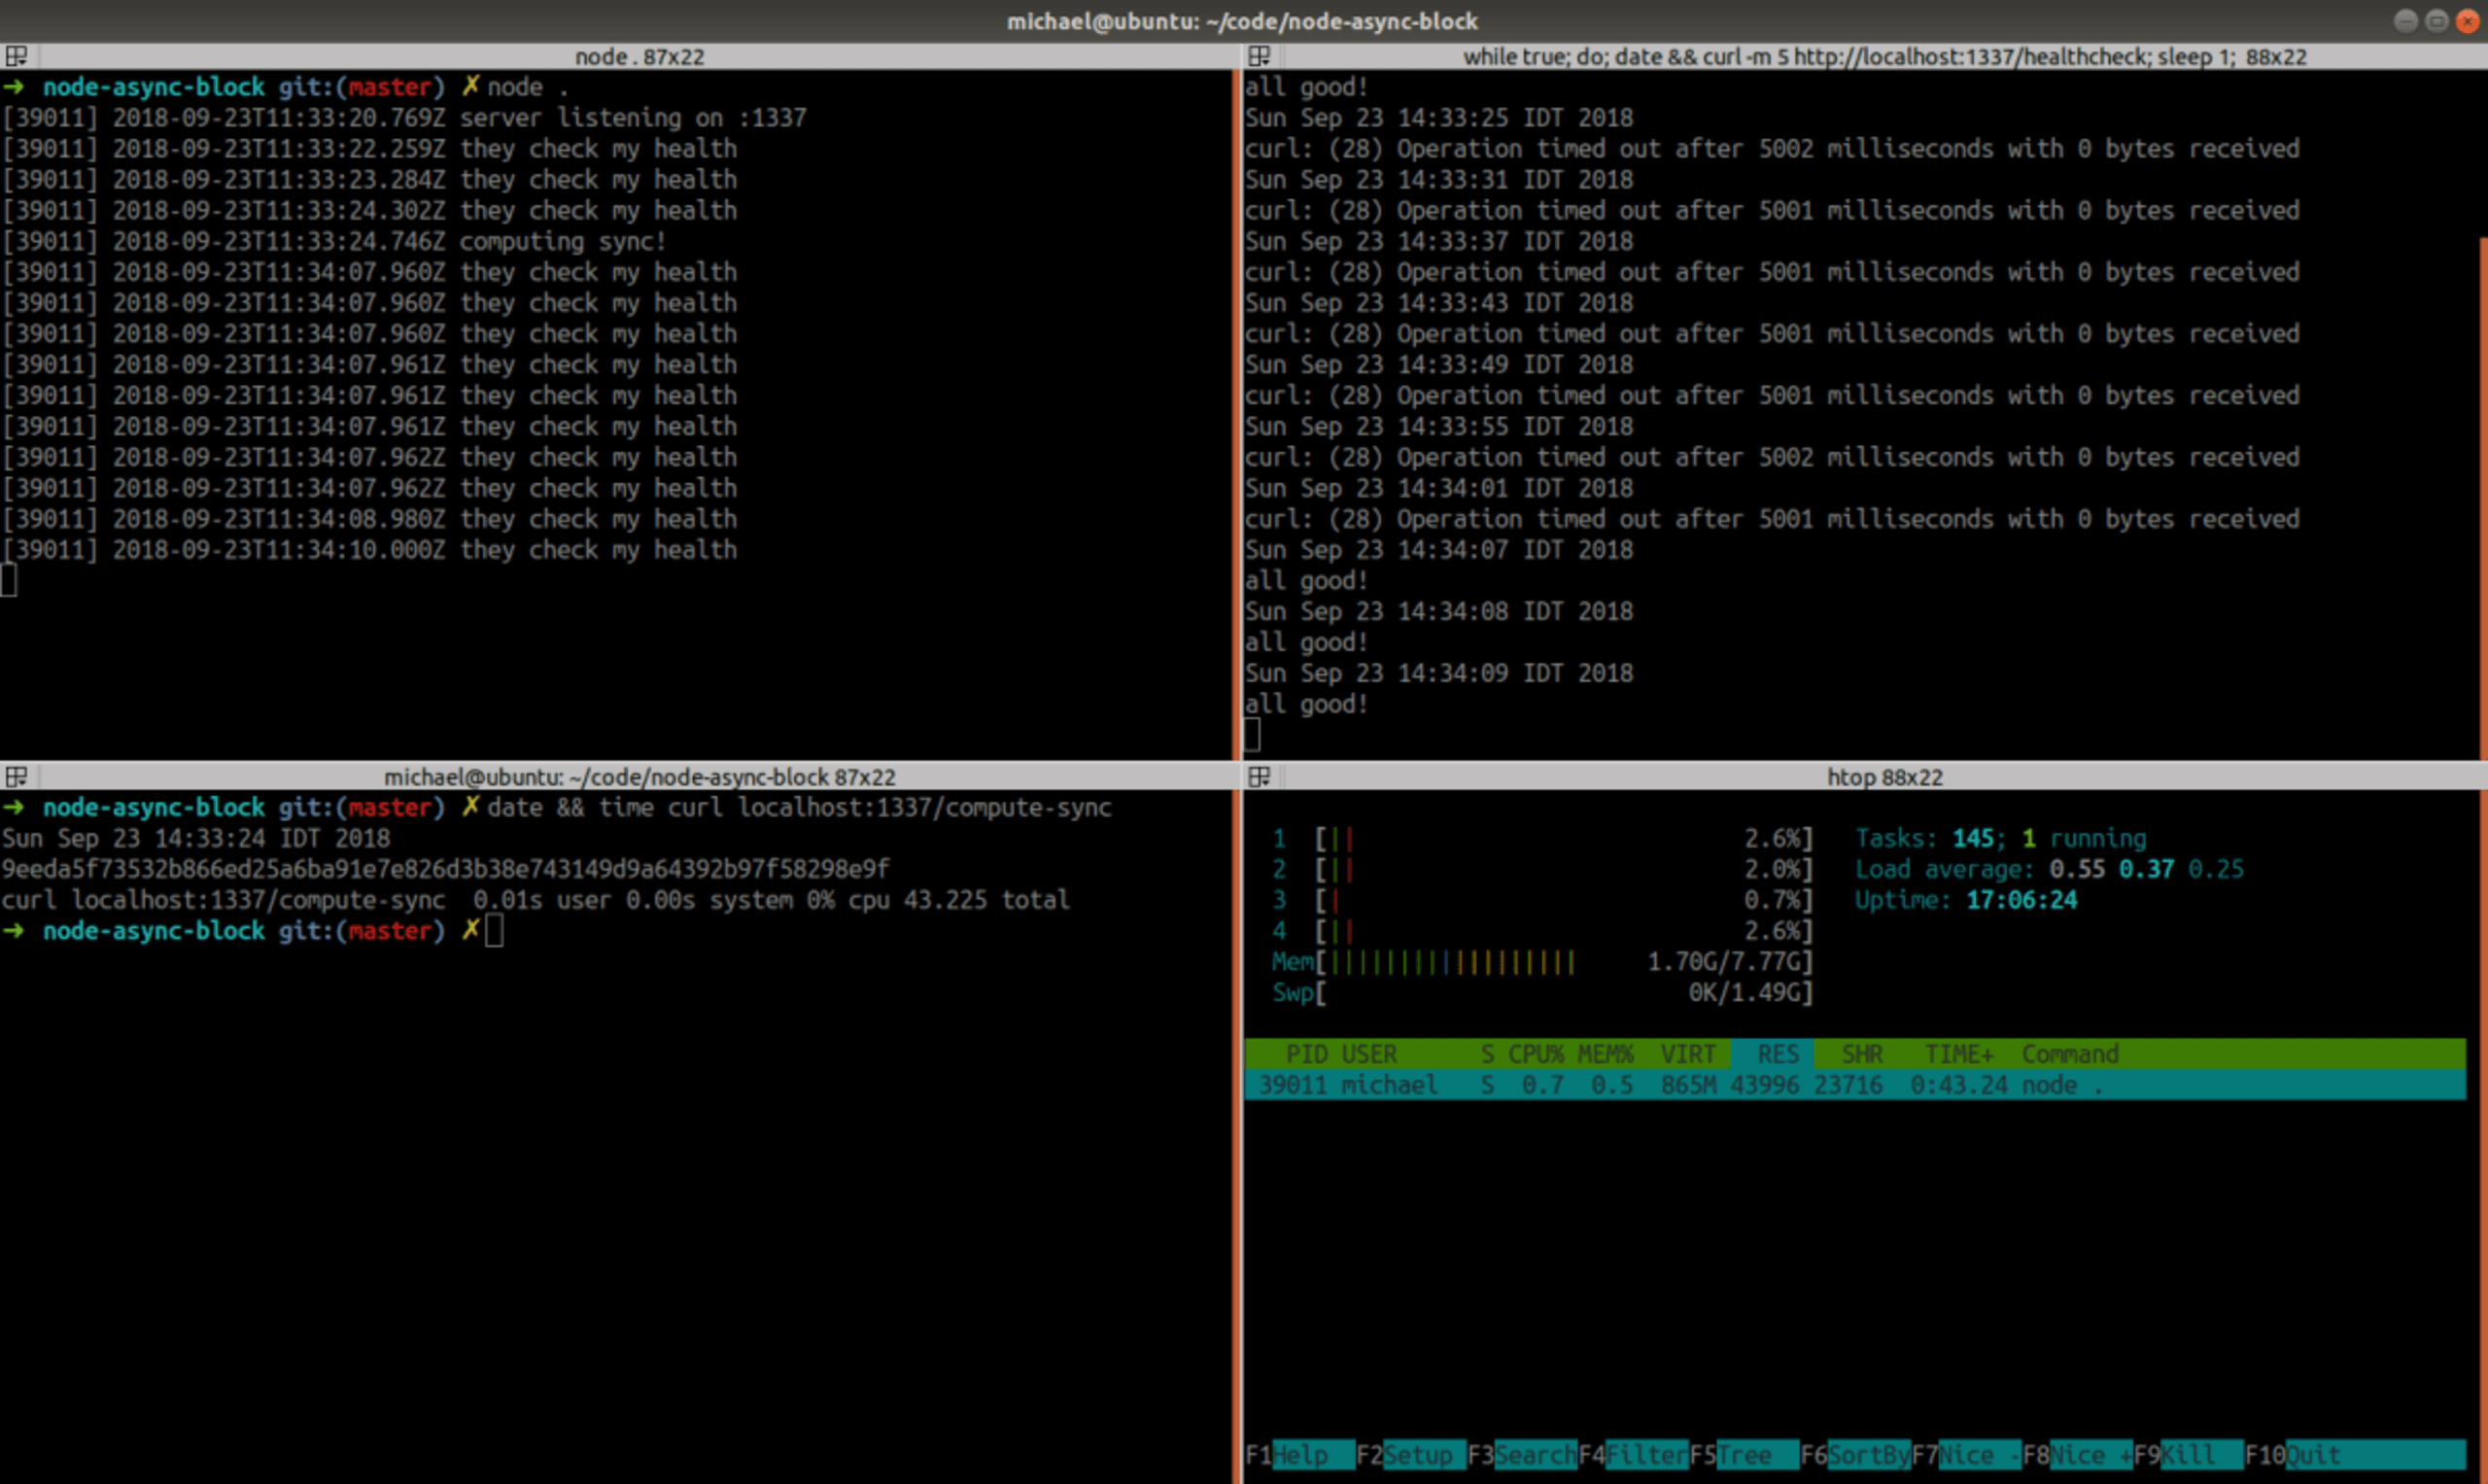
Nach 43,2 Sekunden ist die Berechnung abgeschlossen, die 8 ausstehenden Anfragen an /healthcheck werden verarbeitet und der Server ist wieder erreichbar.
Das ist ziemlich problematisch: Eine einzige fehlerhafte Anfrage blockiert den Server vollständig. Wenn man weiß, dass die Event-Loop aus einem einzelnen Thread besteht, ist klar, warum der Code in /compute-sync alle anderen Anfragen blockiert hat: Bevor er abgeschlossen war, gab er die Kontrolle nicht an den Event-Loop-Scheduler zurück. Daher hatte der Handler für /healthcheck keine Chance, ausgeführt zu werden.
Heben wir die Blockade auf!
Fügen wir einen neuen Endpunkt /compute-async hinzu. Dort teilen wir die lange, blockierende Schleife in einzelne Schritte auf und geben nach jedem Schritt die Kontrolle an die Event-Loop zurück (zu viele Kontextwechsel? Vielleicht … Wir können das später optimieren und nur alle X Iterationen nachgeben. Fangen wir aber einfach an):
Probieren wir es aus:
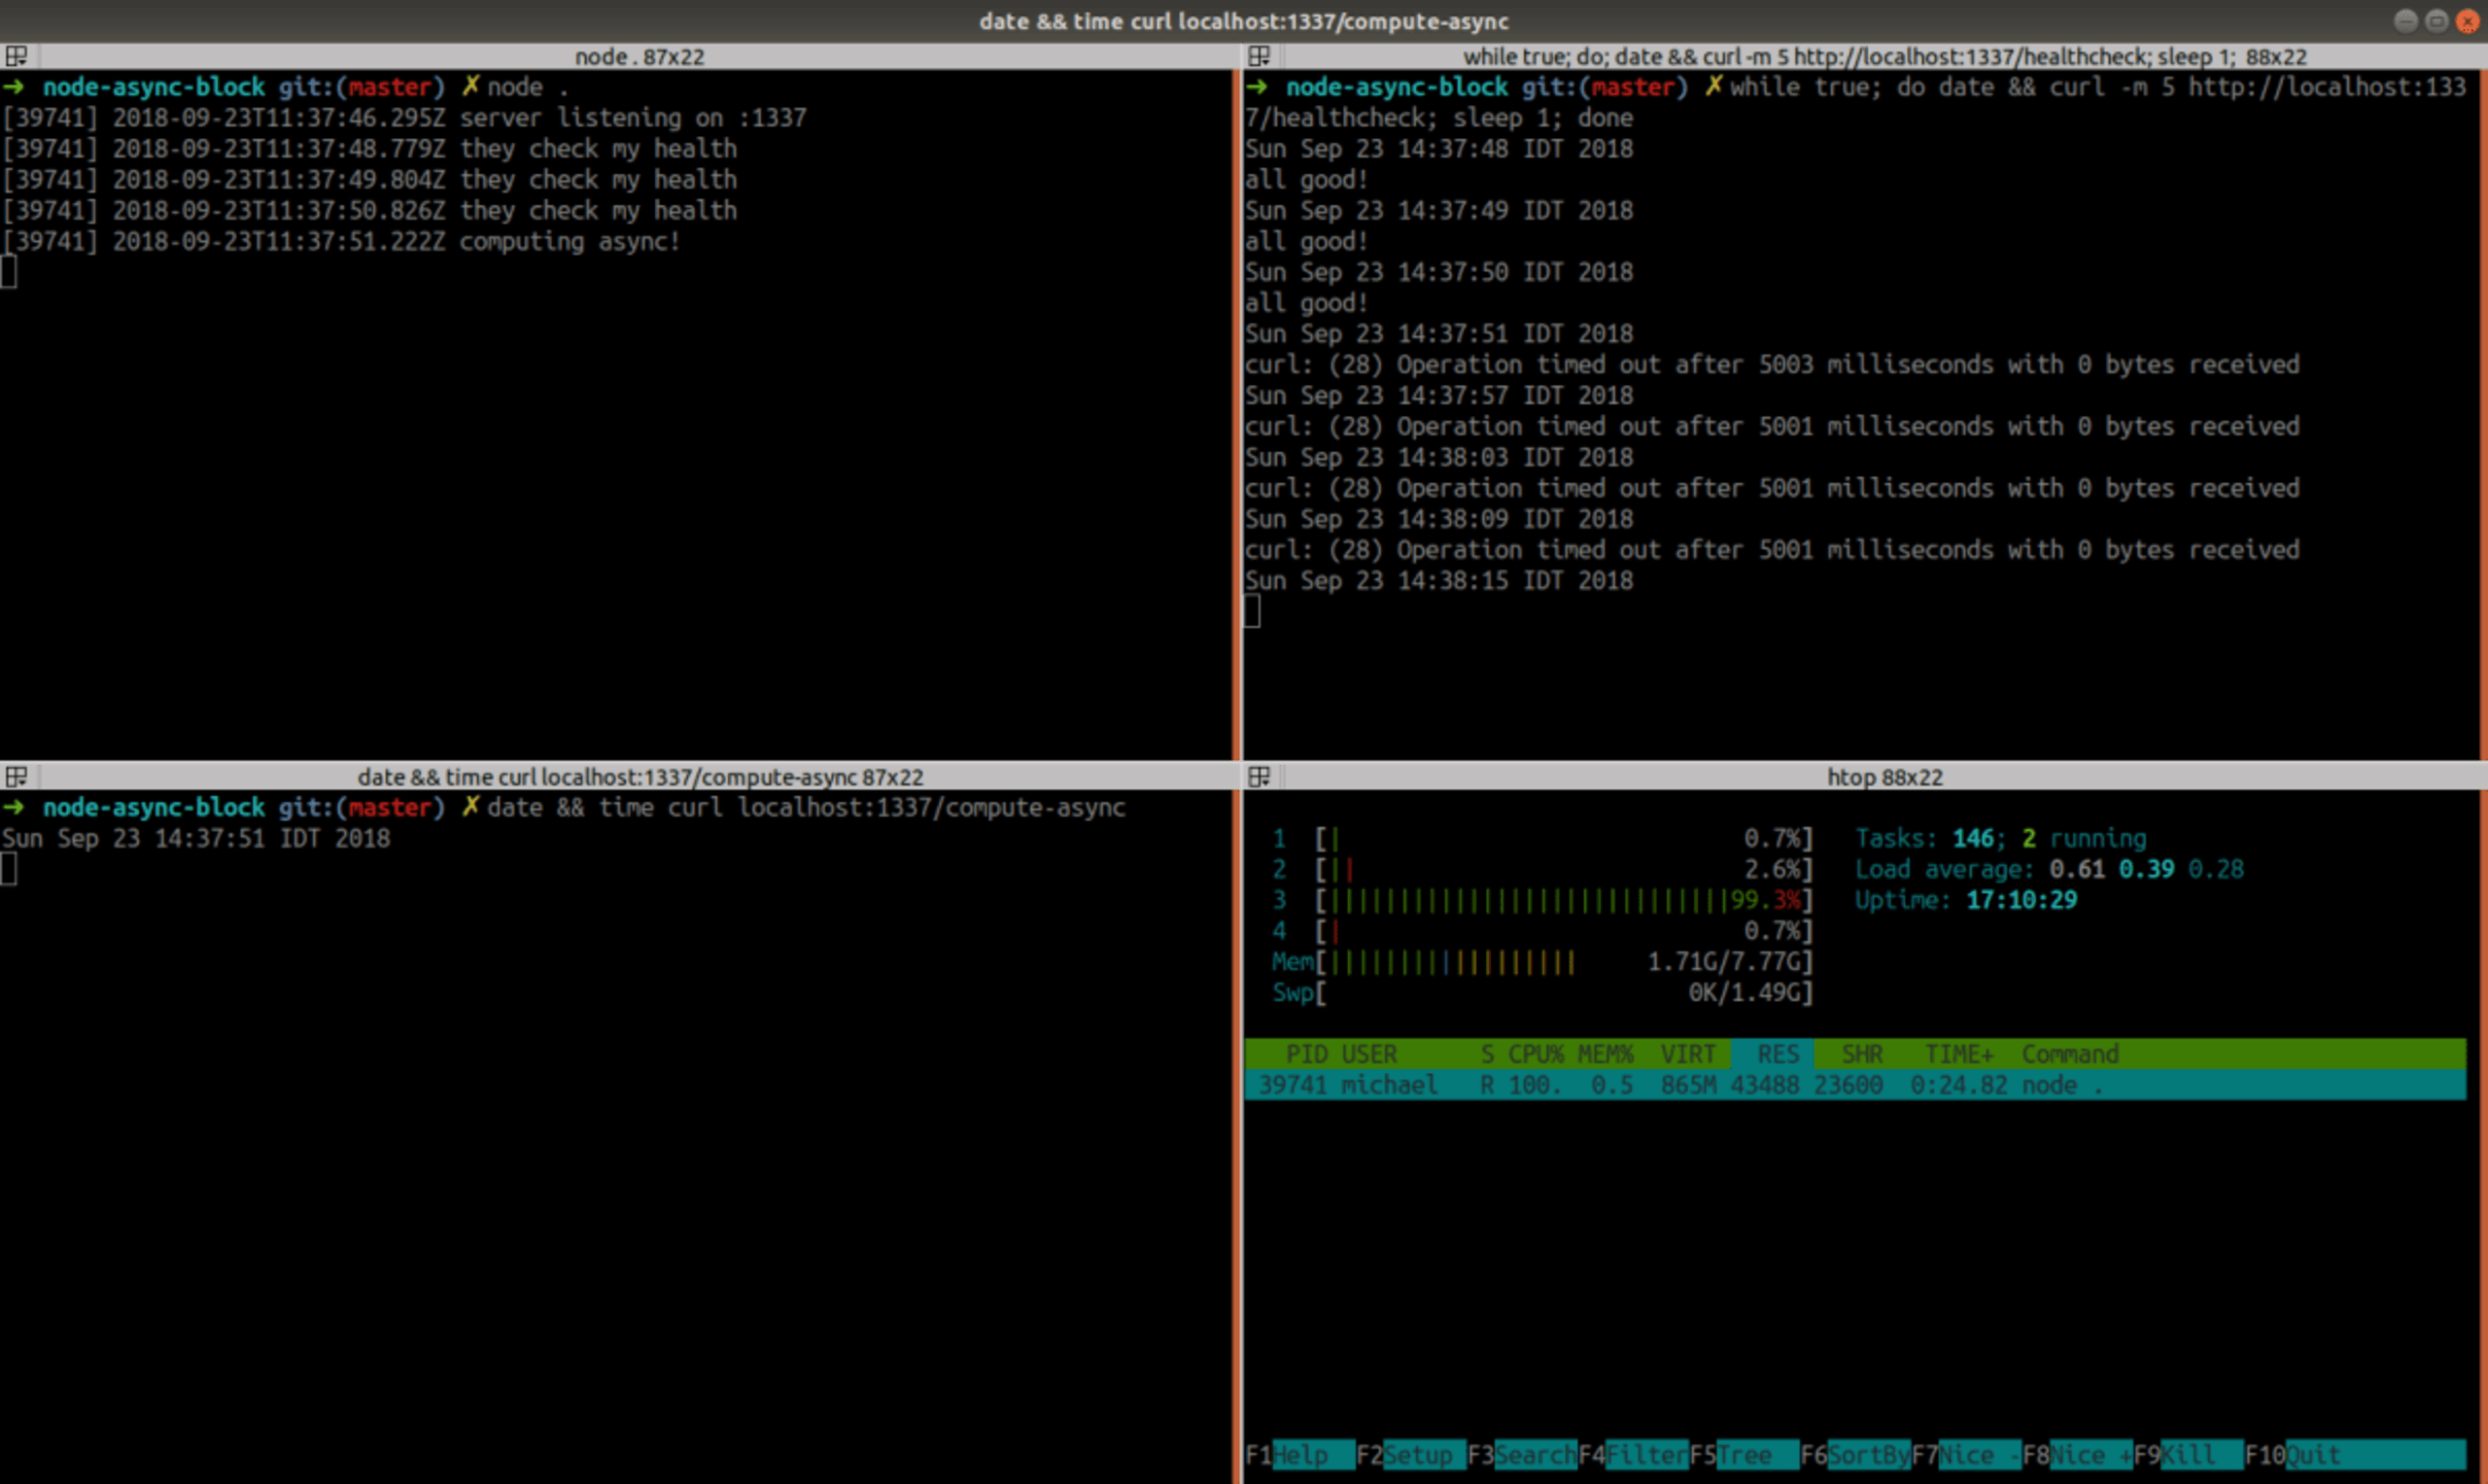
Hmm … die Event-Loop wird immer noch blockiert?
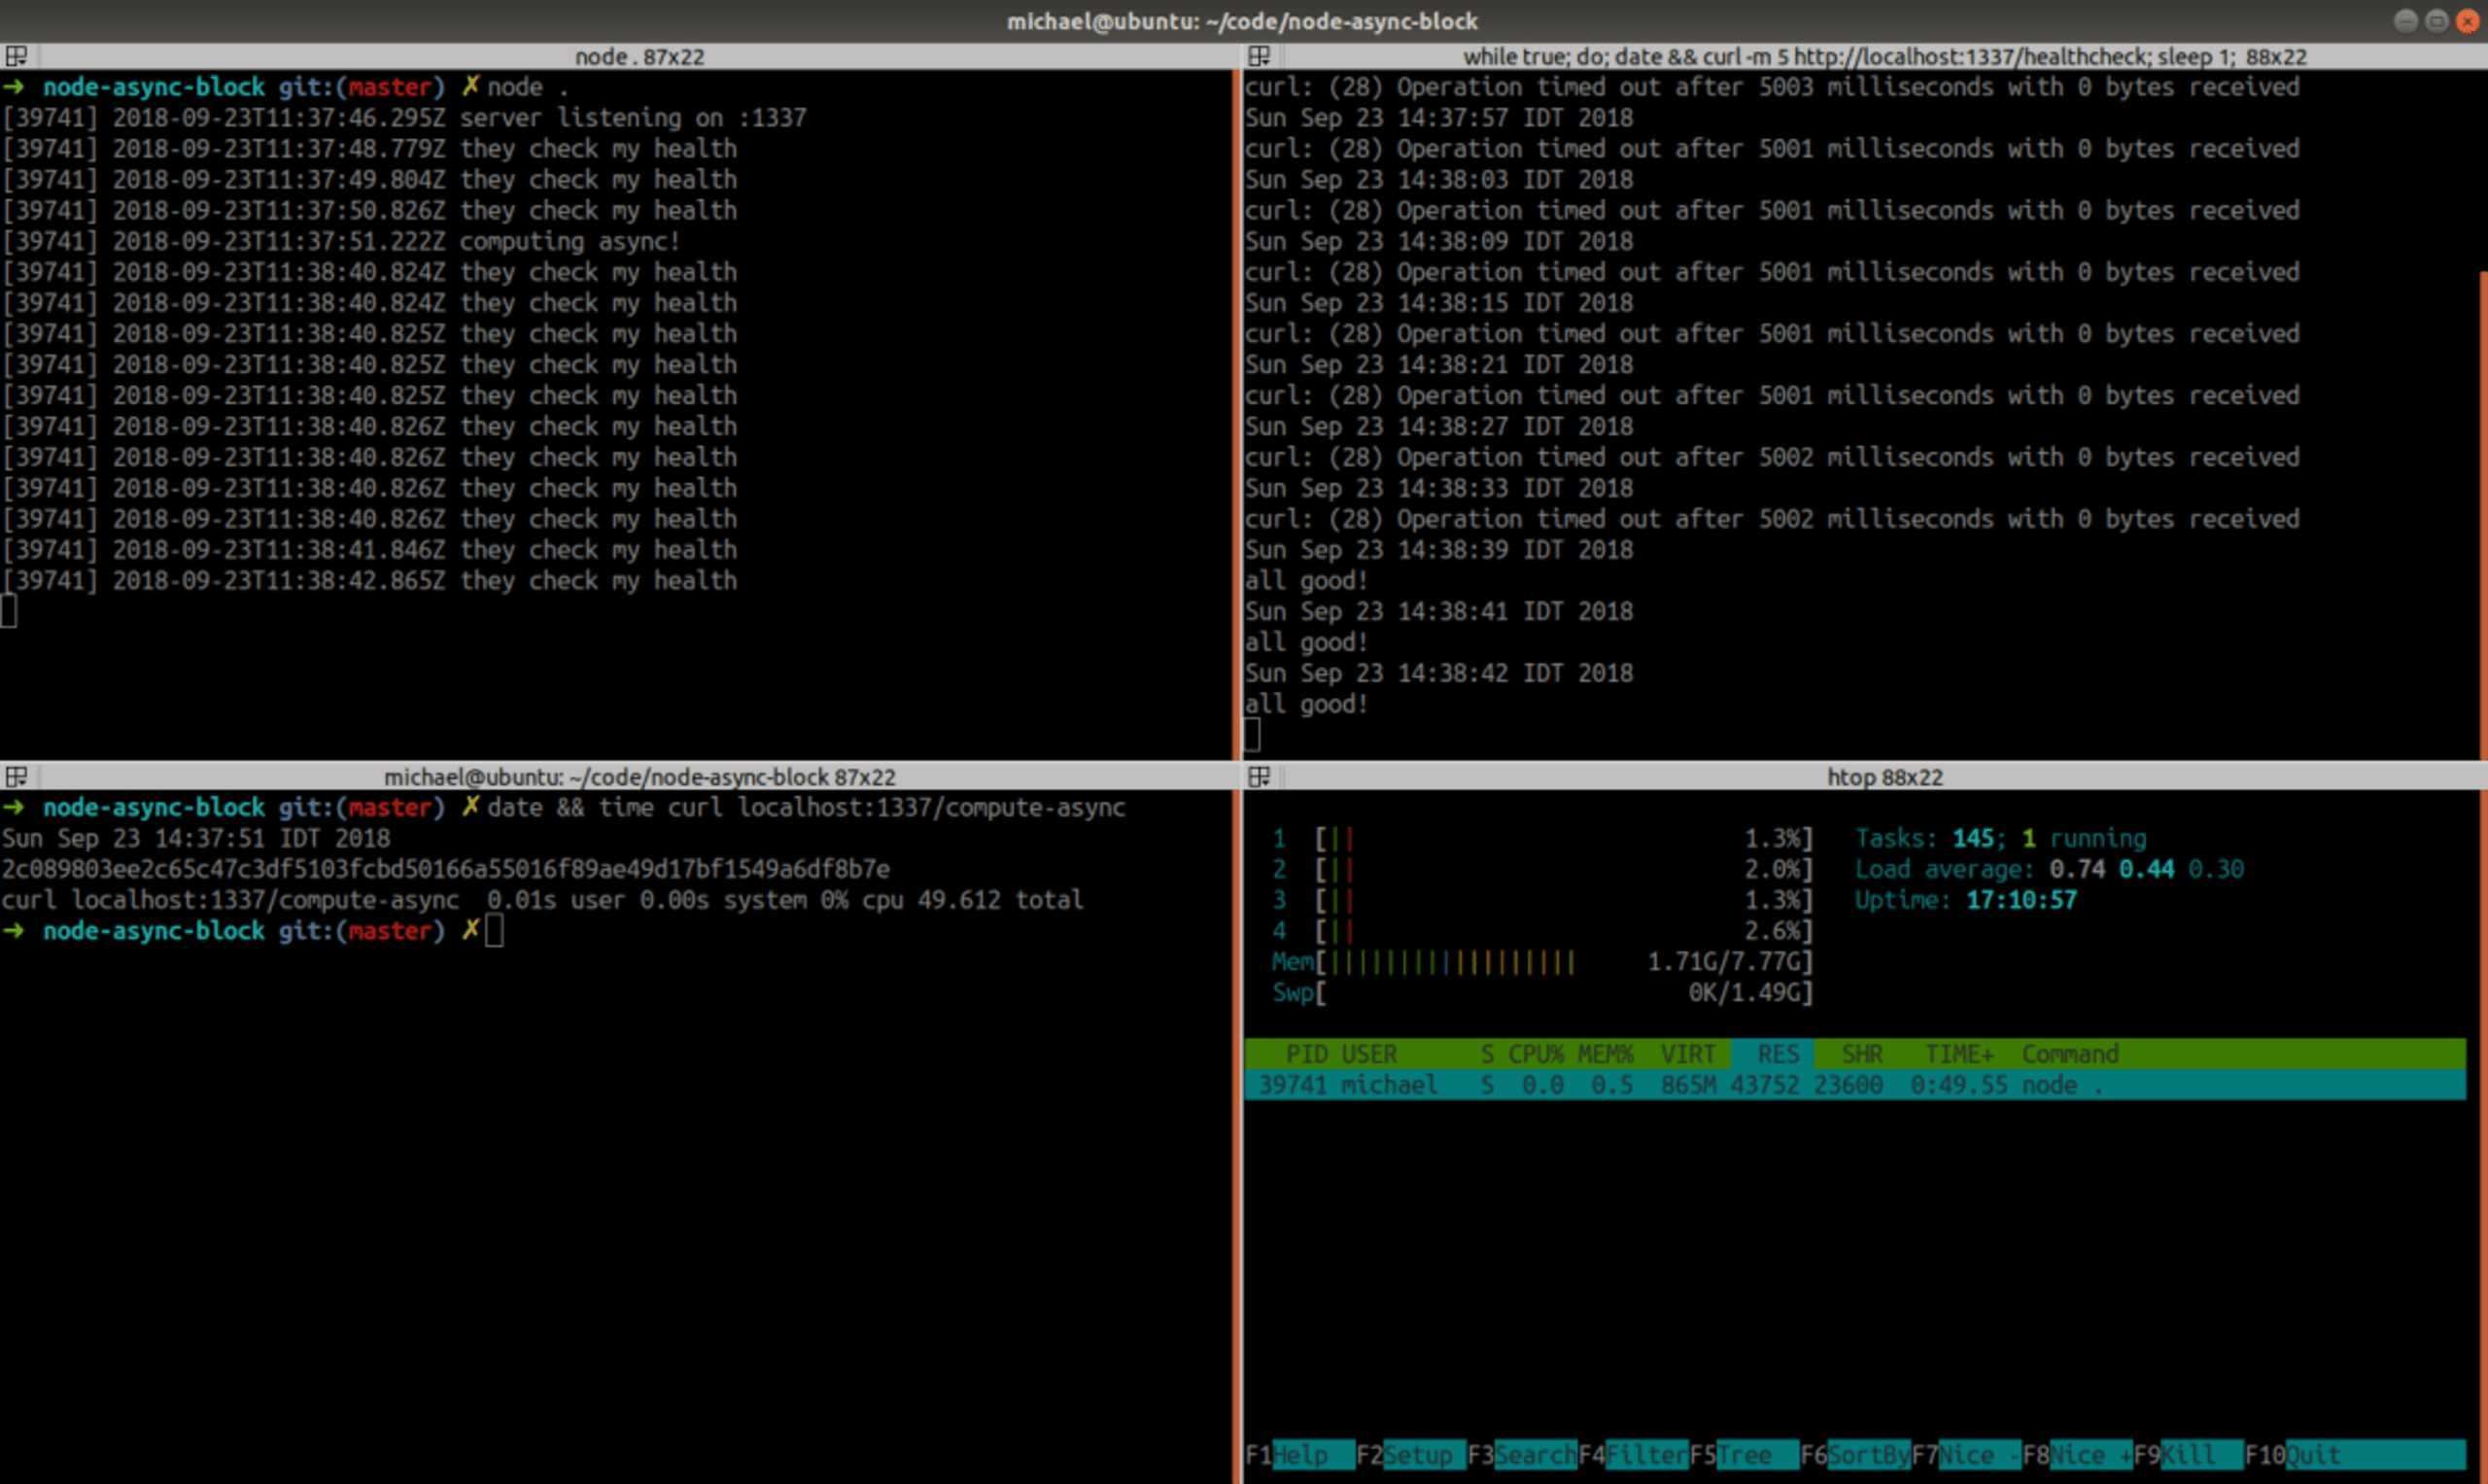
Was ist hier los? Optimiert Node.js unseren Spielzeug-Einsatz von async/await etwa weg? Die Ausführung dauerte einige Sekunden länger, daher scheint das nicht der Fall zu sein … Flame-Graphs können Hinweise darauf geben, ob async tatsächlich wirksam war. Mit diesem praktischen GitHub-Projekt lassen sich ganz einfach Flame-Graphs erstellen:
Zuerst der Flame-Graph, der während der Ausführung von /compute-sync aufgezeichnet wurde:
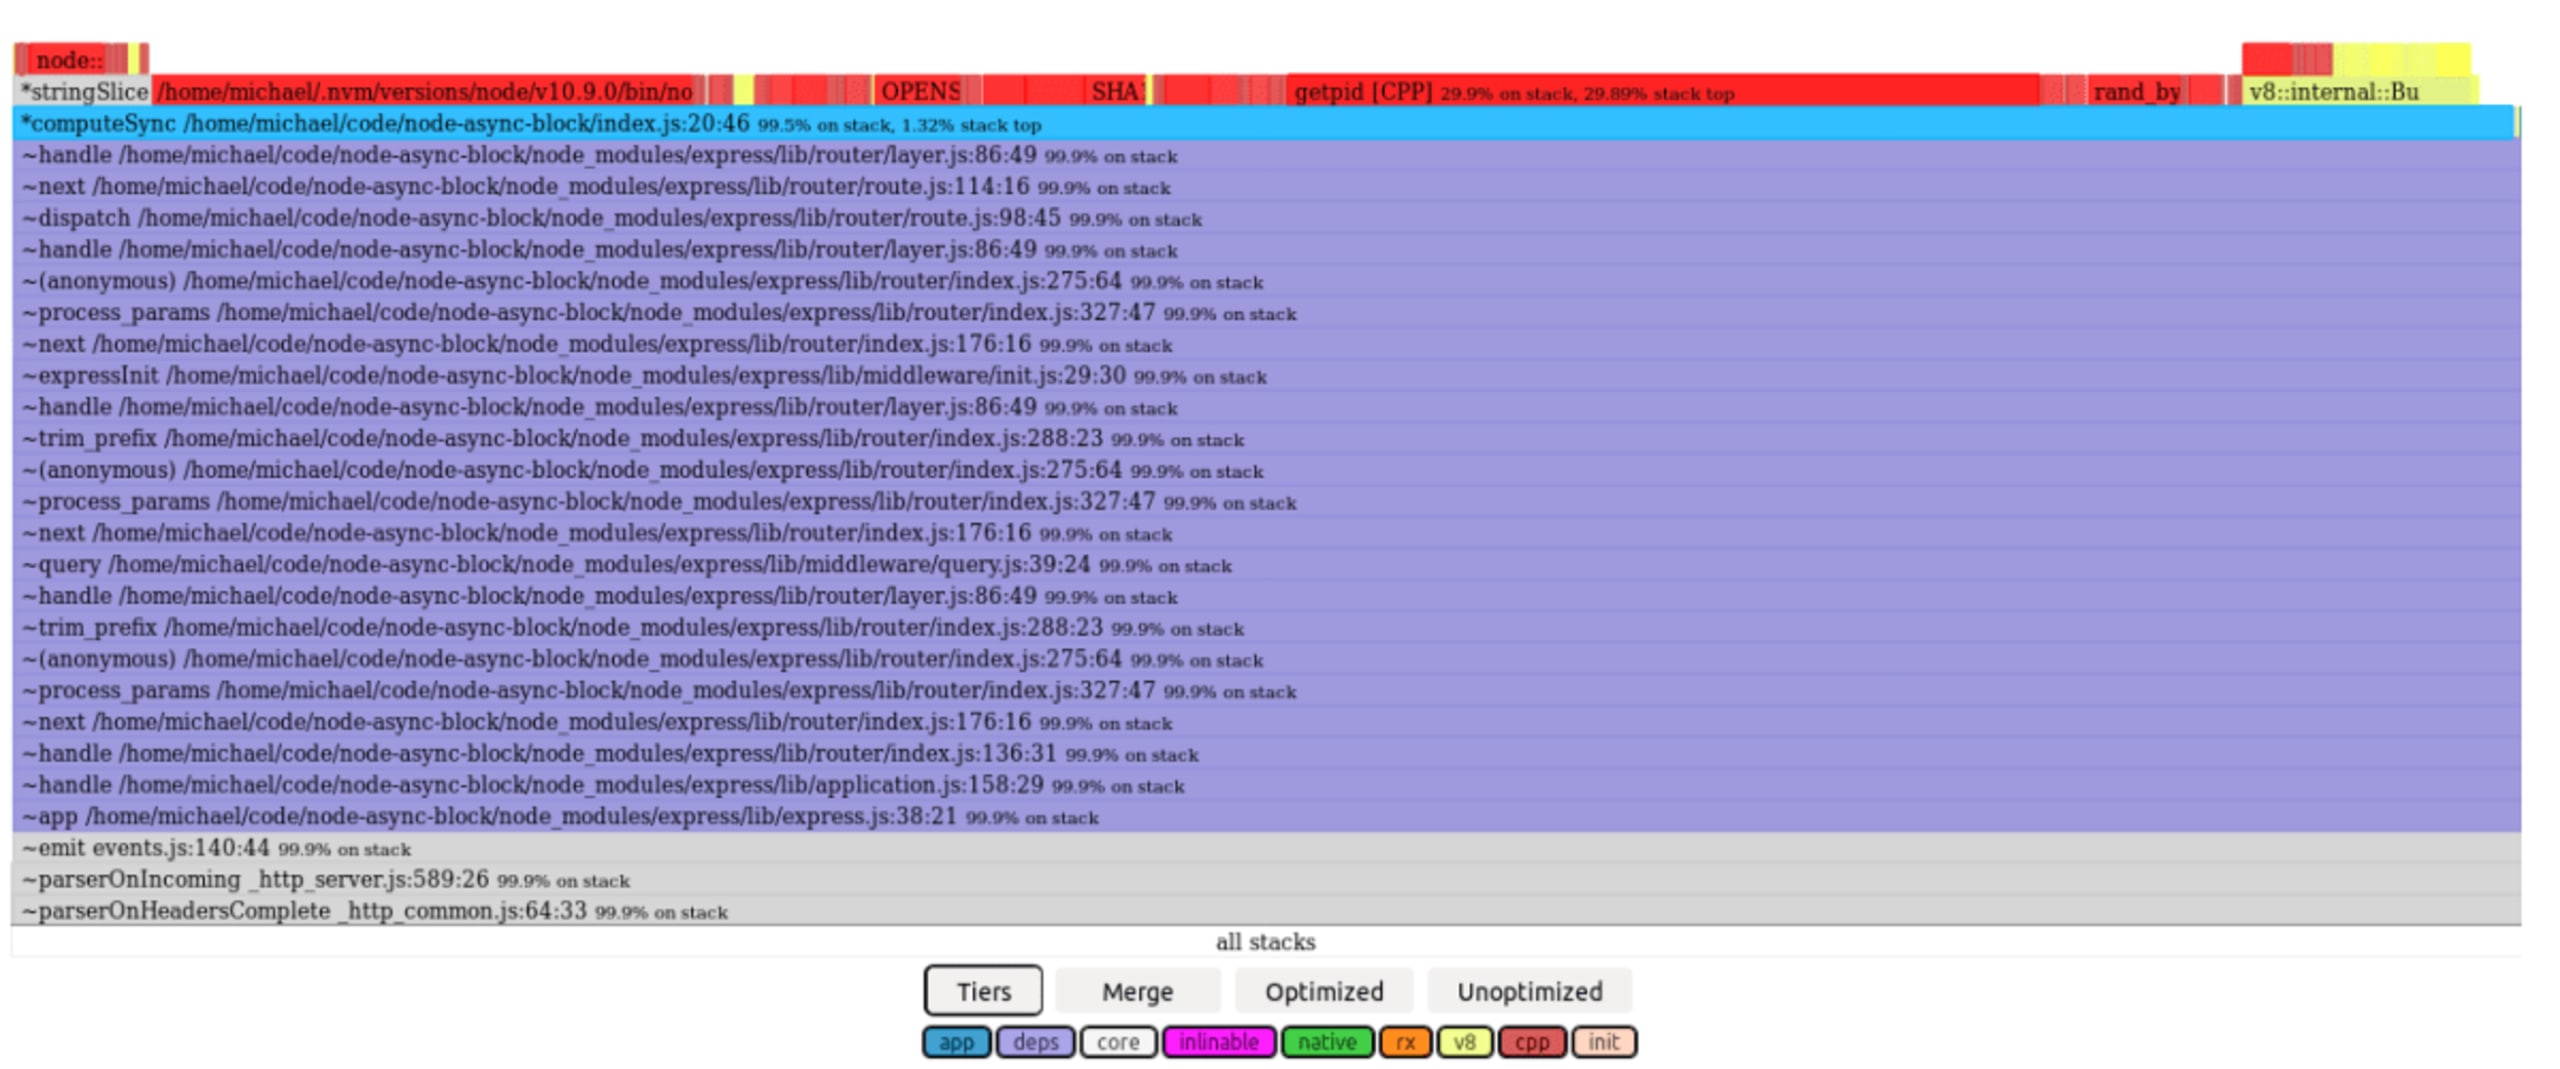
Wir sehen, dass der Stack von /compute-sync den Express-Handler-Stack umfasst, da die Ausführung zu 100 % synchron war.
Und nun der Flame-Graph, der während der Ausführung von /compute-async aufgezeichnet wurde:
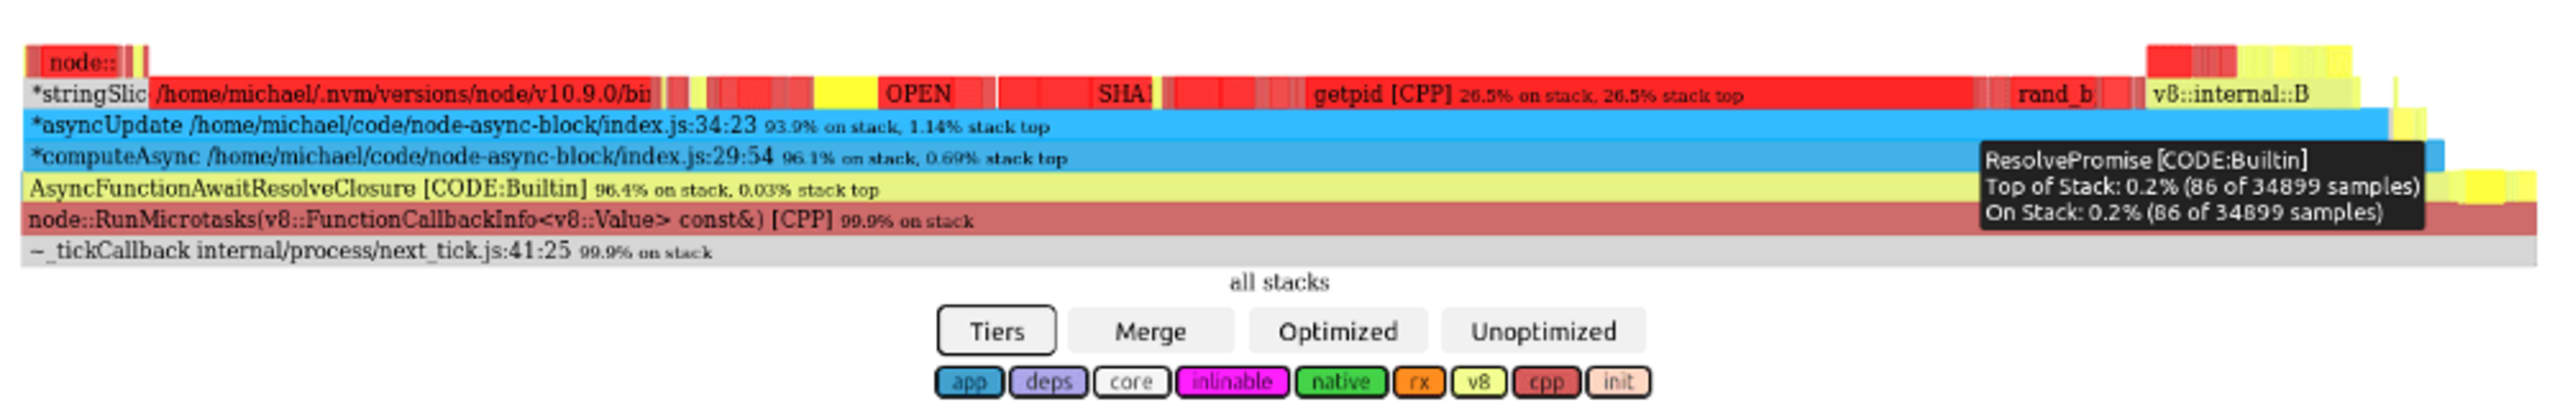
Der Flame-Graph von /compute-async sieht dagegen ganz anders aus: Die Ausführung findet im Kontext der V8-Funktionen RunMicrotask und AsyncFunctionAwaitResolveClosure statt. Also nein … es sieht nicht so aus, als wäre async/await „wegoptimiert“ worden.
Bevor wir tiefer einsteigen, probieren wir noch einen letzten, verzweifelten Trick aus, den wir Entwickler manchmal anwenden: einen Sleep-Aufruf hinzufügen!
Führen wir es aus:
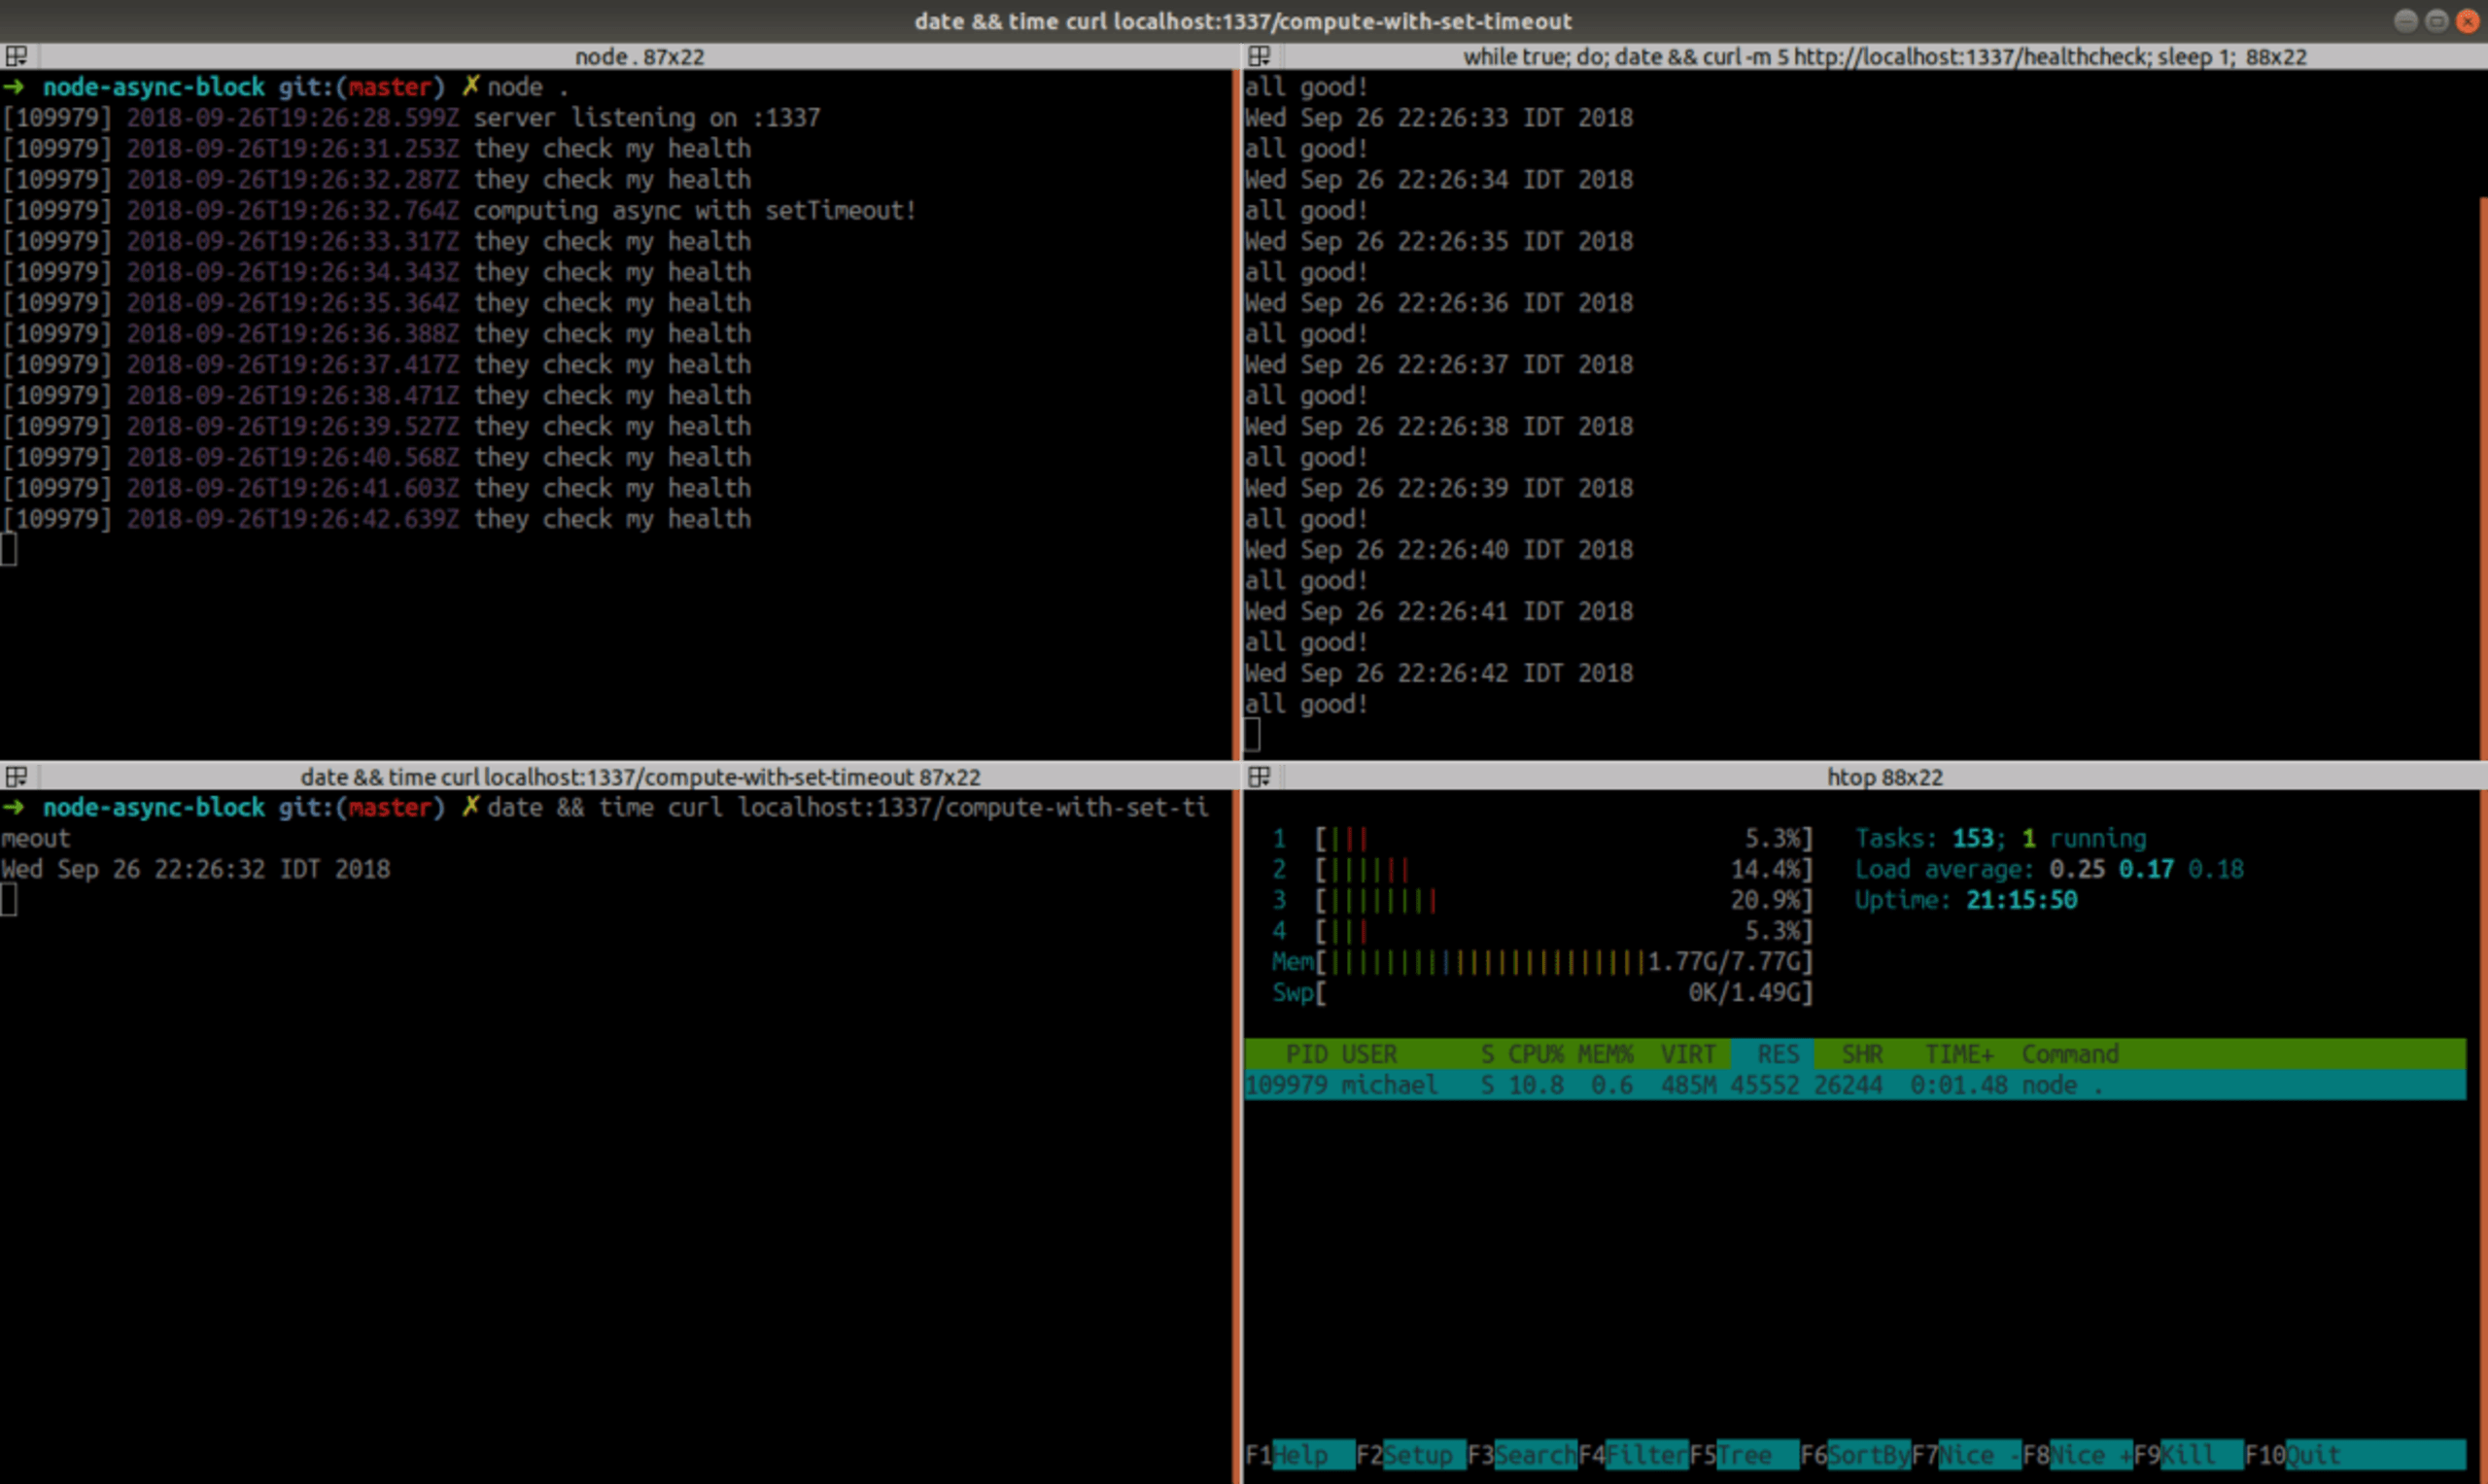
Endlich bleibt der Server während der rechenintensiven Operation erreichbar. Leider ist der Preis für diese Lösung zu hoch: Die CPU-Auslastung liegt bei etwa 10 %. Offenbar arbeitet der Prozess nicht intensiv genug an der Berechnung, die praktisch ewig dauert (ich hatte nicht genug Geduld, um das Ende abzuwarten). Erst als ich die Anzahl der Iterationen von 10⁷ auf 10⁵ reduzierte, war die Berechnung nach 2:23 Minuten abgeschlossen! (Falls Sie sich fragen: Wenn Sie als Verzögerungsparameter an setTimeout statt 0 den Wert 1 übergeben, macht das keinen Unterschied – dazu später mehr.)
Das wirft einige Fragen auf:
Warum wurde der
async-Code ohne den AufrufsetTimeout()blockiert?Warum hat
setTimeout()einen so enormen Leistungsverlust verursacht?Wie können wir die Berechnung ohne solche Einbußen entblockieren?
Phasen der Event-Loop
Als mir etwas Ähnliches passierte, suchte ich bei Google nach Antworten. Bei einer Suche nach Begriffen wie „node async block event loop“ gehört diese offizielle Node.js-Dokumentation zu den ersten Ergebnissen. Sie hat mir die Augen geöffnet.
Darin wird erklärt, dass die Event-Loop kein magischer Scheduler ist, wie ich es mir vorgestellt hatte, sondern eine ziemlich einfache Schleife mit mehreren Phasen. Hier sehen Sie ein übersichtliches ASCII-Diagramm der wichtigsten Phasen, übernommen aus dem Leitfaden:
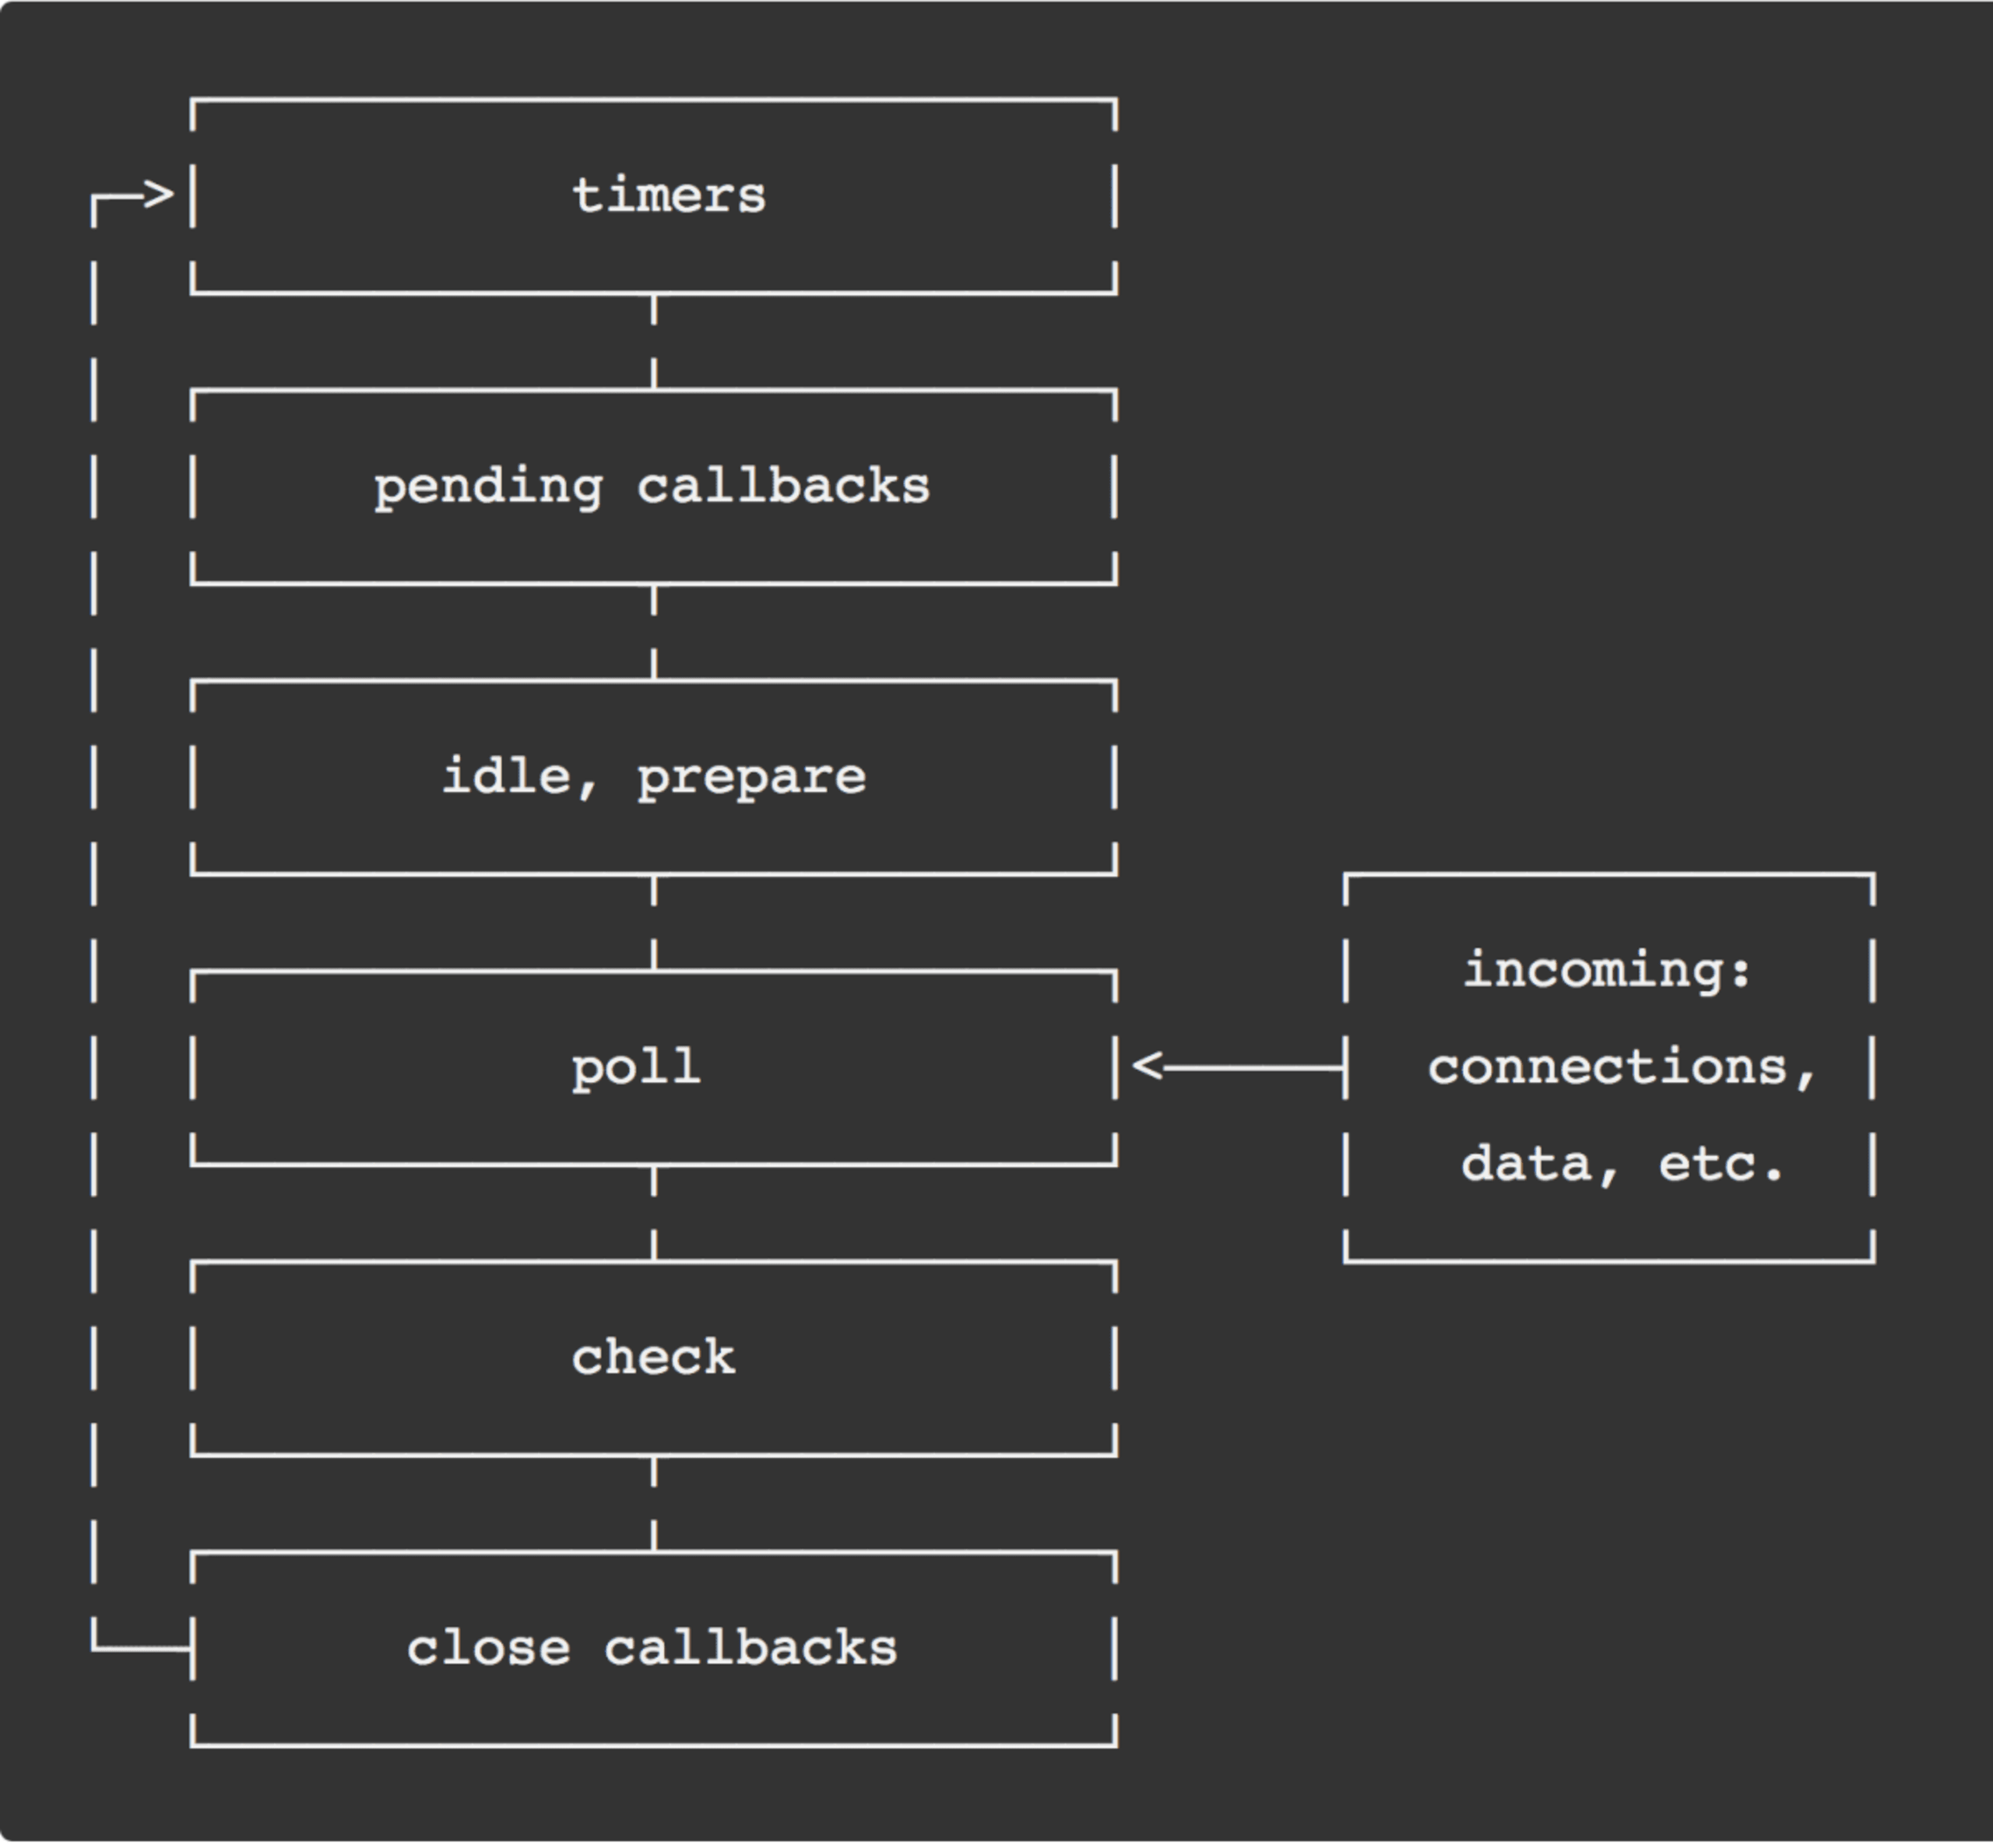
(Später habe ich herausgefunden, dass diese Schleife in libuv mit Funktionen implementiert ist, deren Namen denen im Diagramm entsprechen: https://github.com/libuv/libuv/blob/v1.22.0/src/unix/core.c#L359)
Der Leitfaden erläutert die verschiedenen Phasen und gibt folgenden Überblick:
timers: In dieser Phase werden Callbacks ausgeführt, die mit
setTimeout()undsetInterval()geplant wurden.pending callbacks: Führt I/O-Callbacks aus, die bis zur nächsten Schleifeniteration zurückgestellt wurden.
idle, prepare: Wird nur intern verwendet.
poll: Ruft neue I/O-Ereignisse ab und führt I/O-bezogene Callbacks aus.
check: Hier werden Callbacks von
setImmediate()aufgerufen.close callbacks: Einige Close-Callbacks, z. B.
socket.on('close', ...).
Dieses Zitat hilft, unsere Frage zu beantworten:
„Wenn die Event-Loop eine bestimmte Phase betritt, führt sie in der Regel die für diese Phase vorgesehenen Operationen aus und arbeitet dann die Callbacks in der Warteschlange dieser Phase ab, bis die Warteschlange leer ist … Da durch jede dieser Operationen weitere Operationen geplant werden können …“
Das deutet (wenn auch nur vage) darauf hin, dass ein Callback, der einen weiteren Callback einreiht, der in derselben Phase verarbeitet werden kann, noch vor dem Wechsel zur nächsten Phase ausgeführt wird.
Nur in der Phase poll prüft Node.js Netzwerk-Sockets auf neue Anfragen. Bedeutet das also, dass unser Code in /compute-async die Event-Loop tatsächlich daran gehindert hat, eine bestimmte Phase zu verlassen – und sie deshalb nie die Phase poll durchlaufen hat, um überhaupt die Anfrage an /healthcheck zu empfangen?
Für bessere Antworten müssen wir tiefer graben. Jetzt ist jedoch klar, warum setTimeout() geholfen hat: Jedes Mal, wenn wir einen Timer-Callback einreihen und die Warteschlange der aktuellen Phase abgearbeitet ist, muss die Event-Loop alle Phasen durchlaufen, um zur Phase „Timers“ zu gelangen. Dabei durchläuft sie auch die Phase poll und verarbeitet ausstehende Netzwerkanfragen.
Microtasks
Die Schlüsselwörter async/await, die wir in /compute-async verwendet haben, sind bekanntlich syntaktischer Zucker für Promises. Tatsächlich erstellen wir also in jeder Schleifeniteration ein Promise (einen asynchronen Vorgang), um einen Hash zu berechnen. Sobald es aufgelöst ist, fährt die Schleife mit der nächsten Iteration fort. Im erwähnten offiziellen Leitfaden wird nicht erklärt, wie Promises im Zusammenhang mit den Phasen der Event-Loop verarbeitet werden. Unsere Experimente legen jedoch nahe, dass sowohl der Promise-Callback als auch der resolve-Callback aufgerufen wurden, ohne die Phase poll zu durchlaufen.
Bei einer weiteren Google-Suche habe ich eine ausführlichere und sehr gut geschriebene fünfteilige Artikelserie von Deepal Jayasekara über die Event-Loop gefunden, die auch Informationen zur Verarbeitung von Promises enthält!
Sie enthält dieses hilfreiche Diagramm:
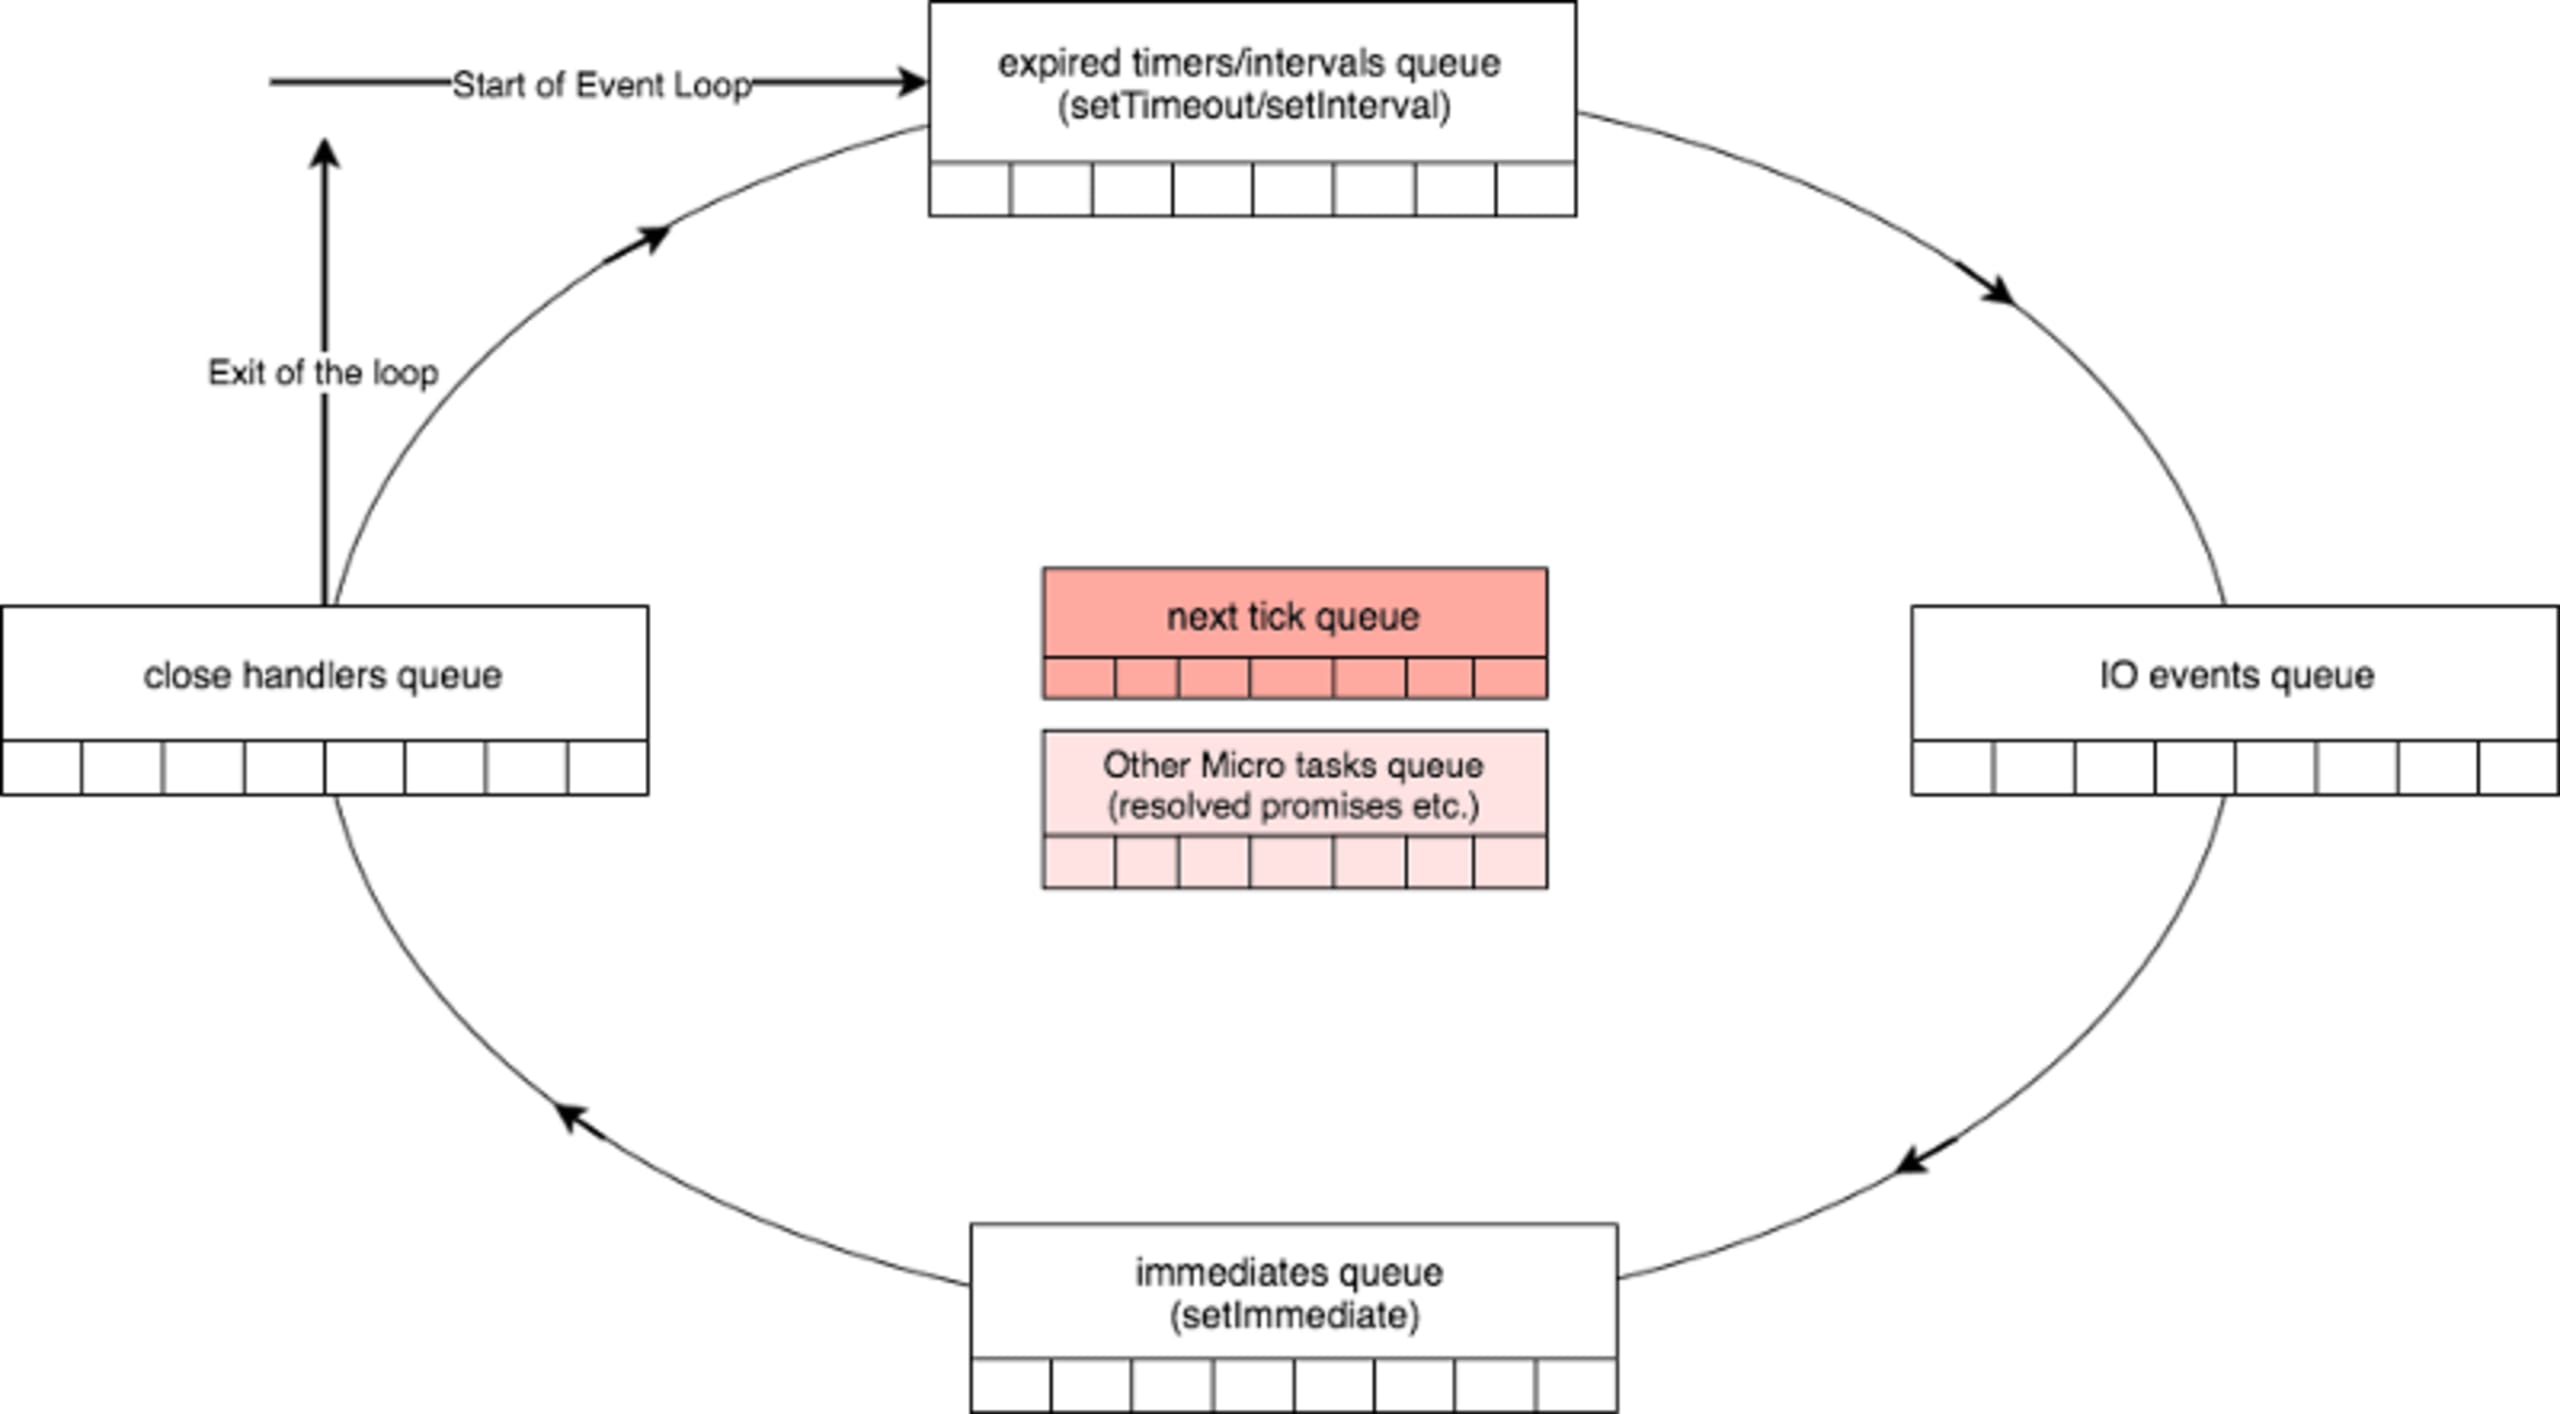
Die Kästchen um den Kreis stellen die Warteschlangen der verschiedenen Phasen dar, die wir bereits gesehen haben. Die beiden Kästchen in der Mitte stehen für zwei besondere Warteschlangen, die abgearbeitet werden müssen, bevor die Event-Loop zur nächsten Phase wechselt. Die „next tick queue“ verarbeitet Callbacks, die über nextTick() registriert wurden. Die „Other Micro Tasks queue“ beantwortet unsere Frage zu Promises.
Was passiert also wie in unserem Fall, wenn ein aufgelöstes Promise ein weiteres Promise erstellt? Wird es noch in derselben Phase verarbeitet, bevor die nächste beginnt? Wie wir gesehen haben, lautet die Antwort: Ja! Wie das funktioniert, sehen Sie im V8-Quellcode. Der Link führt zur Implementierung von RunMicrotask(). Hier sehen Sie einen Ausschnitt mit den relevanten Zeilen:
Dieser C-Code sieht ungewöhnlich aus und führt Schleifen mithilfe der magisch anmutenden, hardwarenahen Funktionen bzw. Makros Goto() und Branch() aus. Der Grund: Er wurde mit V8s „CodeStubAssembly“ geschrieben, einer „benutzerdefinierten, plattformunabhängigen Assemblersprache, die hardwarenahe Grundfunktionen als schlanke Abstraktion über Assembler bereitstellt“.
Im Gist sehen wir eine äußere Schleife mit der Bezeichnung init_queue_loop und eine innere Schleife mit der Bezeichnung loop. Die äußere Schleife prüft die tatsächliche Anzahl der ausstehenden Microtasks. Anschließend verarbeitet die innere Schleife alle Aufgaben nacheinander. Danach – wie in Zeile 62 des obigen Gists zu sehen – durchläuft sie erneut die äußere Schleife, die nochmals die tatsächliche Anzahl der ausstehenden Microtasks prüft. Nur wenn keine neuen Aufgaben hinzugekommen sind, wird die Funktion beendet.
Wenn Sie sehen möchten, wie Microtasks am Ende jeder Phase der Event-Loop verarbeitet werden, empfehle ich Ihnen einen weiteren großartigen Artikel von Deepal Jayasekara.
(Übrigens: Erinnern Sie sich an den Flame-Graph, den wir für /compute-async erstellt haben? Wenn Sie nach oben scrollen und ihn sich noch einmal ansehen, erkennen Sie RunMicrotasks() im Stack.)
Beachten Sie außerdem, dass Microtasks eine V8-Funktion sind und somit auch für Chrome relevant sind. Dort werden Promises genauso verarbeitet – ohne die Event-Loop des Browsers zu durchlaufen.
nextTick() lässt die Event-Loop nicht weiterticken
In der Node.js-Dokumentation heißt es:
Callbacks, die an
process.nextTick()übergeben werden, werden aufgelöst, bevor die Event-Loop fortgesetzt wird. Das kann problematisch sein, denn so lässt sich die I/O-Verarbeitung „aushungern“, indem rekursivprocess.nextTick()-Aufrufe ausgeführt werden.
Diesmal ist die Erklärung im Text ziemlich eindeutig, deshalb erspare ich Ihnen einen weiteren Screenshot aus dem Terminal. Sie können es aber selbst ausprobieren, indem Sie in node async block GET /compute-with-next-tick ausführen.
Die nextTick-Warteschlange wird hier verarbeitet.
Es ist klar: Wenn callback ein weiteres process.nextTick() aufruft, verarbeitet die Schleife den nächsten Callback in derselben Schleife und wird erst beendet, wenn die nextTick-Warteschlange leer ist.
Rettung durch setImmediate()?
Promises sind also rot, Timer blau – was können wir sonst noch tun?
In den obigen Diagrammen wird jeweils die setImmediate()-Warteschlange erwähnt, die während der Phase „check“ direkt nach der Phase „poll“ verarbeitet wird. Auch in der offiziellen Node.js-Dokumentation heißt es:
setImmediate()undsetTimeout()sind ähnlich, verhalten sich aber je nach Zeitpunkt ihres Aufrufs unterschiedlich …
Der wichtigste Vorteil von
setImmediate()gegenübersetTimeout()ist: WirdsetImmediate()innerhalb eines I/O-Zyklus geplant, wird es immer vor allen Timern ausgeführt – unabhängig davon, wie viele Timer vorhanden sind.
Klingt gut, aber das vielversprechendste Zitat lautet:
Wenn die Phase poll inaktiv wird und Skripts mit
setImmediate()in die Warteschlange gestellt wurden, kann die Event-Loop zur Phase check wechseln, anstatt zu warten.
Erinnern Sie sich daran, dass der Prozess bei Verwendung von setTimeout() größtenteils inaktiv war (also wartete) und etwa 10 % CPU nutzte? Sehen wir, ob setImmediate() das Problem löst:
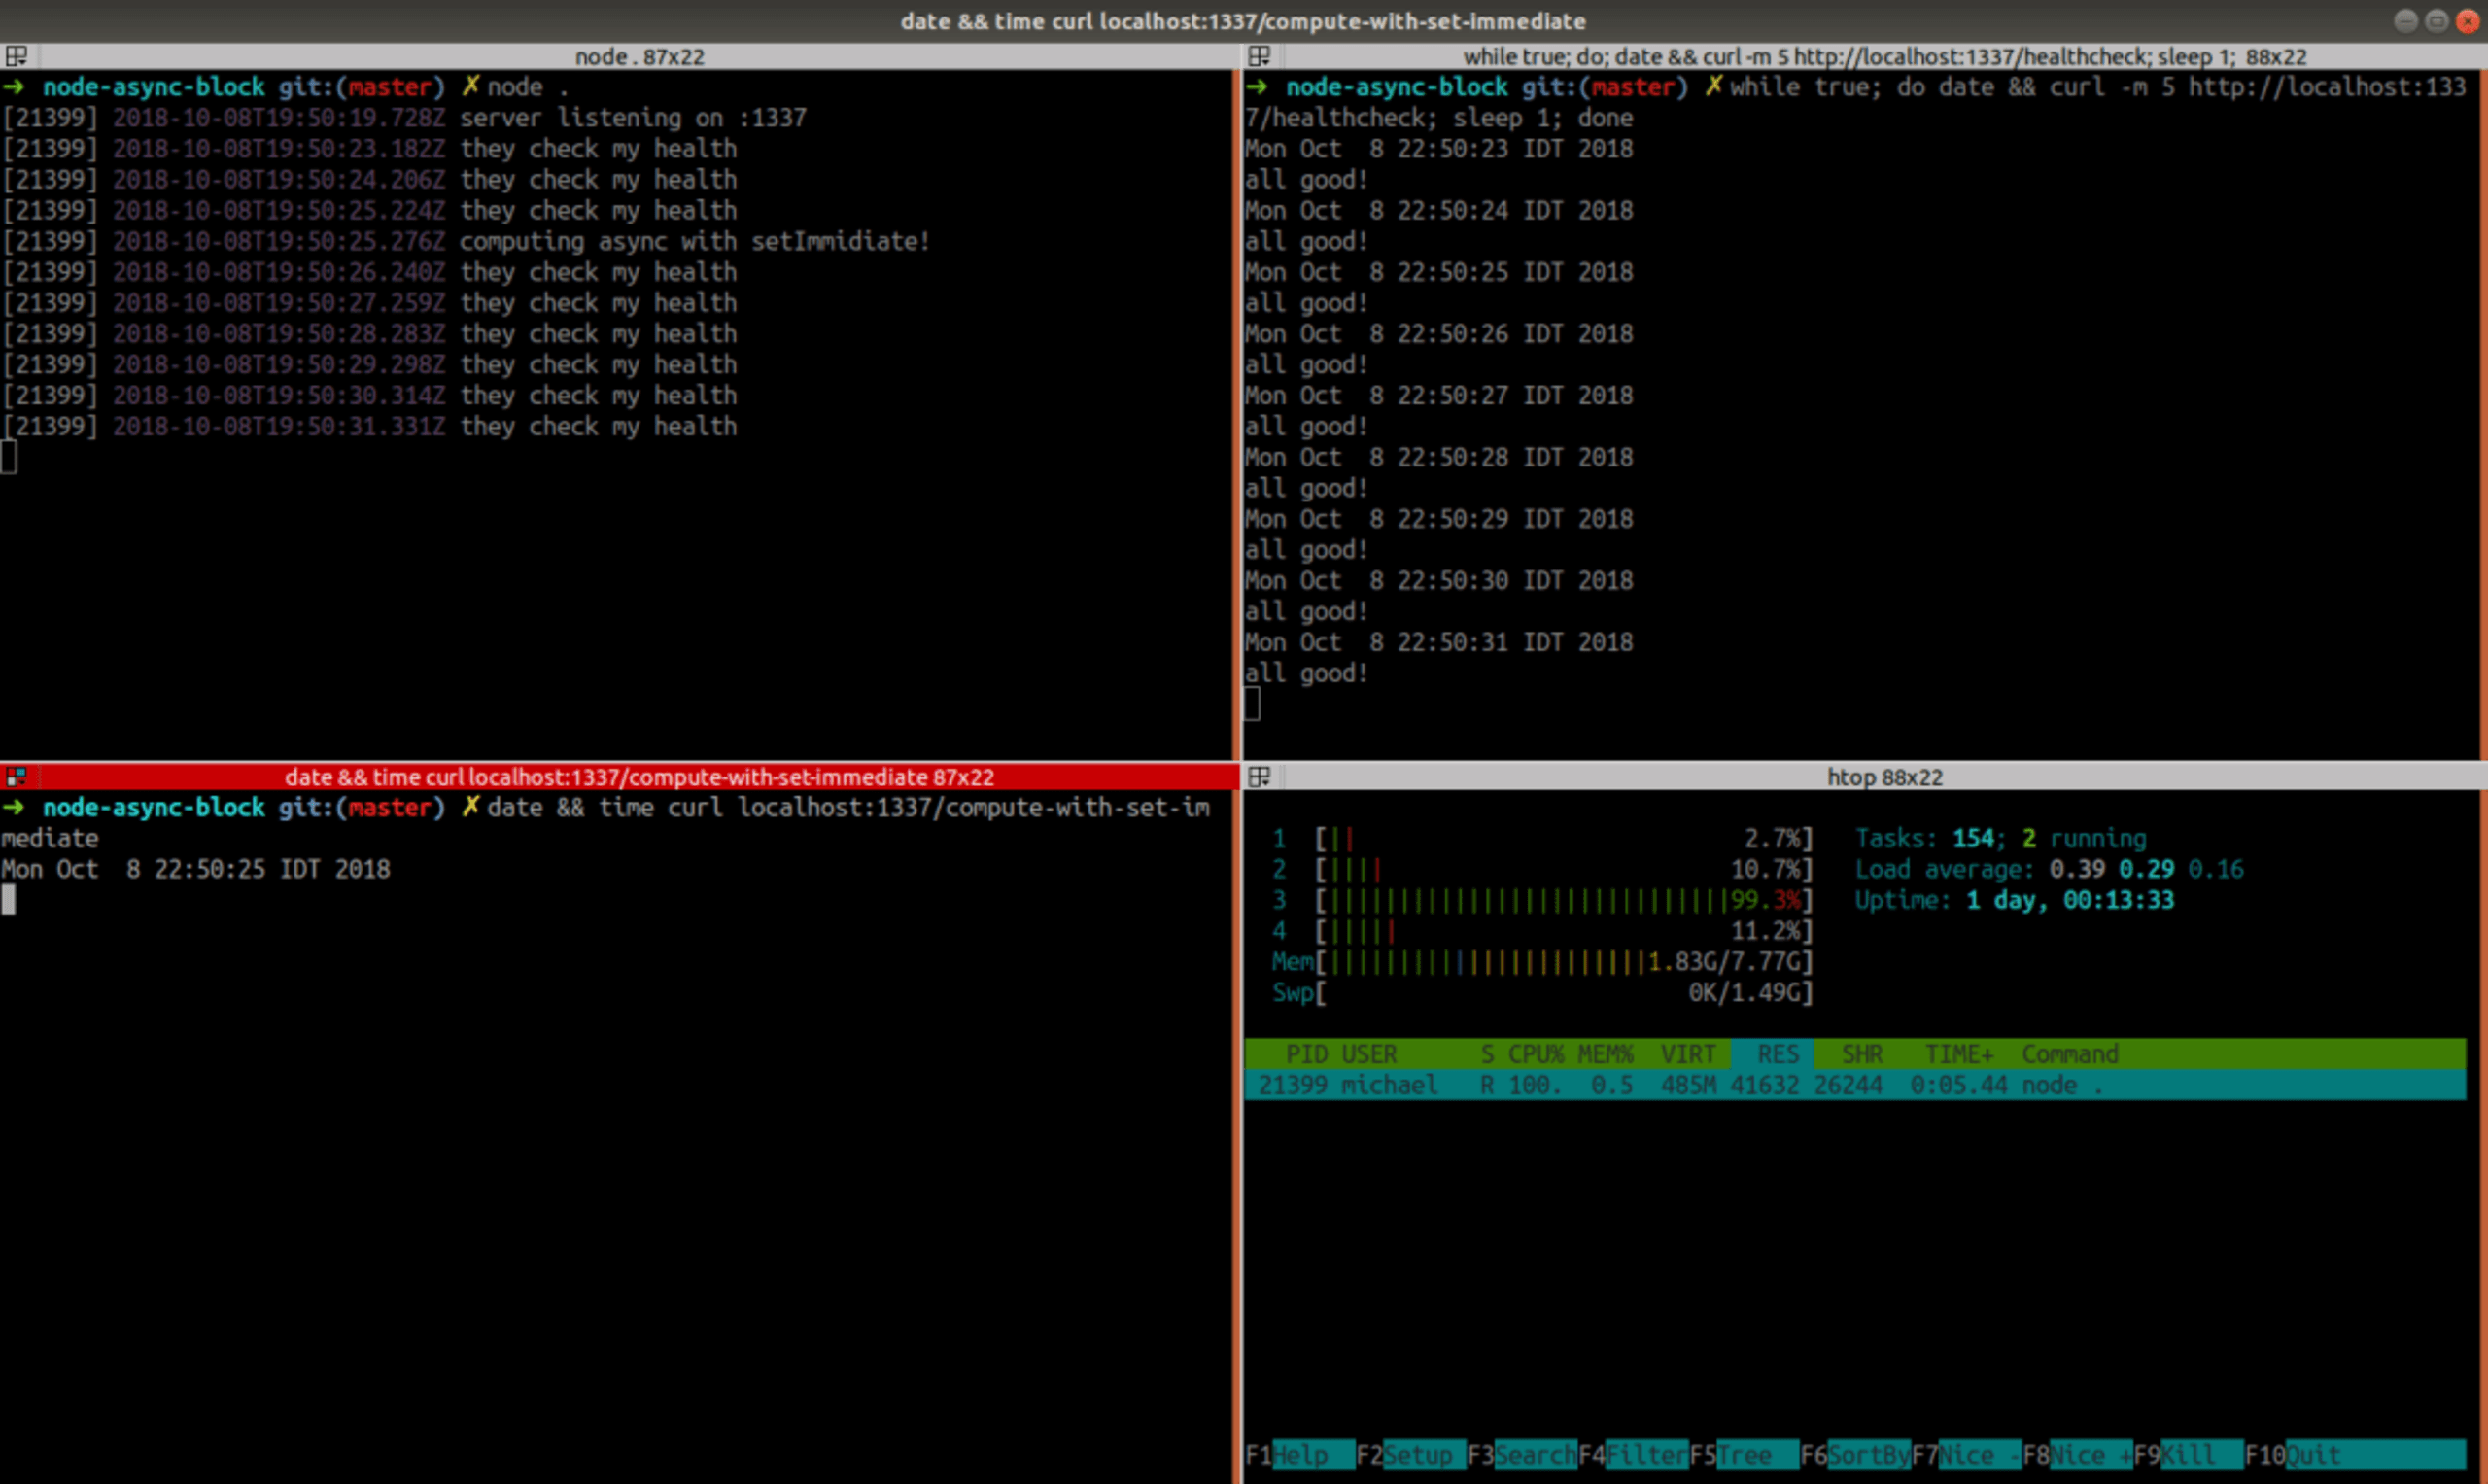
Hurra! Der Server wird nicht blockiert und die CPU ist zu 100 % ausgelastet! Sehen wir uns an, wie lange der Vorgang dauert:
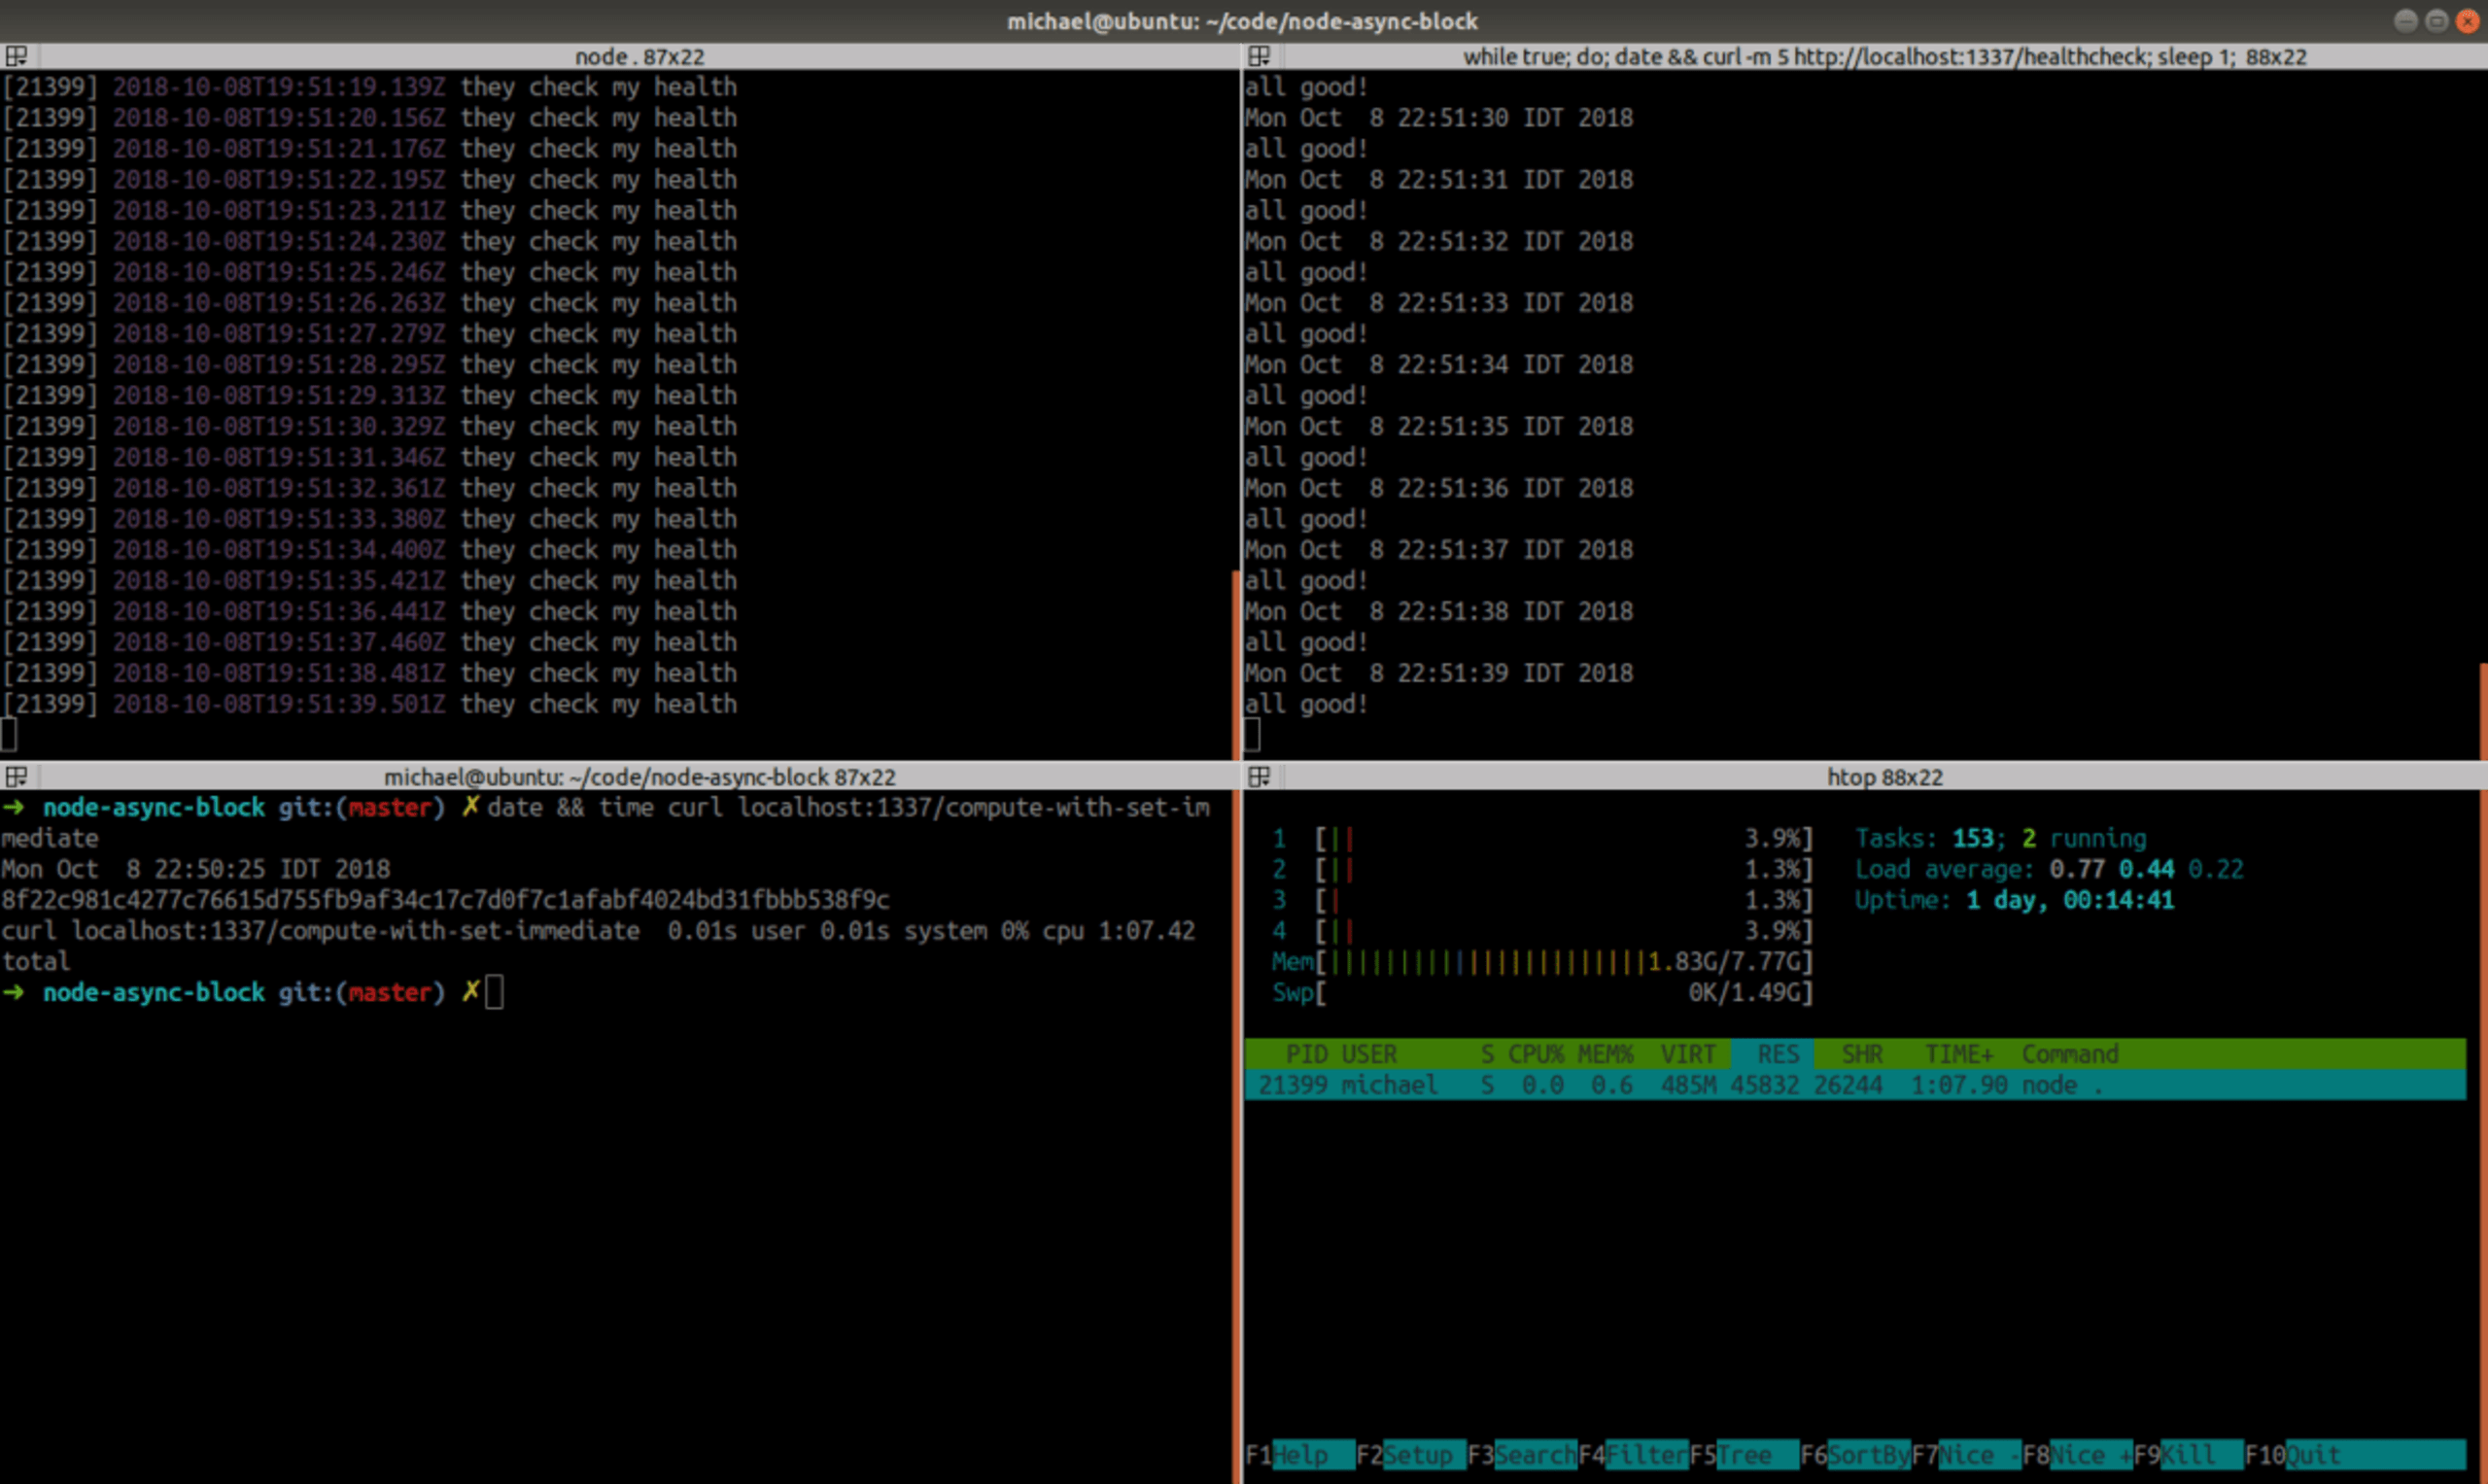
Na ja, gut. Der Vorgang war nach 1:07 Minuten abgeschlossen, etwa 50 % länger als /compute-sync und 34 % länger als /compute-async – aber nutzbar, anders als /compute-with-set-timeout. Da es sich um ein Spielzeugbeispiel handelt, bei dem wir in jeder der 10⁷ winzigen Iterationen setImmediate() verwendet haben, was wahrscheinlich zu 10⁷ vollständigen Event-Loop-Durchläufen geführt hat, ist diese Verlangsamung gut nachvollziehbar. Führt das Planen eines setImmediate() in einem setImmediate()-Callback also nicht dazu, dass der Callback in derselben Phase bleibt? Genau, die Node.js-Dokumentation sagt eindeutig:
Wird ein Immediate-Timer innerhalb eines gerade ausgeführten Callbacks in die Warteschlange gestellt, wird er erst beim nächsten Event-Loop-Durchlauf ausgelöst.
Zum Vergleich von setImmediate() und process.nextTick() heißt es im Node.js-Leitfaden:
Wir empfehlen Entwicklern, in allen Fällen
setImmediate()zu verwenden …
Sie wurden bereits mit Codeverweisen verwöhnt. Damit ich Sie nicht enttäusche: Ich glaube, dies ist der Code, der die setImmediate()-Callbacks tatsächlich ausführt. Übrigens: Eine interessante Tatsache aus Teil 3 von Deepals Reihe ist, dass die beliebte, nicht native Bluebird-Promise-Bibliothek setImmediate() verwendet, um Promise-Callbacks zu planen.
Abschließende Gedanken
(Fast – als Bonus folgt noch ein Abschnitt zu setTimeout() ) setImmediate() scheint also eine praktikable Lösung zu sein, um lang laufenden synchronen Code in Abschnitte aufzuteilen. Das ist jedoch nicht immer einfach umzusetzen – und richtig umzusetzen. Jeder Übergang zu setImmediate() verursacht natürlich einen gewissen Overhead. Je mehr Anfragen ausstehen, desto länger dauert es, bis die lang laufende Aufgabe abgeschlossen ist. Eine zu starke Aufteilung des Codes ist also problematisch, während eine zu geringe Aufteilung den Vorgang zu lange blockieren kann. In manchen Fällen besteht der blockierende Code nicht aus einer einfachen Schleife wie in unserem Beispiel, sondern aus einer Rekursion, die eine komplexe Struktur durchläuft. Dann ist es schwieriger, die richtige Stelle und Bedingung für den Übergang zu finden. Für manche Fälle könnte es sinnvoll sein, zu erfassen, wie lange die Blockierung dauert, bevor zu setImmediate() übergegangen wird. Dieses Snippet gibt die Kontrolle nur ab, wenn seit dem letzten Übergang mindestens 10 ms vergangen sind:
In anderen Fällen kann Code von Drittanbietern, den Sie weniger gut kontrollieren können, blockieren – sogar integrierte Funktionen wie JSON.parse().
Eine drastischere Lösung besteht darin, potenziell blockierenden Code an einen anderen (nicht auf Node.js basierenden) Dienst, an Unterprozesse (über Pakete wie tiny-worker) oder an echte Threads auszulagern, etwa über Pakete wie webworker-threads oder die (noch experimentelle) integrierte Node.js-worker-threads-Lösung. In vielen Fällen ist das die richtige Lösung. All diese Ansätze zur Auslagerung bringen jedoch die Hürde mit sich, serialisierte Daten hin und her zu übertragen, da der ausgelagerte Code nicht auf den Kontext des Hauptthreads (und einzigen) JS-Threads zugreifen kann.
Eine häufige Herausforderung all dieser Lösungen: Die Verantwortung dafür, Blockierungen zu vermeiden, liegt bei jedem einzelnen Entwickler und nicht beim Betriebssystem wie bei den meisten Programmiersprachen mit Threads oder bei der Laufzeit-VM wie bei Erlang. Es ist nicht nur schwierig sicherzustellen, dass sich alle Entwickler dessen stets bewusst sind – oft ist es auch nicht optimal, die Kontrolle explizit im Code abzugeben, dem der Kontext und der Überblick über andere ausstehende Routinen und E/A-Vorgänge fehlen.
Der hohe Durchsatz, den Node.js ermöglicht, kann bei unvorsichtiger Nutzung dazu führen, dass sich zahlreiche ausstehende Anfragen aufgrund einer einzigen blockierenden Operation anstellen. Damit der Load-Balancer möglichst schnell erfährt, dass ein Server eine lange Warteschlange verzögerter Anfragen hat, und Anfragen an andere Knoten weiterleiten kann, können Sie in Ihren Health-Check-Endpunkten Pakete wie toobusy-js verwenden (während der tatsächlichen Blockierung hilft das allerdings nicht …). Wichtig ist außerdem, den Event-Loop zur Laufzeit zu überwachen – mit Paketen wie blocked-at oder Lösungen wie N|Solid und New-Relic.
Bonus: Warum die 0 in setTimeout(0) nicht wirklich 0 ist
Ich wollte unbedingt wissen, warum setTimeout(0) den Prozess zu 90 % im Leerlauf hielt, anstatt unsere Berechnung auszuführen. Eine inaktive CPU bedeutet vermutlich, dass der Hauptthread von node einen Systemaufruf ausgelöst hat, der die Ausführung lange genug angehalten (also schlafen gelegt) hat, bis der Kernel ihn wieder zur Ausführung einplante. Das deutet auf unser setTimeout() hin.
Wenn man den Quellcode von libuv zur Timer-Verarbeitung liest, scheint das tatsächliche „Schlafen“ in uv__io_poll() stattzufinden – als Teil des poll()-Systemaufrufs über dessen timeout-Parameter.
Auf der Manpage von poll() steht:
Das Argument
timeoutgibt die Anzahl der Millisekunden an, die poll() blockieren soll, während auf die Bereitschaft eines Dateideskriptors gewartet wird … Ein negativer Wert fürtimeoutbedeutet eine unbegrenzte Wartezeit. Eintimeoutvon null bewirkt, dass poll() sofort zurückkehrt.
Der Prozess schläft also, sofern das Timeout nicht genau 0 beträgt. Wir vermuten, dass das tatsächliche Timeout, das an poll() übergeben wird, größer ist, obwohl wir setTimeout() 0 übergeben. Das können wir überprüfen, indem wir node selbst mit gdb debuggen.
Mit dem Befehl dprintf von gdb können wir alle Aufrufe von uv__io_poll() nachverfolgen:
Geben wir bei jeder Ablaufverfolgung auch die aktuelle Uhrzeit aus:
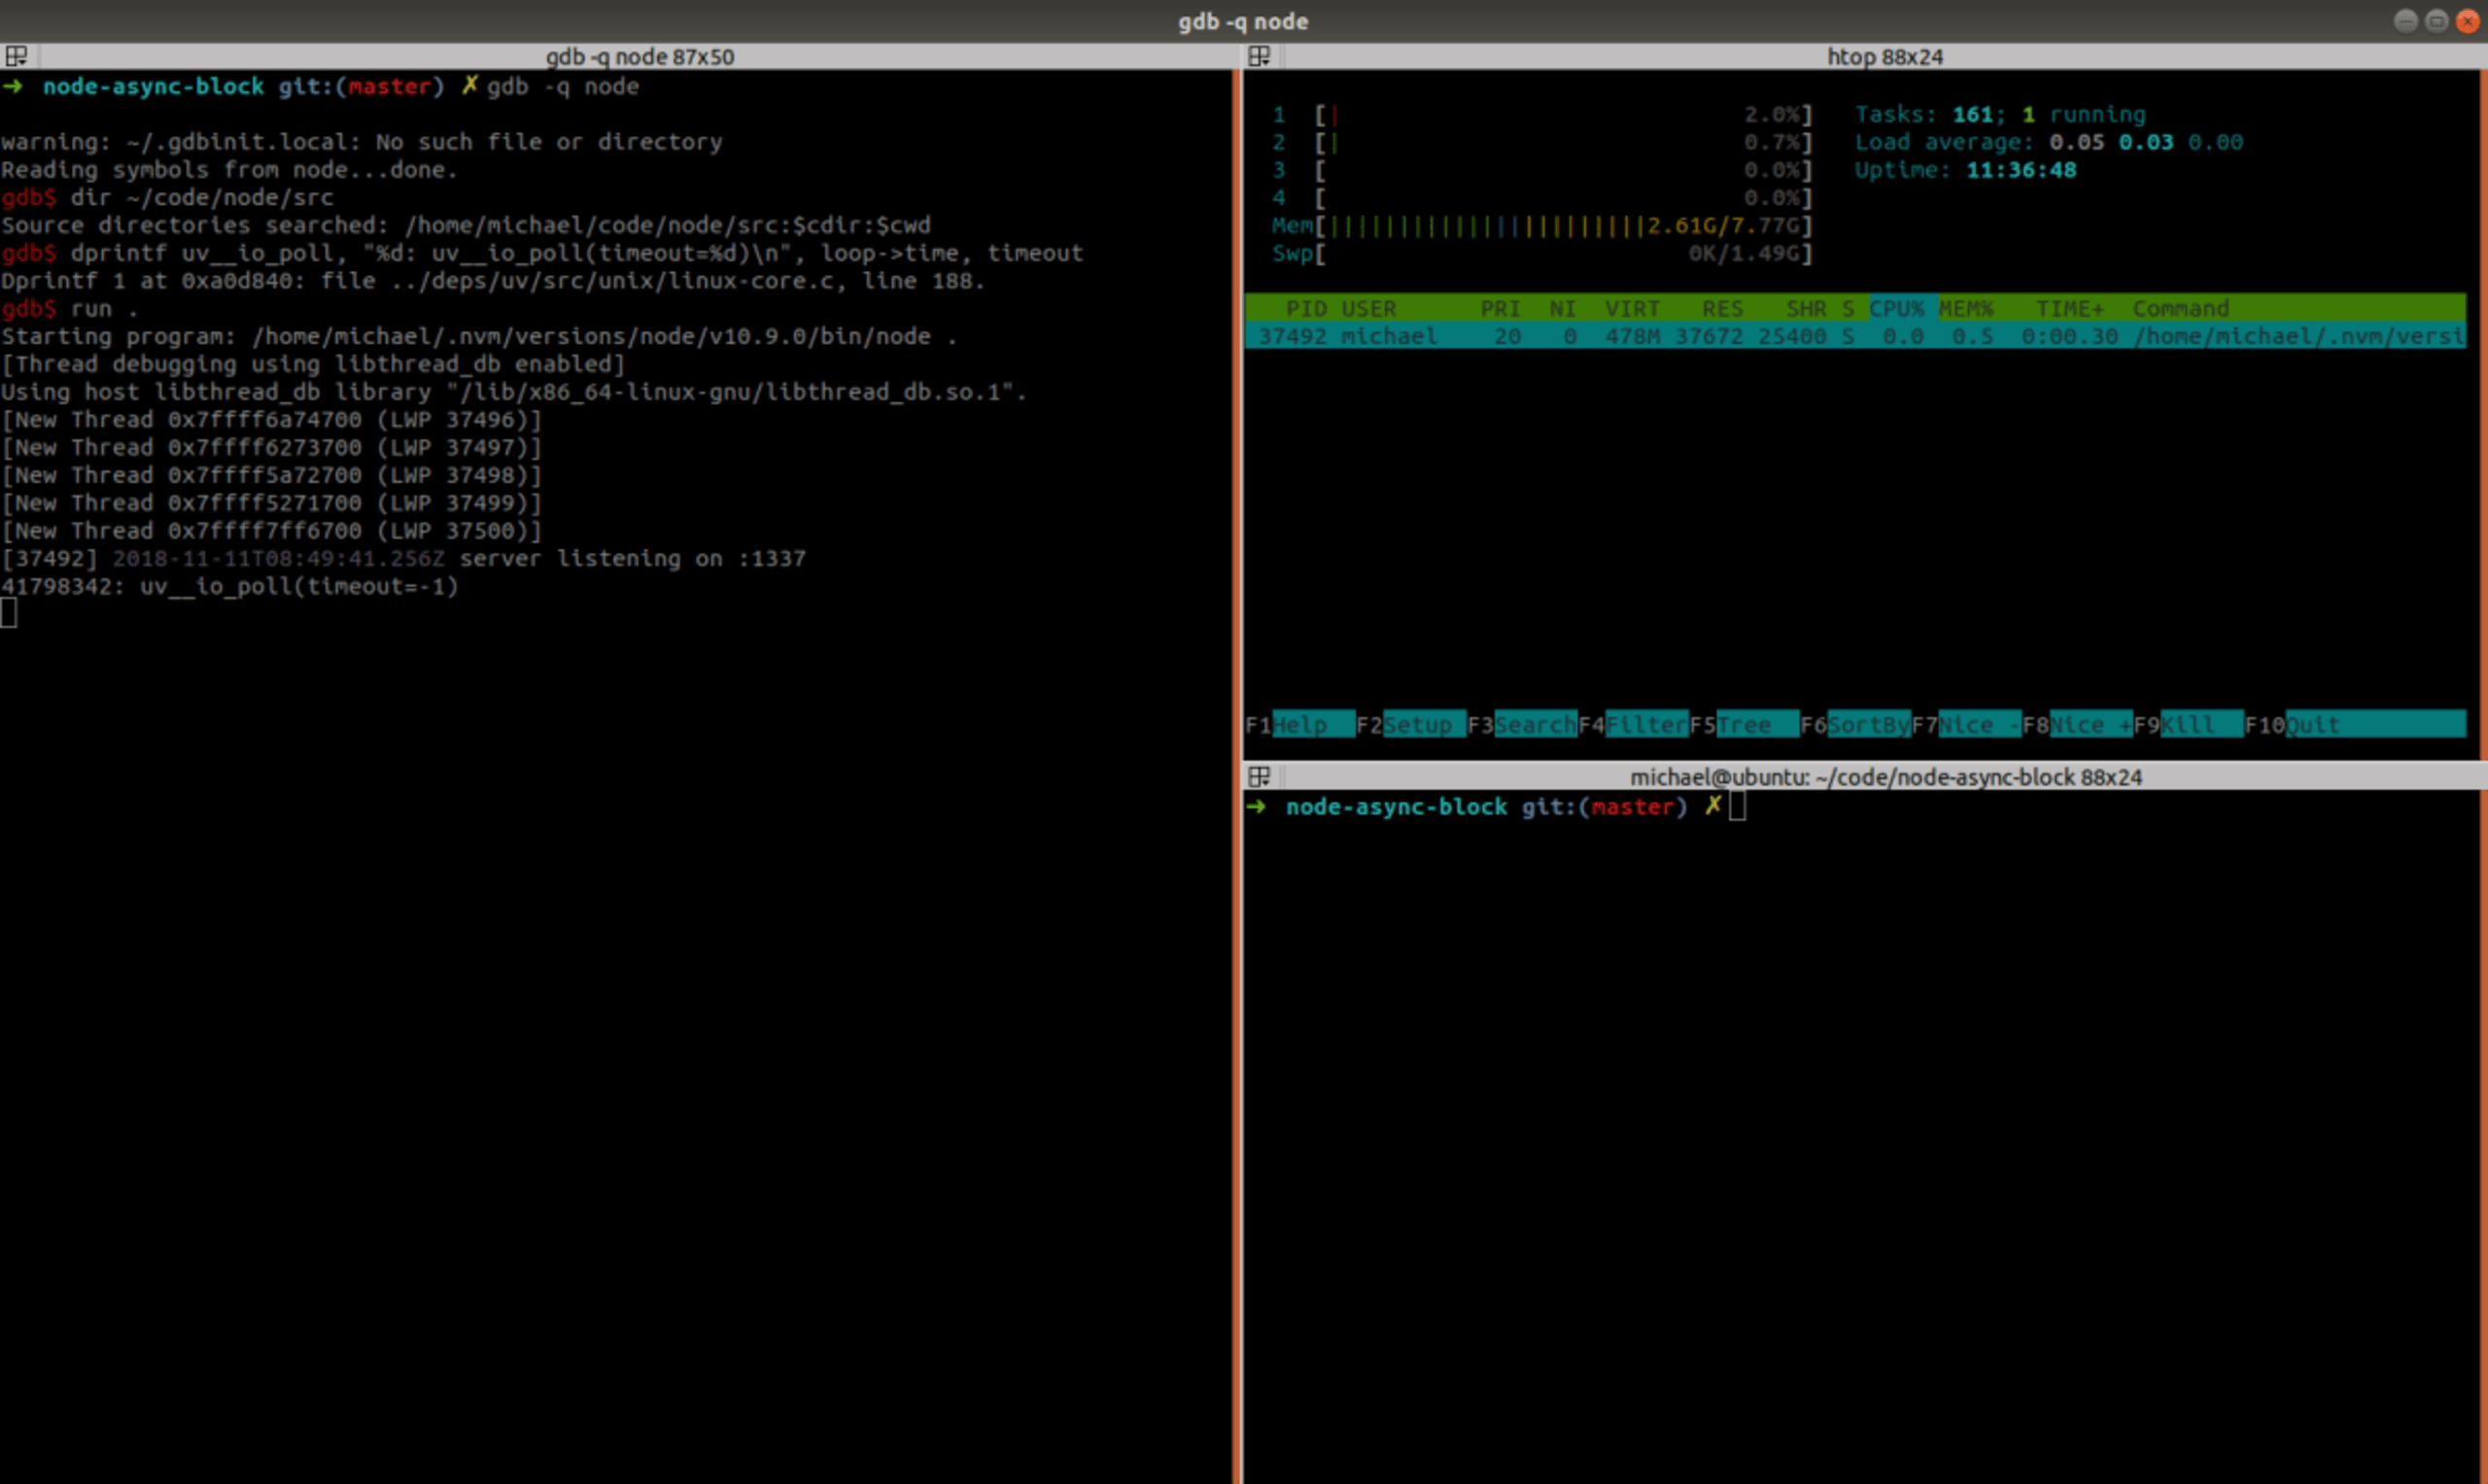
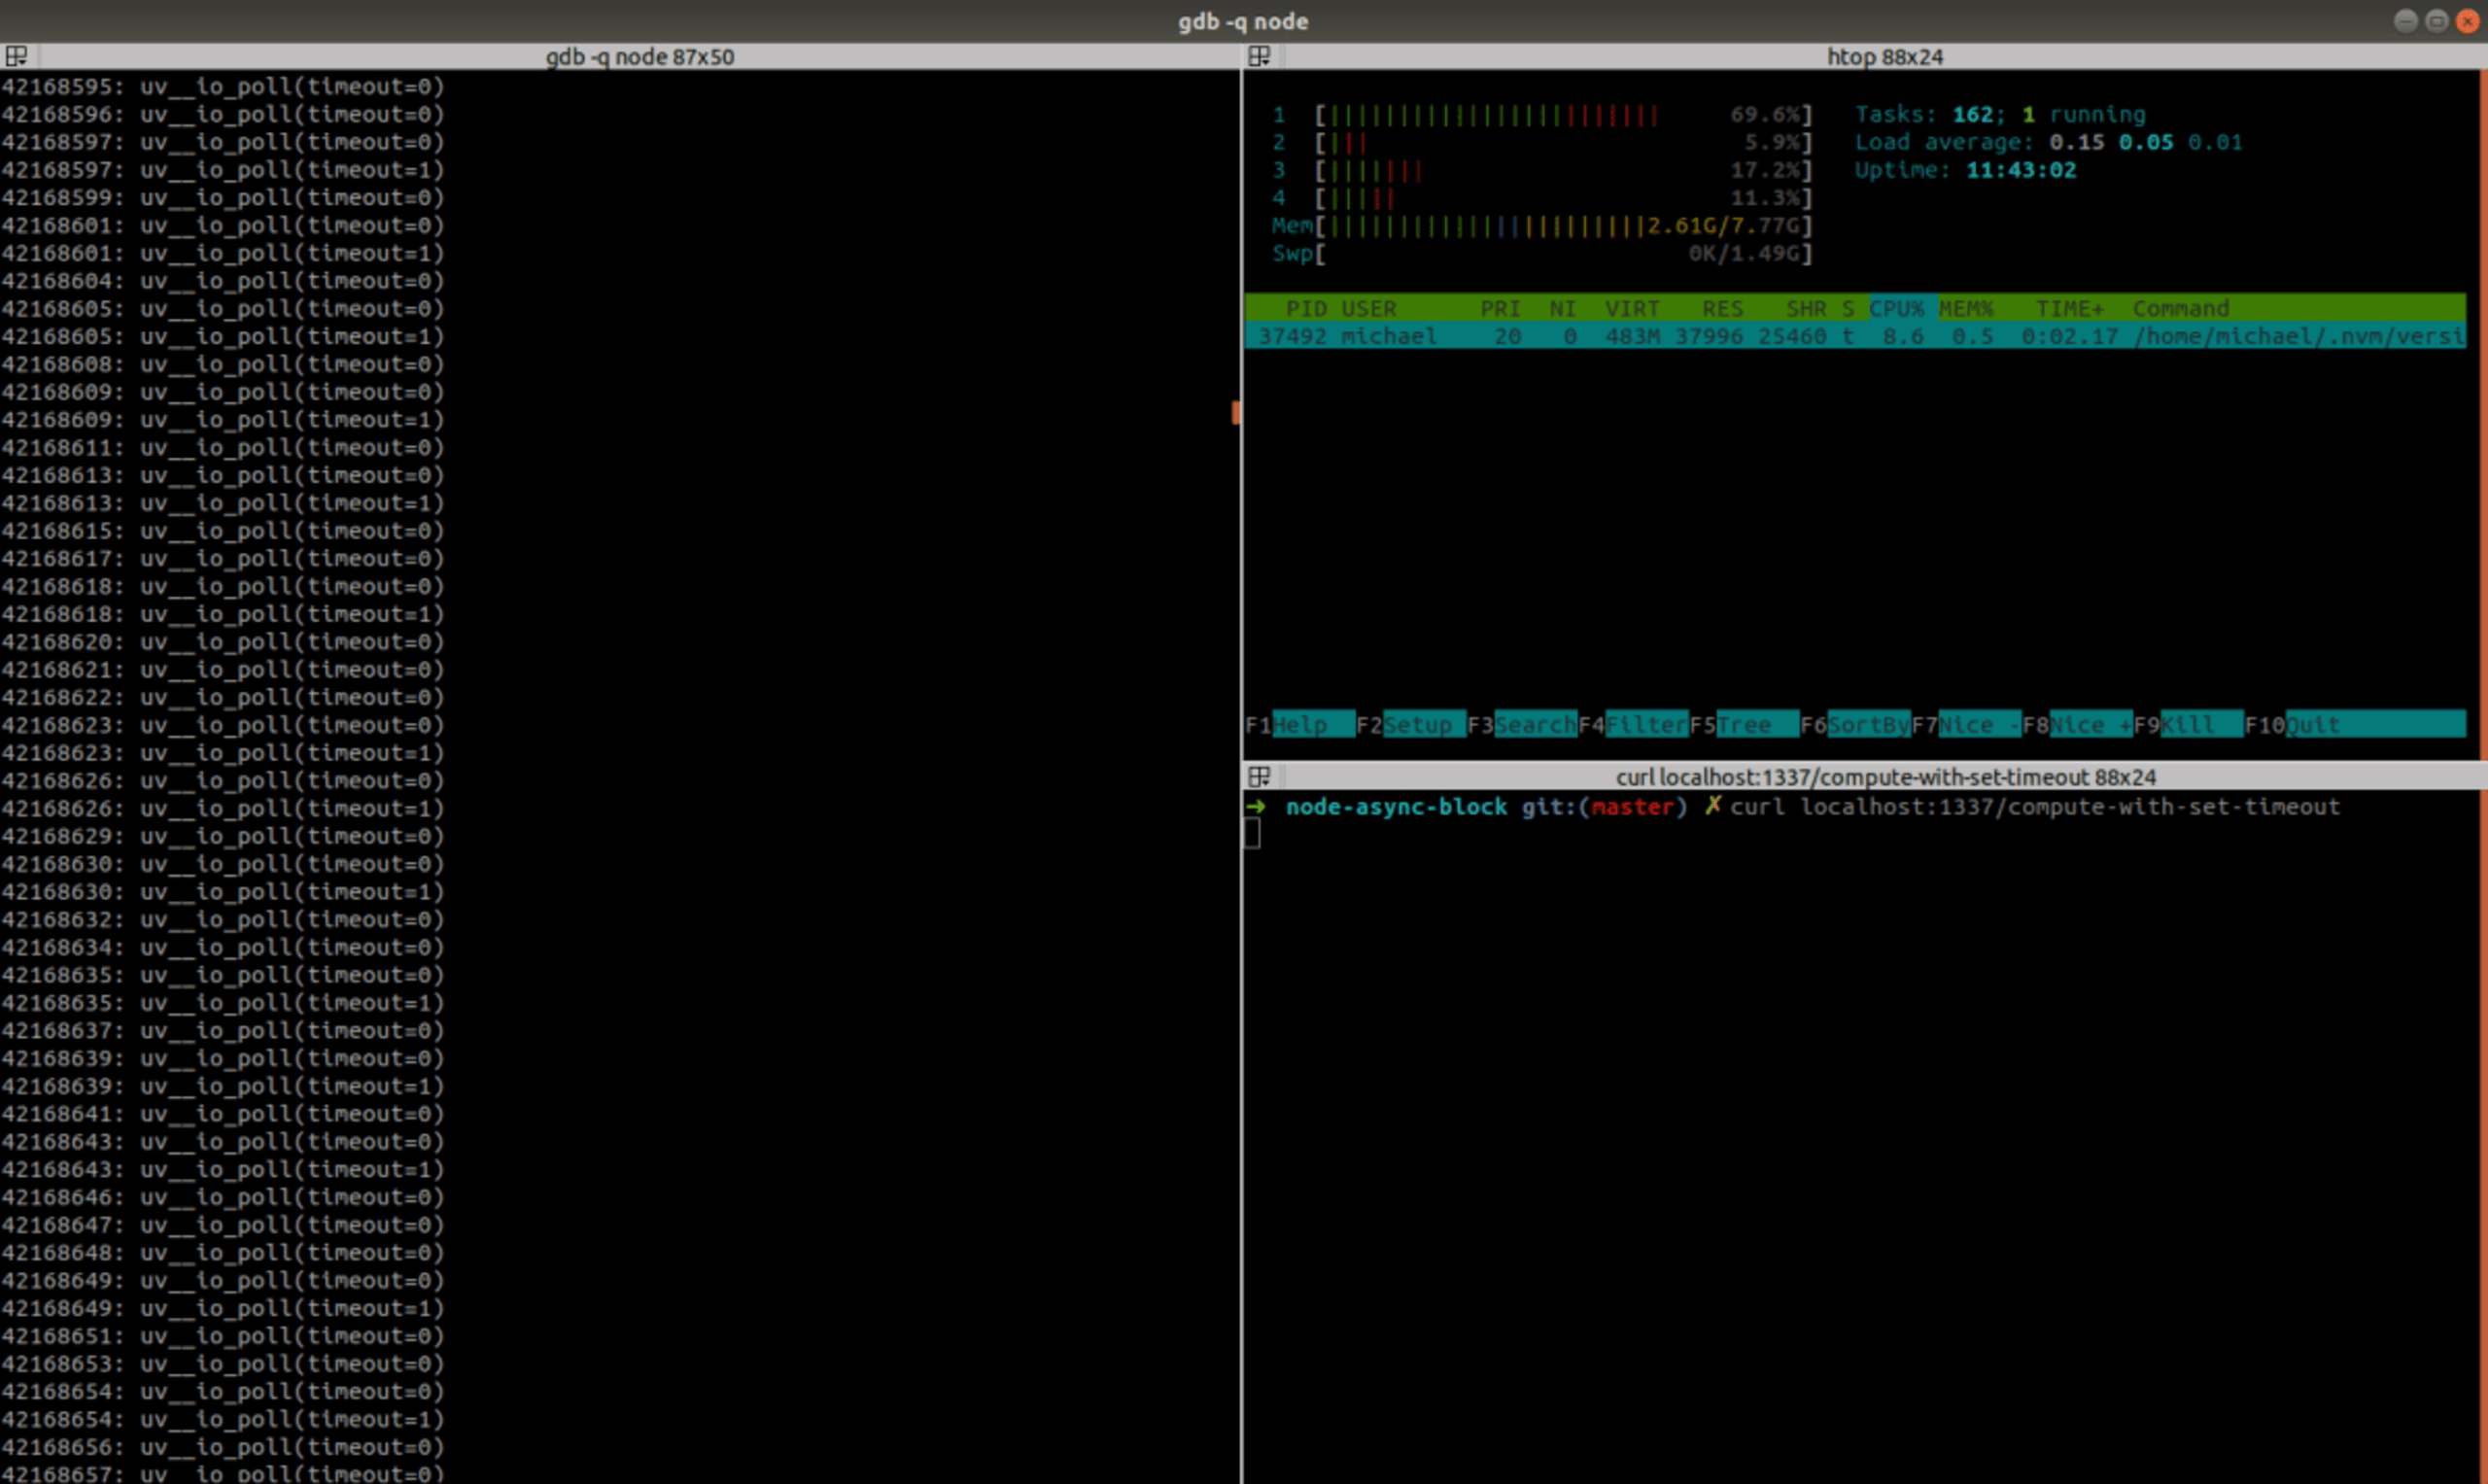
Beim Start unseres Servers wird uv__io_poll() mit einem Timeout von -1 aufgerufen, was „unbegrenztes Timeout“ bedeutet – denn außer auf eine HTTP-Anfrage zu warten, hat der Server nichts zu tun. Rufen wir nun den Endpunkt /compute-with-set-timeout mit GET auf:
Wie wir sehen, beträgt das Timeout manchmal 1. Und selbst wenn es 0 beträgt, vergeht zwischen zwei aufeinanderfolgenden Aufrufen in der Regel mindestens 1 ms. Wenn wir auf dieselbe Weise debuggen und GET an /compute-with-set-immediate senden, wird immer timeout=0 angezeigt.
Für eine CPU ist 1 Millisekunde eine lange Zeit. Die enge Schleife unter /compute-sync hat 10⁷ Iterationen in 43 Sekunden abgeschlossen. Das entspricht etwa 233 zufälligen Hash-Berechnungen pro Millisekunde. Bei einer Wartezeit von 1 ms pro Iteration würde die Wartezeit insgesamt 10.000 Sekunden betragen – also 2 Stunden und 45 Minuten!
Versuchen wir herauszufinden, warum das an uv__io_poll() übergebene Timeout nicht 0 ist. Das Timeout wird in uv_backend_timeout() berechnet und dann an uv__io_poll() weitergegeben, wie sich in der Hauptschleife von libuv sehen lässt. In einigen Fällen (etwa bei ausstehenden aktiven Handles oder Anfragen) gibt uv_backend_timeout() 0 zurück. Andernfalls gibt die Funktion das Ergebnis von uv__next_timeout() zurück, das das nächste Timeout aus dem „Timer-Heap“ ermittelt und die verbleibende Zeit bis zu dessen Ablauf zurückgibt.
Die Funktion, mit der die „Timeouts“ zum „Timer-Heap“ hinzugefügt werden, heißt uv_timer_start(). Sie wird an vielen Stellen aufgerufen. Wir können also versuchen, einen Breakpoint darin zu setzen, um herauszufinden, welcher Aufrufer in unserem Fall einen Wert ungleich null übergibt. Wird am Breakpoint in GDB der Befehl info stack ausgeführt, ergibt sich:
TimerWrap::Start ist lediglich ein dünner Wrapper um uv_timer_start(). Die unleserlichen Adressen weiter oben im Stack deuten darauf hin, dass der gesuchte Code wahrscheinlich in JavaScript implementiert ist. Wenn wir im Node-Quellcode nach Verwendungen von TimerWrap:Start suchen oder die Implementierung von setTimeout() auf der JS-Seite mit einem JS-Debugger durchgehen, finden wir schnell den Timeout-Konstruktor unter https://github.com/nodejs/node/blob/v10.9.0/lib/internal/timers.js#L53:
Und schließlich sehen wir hier, dass ein Timeout von 0 auf 1 aufgerundet wird.
Ich hoffe, dieser Artikel war hilfreich für Sie. Vielen Dank fürs Lesen.
Quellen:
https://nodejs.org/en/docs/guides/event-loop-timers-and-nexttick/
https://jsblog.insiderattack.net/event-loop-and-the-big-picture-nodejs-event-loop-part-1-1cb67a182810 (5-teilige Artikelreihe)
https://github.com/libuv/libuv (auch in nodejs/node eingebunden)
https://github.com/v8/v8 (auch in nodejs/node eingebunden)
Weitere Lektüre zum Thema:
https://javabeginnerstutorial.com/node-js/event-loop-and-asynchronous-non-blocking-in-node-js/
https://stackoverflow.com/questions/34824460/why-does-a-while-loop-block-the-event-loop
https://stackoverflow.com/questions/46004290/will-async-await-block-a-thread-node-js
https://stackoverflow.com/questions/51694299/node-js-socket-io-async-and-blocking-event-loop
http://voidcanvas.com/setimmediate-vs-nexttick-vs-settimeout/
http://dtrace.org/blogs/brendan/2012/11/14/dtracing-in-anger/
https://developer.mozilla.org/en-US/docs/Web/JavaScript/EventLoop
https://jakearchibald.com/2015/tasks-microtasks-queues-and-schedules/ – Browser
https://blog.risingstack.com/node-js-at-scale-understanding-node-js-event-loop/
https://humanwhocodes.com/blog/2013/07/09/the-case-for-setimmediate/