Architektur einer serverlosen Webanwendung in AWS
9. Mai 2016
0 Min. LesezeitAnmerkung der Redaktion
Dieser Blogbeitrag erschien ursprünglich auf fugue.co. Fugue wurde 2022 Teil von Snyk und ist ein wichtiger Bestandteil von Snyk IaC.
Hier bei Fugue ist das Webteam eine kleine, aber engagierte Minderheit – mit einer Vorliebe für JavaScript, 60 Bilder pro Sekunde und möglichst unkompliziertes DevOps. Wir experimentieren gern und interessieren uns für neue Ansätze des Computings, bei denen Substanz und Eleganz wichtiger sind als kurzlebige Trends und Effekthascherei. Seit einiger Zeit verwenden wir AWS Lambda mit SNS-Themen und votebots, hatten damit aber noch nichts Größeres ausprobiert. Bis jetzt. Das Serverless-Framework gab uns den nötigen Anstoß. Unser Ziel? Eine für das Unternehmen nützliche Anwendung über eine mit Lambda und API Gateway erstellte API bereitzustellen – ohne dabei EC2-Instanzen zu beeinträchtigen.
Spulen wir kurz zurück und erklären AWS Lambda. Wie IBM OpenWhisk, Google Cloud Functions und Azure Functions ist es ein Dienst „zur Ausführung von Code als Reaktion auf bestimmte Ereignisse, etwa wenn eine Datei in Amazon S3 hochgeladen wird, bei einem Ereignisstream oder bei einer Anfrage an ein API-Gateway“. Fintan Ryan gibt, teilweise zitiert, hier einen guten Überblick. Ihr Code wird automatisch skaliert, um Anfragen zu bewältigen. Diese Art des direkten Computings befindet sich auf einem rasanten Wachstumskurs.
Die Anwendung
Die von uns entwickelte Frontend-Webanwendung ist unkompliziert. Nach der Anmeldung werden Nutzerinnen und Nutzern Informationen zu unseren Software-Builds und sichere Download-URLs angezeigt. Die Anwendung liegt in S3. Für diese Funktionalität entwickeln wir eine REST-API. Sehen wir uns die Architektur der API an:
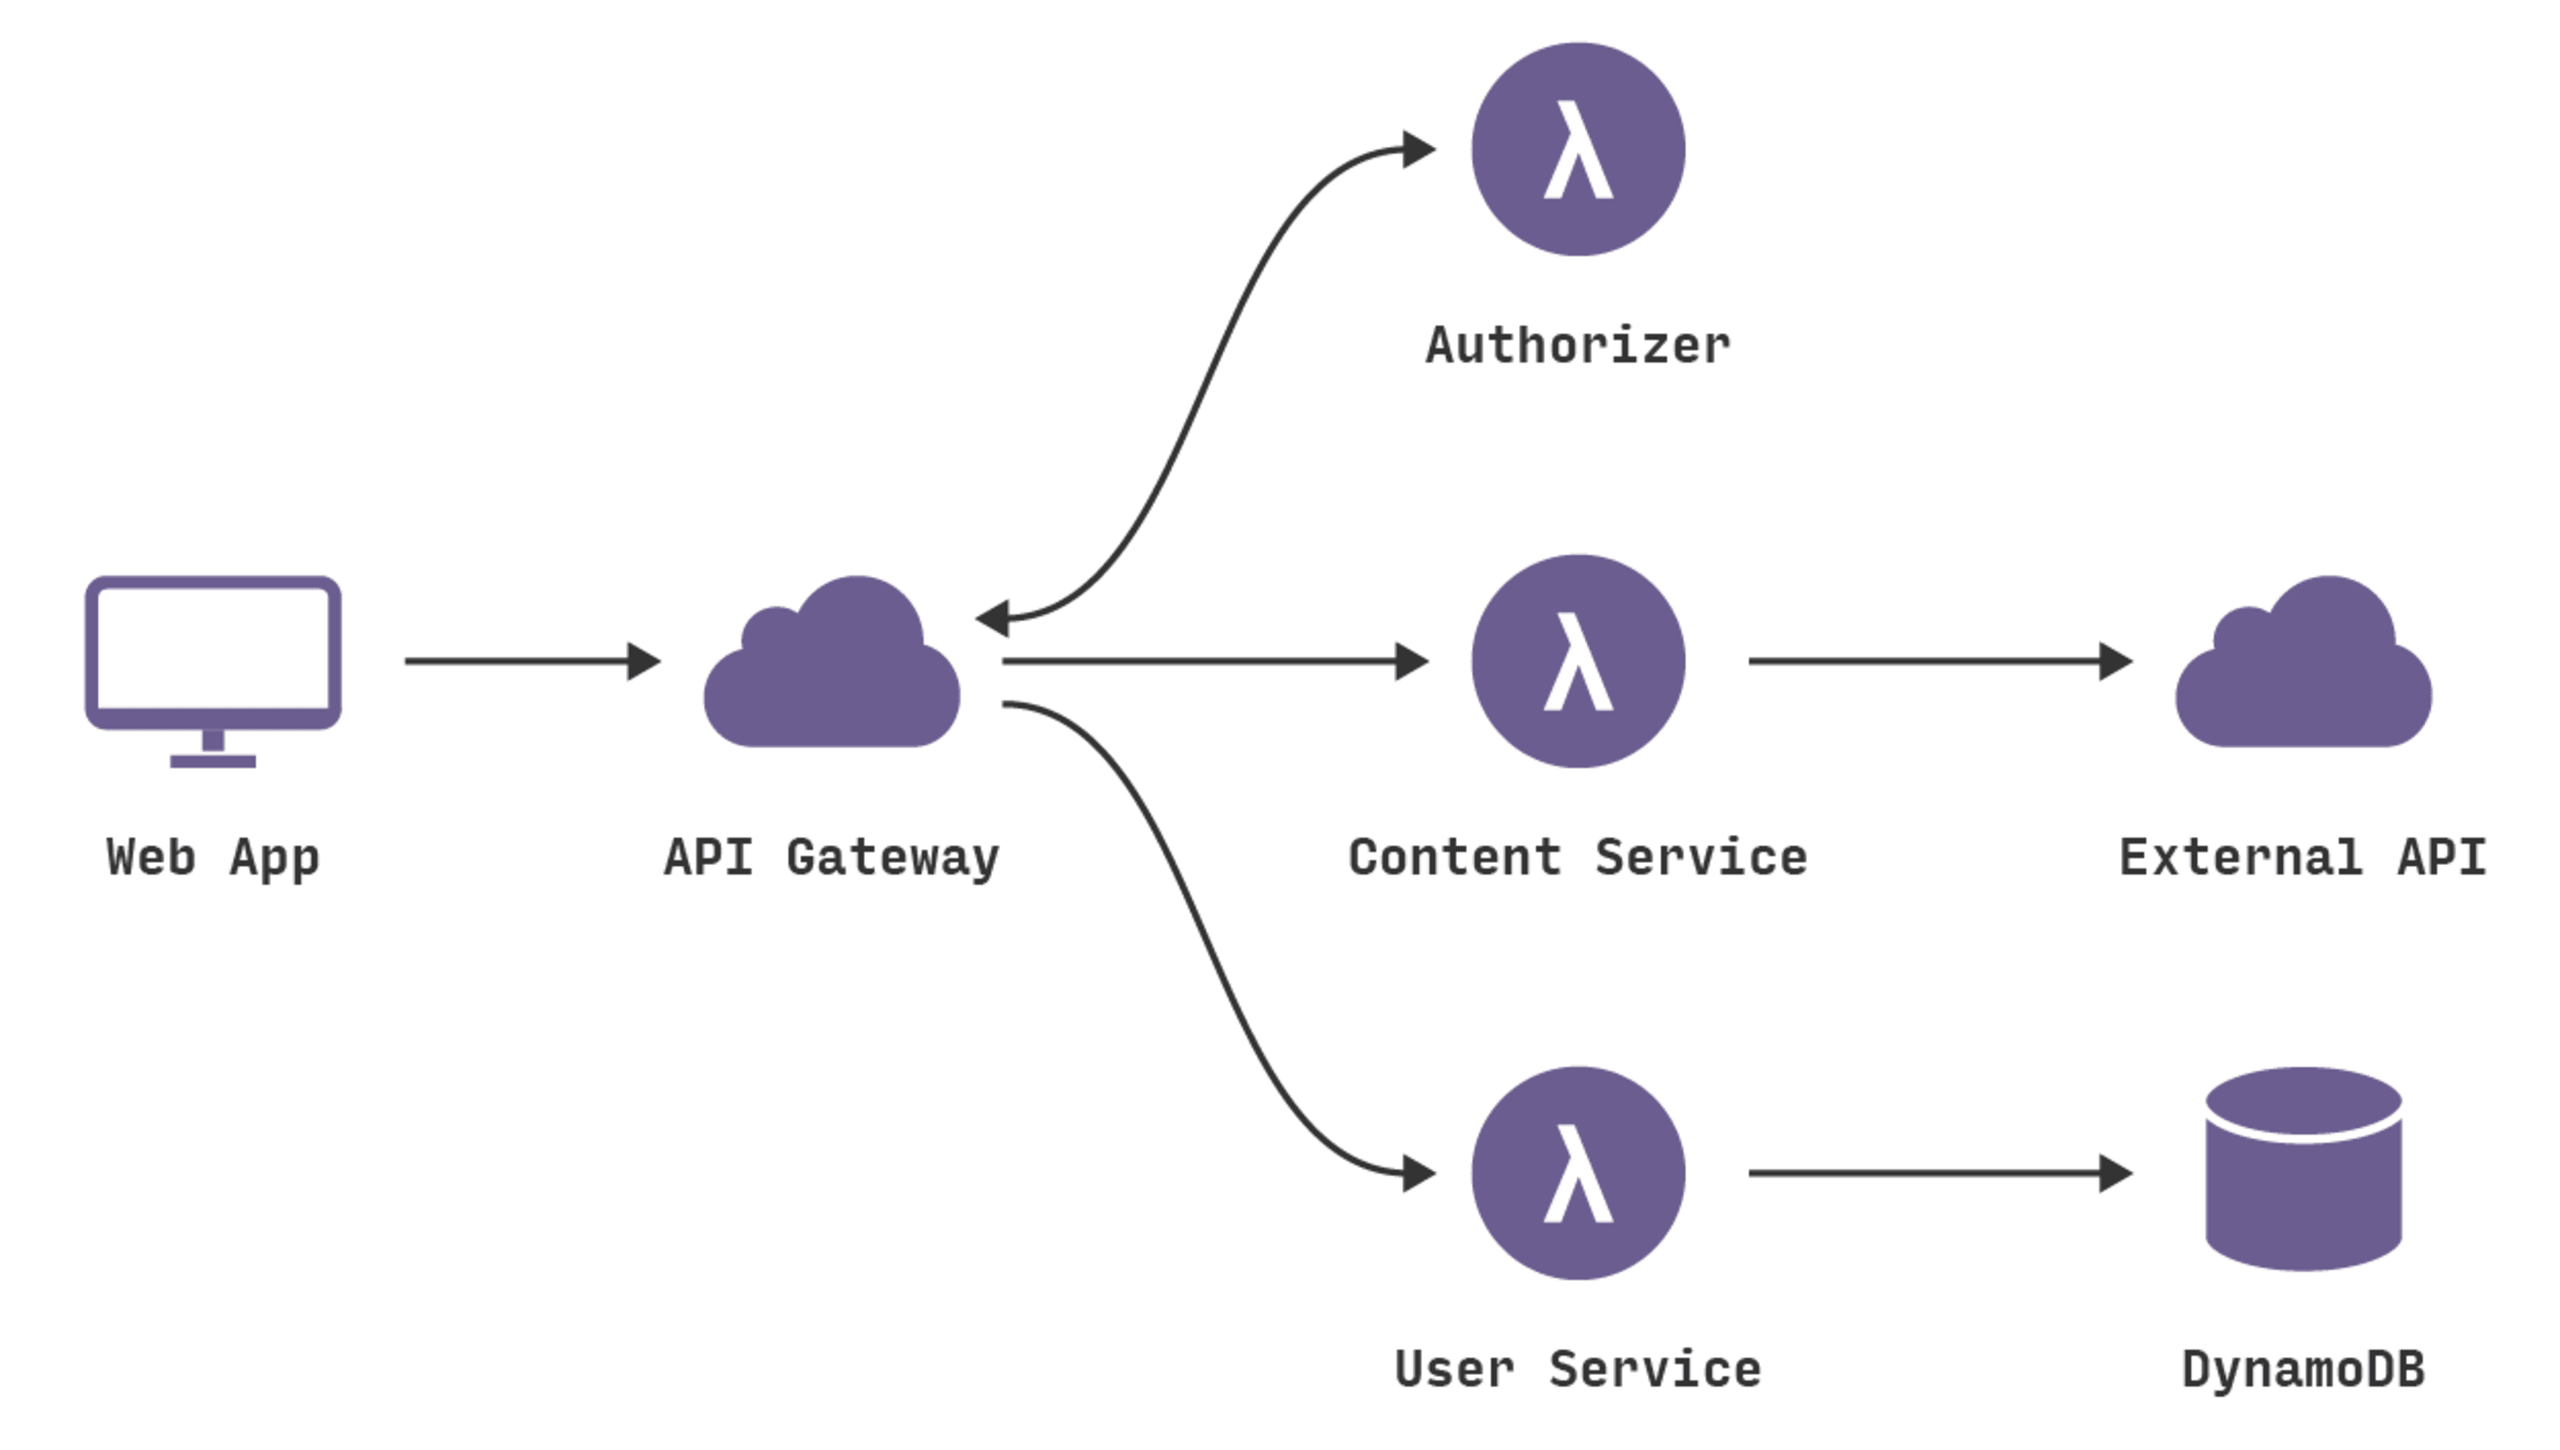
Wie Sie sehen, gibt es eine Reihe von API-Gateway-Endpunkten, die Lambda-Funktionen auslösen. Die User-Service-Lambda speichert Daten in DynamoDB. Die Content-Service-Lambda verbindet sich mit der API unseres Verteilungsdienstes, ruft Inhalte ab, nimmt kosmetische Änderungen vor und übergibt sie an die Frontend-Anwendung. Die Authorization-Lambda validiert Sitzungstokens der Nutzer und gewährt Zugriff auf geschützte Endpunkte.
Sie könnten all diese Dienste manuell in AWS konfigurieren. Wir verwenden jedoch das Serverless-Framework als Deployment-Tool und geben unserem Projekt damit eine klare Struktur.
Serverless vorgestellt
Serverless ist ein Framework für die Entwicklung von Anwendungen mit Lambda und API Gateway. Außerdem unterstützt es die Verwaltung weiterer AWS-Ressourcen mithilfe von CloudFormation-Vorlagen. Es wird als gut dokumentierte Node.js-CLI bereitgestellt.
Serverless ist leistungsstark, weil es sowohl Ihren Code als auch Ihre AWS-Konfiguration verwaltet. Es gibt eine festgelegte Projektstruktur mit JSON-Konfigurationsdateien für Ihre Lambda-Funktionen. Diese Funktionskonfigurationsdateien enthalten Definitionen für Ihre API-Gateway-Endpunkte und weitere Ereignisse, die die Funktion auslösen können. Für das Deployment Ihres Projekts müssen Sie in Ihrem AWS-Konto einen Serverless-Benutzer anlegen und ihm Berechtigungen für die verwendeten Dienste erteilen. Anschließend können Sie das Deployment über die CLI starten. Dabei werden die verwendeten AWS-Dienste konfiguriert und Ihr Lambda-Funktionscode veröffentlicht.
Herausforderungen angehen
Serverless löst einige der Herausforderungen, auf die wir beim Versuch gestoßen sind, diese Art von Projekt in AWS ohne Framework einzurichten:
1) Lambda-Funktionen sind eigenständig und können keinen Code gemeinsam nutzen.
Wenn Sie ein Projekt mit mehreren Funktionen umsetzen, möchten Sie wahrscheinlich Code zwischen ihnen gemeinsam nutzen – selbst wenn es nur eine utils-Bibliothek ist. Lambda-Funktionen werden isoliert in Containern bereitgestellt. Daher kann Ihre Funktion nicht von einem gemeinsamen Bibliotheksverzeichnis abhängen. Serverless löst dieses Problem, indem Sie die Verzeichnisebene festlegen können, die in das Deployment-Paket aufgenommen werden soll. So können Sie Code aus einem übergeordneten Ordner in Ihre Funktion einbinden, den auch andere Funktionen verwenden können. Die eingebundenen Dateien werden zusammen mit dem Deployment-Paket gezippt.
2) Lambda-Funktionen unterstützen keine Umgebungsvariablen.
Wie binden Sie geheime Zugangsdaten wie API-Schlüssel sicher in Ihre Lambda-Funktion ein, ohne sie direkt in den Code zu schreiben und für Nutzer Ihres GitHub-Repositorys sichtbar zu machen? Serverless speichert Definitionen für Umgebungsvariablen in JSON-Dateien in einem von Git ignorierten Ordner namens _meta und fügt die Werte während des Deployments in Ihre Funktionen ein. Wenn Sie im Team arbeiten, synchronisiert das Meta Sync-Plugin diese Variablendefinitionen sicher über S3.
3) API Gateway mit Lambda kommunizieren zu lassen, ist schwierig.
Jeder API-Gateway-Endpunkt benötigt eine Anfragevorlage, in der festgelegt wird, welche Informationen zur Anfrage der ausgelösten Lambda-Funktion zur Verfügung stehen. Ihre Lambda-Funktion muss wahrscheinlich den Anfragepfad und die Methode, URL-Parameter, Abfrageparameter und möglicherweise einen benutzerdefinierten Header oder den Body einer POST-Anfrage kennen. Ohne Anfragevorlage stehen diese Informationen nicht zur Verfügung. Ebenso interpretiert API Gateway standardmäßig keine Antwort einer Lambda-Funktion. Gibt Ihre Funktion einen Fehler zurück, werden daher nicht automatisch HTTP-Fehlercodes zugeordnet. Sie müssen eine Antwortvorlage hinzufügen, um Fehlermeldungszeichenfolgen der Lambda-Funktion den passenden Antwortcodes zuzuordnen. Serverless vereinfacht dies durch die Unterstützung der Vererbung von Anfrage- und Antwortvorlagen. So können Sie allgemeingültige Vorlagen für alle Endpunkte definieren und sie bei Bedarf für einzelne Endpunkte überschreiben.
Projektstruktur
Hier sehen Sie die Verzeichnisstruktur unseres Serverless-Projekts:
s-project.json
Diese Datei enthält den Projektnamen, die Beschreibung und die benutzerdefinierten Plugins, die in diesem Projekt verwendet werden.
s-resources-cf.json
Diese CloudFormation-Vorlage definiert die Ressourcen, die dieses Projekt neben Lambda und API Gateway verwendet. In unserem Fall sind das eine DynamoDB-Tabelle sowie eine IAM-Rolle und -Richtlinie für die Lambda-Funktion, die ihr Lese- und Schreibzugriff auf DynamoDB gewähren.
_meta
Dieser Ordner enthält JSON-Dateien mit Umgebungsvariablen für das Projekt, die gegebenenfalls auf die Deployment-Phase und die Region zugeschnitten sind. Dieser Ordner wird von Git ignoriert.
functions
Dieser Ordner enthält Unterordner für jede unserer Lambda-Funktionen. Serverless schreibt hier keine bestimmte Organisationsstruktur vor. Sie können Funktionen also beliebig in Ordnern verschachteln. Ein Funktionsordner muss eine Datei mit Ihrem Funktionscode enthalten (in diesem Fall handler.js) sowie eine Datei namens s-function.json, in der die Funktionskonfiguration und die Endpunkte enthalten sind, die Ihre Funktion auslösen können. Außerdem kann er eine event.json enthalten, in der ein Testobjekt gespeichert ist, auf das wir später eingehen. Wie bereits erwähnt, gibt es einen lib-Ordner neben unseren Funktionsordnern, den jeder Funktionsordner (z. B. user, content) einbinden kann.
Ein genauerer Blick auf die Komponenten eines Serverless-Projekts
Unser Serverless-Projekt hat drei wichtige Architekturkomponenten: Lambda-Funktionen, eine REST-API in API Gateway und weitere AWS-Ressourcen wie unsere DynamoDB-Tabelle und die IAM-Rolle. Sehen wir uns genauer an, wie wir diese Komponenten verwenden.
Lambda-Funktionen
Abgesehen von der authorizer-Lambda-Funktion, auf die wir gleich eingehen, haben wir unseren Code in zwei Funktionen aufgeteilt: content und user. Warum?
Technisch gesehen können Sie Ihren Lambda-Code beliebig aufteilen. Alle Ihre Endpunkte könnten eine einzige Funktion auslösen, die die Anfrage analysiert und entscheidet, wie sie darauf antwortet. Oder Sie erstellen für jeden Endpunkt und jedes Ereignis in Ihrem Projekt eine eigene Funktion. Nach Abwägung einiger Faktoren haben wir uns für einen Mittelweg entschieden und den Code in Microservice-Funktionen gruppiert:
Codeorganisation
Ähnliche Endpunkte einer Funktion zuzuweisen, ist sinnvoll. Unser gesamter nutzerbezogener Code arbeitet mit derselben Datenbanktabelle und verwendet dieselben externen Bibliotheken. Gruppieren wir diesen ähnlichen Code in einer Funktion, wirken sich Codeänderungen sofort auf alle Endpunkte aus.
Leistung
Die Lambda-Dokumentation weist darauf hin, dass kleinere Funktionen besser performen. Die Latenz einer Funktion ist deutlich höher, wenn sie längere Zeit nicht aufgerufen wurde – unserer Erfahrung nach, wenn der letzte Aufruf etwa fünf Minuten zurückliegt. Nach dem ersten Aufruf sinkt die Latenz dann erheblich. Die anfängliche Latenz, die sogenannte „Cold-Start-Zeit“, hängt direkt von der Größe der Funktion ab. Kleinere Funktionen haben kürzere Cold-Start-Zeiten. (Sie können diese Cold-Start-Zeit auch verkürzen, indem Sie die Speicherzuweisung für Ihre Funktionen erhöhen. Dadurch steigt proportional auch die CPU-Leistung.)
Diese langsame Cold-Start-Zeit ist bei asynchronen Lambda-Anwendungsfällen kein Problem. Bei einer API mit geringem Datenverkehr hingegen schon. Unsere API muss schnell antworten, sonst leidet die Nutzererfahrung der Anwendung.
Wenn Sie zusammengehörige Funktionen in größeren Lambda-Funktionen bündeln, bleiben diese teilweise aufgewärmt. Meldet sich beispielsweise ein Nutzer bei seinem Konto an und ruft anschließend sein Profil auf, kann das zwei API-Aufrufen entsprechen. Wenn die Funktion kürzlich nicht aufgerufen wurde, könnte der erste Aufruf langsam sein. Lösen jedoch beide Endpunkte dieselbe Funktion aus, ist der zweite Aufruf garantiert schnell.
Hinweis: Wir haben darüber gesprochen, unsere Funktionen aufgewärmt zu halten, indem wir einfach alle fünf Minuten einen Endpunkt anpingen. Das würde zweifellos funktionieren, aber bisher sahen wir keinen Grund, das umzusetzen.
Funktions-Handler
In unserer s-function.json-Datei definieren wir den Funktions-Handler. In unserem Fall ist das eine Funktion namens handler in handler.js. Diese Funktion wird aufgerufen, wenn die Lambda-Funktion ausgeführt wird. So sieht die content der handler.js-Funktion aus:
Wie Sie sehen, dient sie lediglich als Router für unsere Funktion. Der gesamte wichtige Code ist in /lib/download.js ausgelagert. Diese Datei weiß nicht, dass sie Teil einer Lambda-Funktion ist. Dadurch lassen sich Unit-Tests für unseren Code einfacher schreiben, denn /lib/download.js ist einfach eine JavaScript-Datei ohne spezielle Lambda-Abhängigkeiten.
REST-API in API Gateway
Die Endpunkte werden in der s-function.json-Datei konfiguriert. Hier sehen Sie ein Beispiel für eine Endpunktkonfiguration:
Dieser Endpunkt ist unter GET /downloads verfügbar.
Anfrage- und Antwortvorlagen
In der obigen Endpunktkonfiguration haben Sie $${requestTemplate} und $${responseTemplate} gesehen. Das bedeutet, dass der downloads-Endpunkt die requestTemplate und die responseTemplate übernimmt, die wir in einer globalen Vorlagendatei für unser Projekt definiert haben.
Anfrage- und Antwortvorlagen werden in JSON dargestellt und verwenden JSONPath-Ausdrücke. Sie können JSONPath-Ausdrücke mit der Apache Velocity Template Language (VTL) bearbeiten. Die Syntax ist etwas knifflig.
Serverless hat vor Kurzem Unterstützung für YAML-Anfrage- und Antwortvorlagen hinzugefügt. Wir verwenden derzeit jedoch das JSON-Format. Hier sehen Sie unsere Anfragevorlage:
Ja, sie sieht ein wenig verrückt aus – wie man es von in JSON maskiertem JSON erwarten würde. Sie erzeugt jedoch ein Ereignisobjekt für die Lambda-Funktion, das alle benötigten Informationen zur Anfrage enthält:
body enthält den geparsten JSON-Body der Anfrage
path ist der Pfad des angefragten Endpunkts
method ist die HTTP-Methode der Anfrage
headers enthält alle HTTP-Header der Anfrage
params enthält die Pfadparameter der Anfrage
query enthält die Abfrageparameter der Anfrage
authorizedUser ist der Benutzername des autorisierten Nutzers, sofern für den Endpunkt eine Autorisierung erforderlich war
Und hier ist unsere Antwortvorlage. Wenn die Lambda-Funktion erfolgreich ausgeführt wurde, wird die Ergebniszeichenfolge als JSON an den Nutzer weitergegeben (mithilfe des Vorlagenfragments response200). Schlägt die Funktion fehl, versuchen die regulären Ausdrücke, eine Übereinstimmung mit der Ergebniszeichenfolge zu finden. Je nach Fehlermeldung geben wir unterschiedliche HTTP-Fehlercodes zurück.
Autorisierung verwalten
Für die Berechtigungen unserer Anwendung nutzen wir zwei Funktionen von API Gateway: API-Schlüssel und benutzerdefinierte Authorizer-Funktionen. Beide Funktionen vereinfachen unseren Anwendungscode, da sie Berechtigungsprüfungen aus den zentralen Lambda-Funktionen auslagern.
API-Schlüssel
Mit API Gateway können Sie einen API-Schlüssel erstellen und einzelnen Endpunkten zuweisen. Damit schützen wir bestimmte sensible Endpunkte, auf die nicht clientseitig zugegriffen werden sollte, etwa die Benutzerverwaltung. API Gateway sucht bei Anfragen an die ausgewählten Endpunkte nach einem x-api-key-Header und gleicht dessen Wert mit dem von uns erstellten API-Schlüssel ab. Fehlt der Header oder ist er ungültig, wird die Anfrage mit einem 403-Fehler abgewiesen und die Lambda-Funktion nicht aufgerufen.
Benutzerdefinierte Authorizer
API Gateway hat vor Kurzem benutzerdefinierte Autorisierung eingeführt. Damit kann eine Lambda-Funktion den Zugriff auf Endpunkte steuern. Bei einer eingehenden Anfrage wird die benutzerdefinierte Authorizer-Funktion mit einem Autorisierungstoken aus einem festgelegten benutzerdefinierten Anfrage-Header aufgerufen. Der benutzerdefinierte Authorizer prüft das Autorisierungstoken – in unserem Fall ein JSON Web Token – und gibt eine IAM-Richtlinie zurück, die die Anfrage autorisiert. Ist die Richtlinie für die Anfrage ungültig oder schlägt die Autorisierung fehl, gibt API Gateway einen 403-Fehler zurück. Ist die Richtlinie gültig, wird die dem Endpunkt zugewiesene Lambda-Funktion ausgelöst.
Hier sehen Sie ein Beispiel für die IAM-Richtlinie, die unser benutzerdefinierter Authorizer zurückgibt:
Da unsere Webanwendung keine granularen Berechtigungen unterstützt, gewähren wir Zugriff auf alle Endpunkte der API, die den benutzerdefinierten Authorizer verwenden. API Gateway speichert die generierte IAM-Richtlinie zusammen mit dem zu ihrer Erstellung verwendeten Autorisierungstoken im Cache. Bei nachfolgenden Anfragen an beliebige geschützte Endpunkte mit demselben Autorisierungstoken im Header wird diese Richtlinie automatisch angewendet und der benutzerdefinierte Authorizer umgangen – und zwar für eine von Ihnen festgelegte TTL.
Workflow für Serverless-Projekte
Umgebungen
Mindestens benötigen wir für unser Projekt separate Entwicklungs-, Test- und Produktionsumgebungen.
Serverless arbeitet mit sogenannten „Stages“, die in den verschiedenen AWS-Services jeweils anders umgesetzt sind, zusammen aber wie eine Umgebung funktionieren.
Lambda: Jedes Mal, wenn der Code einer Lambda-Funktion geändert wird, erstellt Lambda automatisch eine neue Version. Lambda-Funktionen können Versions-Aliase haben, und Serverless nutzt Aliase, um in den verschiedenen Stages auf unterschiedliche Versionen zu verweisen. Wird beispielsweise die Stage dev veröffentlicht und zur Version 1 der Lambda-Funktion, erstellt Serverless auch einen Alias dev, der auf Version 1 verweist. Wird anschließend die Stage prod der Funktion veröffentlicht, wird der Prod-Code zu Version 2, der Alias dev verweist jedoch weiterhin auf Version 1.
API Gateway: Eine einzelne API in API Gateway kann mehrere Stages haben. Jede Stage eines API-Endpunkts kann einen anderen Lambda-Alias auslösen. So kann die API-Gateway-Stage dev den Alias dev der Lambda-Funktion verwenden – unabhängig davon, auf welche Version dieser gerade verweist. Der Name der Stage wird Teil des Endpunktpfads.
Andere AWS-Services wie DynamoDB-Tabellen, S3-Buckets usw. sind für jede Stage jeweils separat vorhanden.
Tests
Der Ordner jeder Lambda-Funktion kann in einer Datei event.json ein Mock-Event-Objekt für Tests enthalten:
Mit serverless function run wird die Funktion ausgeführt und event.json als Event verwendet. Das eignet sich für End-to-End-Tests der Funktion.
Es gibt einige Serverless-Plugins, die API Gateway für Tests lokal simulieren, etwa Offline und Serve. Da API Gateway laufend um neue Funktionen erweitert wird, unterstützten diese Plugins nicht immer die Funktionen, die wir verwenden wollten. Deshalb haben wir die meisten API-Gateway-Tests in der AWS Console durchgeführt.
Für Unit-Tests unserer JavaScript-Dateien im Verzeichnis lib verwenden wir Jasmine.
Deployment
Damit unser Projekt einsatzbereit ist, müssen drei Dinge bereitgestellt werden: Funktionen, Endpunkte und Projektressourcen (also die AWS-Ressourcen in s-resources.json). Wir können sie mit den folgenden CLI-Befehlen einzeln bereitstellen:
Alternativ können wir das praktische interaktive Deployment-Dashboard über den Befehl serverless dash deploy verwenden:
Mit beiden Optionen ist ein sehr granularer Deployment möglich. So können wir eine Funktion oder einen Endpunkt aktualisieren, ohne etwas anderes zu ändern.
Das interaktive Dashboard eignet sich hervorragend für die lokale Entwicklung und Tests. Für den Einsatz mit Continuous-Integration-Tools verwenden wir jedoch die erste Gruppe von Befehlen. Standardmäßig fragt die CLI nach fehlenden Optionen. Sie können diese Interaktivität deaktivieren, indem Sie eine Umgebungsvariable namens CI auf true setzen. Für Continuous Integration und Deployments nutzen wir Travis CI. Travis führt unsere Unit-Tests aus und verwendet anschließend die CLI im CI-Modus, um unseren Code auf AWS bereitzustellen.
Weitere Informationen finden Sie in der Serverless-CLI-Referenz.
Abschließende Gedanken
Vor einigen Monaten teilte unser CEO Josh seine Gedanken zu AWS Lambda und zur fortlaufenden Entwicklung der Cloud. Er merkte an:
Lambda gibt die Anwendungsarchitektur stärker vor als herkömmliche PaaS-Angebote. Der Service gibt nicht vor, ein herkömmlicher Computer oder Cluster aus herkömmlichen Computern zu sein. Stattdessen ist Lambda von Natur aus ereignisgesteuert und setzt auf Funktionsebene Zustandslosigkeit voraus. Das bedeutet, dass Sie beim Zusammenstellen einer Anwendung etwas anders denken müssen. Im Vergleich zu Recheninstanzen oder Containern profitieren Sie von nahezu unbegrenzter Skalierbarkeit und sehr niedrigen Kosten. Im Gegenzug müssen Sie Zeit in das Lernen investieren, können bei Ihren Experimenten und Untersuchungen aber durchaus neue Muster entwickeln.
Dem stimmen wir zu. Die Zeit und Mühe, die Sie in Lernen und praktische Arbeit investieren, zahlt sich aus. Wir hoffen, dass das hier vorgestellte Beispiel hilfreich ist. In naher Zukunft werden wahrscheinlich weitere Frameworks wie Serverless aufkommen. Für den Einstieg und die Entwicklung einer soliden Webanwendung ist Serverless jedoch eine gute Wahl.
IaC-Sicherheit für Entwickler
Snyk schützt Ihre Infrastructure as Code vom SDLC bis zur Laufzeit in der Cloud mit einer einheitlichen Policy-as-Code-Engine, damit jedes Team sicher entwickeln, bereitstellen und betreiben kann.


