KI-Qualität: Garbage in, garbage out

11. Juni 2024
0 Min. LesezeitWenn Sie abgelaufene, verschimmelte Zutaten für Ihr Dessert verwenden, erhalten Sie vielleicht etwas, das gut aussieht, aber scheußlich schmeckt. Und Ihren Gästen würden Sie es bestimmt nicht servieren wollen. Garbage in, garbage out (GIGO) gilt nicht nur für Technologie und KI. Schlechte Zutaten in ein Rezept zu geben, kann zu einem potenziell giftigen Ergebnis führen. Wenn es ein wenig verdächtig aussieht, können Sie es natürlich mit Zuckerguss überdecken – und niemand merkt etwas. Genau diese Gefahr beobachten wir gerade.
Bei KI/ML sieht alles gut aus. Sie können Ihren Lieblings-Bot verwenden und ein Stück Code erhalten, das fantastisch aussieht. Es enthält Kommentare, ist korrekt eingerückt und verwendet vielleicht sogar eine Bibliothek, die Ihnen weiterhilft. Aber wenn die Milch verdorben war und der Bot sie aus dem Kühlschrank genommen hat, könnte Ihr Code sauer sein.
Über GIGO wird oft abstrakt gesprochen. Sehen wir uns deshalb ein Beispiel dafür an, wie es dazu kommt. Ich habe an einer Universität einen Kurs über künstliche Intelligenz unterrichtet. Im Rahmen des Kurses haben wir ein Expertensystem mit einem Entscheidungsbaum entwickelt.
Ein Expertensystem ist eine Art Computerprogramm der künstlichen Intelligenz (KI), das die Entscheidungsfähigkeit eines menschlichen Experten in einem bestimmten Fach- oder Wissensgebiet nachahmt. Es soll komplexe Probleme lösen, Empfehlungen aussprechen oder fachkundige Ratschläge auf Expertenniveau geben – auf Grundlage von Regeln, Wissen und logischem Denken. In unserem Beispiel löst es ein sehr einfaches Problem.
Ein Expertensystem stützt sich auf eine Wissensdatenbank. Dort speichert das System domänenspezifische Informationen, Fakten, Regeln und Heuristiken. Außerdem gibt es die Inferenzmaschine. Sie ist die Schlussfolgerungskomponente des Expertensystems. Mithilfe des Wissens aus der Wissensdatenbank zieht sie Schlüsse, trifft Entscheidungen und löst Probleme. Dazu verwendet sie verschiedene Schlussfolgerungsverfahren, etwa Vorwärtsverkettung (von bekannten Fakten zu Schlussfolgerungen) oder Rückwärtsverkettung (ausgehend von einem Ziel rückwärts nach Belegen suchen). Uns geht es hier jedoch um die Daten im System.
Die Aufgabe, die ich gestellt habe, war ganz einfach: Das Programm sollte anhand der von der Benutzerin oder dem Benutzer angegebenen Eigenschaften ein Tier erraten. Lag es falsch, fügte es dem System ein neues Merkmal hinzu.
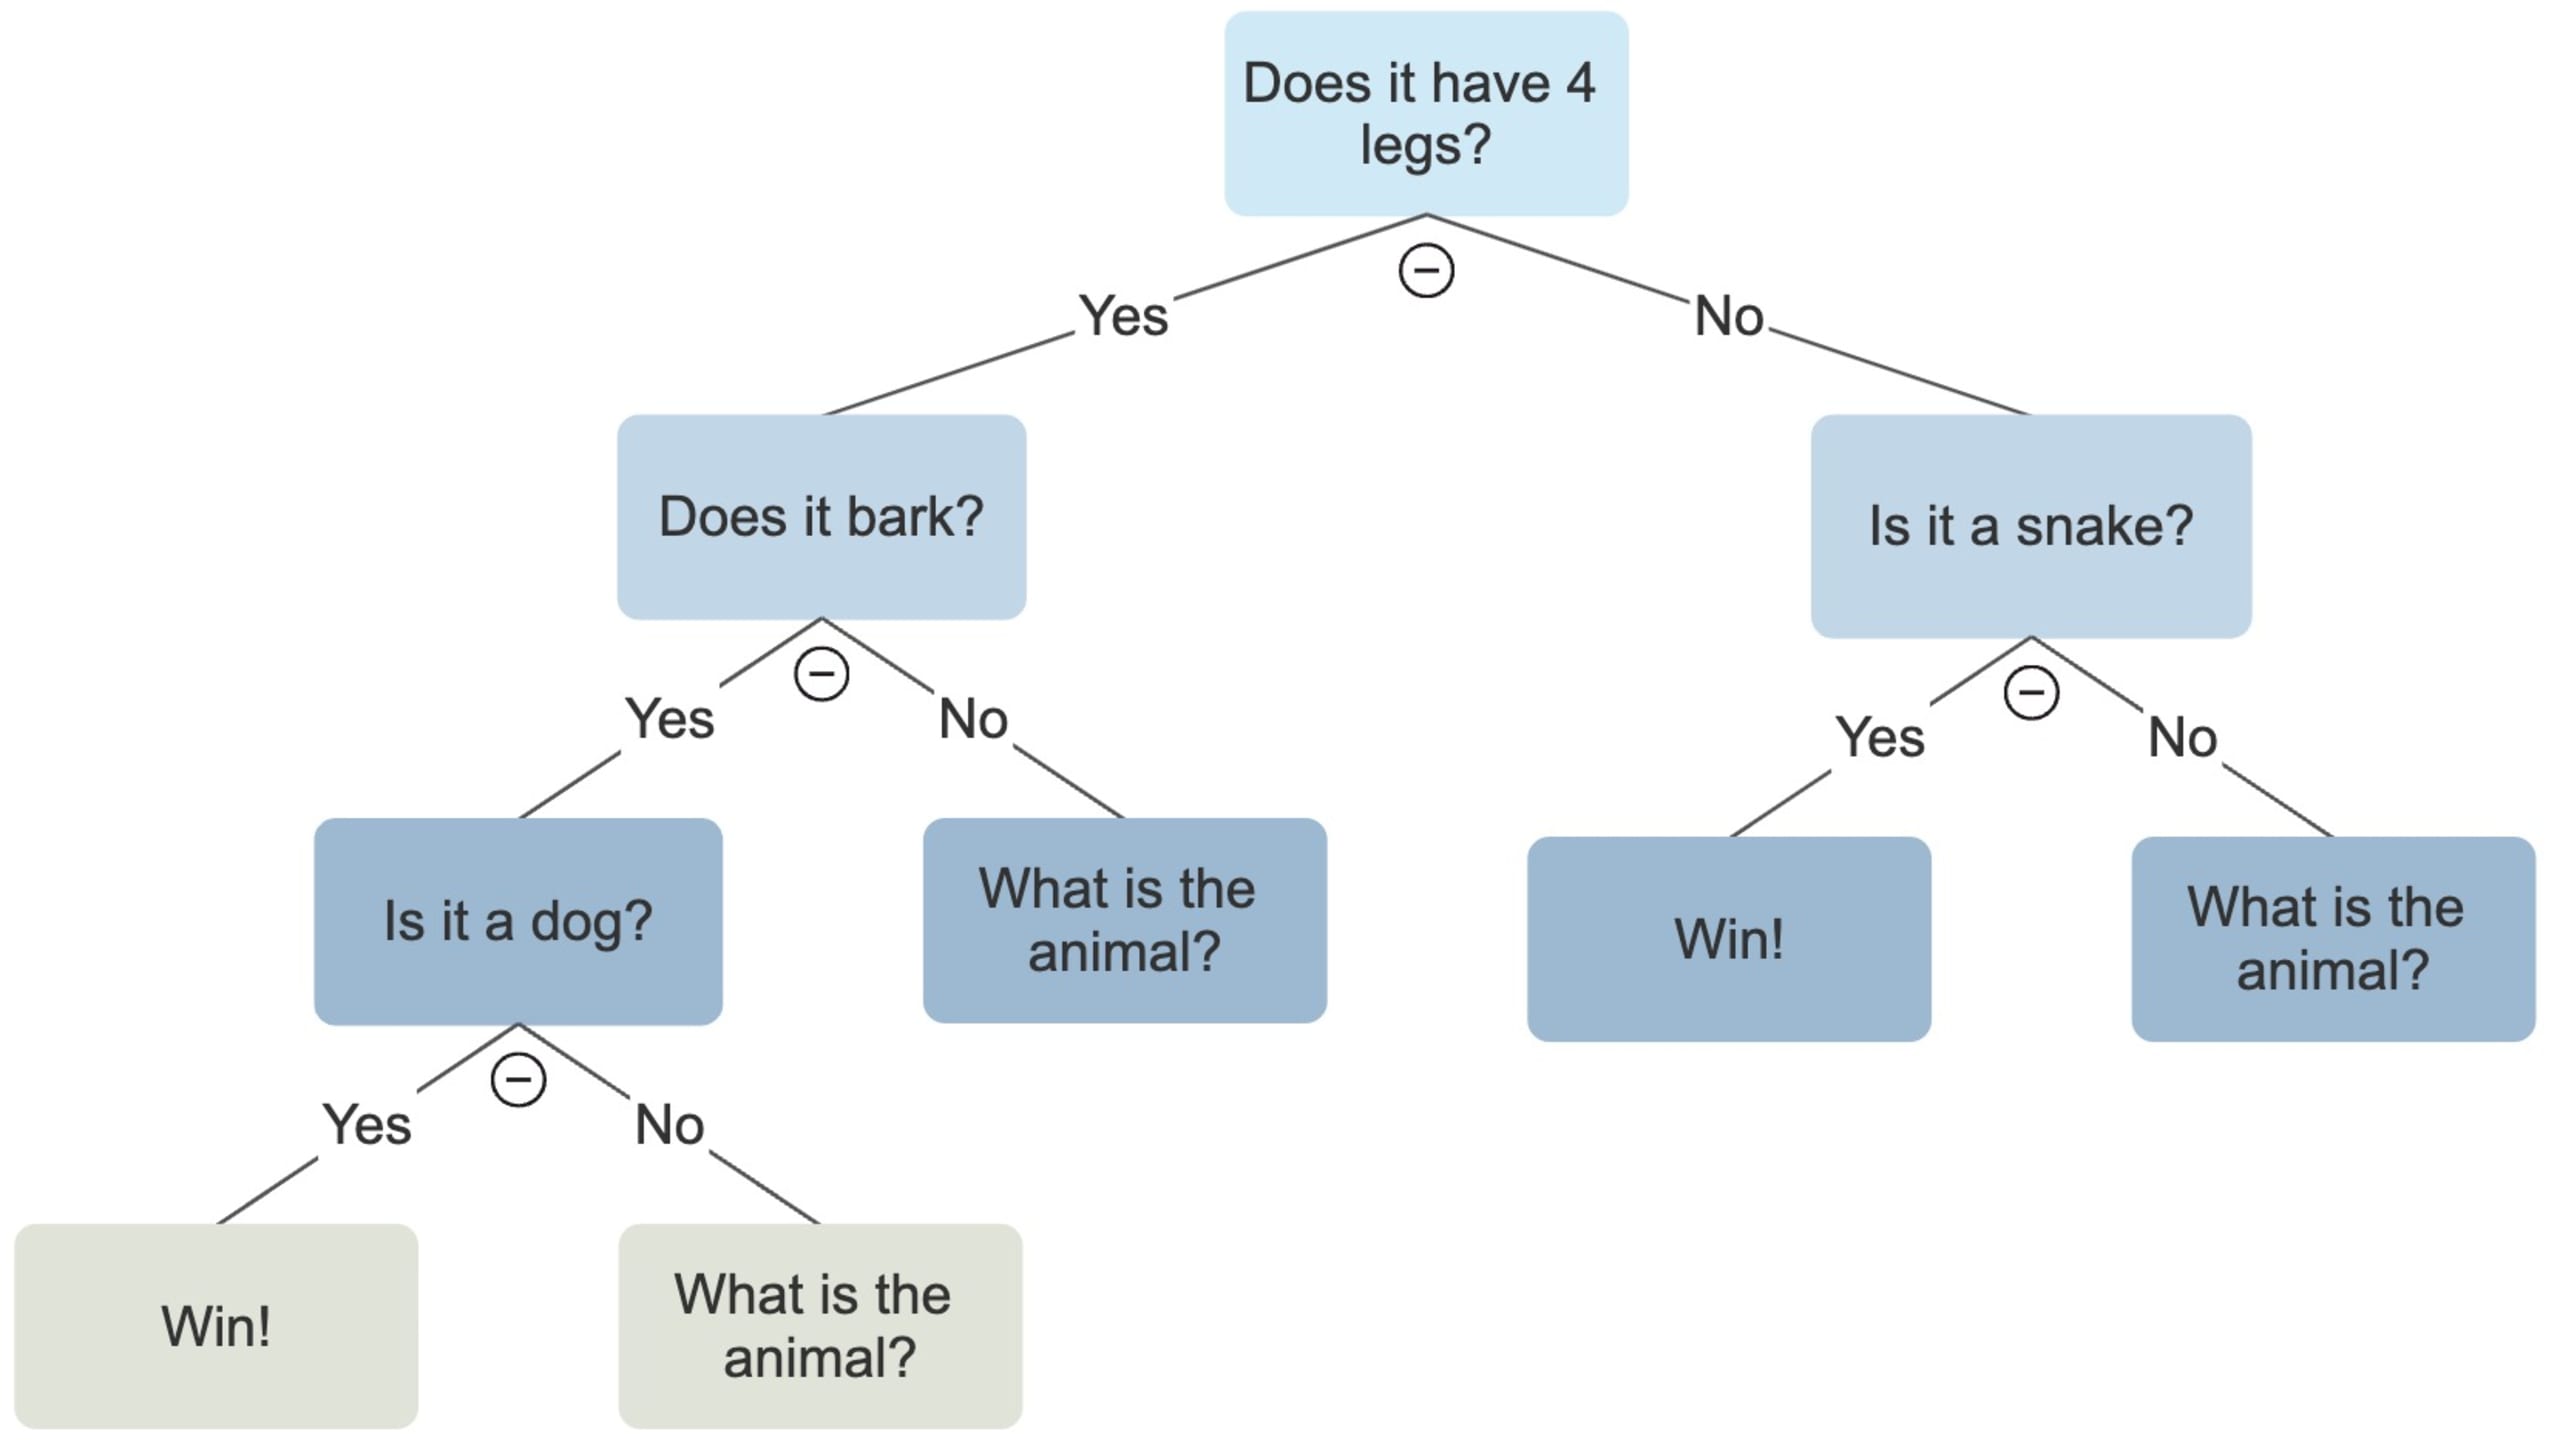
Mit diesem Expertensystem kann das Programm scheinbar lernen und so eine Form von künstlicher Intelligenz zeigen. Wenn die Benutzerin oder der Benutzer beispielsweise an eine Katze denkt, antwortet das System zunächst mit JA auf die Frage, ob sie vier Beine hat, und dann mit NEIN auf die Frage, ob sie bellt. Anschließend fragt das System, um welches Tier es sich handelt, und stellt dann die Frage: „Welche Frage würde helfen, eine Katze von einem Hund zu unterscheiden?“
In diesem Fall könnte die Benutzerin oder der Benutzer sagen: „Miaut es?“
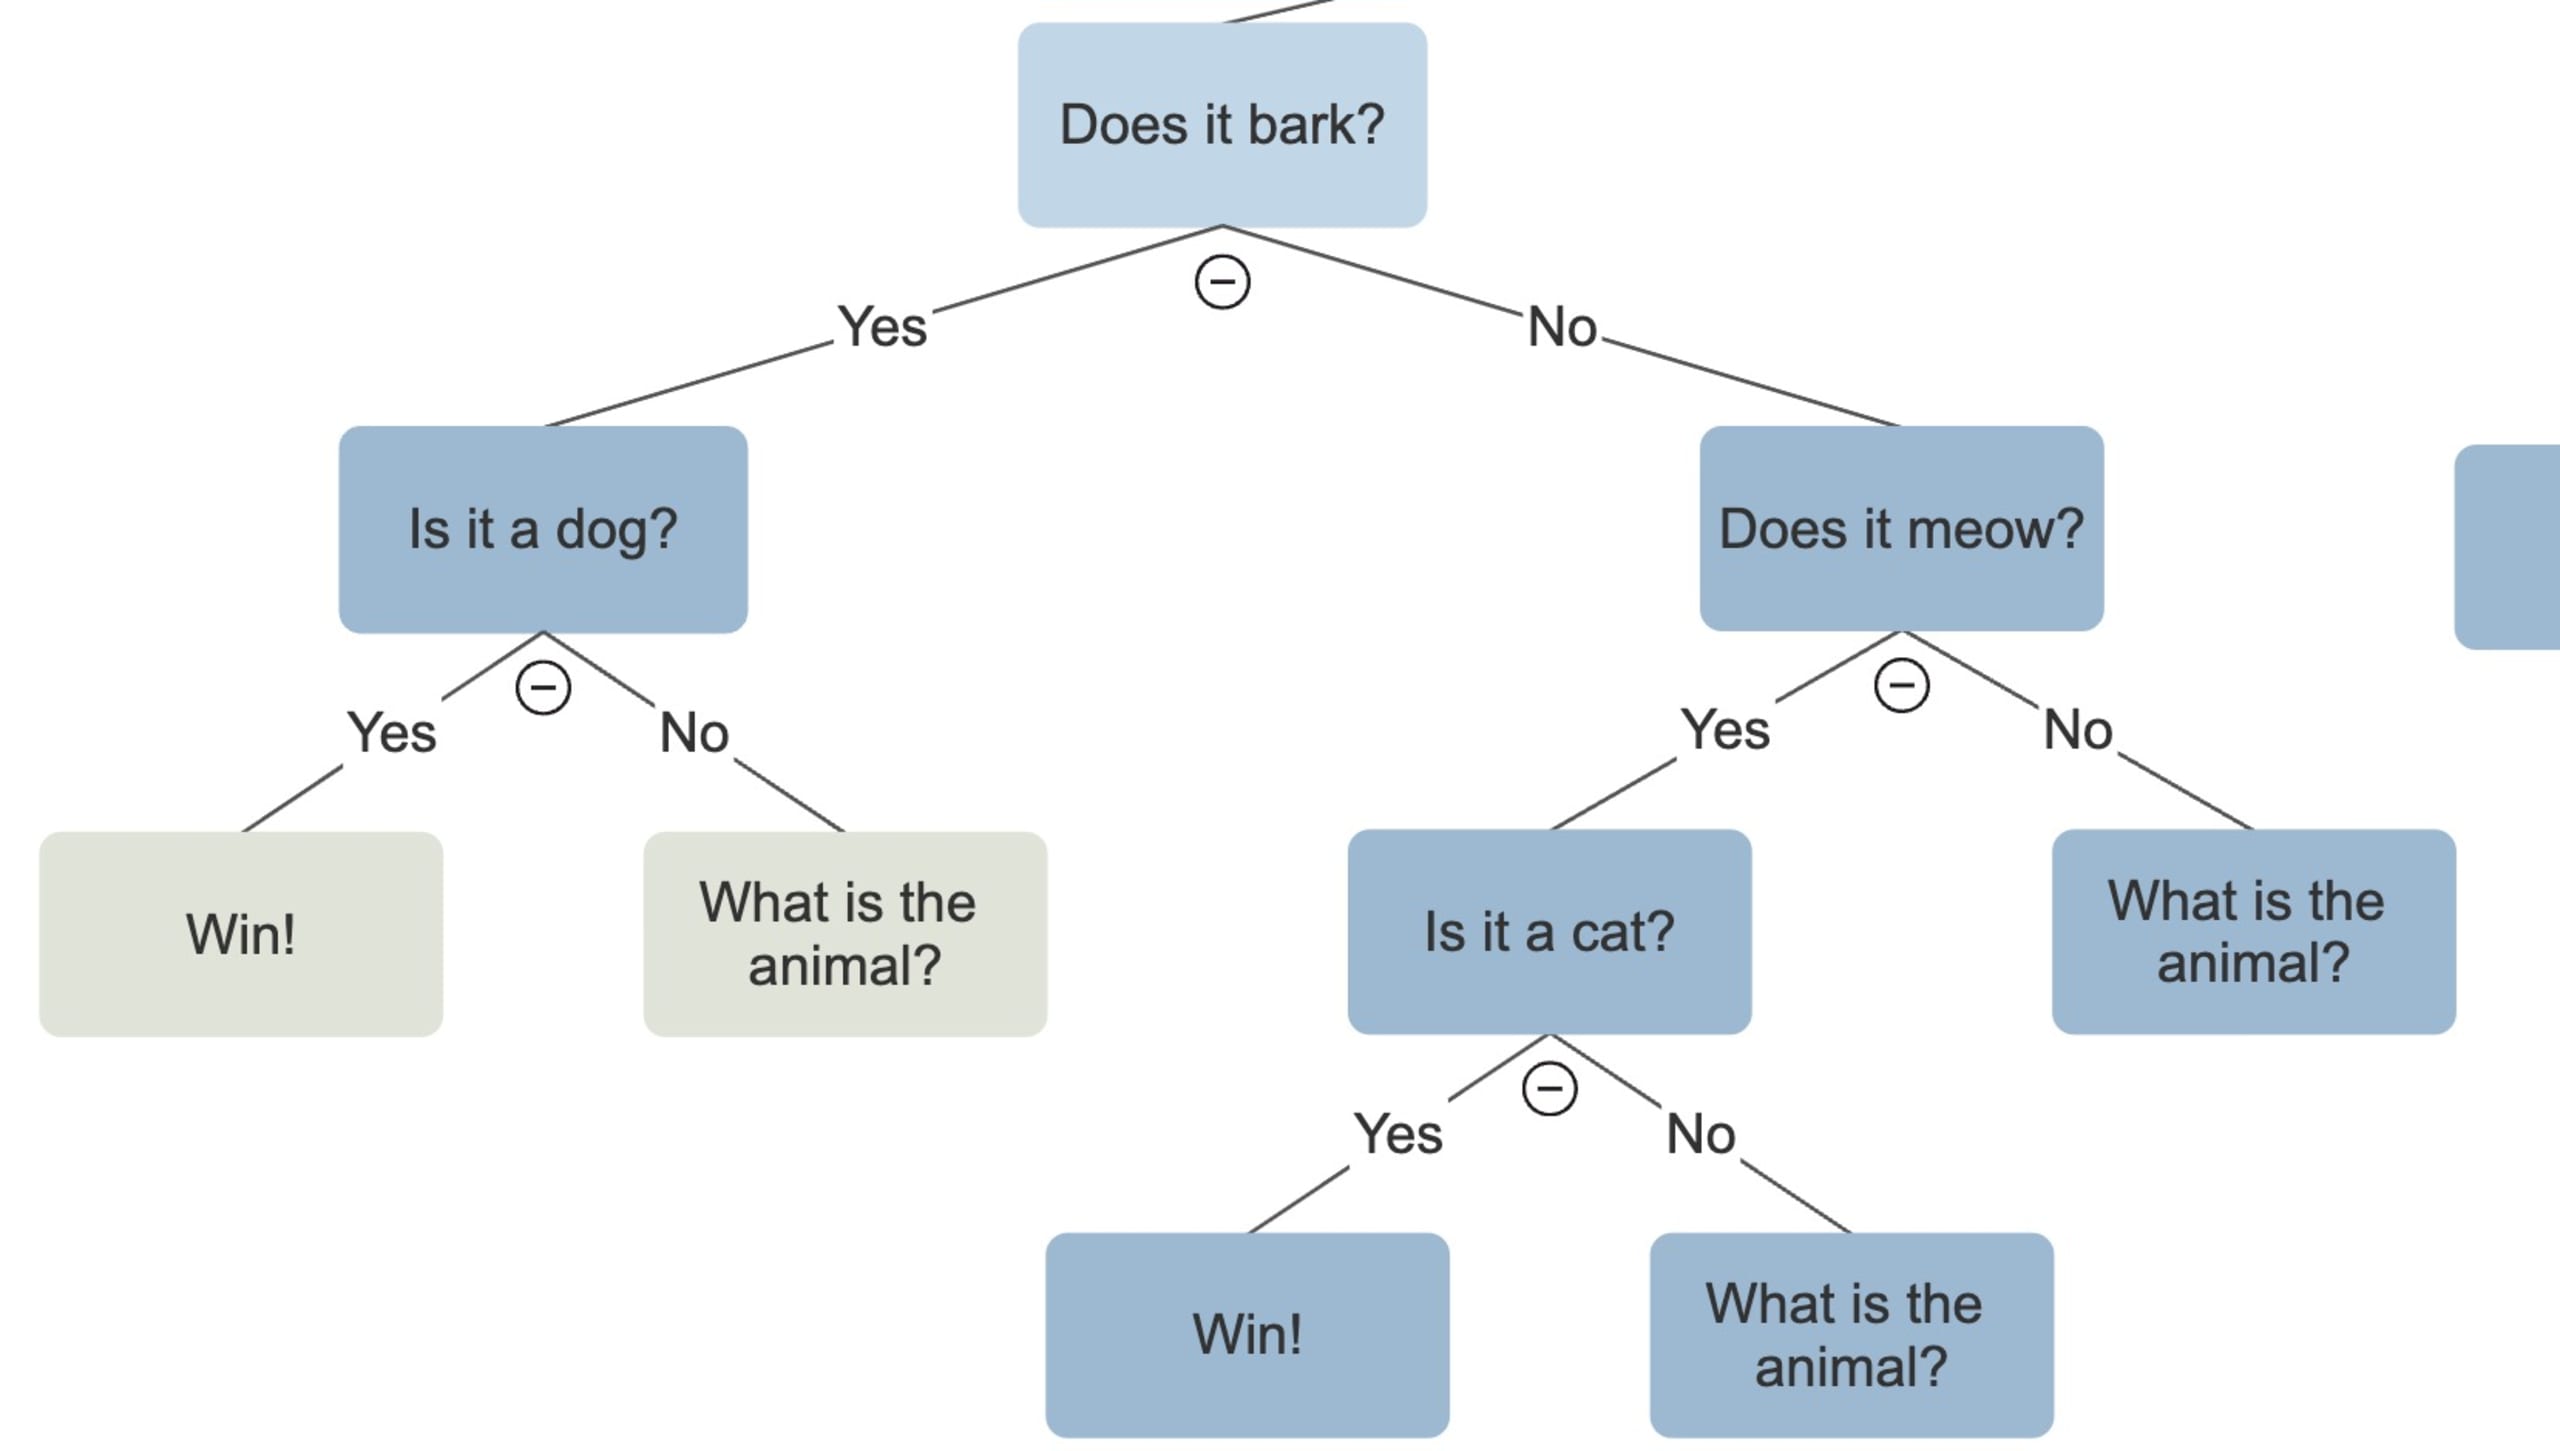
Dieses System Tier für Tier von Benutzerinnen und Benutzern aufbauen zu lassen, ist äußerst ineffizient. Aber denken Sie daran: Es handelte sich lediglich um eine Aufgabe, mit der die Studierenden Entscheidungsbäume und Expertensysteme kennenlernen sollten. Wenn eine Person das Spiel 100-mal spielt, hat das Spiel möglicherweise 100 neue Tiere gelernt. Spielt eine andere Person, stehen die Chancen gut, dass das System das Tier erkennt, an das sie gedacht hat.
Doch all das hängt von einer Sache ab – guten Daten.
Was wäre, wenn eine Benutzerin oder ein Benutzer entscheidet, dass eine Katze tatsächlich bellt, ein Pferd miaut und eine Kuh quakt? Würde das System weiterhin funktionieren? Ja. Würde es wünschenswerte Ergebnisse liefern? Nein.
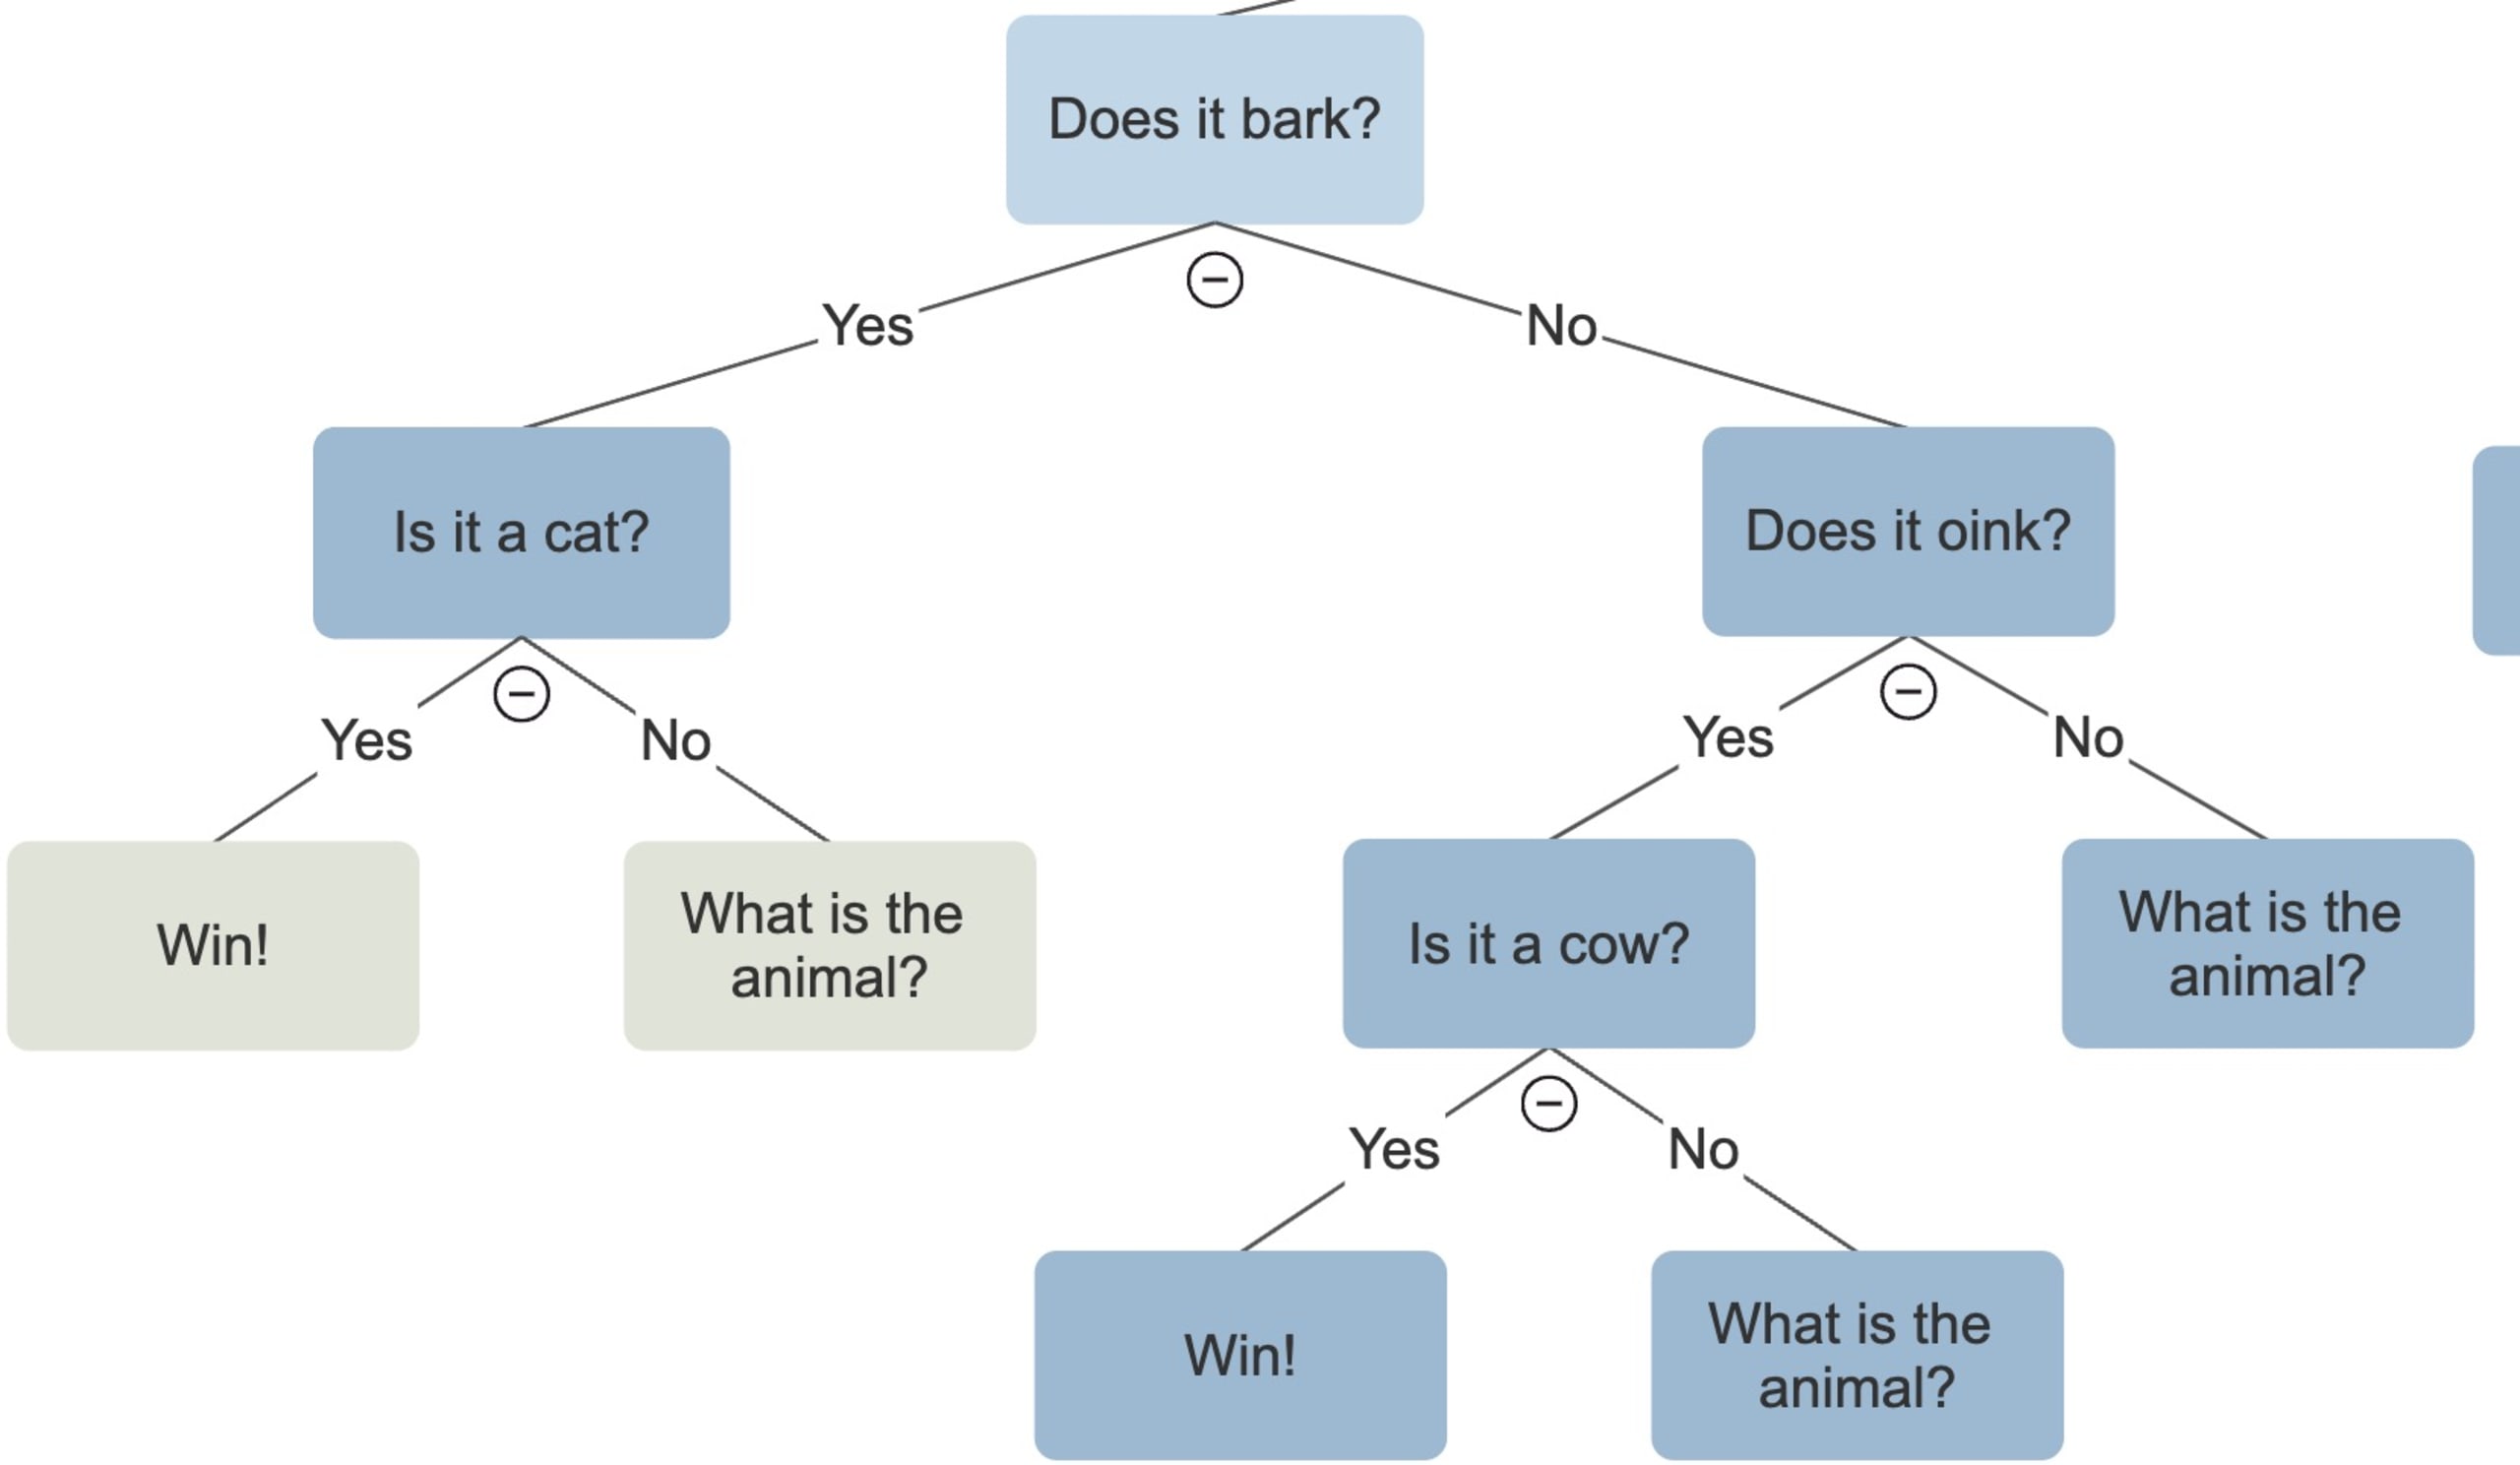
Expertensysteme (und viele andere KI-Systeme) können aufgrund unvollständiger oder voreingenommener Daten, menschlicher Eingaben und vieler weiterer Ursachen versagen. Wenn wir eine KI bitten, ein Stück Code zu generieren, greift sie dafür auf vorhandene Daten zurück (Trainingsdaten). Sind diese Daten falsch, fehlerhaft oder in irgendeiner Weise verzerrt, weist auch die Ausgabe dieselben Mängel auf.
Expertensysteme und LLMs unterscheiden sich stark voneinander. Das eine stützt sich auf eine Wissensdatenbank, das andere lernt aus Mustern und Zusammenhängen. Doch beide sind von GIGO betroffen und stark auf korrekte Daten angewiesen.
Wenn Sie ein KI-System mit minderwertigen Daten mit „Müll“ füttern, erhalten Sie „Müll“-Ergebnisse – mit möglichen Folgen für die reale Welt. Diese Folgen sehen wir bereits. Unsere Forschung hat ergeben, dass mehr als drei Viertel der Entwicklerinnen und Entwickler etablierte Protokolle umgehen, um Code-Completion-Tools zu verwenden – trotz der möglichen Risiken.
Erfahren Sie mehr über KI-Schwachstellen in den OWASP Top 10 LLM und auf unserer Security-Education-Plattform mit unseren Lektionen zu KI.