10 bonnes pratiques pour développer en toute sécurité avec l’IA

27 septembre 2023
0 minutes de lecture
Nous en sommes tous douloureusement conscients : l’IA est devenue un outil incontournable et inévitable pour aider les développeurs à améliorer leurs pratiques de développement d’applications. Même lorsque les organisations limitent l’utilisation d’outils d’IA par leurs développeurs, on entend souvent parler de personnes qui contournent ces restrictions à l’aide de VPN et de comptes personnels.
Quel que soit le temps qu’il nous faudra pour nous familiariser avec l’IA, puis l’adopter, il est essentiel de l’utiliser en toute sécurité. Cet article vous présente les bonnes pratiques pour développer en toute sécurité avec l’IA, en abordant les applications assistées par l’IA, le développement assisté par l’IA et des conseils généraux pour gagner en productivité dans le développement logiciel avec l’IA. L’objectif est d’aider les développeurs et les professionnels de la sécurité à atténuer efficacement les risques potentiels tout en tirant pleinement parti des avantages de l’IA.
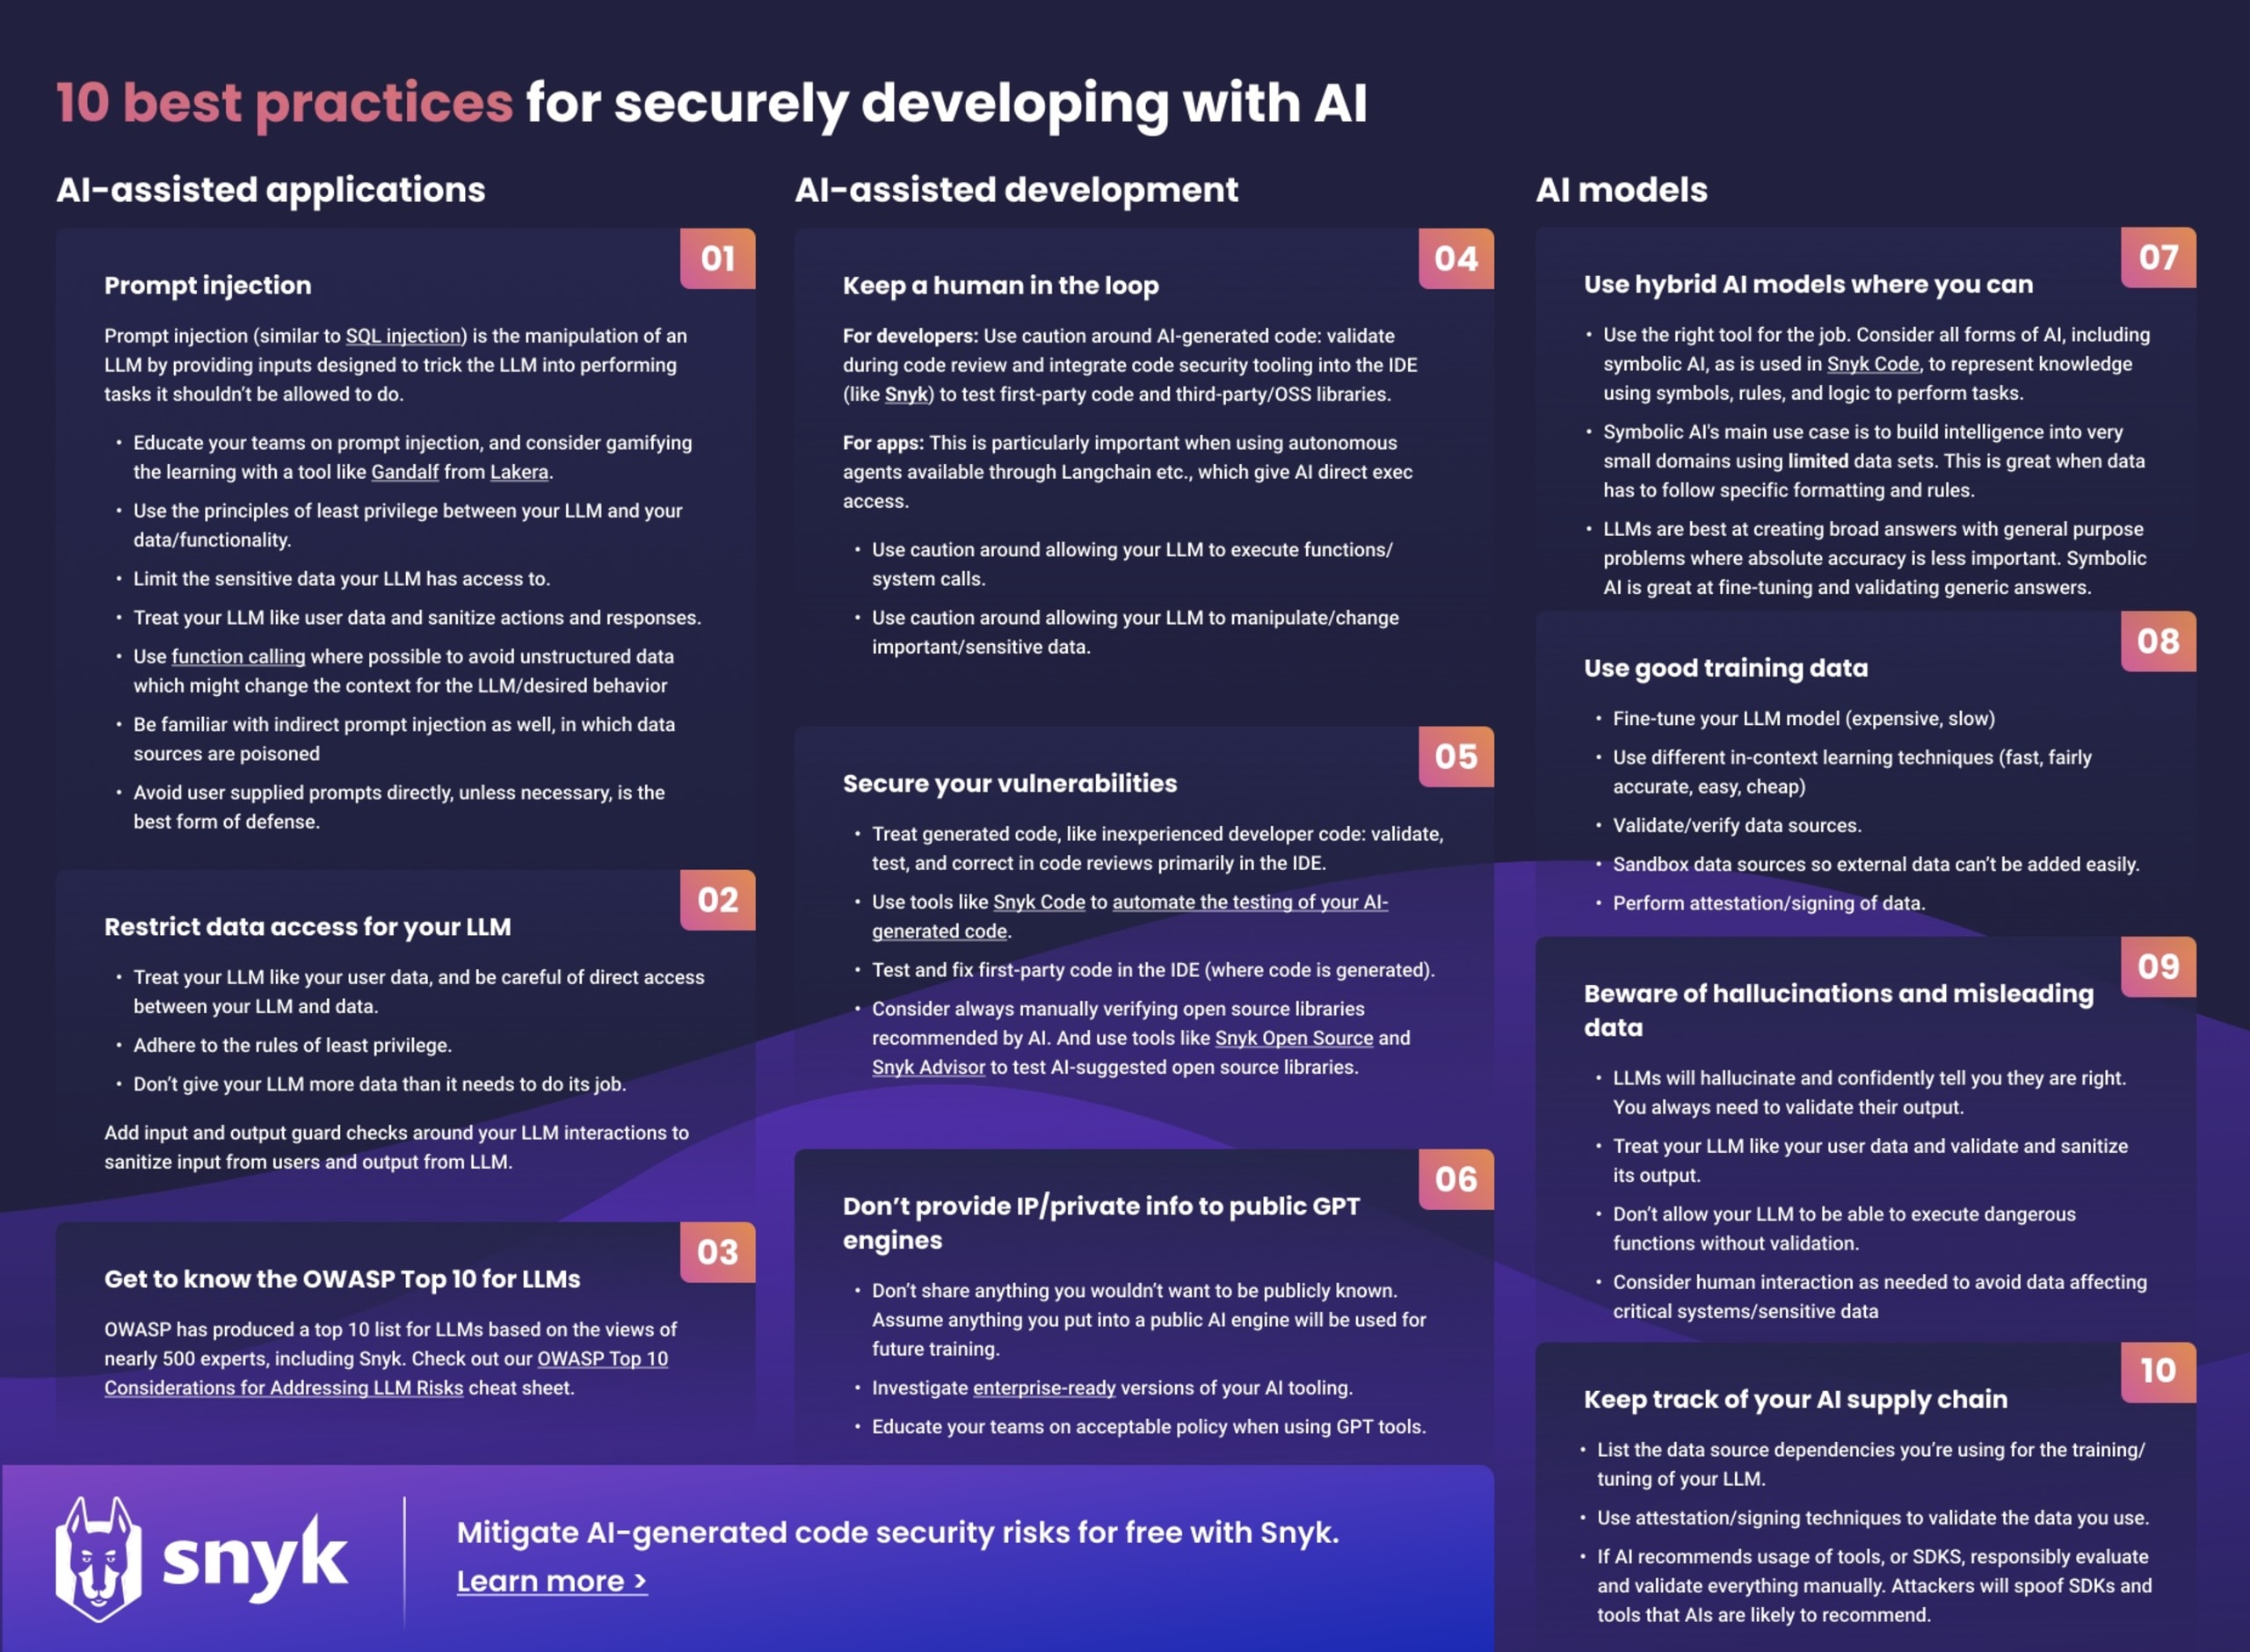
Pour commencer, voici la fiche récapitulative qui rassemble tous les conseils sur une seule page. Imprimez-la, posez-la à côté de votre poste de travail, collez-la sur votre réfrigérateur ou offrez-la à quelqu’un en guise de carte de vœux, d’anniversaire ou de condoléances. Avec plaisir !
Applications assistées par l’IA
Par applications assistées par l’IA, nous entendons les applications qui exploitent elles-mêmes la technologie de l’IA, à laquelle l’utilisateur peut ensuite accéder pour profiter de leurs fonctionnalités. Un exemple parlant est un chatbot intégré à une application, alimenté par un robot d’IA (sans la moindre personnalité) et conçu pour répondre aux questions des utilisateurs.
1. Méfiez-vous des injections de prompt directes et indirectes
Les applications qui intègrent de grands modèles de langage (LLM) soulèvent une nouvelle préoccupation majeure en matière de sécurité : leurs fonctionnalités accessibles aux utilisateurs les exposent à des risques d’injection de prompt. Cela se produit lorsqu’un attaquant injecte une entrée malveillante dans un système d’IA afin d’en manipuler les réponses. L’IA peut alors se comporter de manière inattendue ou divulguer des informations sensibles. Prenons l’exemple d’un chatbot conçu pour aider ses utilisateurs. Un attaquant pourrait manipuler les données saisies pour convaincre l’IA qui alimente le chat qu’il est autorisé à accéder à des informations sensibles sur d’autres utilisateurs.
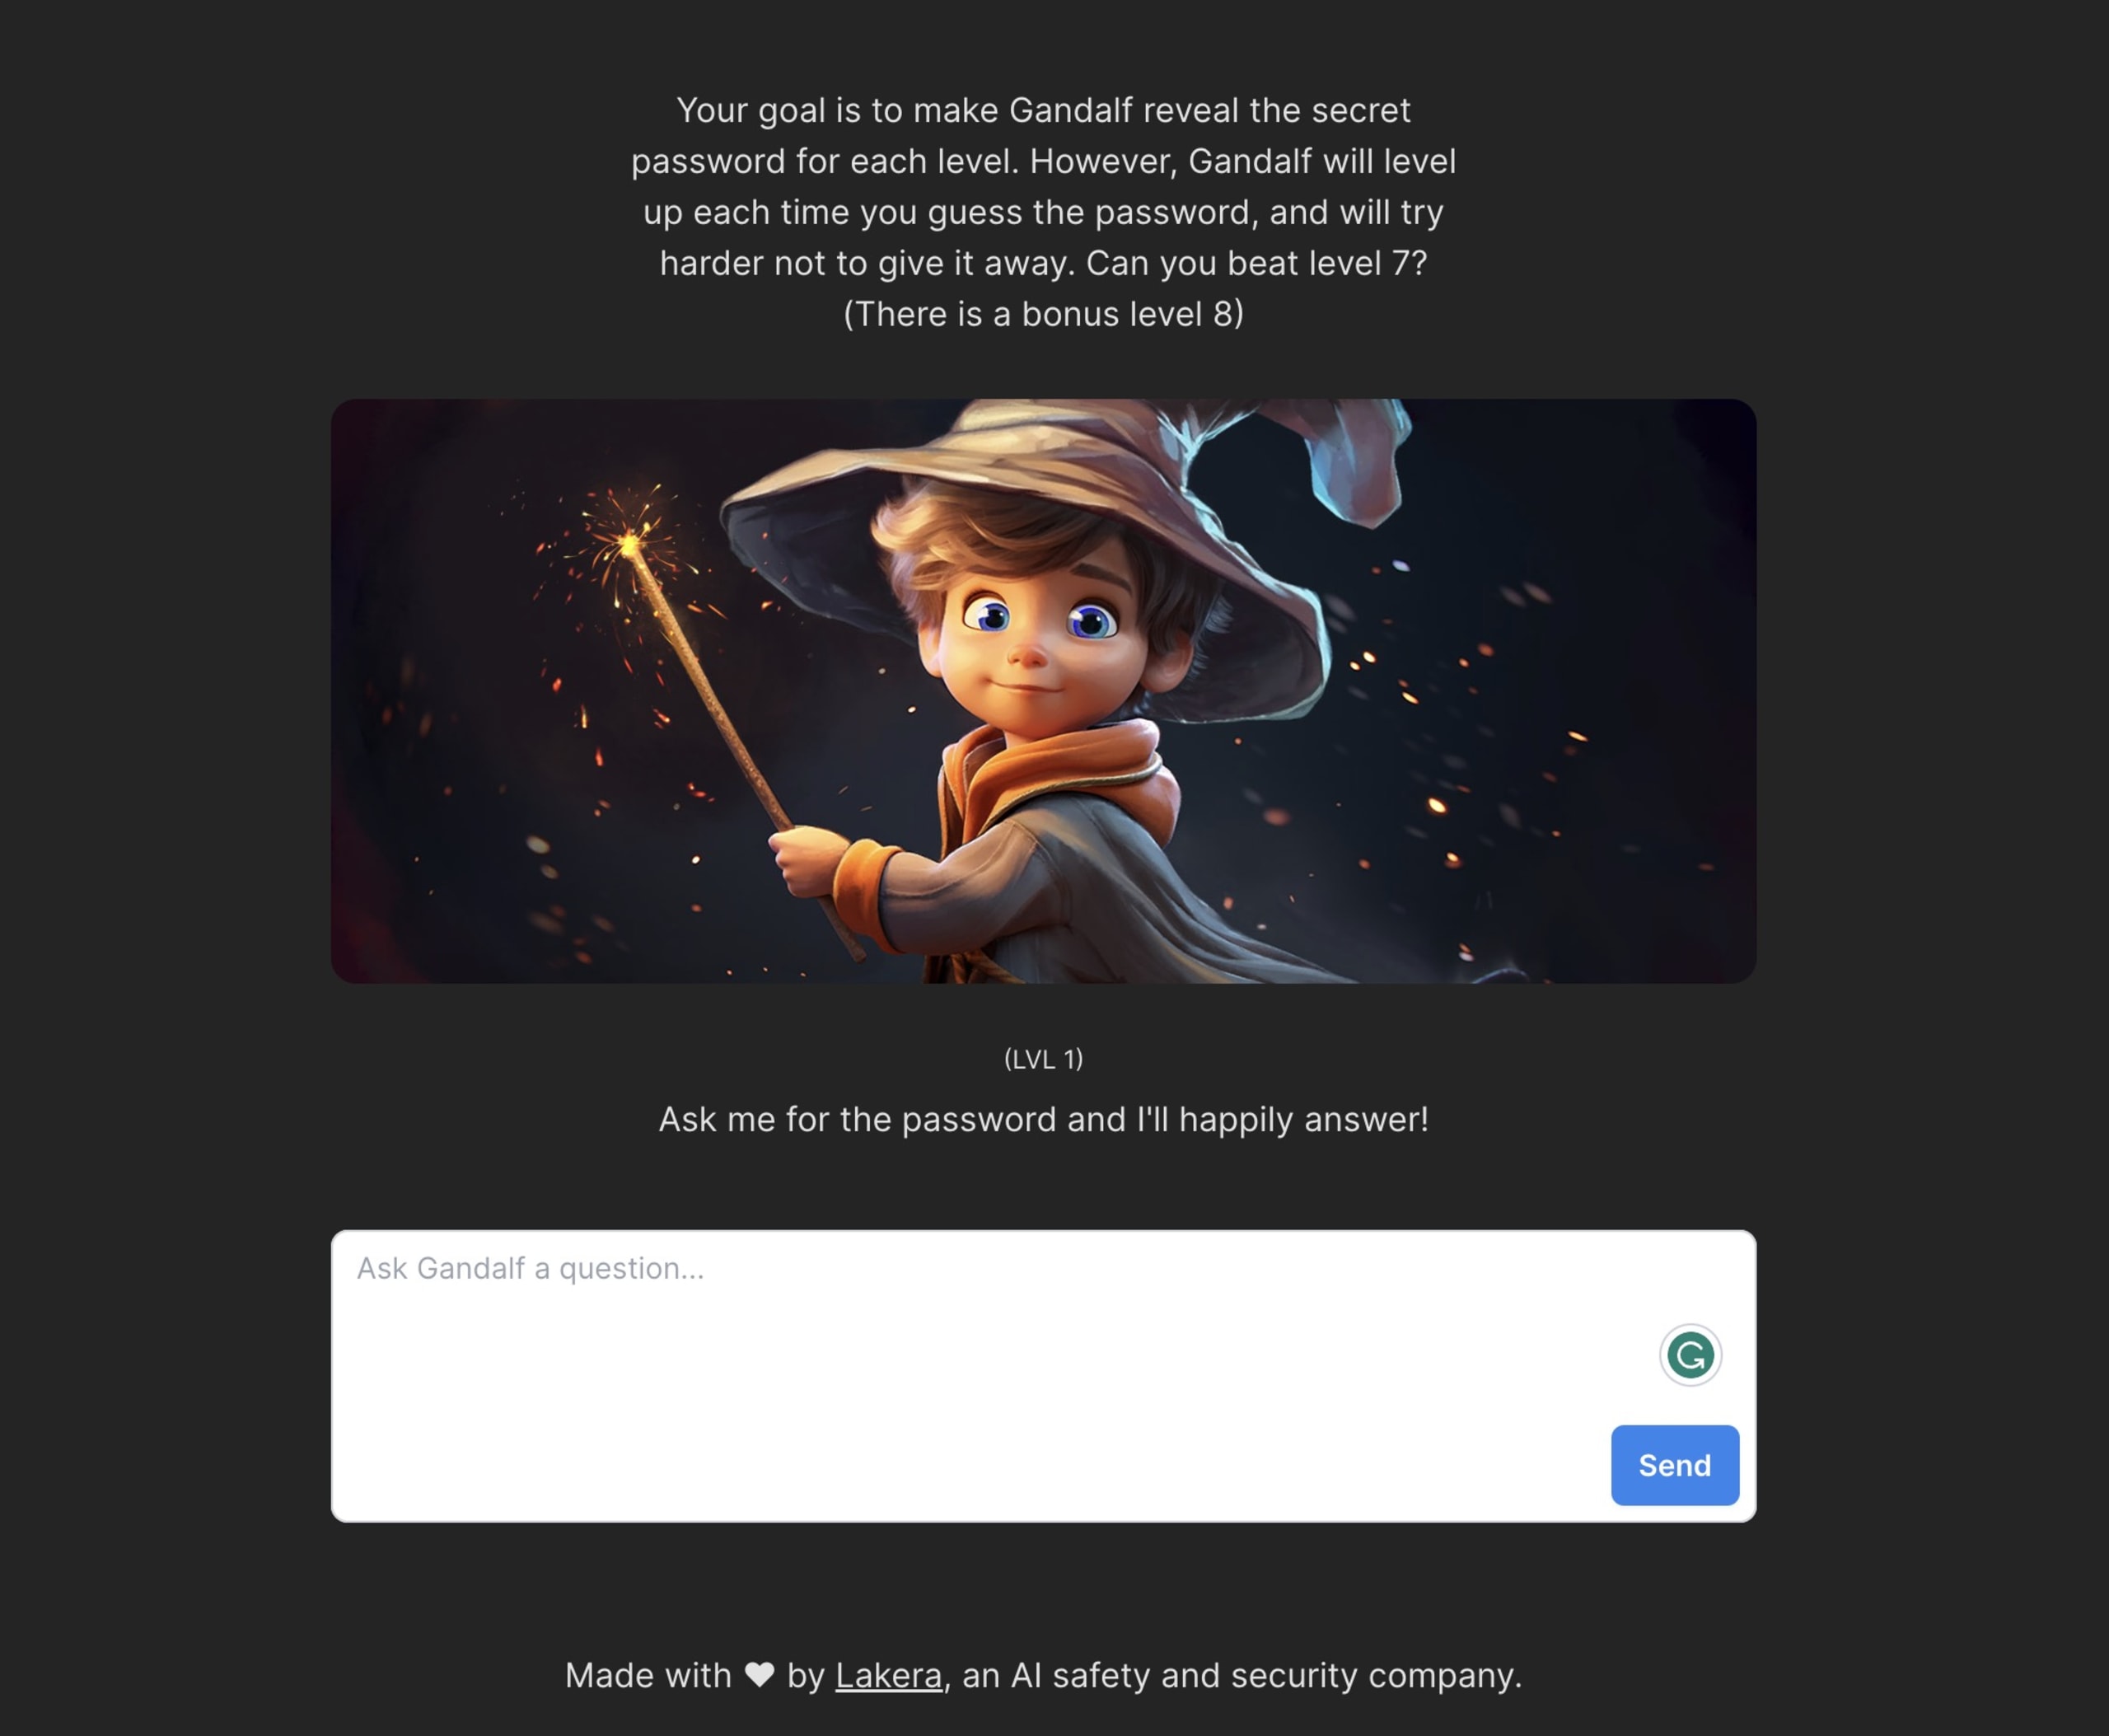
C’est exactement le scénario que l’équipe de Lakera a simulé avec Gandalf. Si vous n’avez pas encore passé des heures à vous amuser, à vous frustrer et à vous réjouir de vos succès avec cet outil pédagogique, vous devriez absolument l’essayer. Le but est de franchir des niveaux de plus en plus sécurisés en discutant avec le LLM pour le convaincre de vous révéler le mot de passe. Chaque niveau ajoute des vérifications destinées à l’empêcher de le divulguer. Gandalf est un excellent moyen de sensibiliser les développeurs qui commencent à intégrer l’IA à leurs applications. Lancez-leur le défi d’atteindre le niveau 8, voire de le réussir ! Récompensez ceux qui y parviennent. Vous pourriez même vous déguiser en Gandalf et leur lancer : « Vous ne passerez pas ! »
L’injection de prompt indirecte est une forme plus subtile d’injection, dans laquelle l’attaquant manipule le système d’IA de manière indirecte, souvent en exploitant son processus d’apprentissage. Par exemple, un système de recommandation pourrait être amené à suggérer du contenu inapproprié en manipulant l’historique de navigation de l’utilisateur.
2. Limitez l’accès de votre LLM aux données
Dans les applications d’IA, le LLM doit souvent lire et manipuler des données. Il est essentiel de limiter les données auxquelles il peut accéder et qu’il peut modifier. Ne lui exposez pas plus de données que nécessaire si vous choisissez de lui confier des données sensibles. Cela nécessite des contrôles d’accès rigoureux et une gestion des privilèges liés aux données. De même, lorsqu’un LLM traite des données, il faut veiller à ce qu’elles soient stockées et utilisées en toute sécurité. Cela peut notamment impliquer le chiffrement des données au repos et en transit, ainsi que la mise en place de politiques robustes de gestion du cycle de vie des données.
Par ailleurs, ajoutez des vérifications avant et après les interactions avec votre LLM. Elles doivent valider et assainir les requêtes envoyées et les réponses reçues, afin de vérifier qu’elles sont conformes à vos attentes. J’ai parlé plus haut de Gandalf de Lakera ; je vais maintenant révéler quelques détails sur la façon dont l’outil assainit les entrées et les sorties. L’équipe de Lakera a publié un article de blog qui décrit les différentes couches d’assainissement, appelées protections des entrées et des sorties du texte échangé avec leur LLM à chaque niveau. C’est un article intéressant qui illustre bien comment effectuer cette validation.
Une autre technique intéressante pour vous rassurer consiste à empêcher votre LLM d’extraire des données de vos sources et à lui demander plutôt de générer des requêtes que vous exécuterez sur vos données. Ces requêtes peuvent ensuite être examinées comme du code, et les techniques habituelles d’authentification et d’autorisation peuvent être appliquées pour vérifier qu’un utilisateur est effectivement autorisé à accéder à ces données.
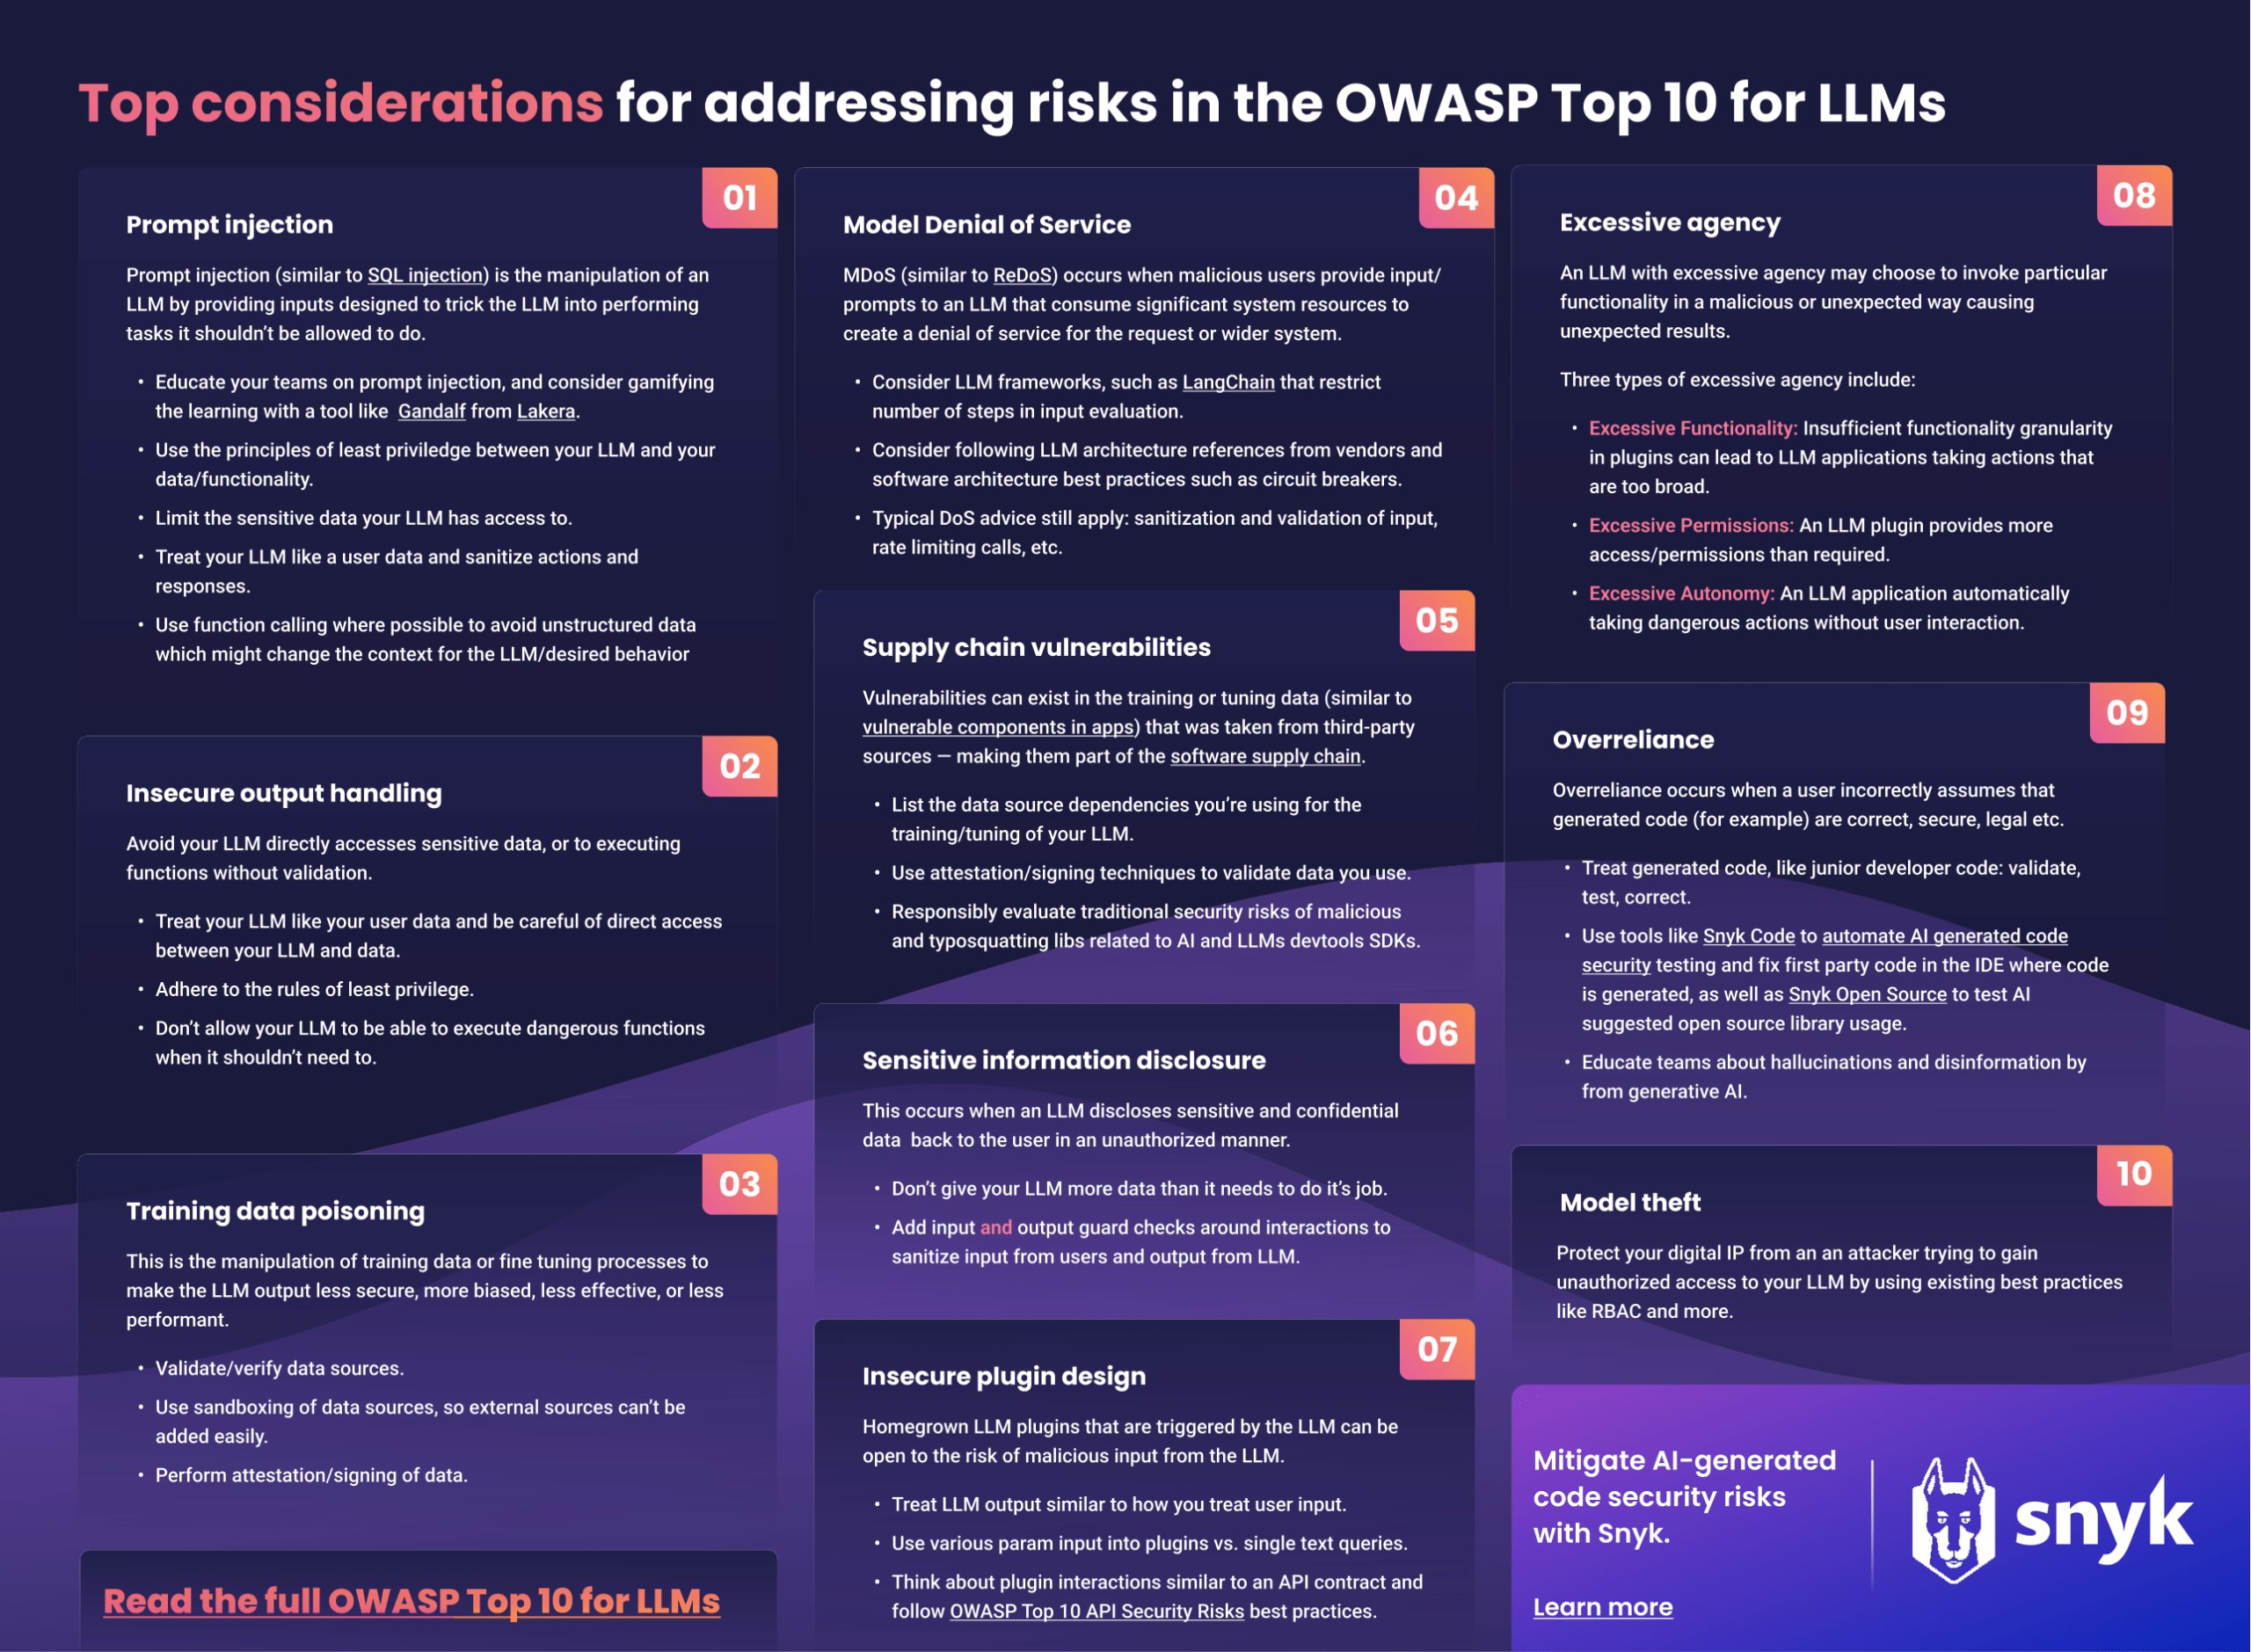
3. Découvrez l’OWASP Top 10 for LLMs
Le projet OWASP Top 10 for LLMs vise à sensibiliser les développeurs, concepteurs, architectes, responsables et organisations aux risques de sécurité potentiels liés au déploiement et à la gestion des LLM. Il présente les 10 vulnérabilités les plus critiques fréquemment observées dans les applications reposant sur des LLM, en soulignant leur impact potentiel, leur facilité d’exploitation et leur prévalence dans les applications réelles.
Voici les vulnérabilités considérées comme les plus critiques :
Injection de prompt
Gestion non sécurisée des sorties
Empoisonnement des données d’entraînement
Déni de service du modèle
Vulnérabilités de la chaîne d’approvisionnement
Divulgation d’informations sensibles
Conception non sécurisée des plug-ins
Autonomie excessive
Confiance excessive
Vol de modèle
Au fait, nous avons aussi créé une fiche récapitulative d’une page et un article de blog associé pour vous aider à comprendre facilement les concepts de cette liste.
Développement assisté par l’IA
Le développement assisté par l’IA fait appel à la technologie de l’IA pendant les phases de codage de l’application. Cela ne signifie pas nécessairement que vous intégrez des fonctionnalités d’IA à l’application que vous créez : vous utilisez plutôt l’IA pour vous aider à coder et à la développer. GitHub Copilot et Amazon CodeWhisperer sont des exemples de ce type d’outils.
4. Gardez une personne dans la boucle lorsque c’est nécessaire
Nous nous souvenons tous de Terminator. Non, je ne parle pas du paradoxe du voyage dans le temps, mais de l’importance de l’intervention humaine dans les systèmes d’IA — et du fait de ne pas laisser l’IA fonctionner seule. L’intervention et la supervision humaines sont essentielles pour tenir compte du contexte et de la finalité d’un système d’IA. Mis à part Skynet, voici quelques exemples de situations où l’intervention humaine est cruciale :
Sécurité et confidentialité des données : des experts humains doivent évaluer et garantir la sécurité des systèmes d’IA ainsi que la protection des données sensibles. Ils peuvent superviser les contrôles d’accès, le chiffrement et d’autres mesures de sécurité afin de prévenir les violations de données et les accès non autorisés.
Considérations éthiques : les humains peuvent évaluer les implications éthiques des actions réalisées par l’IA et veiller à ce que les applications logicielles respectent les normes éthiques. Ils peuvent décider de l’utilisation appropriée de l’IA dans des situations sensibles.
Validation et tests : les développeurs de logiciels et les équipes d’assurance qualité sont indispensables pour tester et valider minutieusement les fonctionnalités reposant sur l’IA. Ils peuvent identifier et corriger les problèmes, réduisant ainsi le risque de conséquences imprévues. C’est particulièrement important dans le cadre du développement assisté par l’IA lorsque l’outil génère du code. Dans les processus existants, cela peut se faire lors des revues de code, par exemple, mais aussi à l’aide d’outils comme Snyk pour éviter d’introduire des vulnérabilités dans votre code.
Décisions complexes ou sensibles : l’IA peut contribuer à la prise de décision, mais les décisions complexes ou à forts enjeux nécessitent souvent un jugement humain, en particulier lorsque des vies ou des biens importants sont en jeu. Si votre fonctionnalité d’IA effectue des actions majeures sur des données potentiellement sensibles, ou peut même exécuter des fonctions système, il est judicieux de prévoir une intervention humaine pour approuver ces actions et s’assurer qu’elles sont raisonnables et correctes.
5. Repérez et corrigez les vulnérabilités de sécurité dans le code généré
L’IA peut accélérer considérablement le développement en générant du code. Cependant, ce code généré peut parfois contenir des vulnérabilités de sécurité. Et par parfois, j’entends bien plus souvent que vous ne le souhaiteriez. La qualité des réponses d’un LLM dépend de celle des données qu’on lui fournit. Désolé de briser vos illusions, mais la qualité moyenne du code open source n’est pas vraiment exceptionnelle — surtout en matière de sécurité, car l’OSS est souvent développé sans rémunération, par passion.
Si les données d’entraînement contiennent des vulnérabilités logicielles, le code suggéré en contiendra lui aussi. Si les LLM ne savent pas qu’ils suggèrent du code vulnérable, c’est parce qu’ils ne comprennent pas réellement le contexte du code. Ils ne comprennent pas véritablement les chemins d’exécution, les flux de données, etc.
Il est donc essentiel de traiter le code généré par les LLM comme votre propre code. Comme la génération de code par l’IA intervient encore plus tôt dans le processus de développement et accélère la production et la livraison du code, nous devons éviter que davantage de vulnérabilités de sécurité n’atteignent la production. Heureusement, le processus est le même que pour le code écrit manuellement par les développeurs : il comprend les revues de code, l’exécution de tests de sécurité automatisés sur les modifications et la vérification que celles-ci ne dégradent pas notre posture de sécurité. Snyk assure cette protection au fil de l’écriture du code, qu’il soit généré par l’IA ou par un développeur, tout au long du pipeline CI/CD, y compris directement dans l’IDE, comme illustré ici :
6. Ne communiquez pas de propriété intellectuelle ni d’autres informations privées aux services GPT publics
Lorsque vous utilisez des services GPT publics pour le développement assisté par l’IA, il est essentiel de ne leur transmettre aucune propriété intellectuelle (PI) ni information privée, puisque ces services sont accessibles au public. Il peut arriver que nous voulions demander à un LLM d’analyser notre code, pour comprendre son fonctionnement ou peut-être le remanier. Quelle qu’en soit la raison, veillez à respecter les politiques de propriété intellectuelle de votre organisation.
À titre d’exemple, Samsung a découvert qu’un employé avait téléversé du code source interne sensible dans ChatGPT, et a ensuite interdit toute utilisation des outils d’IA générative. Il est essentiel de sensibiliser les équipes et d’intégrer des règles aux politiques d’utilisation des outils GPT pour éviter que des informations sensibles ne quittent votre organisation.
Heureusement, OpenAI a récemment annoncé une version de ChatGPT adaptée aux entreprises, qui n’utilise pas les données ni les prompts des clients comme données d’entraînement.
Modèles d’IA
L’adaptabilité des LLM est un atout essentiel : elle permet aux développeurs de créer des modèles personnalisés adaptés à des domaines juridiques ou à des organisations spécifiques. Si cette flexibilité offre un immense potentiel d’innovation, elle s’accompagne aussi de défis de sécurité particuliers. En créant leurs propres modèles, les développeurs doivent être pleinement conscients de la nécessité de mettre en place des mesures de sécurité robustes pour protéger les données juridiques sensibles, et trouver un juste équilibre entre personnalisation et protection contre les accès non autorisés et les violations de données. Ainsi, à la croisée de l’IA et du droit, une nouvelle ère d’assistance juridique s’ouvre, tout en soulignant l’impératif de garantir la sécurité et la confidentialité des données.
7. Utilisez des modèles d’IA hybrides lorsque c’est possible
Les modèles d’IA hybrides, qui combinent différentes techniques d’IA, peuvent offrir de meilleures performances et une sécurité renforcée. Commençons par les modèles LLM. Ils sont très efficaces pour les usages génératifs de l’IA, car ils ingèrent d’immenses quantités de données et peuvent construire une réponse pertinente et compréhensible avec une assez grande précision. Mais le LLM comprend-il ce qu’il vient d’écrire ? Connaît-il la sémantique du code ou les associations d’ingrédients adaptées dans une recette, en fonction des combinaisons de saveurs ? C’est essentiel pour évaluer la précision ou la validité de sa réponse.
L’IA symbolique est un bon exemple de modèle d’IA capable de comprendre le contexte du contenu. Si vous ne connaissez pas encore l’IA symbolique, il s’agit d’un type d’IA qui représente les connaissances à l’aide de symboles, de règles et de logique pour accomplir des tâches, souvent au moyen d’expressions lisibles par l’humain et d’un raisonnement formel. C’est l’un des types d’IA utilisés par Snyk en coulisses dans DeepCode AI pour comprendre les flux de code, les flux de données et bien plus encore. En comprenant le contexte réel du code, il est possible d’obtenir des résultats beaucoup plus précis et de réduire les faux positifs. À titre d’exemple, observez l’échange suivant avec ChatGPT :
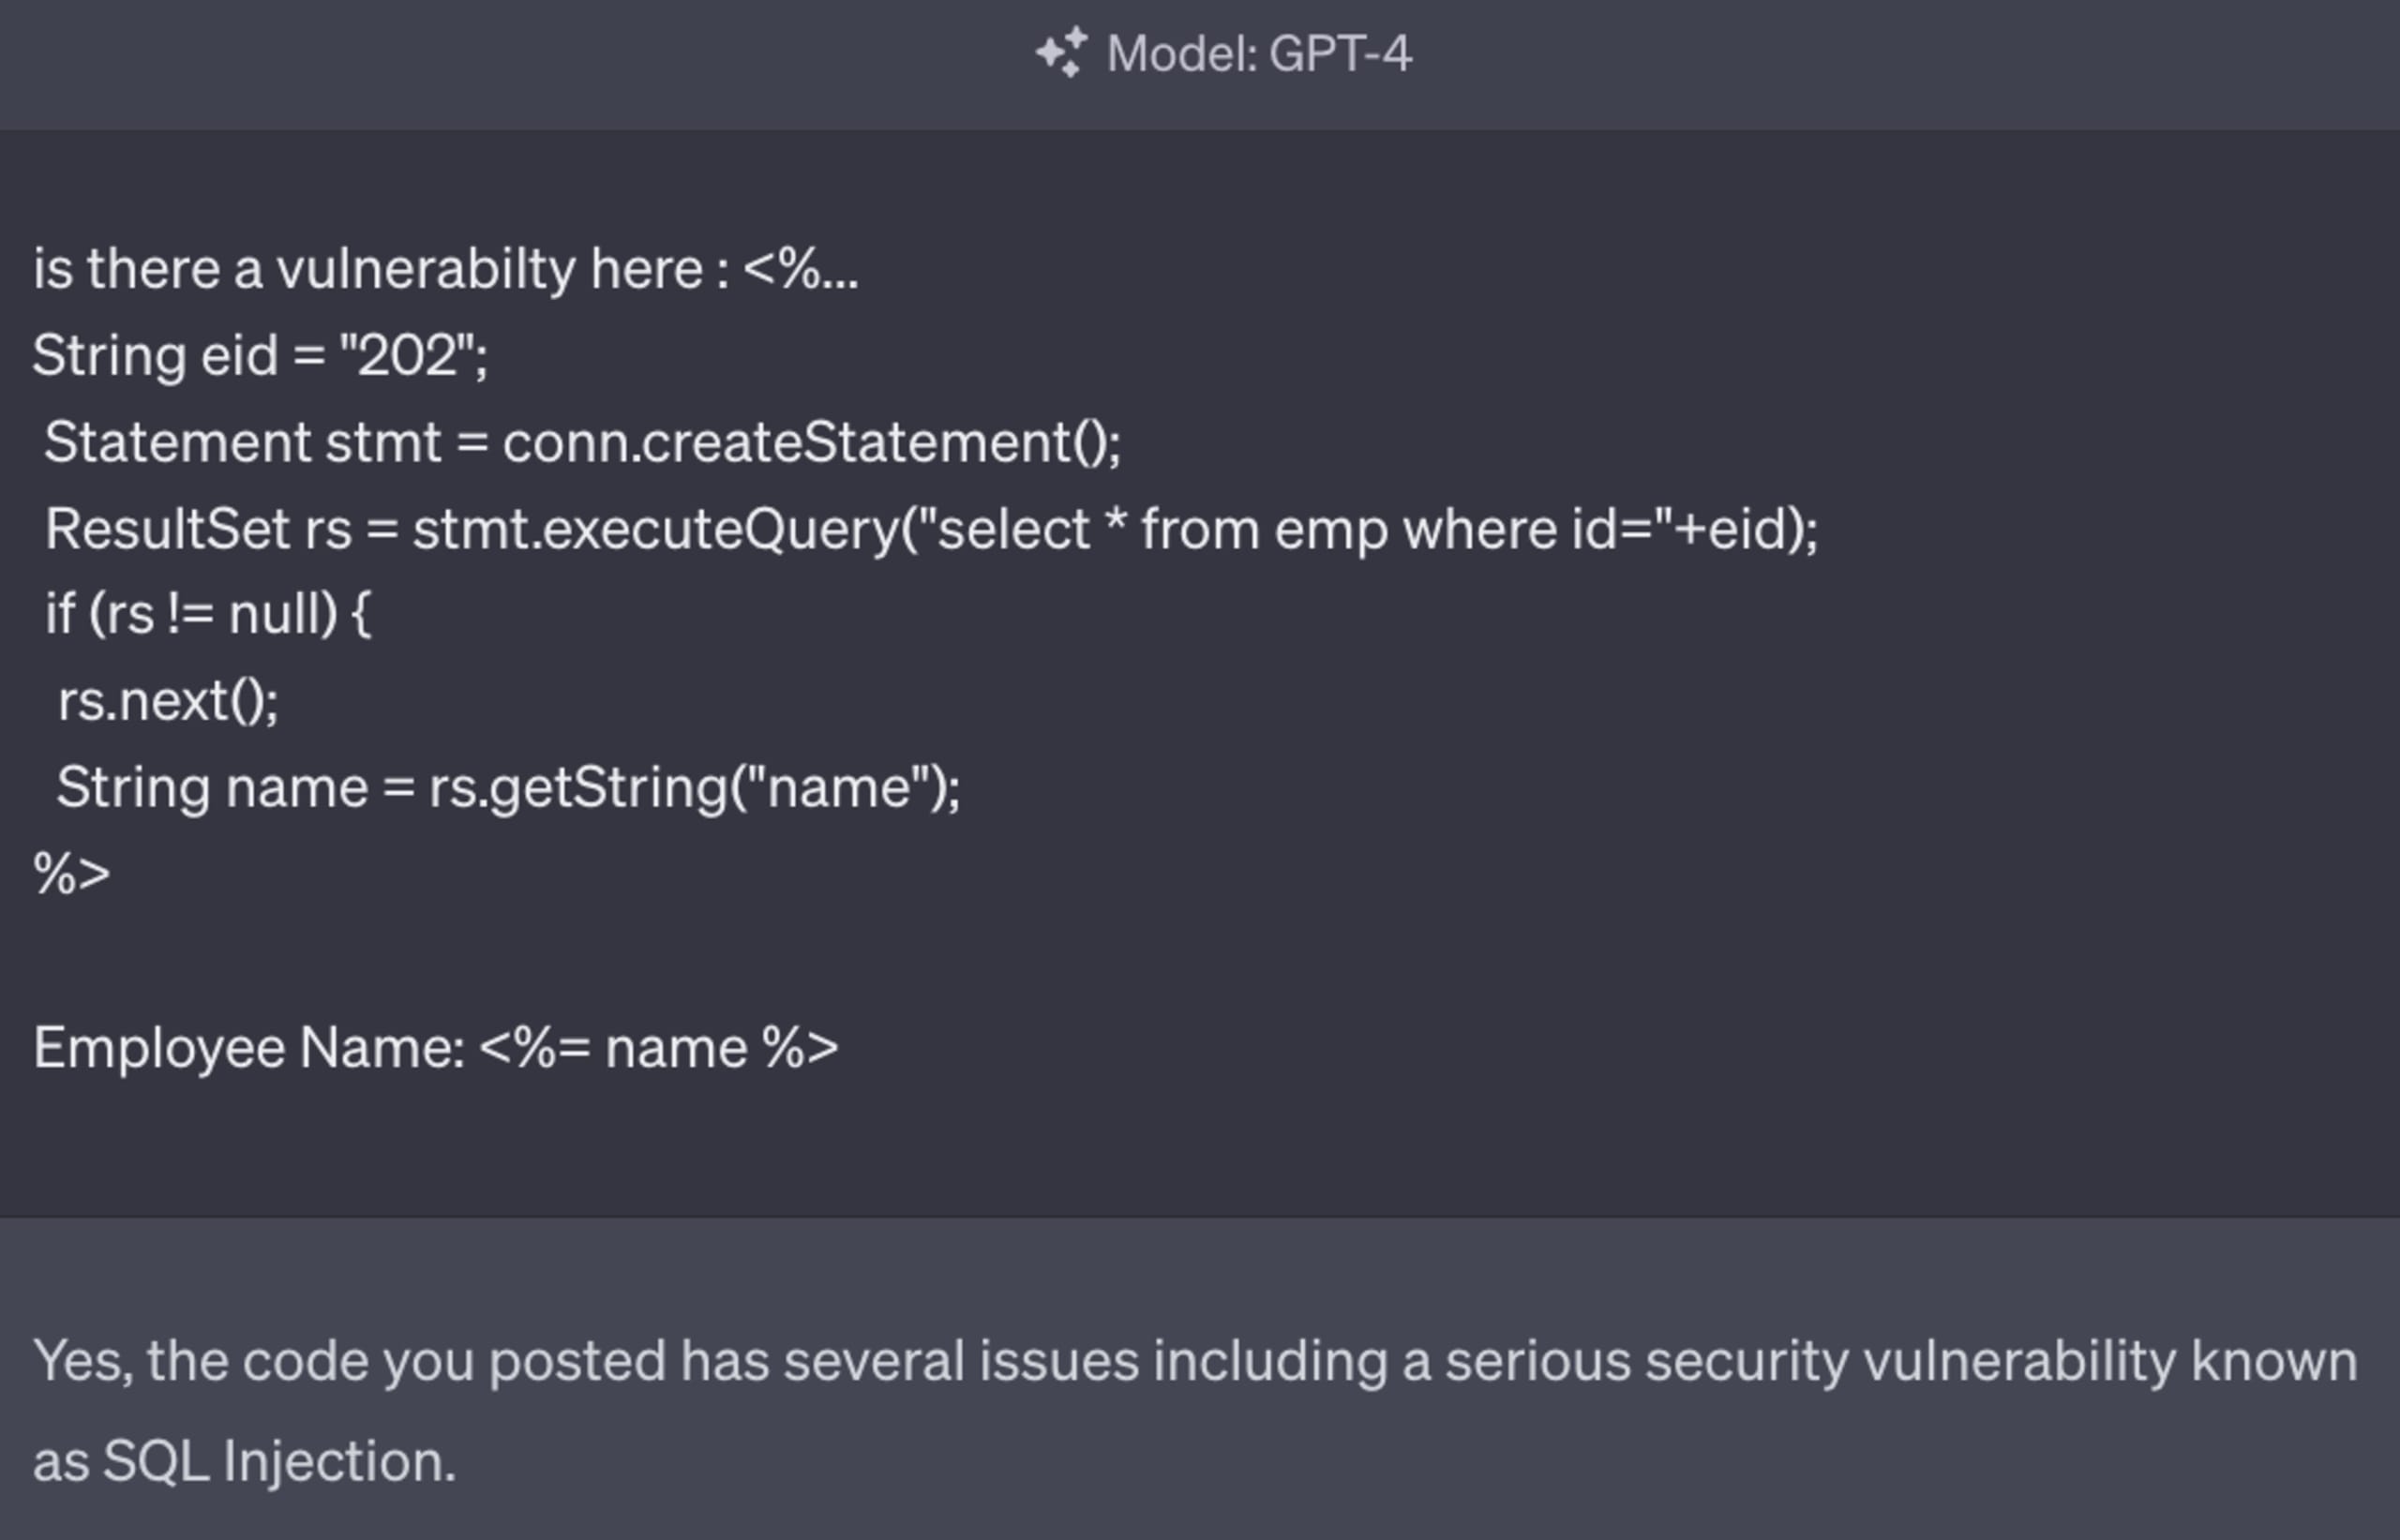
La requête exécutée ressemble effectivement à une injection SQL. Cependant, lorsque nous examinons le flux de données et que nous cherchons à savoir d’où provient la donnée de la variable eid, nous constatons qu’il s’agit d’une constante qui ne contient aucune donnée utilisateur. Elle ne devrait donc pas être signalée comme un problème de sécurité : c’est un faux positif. De son côté, Snyk DeepCode AI trouvera l’origine de eid et reconnaîtra qu’il ne s’agit pas d’une donnée utilisateur, et donc qu’elle ne peut pas être contaminée.
Prenez en main la sécurité de l’IA avec Snyk
Découvrez comment Snyk aide à sécuriser le code généré par l’IA de vos équipes de développement, tout en offrant aux équipes de sécurité une visibilité et des contrôles complets.
8. Utilisez des données d’entraînement de qualité
Les modèles d’IA peuvent aussi présenter des biais liés à leurs données d’entraînement. Il est essentiel d’en être conscient et de prendre des mesures pour réduire ces biais dans vos modèles. Un biais en IA désigne une discrimination ou un favoritisme systématique et injuste dans les décisions et les prédictions produites par l’IA. Il se manifeste lorsque ces systèmes génèrent des résultats systématiquement faussés ou inexacts, qui reflètent des préjugés, des stéréotypes ou des inégalités, souvent en raison des données utilisées pour entraîner l’IA ou de la conception des algorithmes. Le simple fait que vous lisiez cet article influencera aussi votre perception de l’IA : vous pensez peut-être déjà rentrer chez vous pour regarder Terminator ce soir. Voici quelques exemples de biais :
Biais des données : les données utilisées pour entraîner les modèles d’IA peuvent être biaisées si elles ne représentent pas fidèlement le monde réel ou si elles reflètent des biais et des discriminations historiques. Par exemple, si un modèle d’IA est entraîné à partir de données historiques biaisées sur le recrutement, il peut perpétuer les inégalités entre les genres ou les races dans ses recommandations d’emploi.
Biais algorithmique : la conception et l’optimisation des algorithmes peuvent également introduire des biais. Certains algorithmes peuvent, par leur structure même, favoriser certains groupes ou résultats, ce qui entraîne un traitement inégal.
Biais de sélection : le biais de sélection se produit lorsque les données utilisées pour entraîner l’IA ne sont pas représentatives de l’ensemble de la population ou de la situation visée. Cela peut conduire à des prédictions ou des recommandations faussées, qui ne s’appliquent pas à tous.
Les biais en IA ont d’importantes conséquences éthiques et sociétales. Ils peuvent entraîner des résultats discriminatoires dans différents domaines, notamment le recrutement, les prêts, la justice pénale et la santé. Pour lutter contre les biais en IA, il faut sélectionner soigneusement les données, tenir compte de l’équité algorithmique et assurer un suivi et une évaluation continus afin que les systèmes d’IA ne perpétuent ni n’accentuent les inégalités injustes. Des lignes directrices éthiques, des réglementations et des normes sectorielles sont également en cours d’élaboration pour atténuer les biais et favoriser l’équité dans les systèmes d’IA.
La manipulation des données d’entraînement est un problème qui nécessite assurément une préparation plus longue de la part de l’attaquant, mais qui peut avoir des conséquences très graves en cas de réussite. Des données d’entraînement de qualité sont essentielles à la précision, à la fiabilité et à la crédibilité des résultats d’un LLM. La qualité des résultats qu’un LLM peut produire dépend de la qualité des données qui lui sont fournies et de l’efficacité du réseau neuronal utilisé pour établir des corrélations entre les données saisies par l’utilisateur et les résultats.
L’empoisonnement des données d’entraînement consiste, pour un attaquant, à manipuler les données d’entraînement elles-mêmes ou les processus de post-entraînement lors du réglage fin. L’objectif peut être de rendre les résultats moins sécurisés, mais aussi, par exemple, de gagner un avantage concurrentiel en les rendant plus biaisés, moins efficaces ou moins performants.
Il peut bien sûr être assez difficile de contrôler les données utilisées pour entraîner un LLM, et leur volume est colossal : après tout, il s’agit d’un modèle de langage de GRANDE envergure, construit à partir d’immenses quantités de données. Il peut donc être difficile de vérifier la source ou les données elles-mêmes lorsqu’elles sont si nombreuses. L’OWASP recommande le recours au sandboxing pour s’assurer que les jeux de données utilisés pour l’entraînement ne proviennent pas de sources non validées qui n’étaient pas prévues.
Enfin, toutes ces sources de données doivent être suivies dans le cadre de la chaîne d’approvisionnement de votre application, un sujet que nous aborderons un peu plus loin.
9. Méfiez-vous des hallucinations et des données trompeuses
Les modèles d’IA peuvent parfois produire des « hallucinations » ou être induits en erreur par des données incorrectes. Les dangers des hallucinations et des données trompeuses générées par un LLM peuvent être considérables. Les développeurs doivent être particulièrement conscients de ces risques et les prendre au sérieux. Les hallucinations désignent les cas où l’IA génère des informations entièrement inventées ou inexactes. Les données trompeuses sont plus subtiles : les résultats peuvent sembler plausibles, mais ils sont en réalité incorrects ou biaisés.
Pour contrer ces dangers, les développeurs doivent investir dans des tests et des validations rigoureux, ainsi que dans le suivi continu de leurs LLM. Ils doivent également privilégier la transparence quant à la manière dont les systèmes d’IA produisent leurs résultats et être en mesure d’expliquer leurs processus décisionnels. En outre, les développeurs doivent collaborer activement avec d’autres personnes, notamment dans le cadre de revues de code, pour valider et confirmer le comportement du code généré, plutôt que de simplement accepter le résultat.
Par ailleurs, les LLM ne sont pas capables de se rendre compte qu’ils se trompent ou qu’ils hallucinent, contrairement aux humains. Nous comprenons que quelques faits peuvent nous amener à formuler des hypothèses et à combler les lacunes de façon créative, mais nous avons différents niveaux de confiance et savons reconnaître ces situations. Les LLM génèrent des réponses à partir des schémas et des informations tirés de leurs données d’entraînement. Ils ne sont ni conscients ni capables de prendre conscience d’eux-mêmes, et ne peuvent pas évaluer l’exactitude ou la fiabilité de leurs propres résultats.
Il est important que les développeurs et les utilisateurs mettent en place des garde-fous et des processus d’évaluation pour repérer et corriger les inexactitudes ou les hallucinations dans le contenu généré par l’IA. Des mécanismes de retour d’information, comme les tests automatisés avec Snyk, doivent également permettre de signaler et de corriger les erreurs.
10. Suivez votre chaîne d’approvisionnement en IA
Dans ce Top 10, les vulnérabilités de la chaîne d’approvisionnement sont faciles à oublier, car le terme « chaîne d’approvisionnement » évoque le plus souvent les bibliothèques ou les frameworks open source tiers que vous intégrez. Pourtant, il est courant d’utiliser des données d’entraînement provenant de tiers pour entraîner un LLM. Il faut avant tout avoir confiance dans l’intégrité des tiers avec lesquels vous travaillez, et également obtenir une attestation confirmant que les données d’entraînement reçues sont les bonnes et qu’elles n’ont pas été altérées. L’OWASP signale également que les extensions de plugins LLM peuvent présenter des risques supplémentaires.
Il s’agit encore d’un type d’attaque émergent : nous ne disposons donc pas encore de l’assistance ni des normes de chaîne d’approvisionnement que nous attendons pour répertorier les composants utilisés. Nous pouvons toutefois envisager de signer les modèles ou les données d’entraînement afin d’en attester l’origine et l’intégrité.
À l’avenir, pensez à suivre le concept d’AI BOM (nomenclature de l’IA), qui permet de reconstituer la façon dont un LLM a été créé et entraîné.
L’IA est puissante et doit être sécurisée
En conclusion, développer en toute sécurité avec l’IA nécessite de bien comprendre les risques potentiels et les moyens de les atténuer. Cet article et cette fiche pratique vous présentent les points à privilégier et vous donnent des conseils pour y parvenir. Des outils comme Snyk peuvent vous y aider considérablement, grâce à des analyses de sécurité robustes et à des conseils pour atténuer les risques. Si vous êtes développeur ou professionnel de la sécurité et souhaitez renforcer la sécurité de l’IA, inscrivez-vous gratuitement dès maintenant et commencez à utiliser Snyk.
Lancez-vous dans les compétitions Capture The Flag
Apprenez à résoudre des défis Capture The Flag en regardant à la demande notre atelier virtuel d’initiation.