Principaux points à prendre en compte pour gérer les risques de l’OWASP Top 10 for LLMs

7 septembre 2023
0 minutes de lectureBienvenue dans notre fiche pratique consacrée à OWASP Top 10 for LLMs. Si vous n’avez jamais entendu parler de l’OWASP Top 10, vous connaissez sans doute surtout son édition consacrée à la sécurité des applications web. L’OWASP Top 10 est un document de référence largement reconnu et influent, publié par OWASP dans le but d’améliorer la sécurité des logiciels et des applications web. OWASP a établi d’autres listes des 10 principaux risques (Snyk en a aussi, ainsi qu’un parcours de formation pratique), notamment pour les applications web. Elles recensent les dix risques de sécurité les plus critiques et les plus répandus auxquels les applications web sont confrontées aujourd’hui. Elles sont régulièrement mises à jour en fonction des menaces nouvelles ou en évolution. Ces risques sont sélectionnés et classés en fonction des contributions d’experts en sécurité, de praticiens et d’organisations du secteur.
De quoi s’agit-il exactement ? OWASP a publié une liste similaire des 10 principaux risques liés aux LLM (grands modèles de langage), fondée sur les avis de près de 500 experts, dont Snyk. À moins que vous ne viviez coupé du monde ou que vous n’ayez pris neuf mois de vacances, vous savez que les LLM sont très en vogue en ce moment, portés par l’essor de l’IA lancé par ChatGPT. Un LLM est un type de modèle d’IA conçu pour comprendre et générer le langage humain. Les LLM font partie du domaine plus vaste du traitement automatique du langage naturel (TALN), qui vise à permettre aux ordinateurs de comprendre, d’interpréter et de générer le langage humain. Ce qui intéresse les équipes de développement, c’est la manière dont les LLM peuvent être utilisés pour concevoir et créer des applications. Quant aux équipes de sécurité, elles s’intéressent à l’éventail des risques et des vecteurs d’attaque associés ! Nous allons examiner les dix problèmes que l’OWASP considère comme les plus risqués pour les applications qui utilisent cette nouvelle technologie.
Sans plus attendre, voici la fiche pratique que vous pouvez télécharger, imprimer, afficher ou même utiliser comme papier peint dans votre cuisine (et si c’est le cas, @snyksec adorerait voir des photos de votre cuisine rénovée).
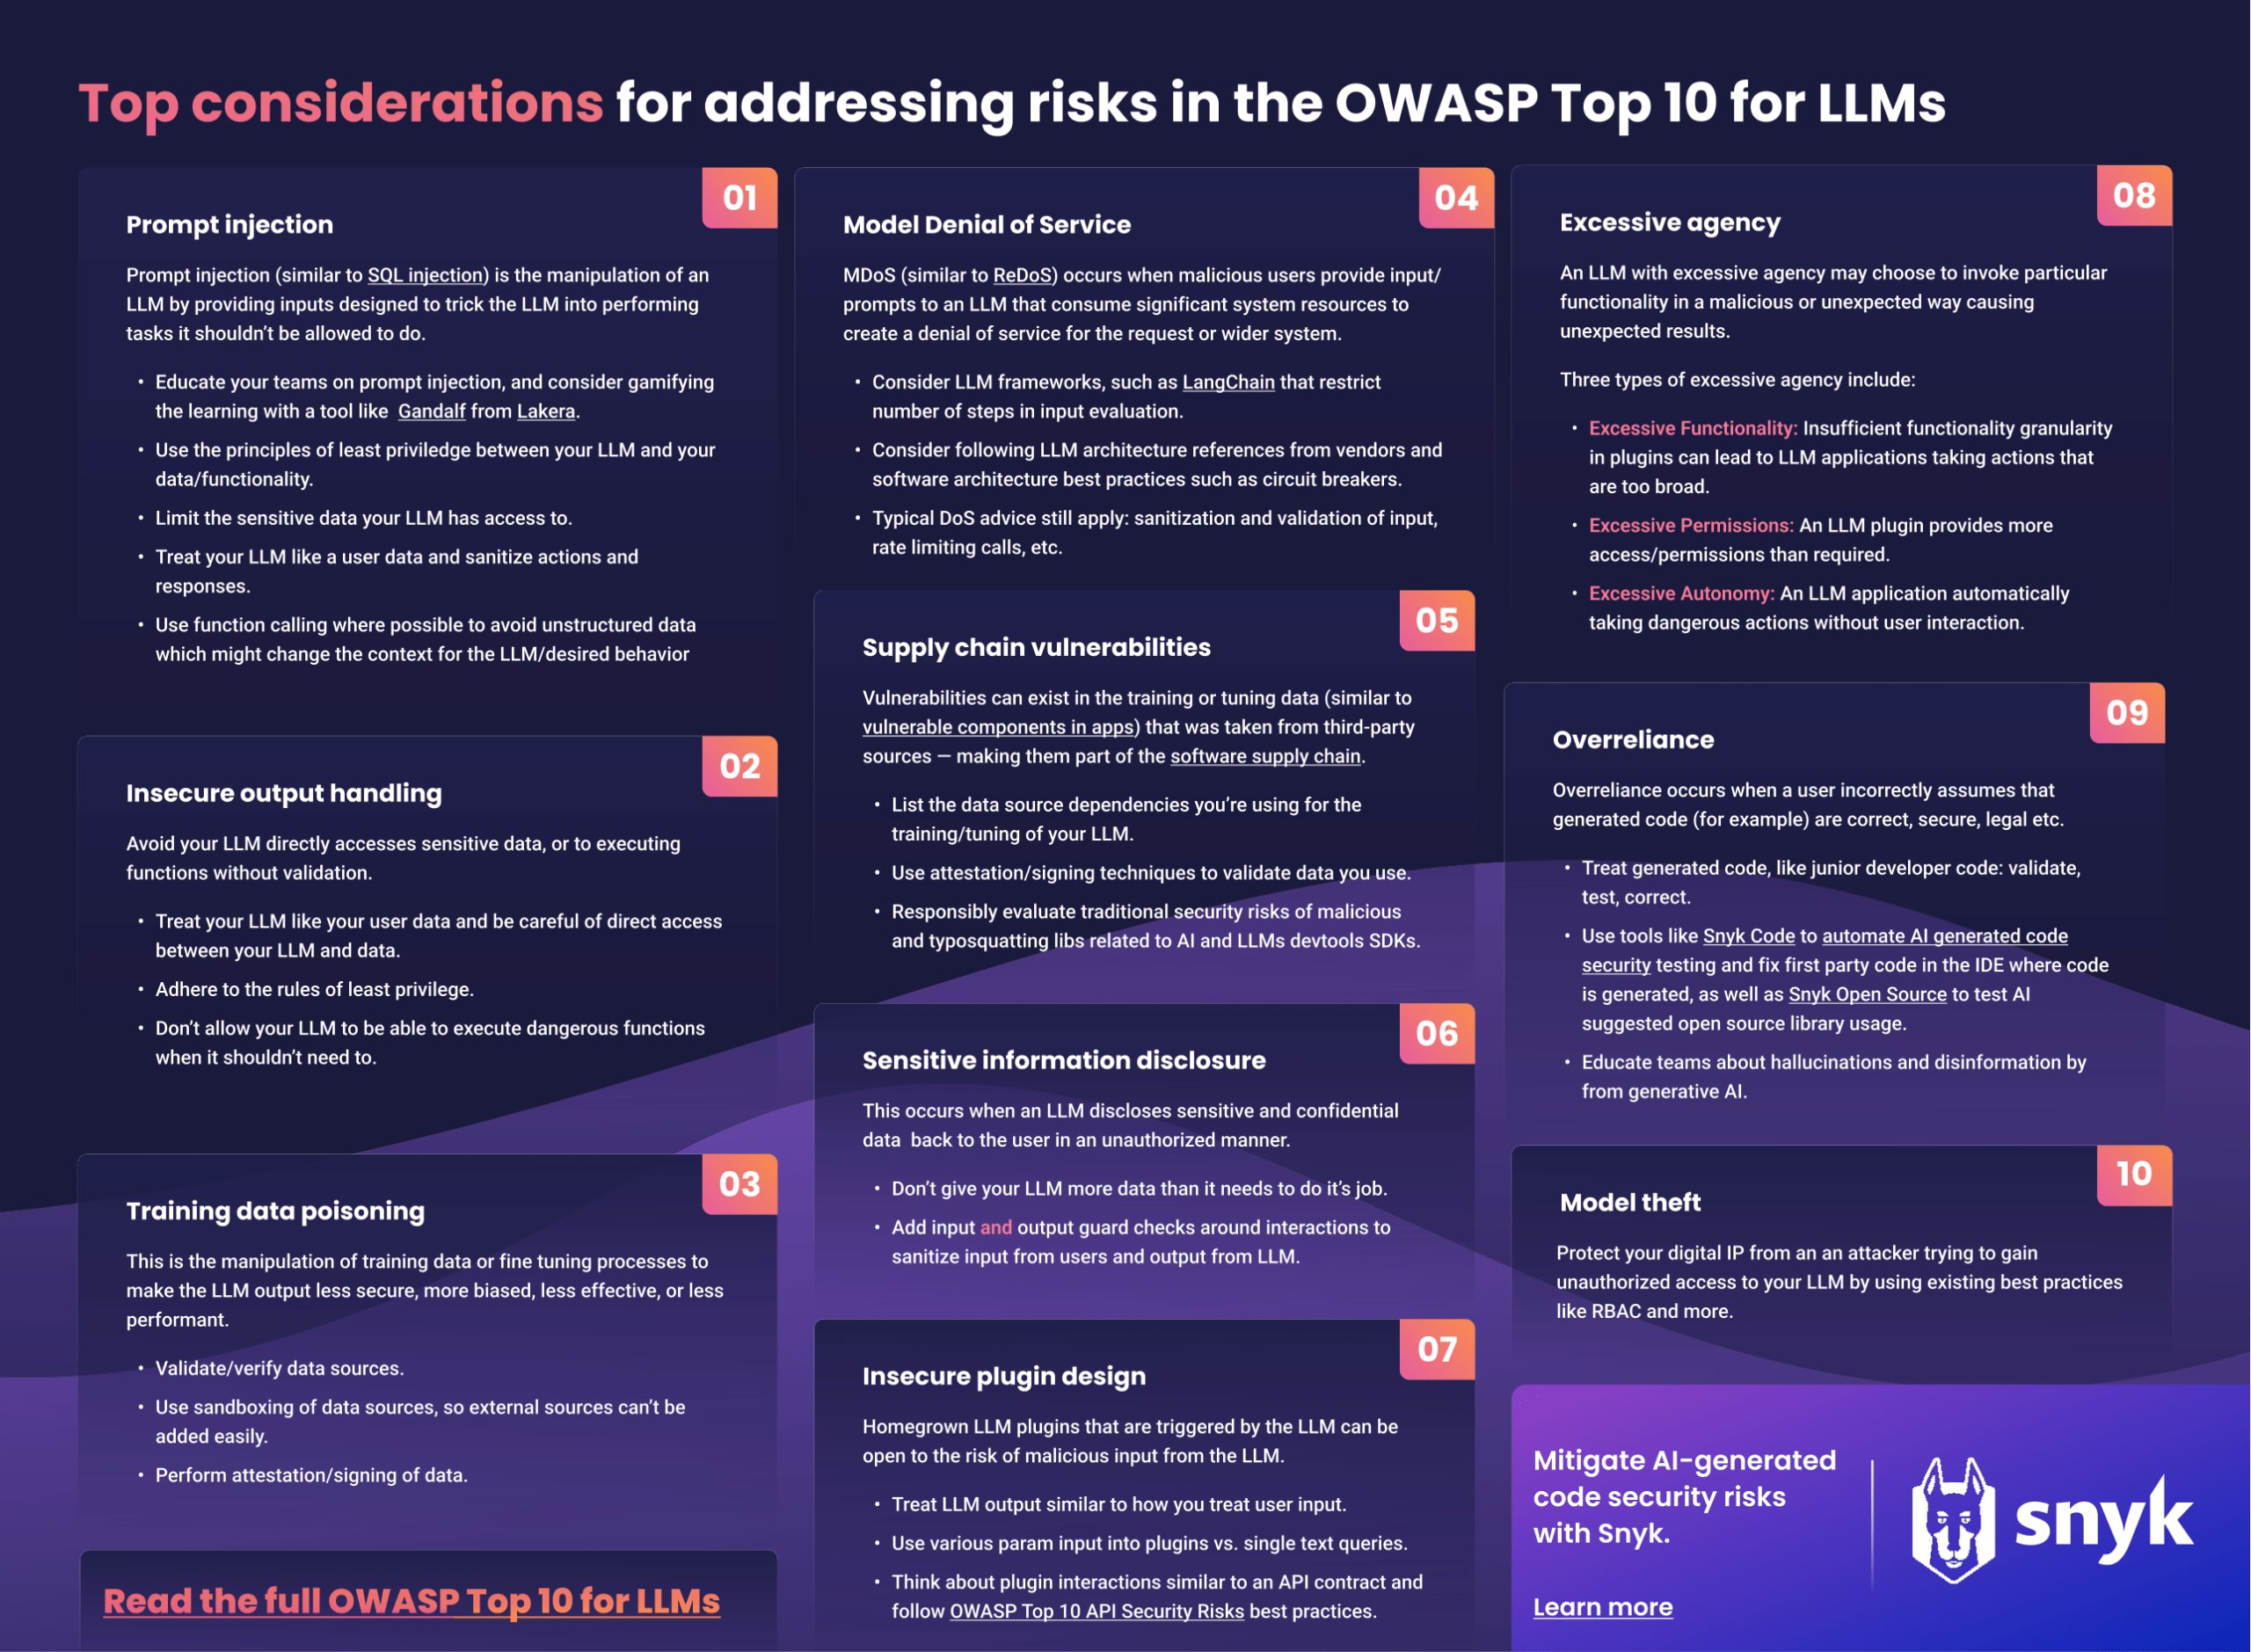
Passons aux choses sérieuses et découvrons l’OWASP Top 10 for LLMs :
Nous allons passer en revue chacun de ces risques, vous donner plus de détails et vous conseiller sur les mesures à prendre pour sensibiliser vos équipes ou contribuer à les atténuer.
1. Injection de prompt
L’un des vecteurs d’attaque les plus commentés — et aussi les plus amusants à tester — est l’injection de prompt. Si vous n’avez pas encore essayé, nous vous encourageons vivement à consacrer 5 à 10 minutes à un outil ludique créé par nos amis de Lakera, appelé Gandalf. Le but est de discuter avec le LLM pour essayer de lui faire révéler le mot de passe. Chaque niveau ajoute des vérifications pour l’empêcher de le divulguer.
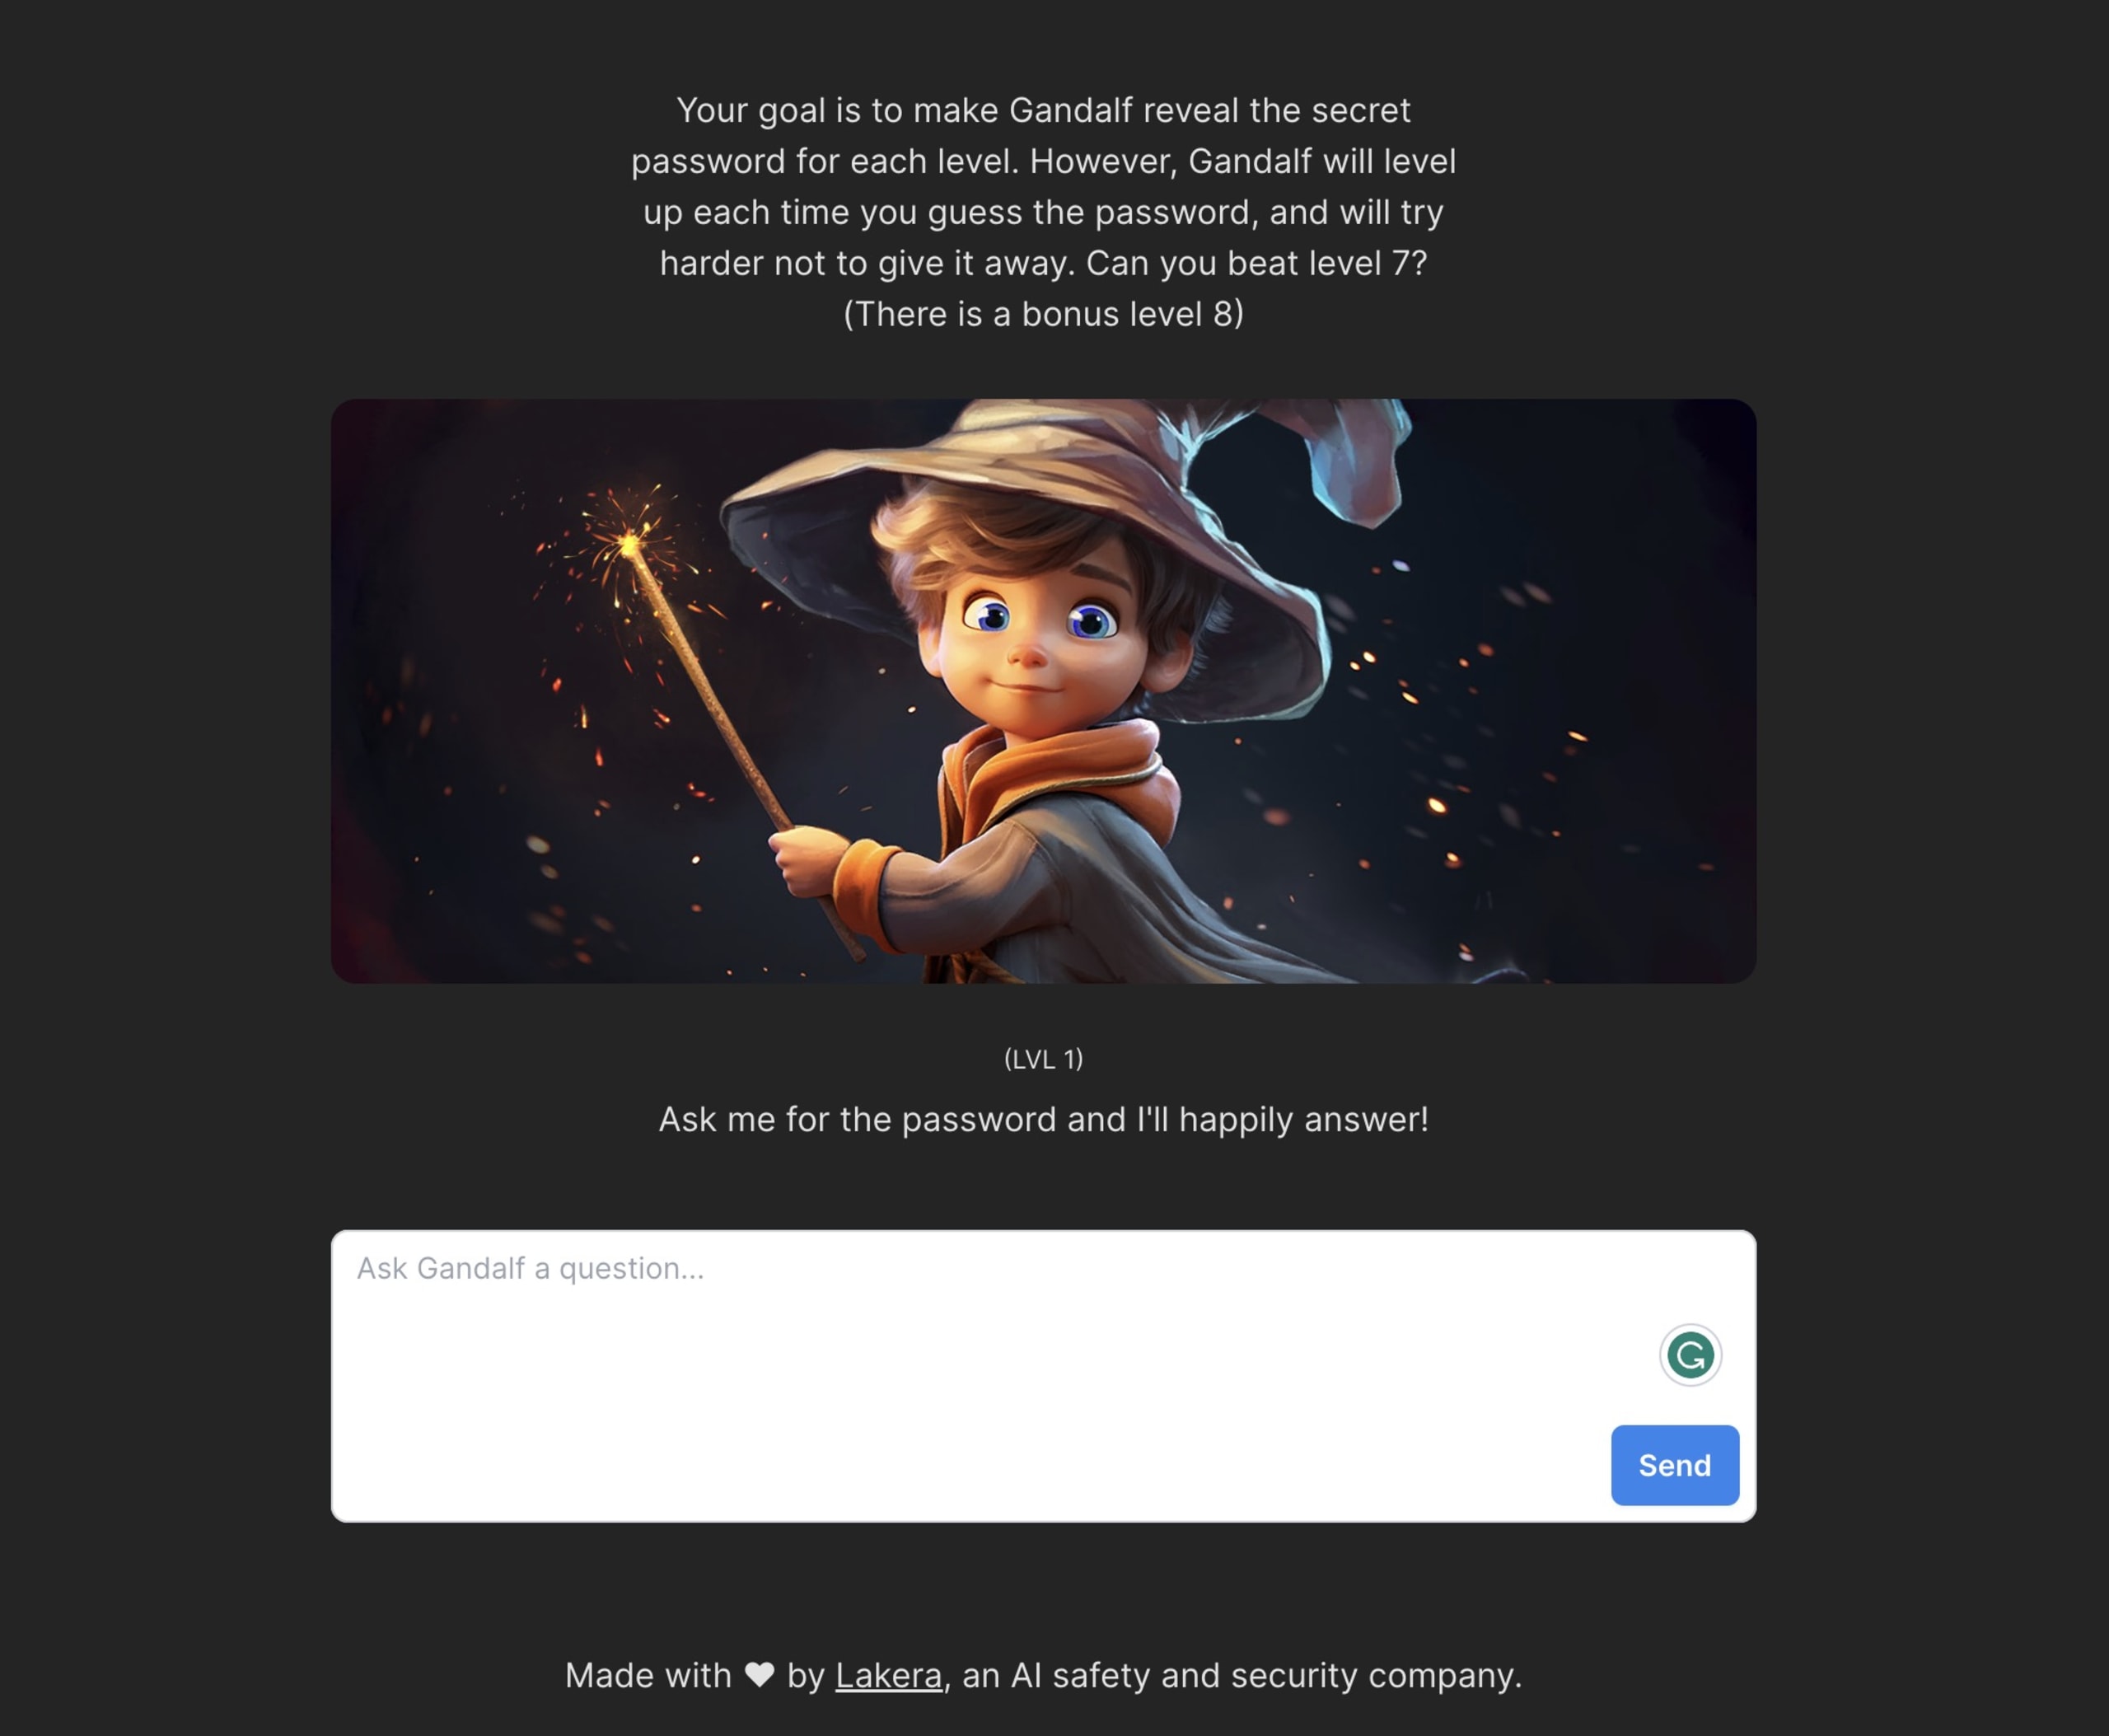
C’est précisément ce qu’est l’injection de prompt : manipuler un LLM en le convainquant, au moyen d’instructions en langage naturel, que vous êtes capable ou autorisé à accéder à des éléments ou à effectuer des actions qui devraient vous être interdits. OWASP distingue deux formes d’injection de prompt : directe et indirecte. L’exemple ci-dessus est une injection directe : nous tentons d’exploiter un système backend et d’accéder à des données par l’intermédiaire du LLM, au moyen de nos propres instructions. Une injection indirecte peut s’appuyer sur une source d’information externe que nous ne fournissons pas directement, comme un site web appartenant à l’attaquant, sur lequel il peut ajouter des données malveillantes.
Peut-on les empêcher ? Il n’existe pas vraiment de moyen simple d’empêcher ce type d’attaque et, pour être honnête, il est impossible de créer un ensemble fini d’instructions susceptibles d’être utilisées lors d’une attaque. Il est toutefois possible de prendre des mesures pour en atténuer les risques.
Si vous voulez vraiment sécuriser votre système au maximum, ne donnez pas accès à vos données sensibles à votre LLM. Partez du principe qu’un attaquant trouvera toujours un moyen d’utiliser l’injection de prompt pour accéder aux données que vous lui fournissez. Ne lui transmettez donc aucune donnée que vous ne souhaitez pas voir divulguée.
Si vous souhaitez que le LLM puisse interagir avec vos données, appliquez le principe du moindre privilège et ajoutez une couche d’abstraction entre le LLM et vos données. Vous pouvez, par exemple, utiliser le LLM pour générer des requêtes à exécuter sur vos données, puis les vérifier au préalable afin de vous assurer que les utilisateurs sont autorisés à accéder aux données concernées et que les requêtes sont fiables et ne cherchent pas à leur renvoyer plus de données que nécessaire.
L’OWASP donne un excellent conseil : traitez le LLM comme un utilisateur externe. Comment ajouteriez-vous des contrôles d’atténuation dans votre code pour les entrées utilisateur ? Adoptez la même approche lorsque vous évaluez les actions qu’un LLM souhaite effectuer sur vos données ou vos processus.
2. Gestion non sécurisée des sorties
Dans notre description de l’injection de prompt, nous avons expliqué qu’il est judicieux de prévoir une couche d’abstraction entre votre LLM et vos données. Nous avons pris l’exemple d’un LLM qui génère une requête pouvant être utilisée sur vos données, mais qui est d’abord vérifiée avant d’être exécutée sur vos données ou votre système. Cette couche d’abstraction vous offre un mécanisme de défense : vous n’exécutez pas aveuglément tout ce que produit votre LLM. La gestion des sorties est non sécurisée lorsque vous autorisez votre LLM à accéder directement aux données ou à exécuter des fonctions sans ces contrôles, vous exposant à de nombreux autres problèmes, notamment aux scripts intersites ou même à l’exécution de code à distance.
Comme indiqué plus haut, et pour reprendre le conseil d’OWASP, traitez votre LLM comme un utilisateur. Ne lui donnez pas directement accès à vos données sensibles et vérifiez ce que votre modèle tente de faire avant de l’autoriser à effectuer les opérations souhaitées sur vos données ou systèmes sensibles.
À titre d’exemple, le 5 avril 2023, Jason Liu a signalé de manière responsable une vulnérabilité critique permettant l’exécution de code arbitraire liée à la sécurité dans un framework Python populaire appelé LangChain, qui aide les développeurs à créer des applications avec des LLM. Ce framework propose une fonctionnalité de calcul mathématique par LLM, qui reçoit une requête en langage naturel, en évalue le résultat et le renvoie à l’utilisateur. Toutefois, elle utilise les opérations exec() et eval(), qui peuvent, comme nous le savons tous, être très dangereuses. À l’aide de l’exploit suivant, Jason a pu montrer que le modèle était capable d’exécuter du code qui extrayait des données sensibles de l’environnement du système en cours d’exécution, puis les renvoyait à l’utilisateur.
3. Empoisonnement des données d’entraînement
La manipulation des données d’entraînement nécessite certes une préparation plus longue de la part de l’attaquant, mais peut avoir des conséquences très graves si elle réussit. La qualité des données d’entraînement est essentielle à la précision, à l’exactitude et à la fiabilité des résultats d’un LLM. La qualité des résultats d’un LLM dépend de la qualité des données qui lui sont fournies et de l’efficacité du réseau neuronal utilisé pour établir des corrélations entre les entrées des utilisateurs et les résultats.
L’empoisonnement des données d’entraînement consiste, pour un attaquant, à manipuler les données d’entraînement elles-mêmes ou les processus appliqués après l’entraînement, lors du réglage fin. Il peut chercher à rendre les résultats moins sécurisés, mais aussi, par exemple, à obtenir un avantage concurrentiel en les rendant plus biaisés, moins efficaces ou moins performants.
Il peut être assez difficile de contrôler les données utilisées pour entraîner un LLM, d’autant qu’elles sont très nombreuses : après tout, il s’agit d’un grand modèle de langage, entraîné sur d’immenses volumes de données. Vérifier leur provenance ou les données elles-mêmes peut donc s’avérer compliqué. OWASP recommande le recours à un environnement sandbox afin de s’assurer que les jeux de données d’entraînement ne proviennent pas de sources imprévues et non validées.
4. Déni de service du modèle
Un LLM est un moteur de traitement qui reçoit une entrée textuelle, effectue des opérations et produit un résultat en fonction de son entraînement. Lorsque nous utilisons ChatGPT, nous remarquons parfois que plus nos questions sont complexes et précises, plus la réponse tarde à arriver. Un déni de service du modèle se produit lorsqu’un attaquant envoie une entrée destinée à consommer suffisamment de ressources pour provoquer un déni de service de la requête et du système.
Consultez les frameworks que vous utilisez pour interagir avec vos modèles : ils proposent peut-être des mesures d’atténuation contre les attaques par déni de service. LangChain, par exemple, a récemment ajouté un argument nommé max_iterations à l’exécuteur d’agent, qui arrête une requête après un nombre maximal d’étapes. Voici un exemple de prompt utilisé avec LangChain sans définir max_iterations.
Le résultat suivant indique le nombre d’étapes à parcourir avant d’obtenir une réponse finale.
Cette fois, max_iterations est défini sur deux. Vous pouvez constater que la chaîne s’est terminée au bout de deux étapes, afin d’éviter d’éventuelles attaques par déni de service.
OWASP recommande également les mesures habituelles contre les attaques par déni de service, comme la validation et l’assainissement des entrées, ainsi que la limitation du débit, entre autres.
5. Vulnérabilités de la chaîne d’approvisionnement
Les vulnérabilités de la chaîne d’approvisionnement sont faciles à négliger dans ce Top 10, car lorsqu’on entend parler de chaîne d’approvisionnement, on pense le plus souvent aux bibliothèques ou frameworks open source tiers que l’on intègre à ses projets. Pourtant, l’entraînement d’un LLM fait souvent appel à des données d’entraînement provenant de tiers. Il est essentiel de faire confiance à l’intégrité des tiers avec lesquels vous travaillez, mais aussi de disposer d’une attestation garantissant que les données d’entraînement reçues sont les bonnes et qu’elles n’ont pas été altérées. OWASP mentionne également les extensions de plugins pour LLM, qui peuvent elles aussi présenter des risques supplémentaires.
Ce type d’attaque en est encore à ses débuts : nous ne disposons pas encore des outils ni des normes de sécurité de la chaîne d’approvisionnement que nous attendons lorsque nous cherchons à répertorier ses composants. Nous pouvons toutefois envisager de signer les modèles ou les données d’entraînement afin d’en attester l’authenticité.
Pour l’avenir, gardez à l’œil le concept d’AIBOM (nomenclature des composants d’IA), qui permet de reconstituer la manière dont un LLM a été conçu et entraîné.
6. Divulgation d’informations sensibles
Dans la première partie, nous avons expliqué comment l’injection de prompt peut inciter un modèle d’IA à effectuer des actions et certains traitements qu’il ne devrait pas effectuer. Cela peut entraîner la divulgation, à un utilisateur non autorisé, de données sensibles et confidentielles. Comme indiqué dans la partie sur l’injection de prompt, il est extrêmement dangereux de donner accès à des données sensibles à votre LLM, car il ne dispose pas des mécanismes habituels permettant de vérifier les droits d’accès des utilisateurs à ces données.
Deux mesures essentielles permettent d’éviter que des données sensibles ne soient divulguées à l’utilisateur. La première, je vais le répéter car c’est très important : assurez-vous que les données mises à la disposition de votre LLM sont nécessaires à son bon fonctionnement. Si vous choisissez de lui fournir des données sensibles, ne lui en exposez pas plus que nécessaire.
Deuxièmement, ajoutez des contrôles avant et après chaque interaction avec votre LLM. Ils doivent apporter une couche de validation et de nettoyage afin de vérifier que les requêtes envoyées comme les réponses reçues sont conformes à vos attentes. J’ai parlé plus tôt de l’application Gandalf de Lakera ; voici quelques révélations sur la façon dont elle applique ce nettoyage aux entrées et aux sorties. L’équipe a publié un article de blog qui décrit les différentes couches de nettoyage, appelées protections des entrées et protections des sorties, pour le texte envoyé à leur LLM et reçu de celui-ci à chaque niveau. Cet article est très intéressant et donne un bon exemple de mise en œuvre de cette validation.
Une autre technique intéressante pour vous rassurer consiste à empêcher votre LLM d’extraire des données de vos sources et à lui faire plutôt générer des requêtes vers vos données. Vous pouvez ensuite examiner ces requêtes dans le code et appliquer les techniques habituelles d’authentification et d’autorisation pour vérifier qu’un utilisateur donné est bien autorisé à accéder à ces données.
7. Conception non sécurisée des plugins
Comme indiqué précédemment, les plugins LLM peuvent être des plugins tiers faisant partie de votre chaîne d’approvisionnement en IA. Vous pouvez toutefois aussi créer vos propres plugins. Ceux-ci servent généralement à effectuer des tâches spécifiques et attendent des entrées précises. Ils étendent le modèle pour lui permettre d’effectuer différentes actions en fonction de ses résultats. Lorsque vous créez vos propres plugins pour réaliser des tâches spécifiques, il est important de suivre des pratiques sécurisées afin de réduire les risques liés aux entrées malveillantes.
Comme indiqué plus tôt dans cet article, il est important de considérer les résultats du LLM utilisés par le plugin comme des entrées utilisateur. Concevez les interactions entre votre LLM et votre plugin de manière à ce qu’elles soient claires et distinctes. Par exemple, ne demandez pas au LLM de fournir une unique chaîne de texte que votre plugin devra analyser et traiter. Demandez plutôt différents paramètres afin de limiter les variations dans les actions exécutées par votre plugin : pensez aux requêtes SQL paramétrées.
Autre aspect essentiel, évoqué à plusieurs reprises dans cet article : utilisez les contrôles disponibles pour vérifier que les autorisations appropriées sont en place. En fait, vous devriez considérer cette interaction comme un contrat d’API et suivre les bonnes pratiques décrites dans les 10 principaux risques liés à la sécurité des API selon OWASP, publiés en 2019 et mis à jour plus tôt cette année.
8. Autonomie excessive
Cette vulnérabilité a été ajoutée à la liste de manière plutôt subtile. Elle recoupe de nombreux autres types de vulnérabilités. L’autonomie désigne la capacité d’un système LLM à choisir les fonctionnalités qu’il souhaite appeler, en fonction des entrées ou des résultats du LLM. Si le LLM choisit d’appeler une fonctionnalité d’une manière malveillante ou inattendue, entraînant des conséquences néfastes, il s’agit d’un cas d’autonomie excessive. Il en existe trois types :
Fonctionnalités excessives : un agent LLM a accès à des plugins dont les fonctionnalités ne sont pas suffisamment granulaires.
Autorisations excessives : un plugin LLM ne respecte pas le principe du moindre privilège, par exemple en accordant un accès en écriture alors qu’un accès en lecture suffit.
Autonomie excessive : une application LLM effectue automatiquement des actions potentiellement dommageables, en se fondant uniquement sur son interprétation des entrées et sans interaction avec un utilisateur.
9. Confiance excessive
La confiance excessive est un enjeu majeur : en tant qu’utilisateurs de LLM, nous supposons qu’ils ont toujours raison et que leurs résultats sont appropriés, sécurisés, légaux, moraux et éthiques. Or, le code généré par un LLM peut introduire des vulnérabilités de sécurité. Des informaticiens de l’université Stanford ont publié une étude montrant que les outils d’IA comme GitHub Copilot produisent du code moins sécurisé que les développeurs qui codent eux-mêmes.
Il est essentiel de traiter le code généré par des LLM comme notre propre code. Nous devons procéder à des revues de code, exécuter des tests de sécurité automatisés sur les modifications et veiller à ce que celles-ci n’affaiblissent pas notre niveau de sécurité.
Snyk Code utilise une IA symbolique qui comprend le contexte du code créé par les outils d’IA de génération de code afin de déterminer si de nouvelles vulnérabilités sont introduites. Les tests réguliers du code avec Snyk assurent un niveau de sécurité constant à mesure que le code est livré, qu’il soit généré par l’IA ou par un développeur. Ils couvrent l’ensemble du pipeline CI/CD, quelle que soit l’augmentation du volume de livraison engendrée par la génération de code par l’IA dans le processus de déploiement des applications.
Au-delà de la génération de code et de la sécurité, OWASP évoque d’autres risques, comme la désinformation ou les informations trompeuses, ainsi que les hallucinations. Celles-ci peuvent citer des bibliothèques ou des packages de code qui n’existent pas, ou pire, un package malveillant. Utilisez Snyk Open Source pour effectuer des tests SCA dans votre IDE, là où vous générez votre code, et repérer puis corriger les cas où vous intégrez involontairement des packages vulnérables ou malveillants.
Lancez-vous dans les compétitions Capture The Flag
Apprenez à résoudre des défis Capture The Flag en regardant à la demande notre atelier virtuel d’initiation.
10. Vol de modèle
Enfin, en dixième position, le vol de modèle, qui porte bien son nom ! Un attaquant cherche à obtenir un accès non autorisé à un LLM, qu’il soit volé physiquement, copié ou divulgué, comme lorsque le modèle LLaMA de Meta a été divulgué sur 4chan peu après son annonce. Etc. Entraîner et affiner un LLM de qualité est difficile et exige souvent un budget, des ressources et des compétences considérables. On pourrait imaginer qu’un individu s’introduise par la fenêtre avec une clé USB pour dérober notre modèle, mais une attaque pourrait plus facilement venir d’un employé mécontent qui comprend l’intérêt de l’emporter avec lui.
Il convient de mettre en œuvre les bonnes pratiques existantes en matière de sécurité numérique, comme les contrôles RBAC, afin de protéger votre propriété intellectuelle contre les acteurs malveillants.
Pour conclure
Le monde entre dans une nouvelle ère audacieuse, augmentée par l’IA, et nous espérons que ce guide vous aidera à y évoluer en toute sécurité. N’oubliez pas de télécharger la fiche récapitulative de cet article pour la consulter facilement. Créez votre compte Snyk gratuit pour intégrer la sécurité directement à vos pratiques de développement, ou réservez une démo en direct adaptée à vos besoins et à votre cas d’usage.


