RPM Package Manager: Sicherheitsscans für RPM-Pakete mit Snyk

Ivan Stanev
13. November 2020
0 Min. LesezeitBeim Scannen von Container-Images kann Snyk verschiedene Informationen erkennen, etwa die Betriebssystemdistribution, den Software-Paketmanager, installierte Anwendungen und sämtliche Anwendungsabhängigkeiten. RPM ist einer der am weitesten verbreiteten Paketmanager im Linux-Ökosystem und wird von Snyk vollständig unterstützt.
Was ist der RPM Package Manager?
RPM wird in vielen Linux-Distributionen verwendet, darunter Red Hat Enterprise Linux, Fedora, CentOS und weitere. Ursprünglich stammt RPM aus Red Hat Linux und stand zunächst für RedHat Package Manager. Heute ist es ein rekursives Akronym für RPM Package Manager. RPM kann sowohl den Paketmanager als auch das rpm-Dateiformat bezeichnen, das dieser zur Verteilung von Anwendungen verwendet.
Welches Datenformat verwendet RPM?
Die Arbeit mit dem RPM-Paketmanager ist besonders anspruchsvoll, weil er seine Abhängigkeiten nicht in einem menschenlesbaren Format wie JSON oder XML auflistet. Stattdessen werden Pakete in binärer Form in einer BerkeleyDB-Datenbank gespeichert. Sie lassen sich daher nur lesen, wenn wir das korrekte Binärformat und den Aufbau sowohl der Datenbank als auch ihrer Einträge kennen.
Es gab zwar Open-Source-Code zum Lesen der RPM-Datenbank, doch in Snyk konnten wir ihn nicht ohne Weiteres verwenden, da unser Technologie-Stack auf Node.js und TypeScript basiert. Zwar lassen sich C-Bindings für BerkeleyDB kompilieren und nutzen, aber wir wollten den Aufwand für Cross-Compilation und Wartung vermeiden. Außerdem brauchten wir nur eine Bibliothek zum Lesen von RPM-Paketen – einen winzigen Teil der Funktionen von RPM und BerkeleyDB.
Dank der Magie von Open Source erlaubte uns die in RPM verwendete BerkeleyDB-Lizenz, den Code frei zu lesen und zu ändern. Deshalb entschieden wir uns, die Funktionalität selbst nachzubilden. Schließlich lösten wir die Herausforderung und veröffentlichten eine vollständig quelloffene TypeScript-Bibliothek, die Sie in unserem Snyk-rpm-parser-Repository auf GitHub finden.
In diesem Blogbeitrag möchte ich Ihnen zeigen, wie wir dabei vorgegangen sind, und erklären, wie wir das Innenleben der RPM-Datenbank analysiert haben. Machen Sie sich auf ein wenig Tüftelei mit Bits und Bytes auf niedriger Ebene gefasst! ?ï¸
Wie sieht eine RPM-Datenbank aus?
Wir wissen, dass BerkeleyDB eine binäre Datenbank ist. Wie können wir also aussagekräftige Inhalte extrahieren? Binäre Dateiformate erkennt man üblicherweise, indem man den Dateianfang untersucht. Dort findet man oft eine spezielle Kennung (zum Beispiel eine „Magic Number“), die den Typ der Datei angibt. Am besten lesen wir dazu den Quellcode und probieren es mit einer Kopie der RPM-Datenbank aus. Die von RPM erstellte BerkeleyDB-Datenbank befindet sich unter /var/lib/rpm/Packages. Daher untersuchen wir zunächst deren Inhalt. Der BerkeleyDB-Quellcode zeigt, dass die ersten Bytes der Datei Folgendes enthalten:
BerkeleyDB unterstützt verschiedene Datenbanktypen: B-Tree, Hash (HStore) und Queue sowie in den neuesten Versionen weitere Typen. Jeder Datenbanktyp hat eine eigene Magic Number: 0x053162 für B-Tree, 0x061561 für Hash und 0x042253 für Queue. Wie sich herausstellt, ist jede RPM-Datenbank, die wir öffnen, vom Typ Hash: Ab Byte 12 der Datei /var/lib/rpm/Packages finden wir die Magic Number 0x061561. Außerdem enthält type den Wert 0x08, der in den Typdefinitionen des Quellcodes wie folgt aufgeführt ist:
Das Feld pagesize und das darauf folgende last_pgno (Nummer der letzten Seite) in der Typdefinition zeigen uns, dass die Datenbank in gleich große Seiten aufgeteilt ist. Das bedeutet auch, dass sich einzelne Datenelemente über mehrere Datenbankseiten erstrecken können und die Seiten höchstwahrscheinlich nicht in der richtigen Reihenfolge liegen (wie wir bei der späteren Analyse feststellen werden).
Wie sich herausstellt, werden diese allgemeinen Datenbankmetadaten von allen Datenbanktypen gemeinsam genutzt. Daher wird der anfängliche Abschnitt _dbmeta33 je nach Datenbanktyp erweitert. Da uns nur die Hash-Datenbank interessiert, erhalten wir folgende zusätzliche Daten:
Anhand von nelem (Anzahl der Elemente) können wir auch ermitteln, wie viele Elemente die Datenbank enthält. iv (Initialisierungsvektor) und chksum (Prüfsumme) lassen jedoch auf eine mögliche Verschlüsselung schließen.
Wenn wir diese Bytes lesen und in einem JavaScript-Objekt speichern, das wir später ausgeben können, erhalten wir etwa Folgendes:
Wie sich herausstellt, verwendet RPM für die Datenbank keine Verschlüsselung – zumindest nicht standardmäßig. Diesen Anwendungsfall können wir also vollständig außer Acht lassen.
Bis hierhin ergibt sich folgender Überblick über den Datenbankaufbau:
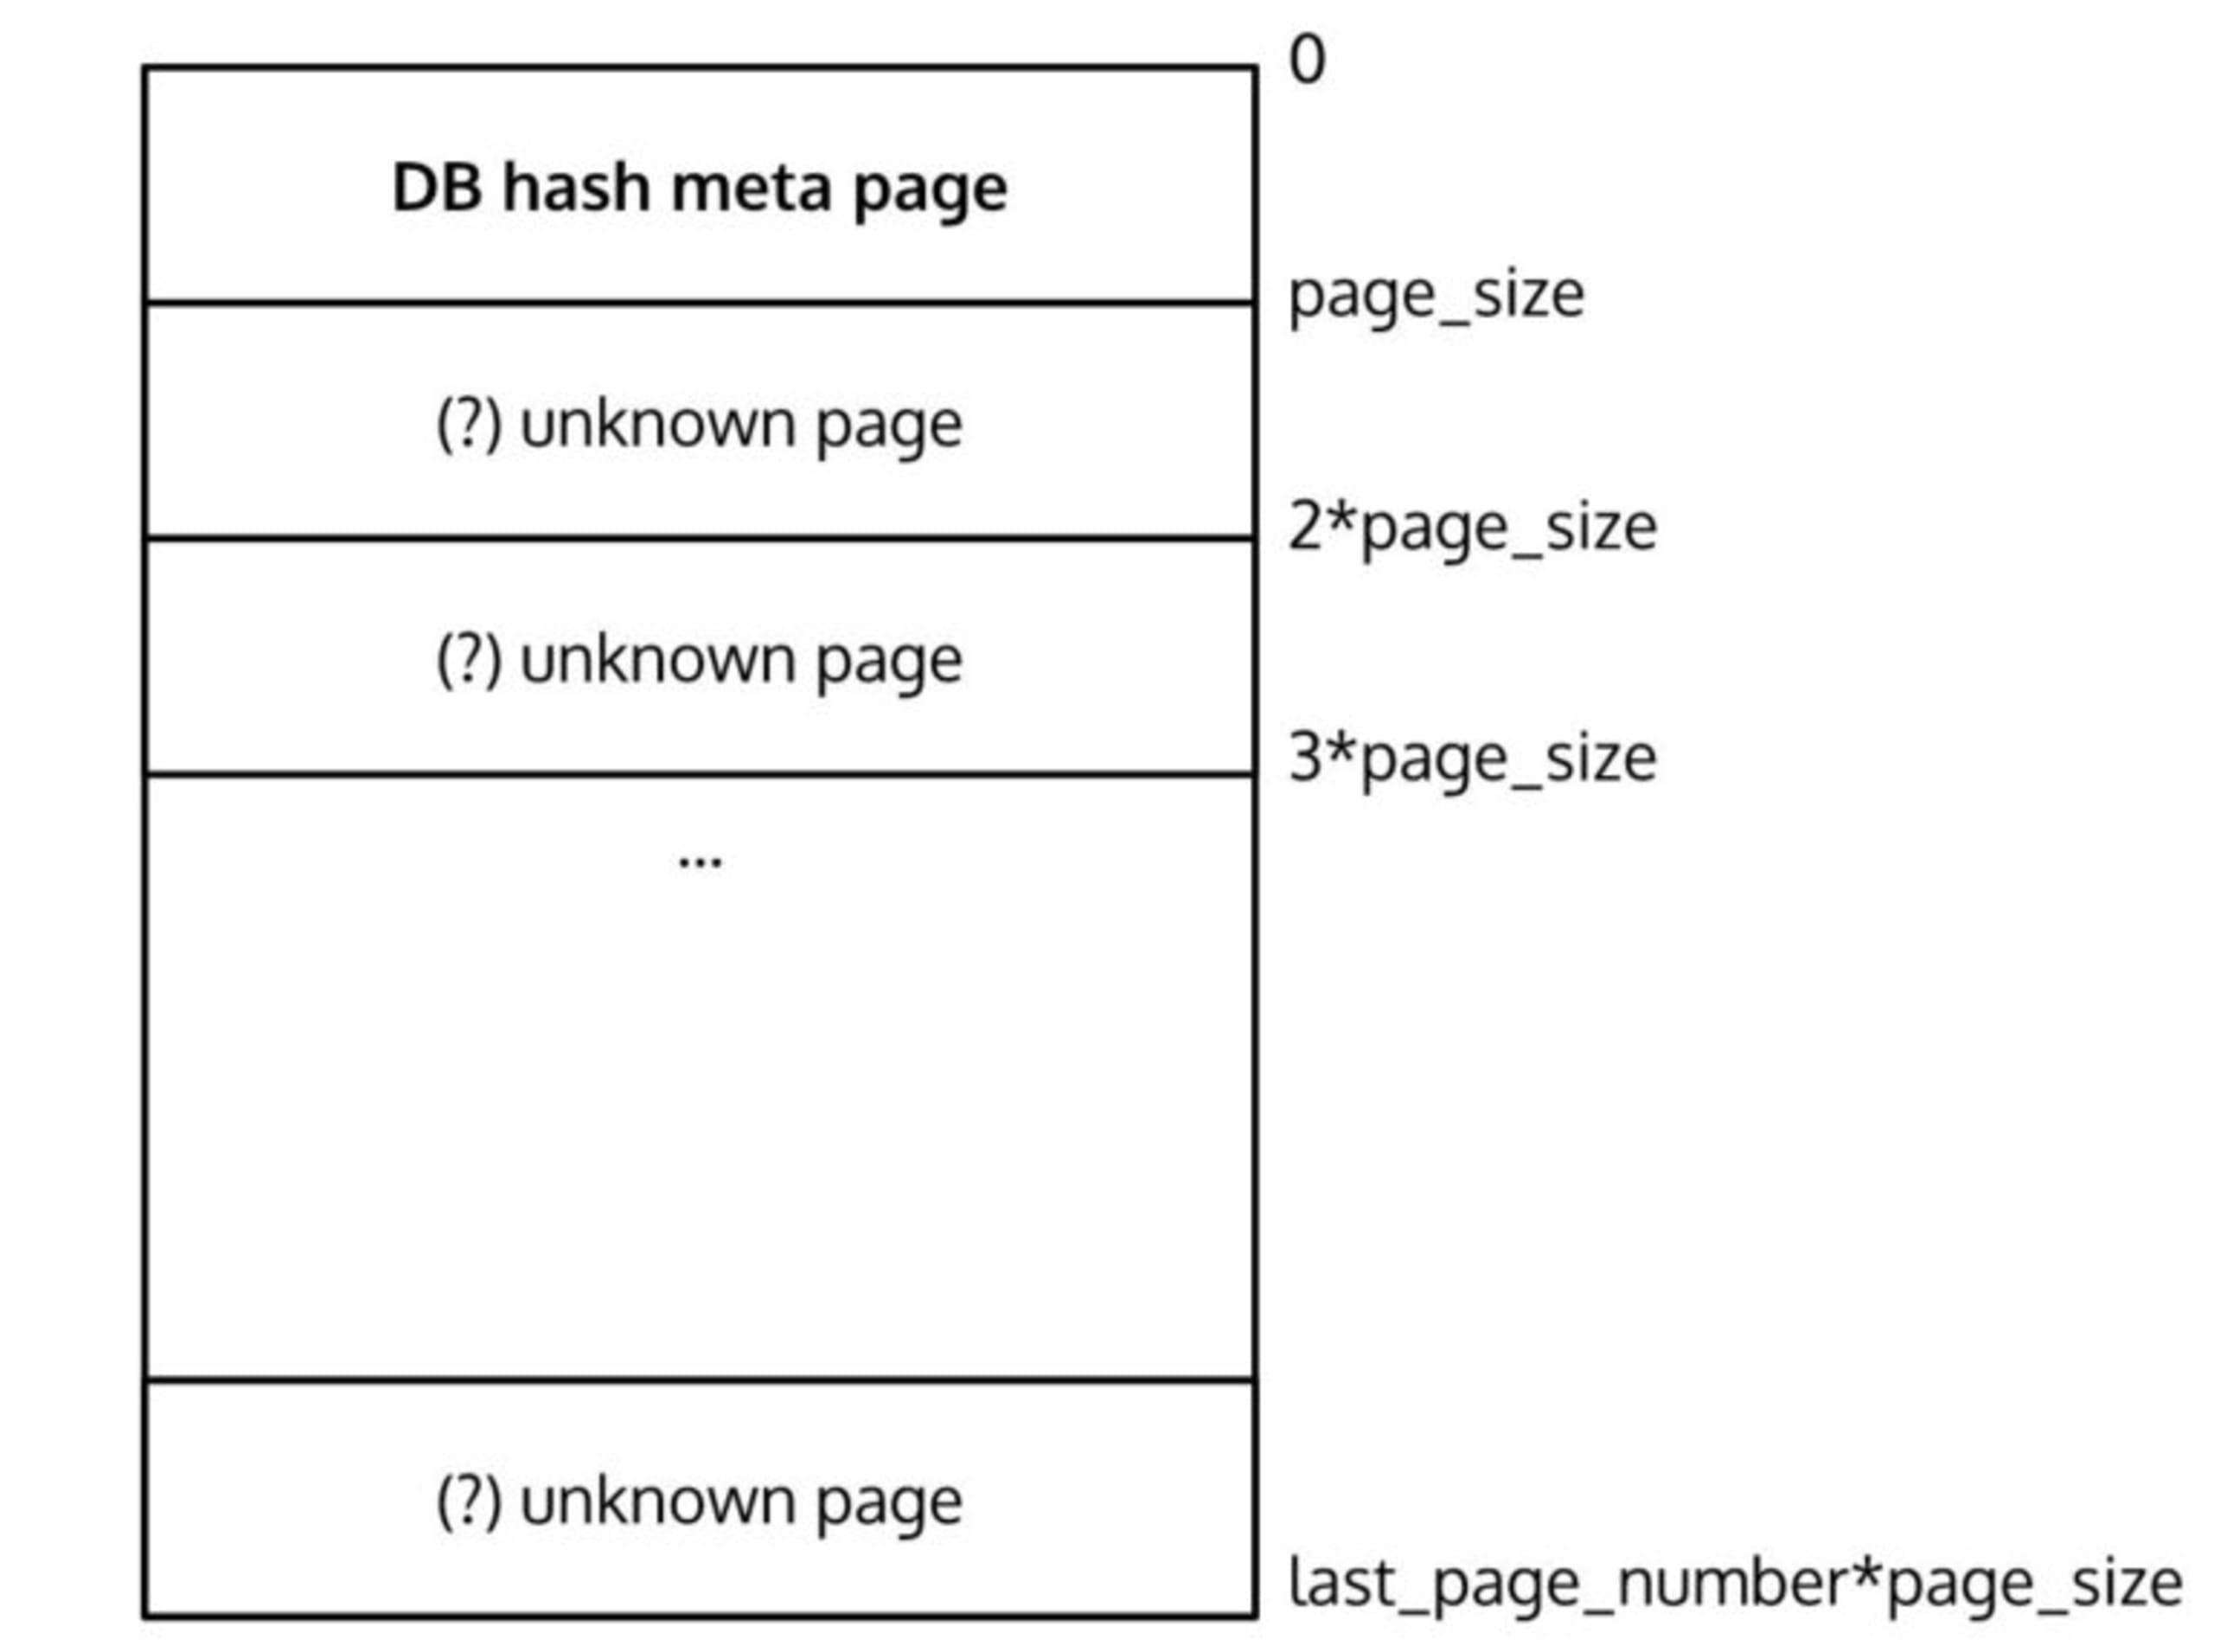
Da eine Seite 4096 Byte groß ist und die erste Seite die Datenbankmetadaten enthält, wechseln wir zur nächsten Seite und sehen uns an, welche Daten wir dort erwarten können. Auch hier ist der BerkeleyDB-Quellcode sehr hilfreich und zeigt uns den folgenden Aufbau:
Aus den Typdefinitionen gehen die Größen der einzelnen Einträge hervor. Wenn wir also die richtige Anzahl von Bytes lesen und einem JavaScript-Objekt zuordnen, erhalten wir Folgendes:
Beachten Sie den Eintrag type: 13, der einen völlig neuen Seitentyp kennzeichnet. In den Typdefinitionen ist dieser wie folgt aufgeführt:
Für prev_pgno und next_pgno ist der Wert 0 festgelegt. Das bedeutet, dass die Daten (was auch immer sie enthalten) vollständig auf dieser Seite gespeichert sind und wir keine weiteren Seiten durchsuchen müssen, um sie zu erfassen.
Beachten Sie den Wert von hf_offset. Wenn wir uns die gesamten auf der Seite gespeicherten Daten ansehen, erkennen wir, dass die Bytes ungefähr ab Position 2850 auf null gesetzt sind. Das entspricht dem Wert von hf_offset. hf_offset verweist also auf die Stelle, an der die Daten auf der Seite enden. Das ist später besonders nützlich, wenn wir Datenelemente von mehreren Seiten lesen und wissen müssen, wo die Daten beginnen und enden.
Jede Seite beginnt also mit einem allgemeinen 26-Byte-Seitenheader. Die übrigen 4070 Byte sind teilweise oder vollständig mit Daten belegt. Die Seite vom Typ Hash enthält einen Index mit Einträgen, die auf bestimmte Bytepositionen beziehungsweise Offsets der aktuellen Seite verweisen. Diese Offsets zeigen auf Daten am gegenüberliegenden Ende der Seite. Die Anordnung der Daten auf einer Hash-Seite ähnelt dem Aufbau von Stack und Heap:
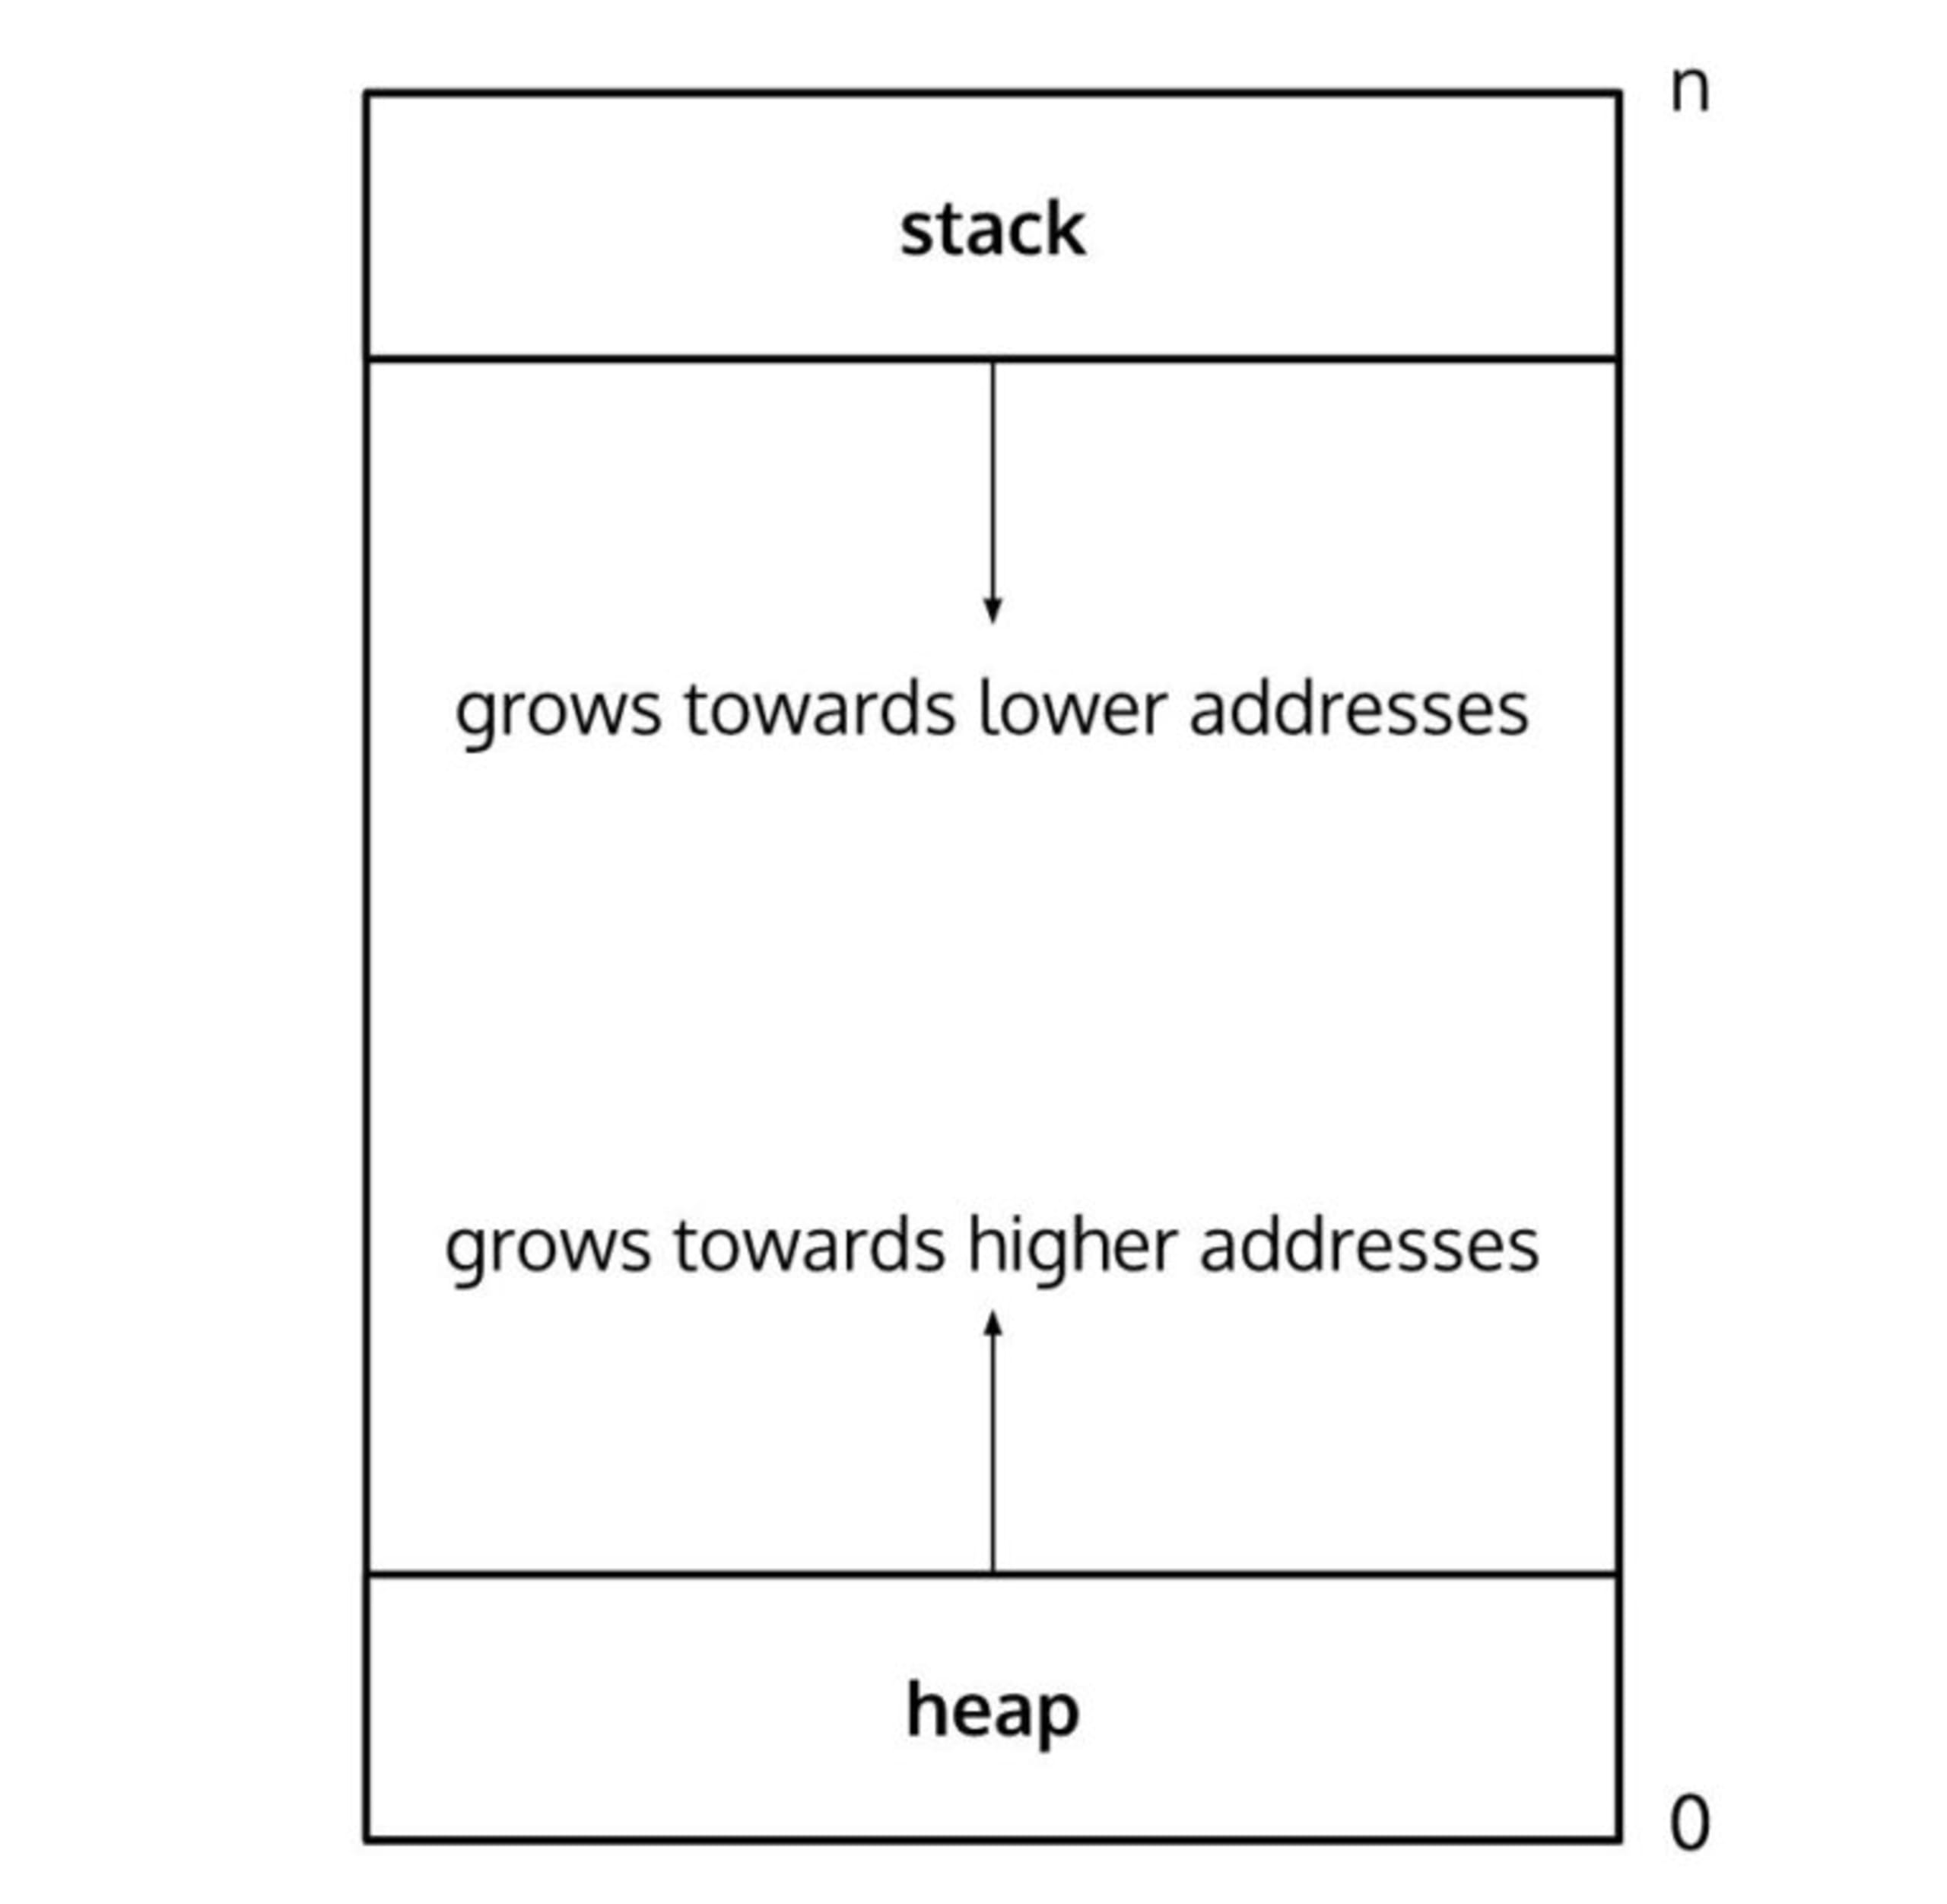
Der Index liegt im Heap-Bereich der Seite, während die Daten – auf die die Offsets im Index verweisen – im Stack-Bereich gespeichert sind.
Der Index enthält nacheinander Einträge in Form von Schlüsseln und Werten. Der Schlüssel ist eine interne Kennung in der Datenbank; der Wert verweist auf einen Offset innerhalb der aktuellen Seite. Eine Typdefinition hilft uns dabei, die Daten an jedem Offset zu interpretieren:
Mit diesen Informationen können wir ermitteln, wo diese Daten innerhalb der gesamten BerkeleyDB gespeichert sind – oder zumindest, wo sie beginnen. Die Daten beginnen auf einer bestimmten Seitennummer und können sich über mehrere Seiten erstrecken, wenn ihre Länge die Seitengröße überschreitet (erinnern Sie sich an pagesize, das wir von Seite 0 ausgelesen haben?).
Bis hierhin ergibt sich folgender Überblick über die Datenbank:
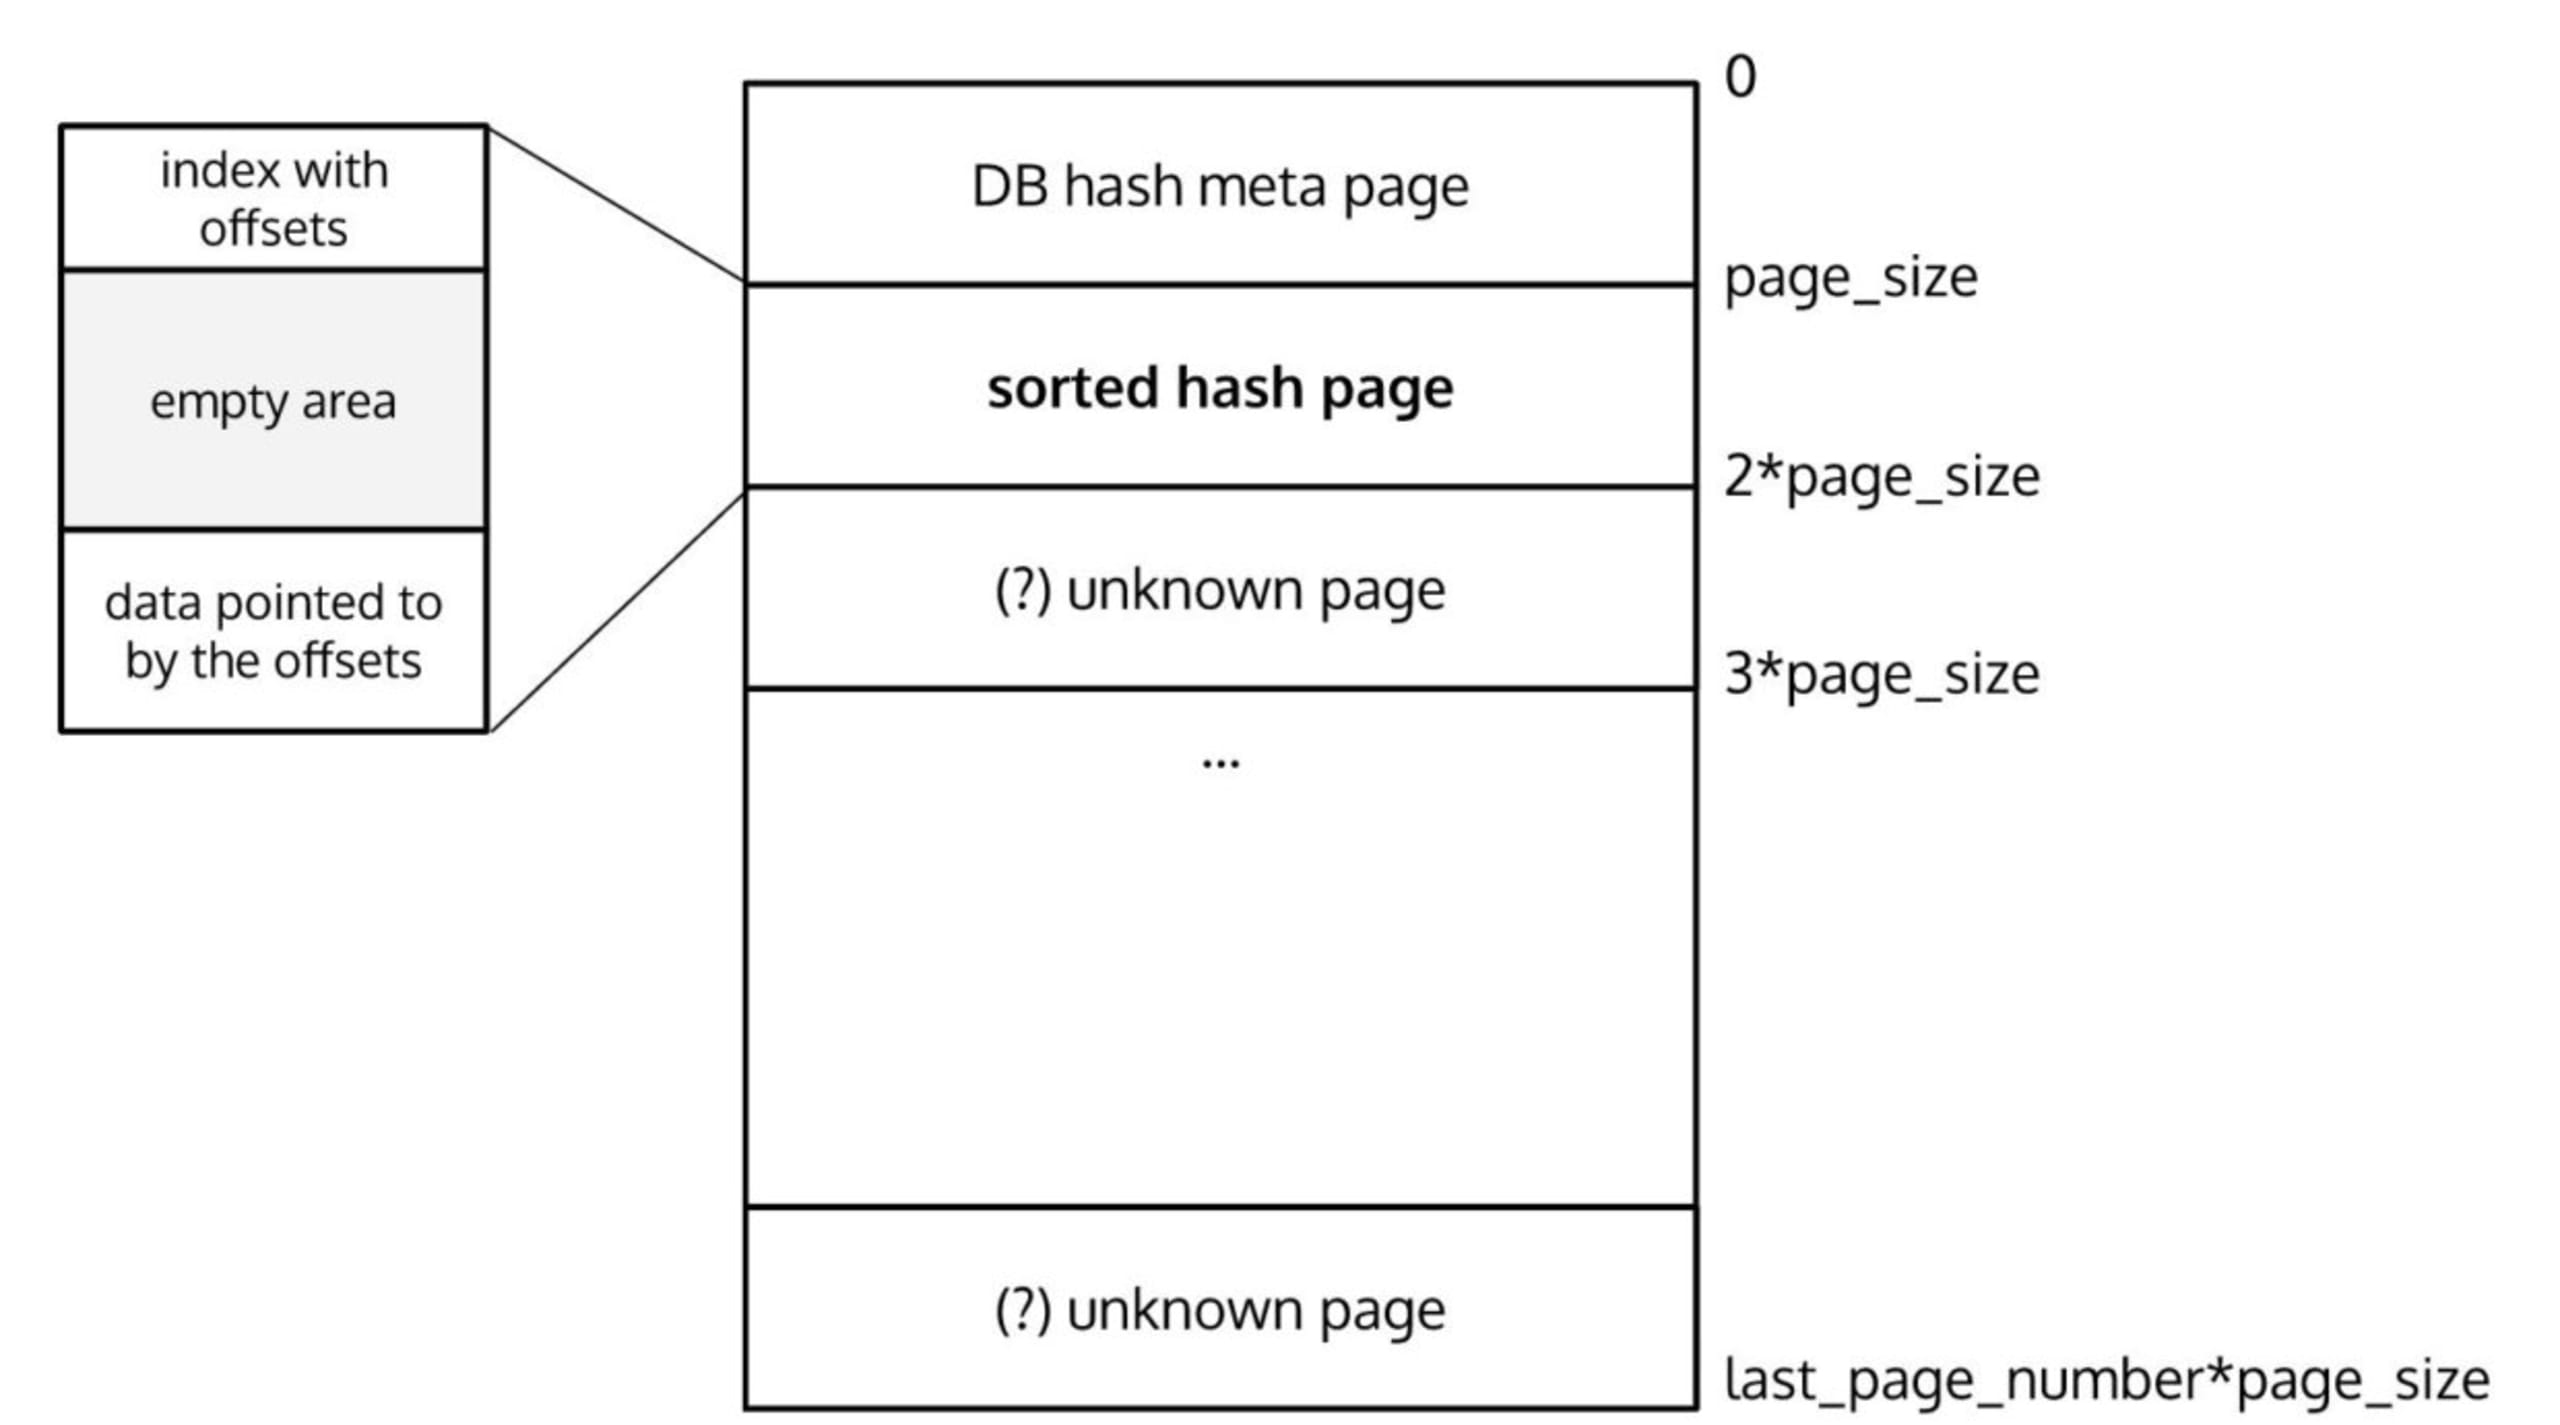
Sehen wir uns als Nächstes einen Eintrag aus dem Datenindex (dargestellt durch struct __hoffpage) an und werfen einen Blick auf die Seite, auf die er verweist. Wir können diese Seite laden, da wir sowohl ihre Nummer als auch die Größe jeder Seite kennen, und ihren Inhalt untersuchen:
Beachten Sie, dass next_pgno einen Wert enthält, der auf die nächste Seite mit den restlichen Daten verweist. hf_offset hat den Wert 4070. Das bedeutet, dass diese Seite vollständig mit Daten gefüllt ist (sie umfasst 4070 Byte, da die Seitengröße von 4096 Byte abzüglich des allgemeinen 26-Byte-Seitenheaders gerechnet wird). Um alle Daten zu erhalten, müssen wir also mehrere Seiten durchlaufen, indem wir next_pgno folgen und sämtliche Bytes zusammenführen.
Der vollständige Aufbau der Datenbank sieht so aus:
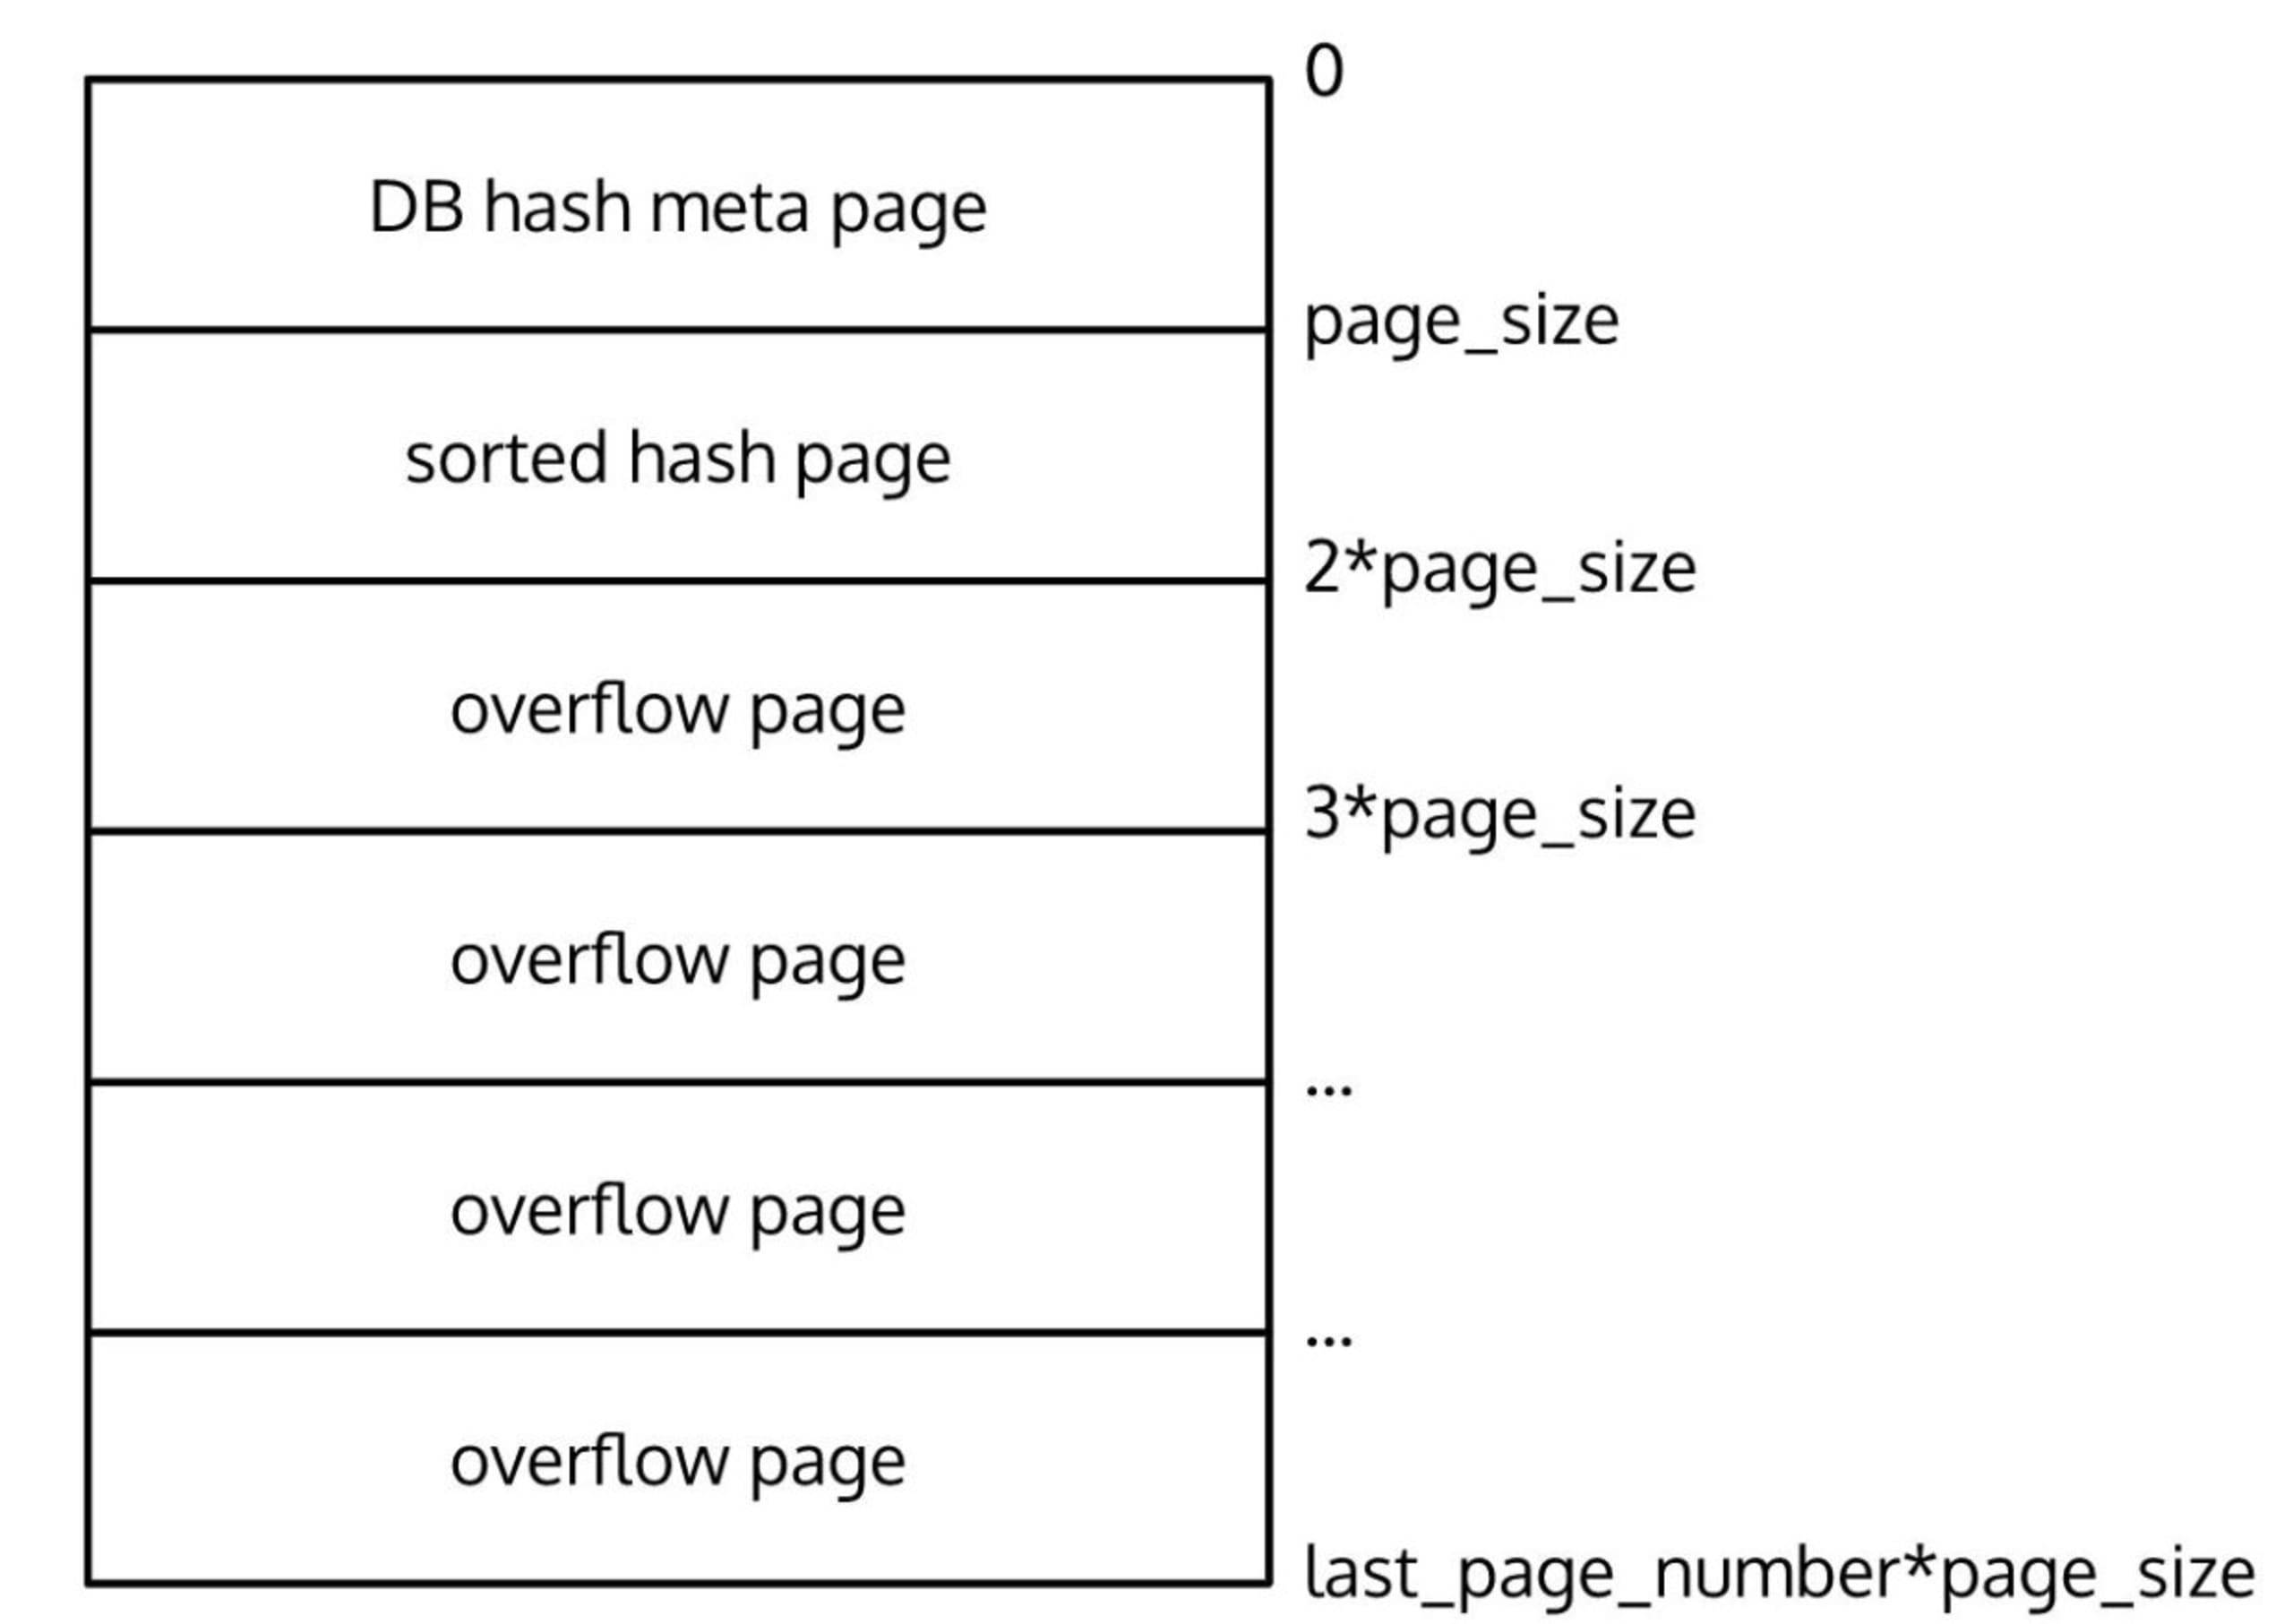
Damit wissen wir alles, was zum Lesen der Daten nötig ist! Nachdem wir alle miteinander verbundenen Overflow-Seiten durchlaufen haben, erhalten wir eine Liste binärer Datenblöcke, die den tatsächlichen RPM-Paketen entsprechen. Als Nächstes lesen wir die Pakete aus, um Informationen wie Paketname, Version, Architektur und mehr zu extrahieren.
RPM-Paketmetadaten analysieren
An dieser Stelle wechseln wir vom BerkeleyDB-Kontext zum Format der RPM-Pakete und ihrer Metadaten. Um zu verstehen, wie ein RPM-Paket aufgebaut ist, ziehen wir die Dokumentation zum RPM-Dateiformat heran.
Eine rpm-Datei besteht aus vier Abschnitten: einem Lead, einem Signatur-Header, einem Payload-Header und einer Payload (den eigentlichen Daten). Beide Header-Abschnitte haben dasselbe Format. Der Aufbau der einzelnen Abschnitte ist in den folgenden Abschnitten beschrieben. Sie stehen in der Datei direkt hintereinander, ohne zusätzliche Informationen davor, dazwischen oder danach.
Durch Ausprobieren stellen wir fest, dass BerkeleyDB in den binären Datenblöcken tatsächlich zwei Elemente speichert: einen teilweisen Payload-Headerund eine vollständige Payload. Der Lead und der Signatur-Header fehlen vollständig. Laut der RPM-Dokumentation sieht der Aufbau des Payload-Headers folgendermaßen aus:
Wie sich herausstellt, fehlen auch alle HMx-Einträge (Header Magic), die Versionsangabe und die reservierten Bytes! Stattdessen erhalten wir einen unvollständigen Header mit indexcount (Anzahl der Header-Indexeinträge), storesize (Größe des Datenspeichers in Byte), den Indexeinträgen und dem Datenspeicher.
Wichtig ist hier, dass die Daten im Big-Endian-Format gespeichert sind. Daher muss jeder Eintrag ausdrücklich in diesem Format gelesen beziehungsweise interpretiert werden.
Bis hierhin sehen die von uns aus BerkeleyDB erfassten binären Datenblöcke im Pseudocode so aus:
Die ersten beiden Elemente können wir recht einfach lesen. Um jedoch die index_entries auszulesen, müssen wir ihren Aufbau verstehen. Die Dokumentation zum RPM-Dateiformat gibt folgende Auskunft:
Wie sich herausstellt, ist jeder index_entry 16 Byte lang. Mit diesem Wissen und dem Wert von indexcount können wir alle RPM-Header-Einträge erfassen.
Nun können wir alle Indexeinträge in JavaScript auslesen und eine Liste wie die folgende erstellen:
In der RPM-Dokumentation finden wir eine Tabelle, in der erklärt wird, wofür die einzelnen tag-Werte stehen. Tags geben Paketinformationen wie Name (1000), Version (1001), Architektur (1022) und mehr an. Auch den type finden wir in der RPM-Dokumentation. Dort sind Einträge wie string (6), int32 (4) oder sogar der Typ null (0) aufgeführt.
Anhand von offset können wir nun zum Datenanfang jedes dieser Einträge springen. Dabei müssen wir bei der Berechnung des Offsets auch indexcount berücksichtigen, damit wir an der richtigen Datenposition landen. Je nach Wert von type können wir das folgende Byte-Array dann auf bestimmte Weise verarbeiten: Bei Typen wie string lesen wir beispielsweise die Bytefolge bis zu einem Byte mit dem Wert 0, das wie bei C-Software üblich das Ende der Zeichenfolge markiert. Bei einem Typ int32 wissen wir dagegen, dass wir nur 4 Byte lesen müssen.
Mit all diesen Informationen können wir sämtliche Indexeinträge durchlaufen und schließlich genügend Paketdaten extrahieren, um eine Abhängigkeit zu erstellen. Hier ist ein Beispiel für einen Eintrag:
Wenn wir denselben Vorgang für alle BerkeleyDB-Datenblöcke wiederholen, können wir sämtliche Paketinformationen extrahieren und die Liste der Abhängigkeiten erstellen.
Zusammenfassung
Wir haben uns eingehend mit dem Innenleben des RPM-Paketmanagers beschäftigt, um den binären Datenaufbau und die interne Darstellung der Informationen zu installierten Paketen zu verstehen. Genau so liest und analysiert Snyk die Liste der Abhängigkeiten in Ihren Container-Images. Snyk ist kostenlos nutzbar, und Sie können ein Konto erstellen. Sehen Sie sich auch unsere Open-Source-Bibliothek RPM parser auf GitHub an, die Ihnen diese Arbeit abnimmt!
Starten Sie mit Capture-the-Flag
Erfahren Sie in unserem virtuellen On-Demand-Workshop für Einsteiger, wie Sie Capture-the-Flag-Challenges lösen.


