Benchmarking de correções seguras e funcionais: como o Snyk Agent Fix aumenta em mais de 14% a taxa de correção dos modelos de ponta


18 de agosto de 2026
0 minutos de leituraResumo
Avaliamos o desempenho dos principais modelos na criação de correções de vulnerabilidades seguras e funcionais, usando cerca de 150 amostras reais de código vulnerável em JavaScript, Java e Python. Testamos cada modelo sozinho e com o Snyk Intelligence (a nova arquitetura agentiva do Agent Fix). Principais descobertas:
Sem ajustes, os modelos de ponta ficam entre 72% e 75%. Gemini 3.1 Pro, Claude Sonnet 4.6 e Claude Opus 4.6 têm resultados muito próximos. Na correção segura e funcional, a escolha do modelo quase não altera o resultado.
O Snyk Intelligence faz os mesmos modelos superarem essa faixa. O Opus 4.6 sobe de 74,6% para 85,4%, um ganho de 10,8 pontos (mais 14,48% de amostras corrigidas). O que faz diferença é o contexto de segurança, não o modelo.
O ganho é maior justamente onde o modelo tem mais dificuldade. O Opus sozinho corrige apenas 64% das amostras em Python; com o Snyk Intelligence, chega a 88%.
Introdução
Existem benchmarks de agentes de programação para geração de testes unitários, correção de bugs no estilo SWE-bench e conclusão de código. Mas não há um benchmark público amplamente usado para a tarefa que realmente importa para uma equipe de segurança: pegar um código com uma vulnerabilidade conhecida e criar uma correção que elimine a vulnerabilidade e mantenha o código funcionando. São dois critérios independentes, e atender a um sem cumprir o outro é uma falha comum e custosa. Uma correção que elimina uma injeção de SQL, mas altera o resultado da consulta, não ajuda ninguém. E uma correção que parece boa, mas mantém a injeção, é ainda pior, porque parece resolver o problema.
Por isso, criamos um benchmark que avalia os dois critérios em cada correção e testamos modelos de ponta de duas formas: sozinhos e com o conhecimento de segurança da Snyk. A pergunta que queríamos responder de forma direta era: quanto o contexto de segurança da Snyk muda o que um modelo de ponta consegue corrigir, e em quais casos?
Em resumo: sem ajustes, os modelos estagnaram na faixa de 72% a 75%, e o Snyk Intelligence é o que permite superar esse patamar. O restante deste post apresenta os dados e a metodologia.
Como medimos: o benchmark Golden Test
A maioria dos benchmarks de código verifica se o código executa ou se resolve um relato de bug. Nenhum desses critérios basta para uma correção de segurança, que precisa atender ao mesmo tempo a um requisito de segurança e a um de funcionalidade. Nosso conjunto de avaliação, os Golden Tests, foi criado para medir os dois. O projeto se inspira no SWE-bench, adaptado para segurança.
As amostras
O conjunto contém cerca de 150 amostras reais de código vulnerável: 50 em Python, 54 em JavaScript e 39 em Java. Cada amostra é um trecho de código com exatamente uma vulnerabilidade, identificada pelo Snyk Code e confirmada por um especialista humano em segurança. As amostras foram escolhidas para que o modelo consiga corrigir o problema com o código disponível, sem depender de contexto externo ausente.
A avaliação
Cada amostra vem acompanhada de dois testes unitários verificados por pessoas:
Um teste que falha quando a vulnerabilidade está presente; e
Um teste que passa quando a funcionalidade original do código é preservada (por exemplo, uma função auxiliar que deve retornar 'hello world' continua retornando 'hello world' após a correção).
Para ser aprovado, o modelo precisa corrigir o código de modo que os dois testes passem, na primeira tentativa e sem nunca ver nenhum dos testes. O modelo não vê os testes unitários, então a aprovação indica uma correção realmente segura e funcional, não uma resposta ajustada a um teste conhecido.
Considere uma amostra em Python com uma injeção de SQL: o código monta uma consulta concatenando a entrada do usuário. O teste de segurança envia uma carga de injeção de SQL e verifica se o banco de dados não expõe todas as linhas; o código vulnerável falha nesse teste. O teste funcional envia um nome de usuário comum e verifica se o registro correto é retornado; o código original passa. A correção só conta se a alteração do modelo fizer o teste de segurança passar sem comprometer o teste funcional, na primeira tentativa e sem que os testes tenham sido vistos.
O que avaliamos
Seis configurações: o modelo interno anterior do Agent Fix, baseado no StarCoder; três modelos de ponta sem ajustes (Gemini 3.1 Pro, Claude Sonnet 4.6 e Claude Opus 4.6); e o Sonnet 4.6 e o Opus 4.6, cada um com o Snyk Intelligence na nova arquitetura agentiva do Agent Fix. Neste contexto, “Snyk Intelligence” se refere à geração dinâmica de exemplos: no momento da correção, inserimos as correções mais relevantes, escritas por especialistas, para aquela vulnerabilidade específica, extraídas do banco de dados da Snyk, com mais de 35 mil vulnerabilidades. (Isso dá continuidade a um trabalho anterior em que a mesma abordagem melhorou o desempenho de LLMs prontos para uso.)
Como o benchmark Snyk Agent Fix se compara aos benchmarks anteriores?
O conjunto Golden Test faz parte de uma trajetória de pesquisas que vem elevando o padrão de avaliação de IA em código. O SWE-bench estabeleceu o método de avaliar modelos com testes reais ocultos, em vez de confiar na plausibilidade declarada pelo próprio modelo. Na área de segurança, o Vul4J introduziu vulnerabilidades reproduzíveis com testes que comprovam sua presença e um conjunto de testes de regressão funcional, o precedente mais próximo do nosso modelo de FALHA para APROVAÇÃO e APROVAÇÃO para APROVAÇÃO. Pesquisas mais recentes, como BaxBench e SEC-bench, reforçam o princípio que orientou nosso trabalho: um código funcionalmente correto ainda costuma ser inseguro. Por isso, um benchmark confiável de correções precisa avaliar as duas propriedades ao mesmo tempo. O diferencial do conjunto Golden Test é aplicar os dois critérios em conjunto, com amostras reais verificadas por especialistas, testes ocultos para o modelo e cobertura de três linguagens usadas em produção.
Resultados
A principal métrica é a porcentagem de Golden Tests em que a correção foi segura e funcional.
Configuração | Taxa de correções funcionais e seguras |
|---|---|
StarCoder (modelo anterior do Agent Fix) | 72,4% |
Gemini 3.1 Pro | 74,2% |
Claude Sonnet 4.6 | 72,4% |
Claude Opus 4.6 | 74,6% |
Claude Sonnet 4.6 + Snyk Intelligence | 82,5% |
Claude Opus 4.6 + Snyk Intelligence | 85,4% |
GRÁFICO 1: Taxa de correções funcionais e seguras.
Sem ajustes, os modelos ficam em uma faixa de três pontos. Com o Snyk Intelligence, a diferença chega a 8 a 11 pontos para o mesmo modelo: o Opus 4.6 sobe de 74,6% para 85,4%.
A análise dos resultados do Opus por linguagem mostra que o ganho não é um artefato da média. Ele se mantém em todas as linguagens testadas e é maior justamente onde o modelo sem ajustes tem mais dificuldade.
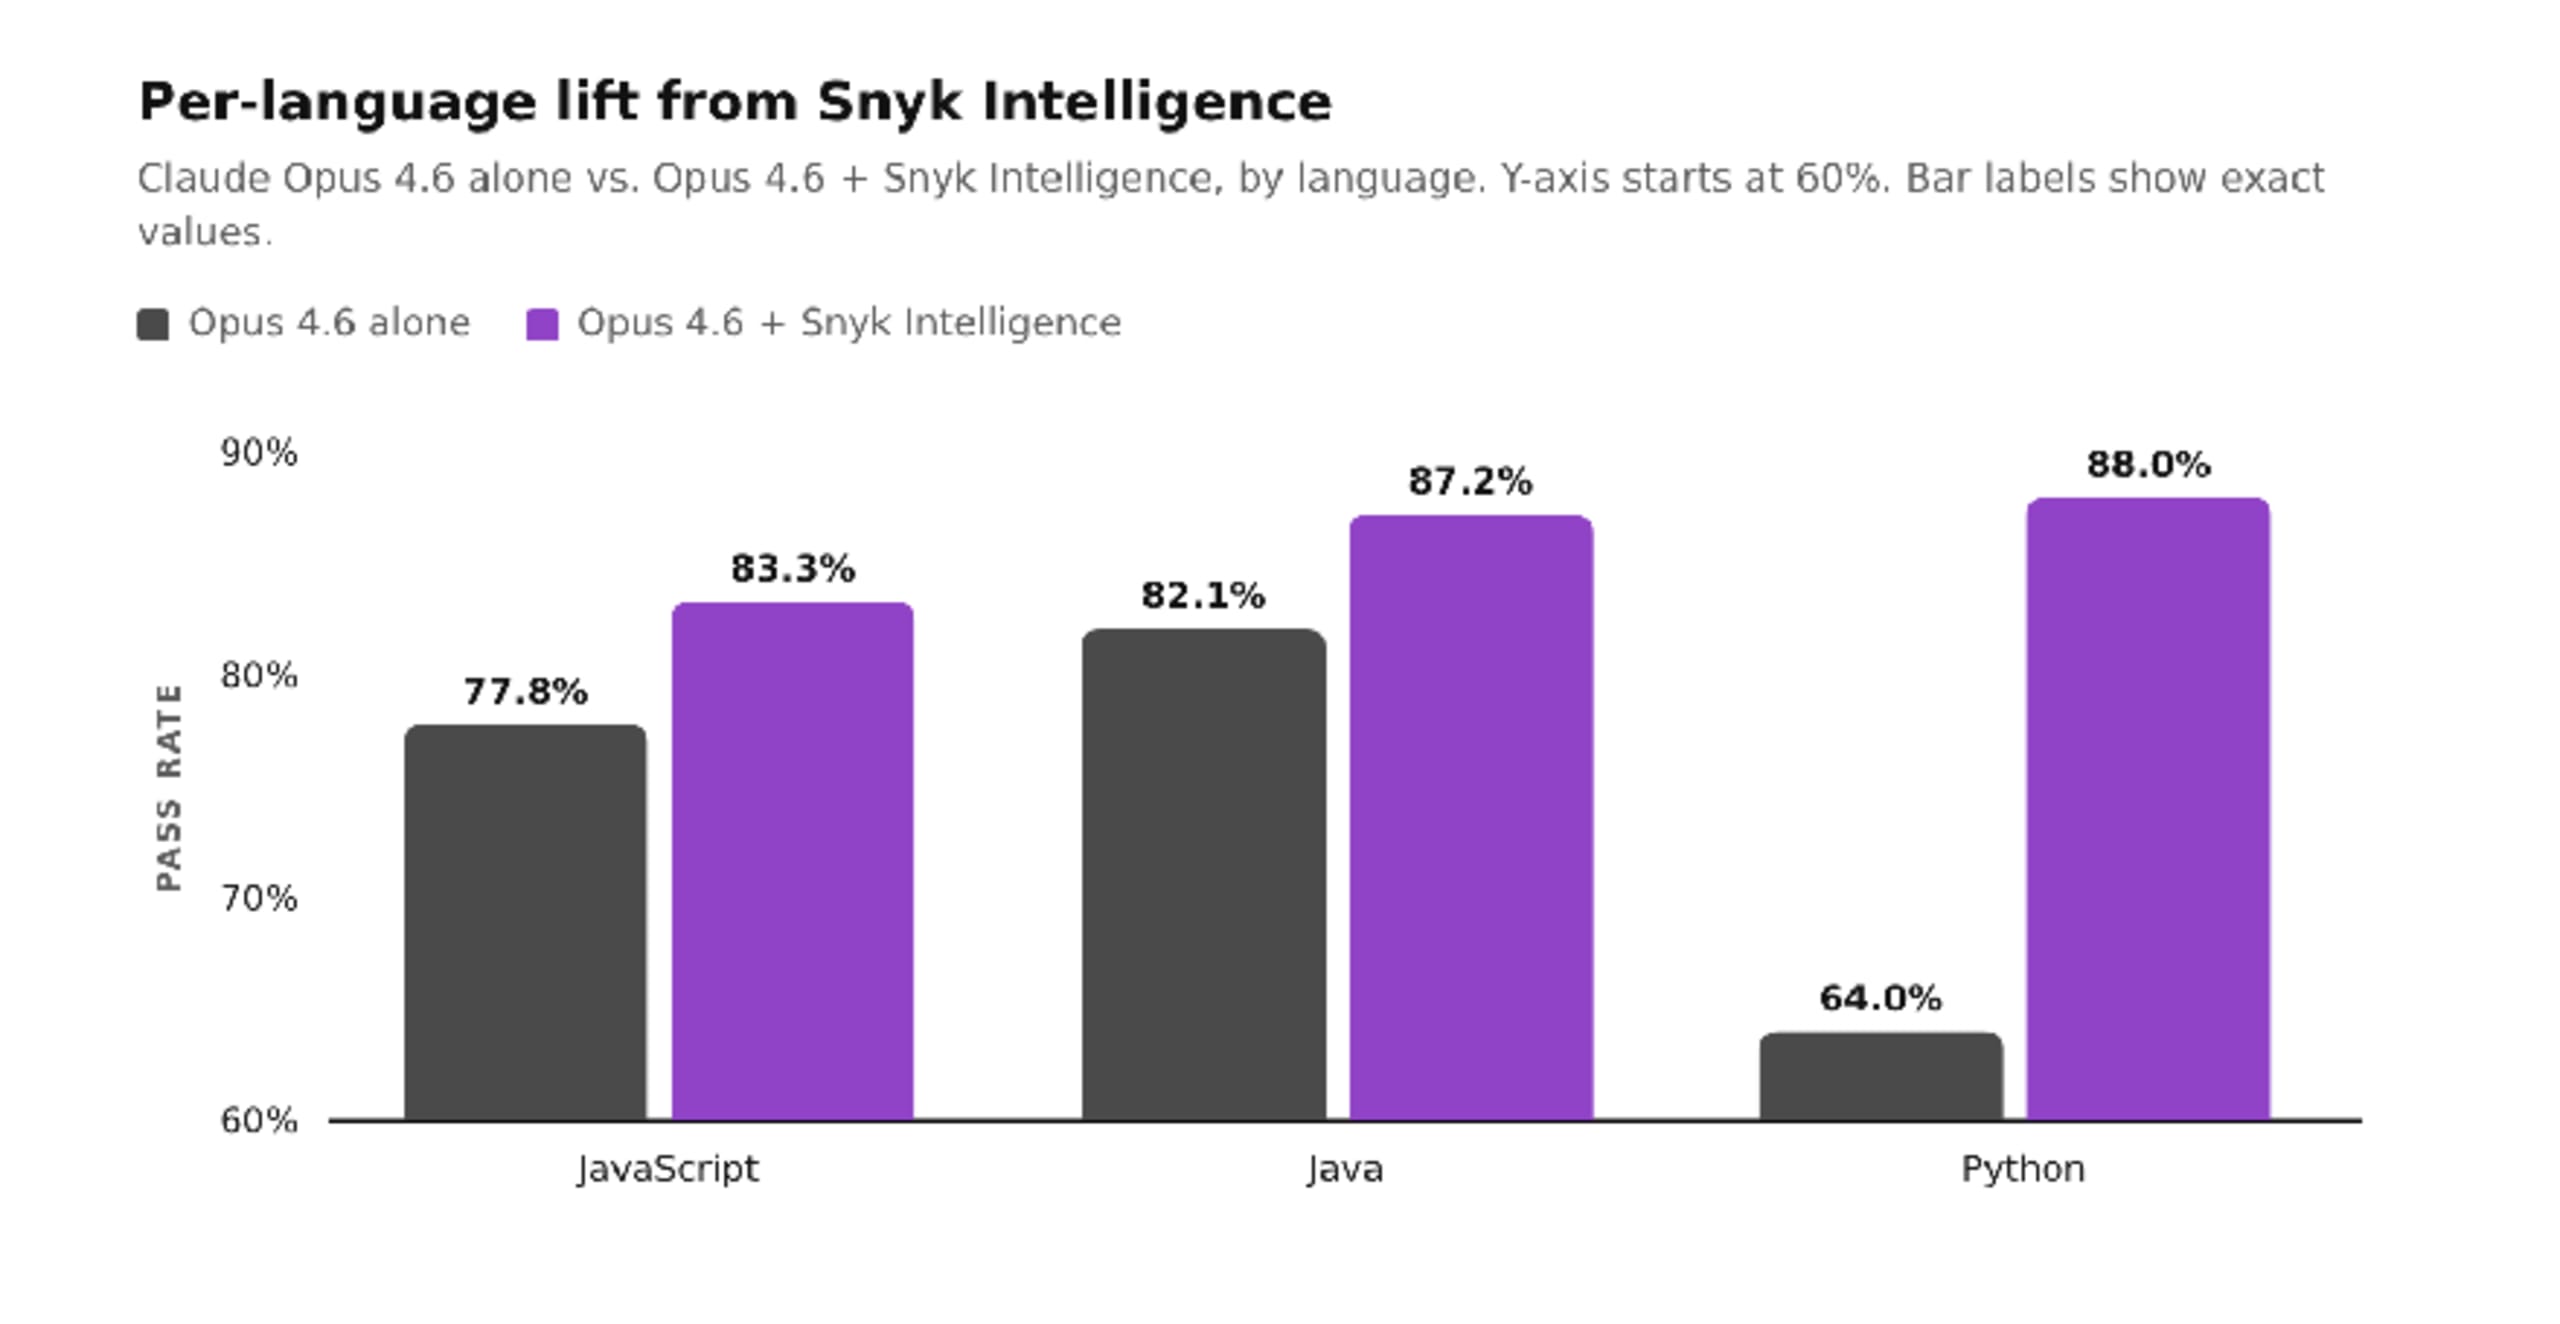
GRÁFICO 2: Ganho por linguagem
Python é o caso mais evidente: o Opus sozinho corrige 64,0% das amostras; com o Snyk Intelligence, esse índice salta para 88,0%. Em JavaScript e Java, onde o Opus já começa com resultados fortes, o ganho é de cinco a seis pontos.
O que os números significam
O tamanho bruto do modelo chegou a um platô na correção segura e funcional
Os três modelos sem ajustes variam de 72,4% a 74,6%, uma diferença de 2,2 pontos entre dois fornecedores. Se um modelo maior ou mais recente fosse o fator decisivo para essa tarefa, esperaríamos ver essa diferença aqui. Mas não vemos. A tarefa é difícil por um motivo que a capacidade geral não resolve diretamente: o modelo precisa saber como é uma correção segura para essa vulnerabilidade específica, e não apenas escrever um código plausível.
O que faz diferença é o contexto de segurança, não um modelo maior
O mesmo Opus 4.6 ganha 10,8 pontos (mais 14,48% de amostras corrigidas) apenas com a inclusão de exemplos de segurança no momento da correção. Como a abordagem não depende de um modelo específico, cada avanço nos modelos de ponta se soma a esse contexto, em vez de competir com ele. O ativo duradouro são as mais de 35 mil correções feitas por especialistas; o modelo é um componente que podemos substituir à medida que o campo evolui. Por isso, o Agent Fix em produção agora combina o Snyk Intelligence com o Claude Opus 4.7.
O ganho é maior justamente onde o modelo tem mais dificuldade
O Opus sozinho corrigiu apenas 64% das amostras em Python, sua linguagem com pior resultado. Com o Snyk Intelligence, chegou a 88%, o maior ganho entre as três linguagens. O contexto de segurança não apenas eleva a média; ele melhora o resultado mais baixo.
Os resultados se confirmam em uma segunda análise
O resultado do Opus com Snyk é uma média entre execuções (84,6% e 86,0% nas duas execuções agregadas); assim, os 85,4% divulgados refletem um desempenho consistente. A variação entre execuções nesse conjunto é de cerca de um ponto, o que vale ter em mente ao comparar configurações com diferença de um ou dois pontos.
A seguir: Snyk VulnBench e detecção de vulnerabilidades com agentes de programação
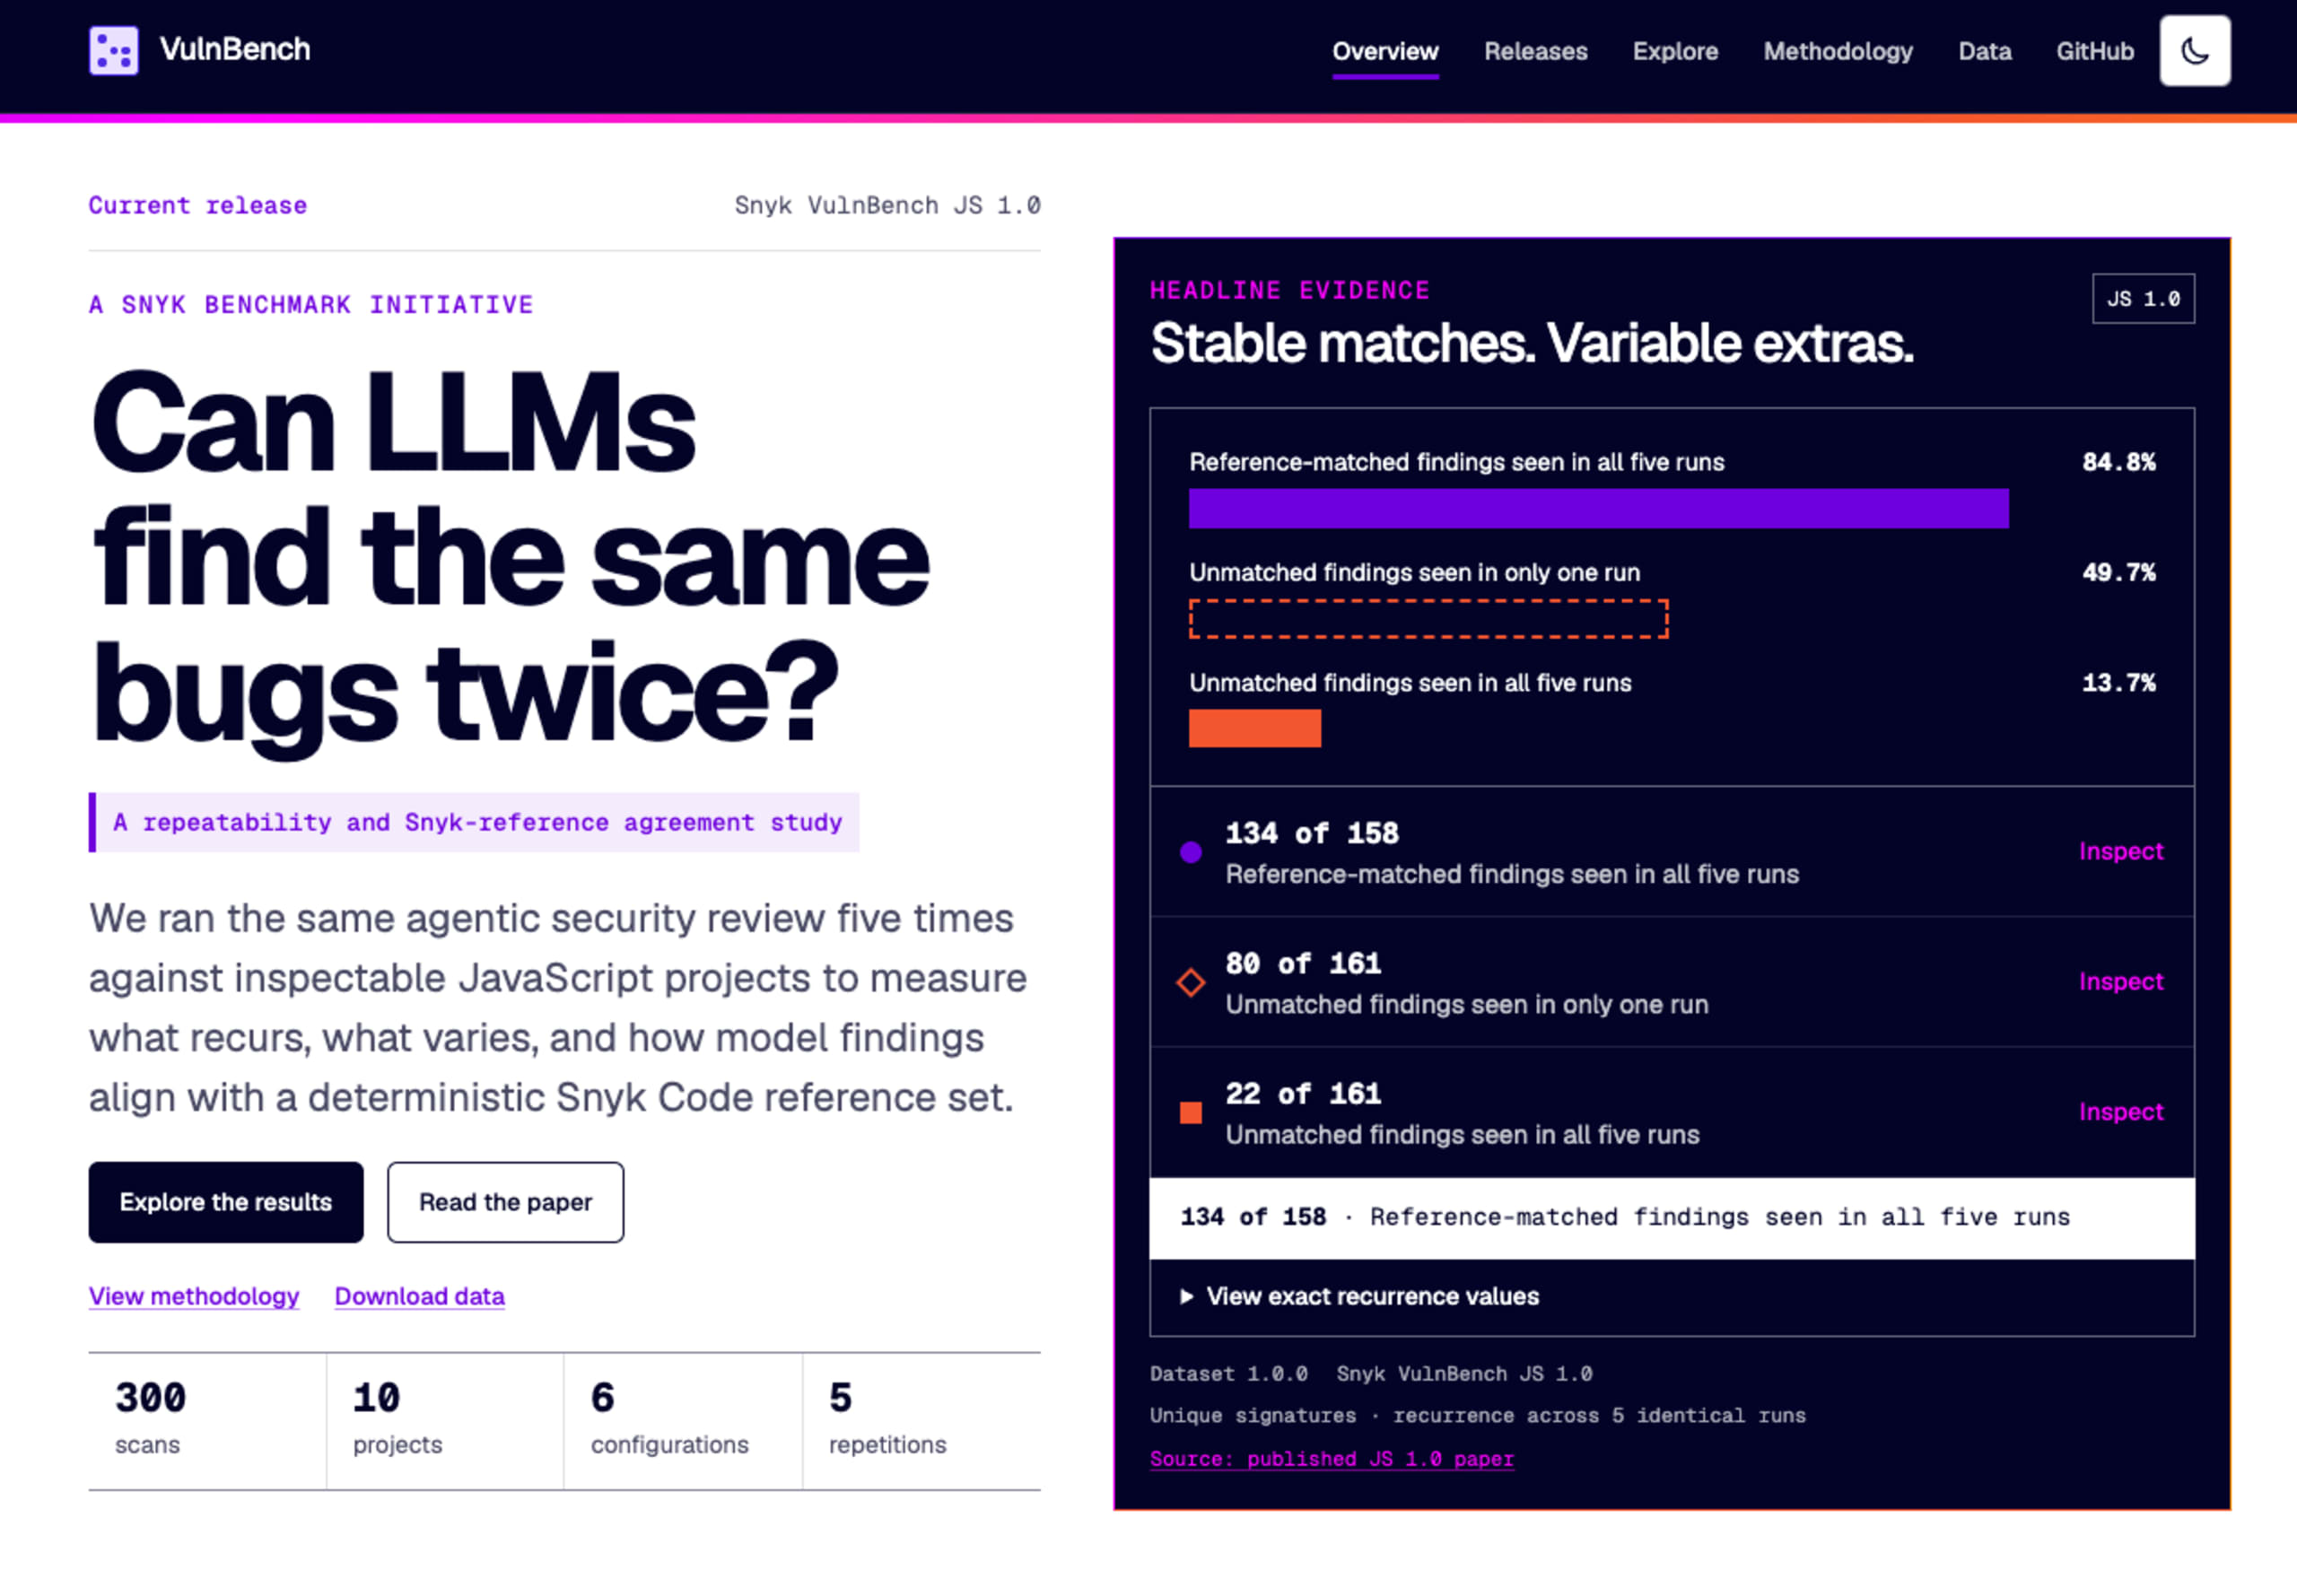
Corrigir uma vulnerabilidade pressupõe que você a encontrou. Em junho de 2026, publicamos o artigo Snyk VulnBench JS 1.0, que comparou o Snyk Code, um mecanismo SAST determinístico e rápido, com LLMs equipados com agentes de programação (o harness do Claude Code) para detectar vulnerabilidades no código antes que precisem ser corrigidas.
Nossas descobertas com o Snyk VulnBench mostraram que até mesmo modelos de linguagem de ponta, como o Claude Opus 4.7 no nível máximo de raciocínio (também chamado de max), e até mesmo com um harness avançado de agente de programação (o próprio Claude Code), enfrentaram desafios de repetibilidade e determinismo. Algumas das principais descobertas:
Em um caso, o modelo e o agente de programação relataram cerca de 50% de descobertas que não se repetiram em quatro das cinco execuções seguintes, gerando um acúmulo de falsos positivos e fadiga de vulnerabilidades para desenvolvedores de sistemas agentivos e engenheiros de segurança de IA.
Em outros casos, 13% dos agentes de programação relataram vulnerabilidades não correspondentes em todas as cinco execuções, criando ainda mais confusão e sobrecarga cognitiva com o acúmulo de problemas de segurança que poderiam ser falsos positivos.
Convidamos você a investigar e explorar o conjunto de dados Snyk VulnBench, disponível publicamente online para consulta em https://vulnbench.com/
Limitações
Quatro limitações que você deve considerar antes de se basear nestes números:
Tamanho do conjunto: Cerca de 150 amostras (50 em Python, 54 em JavaScript e 39 em Java) são suficientes para revelar padrões claros, mas não para afirmar significância estatística em diferenças pequenas. A avaliação de referência do StarCoder usou uma amostra cerca de 20% menor (apenas regras compatíveis com o Agent Fix para as quais havia dados de treinamento); considerando todas as regras, o resultado é de 54,9%. É o modelo interno da Snyk, ajustado para a tarefa e incluído como referência, não como modelo de ponta.
Trechos de código, não aplicações inteiras: Cada amostra é um único arquivo com uma vulnerabilidade, corrigível com base no contexto local. Bases de código reais têm contexto distribuído entre arquivos e vários problemas interagindo entre si; este benchmark não mede isso.
Três linguagens: Avaliamos JavaScript, Java e Python. A nova arquitetura oferece suporte a todas as linguagens compatíveis com o Snyk Code, mas hoje estas são as três que têm cobertura no Golden Test.
Poucas execuções para medir a variação: Agregamos duas execuções para as configurações com Snyk e ainda não fizemos repetições suficientes para publicar margens de erro formais para cada resultado. Considere aproximadas as diferenças inferiores a dois pontos.
Apresentamos essas limitações para ajudar você a avaliar quais conclusões considerar, não para relativizar os resultados. A diferença de mais de 10 pontos com o Snyk Intelligence supera com folga a variação entre execuções; já a ordem das pequenas diferenças por linguagem, não.
Próximos passos
Ampliar a cobertura de linguagens: Expandir os conjuntos Golden Test para além de JavaScript, Java e Python, alinhando o benchmark a todas as linguagens compatíveis com a arquitetura.
Quantificar a variação: Executar cada configuração vezes suficientes para publicar margens de erro adequadas, em vez de uma média de duas execuções.
Avaliar detecção, não apenas correção: Este benchmark mede a correção de vulnerabilidades. Um estudo complementar mede o quanto os agentes conseguem identificar vulnerabilidades em comparação com o Snyk Code, e apresentaremos os resultados separadamente.
O novo Agent Fix agentivo já está disponível, combinando o Snyk Intelligence com o Claude Opus 4.7. Quer ver correções seguras e funcionais no seu próprio código? Comece com o Snyk Code e o Agent Fix e saiba mais sobre a engenharia por trás destes números.
Você pode confiar no código gerado por IA? Criei um scanner para descobrir
Apêndice: metodologia e agregação
Estrutura da avaliação: Cada Golden Test contém um exemplo de código com exatamente uma vulnerabilidade, além de um teste de segurança unitário (que falha no código vulnerável) e um teste funcional unitário (que passa no código original). Uma configuração só é aprovada em um exemplo se a correção fizer os dois testes passarem na primeira tentativa, sem que o modelo tenha acesso aos testes.
Agregação: As taxas reportadas correspondem à proporção de exemplos corrigidos.
O resultado anterior do modelo (StarCoder), de 72,4%, é a média das taxas por linguagem e considera apenas as regras compatíveis com o Agent Fix; incluindo todas as regras, cai para 54,9%.
O resultado de 85,4% para Opus 4.6 + Snyk Intelligence é a média entre as execuções (execução 1 = 86,0%, execução 2 = 84,6%). Os resultados por linguagem no segundo gráfico vêm de uma única execução representativa, por isso a média é um pouco maior (~86%) do que o resultado geral obtido em várias execuções. O resultado geral é o que deve ser citado.
Configurações: StarCoder (modelo anterior do Agent Fix); Gemini 3.1 Pro; Claude Sonnet 4.6 e Claude Opus 4.6, ambos sem ajustes e com Snyk Intelligence, usando a arquitetura agentiva do Agent Fix. Os dados foram coletados com o Opus 4.6; desde então, o Agent Fix em produção passou a usar o Claude Opus 4.7. O Snyk Intelligence insere correções elaboradas por especialistas para a fraqueza específica no momento da geração (prompting dinâmico com few-shot).
Veja o Snyk em ação
Veja por que desenvolvedores e equipes de segurança escolhem o Snyk como solução de AppSec — e o que ele pode fazer pela sua equipe.