Simplificando a segurança de contêineres com a expertise em segurança da Snyk

Hadas Bloom
8 de março de 2022
0 minutos de leituraO aspecto mais fascinante e inspirador do código aberto é, bem, o fato de ser de código aberto. Podemos ver os pacotes de código aberto como presentes trocados entre desenvolvedores de todo o mundo da engenharia: eles permitem que todos aprendam com o trabalho de outras pessoas, contribuam com sua própria expertise e desenvolvam suas capacidades profissionais. A comunidade valoriza muito as contribuições para projetos de código aberto, e é importante lembrar que não devemos apenas nos beneficiar deles, mas também contribuir. Essa colaboração mantém o código aberto em constante evolução, com conhecimento compartilhado e pacotes que servem de base para tecnologias novas e empolgantes.
Mas essas bibliotecas e esses projetos de uso gratuito também trazem riscos, sejam eles acidentais ou causados por agentes mal-intencionados — e é exatamente aí que a Snyk entra.
Naturalmente, com a evolução contínua das tecnologias de código aberto, como as novas e aprimoradas distribuições Linux e ferramentas de contêiner como o Docker, cada vez mais imagens que agrupam esses pacotes de código aberto são criadas e usadas. Basicamente, uma imagem de contêiner é um arquivo que contém o código, as bibliotecas, as dependências e outras ferramentas e arquivos necessários para a execução de aplicações. Um contêiner, por sua vez, é a instância em execução dessa imagem e define o “espaço” em que a aplicação é executada e desenvolvida. Um contêiner permite criar um ambiente em que seu código pode funcionar e depende da imagem — na verdade, ele é iniciado a partir dela. Melhor ainda: um dos recursos mais poderosos das imagens de contêiner é que elas podem ser construídas umas sobre as outras. Você pode começar com uma imagem que tenha apenas os elementos básicos do Linux — por exemplo, algo como alpine do Docker; adicionar ferramentas e frameworks específicos de uma linguagem para criar uma imagem voltada a ela; incluir ferramentas de desenvolvimento para essa linguagem; e, por fim, adicionar os detalhes do seu próprio código.
Se uma imagem é apenas um arquivo com um conjunto de pacotes, você provavelmente já está se perguntando qual é o desafio para determinar quais vulnerabilidades os afetam. Não podemos presumir que, se há uma vulnerabilidade em um pacote de código aberto e esse pacote é usado em uma imagem, a imagem está vulnerável? Ótima pergunta, obrigado por perguntar! Assim como o uso de uma imagem-base, como alpine no exemplo acima, oferece muitas ferramentas e possibilidades, cada pacote também pode introduzir vulnerabilidades sem que você perceba. De repente, descobrir vulnerabilidades no seu próprio código já não basta — você também precisa garantir a segurança da imagem-base e de todas as imagens que cria ao adicionar suas ferramentas.
Para este artigo, vamos nos concentrar na primeira parte da imagem: a imagem-pai que você escolhe inicialmente como base (alpine, no exemplo). Essa camada costuma ser onde a maioria dos pacotes principais do Linux é introduzida, assim como o próprio gerenciador de pacotes do Linux. Também é uma área que costuma gerar confusão porque, ao contrário de tudo o que você pode escolher adicionar, você tem pouco controle sobre o que vem nessa imagem-base. Então, vamos explorar a fundo os desafios das vulnerabilidades em contêineres e, em seguida, ver como a Snyk pode ajudar a resolvê-los.
Entenda as vulnerabilidades do Linux no universo dos contêineres
Sistema de gerenciamento de pacotes
Cada distribuição Linux (Alpine, Debian, Ubuntu etc.) tem seu próprio grupo de mantenedores. Embora todas ofereçam uma versão do Linux, o que implica alguns pontos em comum, cada uma pode criar seus próprios esquemas de nomenclatura e versionamento para atualizações. Isso significa que nem sempre mantêm os mesmos nomes ou versões dos pacotes correspondentes no upstream. Assim, ao analisar os detalhes das correções de um problema específico — ou mesmo patches gerais do sistema —, cada distribuição pode oferecer orientações diferentes aos usuários.
Veja, por exemplo, a correção para CVE-2021-44228, também conhecida como Log4Shell, no famoso pacote log4j. O pacote upstream, mantido pela equipe Apache no Maven, chama-se logging-log4j2, e a correção para essa vulnerabilidade crítica foi lançada na versão 2.15.0. No entanto, para quem usa Debian, o nome do pacote fornecido pelo Debian é apache-log4j2e a correção foi lançada na versão estável atual, Debian 11 (“bullseye”), na versão 2.15.0-1~deb11u1. No Ubuntu, o nome é semelhante ao do Debian neste caso: apache-log4j2, mas a versão corrigida na versão mais recente do Ubuntu (21.10) é 2.15.0-0.21.10.1.
Em resumo, estes são os pacotes corrigidos para a CVE-2021-44228:
Nome do pacote | Versão corrigida | |
|---|---|---|
Java upstream (Maven) | logging-log4j2 | 2.15.0 |
Debian 11 (“Bullseye”) | apache-log4j2 | 2.15.0~deb11u1 |
Ubuntu 21.10 (“Impish Indri”) | apache-log4j2 | 2.15.0-0.21.10.1 |
Este exemplo relativamente simples mostra que, mesmo quando nossos dedicados analistas de segurança identificam ou fazem a triagem de uma vulnerabilidade em um pacote de código aberto upstream, não podemos presumir de imediato qual pacote correspondente é usado nas diferentes distribuições Linux, quais versões são afetadas ou mesmo se uma determinada distribuição é afetada. É necessário um processo de triagem diferente para os pacotes derivados e incluídos nas diversas imagens.
Essa forma de lidar com nomes e versões facilita o trabalho das diferentes equipes das distribuições Linux: elas podem acompanhar suas próprias versões, identificar qual versão upstream estão usando com base em seu próprio formato e controlar seus pacotes. Cada distribuição gerencia e assume a responsabilidade por todos os aspectos de compilação e criação dos pacotes usados em seu ecossistema. Manter nomes e versões próprios permite controlar corretamente o lançamento de patches e backports no sistema.
O mais correto é tratar cada pacote como uma entidade diferente, dependendo de onde ele pode ser baixado. Se o pacote está no gerenciador de pacotes de uma determinada distribuição Linux, mesmo que tenha o mesmo nome de um pacote controlado no PyPI, Maven ou em outros repositórios, precisamos tratá-lo como um pacote diferente, mantido por outra equipe e compilado especificamente para atender ao ambiente e às necessidades daquela distribuição.
Terminologia e estrutura dos dados
Além das diferenças nos nomes e nas versões dos pacotes usados por cada distribuição Linux, também há diferenças nos termos usados para definir vários aspectos dos dados de segurança fornecidos por cada fonte.
Por exemplo, a definição de gravidade “crítica” pode variar. Uma equipe pode usar “crítica” com mais frequência e flexibilidade do que outra, que geralmente classifica as vulnerabilidades como “alta” e só as considera “críticas” em situações muito específicas.
Por outro lado, termos diferentes podem significar a mesma coisa e ser usados da mesma maneira — como “moderada” e “média”, que equipes diferentes podem usar para indicar o mesmo nível de gravidade.
Além disso, quando uma equipe usa o termo “importante”, por exemplo, é preciso distinguir a importância para priorizar a correção do problema da importância da própria vulnerabilidade (ou seja, se a gravidade dela é relativamente alta).
Para explicar essa complexidade, vamos analisar a CVE-2021-3507, que afeta o Debian:
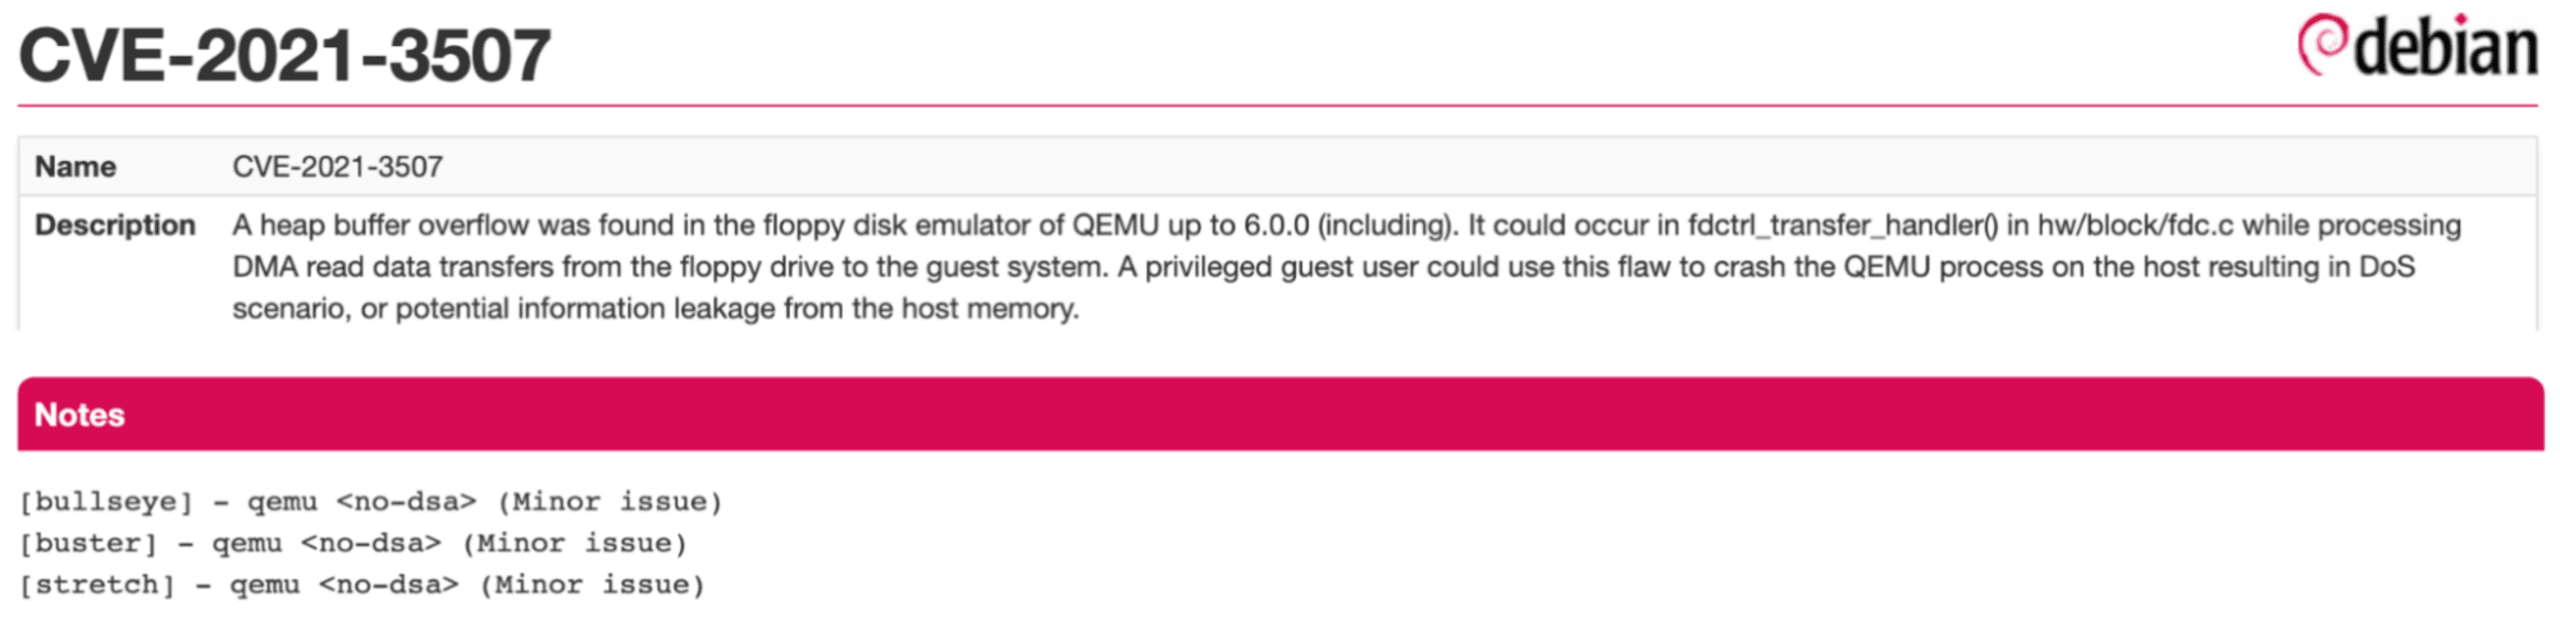
Como mostra o aviso referenciado, essa CVE está marcada como <no-dsa> (Minor issue) para Stretch (Debian 9), Buster (10) e Bullseye (11). Na avaliação dos mantenedores do Debian, essas indicações representam a gravidade do problema nessas versões.
Já a NVD atribuiu a essa CVE uma pontuação CVSS “média”, que reflete uma análise mais ampla da vulnerabilidade, especialmente relevante para o pacote upstream qemu.
Grande volume de dados
Cada distribuição Linux e cada uma de suas versões incluem muitos pacotes por padrão, além de muitos — muitos mesmo — que podem ser baixados do repositório específico da distribuição. Isso significa que nosso contêiner pode ter centenas de vulnerabilidades, afetando pacotes escritos em várias linguagens. O enorme volume de dados sobre vulnerabilidades no ambiente de contêineres torna mais complexo para a Snyk, as equipes de segurança e os desenvolvedores que usam contêineres fazer a triagem e entender vulnerabilidades específicas e o que deve ser feito a respeito. Por isso, analisar cada vulnerabilidade a fundo é um grande desafio.
Esses desafios específicos do universo das vulnerabilidades em contêineres tornam difícil identificar os dados mais precisos dentro de um contêiner. Quais vulnerabilidades são relevantes para um contêiner específico? Qual é o risco real delas, considerando a interação do contêiner com o kernel Linux e com a aplicação em execução? Nossa equipe de vulnerabilidades em contêineres da Snyk trabalha continuamente para responder a essas perguntas com a maior precisão possível. Criamos um modelo complexo que considera diversos fatores para identificar e priorizar essas vulnerabilidades com precisão.
Como resolver esses desafios?
Depois de entender a complexidade, podemos buscar uma solução para identificar os dados mais precisos. O processo de coleta, análise e identificação das vulnerabilidades corretas em contêineres começa com um pipeline escalável, capaz de processar grandes volumes de dados de várias fontes de forma inteligente e automatizada, mas que também aciona a intervenção humana quando necessário. Ele exige conhecimento aprofundado, baseado na combinação de expertise em segurança e colaboração com as equipes de segurança das diferentes distribuições Linux, que fornecem o contexto complementar que nos falta. Com todo esse conhecimento, proveniente de várias fontes, podemos reunir e selecionar as informações mais relevantes e úteis. Por fim, priorizamos as vulnerabilidades em seu contexto específico, considerando todos esses fatores e outros dados externos disponíveis, para reduzir o ruído irrelevante. Veja o que isso significa para nós na Snyk.
Como a Snyk analisa as vulnerabilidades de contêineres e do Linux?
O principal objetivo da nossa equipe de segurança de contêineres é responder às perguntas: Quais vulnerabilidades afetam um contêiner, qual é a prioridade para corrigi-las e o que posso fazer a respeito?
Veja um pouco de como garantimos respostas precisas, completas e rápidas:
Coleta de dados em tempo hábil
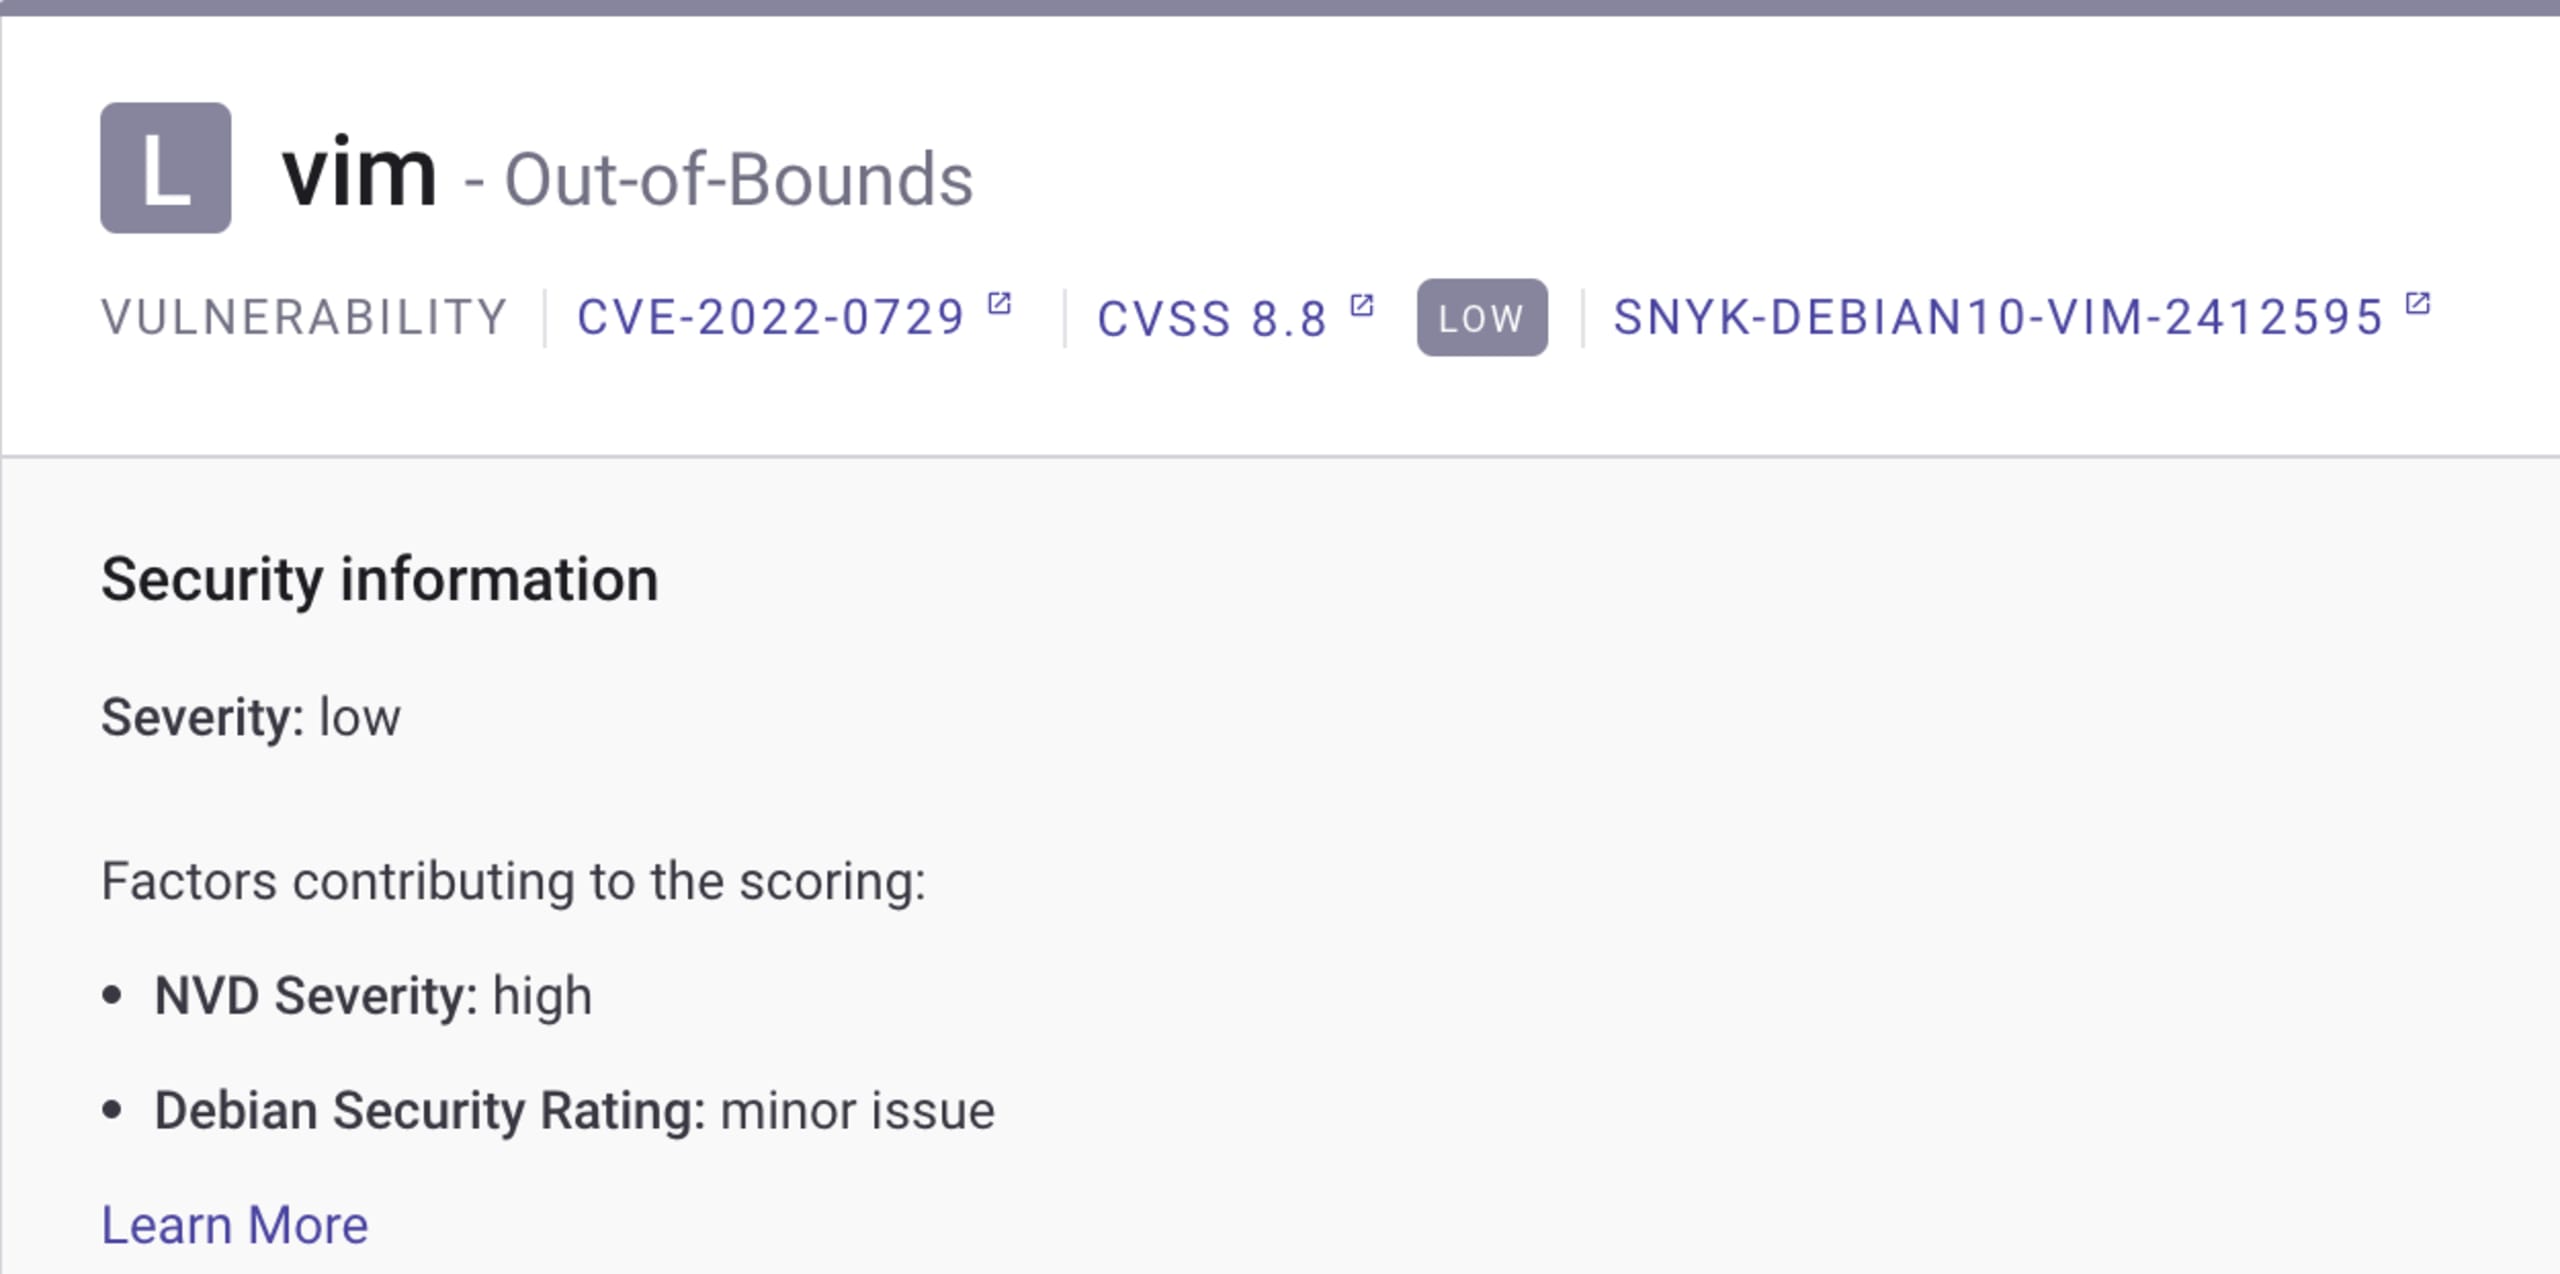
Coletamos dados de segurança diretamente das diferentes fontes das distribuições Linux. Isso significa que acompanhamos novos lançamentos e avisos, tanto de pacotes quanto de versões inteiras das distribuições, assim que são atualizados. Por isso, precisamos atualizar imediatamente nossos dados sobre vulnerabilidades com qualquer informação nova proveniente dessas fontes. Um exemplo desse tipo de atualização que você pode ver diretamente nos resultados do Snyk Container é a importância relativa da vulnerabilidade, que define sua gravidade no contexto de uma imagem específica. No exemplo abaixo, a pontuação CVSS original é 8,8, considerada de gravidade “alta”, mas os mantenedores do Debian analisaram a vulnerabilidade no Debian 10 (a versão usada neste contêiner) e concluíram que era um “problema menor”. Por isso, a Snyk atribui a ela uma gravidade geral “baixa”. Esse dado é essencial para priorizar e fazer a triagem corretamente, pois ajuda a definir quais dos muitos problemas devem ser resolvidos primeiro.
Colaboração e conhecimento aprofundado dos ecossistemas das distribuições Linux
Para entender os dados de segurança de cada distribuição Linux, pesquisamos sobre ela, analisamos seus componentes e verificamos se os dados estão completos. Também identificamos casos específicos e outros dados fornecidos pela distribuição que podemos usar na triagem. Por exemplo, ao aprimorar nossas informações de segurança sobre o Red Hat, percebemos que as páginas públicas de vulnerabilidades incluíam mais informações do que os fluxos OVAL. Entre elas, se a vulnerabilidade estava under investigation ou not affecting um produto específico da Red Hat. Levamos isso ao conhecimento da equipe de segurança da Red Hat e, desde então, essas informações importantes passaram a ser incluídas nos fluxos OVAL, a fonte oficial de dados de segurança que usamos.
Experiência humana em segurança
No nosso processo, que é quase todo automatizado e se baseia na pesquisa descrita acima, identificamos situações específicas que exigem a decisão de um especialista em segurança. Por exemplo, quando uma distribuição remove um aviso e queremos verificá-lo antes de revogá-lo. Nosso sofisticado processo de revogação é essencial para garantir que nossos sistemas automatizados não removam vulnerabilidades que ainda afetam os produtos, evitar falsos positivos e facilitar o trabalho de quem desenvolve.
Enriquecimento adicional e outras fontes
Enriquecemos nossos dados de vulnerabilidades com fontes externas, que adicionamos continuamente. Entre elas estão dados da NVD, informações sobre exploits, tendências no Twitter e, conforme nosso anúncio mais recente, sinais de runtime do Sysdig.
Priorização contextual
Com base em tudo isso, priorizamos as vulnerabilidades usando nossa pontuação exclusiva, indicamos a gravidade, adicionamos dados para dar mais contexto e apresentamos cada vulnerabilidade da forma mais útil para a triagem e a análise.
Uma prévia do futuro da pesquisa de vulnerabilidades do Snyk Container
Temos muitas iniciativas em andamento para lidar com vulnerabilidades em contêineres no futuro.
Um exemplo são os insights de segurança da Snyk. Com eles, queremos reduzir ao máximo o excesso de alertas em um ambiente que já gera muito ruído. Ao oferecer insights de segurança para situações e condições específicas, ajudamos você a entender melhor se uma vulnerabilidade é irrelevante em determinada configuração, ambiente ou aplicação, além de colaborar com quem desenvolve na triagem das vulnerabilidades.
Um exemplo de insight de vulnerabilidade do Snyk Container em que estamos trabalhando é sugerir que uma vulnerabilidade seja ignorada quando estiver em um pacote usado durante o build, ou até mesmo excluir o pacote afetado por completo — o que também elimina automaticamente as outras vulnerabilidades nesse pacote. Essa ideia se baseia em pesquisas que indicam uma baixa probabilidade de exploração de vulnerabilidades durante o build e que as vulnerabilidades que afetam aplicações em runtime devem ter prioridade muito maior. Pense nisso como o oposto da integração com o Sysdig: enquanto o Sysdig mostra o que está em execução em produção — o que aumenta a prioridade de correção de uma vulnerabilidade —, os insights de build do Snyk podem reduzir essa prioridade (ou até facilitar a decisão de ignorar a vulnerabilidade automaticamente) quando ela afeta ferramentas de build que não são executadas em produção.
Além disso, estamos trabalhando para adicionar metadados às vulnerabilidades em contêineres, com informações mais relevantes para tornar a priorização e a análise mais eficientes. Esses dados adicionais incluem, por exemplo, informações sobre o fix state da vulnerabilidade (ela será corrigida algum dia? A correção já foi integrada e está aguardando o lançamento?), além de notas de segurança que dão mais contexto sobre a gravidade e outros estados da vulnerabilidade. E, claro, continuamos avaliando e ampliando o suporte a outras distribuições.
Gerenciar vulnerabilidades nos seus contêineres é complicado, mas você não precisa fazer isso por conta própria. A inteligência da Snyk, referência no setor, está sempre melhorando e evoluindo. Assim, você não precisa ser especialista para manter tudo seguro — basta criar uma conta gratuita na Snyk.
Segurança de contêineres que prioriza os desenvolvedores
O Snyk encontra e corrige automaticamente vulnerabilidades em imagens de contêiner e workloads do Kubernetes.