Conheça o novo Risk Score da Snyk para priorização baseada em risco


17 de agosto de 2023
0 minutos de leituraTemos o prazer de anunciar a disponibilidade em beta aberto do novo Risk Score da Snyk! Substituindo o Priority Score atual, o novo Risk Score foi criado para ajudar você a priorizar com mais eficiência, oferecendo uma compreensão precisa e abrangente do risco representado por cada problema de segurança.
O Risk Score é baseado em um novo modelo de avaliação de riscos que usa vários fatores objetivos e contextuais para medir tanto a probabilidade de uma vulnerabilidade ser explorada quanto o impacto que isso pode causar. O novo Risk Score considera mais fatores de risco do que antes — incluindo alcançabilidade, maturidade da exploração, EPSS, tendências nas redes sociais, CVSS, profundidade transitiva, criticidade para os negócios e muito mais — para oferecer informações de segurança mais completas e precisas.
Depois de ativado, o novo Risk Score será exibido nos cartões de problemas da Snyk, que apresentarão uma explicação completa de como a pontuação foi calculada e pode ajudar a entender o risco representado pelo problema. A pontuação também estará disponível nos relatórios da Snyk e pela nossa API.
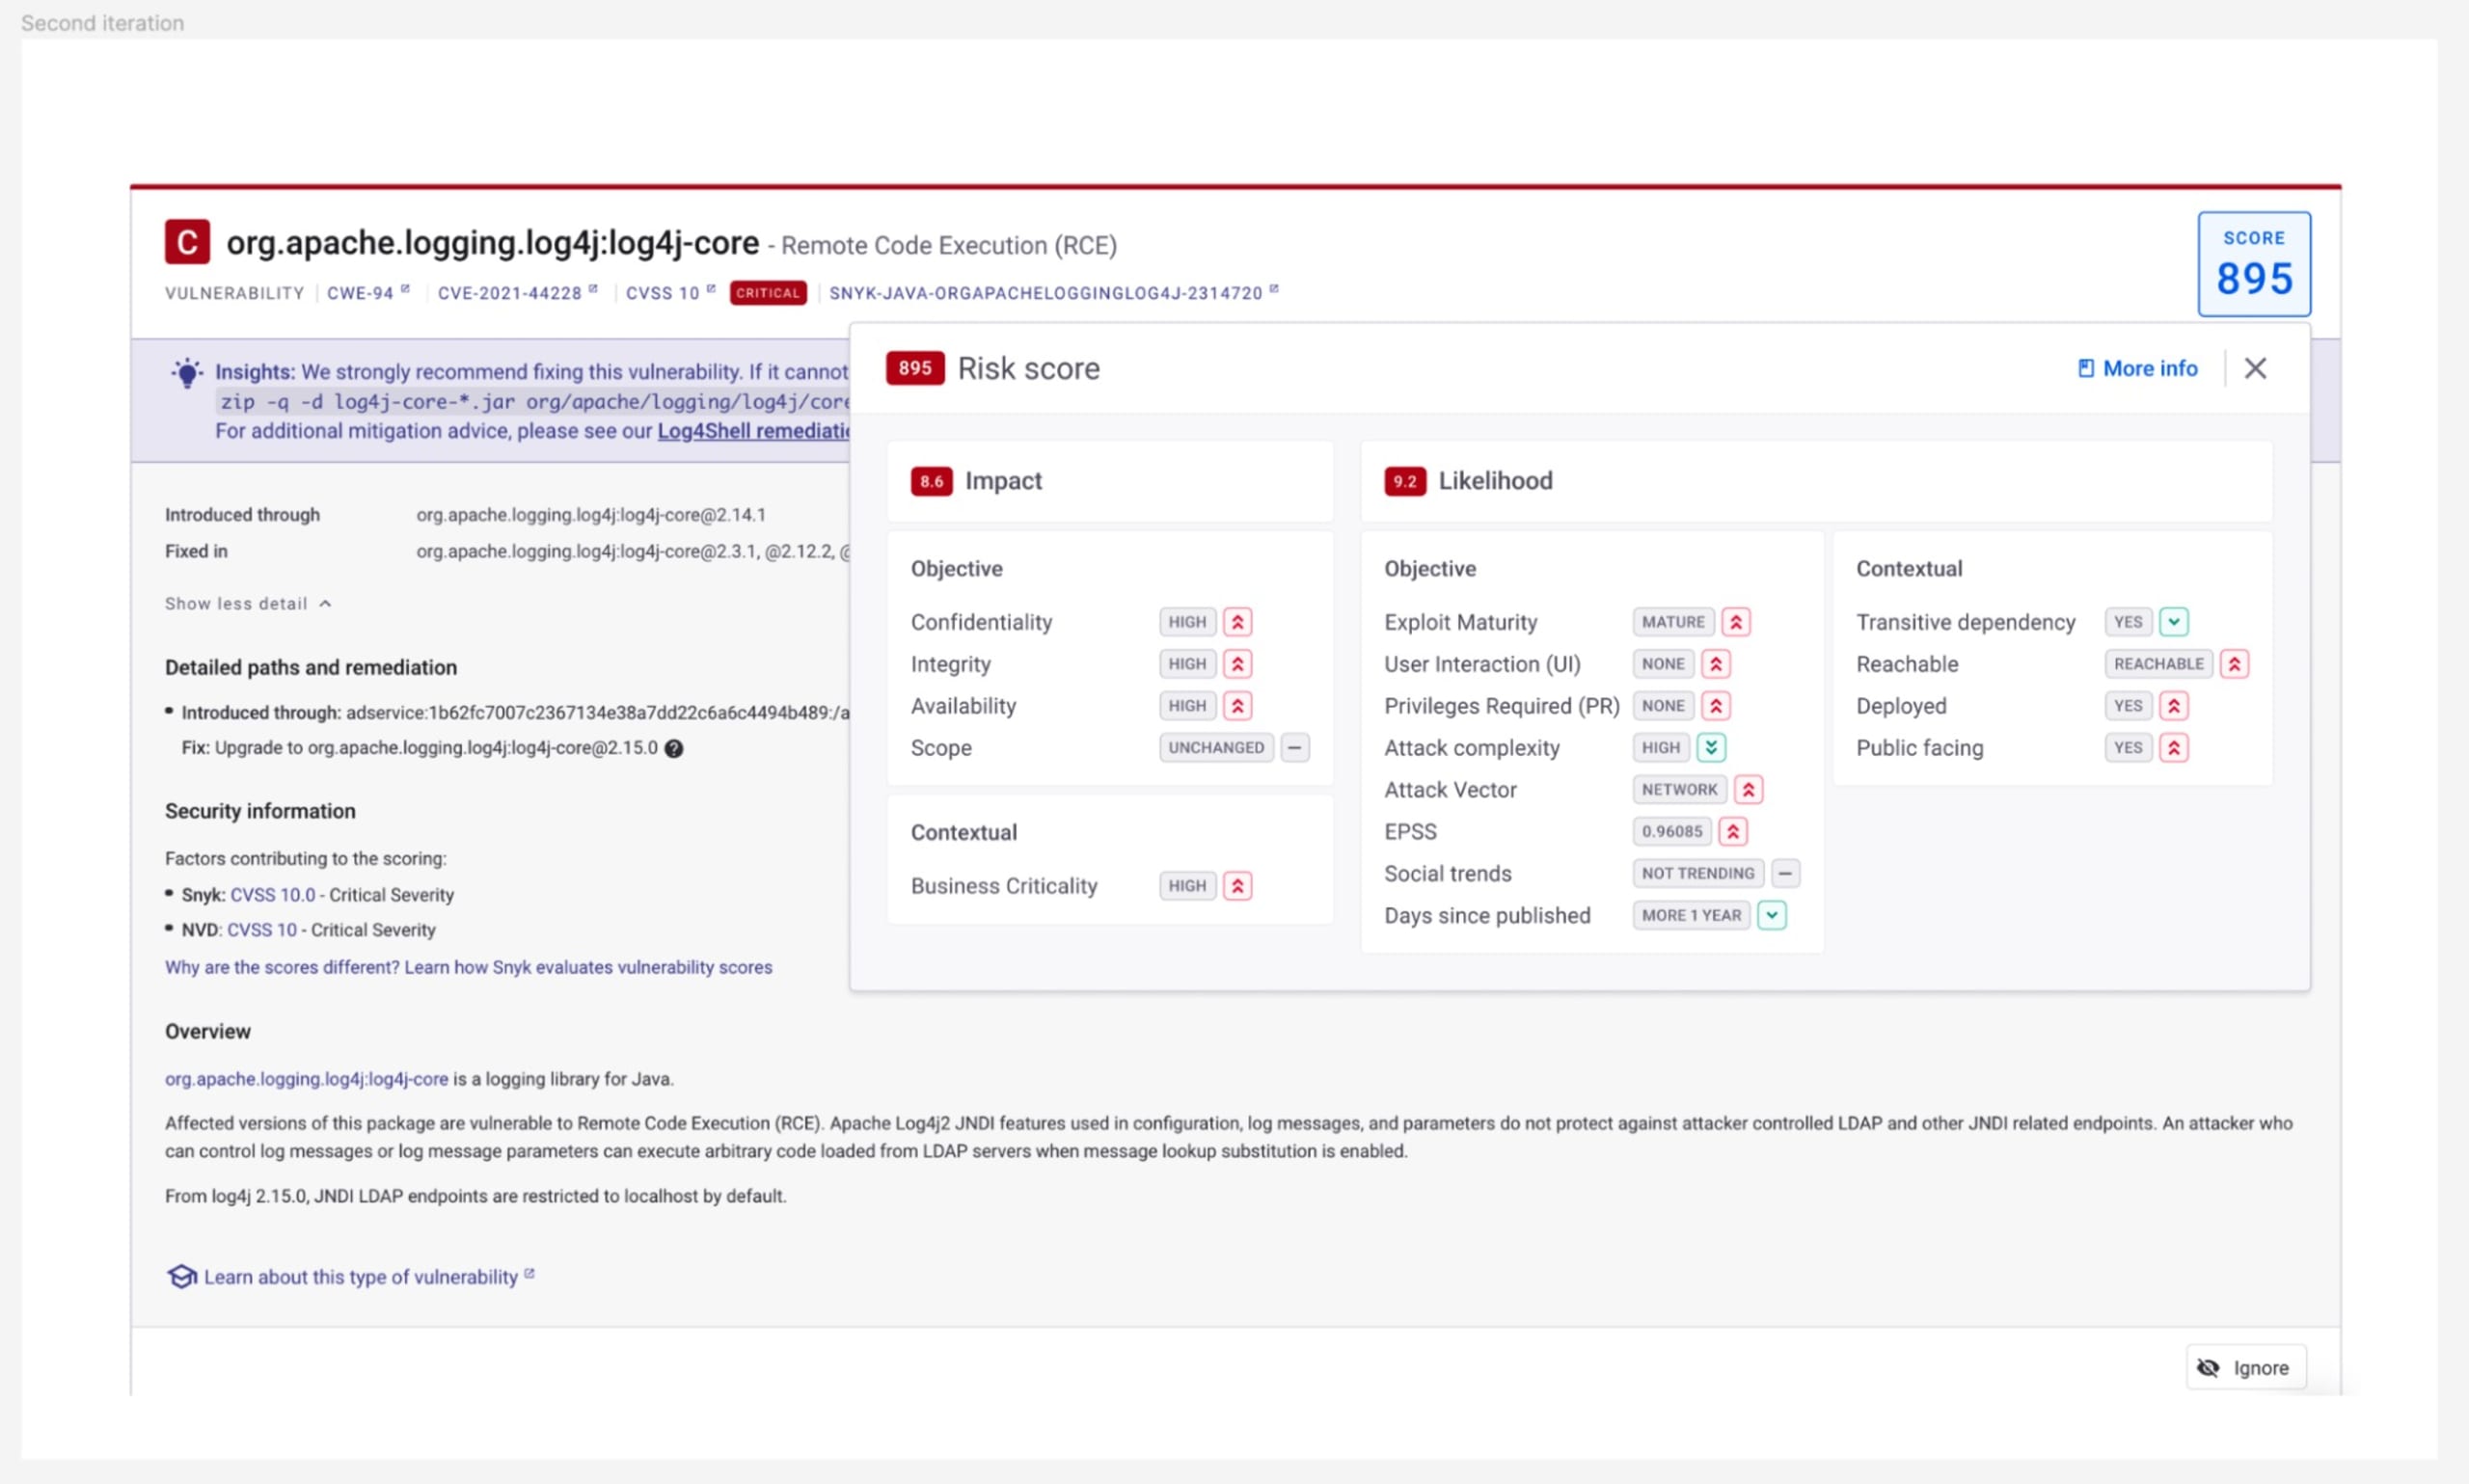
O Risk Score pode ser ativado pelo Snyk Preview e está disponível em beta aberto para problemas do Snyk Open Source e do Snyk Container em todos os planos da Snyk — incluindo o Free. Para saber mais sobre o Risk Score e como usá-lo, consulte nossa documentação online.
O problema: acúmulos de alertas de segurança
Um dos maiores desafios enfrentados hoje pela maioria das equipes de segurança e desenvolvimento que tentam proteger seus softwares ao longo da cadeia de suprimentos de software é a relação entre sinal e ruído.
Por um lado, parece não ter fim o número de vulnerabilidades encontradas no código:
As ferramentas de segurança se tornaram quase onipresentes em toda a cadeia de suprimentos de software, ampliando muito a superfície de ataque que precisa ser protegida e gerando mais problemas do que nunca.
Novas vulnerabilidades são descobertas todos os dias em bibliotecas open source populares e softwares de terceiros, aumentando continuamente o número de ameaças que precisam ser avaliadas, priorizadas e corrigidas.
A complexidade dos softwares só aumenta, e nem sempre é possível automatizar atualizações ou correções sem causar mudanças incompatíveis no código, o que dificulta a avaliação e a resolução dos problemas.
Por outro lado, os usuários percebem que nem todas as ameaças têm o mesmo grau de risco e que a grande maioria dos problemas identificados representa um risco muito menor do que imaginavam. Um exemplo disso é o sistema de modelagem de ameaças EPSS da FIRST, que busca prever a probabilidade de uma CVE específica ser explorada no mundo real:
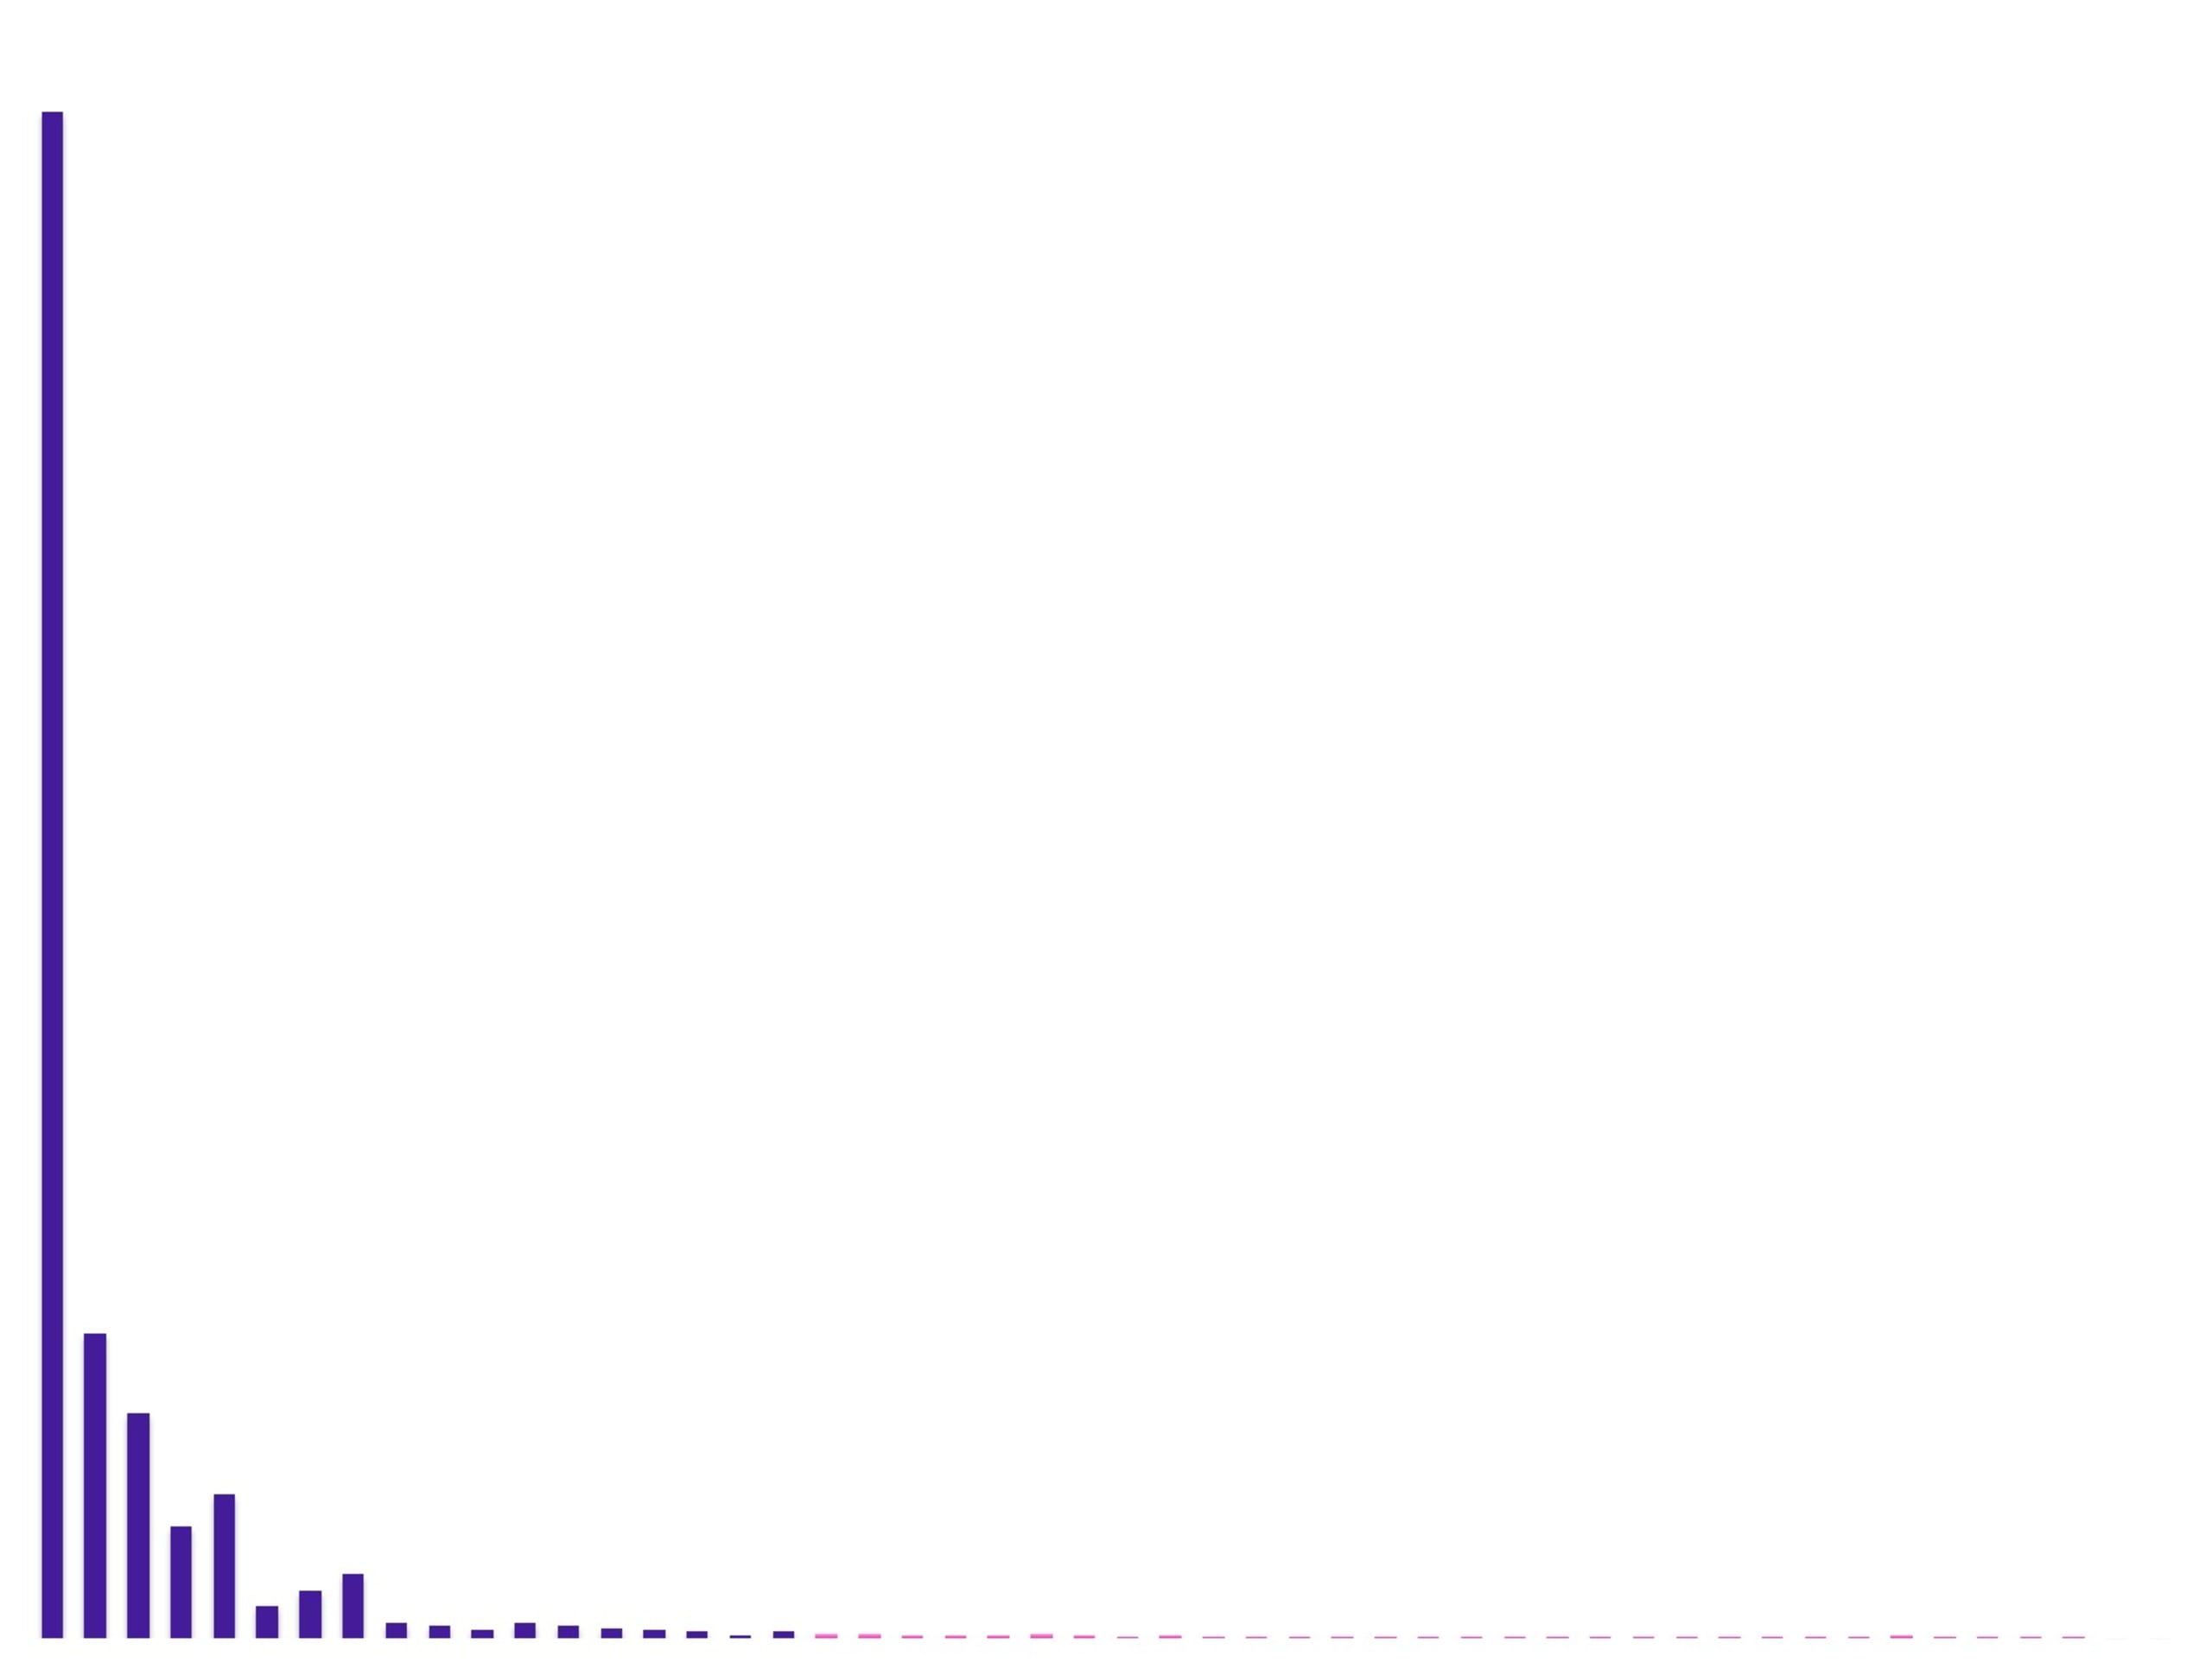
Podemos ver que é altamente improvável que mais de 95% das vulnerabilidades sejam exploradas, e que as ameaças realmente perigosas se concentram em torno do percentil 99.
Compare isso à distribuição das vulnerabilidades por gravidade no CVSS 3.1, a métrica mais usada por profissionais de segurança para avaliar riscos. Nesse caso, uma parcela muito maior das vulnerabilidades se concentra nas categorias Alta e Crítica:
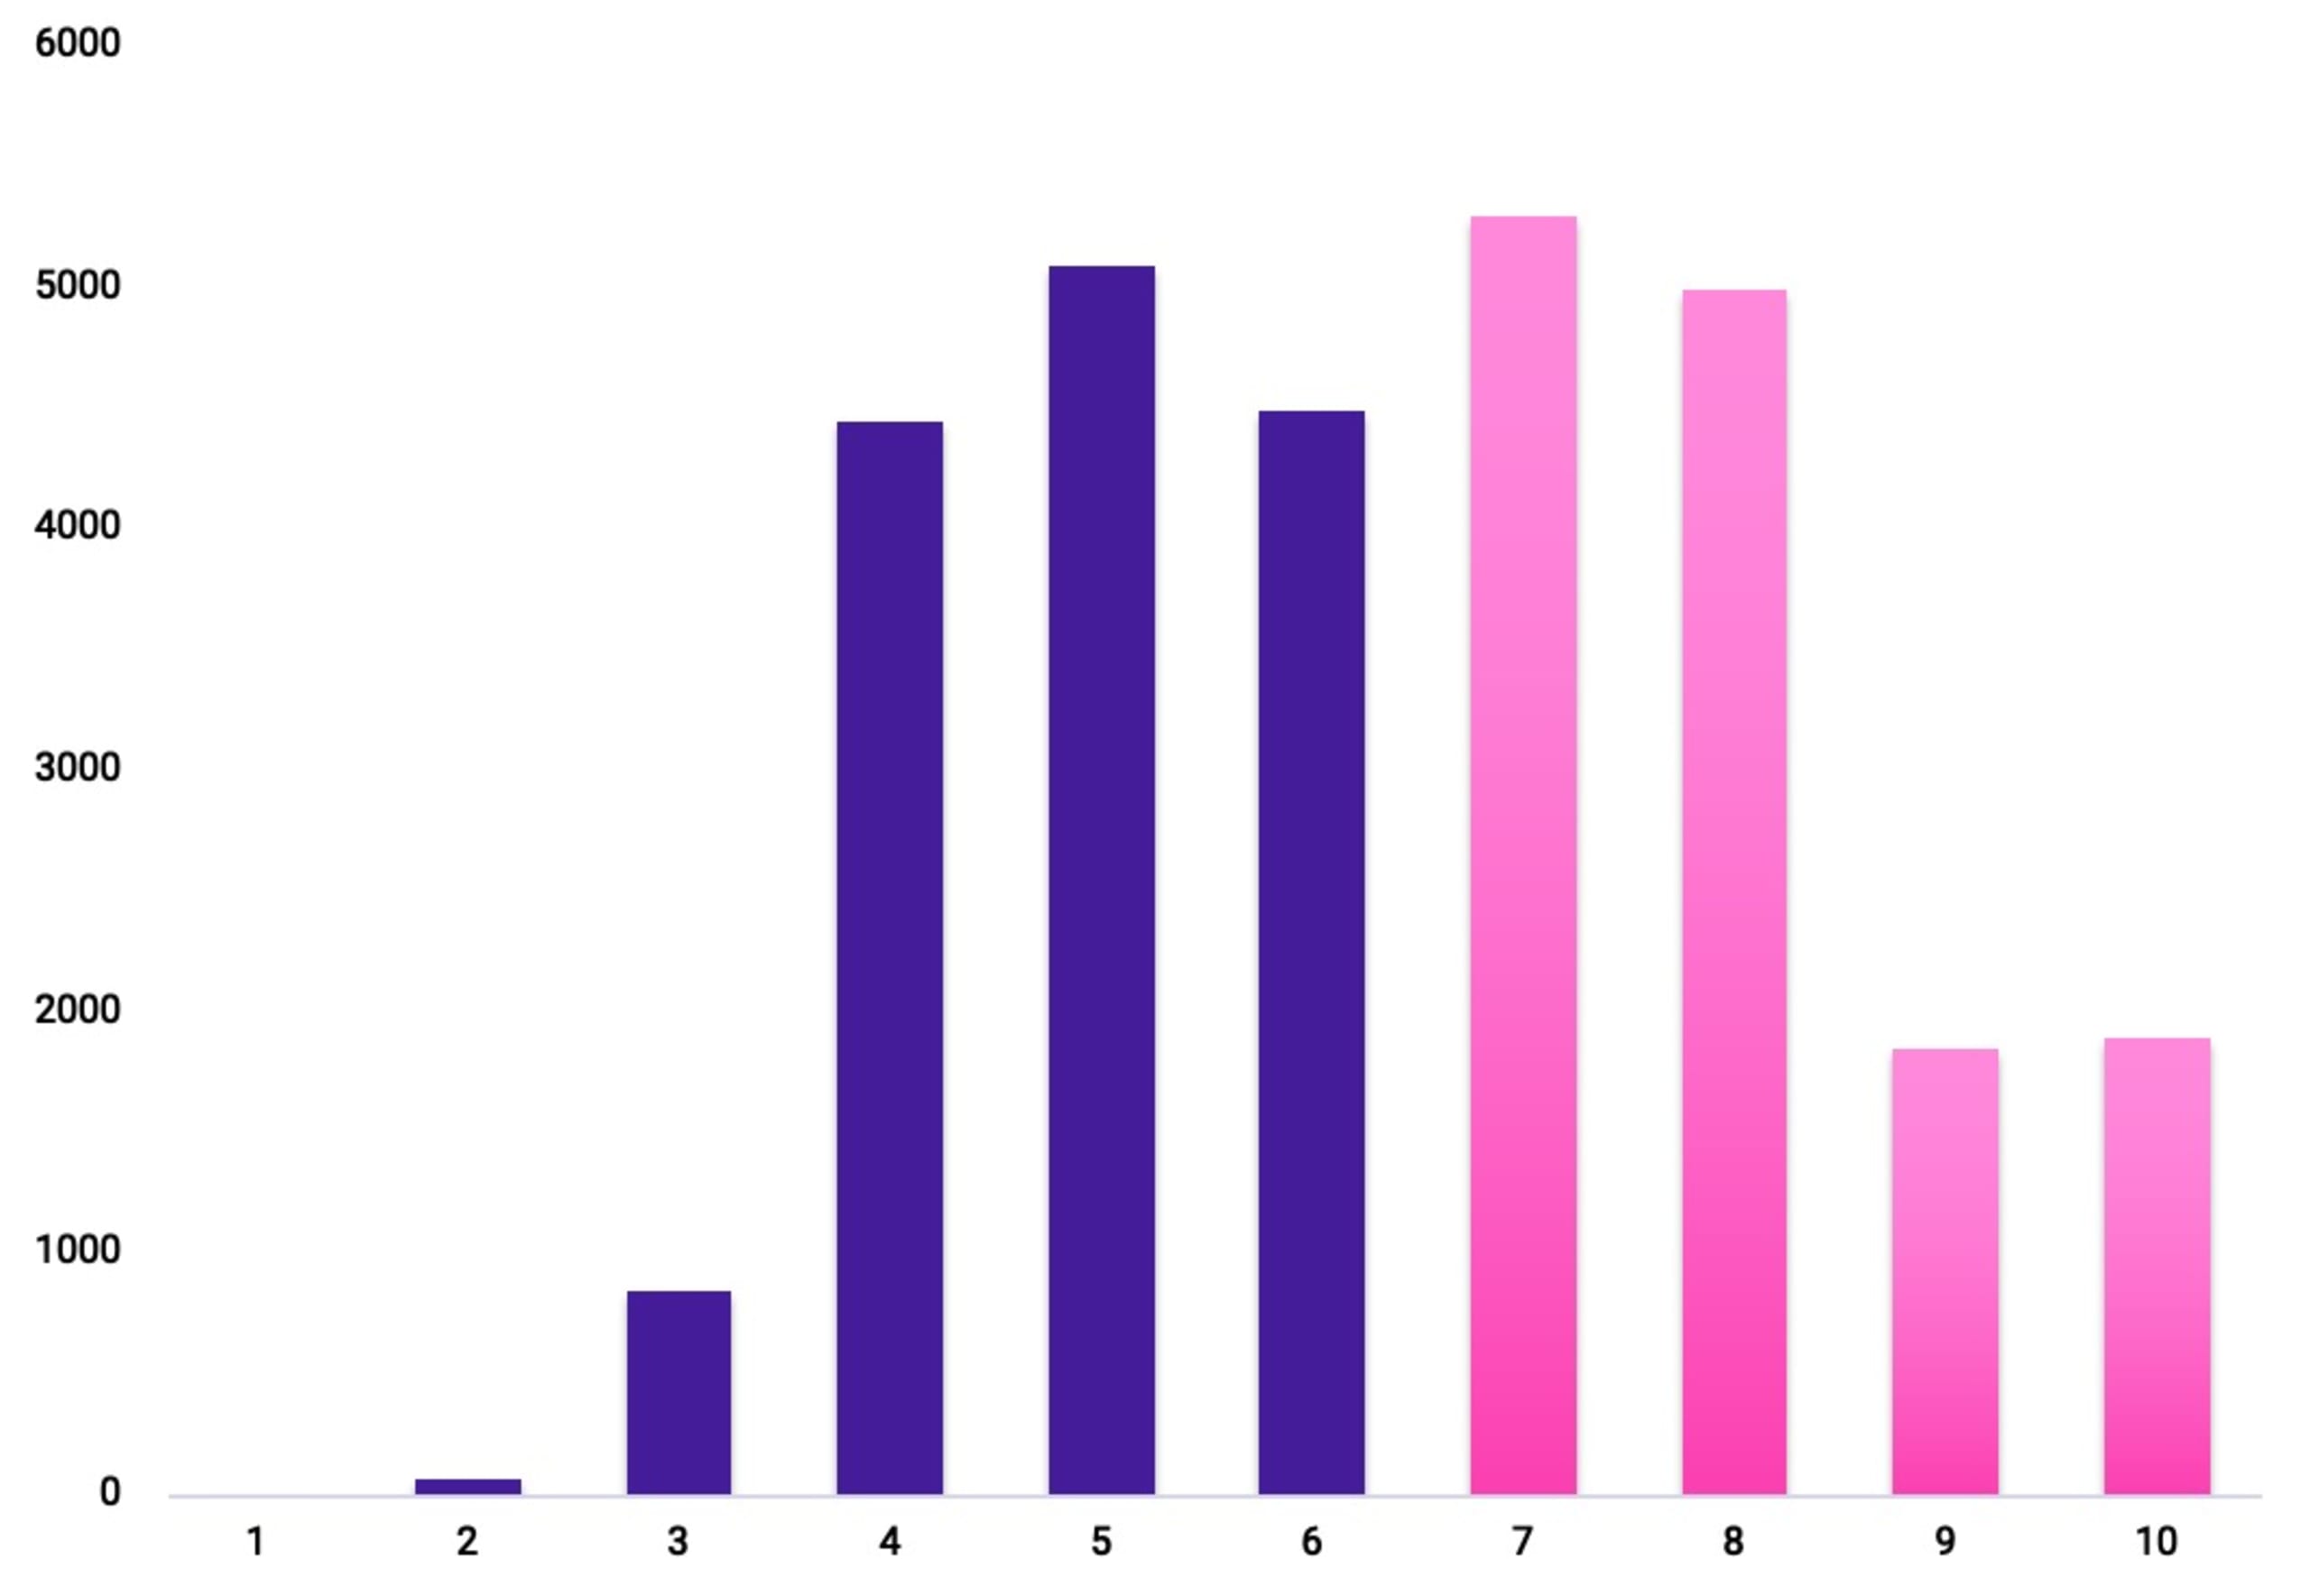
Considerar o CVSS v4.0 também não ajuda. Por definição, a estrutura do CVSS ainda exige que você analise manualmente os problemas no contexto do seu ambiente, o que gera trabalho demais.
Priorização de riscos: em busca de uma solução mágica
A pergunta óbvia é: como sair de um cenário em que tentamos avaliar e lidar com milhares de riscos altamente improváveis para outro em que podemos concentrar a maior parte do nosso tempo nos problemas de maior risco? Nessa área, sugeriram-se várias soluções mágicas — um único fator de risco que pudesse ser usado para descartar de imediato todo o risco de determinadas vulnerabilidades, por exemplo:
Maturidade da exploração ou EPSS - Tenta prever objetivamente se um ataque será tentado e terá sucesso. É uma abordagem preditiva que não leva o seu ambiente em conta.
Alcançabilidade estática do código - Tenta distinguir os componentes usados dos não usados. É útil para destacar os que estão em uso, mas não permite ignorar os demais. Confiar apenas nesse fator de risco também não resolve, pois outros contextos, como a alcançabilidade pela rede e outras condições de exploração, não são considerados.
Transitividade - Há quem defenda que não é preciso considerar problemas em dependências transitivas. O Log4Shell (e inúmeras outras vulnerabilidades) provou que essa premissa está errada.
É fácil entender o apelo de um modelo binário simples de risco — e, se realmente funcionasse, reduziria muito nosso trabalho. Infelizmente, segurança e código não são tão simples nem binários. Esses modelos simplistas nos deixam perigosamente expostos a riscos que descartam e, ainda assim, nos fazem concentrar em um subconjunto de vulnerabilidades, muitas das quais não representam ameaças reais. Usar apenas um desses fatores, ou uma combinação deles, exige confiar plenamente tanto nas informações disponíveis quanto nas que não foram fornecidas.
Desenvolvimento de um novo modelo de avaliação de riscos para o Risk Score
Entendendo o desafio de priorização enfrentado pelos nossos clientes, criamos um novo modelo de avaliação de riscos com três objetivos principais:
Criar um modelo de risco verdadeiramente probabilístico, em vez de binário.
Criar um modelo que levasse em conta e refletisse as complexidades inerentes à avaliação de riscos, sem deixar de permitir que as pessoas compreendessem e verificassem os resultados.
Incluir informações contextuais definidas por cada usuário e possibilitar a ampliação desse fator contextual.
O modelo de avaliação usado no novo Risk Score da Snyk considera dois vetores de risco:
Probabilidade - Qual é a probabilidade de determinado risco se concretizar? Em outras palavras, qual é a probabilidade de uma vulnerabilidade ser explorada no código de um usuário?
Impacto - Caso ocorra uma exploração, qual seria o impacto para nossos usuários?
Cada um desses vetores é dividido em duas categorias de fatores de risco:
Objetivos - Fatores de risco definidos objetivamente para o problema em questão e relevantes para qualquer ambiente vulnerável.
Contextuais - Fatores de risco definidos de acordo com o contexto do ambiente da aplicação vulnerável.
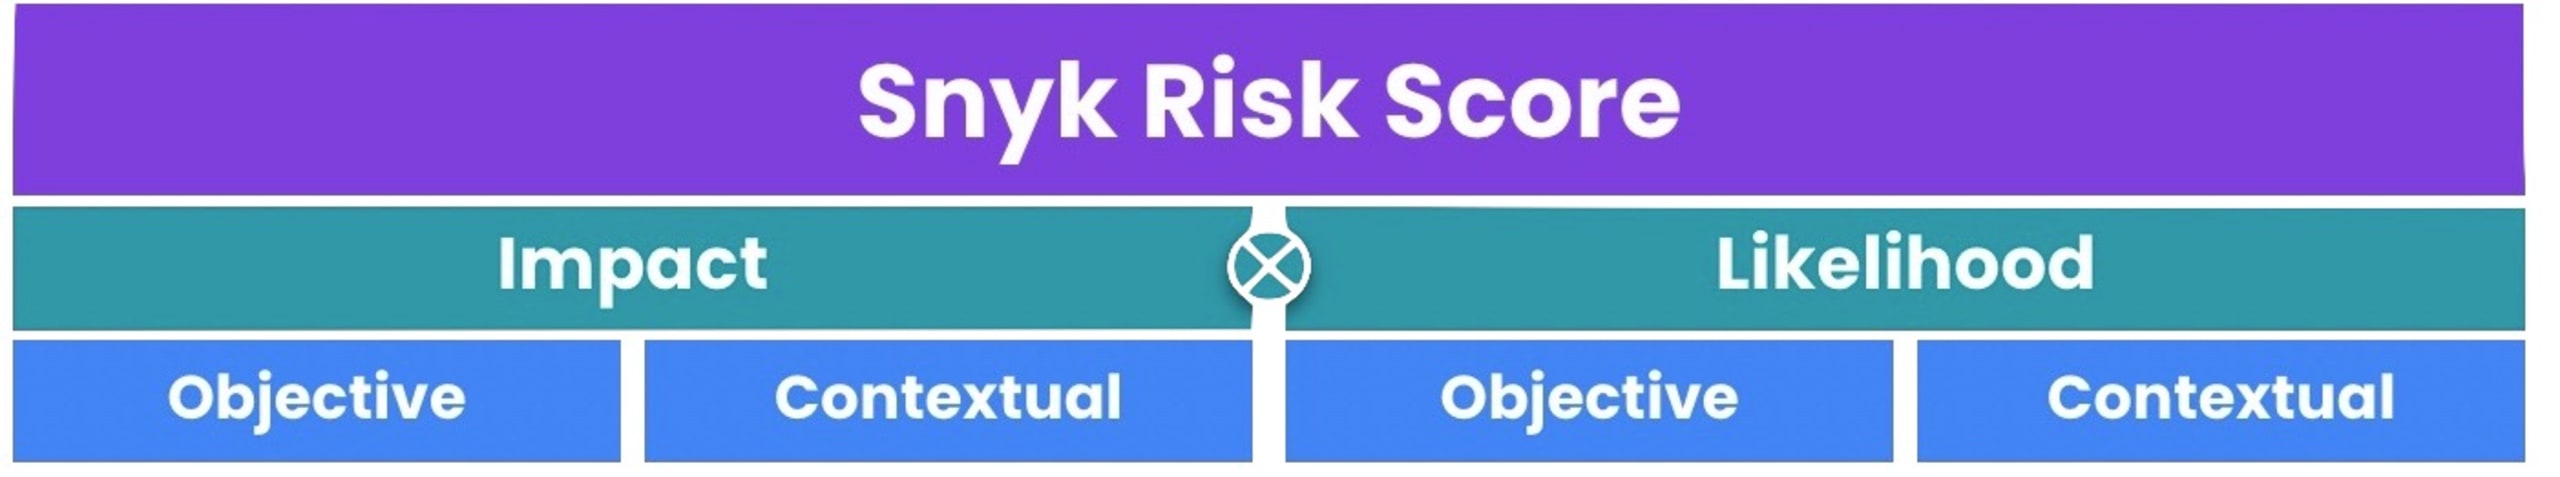
Em seguida, os algoritmos do nosso modelo de avaliação de riscos calculam esses fatores em conjunto para gerar uma pontuação de risco para cada problema.
Como avaliar objetivamente a possibilidade de exploração?
Para cada fator de risco incorporado ao nosso modelo, realizamos dois experimentos para verificar seu uso no algoritmo e seu peso preditivo relativo. Primeiro, estabelecemos uma linha de base para a probabilidade de uma vulnerabilidade aleatória ser explorada, cruzando o banco de dados de vulnerabilidades da própria Snyk com as vulnerabilidades exploradas em ataques reais publicadas pela CISA. Depois, verificamos a correlação relativa entre essa linha de base e cada fator de risco que, segundo nossa hipótese, poderia afetar a probabilidade de exploração.
No entanto, correlação não significa causalidade. Nesse ponto, começamos a testar vários modelos de ML para identificar corretamente quais fatores de risco eram realmente úteis para prever a possibilidade de exploração. Após várias rodadas de experimentos, usamos um modelo de regressão para identificar os fatores de risco com impacto estatisticamente significativo na possibilidade de exploração — e incorporamos os resultados desse modelo ao nosso algoritmo.
Por fim, usamos os resultados dos nossos modelos para testar centenas de projetos anonimizados e verificar se a distribuição da possibilidade de exploração prevista pelo modelo correspondia ao que esperaríamos com base em dados reais de violações, conforme mencionado acima.
Tudo depende do contexto
Embora estejamos satisfeitos por aparentemente prever com precisão a possibilidade de exploração em escala global, os riscos contextuais relacionados à configuração de cada usuário continuam sendo essenciais. Para isso, analisamos nossas pesquisas internas e proprietárias de segurança e tentamos explorar vulnerabilidades específicas sob várias condições. Assim, pudemos incorporar condições aparentemente “binárias”, como alcançabilidade ou transitividade, e usá-las como dados probabilísticos no algoritmo, em vez de fazer afirmações categóricas (e imprecisas).
Por fim, na Snyk, colocamos a transparência e a confiança no centro do nosso trabalho. Por isso, mostramos todos os fatores e raciocínios que levam à pontuação, tanto nos próprios problemas quanto na nossa documentação pública.
O futuro da pontuação de risco na Snyk
Na Snyk, acreditamos que as equipes de AppSec e desenvolvimento devem ter autonomia para definir suas próprias metodologias de priorização. Vemos diferentes empresas abordando essa questão de maneiras distintas:
Foco em riscos - Filtre e classifique os problemas por uma pontuação baseada em um modelo de análise de riscos, como o Snyk Risk Score.
Foco em conformidade - Se a sua empresa precisa priorizar a conformidade, é necessário tratar cada problema Alto ou Crítico conforme definido pelo CVSS. Como mencionado, isso gera muitos problemas para resolver. Por isso, a pontuação de risco pode ajudar a classificar e filtrar os mais importantes.
Foco na capacidade de ação - Agrupe os problemas de acordo com o esforço necessário para corrigi-los. As pontuações de risco não devem incluir esse fator, mas ele acrescenta outra dimensão importante: o esforço necessário para resolver o problema.
Você também pode ter sua própria tolerância a riscos e seus próprios critérios. No futuro, o Risk Score da Snyk permitirá que os usuários personalizem a pontuação e a alimentem com o conhecimento que têm do seu ambiente, aproveitando o modelo preditivo para priorizar os problemas, em vez de eliminá-los.
Para começar a usar o Risk Score, ative-o hoje mesmo pelo Snyk Preview!