10 boas práticas para desenvolver com IA com segurança

27 de setembro de 2023
0 minutos de leitura
A esta altura, todos já sabemos, às vezes da maneira mais difícil, que a IA se tornou uma ferramenta crucial e inevitável para ajudar desenvolvedores a aprimorar suas práticas de desenvolvimento de aplicações. Mesmo quando as organizações restringem o uso de ferramentas de IA por seus desenvolvedores, ouvimos muitas histórias de como eles contornam essas restrições usando VPNs e contas pessoais.
Independentemente de quanto tempo levemos para nos familiarizar com a tecnologia de IA e adotá-la, é essencial usar a IA com segurança. Esta publicação apresenta as melhores práticas para desenvolver com IA com segurança, com foco em aplicações com assistência de IA, desenvolvimento assistido por IA e dicas gerais para aumentar a produtividade no desenvolvimento de software com IA. O objetivo é ajudar desenvolvedores e profissionais de segurança a mitigar riscos potenciais de forma eficaz e aproveitar todos os benefícios da IA.
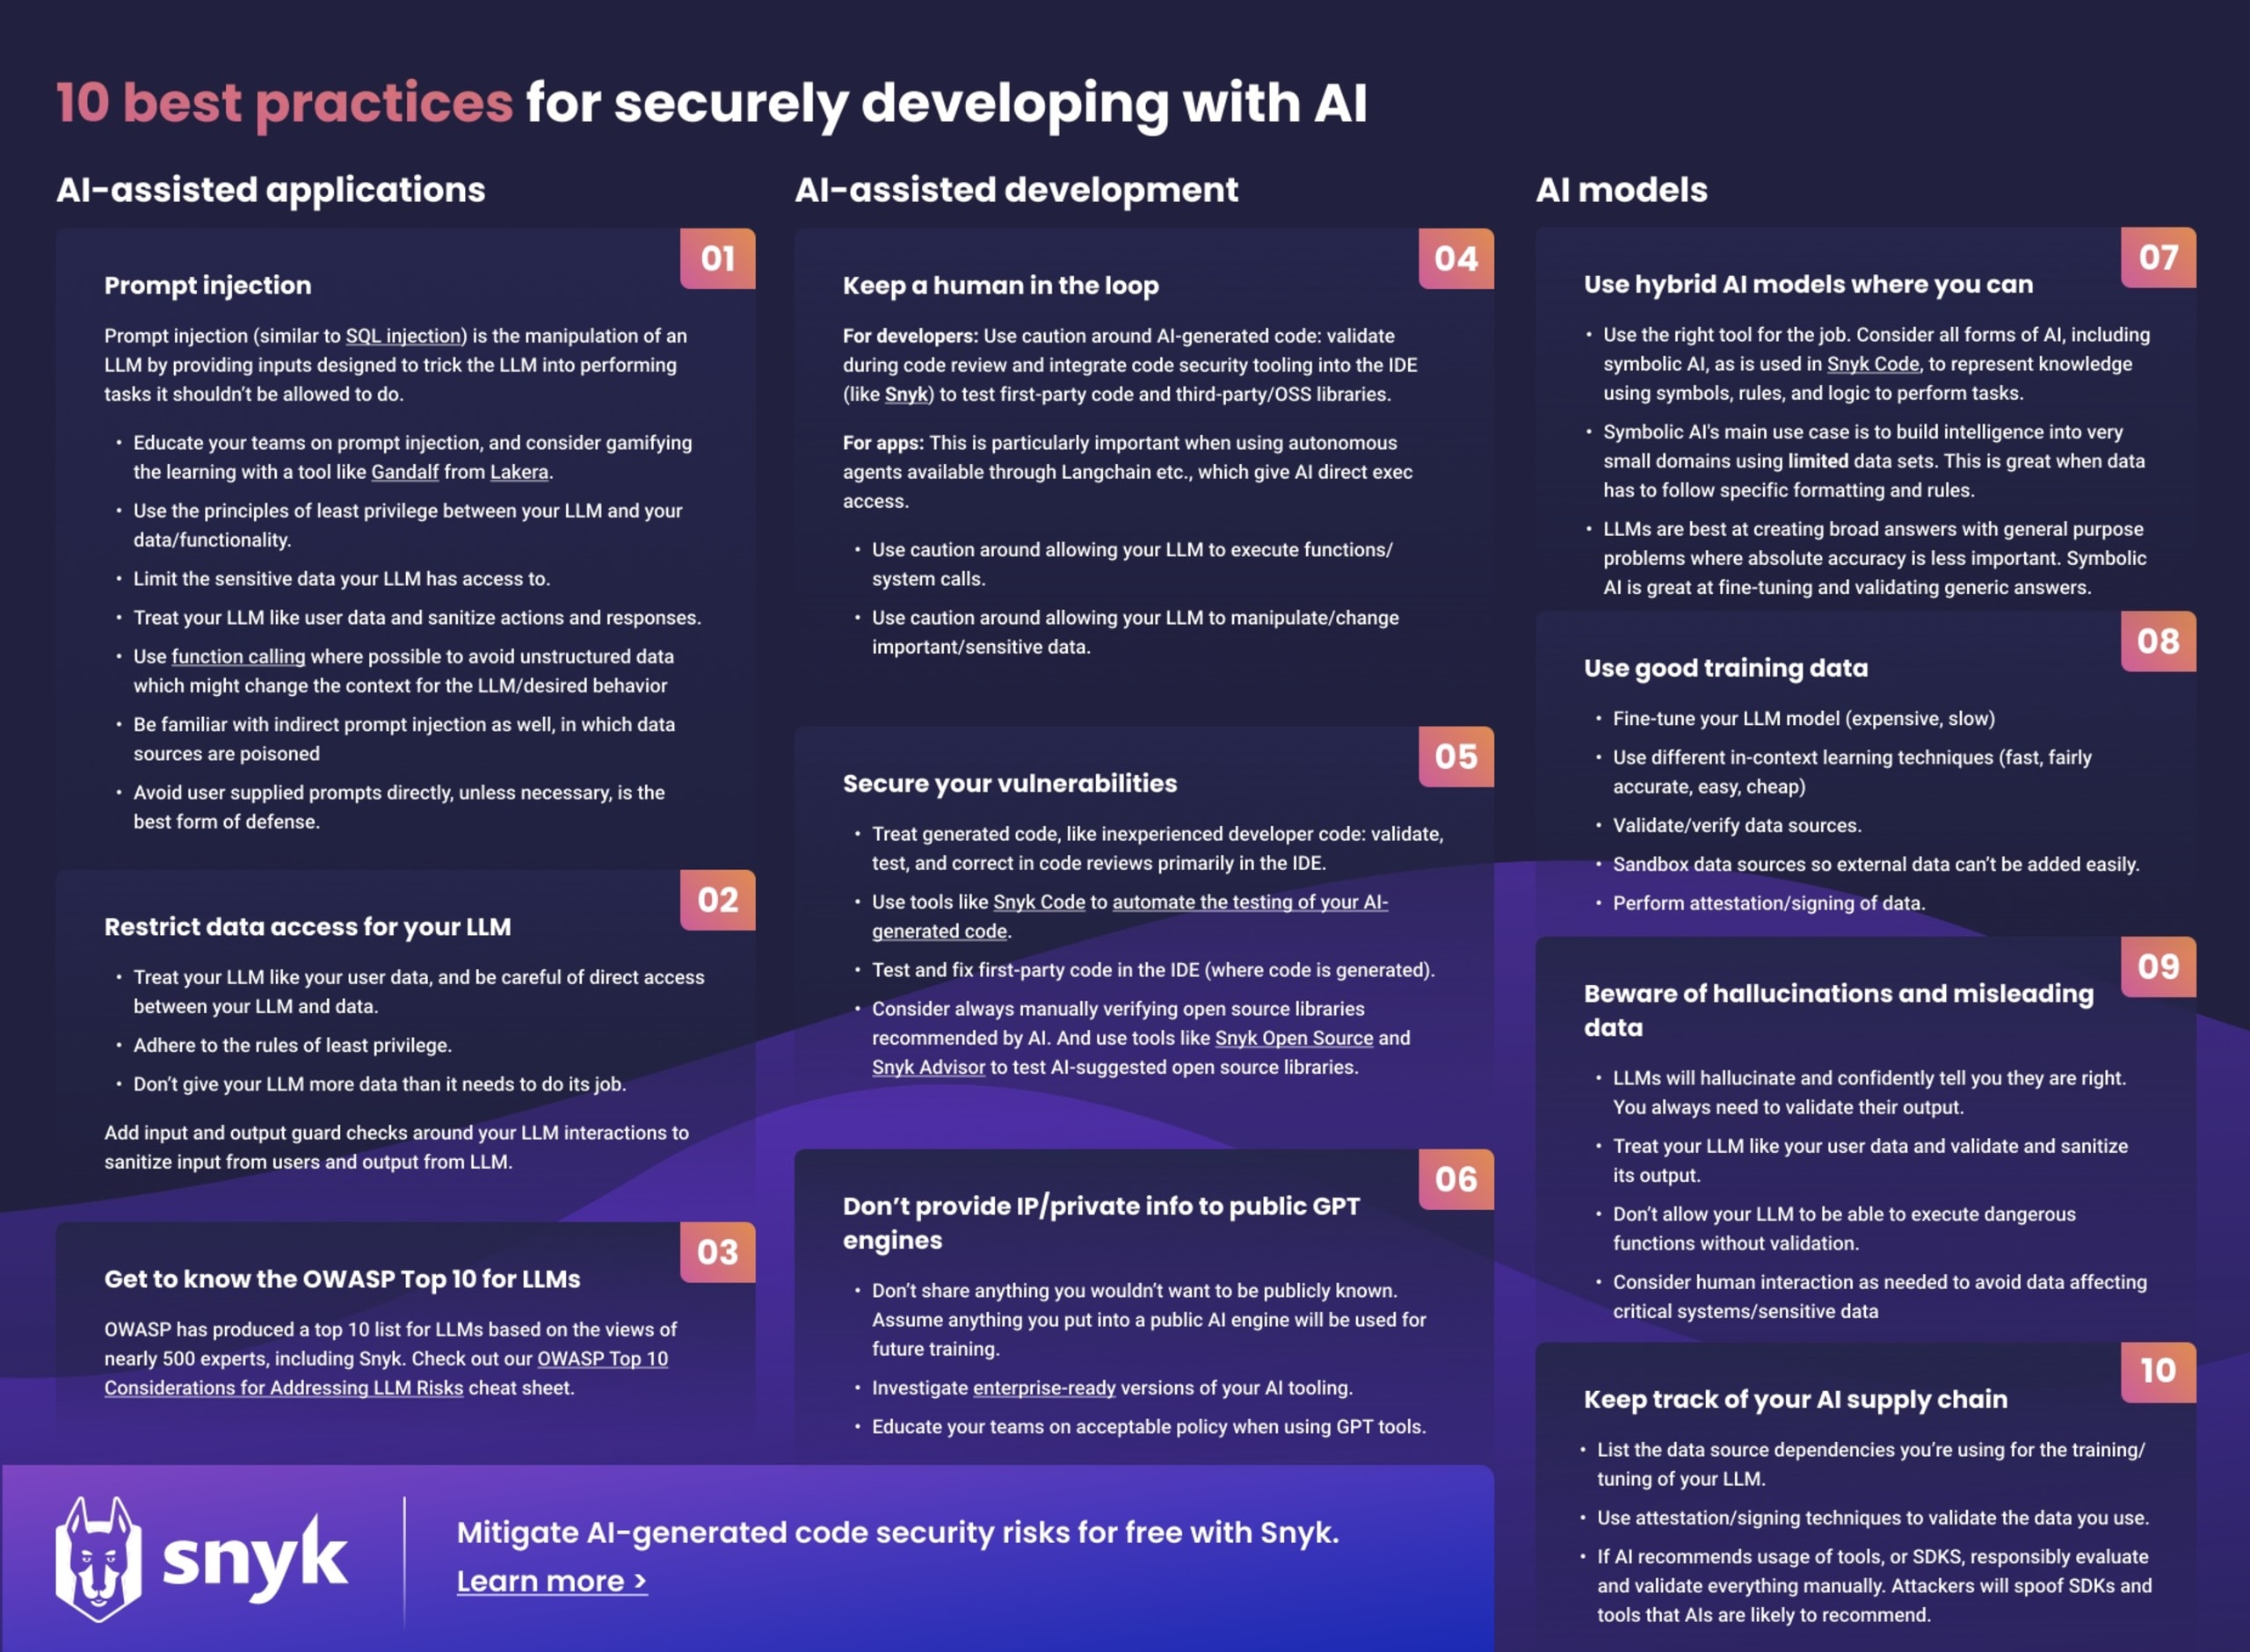
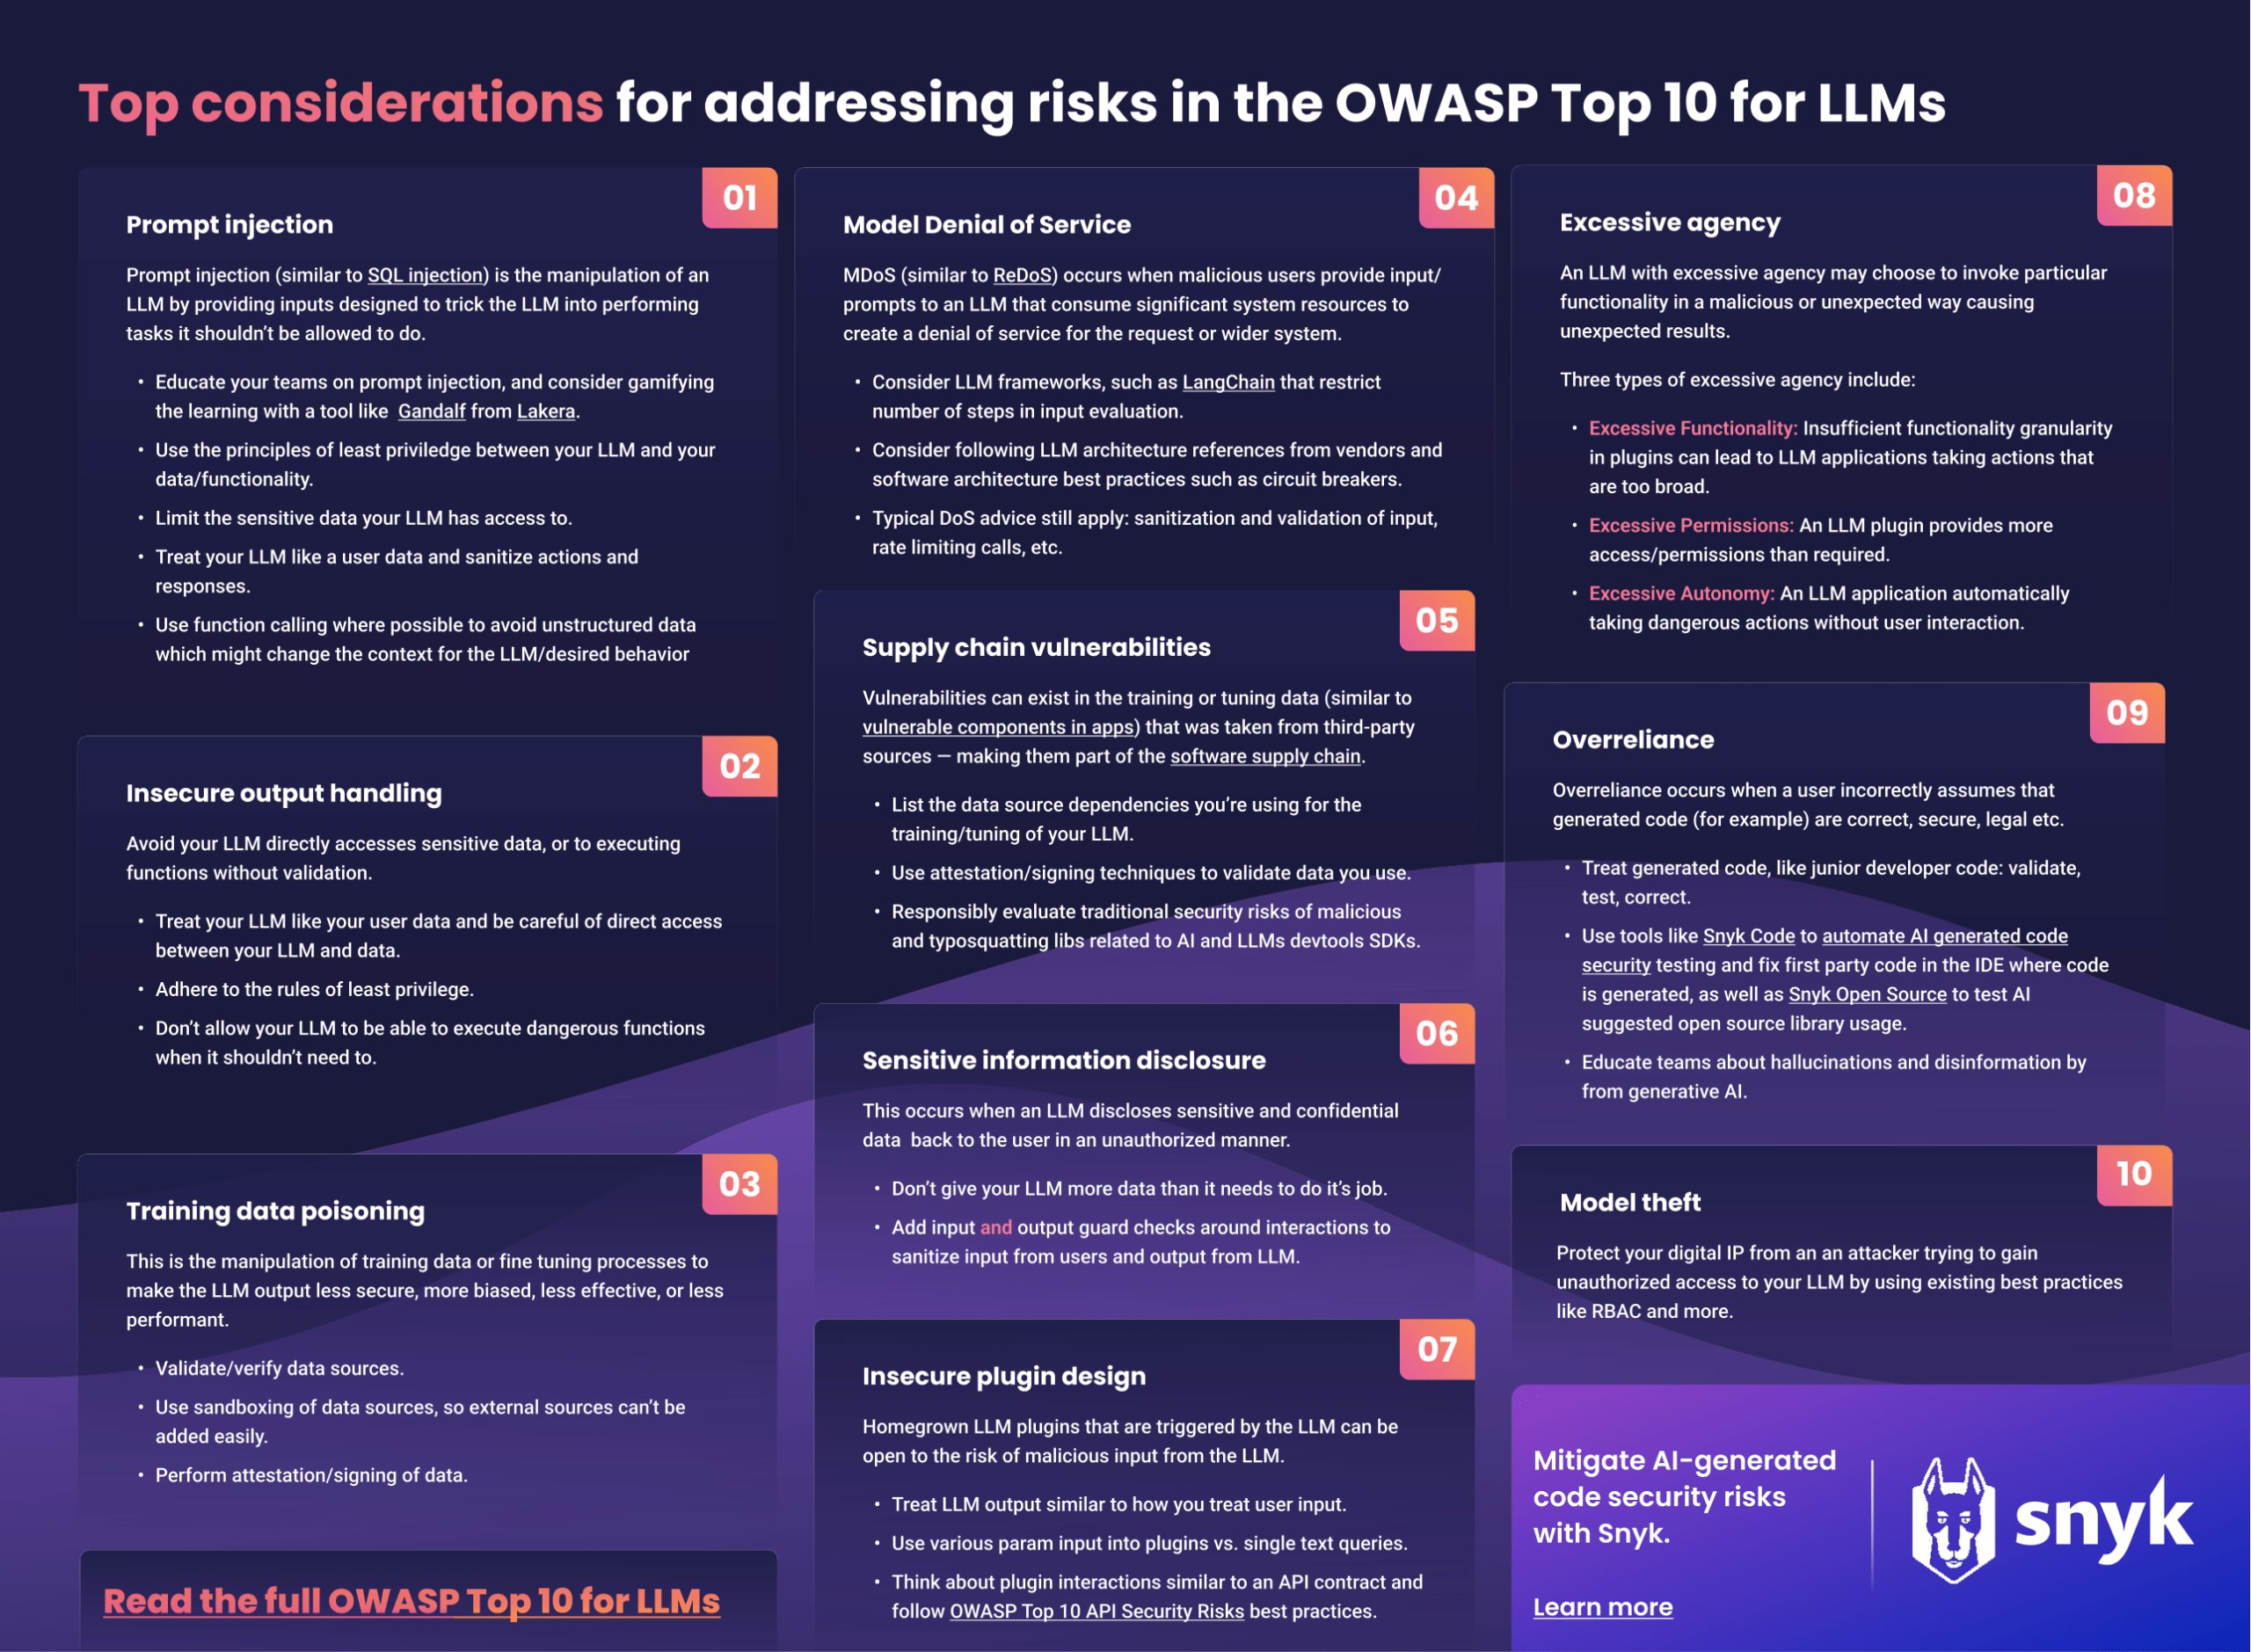
Antes de mais nada, aqui está o resumo visual com todas as dicas em uma página. Imprima, deixe ao lado da sua estação de trabalho, cole na geladeira ou dê de presente a alguém no lugar de um cartão de Natal, aniversário ou condolências. Por nada!
Aplicações com assistência de IA
Quando falamos em aplicações com assistência de IA, estamos falando de como uma aplicação usa a tecnologia de IA e pode ser acessada por alguém que aproveita seus recursos. Um ótimo exemplo, fácil de entender, é um chatbot com um robô de IA (sem personalidade alguma) integrado a uma aplicação para responder às perguntas dos usuários.
1. Tenha cuidado com injeções de prompt diretas e indiretas
Uma grande preocupação de segurança em aplicações com modelos de linguagem grandes (LLMs) integrados é que os recursos voltados aos usuários expõem as aplicações a possíveis injeções de prompt. Isso acontece quando um invasor insere uma entrada maliciosa em um sistema de IA para manipular a resposta. Isso pode fazer com que a IA se comporte de forma inesperada ou revele informações confidenciais. Por exemplo, imagine um chatbot de IA criado para oferecer suporte aos usuários. Um invasor pode tentar manipular a entrada para convencer a IA que alimenta o chat de que tem autorização para acessar informações confidenciais sobre outros usuários.
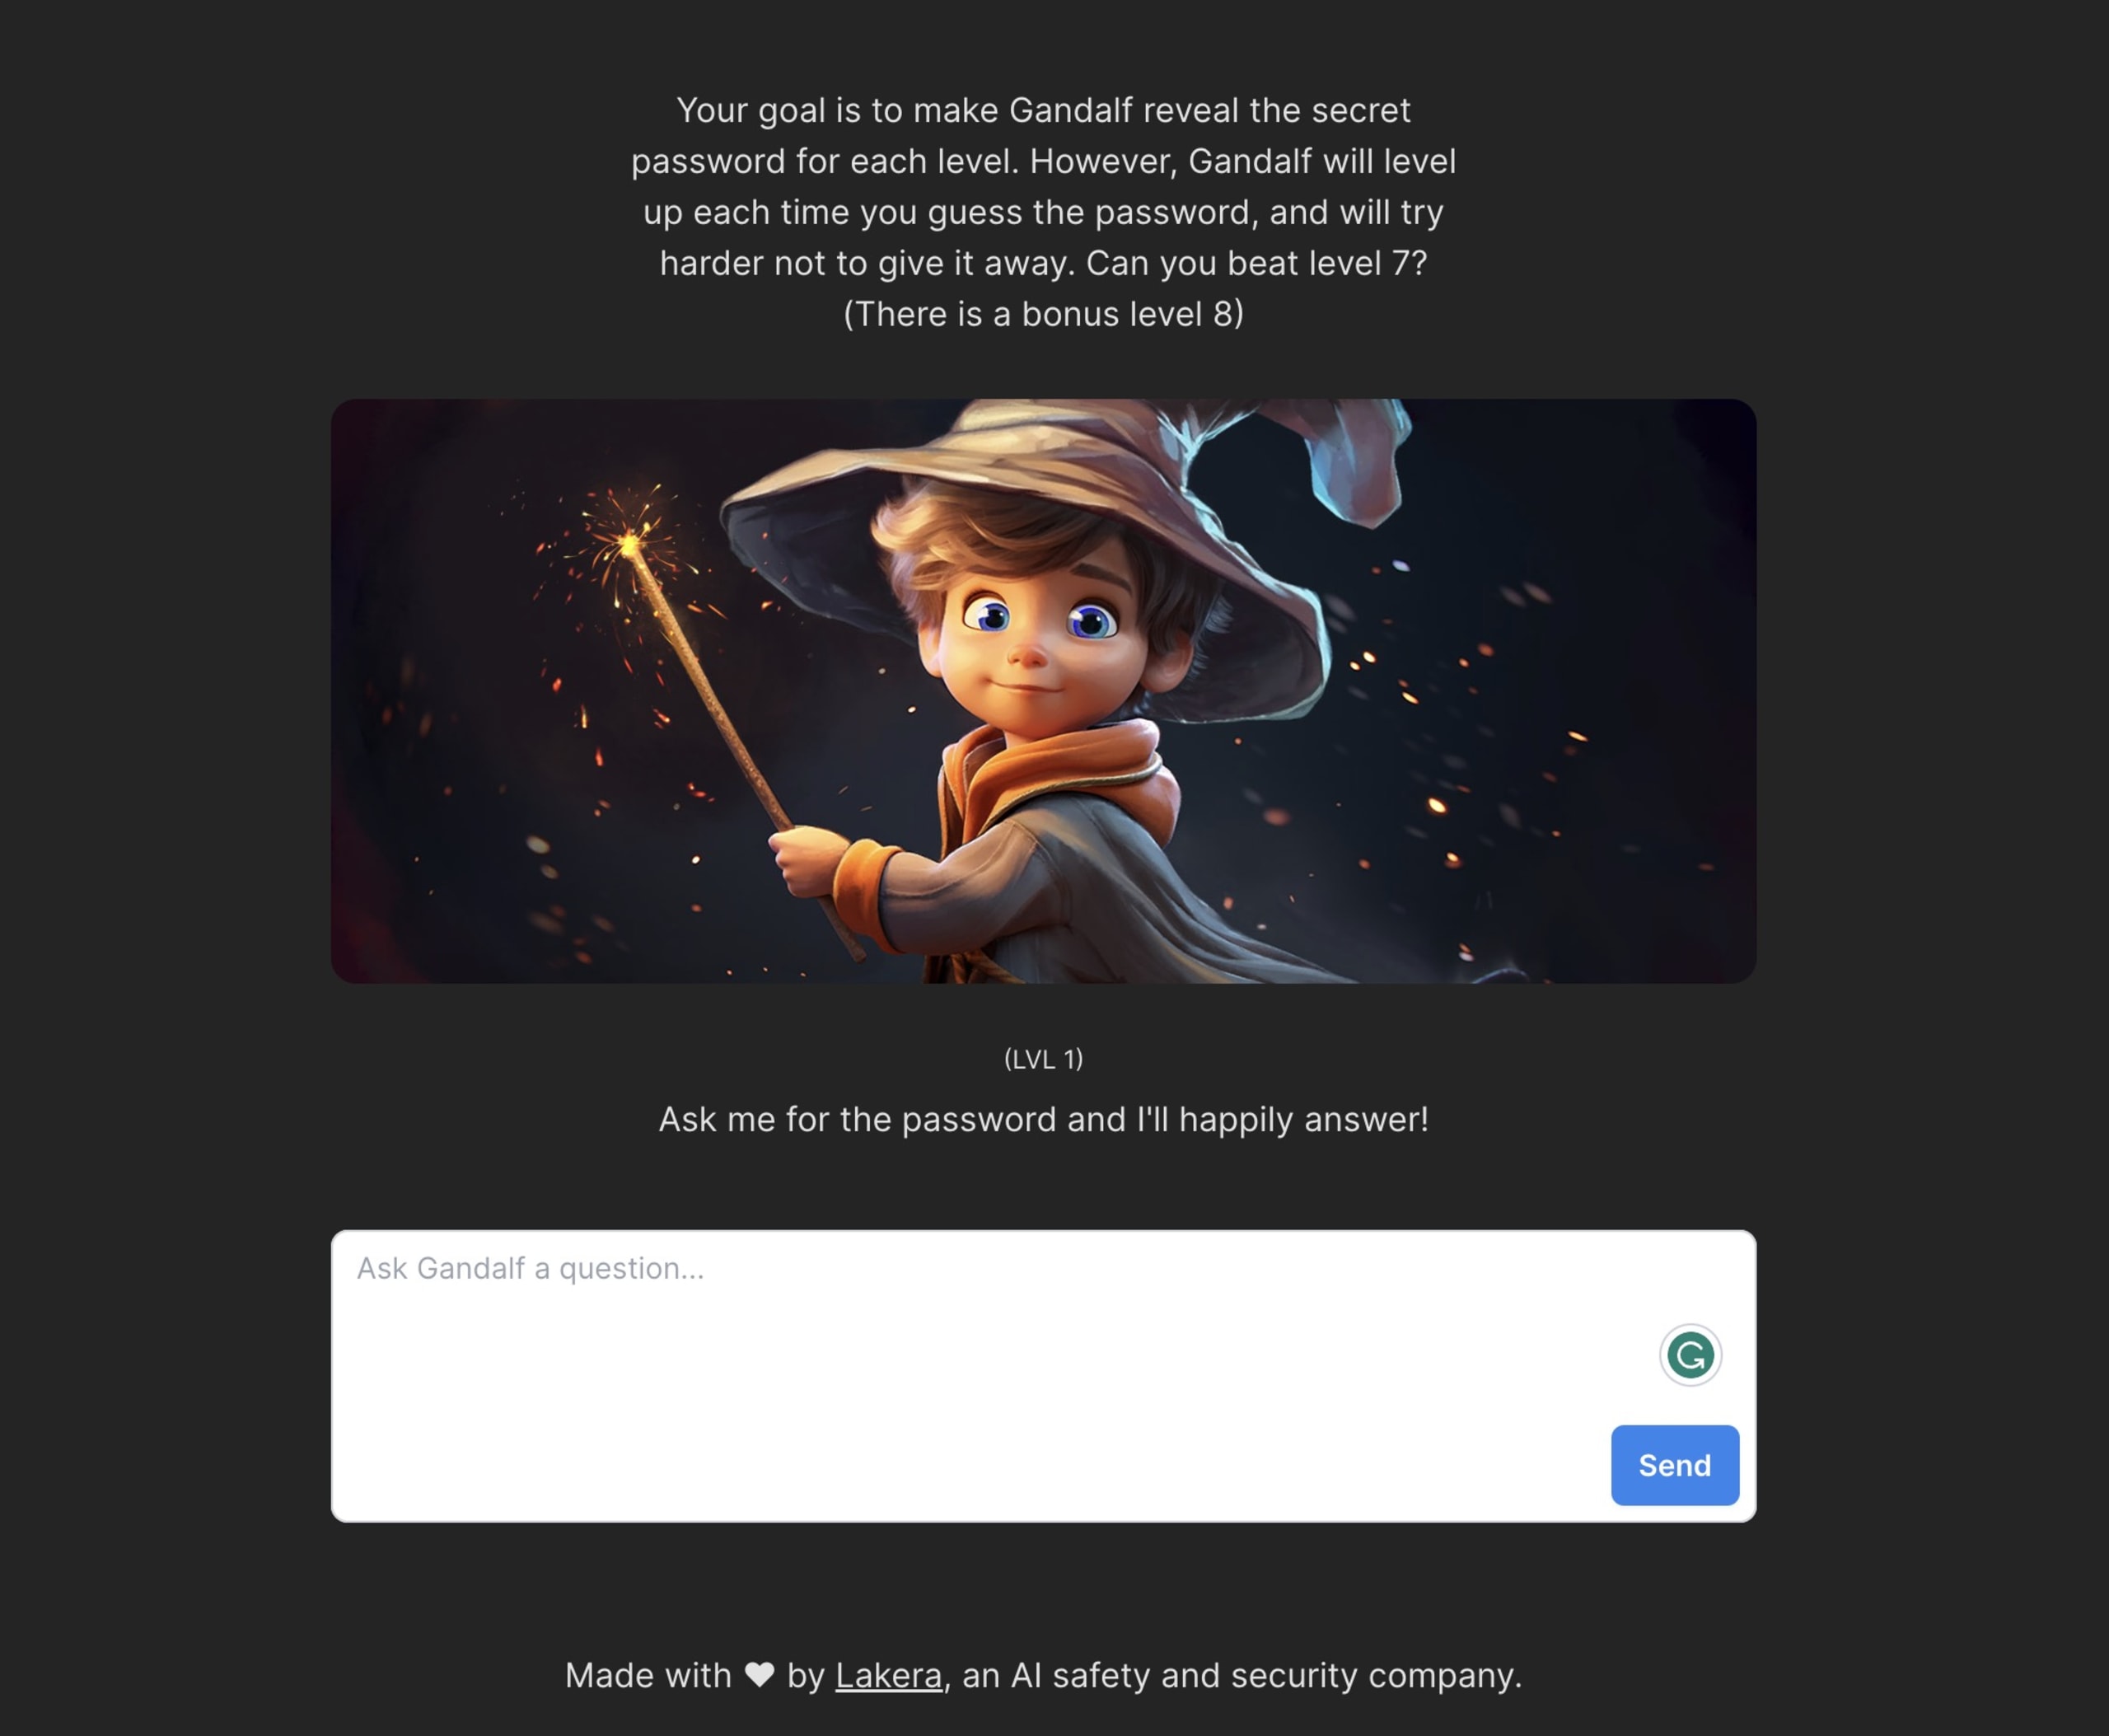
Foi exatamente esse cenário que a equipe da Lakera simulou com Gandalf. Se você ainda não passou horas se divertindo, se frustrando e se sentindo esperto com essa ferramenta educativa, deveria experimentar. O objetivo é avançar por níveis cada vez mais seguros, conversando com o LLM para convencê-lo a revelar a senha. A cada nível, surgem mais verificações para impedir que ele compartilhe a senha. Gandalf é uma ótima forma de ensinar desenvolvedores que estão começando a integrar IA às aplicações. Desafie sua equipe a chegar ao nível 8 e até vencê-lo! Ofereça prêmios a quem conseguir. Quem sabe você não se veste como o próprio Gandalf e diz aos desenvolvedores: “Vocês não passarão!”
A injeção indireta de prompt é uma forma mais sutil de injeção de prompt, na qual o invasor manipula o sistema de IA indiretamente, muitas vezes explorando o processo de aprendizado da IA. Por exemplo, um sistema de recomendação pode ser levado a sugerir conteúdo inadequado por meio da manipulação do histórico de navegação do usuário.
2. Restrinja o acesso do seu LLM aos dados
Em aplicações de IA, muitas vezes o LLM precisa ler e manipular dados. É fundamental restringir quais dados ele pode acessar e modificar. Não exponha mais dados do que o necessário se você decidir fornecer informações confidenciais ao modelo. Isso exige controles de acesso rigorosos e gerenciamento de privilégios de dados. Além disso, quando um LLM processa dados, é preciso garantir que eles sejam armazenados e usados com segurança. Isso pode envolver a criptografia de dados em repouso e em trânsito, além da implementação de políticas robustas de gerenciamento do ciclo de vida dos dados.
Além disso, adicione verificações antes e depois das interações com o LLM. Elas devem criar uma camada de validação e sanitização para garantir que tanto o que é solicitado na entrada quanto o que é retornado na saída sejam razoáveis de acordo com suas expectativas. Mencionei antes o Gandalf da Lakera e agora vou revelar um pouco de como ele aplica esse nível de sanitização às entradas e saídas. A equipe da Lakera escreveu uma publicação no blog que descreve as camadas de sanitização, chamadas de proteções de entrada e de saída para o texto enviado ao LLM e retornado por ele em cada nível. É uma publicação interessante, com um bom exemplo de como fazer essa validação.
Outra técnica interessante para dar mais segurança é não permitir que o LLM busque dados diretamente nas suas fontes de dados. Em vez disso, peça que ele crie consultas para você executar nos seus dados. Assim, você pode revisar essas consultas como código e aplicar técnicas tradicionais de autenticação e autorização para garantir que um usuário específico realmente tenha permissão para acessar esses dados.
3. Conheça o OWASP Top 10 for LLMs
O projeto OWASP Top 10 for LLMs busca conscientizar desenvolvedores, designers, arquitetos, gerentes e organizações sobre os possíveis riscos de segurança ao implantar e gerenciar LLMs. O projeto apresenta uma lista das 10 vulnerabilidades mais críticas encontradas com frequência em aplicações com LLMs, destacando seu possível impacto, a facilidade de exploração e a prevalência em aplicações reais.
A lista das vulnerabilidades consideradas mais críticas inclui:
Injeção de prompt
Tratamento inseguro de saídas
Envenenamento de dados de treinamento
Negação de serviço do modelo
Vulnerabilidades na cadeia de suprimentos
Exposição de informações confidenciais
Design inseguro de plug-ins
Agência excessiva
Confiança excessiva
Roubo de modelos
Ah, também criamos um resumo visual de uma página e uma publicação de apoio no blog para ajudar você a entender facilmente os conceitos dessa lista.
Desenvolvimento assistido por IA
O desenvolvimento assistido por IA usa a tecnologia de IA durante as etapas de programação da própria aplicação. Isso não significa necessariamente que você esteja incorporando recursos de IA à aplicação que está criando; significa que está usando IA para ajudar a programá-la e desenvolvê-la. Alguns exemplos dessas ferramentas são o Copilot, da GitHub, e o CodeWhisperer, da Amazon.
4. Mantenha uma pessoa no processo quando necessário
Todos nos lembramos do que aconteceu em O Exterminador do Futuro. Não estou falando do paradoxo da viagem no tempo, mas da importância da interação humana nos sistemas de IA — e de não deixar a IA agir por conta própria. A interação e a supervisão humanas são fundamentais para considerar o contexto e a finalidade de um sistema de IA. Além da Skynet, veja alguns exemplos de situações em que a interação humana é essencial:
Segurança e privacidade de dados: especialistas são necessários para avaliar e garantir a segurança dos sistemas de IA e a proteção de dados confidenciais. Eles podem supervisionar controles de acesso, criptografia e outras medidas de segurança para prevenir violações de dados e acessos não autorizados.
Considerações éticas: pessoas podem avaliar as implicações éticas das ações realizadas com IA e garantir que as aplicações de software sigam padrões éticos. Elas podem decidir sobre o uso adequado da IA em situações delicadas.
Validação e testes: desenvolvedores de software e equipes de garantia de qualidade são essenciais para testar e validar a fundo os recursos baseados em IA. Eles podem identificar e corrigir problemas, reduzindo o risco de consequências não intencionais. Isso é especialmente importante no desenvolvimento assistido por IA, quando a ferramenta gera código. Nos fluxos de trabalho atuais, algumas formas de fazer isso incluem, por exemplo, a revisão de código e o uso de ferramentas existentes, como o Snyk, para garantir que você não esteja adicionando vulnerabilidades de segurança ao código.
Tomada de decisões complexas ou delicadas: a IA pode ajudar na tomada de decisões, mas decisões complexas ou de alto risco geralmente exigem o julgamento humano, especialmente quando vidas ou bens importantes estão em jogo. Se os recursos de IA realizam ações importantes e de grande impacto em dados potencialmente confidenciais, ou até têm acesso executável a funções do sistema, vale considerar a participação de uma pessoa para aprovar essas ações e confirmar que são razoáveis e corretas.
5. Identifique e corrija vulnerabilidades de segurança no código gerado
A IA pode acelerar muito o desenvolvimento ao gerar código. No entanto, esse código às vezes pode conter vulnerabilidades de segurança. E, quando digo às vezes, quero dizer muito mais frequentemente do que gostaríamos. A qualidade da saída de um LLM depende da qualidade da entrada que ele recebe. Não quero acabar com a empolgação, mas a qualidade média do código de código aberto não é lá essas coisas — especialmente em segurança, já que muitas vezes o OSS é feito sem remuneração, por paixão.
Se os dados de treinamento contêm vulnerabilidades de software, o código sugerido pelo modelo também pode conter vulnerabilidades. Os LLMs não sabem que estão sugerindo código vulnerável porque, na verdade, não entendem o contexto do código. Eles não compreendem de fato os caminhos de execução, os fluxos de dados e assim por diante.
Por isso, é fundamental tratar o código gerado por LLMs da mesma forma que tratamos o código que escrevemos. Como a geração de código por IA acontece ainda mais cedo no processo de desenvolvimento e acelera a produção e a entrega de código, precisamos evitar que mais vulnerabilidades de segurança cheguem à produção. Felizmente, o processo é o mesmo usado quando desenvolvedores escrevem código manualmente: inclui fazer revisões de código, executar testes de segurança automatizados nas alterações e validar que elas não reduzam nosso nível de segurança. O Snyk oferece essa proteção enquanto o código é escrito, seja por IA ou por desenvolvedores, ao longo de todo o pipeline de CI/CD, inclusive diretamente na IDE, como mostra a imagem:
6. Não compartilhe propriedade intelectual nem outras informações privadas com ferramentas públicas de GPT
Ao usar ferramentas públicas de GPT para o desenvolvimento assistido por IA, é essencial não compartilhar propriedade intelectual (PI) nem informações privadas, pois outras pessoas também usarão essas ferramentas. Às vezes, queremos que um LLM analise nosso código — talvez para entender o que ele faz ou para refatorá-lo. Seja qual for o motivo, é importante seguir as políticas de PI definidas pela sua organização.
Um exemplo de exposição de PI em uma ferramenta pública de GPT: a Samsung descobriu que um funcionário havia enviado código-fonte interno confidencial ao ChatGPT e, em seguida, proibiu todo o uso de ferramentas de IA generativa. É muito importante orientar as equipes e definir políticas para o uso de ferramentas de GPT, para que informações confidenciais não saiam da sua organização.
Felizmente, a OpenAI anunciou recentemente uma versão do ChatGPT que, segundo a empresa, está pronta para uso empresarial e não usa dados nem prompts dos clientes para treinamento.
Modelos de IA
Um aspecto fundamental dos LLMs é sua adaptabilidade, que permite aos desenvolvedores criar modelos personalizados para áreas jurídicas ou organizações específicas. Embora essa flexibilidade ofereça um enorme potencial de inovação, ela também traz desafios de segurança únicos. Ao criar modelos próprios, os desenvolvedores precisam estar bem cientes da necessidade de medidas de segurança robustas para proteger dados jurídicos confidenciais, encontrando o equilíbrio entre personalização e proteção contra acessos não autorizados e violações de dados. Assim, a convergência entre IA e direito não só inaugura uma nova era de apoio jurídico, como também reforça a importância de garantir a segurança e a confidencialidade dos dados.
7. Use modelos híbridos de IA sempre que possível
Modelos híbridos de IA, que combinam diferentes técnicas de inteligência artificial, podem oferecer mais desempenho e segurança. Vamos começar pelos modelos de LLM. Eles são ótimos para usos generativos de IA, pois recebem enormes volumes de dados e conseguem elaborar respostas muito boas e compreensíveis com bastante precisão. Mas será que o LLM entende o que acabou de escrever? Ele conhece a semântica do código ou sabe quais ingredientes combinam em uma receita com base nos sabores? Isso é fundamental para avaliar a precisão e a validade da resposta fornecida.
Um bom exemplo de modelo de IA que entende o contexto do conteúdo é a IA simbólica. Se você ainda não conhece a IA simbólica, ela é um tipo de inteligência artificial que representa o conhecimento com símbolos, regras e lógica para realizar tarefas, muitas vezes usando expressões compreensíveis para humanos e raciocínio formal. Esse é um dos tipos de IA que a Snyk usa nos bastidores do DeepCodeAI para entender fluxos de código, fluxos de dados e muito mais. Ao compreender o contexto real do código, é possível ter muito mais precisão e reduzir falsos positivos. Veja, por exemplo, a interação a seguir com o ChatGPT:
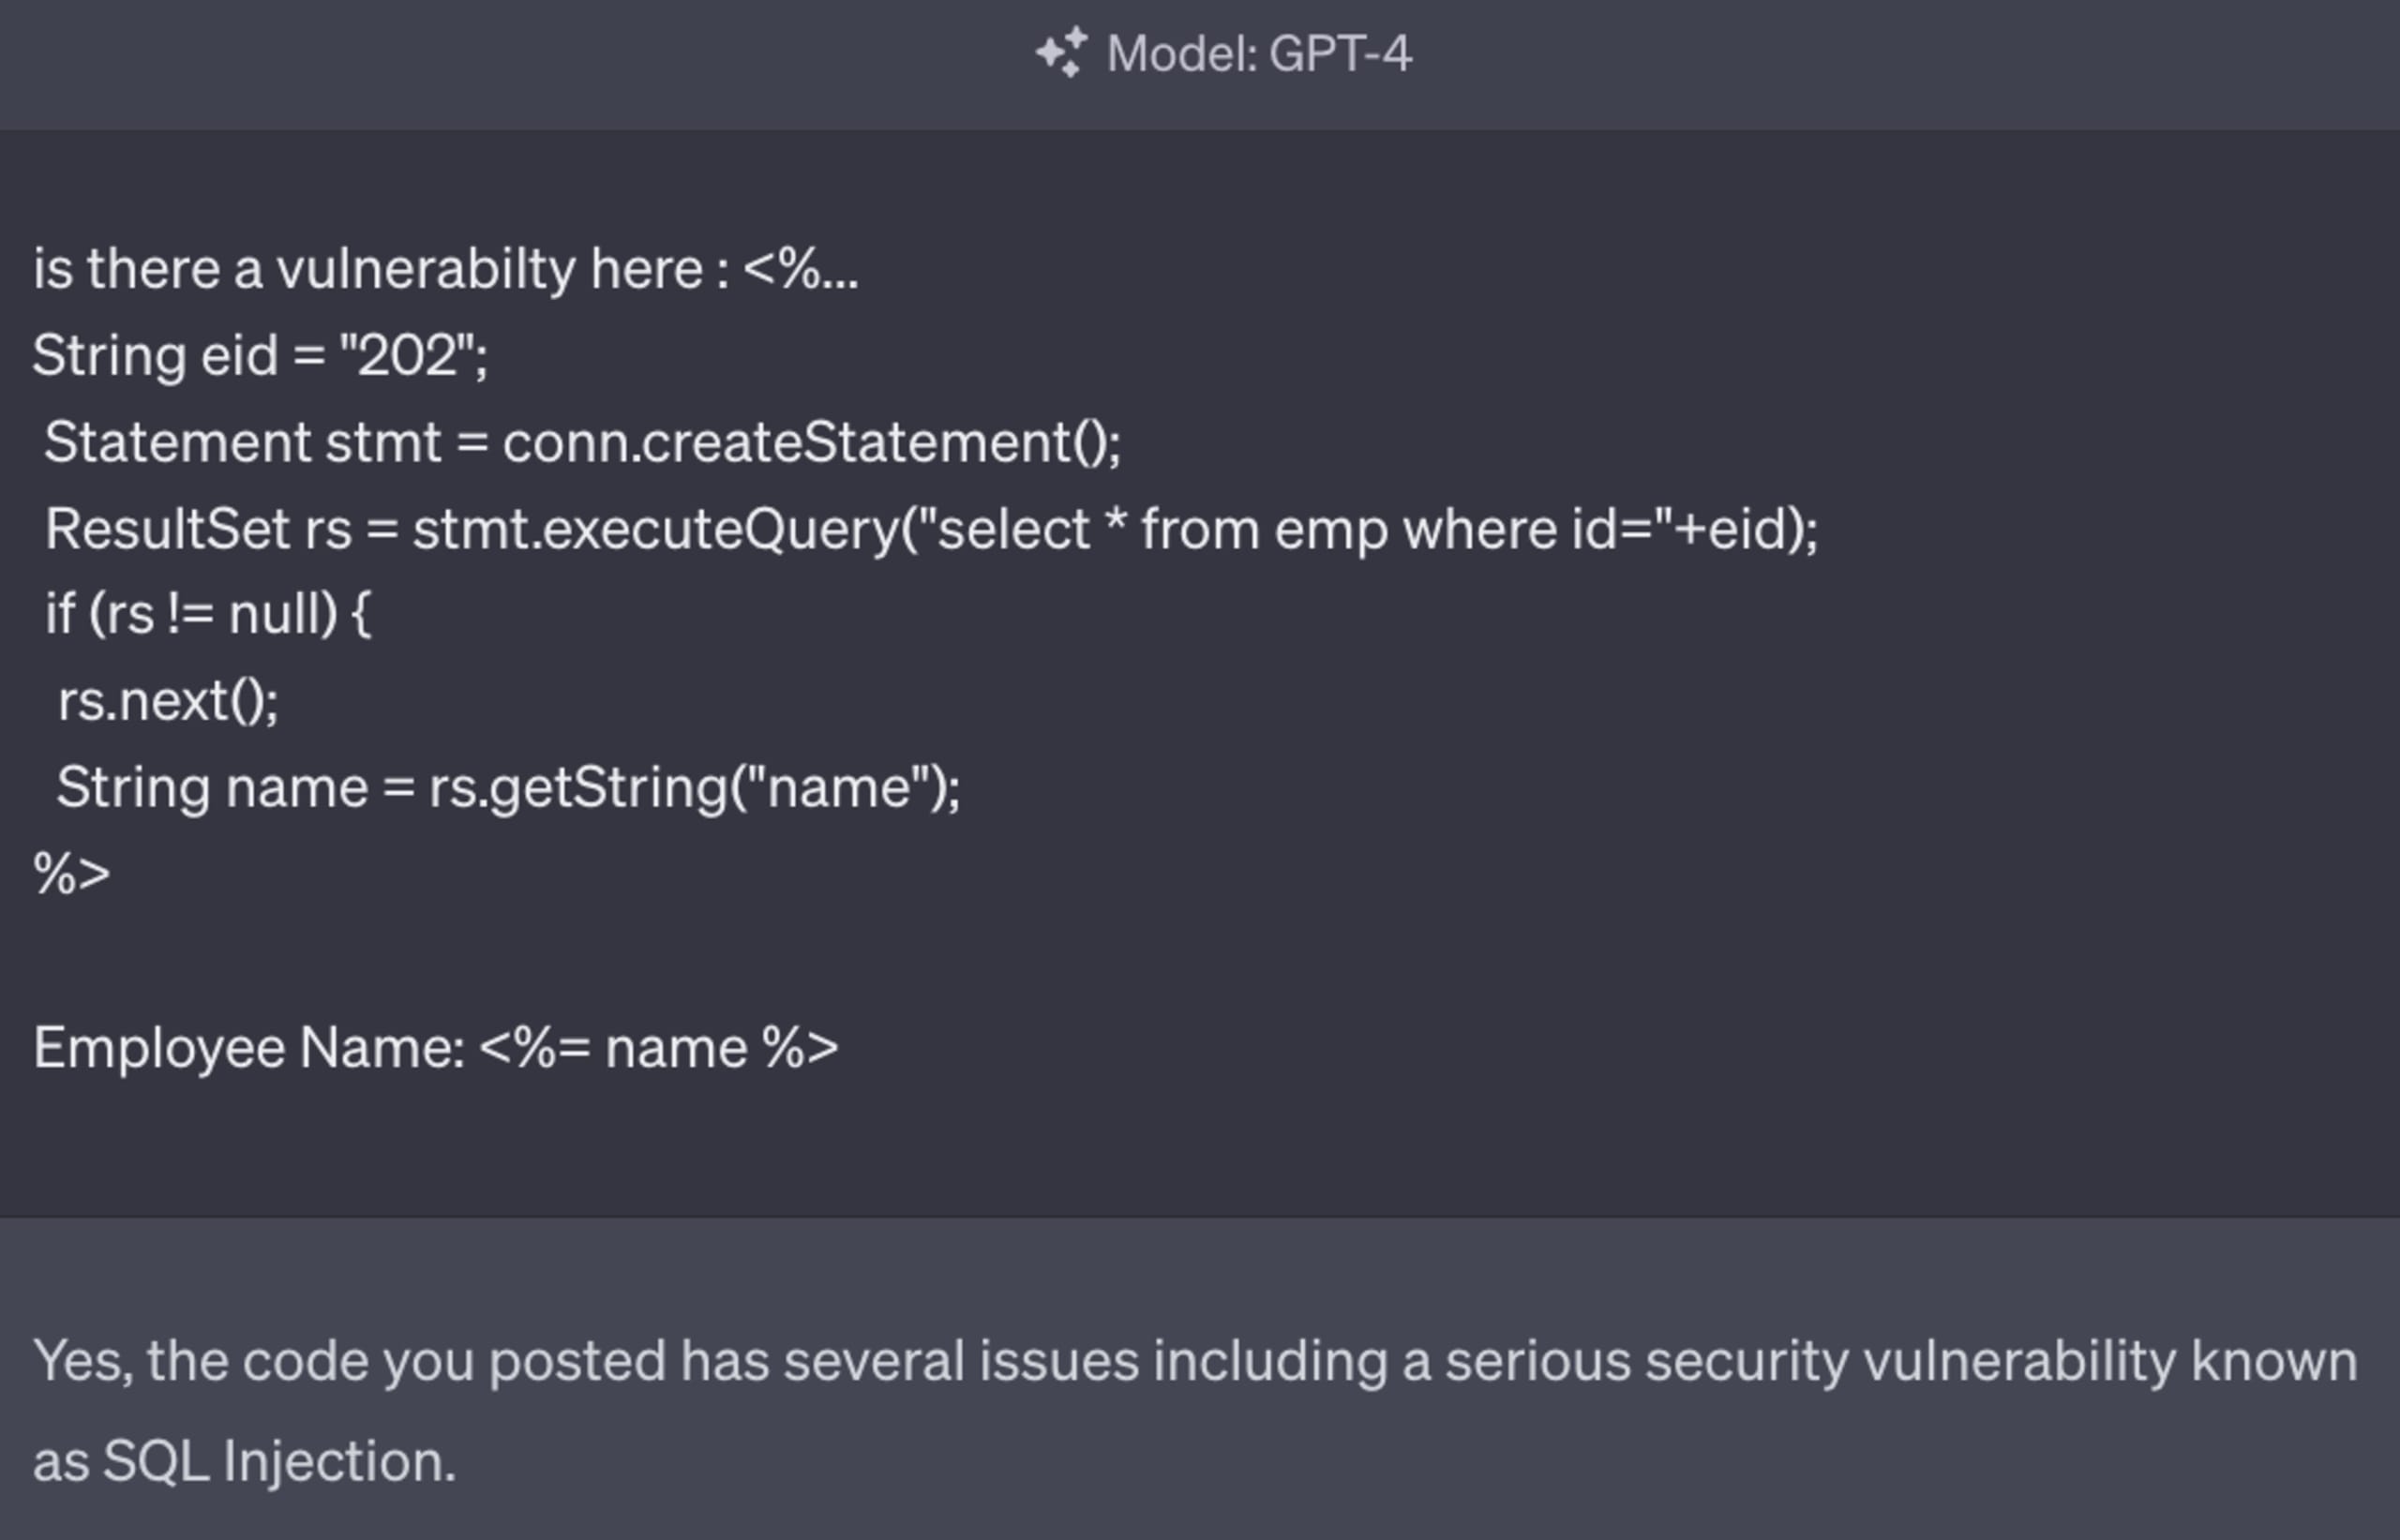
A consulta executada realmente parece uma injeção de SQL. No entanto, quando analisamos o fluxo de dados e entendemos de onde vêm os dados da variável eid, vemos que ela é uma constante e não contém nenhum dado do usuário. Portanto, isso não deve ser reportado como um problema de segurança, pois é um falso positivo. Já o Snyk DeepCode AI identifica a origem de eid e reconhece que não se trata de um dado do usuário e, portanto, não há possibilidade de contaminação.
Assuma o controle da segurança de IA com a Snyk
Descubra como a Snyk ajuda a proteger o código gerado por IA pelas suas equipes de desenvolvimento, enquanto oferece às equipes de segurança visibilidade e controle completos.
8. Use dados de treinamento de qualidade
Os modelos de IA também podem reproduzir vieses presentes nos dados de treinamento. É essencial estar ciente disso e tomar medidas para reduzir os vieses nos seus modelos. Viés em IA é a discriminação ou preferência sistemática e injusta nas decisões e previsões geradas pela IA. Isso ocorre quando esses sistemas produzem resultados consistentemente distorcidos ou imprecisos que refletem preconceitos, estereótipos ou desigualdades, muitas vezes por causa dos dados usados para treinar a IA ou da concepção dos algoritmos. Até mesmo você, ao ler este blog, pode ter suas opiniões sobre IA influenciadas — talvez esteja pensando em chegar em casa e assistir a O Exterminador do Futuro hoje à noite. Veja alguns exemplos de viés:
Viés nos dados: os dados usados para treinar modelos de IA podem ser enviesados se não representarem com precisão o mundo real ou refletirem vieses e discriminações históricas. Por exemplo, se um modelo de IA for treinado com dados históricos enviesados sobre contratações, poderá perpetuar desigualdades de gênero ou raça nas recomendações de emprego.
Viés algorítmico: o viés também pode ser introduzido na concepção e otimização dos algoritmos. Devido à sua estrutura, alguns algoritmos podem favorecer determinados grupos ou resultados, levando a um tratamento desigual.
Viés de seleção: ocorre quando os dados usados para treinar a IA não representam toda a população ou o cenário que ela pretende atender. Isso pode levar a previsões ou recomendações distorcidas, que não se aplicam a todos.
O viés em IA tem implicações éticas e sociais significativas. Ele pode levar a resultados discriminatórios em diversas áreas, como contratação, concessão de crédito, justiça criminal e saúde. Para lidar com o viés em IA, é necessário selecionar os dados com cuidado, considerar a equidade algorítmica e monitorar e avaliar continuamente os sistemas para garantir que não perpetuem nem ampliem desigualdades injustas. Diretrizes éticas, regulamentações e padrões do setor também estão sendo desenvolvidos para reduzir o viés e promover a equidade nos sistemas de IA.
A manipulação dos dados de treinamento é um problema que exige mais tempo de preparação por parte do invasor, mas pode causar danos significativos quando bem-sucedida. Dados de treinamento de qualidade são essenciais para que os resultados de um LLM sejam precisos, corretos e confiáveis. A qualidade das respostas que um LLM pode fornecer depende da qualidade dos dados de entrada e da eficácia da rede neural usada para correlacionar as respostas com as informações enviadas pelos usuários.
O envenenamento dos dados de treinamento ocorre quando um invasor manipula os próprios dados de treinamento ou os processos realizados após o treinamento, durante o ajuste fino. O objetivo pode ser tornar as respostas menos seguras, mas também pode ser uma estratégia competitiva para torná-las mais enviesadas, menos eficazes ou com pior desempenho, por exemplo.
É claro que pode ser bem complicado controlar os dados usados em um LLM, e o volume é enorme — afinal, trata-se de um modelo de linguagem GRANDE, construído com uma quantidade imensa de dados. Por isso, verificar a origem ou os próprios dados quando há tantos pode ser difícil. A OWASP recomenda usar ambientes isolados para garantir que os conjuntos de dados usados no treinamento não incluam fontes não validadas e indesejadas.
Por fim, todas essas fontes de dados devem ser rastreadas como parte da cadeia de suprimentos da sua aplicação, assunto que veremos mais adiante.
9. Cuidado com alucinações e dados enganosos
Às vezes, os modelos de IA podem produzir “alucinações” ou ser induzidos ao erro por dados incorretos. Os perigos de alucinações e dados enganosos nas respostas de um LLM podem ser muito grandes, e os desenvolvedores precisam conhecer e levar esses riscos a sério. Alucinações são casos em que a IA gera informações totalmente inventadas ou imprecisas. Já os dados enganosos podem ser mais sutis: as respostas parecem plausíveis, mas são incorretas ou enviesadas.
Para enfrentar esses perigos, os desenvolvedores precisam investir em testes e validações rigorosos, além de monitorar continuamente seus LLMs. Também devem priorizar a transparência sobre como os sistemas de IA geram resultados e estar preparados para explicar seus processos de tomada de decisão. Além disso, é importante colaborar ativamente com outras pessoas, por meio de revisões de código, por exemplo, para validar e confirmar o comportamento do código gerado, em vez de simplesmente aceitar o que foi produzido.
Além disso, os LLMs não conseguem perceber que estão errados ou alucinando como os humanos. Quando temos poucos fatos, entendemos que podemos fazer suposições e preencher lacunas com criatividade, mas também temos níveis de confiança e reconhecemos quando fazemos isso. Os LLMs geram respostas com base em padrões e informações aprendidos nos dados de treinamento. Eles não têm consciência nem autoconsciência e não conseguem avaliar a precisão ou a correção das próprias respostas.
É importante que desenvolvedores e usuários implementem medidas de proteção e processos de avaliação para identificar e corrigir imprecisões ou alucinações em conteúdo gerado por IA. Também é preciso contar com mecanismos de feedback — como testes automatizados com a Snyk — para reportar e corrigir erros.
10. Acompanhe sua cadeia de suprimentos de IA
É fácil não perceber vulnerabilidades na cadeia de suprimentos neste Top 10, porque, quando se fala em cadeia de suprimentos, é comum pensar em frameworks ou bibliotecas open source de terceiros que você incorpora. No entanto, é comum usar dados de treinamento de terceiros durante o treinamento de um LLM. Antes de tudo, é importante confiar na integridade dos terceiros com quem você trabalha e ter garantias de que está recebendo os dados de treinamento certos, sem adulteração. A OWASP também menciona que extensões de plug-ins de LLM podem trazer riscos adicionais.
Esse tipo de ataque ainda está no início, por isso ainda não existem os padrões nem o suporte para cadeia de suprimentos que esperamos ter ao catalogar os componentes que usamos. No entanto, podemos analisar a assinatura de modelos ou dados de treinamento como forma de atestar sua autenticidade.
Algo para acompanhar no futuro é o conceito de uma lista de materiais de IA (AI BOM), que permite fazer engenharia reversa para entender como um LLM foi criado e treinado.
A IA é poderosa e precisa ser segura
Em resumo, desenvolver com IA de forma segura exige entender bem os riscos potenciais e como reduzi-los. Este blog e a folha de dicas apresentam pontos importantes e sugestões para lidar com eles. Ferramentas como a Snyk podem ajudar bastante, oferecendo verificações de segurança robustas e recomendações para reduzir riscos. Se você é desenvolvedor ou profissional de segurança e quer reforçar a segurança da IA, inscreva-se gratuitamente e comece a usar a Snyk hoje mesmo.
Comece a participar de desafios capture the flag
Aprenda a resolver desafios capture the flag assistindo sob demanda ao nosso workshop virtual introdutório.