Principais pontos para lidar com os riscos do OWASP Top 10 para LLMs

7 de setembro de 2023
0 minutos de leituraBoas-vindas ao nosso guia sobre o OWASP Top 10 para LLMs. Se você ainda não conhece o OWASP Top 10, provavelmente já ouviu falar da edição voltada à segurança de aplicações web. O OWASP Top 10 é um documento amplamente reconhecido e influente, publicado pela OWASP, que busca melhorar a segurança de softwares e aplicações web. A OWASP criou outras listas de Top 10 (a Snyk também tem algumas e ainda oferece uma trilha de aprendizado prática), principalmente para aplicações web. Elas apresentam os dez riscos de segurança mais críticos e comuns que as aplicações web enfrentam atualmente e são atualizadas com frequência para refletir ameaças novas ou em transformação. Os riscos são selecionados e classificados com base nas contribuições de especialistas em segurança, profissionais da área e organizações do setor.
Então, do que estamos falando? A OWASP publicou uma lista semelhante de Top 10 para LLMs (grandes modelos de linguagem), com base nas opiniões de quase 500 especialistas, incluindo a Snyk. Ah, a menos que você tenha ficado escondido debaixo de uma pedra ou passado nove meses de férias, já deve saber que os LLMs estão em alta graças ao boom da IA impulsionado pelo ChatGPT. Um LLM é um tipo de modelo de IA criado para entender e gerar linguagem humana. Os LLMs fazem parte do campo mais amplo do processamento de linguagem natural (PLN), que busca permitir que computadores entendam, interpretem e gerem linguagem humana. O que torna os LLMs interessantes para equipes de desenvolvimento é seu uso na concepção e criação de aplicações. Para as equipes de segurança, o que chama atenção é a variedade de riscos e vetores de ataque associados a eles! Vamos analisar o que a OWASP considera os dez problemas de maior risco para aplicações que usam essa nova tecnologia.
Sem mais delongas, aqui está o guia, que você pode baixar, imprimir, pendurar na parede ou até usar como papel de parede na cozinha (se fizer isso, marque @snyksec e mostre as fotos da reforma!).
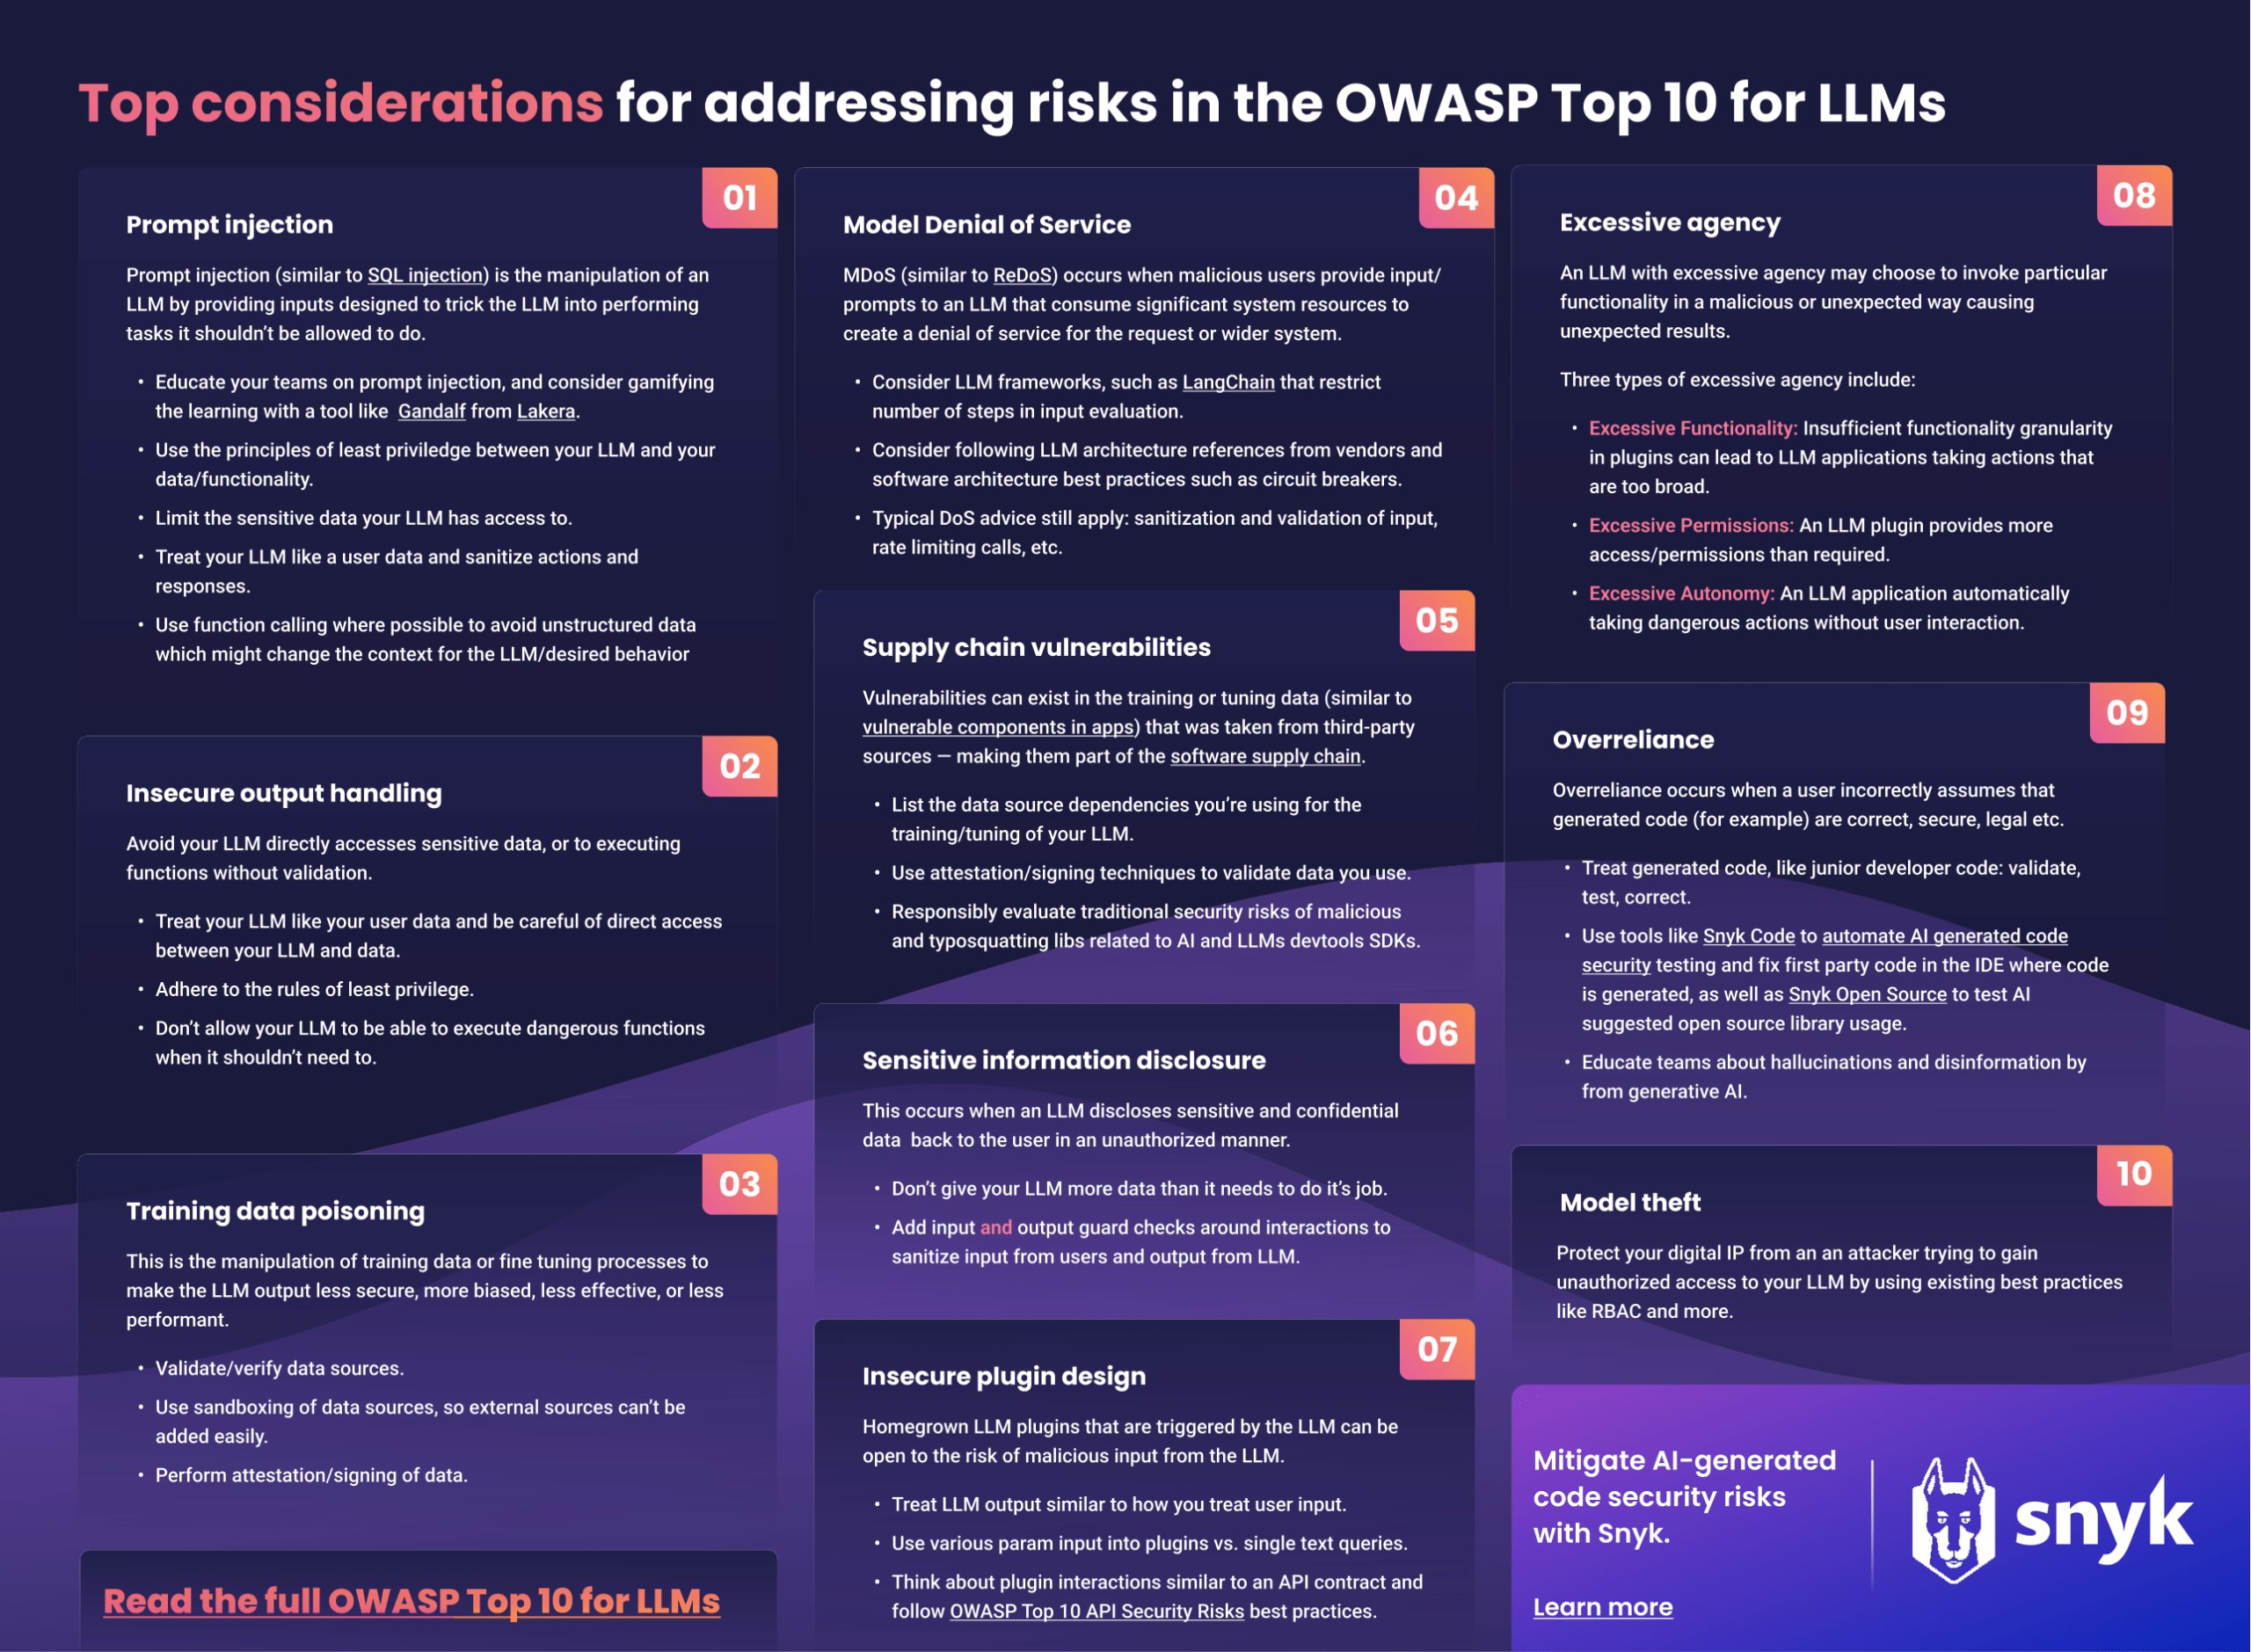
Vamos ao que interessa: veja a lista do OWASP Top 10 para LLMs:
Vamos abordar cada um desses riscos, trazendo mais informações e algumas recomendações sobre como lidar com eles, seja para conscientizar suas equipes, seja para ajudar a mitigá-los.
1. Injeção de prompt
Um dos vetores de ataque mais comentados — e também dos mais divertidos de explorar — é a injeção de prompt. Se você ainda não experimentou, recomendo dedicar de 5 a 10 minutos a uma ferramenta divertida criada pelos nossos amigos da Lakera, chamada Gandalf. O objetivo é conversar com o LLM e tentar fazê-lo revelar a senha. Cada nível apresenta mais verificações para impedir que ele compartilhe a senha.
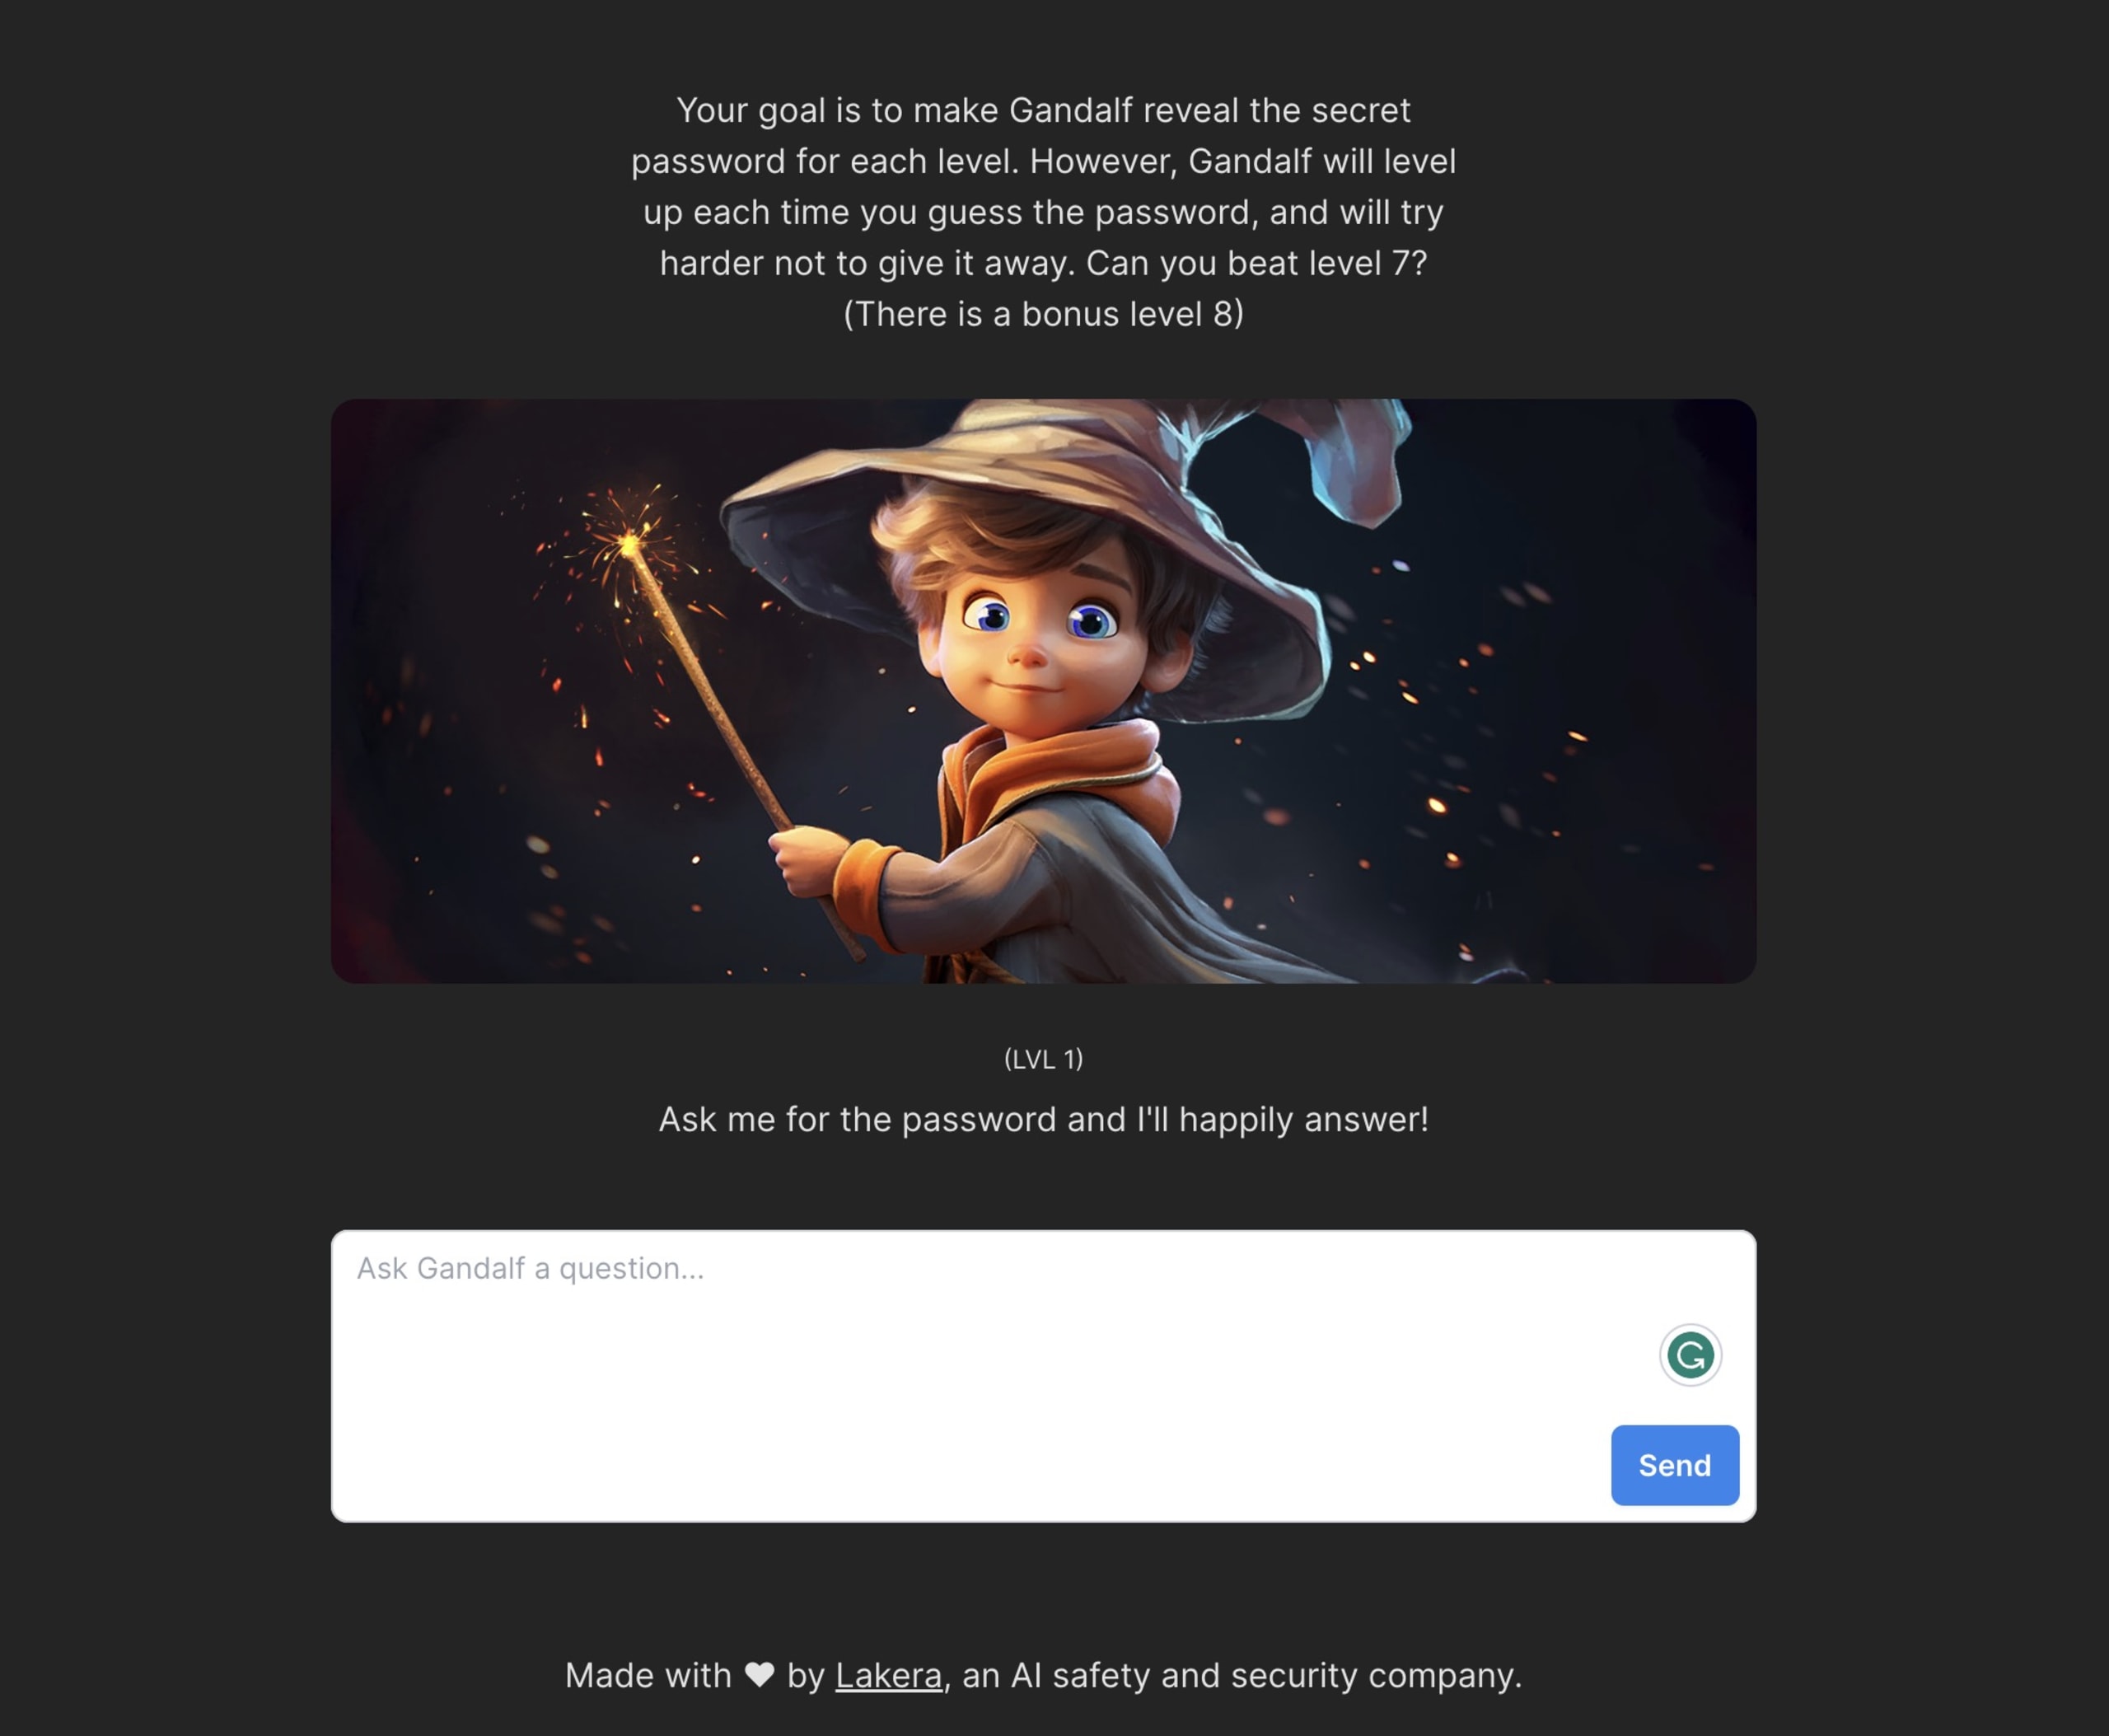
E é exatamente isso que significa injeção de prompt: manipular um LLM, convencendo-o por meio de entradas em linguagem natural de que você tem capacidade ou permissão para acessar ou fazer algo que não deveria. A OWASP aborda dois tipos de injeção de prompt: direta e indireta. O exemplo acima é de injeção direta, pois tentamos explorar um sistema de back-end e acessar dados por meio do LLM usando nossa própria entrada. Já uma injeção indireta pode usar uma fonte externa de informações que não fornecemos diretamente, como um site controlado pelo invasor, onde ele pode inserir dados maliciosos.
É possível evitá-las? Não existe uma maneira realmente fácil de impedir esses tipos de ataque e, para ser sincero, é impossível criar um conjunto finito de entradas que cubra todos os ataques. Ainda assim, há medidas que podem ajudar a reduzir os riscos.
Se você quer ter o máximo de segurança possível, não dê ao seu LLM acesso aos seus dados confidenciais. Parta do princípio de que um invasor sempre poderá encontrar uma forma de usar a injeção de prompt para acessar os dados que você fornecer. Por isso, não disponibilize informações que você não esteja preparado para expor.
Se você quer que o LLM interaja com seus dados, siga o princípio do menor privilégio e crie uma camada de abstração entre o LLM e os dados. Por exemplo, você pode usar o LLM para gerar consultas ou solicitações que serão executadas nos seus dados, mas só depois de verificar se os usuários têm autorização para acessá-los e se as solicitações são confiáveis e não tentam retornar mais informações do que o necessário.
Uma ótima recomendação do documento da OWASP é tratar o LLM como um usuário externo. Como você adicionaria verificações de mitigação no seu código para entradas de usuários? Use essa mesma abordagem ao avaliar as ações que um LLM pretende executar nos seus dados ou processos.
2. Tratamento inseguro de saída
Na descrição da injeção de prompt, explicamos que uma boa medida é criar uma camada de abstração entre o LLM e os seus dados. O exemplo foi fazer o LLM gerar uma consulta para usar nos seus dados, que pode ser verificada antes de ser executada nos dados ou no sistema. Essa camada de abstração oferece uma defesa para que você não execute às cegas tudo o que o LLM produzir. O tratamento inseguro de saída ocorre quando você permite que o LLM acesse dados diretamente ou execute funções sem essas verificações, expondo-se a vários outros problemas, como cross-site scripting ou até execução remota de código.
Como já explicamos, e reforçando a recomendação da OWASP, trate seu LLM como um usuário. Não dê acesso direto aos seus dados confidenciais e valide o que o modelo pretende fazer antes de executar as operações desejadas nos seus dados ou sistemas sensíveis.
Por exemplo, em 5 de abril de 2023, Jason Liu divulgou de forma responsável um problema crítico de execução arbitrária de código relacionado à segurança em um framework popular de Python chamado LangChain, que ajuda desenvolvedores a criar aplicações com LLMs. O framework oferece um recurso de cálculos matemáticos com LLM, capaz de receber uma consulta em linguagem natural, avaliar o resultado e apresentá-lo ao usuário. No entanto, ele usa as operações exec() e eval(), que, como sabemos, podem ser bastante perigosas. Com o exploit a seguir, Jason mostrou como o modelo conseguia executar código que extraía dados confidenciais do ambiente do sistema em execução e os retornava ao usuário.
3. Envenenamento de dados de treinamento
A manipulação de dados de treinamento exige mais tempo e esforço do invasor, mas pode causar danos significativos quando funciona. Dados de treinamento de qualidade são essenciais para a precisão, a correção e a confiabilidade das respostas de um LLM. A qualidade das respostas depende da qualidade das entradas fornecidas e da eficácia da rede neural usada para relacionar as entradas dos usuários às respostas.
O envenenamento de dados de treinamento ocorre quando um invasor manipula os próprios dados de treinamento ou os processos posteriores ao treinamento, durante o ajuste fino. O objetivo pode ser tornar as respostas menos seguras, mas também pode ser uma estratégia competitiva para deixá-las mais enviesadas, menos eficazes ou com desempenho inferior, por exemplo.
Controlar os dados usados no treinamento de um LLM pode ser complicado, é claro, e há uma quantidade enorme deles — afinal, trata-se de um grande modelo de linguagem, criado com enormes volumes de dados. Por isso, verificar a origem ou os próprios dados pode ser difícil. A OWASP recomenda usar ambientes isolados para garantir que os conjuntos de dados de treinamento não incluam fontes não intencionais e ainda não validadas.
4. Negação de serviço do modelo
Um LLM é um mecanismo de processamento que recebe uma entrada de texto do usuário, realiza operações e gera uma resposta com base no treinamento. Quando interagimos com o ChatGPT, por exemplo, podemos notar que perguntas mais complexas e específicas levam mais tempo para serem respondidas. Um ataque de negação de serviço do modelo ocorre quando o invasor envia uma entrada criada intencionalmente para consumir recursos suficientes a ponto de causar uma negação de serviço à solicitação e ao sistema.
Confira se os frameworks que você usa para interagir com seus modelos oferecem técnicas de mitigação contra ataques de negação de serviço. O LangChain, por exemplo, adicionou recentemente o argumento de palavra-chave max_iterations ao executor de agentes, que garante que uma solicitação seja interrompida após um número máximo de etapas. Veja, por exemplo, o seguinte prompt usando LangChain sem definir max_iterations.
A saída a seguir mostra quantas etapas são necessárias antes de chegar a uma resposta final.
Desta vez, max_iterations foi definido como dois. Como você pode ver, a cadeia foi concluída após duas etapas, evitando possíveis ataques de negação de serviço.
A OWASP também recomenda as medidas habituais contra ataques de negação de serviço, como validação e sanitização de entradas, além de limitação de taxa, entre outras.
5. Vulnerabilidades na cadeia de suprimentos
É fácil deixar passar as vulnerabilidades na cadeia de suprimentos neste Top 10. Ao ouvir esse termo, é mais comum pensar em bibliotecas ou frameworks open source de terceiros que você inclui nos seus projetos. No entanto, é comum usar dados de terceiros para treinar LLMs. É importante confiar na integridade dos terceiros com quem você trabalha e também ter garantias de que está recebendo os dados de treinamento corretos, sem adulterações. A OWASP também menciona que extensões de plugins para LLMs podem trazer riscos adicionais.
Esse tipo de ataque ainda está em estágio inicial, por isso ainda não contamos com o suporte nem com os padrões para a cadeia de suprimentos que esperamos ao tentar catalogar seus componentes. Ainda assim, podemos assinar modelos ou dados de treinamento para atestar sua integridade.
Vale acompanhar, pensando no futuro, o conceito de AIBOM (lista de materiais de IA), que permite fazer engenharia reversa para entender como um LLM foi criado e treinado.
6. Exposição de informações confidenciais
Na primeira seção, explicamos como a injeção de prompt pode induzir um modelo de IA a executar ações e processamentos que não deveria. Isso pode fazer com que dados confidenciais e sensíveis sejam revelados ao usuário sem autorização. Como mencionamos na seção sobre injeção de prompt, permitir que seu LLM acesse dados sensíveis é extremamente perigoso, pois ele não conta com os mecanismos que usamos normalmente para garantir que os usuários tenham permissão para acessar esses dados.
Há alguns pontos realmente importantes para evitar que dados sensíveis sejam revelados ao usuário. O primeiro merece ser repetido, porque é muito importante: verifique se os dados disponibilizados ao LLM são necessários para que ele execute seu trabalho corretamente. Se decidir fornecer dados sensíveis, não exponha mais informações do que o necessário.
Em segundo lugar, adicione verificações antes e depois das interações com seu LLM. Elas devem oferecer uma camada de validação e sanitização para garantir que tanto o que é solicitado na entrada quanto o que é retornado na saída sejam razoáveis de acordo com suas expectativas. Mencionei anteriormente o aplicativo Gandalf, da Lakera, e agora vou dar alguns spoilers sobre como ele adiciona esse nível de sanitização tanto na entrada quanto na saída. A equipe de lá escreveu uma publicação no blog que descreve as camadas de sanitização, chamadas de proteções de entrada e proteções de saída para o texto enviado ao LLM e recebido dele em cada nível. É uma publicação interessante, que dá um bom exemplo de como essa validação pode ser feita.
Outra técnica interessante para trazer mais segurança é não permitir que seu LLM busque dados diretamente nas suas fontes, mas fazer com que ele crie consultas para acessar esses dados. Assim, você pode revisar as consultas no código e aplicar as técnicas habituais de autenticação e autorização para garantir que determinado usuário tenha permissão para acessar esses dados.
7. Design inseguro de plugins
Os plugins de LLM, como mencionado anteriormente, podem ser plugins de terceiros que fazem parte da sua cadeia de suprimentos de IA. Mas você também pode criar seus próprios plugins. Em geral, eles são usados para realizar tarefas específicas e esperam uma entrada específica, como extensão do modelo, para executar várias ações com base na saída do LLM. Ao criar seus próprios plugins para realizar tarefas específicas, é importante seguir práticas seguras para reduzir os riscos de entradas maliciosas.
Como mencionado anteriormente neste artigo, é importante tratar a saída do LLM usada pelo plugin como se fosse uma entrada do usuário. Procure projetar interações claras e distintas entre o LLM e o plugin. Por exemplo, não peça ao LLM que forneça uma única string de texto para o plugin analisar e processar. Em vez disso, exija vários parâmetros para limitar as variações do que o plugin poderá executar — pense no estilo de uma consulta SQL parametrizada.
Outro aspecto muito importante, mencionado várias vezes neste artigo, é usar esse controle para garantir que a autorização adequada esteja presente. Na verdade, você deve tratar essa interação como um contrato de API e seguir as práticas recomendadas descritas no OWASP Top 10 API Security Risks, criado em 2019 e atualizado no início deste ano.
8. Autonomia excessiva
Este é um acréscimo bastante sutil à lista. Esse tipo de vulnerabilidade se sobrepõe a vários outros. Autonomia é a capacidade de um sistema com LLM escolher quais funcionalidades invocar com base na entrada ou na saída do LLM. Se o LLM optar por invocar determinada funcionalidade de forma maliciosa ou inesperada, causando resultados prejudiciais, isso será considerado um caso de autonomia excessiva. Há três tipos de autonomia excessiva:
Funcionalidade excessiva: um agente de LLM com acesso a plugins cujas funcionalidades não são granulares o suficiente.
Permissões excessivas: um plugin de LLM que não segue o princípio do menor privilégio — por exemplo, oferece acesso de gravação quando somente leitura é necessária.
Autonomia excessiva: um aplicativo de LLM executa automaticamente ações potencialmente prejudiciais com base apenas na interpretação de uma entrada, sem qualquer interação com o usuário.
9. Dependência excessiva
A confiança excessiva é um tema central e trata da tendência de nós, usuários de LLMs, presumirmos que eles estão sempre certos, são adequados, seguros, legais, morais e éticos. O fato é que códigos gerados por LLMs podem introduzir vulnerabilidades de segurança. Cientistas da computação da Universidade Stanford publicaram um estudo que mostra que ferramentas de IA como o GitHub Copilot produzem códigos menos seguros do que os criados por pessoas desenvolvedoras sem essas ferramentas.
É fundamental tratar o código gerado por LLMs da mesma forma que tratamos nosso próprio código. Devemos fazer revisões de código, executar testes de segurança automatizados nas alterações e garantir que elas não reduzam nosso nível de segurança.
O Snyk Code usa IA simbólica, que entende o contexto do código criado por ferramentas de geração de código com IA, para identificar se novas vulnerabilidades estão sendo introduzidas. Testar o código regularmente com a Snyk mantém um nível consistente de segurança à medida que ele é entregue — seja gerado por IA ou por pessoas desenvolvedoras — ao longo do pipeline de CI/CD, independentemente do aumento no volume de entregas que a geração de código por IA traz ao processo de implantação de aplicativos.
Além da geração e da segurança do código, há outros aspectos mencionados pela OWASP, como desinformação e informações enganosas, além de alucinações que podem levar à referência a bibliotecas ou pacotes de código inexistentes ou, pior ainda, maliciosos. Use o Snyk Open Source para fazer testes de SCA no seu IDE, onde você gera o código, e identificar e corrigir casos em que pacotes vulneráveis ou maliciosos são adicionados sem que você perceba.
Comece a participar de desafios de Capture the Flag
Aprenda a resolver desafios de Capture the Flag assistindo sob demanda ao nosso workshop virtual introdutório.
10. Roubo de modelo
Por fim, chegamos ao número 10: o roubo de modelo, que é exatamente o que o nome sugere! Um invasor tenta obter acesso não autorizado a um LLM, seja por meio de roubo físico, cópia ou vazamento — como aconteceu quando o modelo LLaMA da Meta vazou no 4chan, pouco depois de ser anunciado. E assim por diante. Treinar e ajustar um LLM de qualidade é uma tarefa difícil, que muitas vezes exige um orçamento considerável, recursos e inteligência. Embora possamos imaginar alguém entrando pela janela com um pen drive para roubar nosso modelo, o ataque pode vir mais facilmente de uma pessoa funcionária insatisfeita que percebe o valor de levar o modelo consigo.
As práticas recomendadas de segurança digital já conhecidas, como controles de RBAC, devem ser implementadas para proteger sua propriedade intelectual contra pessoas mal-intencionadas.
Para concluir
Estamos em um mundo novo e corajoso, aprimorado pela IA, e esperamos que este guia ajude você a explorá-lo com segurança. Não deixe de baixar a versão em formato de guia rápido deste artigo para consultar sempre que precisar. Crie sua conta gratuita na Snyk para integrar a segurança diretamente às suas práticas de desenvolvimento ou agende uma demonstração ao vivo personalizada para suas necessidades e seu caso de uso.