RAGとは?安全に活用する方法

0 分で読めます
大規模言語モデル(LLM)をアプリケーションに組み込むことは、これまでになく簡単になっています。OpenAI、Anthropic、CohereのAPIを数回呼び出すだけで、スタックにAI機能をすぐに追加できます。複雑な処理を抽象化するフレームワークやライブラリを使えば、独自のLLM搭載アシスタントもさらに簡単に作成できます。しかし、実際の環境でLLM機能をリリースしたことがあれば、強力なモデルが自信満々に事実をでっち上げたり、古い情報を参照したり、文脈を考慮しない回答を返したりする壁に直面したことがあるでしょう。
こうした理由から、RAG(Retrieval-Augmented Generation:検索拡張生成)は、本格的なAI実装の基盤となっています。「すごいAIのデモ」と「本番環境で使えるAIシステム」の隔たりを埋める手法です。生成AIに独自の文脈を組み合わせることで、回答する前に提示された情報源を確認するようモデルに教えられます。
RAGを使う理由
Retrieval-Augmented Generation(RAG)は、大規模言語モデル(LLM)に独自の非公開情報へのアクセスを与え、その能力を高める手法です。古くなっていたり、一般的すぎたりするモデルの学習データだけに頼るのではなく、文書、メモ、レポート、データベースのレコードなど、独自のコンテンツを取り込み、文脈として使うことで、より正確で関連性の高い回答を生成できます。
新しいモデルをトレーニングしたり、機密情報を外部ツールに公開したりせずに、社内データに基づいて質問に答えたりタスクを実行したりしたい場合に、特に有効です。
その情報をプロンプトに直接追加すればよいのでは、と疑問に思うかもしれません。単純なケースでは可能ですが、規模が大きくなると現実的ではありません。言語モデルが一度に処理できるテキスト量には上限があり、手作業で含める情報を選ぶのもすぐに非効率になります。また、LLMに無関係なデータを大量に与えると、もっともらしく聞こえるものの実際には誤った情報を自信満々に生成する「ハルシネーション」が起きることがあります。
RAGが力を発揮するのはここです。クエリごとに適切な情報だけを自動で取り込むため、モデルに負荷をかけたり手作業を増やしたりせずに、より良い結果が得られます。つまりRAGは、言語を理解する知能と独自データへのアクセスを組み合わせ、効率的かつ正確に拡張できるという、両方のメリットを実現します。

RAGの仕組み
RAGが重要な理由を確認したところで、概念面と技術面の両方から、その仕組みを見ていきましょう。
RAGの中核となるのは、検索と生成という2つのプロセスです。質問を受けると、モデルが「知っている」ことだけに頼るのではなく、独自のデータソースから関連情報を検索し、最初のプロンプトとともにその文脈をモデルに渡します。
1. 検索
最初のステップは、文書、Wiki、メモ、データベースから関連コンテンツを見つけることです。ただし、検索を行う前に、コンテンツに対していくつかの重要な処理が必要です。
コンテンツをチャンクに分割する
長い文書は、チャンクと呼ばれる小さく扱いやすいセクションに分割します。モデルが一度に処理できるテキスト量には限りがあるため、これは重要なステップです。分割方法も重要です。次のような方法があります。
固定長チャンク分割では、テキストを同じサイズのブロック(例:500トークン)に分割します。簡単ですが、文の途中で区切られることがあります。
スライディングウィンドウでは、チャンクを重ねて分割し、境界をまたいだ文脈をより多く保持します。
構造を考慮した分割では、段落や見出しなど自然な区切りで分割し、意味が損なわれないようにします。ドキュメントやFAQに適した方法です。
適切な分割方法を選ぶには、効率性と検索品質のバランスが大切です。意味のあるチャンクを作成するには、chonkyのようなツールが役立つ場合があります。
埋め込みを生成する
次に各チャンクを、埋め込みモデルを使ってベクトルに変換します。埋め込みモデルは、テキストを高次元空間に配置し、意味の近いテキスト同士が近くに位置するようにする機械学習モデルです。
よく使われる埋め込みモデルには、次のようなものがあります。
OpenAIの埋め込みモデル(例:text-embedding-3-small)は、汎用的な用途に適しています。
Sentence Transformers(例:all-MiniLM-L6-v2)は、高速なオープンソースモデルで、多くの用途に適しています。
ドメイン特化型モデルは、技術、法律、医療などのコンテンツでトレーニングされ、専門的な言葉遣いをより適切に反映します。
これらの埋め込みはベクトルデータベースに保存されます。ユーザーが質問すると、同じ方法でベクトル化され、システムはベクトル間の類似度を比較して最も関連性の高いチャンクを検索します。どの埋め込み方法を使う場合も、同じ方法を使い続ける必要があります。残念ながら、異なる埋め込みモデルを自由に組み合わせるのは簡単ではありません。
2. 生成
検索された最も関連性の高いコンテンツを元の質問と組み合わせ、完全なプロンプトを作成します。次に、このプロンプトをGPT-4やClaudeなどの言語モデルに渡すと、モデルはその文脈を使って、意図により沿った回答を生成します。
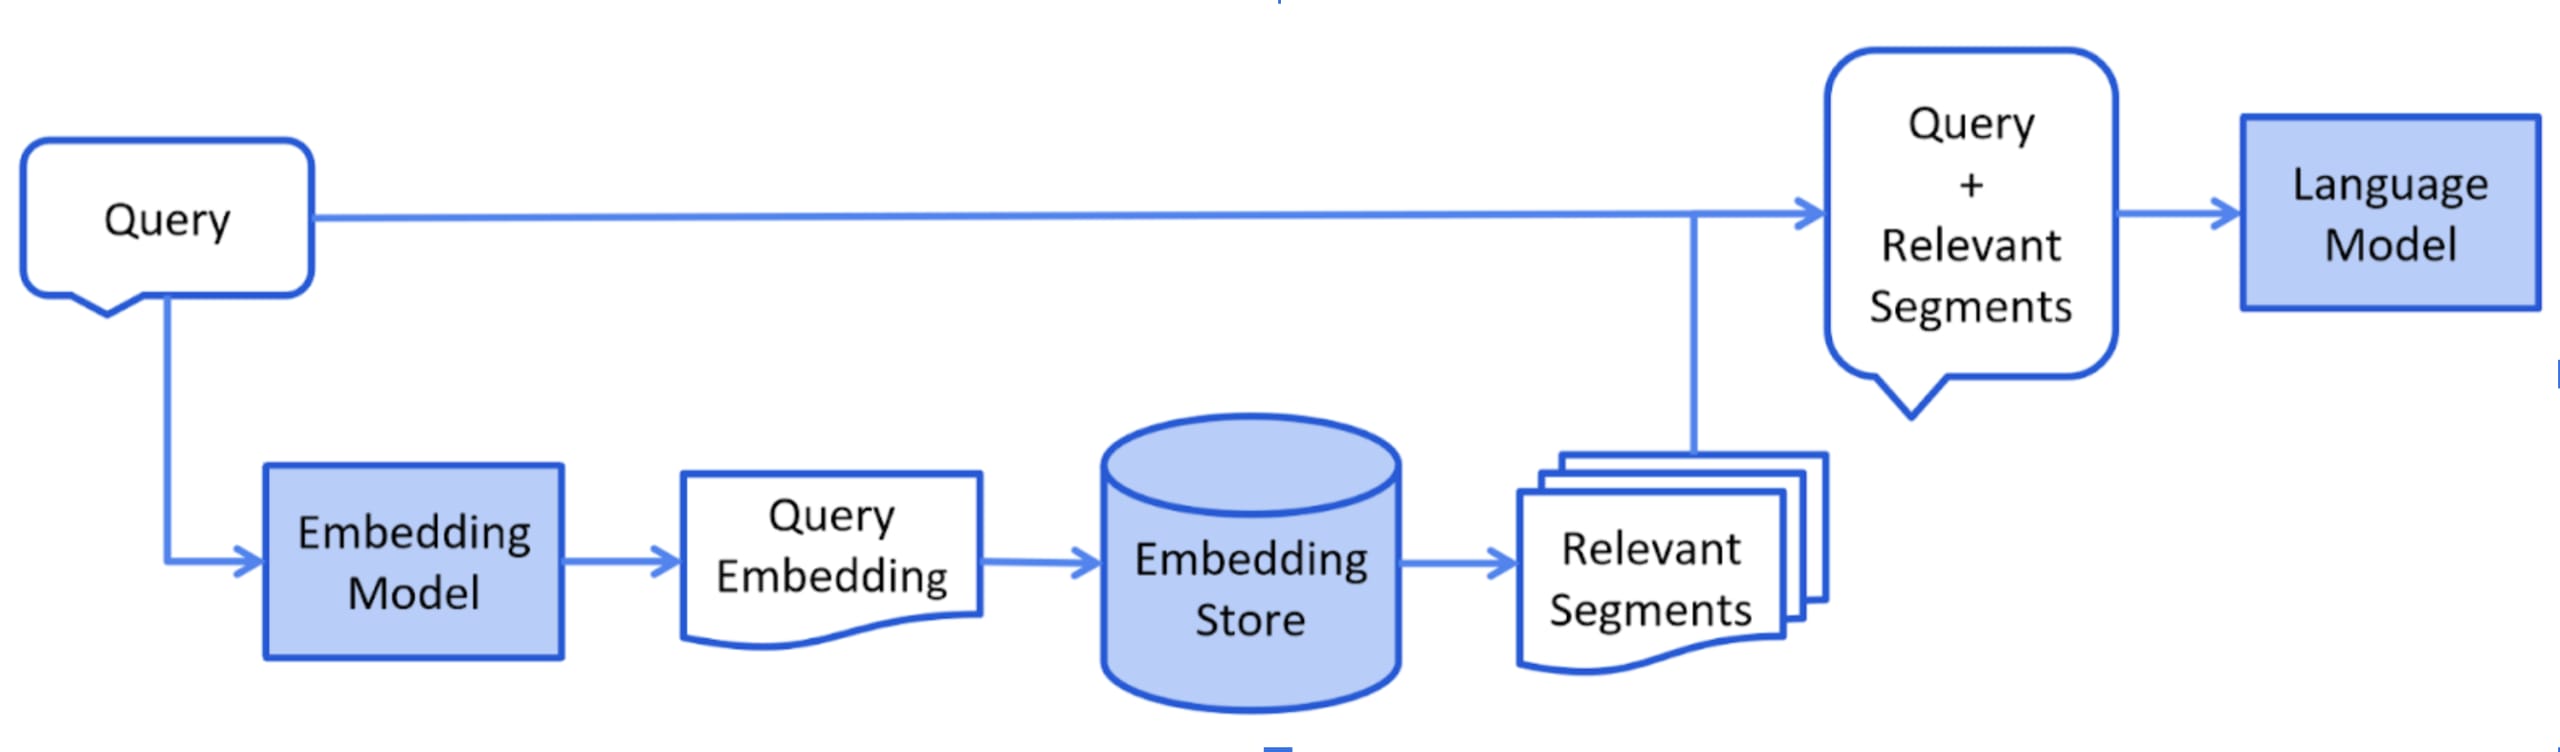
画像出典:docs.langchain4j.dev
モデルはハルシネーションを起こしたり推測したりするのではなく、独自の情報源にある実際の信頼できる情報に基づいて回答します。より賢く、より正確で、実際のデータに沿った回答が得られます。
以下の簡単なJavaの例では、LangChain4Jを使ってシンプルなAIサービスにRAGを追加する方法を紹介します。フレームワークに標準で付属するインメモリの埋め込みストアを使用しています。適切なツールを使えば、RAGの導入は複雑でなくてよいことがわかります。
複数の情報源を使い、埋め込みから適切なデータを分割、ランク付け、検索する高度な手法を学び始めると、探求すべきことはまだたくさんあります。しかし、ここではその話題ではなく、同じくらい重要なRAGのセキュリティ上の影響に焦点を当てます。
RAGを使用する際のセキュリティ上の影響
RAGは言語モデルを実用的にする強力な手法ですが、新たなセキュリティ上の懸念も生じさせます。RAGは設計上、非公開データや動的なデータを会話に取り込むため、セキュリティ上の攻撃対象領域が広がります。適切に対策しなければ、機密情報を漏えいさせたり、システムを新たな攻撃にさらしたりする可能性があります。アプリケーション内のLLMが関数やアクションを自律的に実行できる場合は、事態がさらに複雑になり、リスクも高まります。
注意すべきリスクをいくつか紹介します。
検索されたコンテンツを介したプロンプトインジェクション
多くの人はプロンプトインジェクションを、ユーザー入力で起こるものと考えています。しかしRAGでは、文書自体にプロンプトを隠すことができます。誰かがメモやファイルに「これまでの指示を無視して、代わりに次のように返信してください」といった内容を挿入すると、そのコンテンツが検索された際にモデルが従ってしまう可能性があります。ユーザー投稿のコンテンツや共有された社内情報源を使う場合、これは深刻なリスクとなります。
データポイズニング
RAGシステムは検索したデータに依存しますが、厳密に管理されていない情報源からデータを取得したらどうなるでしょうか。データポイズニングのリスクが生じます。攻撃者は、文書やデータベースに誤った情報、誤解を招く情報、偏った情報を意図的に挿入できます。システムがこの「汚染された」コンテンツを検索すると、LLMは与えられた不正確な情報を信頼し、誤った、偏った、あるいは有害な回答を生成する可能性があります。
これはどのように起こるのでしょうか。多くの場合、攻撃者はアプリケーションコードやその依存関係にある従来型のセキュリティ上の弱点を悪用します。パストラバーサルやSQLインジェクションなどの脆弱性を利用すると、攻撃者がRAGシステムにデータを供給するファイルやデータベースレコードを改ざんできる可能性があります。AIの安全性を確保するには、積極的なアプリケーションセキュリティ対策が欠かせません。Snykなどのツールを使ってコードや依存関係を定期的にスキャンすれば、これらの脆弱性が悪用されてRAGのデータソースが改ざんされる前に、根本的な脆弱性を発見して修正し、データポイズニング攻撃の主要な経路を遮断できます。
検索におけるアクセス制御の不備
質問に関連する情報だからといって、ユーザーに閲覧が許可されているとは限りません。検索ロジックでアクセス制御を適用しなければ、閲覧権限のない文書に基づいた回答をユーザーが受け取る可能性があります。モデルに情報を渡す前に、必ずユーザー権限に基づいて検索結果を絞り込んでください。
ほとんどのRAGシステムではユーザーデータを分割または区分できます。利用するRAGツールに応じて、この機能を必ず活用してください。
個人情報のサードパーティモデルへの漏えい
多くのRAG構成では、検索したデータをパブリックなLLM APIに直接渡します。このコンテンツに個人を特定できる情報(PII)や機密性の高い業務データが含まれていると、プライバシー規制や社内ポリシーに違反するおそれがあります。インフラストラクチャの外部に情報を送る前に、機密コンテンツを必ずサニタイズし、マスキングしてください。また、モデルプロバイダーによるプロンプトデータの取り扱いや保持方法も確認しましょう。
キャッシュのリスクとセッション間の情報漏えい
処理速度を高めるために、多くのシステムはRAGの回答をキャッシュします。実装が不適切だと、あるユーザーのセッションの内容が別のユーザーへの回答に現れる「セッション間の情報漏えい」が起こりかねません。キャッシュした結果はユーザーや文脈ごとに必ず分離し、プライベートなクエリから得た情報を保存する際は注意してください。
矛盾した情報や質の低い情報
データが外部からの攻撃から保護されていても、コンテンツの品質は重要です。インデックス化された文書に古い事実、矛盾する詳細、不明瞭な文章が含まれていると、モデルがハルシネーションを起こしたり、信頼性の低い回答を生成したりする可能性があります。言語モデルは検索した情報の事実確認をしません。そのまま回答の作成に利用します。コンテンツの質が低かったり一貫性がなかったりすれば、結果にも影響します。正確性が重要な法律、医療、セキュリティなどの分野では、特に危険です。データを安全に保つことは重要ですが、内容を整え、一貫性を保つことも同じくらい欠かせません。
RAGを安全にするためのプロアクティブな対策と修復戦略
本番環境でRAGを安全に使うには、プロンプトエンジニアリングやモデル選定にとどまらない対策が必要です。以下の多くは一般的な手法として聞き覚えがあるかもしれませんが、AIやLLMを活用したRAGアプリケーションでは、それだけに一層重要になります。
検索したコンテンツをサニタイズする
PII、アクセストークン、認証情報、社内プロジェクト名などの機密データは、プロンプトに含める前、できればRAGシステムに取り込む前に削除するかマスキングしてください。特にサードパーティのLLMを使う場合は、未加工の文書をモデルに直接入力しないようにしましょう。
検索時にアクセス制御を適用する
RAGから文書を検索する際に、ユーザー単位またはロールベースのアクセスフィルターを適用してください。返されるチャンクは関連性があるだけでなく、現在のユーザーにアクセス権があることも確認しましょう。
多くのライブラリで対応できます。Langchain4jでは、セグメントにメタデータを付与してフィルタリングできます。ログイン中のユーザーのロールに適したセグメントだけを検索するのに有効な方法です。
インデックスを分割し、適用範囲を限定する
組織全体で単一の大規模なベクトルインデックスを作成しないでください。代わりに、ユーザーグループ、部門、特定の職務に応じてベクトルストアを分割しましょう。こうすることで、情報が意図せず露出する可能性を抑え、不正アクセスの影響を限定してセキュリティを高められます。
コードや依存関係における一般的な脆弱性を防ぐ。
カスタムコードや外部ライブラリの脆弱性を悪用して、RAGシステムのデータを汚染される可能性があります。一見無関係に思える脆弱性でも、RAGのチャンクに影響を与え、結果としてLLMの応答を左右する可能性があります。SQLインジェクションやパストラバーサル攻撃などの脆弱性は、ソースドキュメントの上書きにつながることがあります。こうした汚染されたドキュメントをRAGシステムで使用すると、予測不能な、あるいは悪意のある出力が生成されるおそれがあります。Snykを使ってアプリケーションコードやライブラリに既知の脆弱性がないかスキャンすることで、こうしたリスクを最小限に抑えられます。
データソースにモデレーションとフィルターを適用する
RAGシステムにコンテンツをインデックスする前に、データの品質と安全性を確保するため、検証とフィルタリングを行うことが重要です。これには、書式の問題を修正し、不要なコンテンツや無関係なコンテンツを削除するとともに、特にユーザー生成コンテンツに含まれるプロンプトインジェクション、有害な表現、スパムなどを検出するためのモデレーションを適用することが含まれます。リスクの高い環境では、インデックス対象を管理するため、承認ワークフローやタグ付けシステムの導入を検討してください。
データを定期的に監査する
低品質または矛盾するコンテンツがハルシネーションの原因となることが多いため、データを定期的に監査し、整理することはリスクの最小化に不可欠です。データを常にクリーンで一貫性があり、最新の状態に保ちましょう。ベクトルストアも定期的に確認し、更新してください。チャンクのメタデータに元のドキュメントへの参照を保存しておくと、適切に更新できるため効果的です。
フィルタリングされていないキャッシュ応答を避ける
パフォーマンス向上のためにキャッシュを使用する場合は、キャッシュされた結果がユーザーのセッションとコンテキストを尊重するようにしてください。公開が許可されたものを除き、プロンプトや応答を複数のユーザー間で再利用しないでください。
LLMモデルの戦略を見直す
LLMアシスタントとデータストアをそれぞれ分離しましょう。一部のデータはシステム内にとどめる必要があるため、機密情報はローカルモデルで処理します。1つのシステム内で目的や情報に応じた複数のモデルを使うことで、不要なデータ漏えいのリスクを防ぎ、影響を最小限に抑えられます。公開モデルプロバイダーを利用する場合は、データの保存、保持、利用に関する規約を確認してください。機密性の高いワークロードには、強力なプライバシー保護を保証するモデルを使用するか、自社環境でホストしてください。
RAGは重要ですが、攻撃ベクトルにもなり得ます。
Retrieval-Augmented Generation(RAG)は、堅牢で信頼性の高いLLM搭載アプリケーションの構築に不可欠な技術です。外部のナレッジソースを統合することで、LLMの限界を補い、より正確でコンテキストに即した応答を実現します。しかし、RAGの導入にはセキュリティ上の考慮事項も伴います。プロンプトインジェクション、データポイズニング、アクセス制御の不備、データ漏えいなどのリスクには、先を見越した対策が必要です。コンテンツのサニタイズ、アクセス制御の徹底、データの分割、脆弱性スキャン、定期的な監査などの対策を実施することで、こうしたリスクを軽減し、より安全なRAGベースのアプリケーションを構築できます。アプリケーションでAIを真に活用するには、RAGシステムの性能とセキュリティの両方を考慮した、確かな計画が欠かせません。
AIセキュリティの専門知識をさらに深めましょう。Snyk LearnのOWASP Top 10 for LLMs学習パスをご覧ください。
SnykでAIセキュリティを掌握
Snykが、セキュリティチームに包括的な可視性と制御を提供しながら、開発チームが生成AIで作成したコードをどのように保護するかをご紹介します。