Recursos avançados do depurador do IntelliJ que você ainda não conhece

30 de janeiro de 2023
0 minutos de leituraRecentemente, terminei de escrever meu livro sobre depuração e um curso de depuração. Por isso, recebo muitas perguntas sobre meus recursos favoritos de depuração. Depurar vai muito além do depurador da IDE. Na verdade, apenas o primeiro capítulo do livro aborda esse aspecto. Mas, quando pensamos em depuração, nossa mente logo vai para a IDE. Ainda assim, há muitos detalhes a descobrir dentro dessas ferramentas incríveis.
A principal razão para isso é simples: nunca aprendemos a depurar. Não dá para testar conhecimentos de depuração, então as universidades não ensinam essa prática.
Aprendemos no trabalho, conforme avançamos, o que é péssimo. Não é de se surpreender que alguns desenvolvedores tratem a depuração como tirar o lixo: prendem a respiração e correm até a porta para se livrar dele. Depurar é muito mais do que a soma de suas partes, e os depuradores são ferramentas fantásticas que nos ajudam a entender nosso trabalho em profundidade. Eles revelam o funcionamento interno da aplicação sob uma nova perspectiva e nos oferecem um nível de compreensão que nenhuma outra prática proporciona.
Neste post, vamos apresentar três recursos do depurador que, nas minhas palestras sobre o assunto, conquistaram o público. Embora todos devam funcionar na maioria das IDEs da JetBrains, infelizmente nenhum dos três está disponível no VS Code. Acredito que essa tenha sido uma escolha consciente de experiência do usuário por parte da equipe do VS Code, para simplificar o ambiente — uma decisão que espero que reconsiderem.
Três recursos de depuração do IntelliJ:
Configuração de depuração com objetos marcadores
Renderizadores de entradas
Monitoramento de memória
Configuração de depuração do IntelliJ com objetos marcadores
Um dos maiores desafios durante a depuração é acompanhar o que você está fazendo. Paramos em um breakpoint e vemos um objeto. É o mesmo que vimos antes? Ele tem a mesma referência, os mesmos valores, a mesma identidade e o mesmo endereço de ponteiro?
Eu costumava anotar endereços de ponteiros em um pedaço de papel para acompanhar o que já tinha visto e confirmar que não era um endereço novo. É frustrante e confuso. Nem consigo ler minha própria letra… Deve haver um jeito melhor, não?
E há. Ao inspecionar um objeto no depurador, em vez de anotar o valor, podemos marcá-lo pelo menu de contexto.
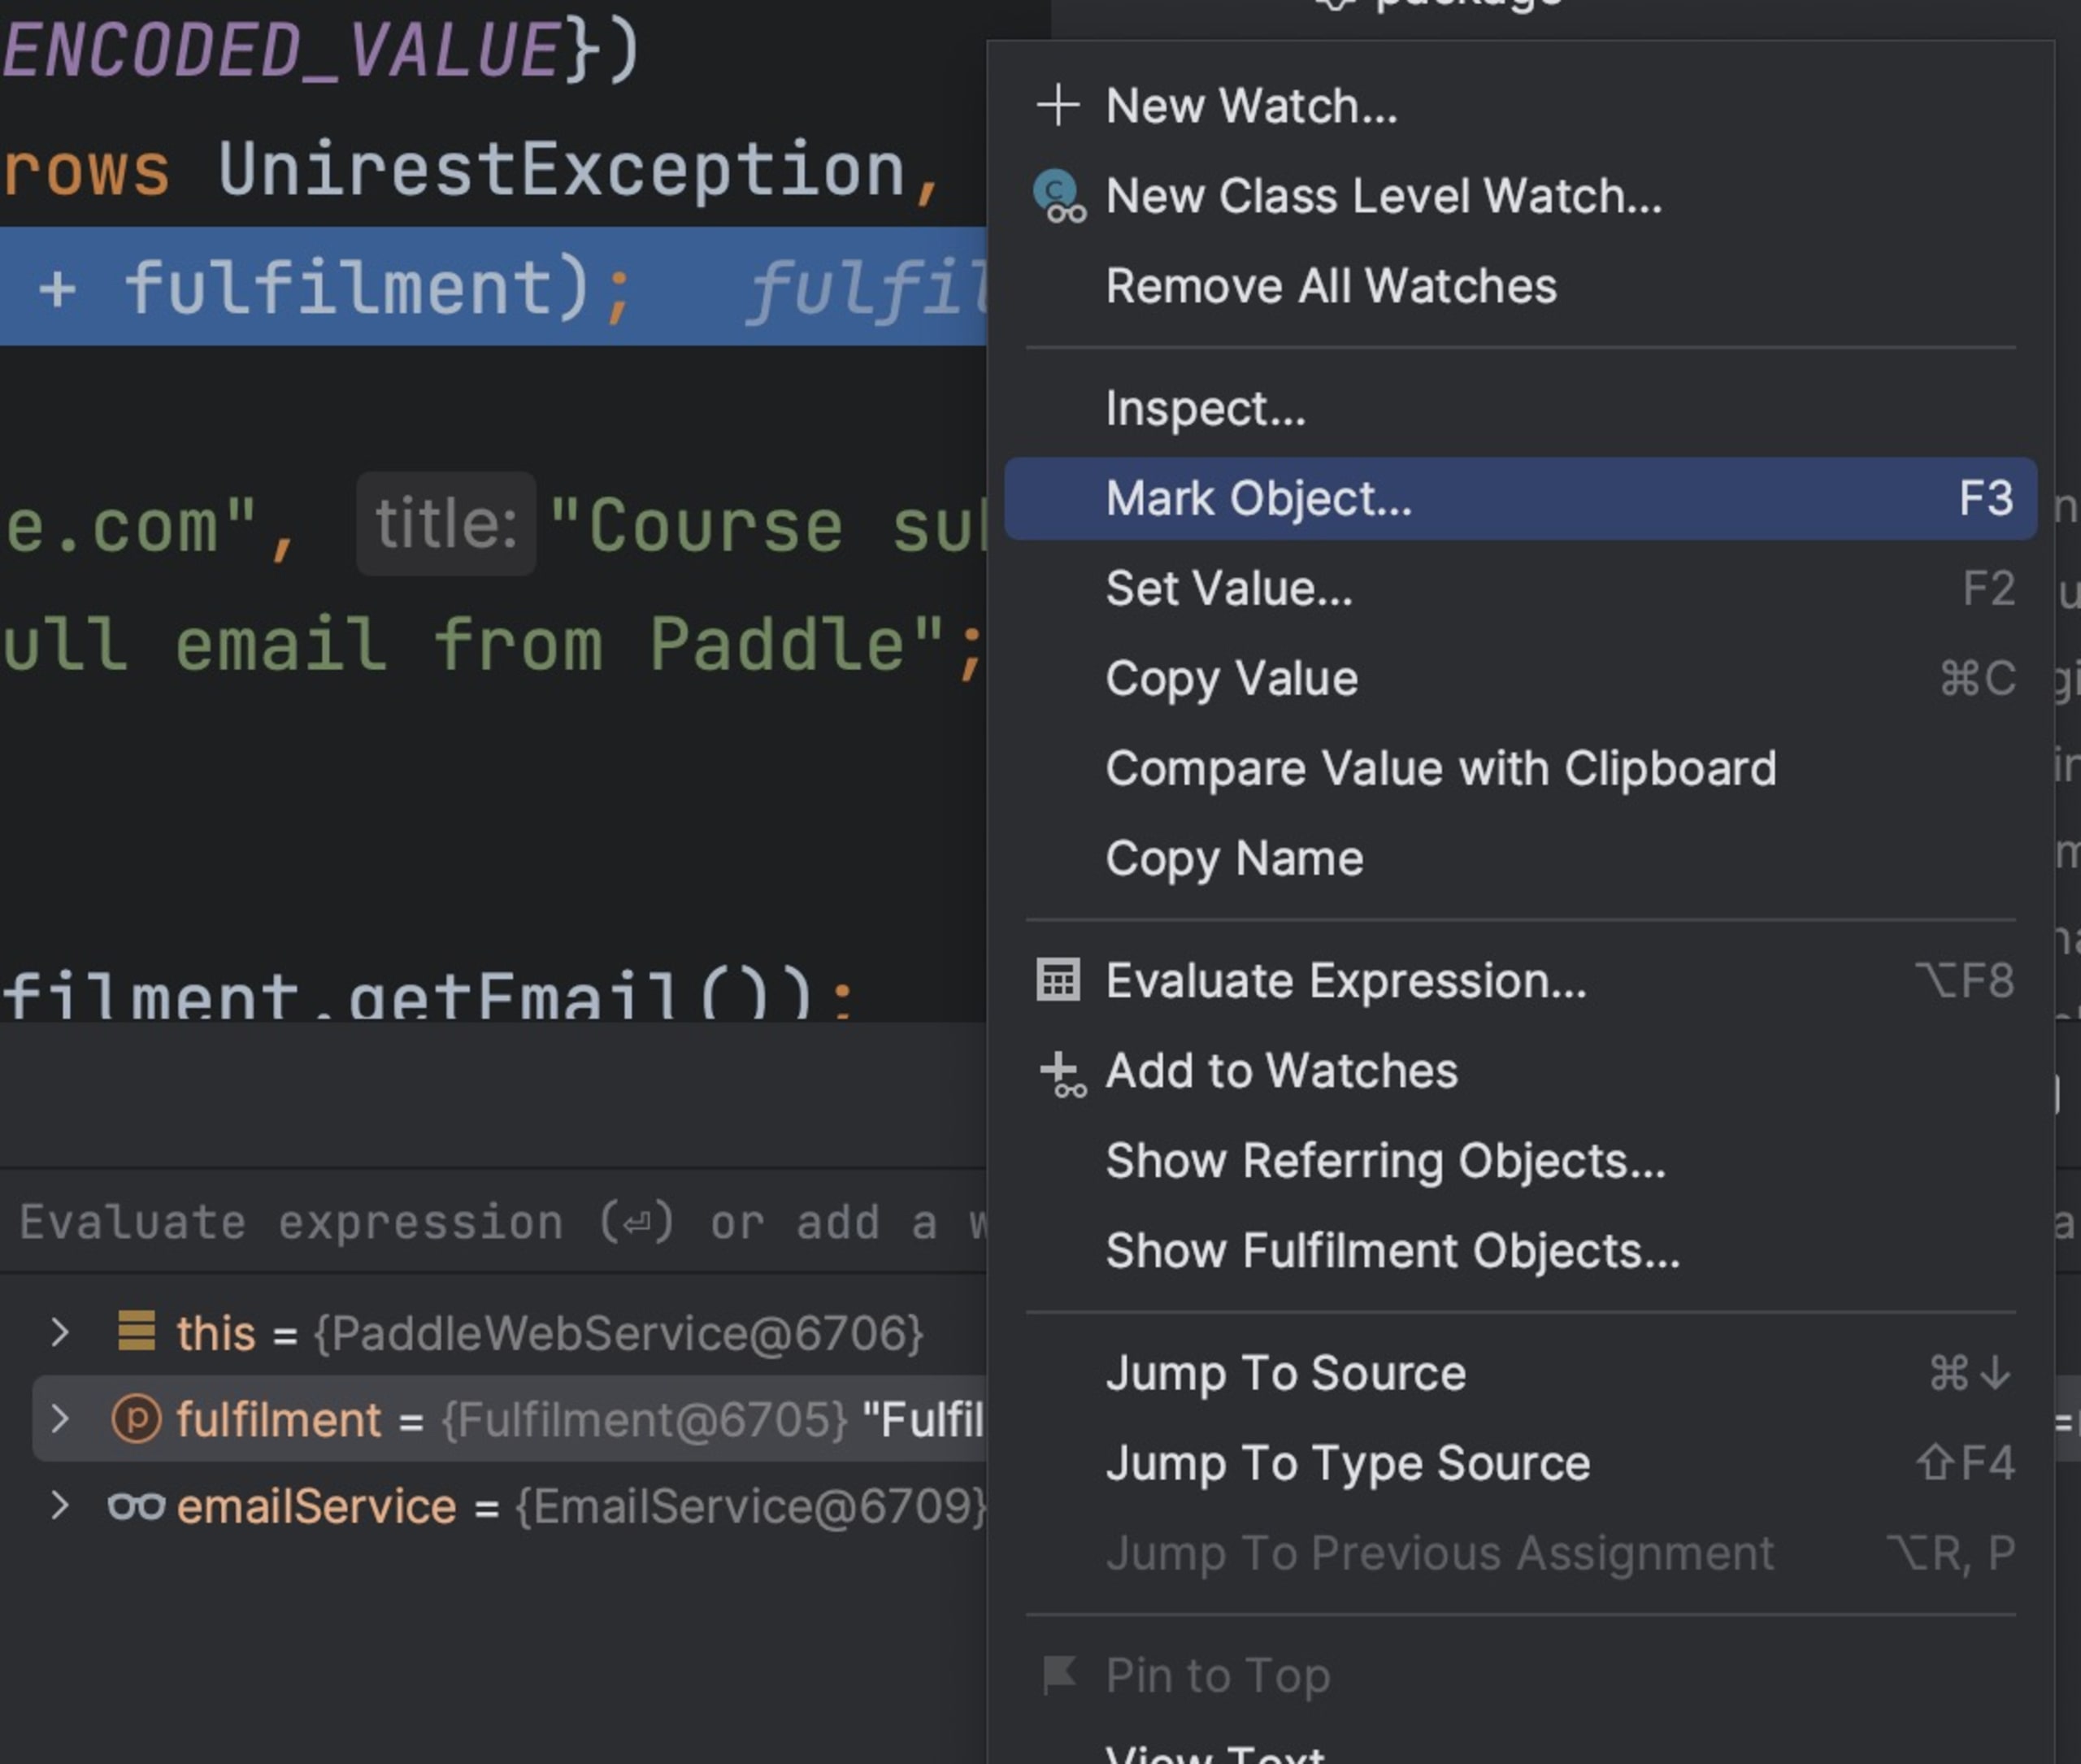
Depois de selecionar essa opção, somos convidados a dar um nome ao objeto. Essa caixa de diálogo é confusa. Você pode presumir, por engano, que isso é apenas um alias para a entrada de observação. Não é.
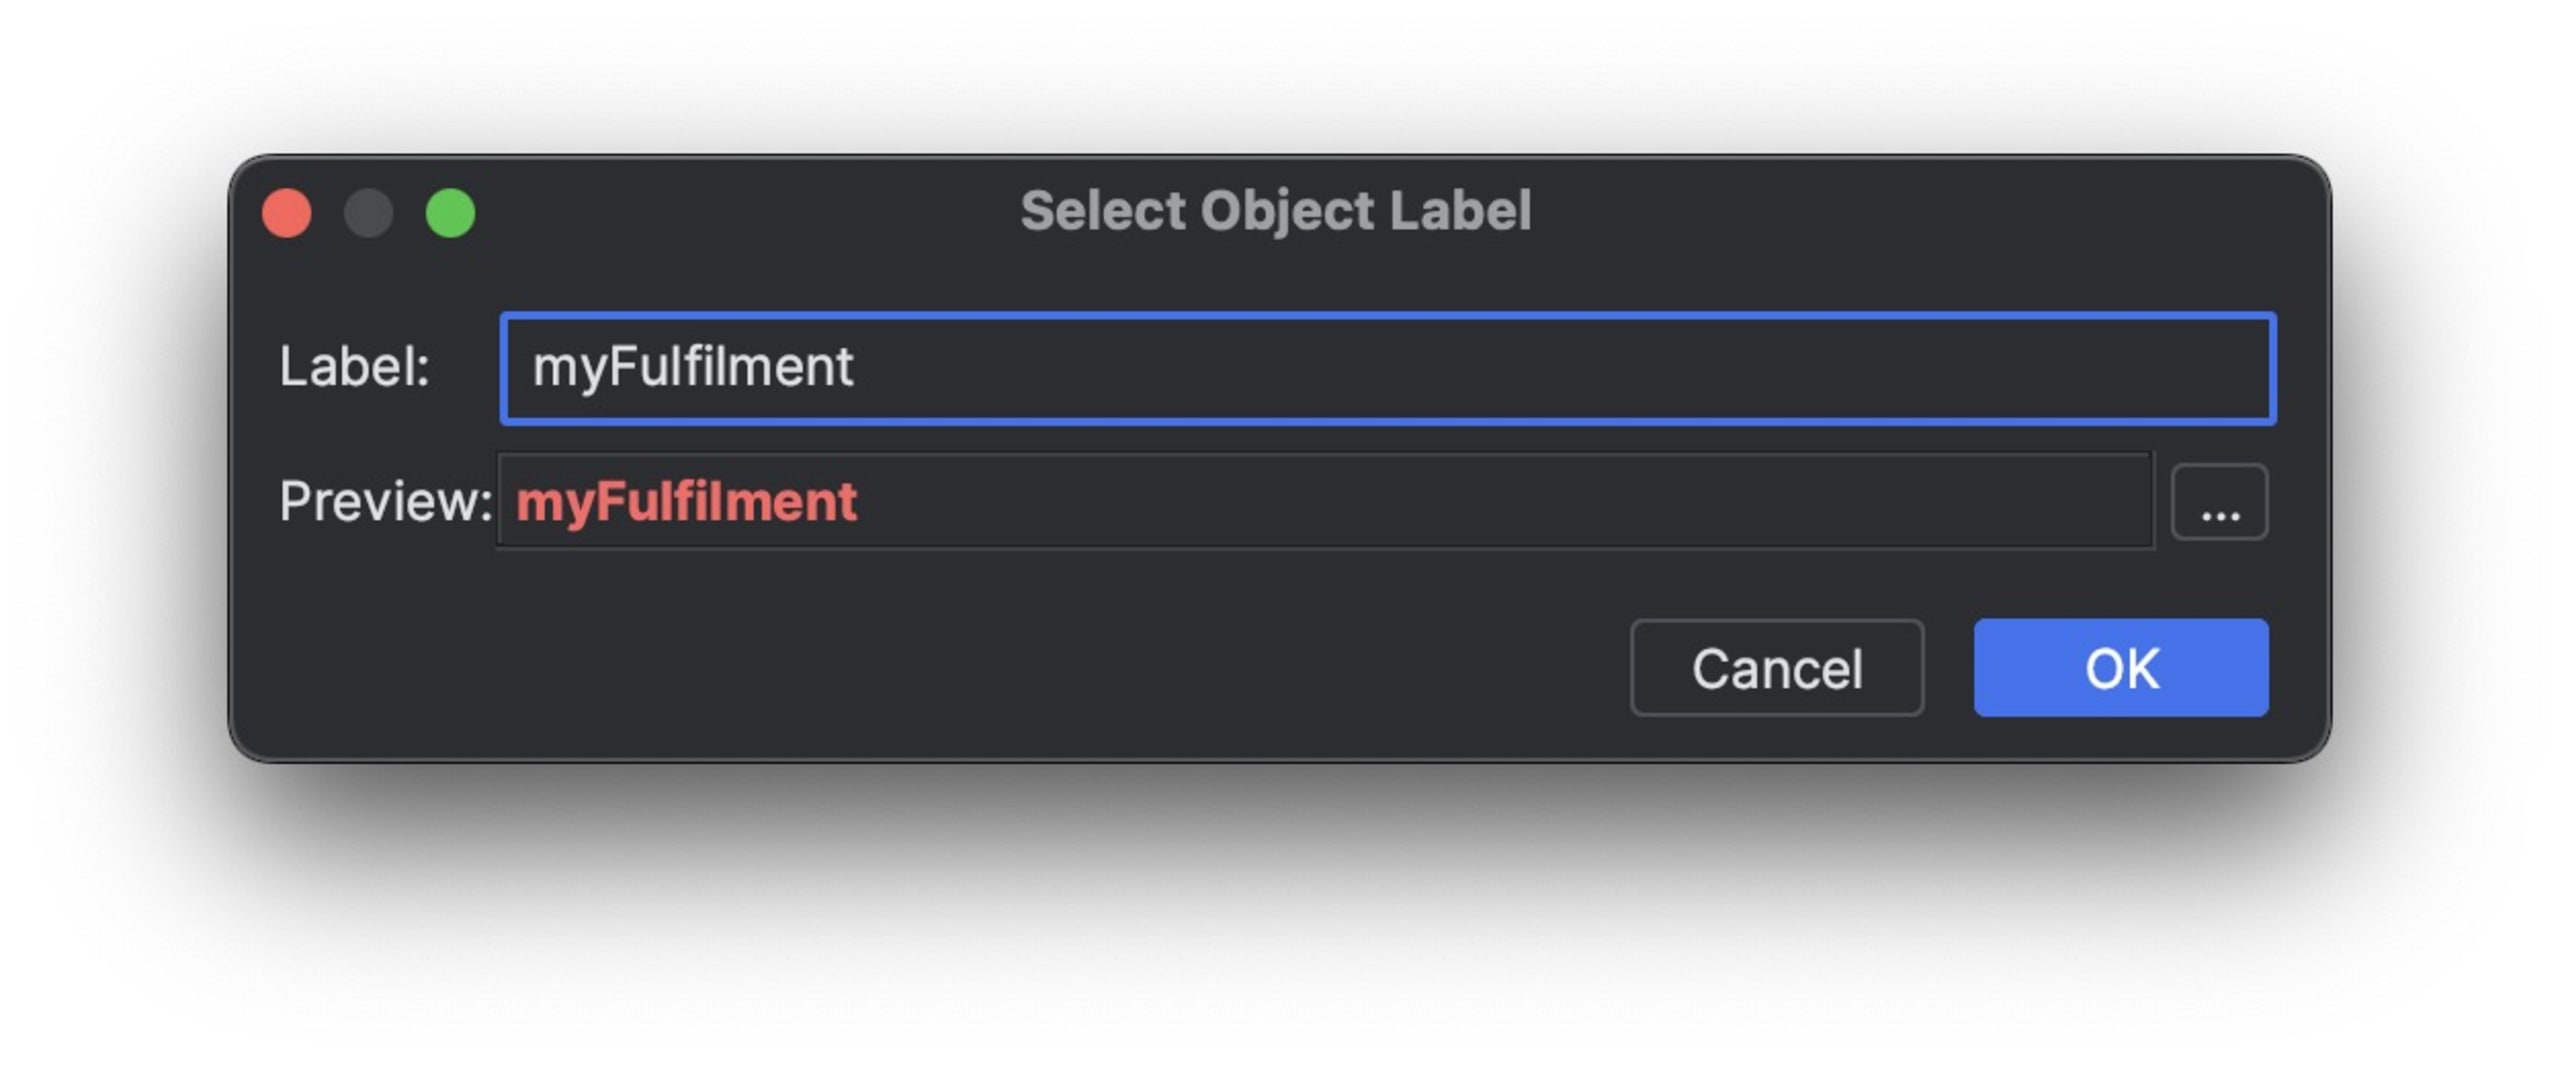
O que estamos fazendo aqui é definir uma nova variável global. Podemos inspecionar o valor na área de observação, independentemente do escopo (o que já é ótimo), e também usá-lo em instruções condicionais, para que o breakpoint só seja acionado se o valor mudar — como vemos aqui.
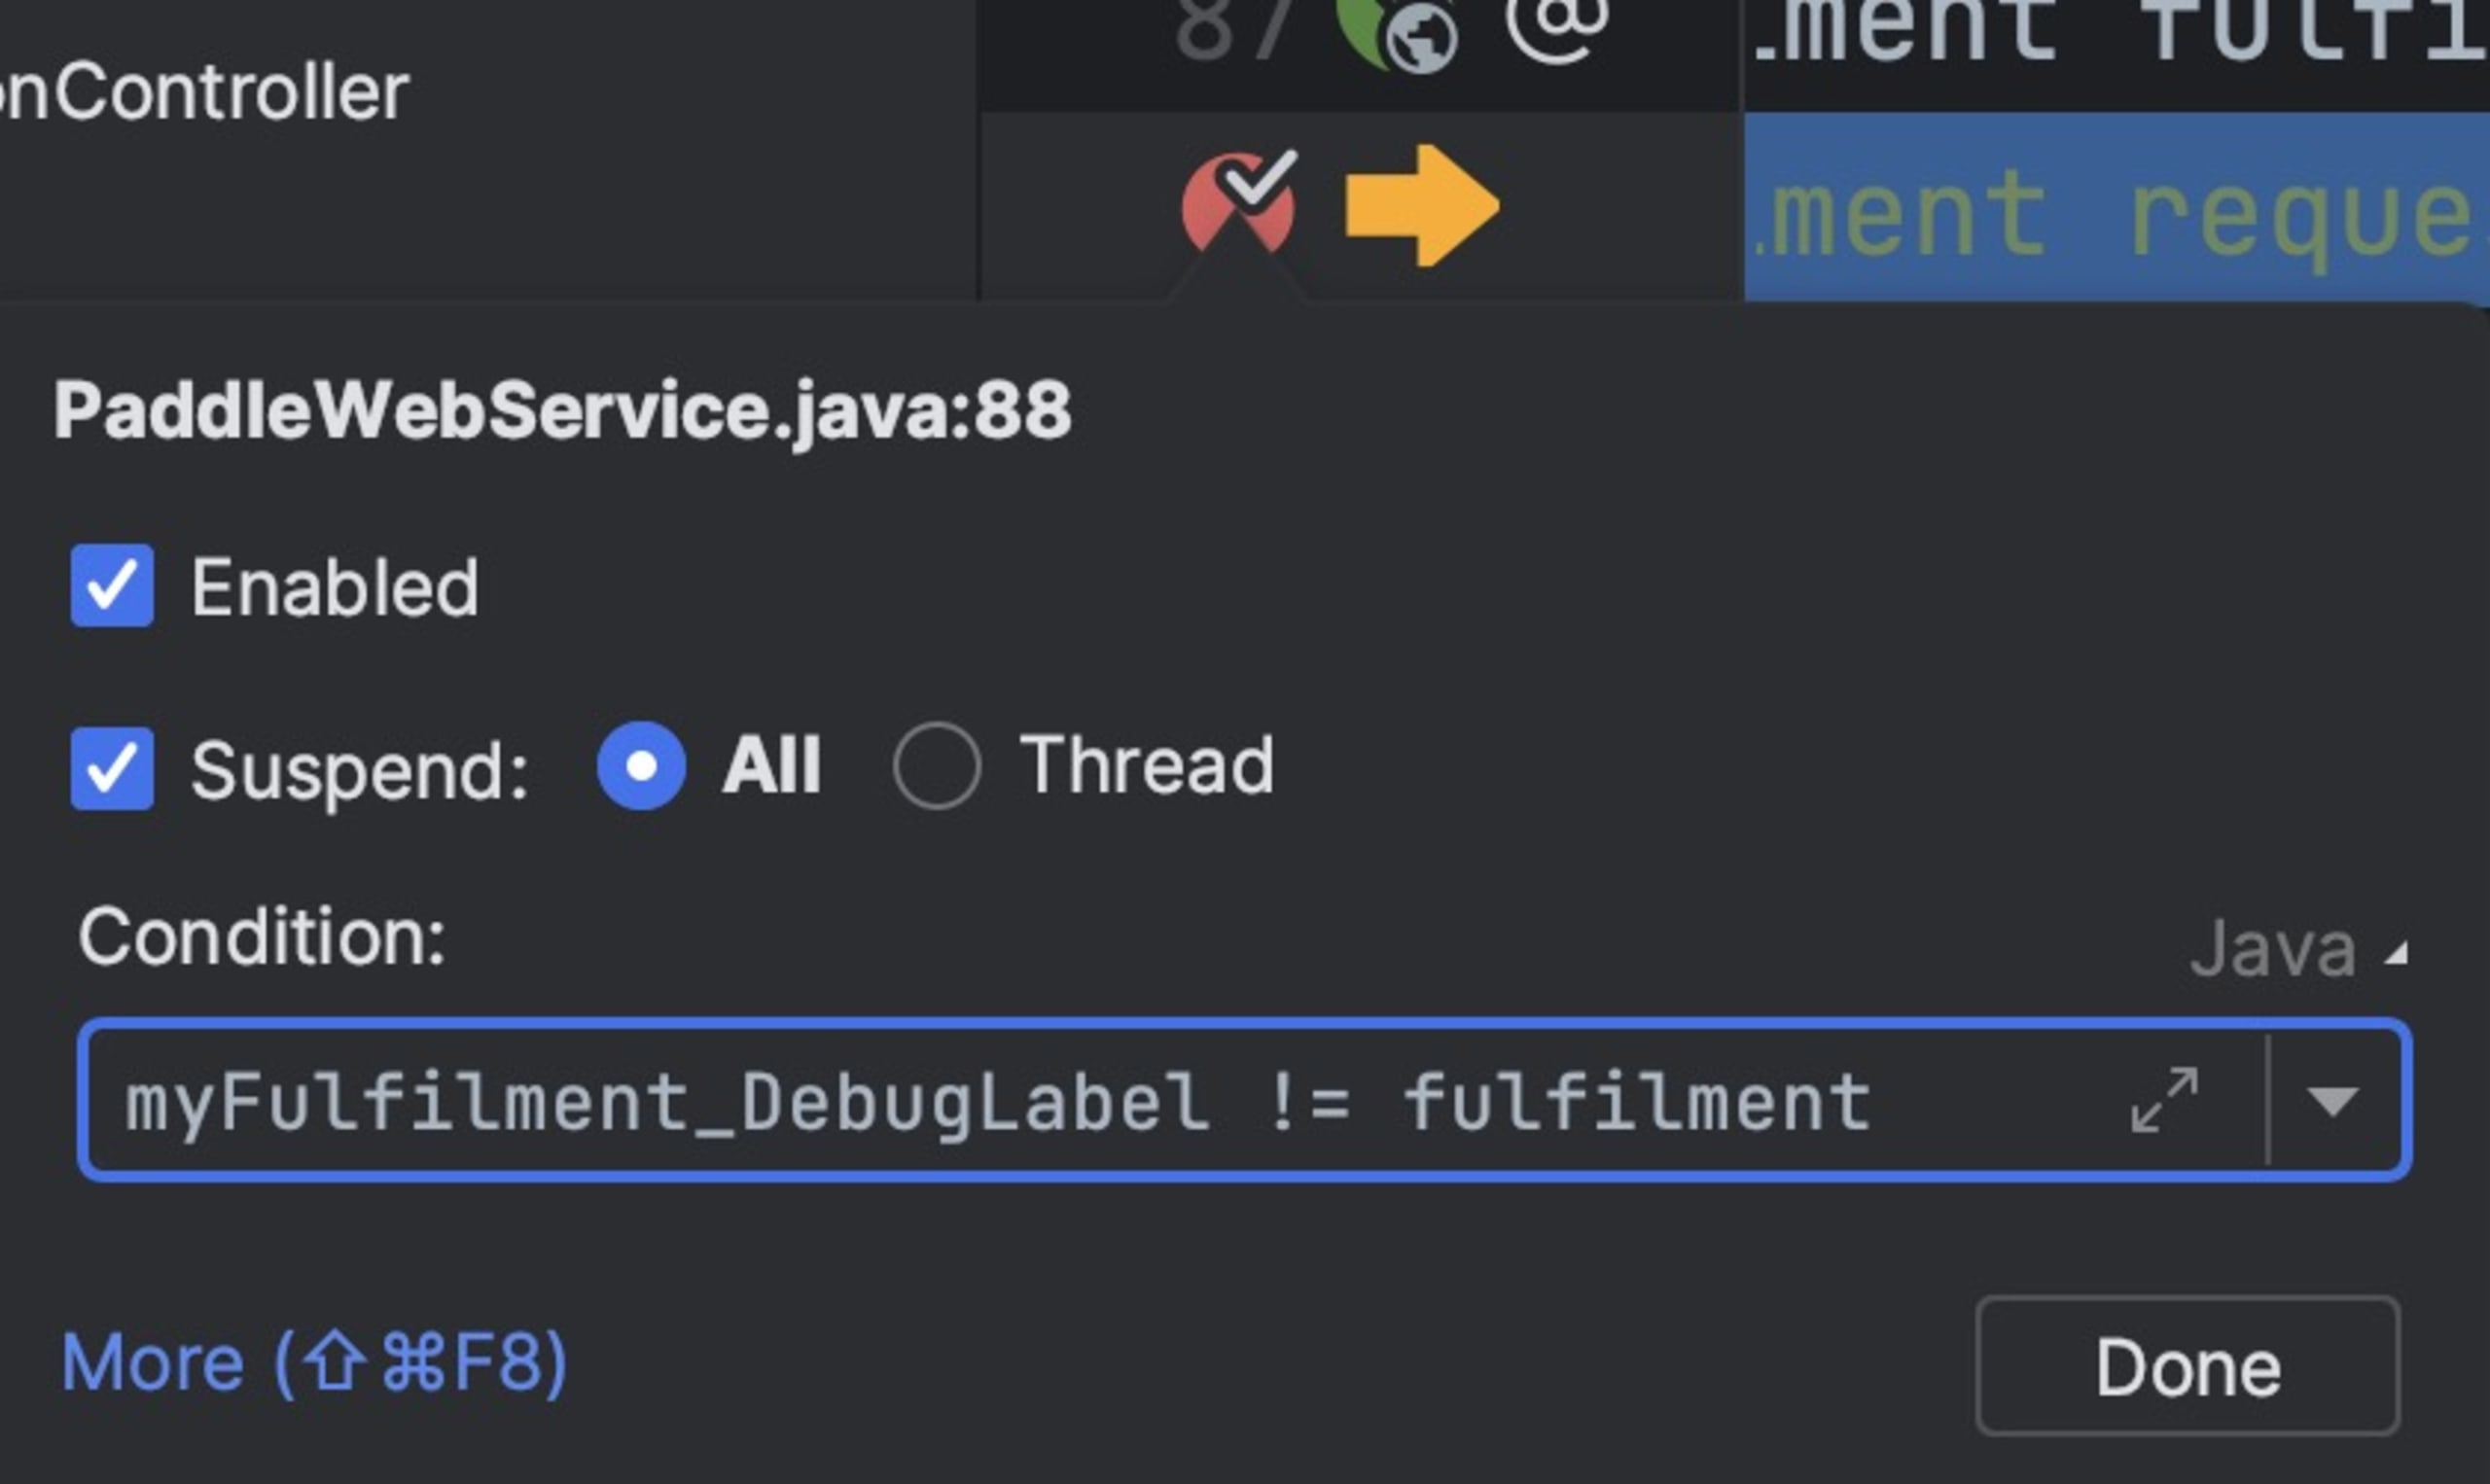
Isso é incrivelmente poderoso. Podemos usar esse recurso para detectar problemas de concorrência marcando a thread atual. Também podemos acompanhar objetos com a mesma identidade, mas ponteiros diferentes. Um bom exemplo é o mapeamento objeto-relacional, quando podemos ter duas instâncias da mesma entidade ao mesmo tempo. É muito difícil rastrear esses bugs.
Renderizadores de entradas
A área de observação é um dos recursos mais incríveis das IDEs modernas. À medida que avançamos pelo código, ela nos mostra rapidamente todas as informações de que precisamos. Mas, às vezes, essa “olhada rápida” vira uma verdadeira busca: precisamos expandir variáveis e explorar uma hierarquia complexa só para encontrar o valor de uma variável que nos interessa.
Em Java, uma solução comum é sobrescrever toString() para retornar um valor mais descritivo. Mas há vários motivos para isso talvez não ser o que eu quero:
Talvez o objeto não seja meu — pode ter sido definido pelo framework.
Talvez seja algo específico para mim. Não quero alterar
toString()para todo mundo.toString()é importante e pode afetar bastante o desempenho da aplicação (por causa do custo dos logs, entre outros fatores).toString()é muito básico. E se eu quiser inspecionar uma variável que contém uma lista de elementos?
Os renderizadores nos permitem aproveitar o potencial da área de observação sem essas desvantagens. Vou demonstrar usando uma versão ligeiramente modificada da demo Spring Pet Clinic. A demo usa a Java Persistence API (JPA) para armazenamento. O suporte do Spring Data inclui o conceito de repositório. Podemos pensar em um repositório como uma tabela de banco de dados. Essa comparação não é “exata”, pois um repositório é uma abstração mais ampla, mas, em geral, é uma aproximação razoável.
Quando paramos em um breakpoint, geralmente vemos a bagunça inútil mostrada na imagem a seguir. visitRepository é um repositório, mas não fornece nenhuma informação útil para mim durante a depuração. Quantos elementos há na tabela? Quais são os valores deles?
Posso expandir ainda mais a entrada de observação, mas isso não vai me levar a lugar algum: esse objeto proxy não apresenta informações úteis para observar.
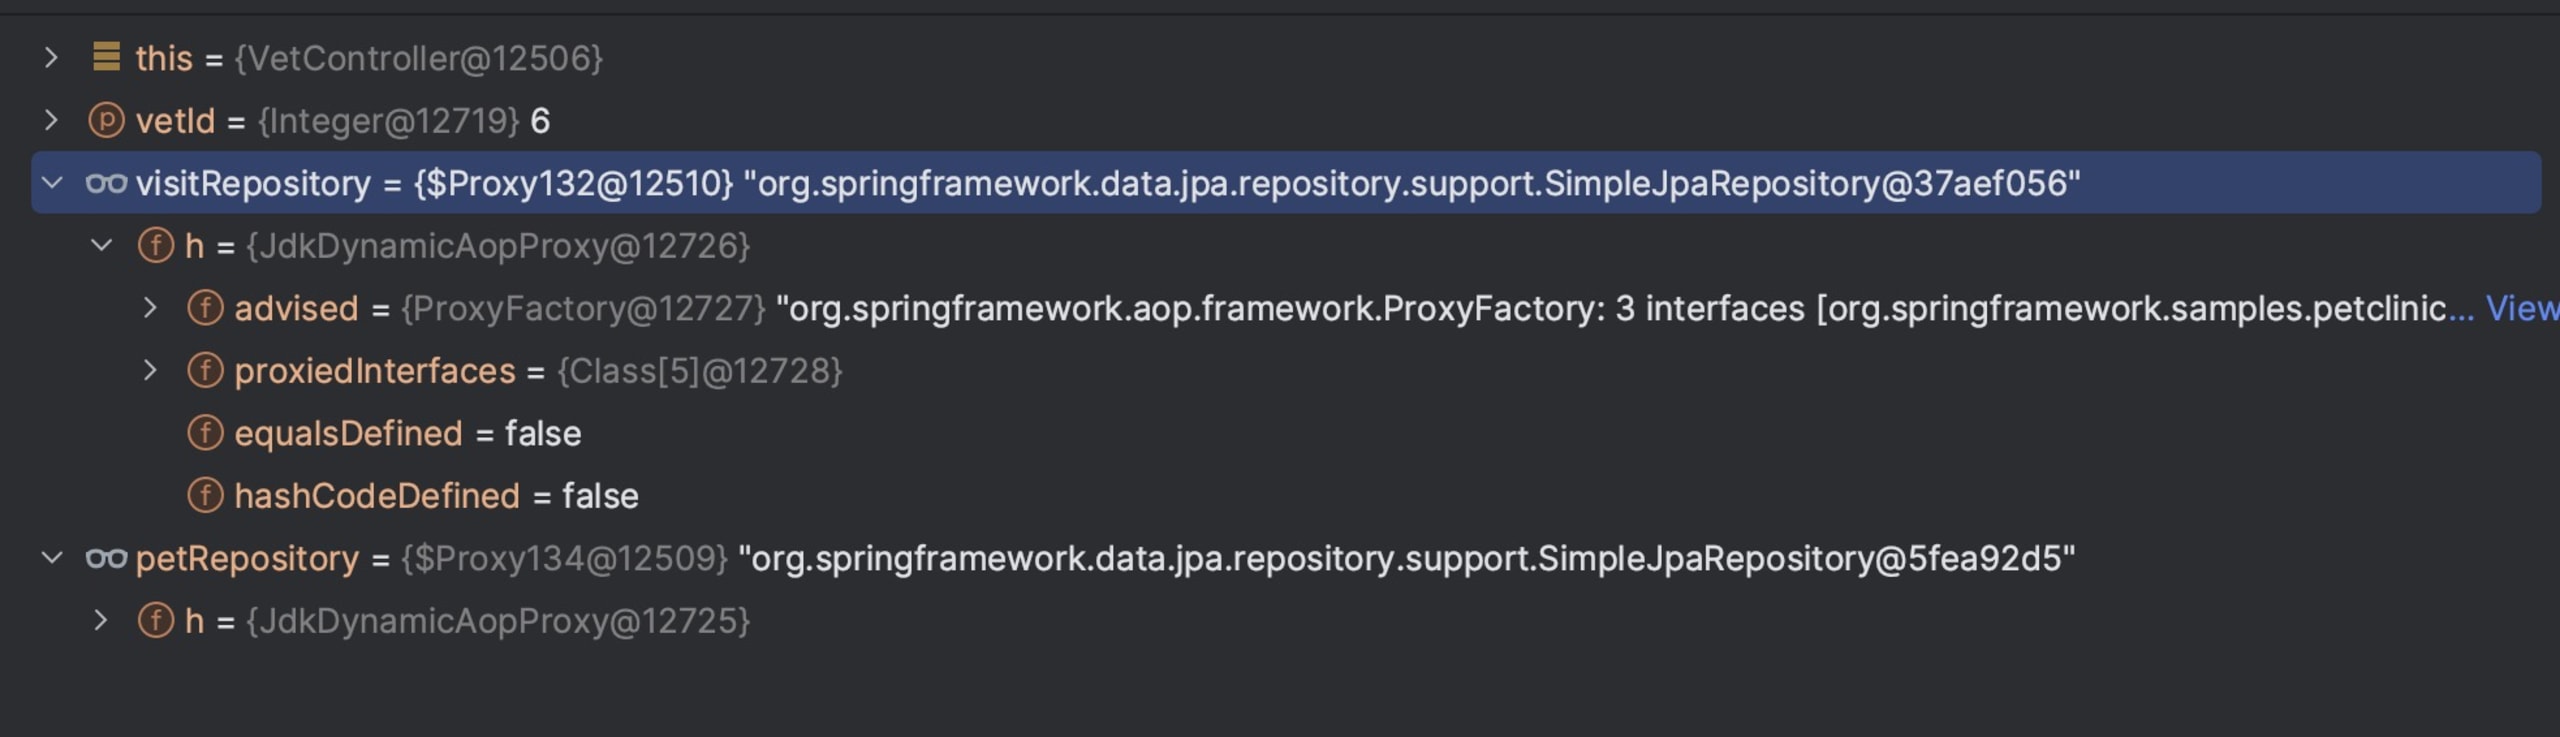
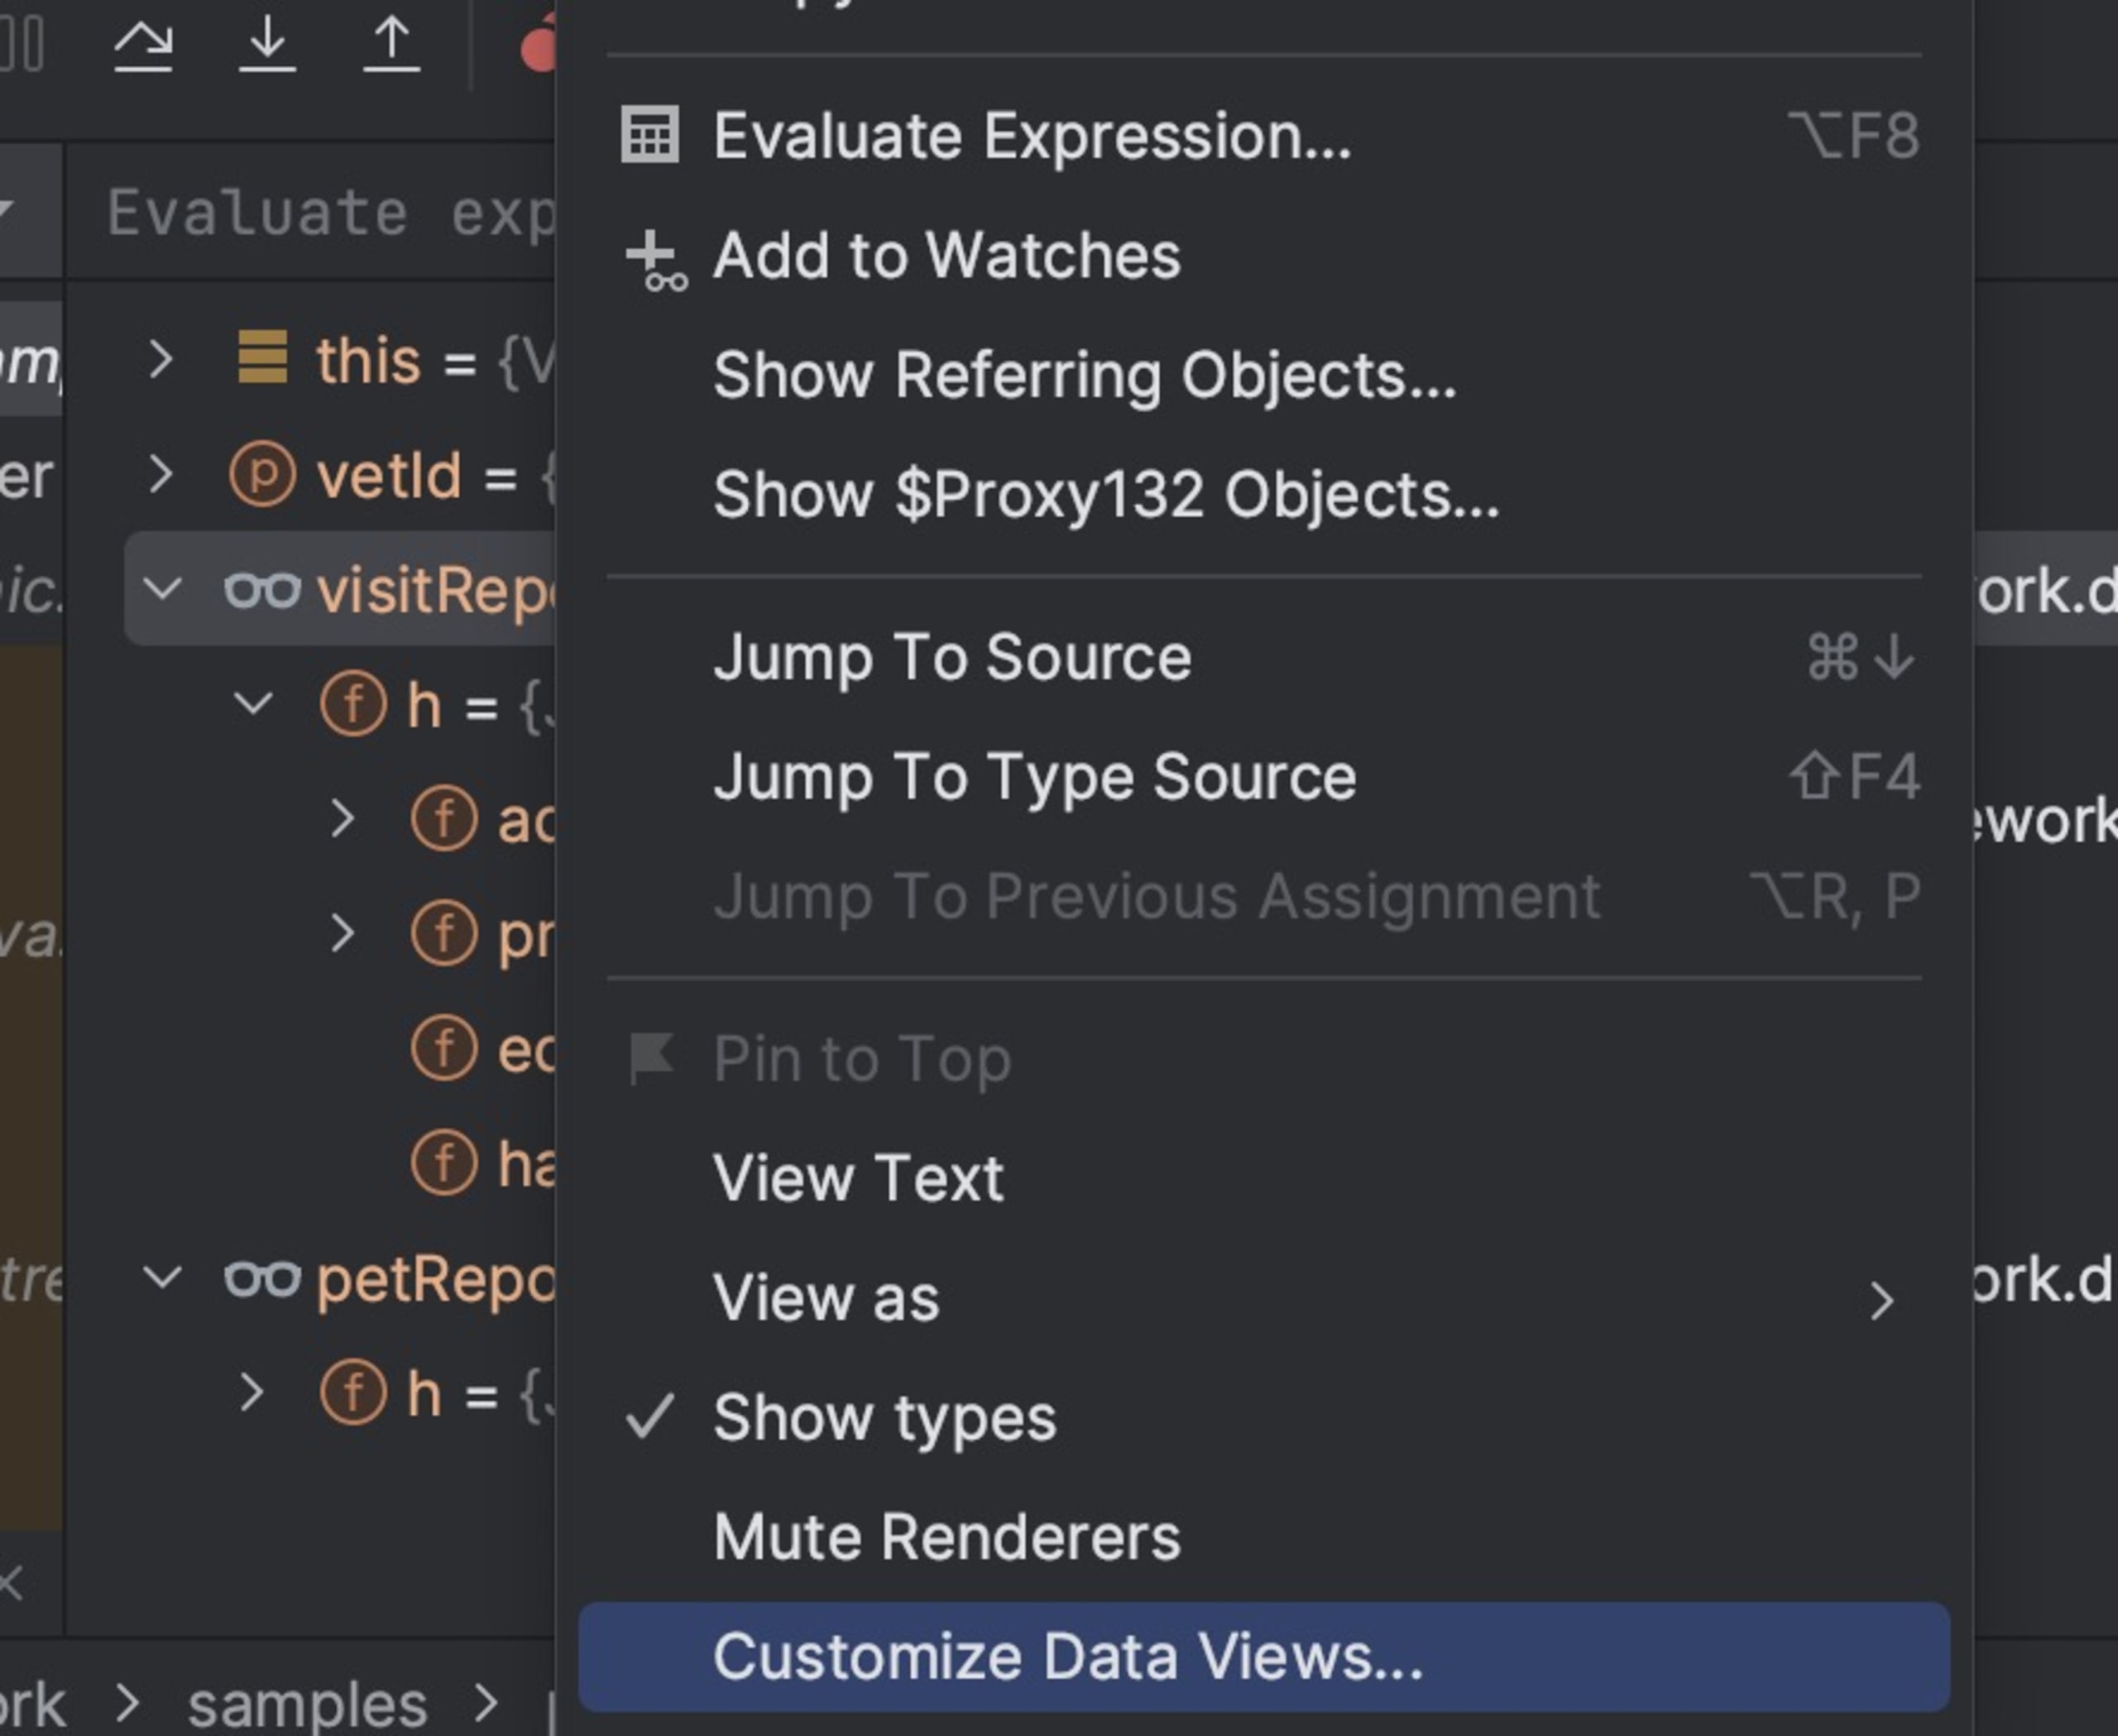
Podemos fazer melhor usando renderizadores. Para começar, clique com o botão direito na área de observação e selecione Personalizar visualizações de dados.
Na caixa de diálogo a seguir, posso definir os elementos do meu renderizador para obter um resultado muito mais útil. Agora, a área de observação mostra rapidamente a quantidade de elementos e permite analisar cada um individualmente, se quisermos!

À esquerda, você vê como isso funciona. Optamos por personalizar o JPARepository. Observe que perRepository na área de observação é de outro tipo de repositório; por isso, não foi afetado. Em seguida, definimos o código aplicável que será executado para implementar a renderização. Chamamos o método count() do objeto para obter a quantidade de objetos e criar uma string a ser exibida na área de observação.
A segunda parte é ainda melhor. Podemos usar findAll() para reunir os elementos do repositório e exibi-los quando o objeto for expandido. A última parte determina se um sinal de mais deve aparecer ao lado do repositório para permitir a expansão.
Incrível. Mas há uma grande desvantagem: precisamos fazer isso para cada tipo de objeto que definirmos. É trabalhoso… Ou será que não?
Podemos definir anotações que representam essas configurações e incluir soluções como essa diretamente na distribuição da nossa biblioteca. Isso pode facilitar muito a depuração de bibliotecas de 3as partes.
Monitoramento de memória
Quando falamos de memória, pensamos em ferramentas de profiling. Que maneira melhor existe de monitorar a memória?
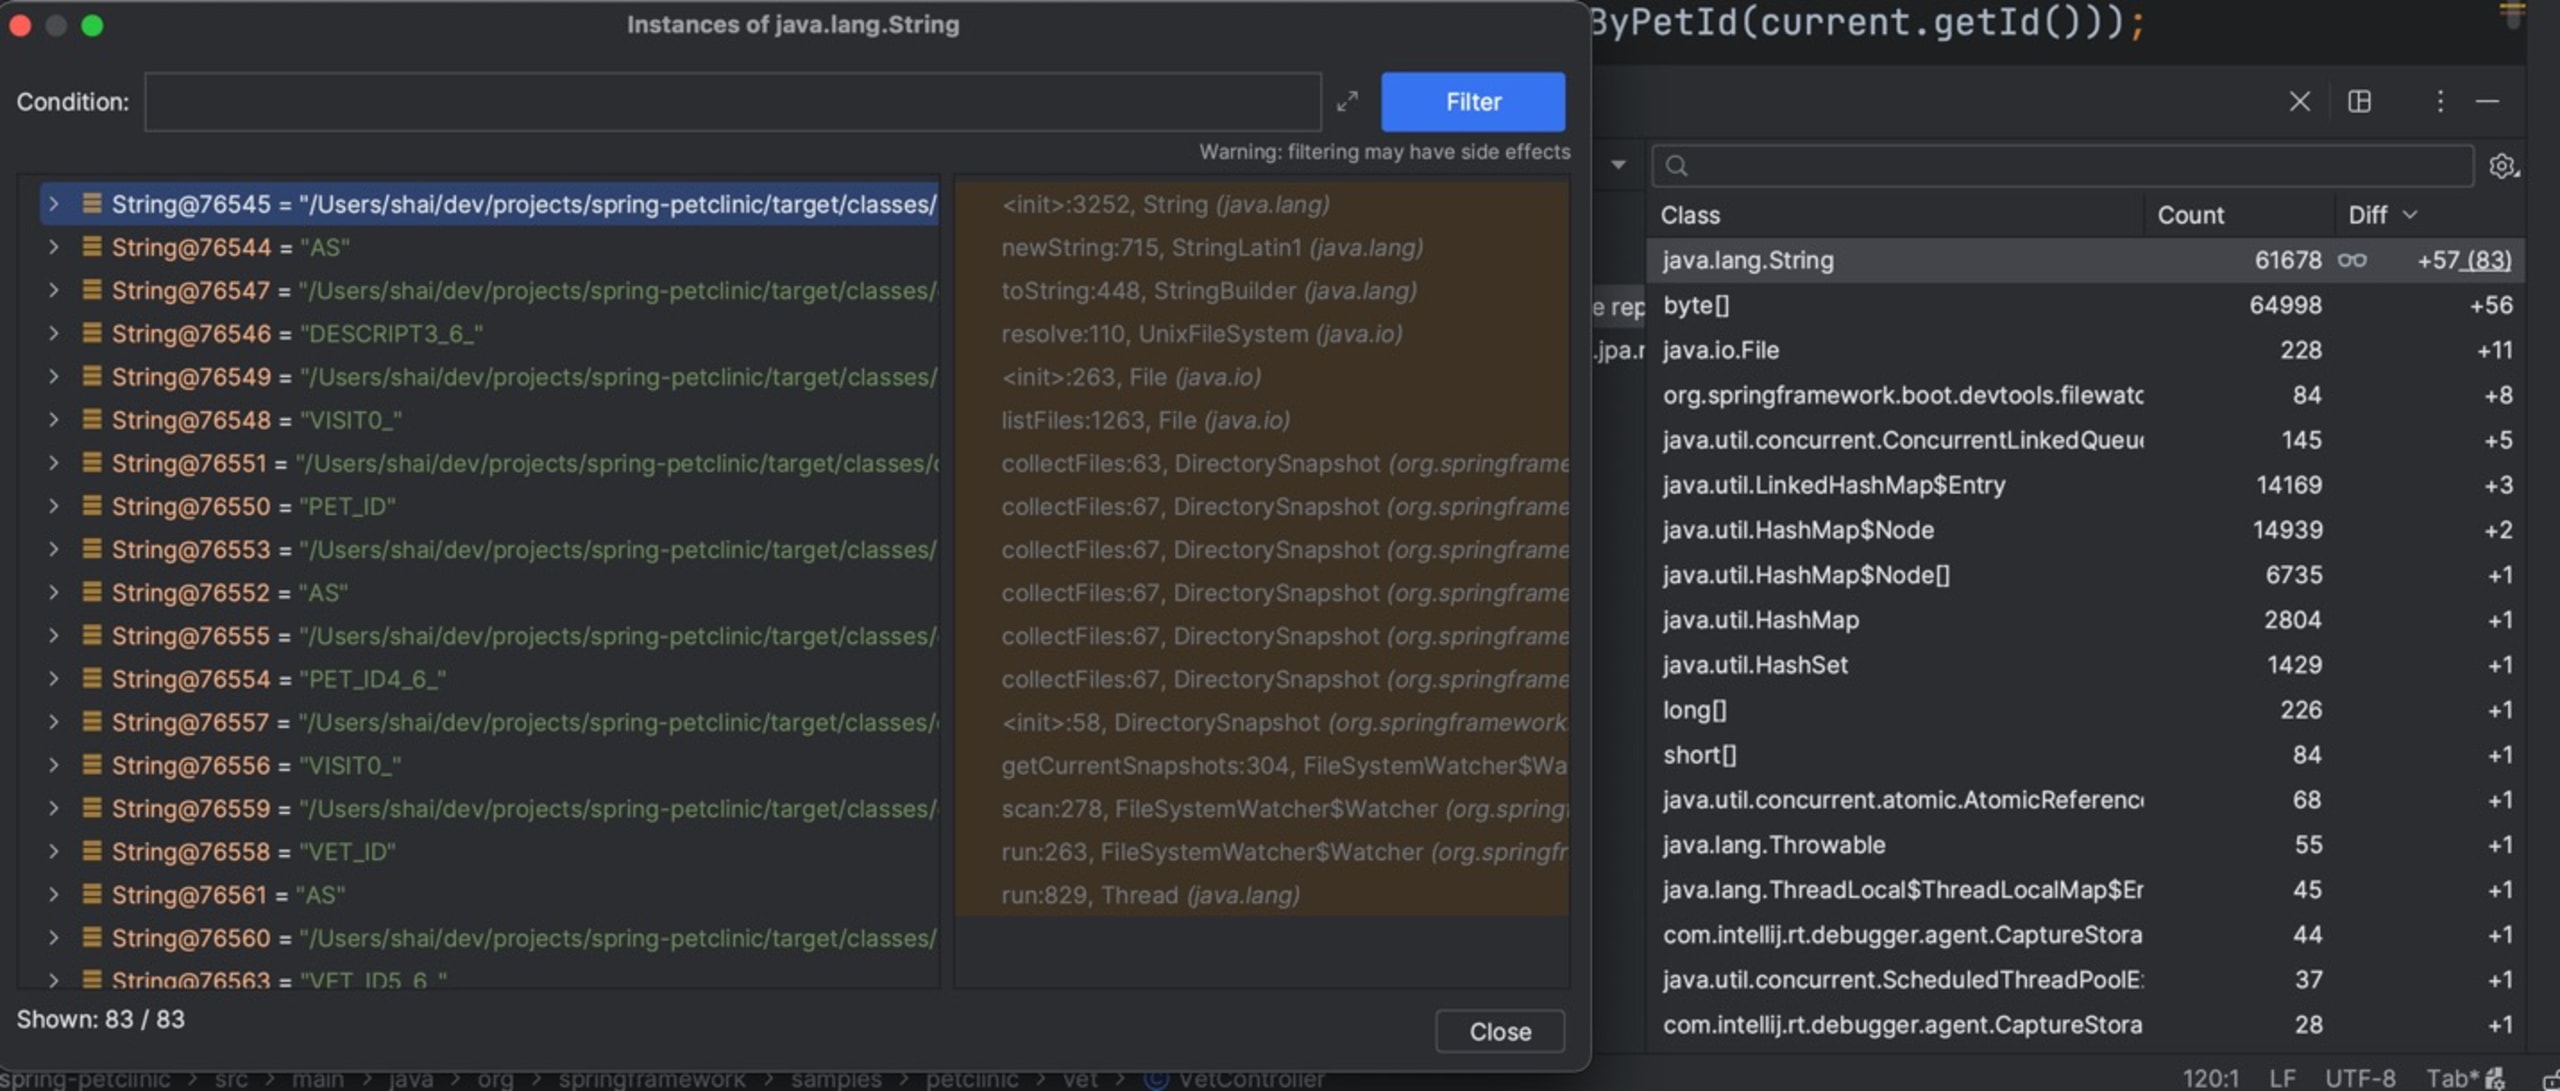
As ferramentas de profiling são ótimas, sem dúvida. Mas são instrumentos abrangentes. Falta a elas uma solução para a “última etapa”, quando estamos investigando um bug. Elas também não são adequadas para rastrear um objeto perdido ou obter uma visão mais detalhada do sistema. Por exemplo, podemos ativar a visualização de memória clicando no canto superior direito da área de observação e habilitando “Memória”.
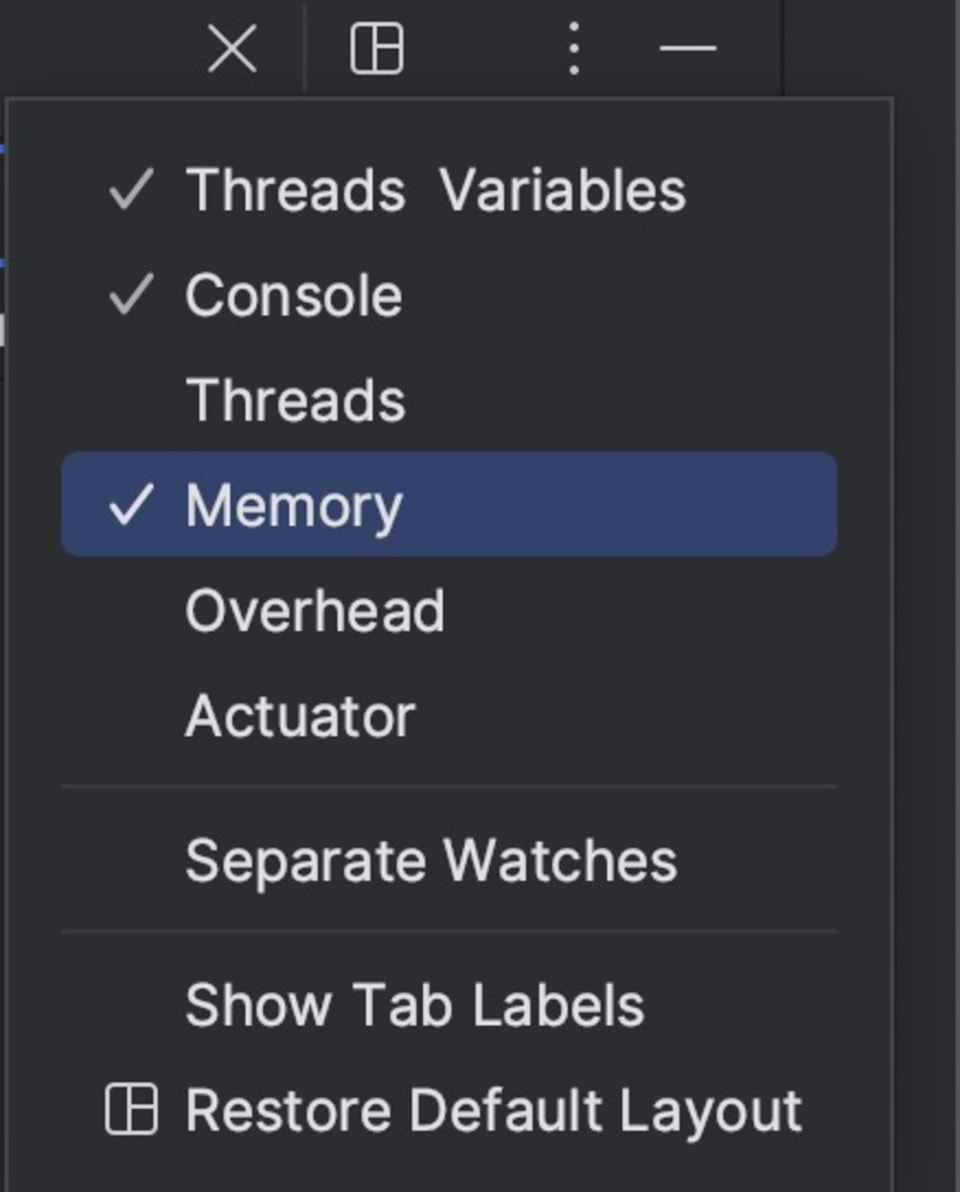
Depois disso, podemos ver uma lista dos objetos na memória e clicar duas vezes em cada objeto para ver a lista completa de objetos que ele contém. Também podemos ver, na coluna “diff”, quantos objetos de cada tipo foram alocados entre este breakpoint e o anterior.
Só isso já é incrível. Mas também é limitado. Não sabemos quais objetos foram alocados em determinado momento. Para isso, a IDE teria que monitorar cada alocação de objeto de todos os tipos e manter uma referência a cada objeto criado. Isso não é viável. Mas podemos escolher um tipo de objeto específico, clicar nele com o botão direito e selecionar a opção Rastrear novas instâncias.
Fiz isso com java.lang.String na captura de tela acima. É isso que o ícone de observação ao lado indica. Assim, podemos ver os objetos específicos alocados entre um breakpoint e o seguinte. Isso é extremamente útil, pois nos permite entender o que o código do sistema está fazendo nos bastidores. Mas tem mais…
Depois disso, também podemos obter o rastreamento completo da pilha de cada alocação de objeto e ver quais linhas a acionaram. Isso nos ajuda a entender cada alocação e o motivo por trás dela. Podemos usar esse recurso para entender o que está acontecendo nos bastidores de sistemas grandes e desconhecidos.
É o complemento perfeito para sua ferramenta de profiling.
Para concluir
Espero que este post tenha provocado o efeito de surpresa que eu queria. Acho que os desenvolvedores encaram o processo de depuração com receio injustificado. Isso se deve, em grande parte, à falta de ferramentas, processos e orientação adequada.
Depurar deveria ser uma experiência revigorante. É um exercício de humildade: durante a depuração, todos nos sentimos iniciantes, mas isso não é ruim. Apesar dos desafios, o processo deveria ser divertido e empolgante. Devemos valorizar as ferramentas que temos à disposição e aproveitá-las ao máximo.
Não trate seu próximo bug como uma fuga depois de um atropelamento. Encare-o como uma aventura. Uma aventura em que você pode tirar esses novos brinquedos da garagem e partir para cima do bug com essas novas habilidades.