10 práticas recomendadas de segurança para aplicações sem servidor



31 de maio de 2019
0 minutos de leituraNesta edição da nossa série de guias rápidos, apresentamos práticas recomendadas para proteger suas implantações sem servidor.
Então, vamos à nossa lista de 10 práticas recomendadas de segurança para aplicações sem servidor.
Se ainda não fez isso, baixe este guia rápido agora e deixe-o à vista para tomar decisões mais seguras no futuro!
Muitos exemplos e casos de uso fazem referência ao AWS Lambda, mas se aplicam também a outros provedores de nuvem e sem servidor. Consulte o CNCF Landscape para ver uma lista de referência.
Então, vamos à nossa lista de 10 práticas recomendadas de segurança para aplicações sem servidor.
1. Corrija as dependências das funções
As plataformas de Function as a Service (FaaS) se responsabilizam por aplicar correções às dependências do sistema operacional, mas não fazem nada para proteger as dependências da sua aplicação, como as obtidas no npm, PyPI, Maven e similares. Essas bibliotecas são tão comuns e vulneráveis quanto as dependências do sistema operacional. Você, como responsável pela aplicação, deve atualizá-las ou aplicar correções quando uma vulnerabilidade nelas for divulgada.
Use uma solução como o Snyk para analisar projetos sem servidor em busca de vulnerabilidades conhecidas nas dependências de código aberto. O Snyk vai além de gerar relatórios de vulnerabilidades: também oferece orientações para corrigi-las e aplica correções automaticamente por meio de atualizações de versão e patches de segurança.
Com as ferramentas do Snyk, você pode proteger funções durante todo o ciclo de desenvolvimento, começando pelo ambiente de desenvolvimento integrado (IDE), com a ajuda do nosso plugin para VSCode ou IntelliJ. Depois, você pode integrar o app do GitHub para que o Snyk abra pull requests automaticamente e corrija vulnerabilidades de segurança assim que forem detectadas, ou interrompa compilações de integração contínua (CI) para evitar implantações quando novas vulnerabilidades forem introduzidas.
Imponha implantações seguras para as funções
Além de monitorar a CI e os repositórios de código-fonte e aplicar proativamente patches para vulnerabilidades, o fluxo de implantação de uma função também deve passar por uma revisão de segurança. As implantações devem ser interrompidas quando vulnerabilidades forem encontradas nas funções em processo de implantação.
O framework Serverless é um conjunto de ferramentas bastante usado para desenvolver e implantar funções sem servidor. Sua arquitetura de plugins permite integrar fluxos de trabalho personalizados ao ciclo de vida das funções. O Snyk oferece um plugin Serverless de código aberto que se integra perfeitamente ao framework.
Veja a seguir uma imagem que mostra o plugin protegendo ativamente uma função contra a implantação, após detectar vulnerabilidades de segurança nas dependências de código aberto:
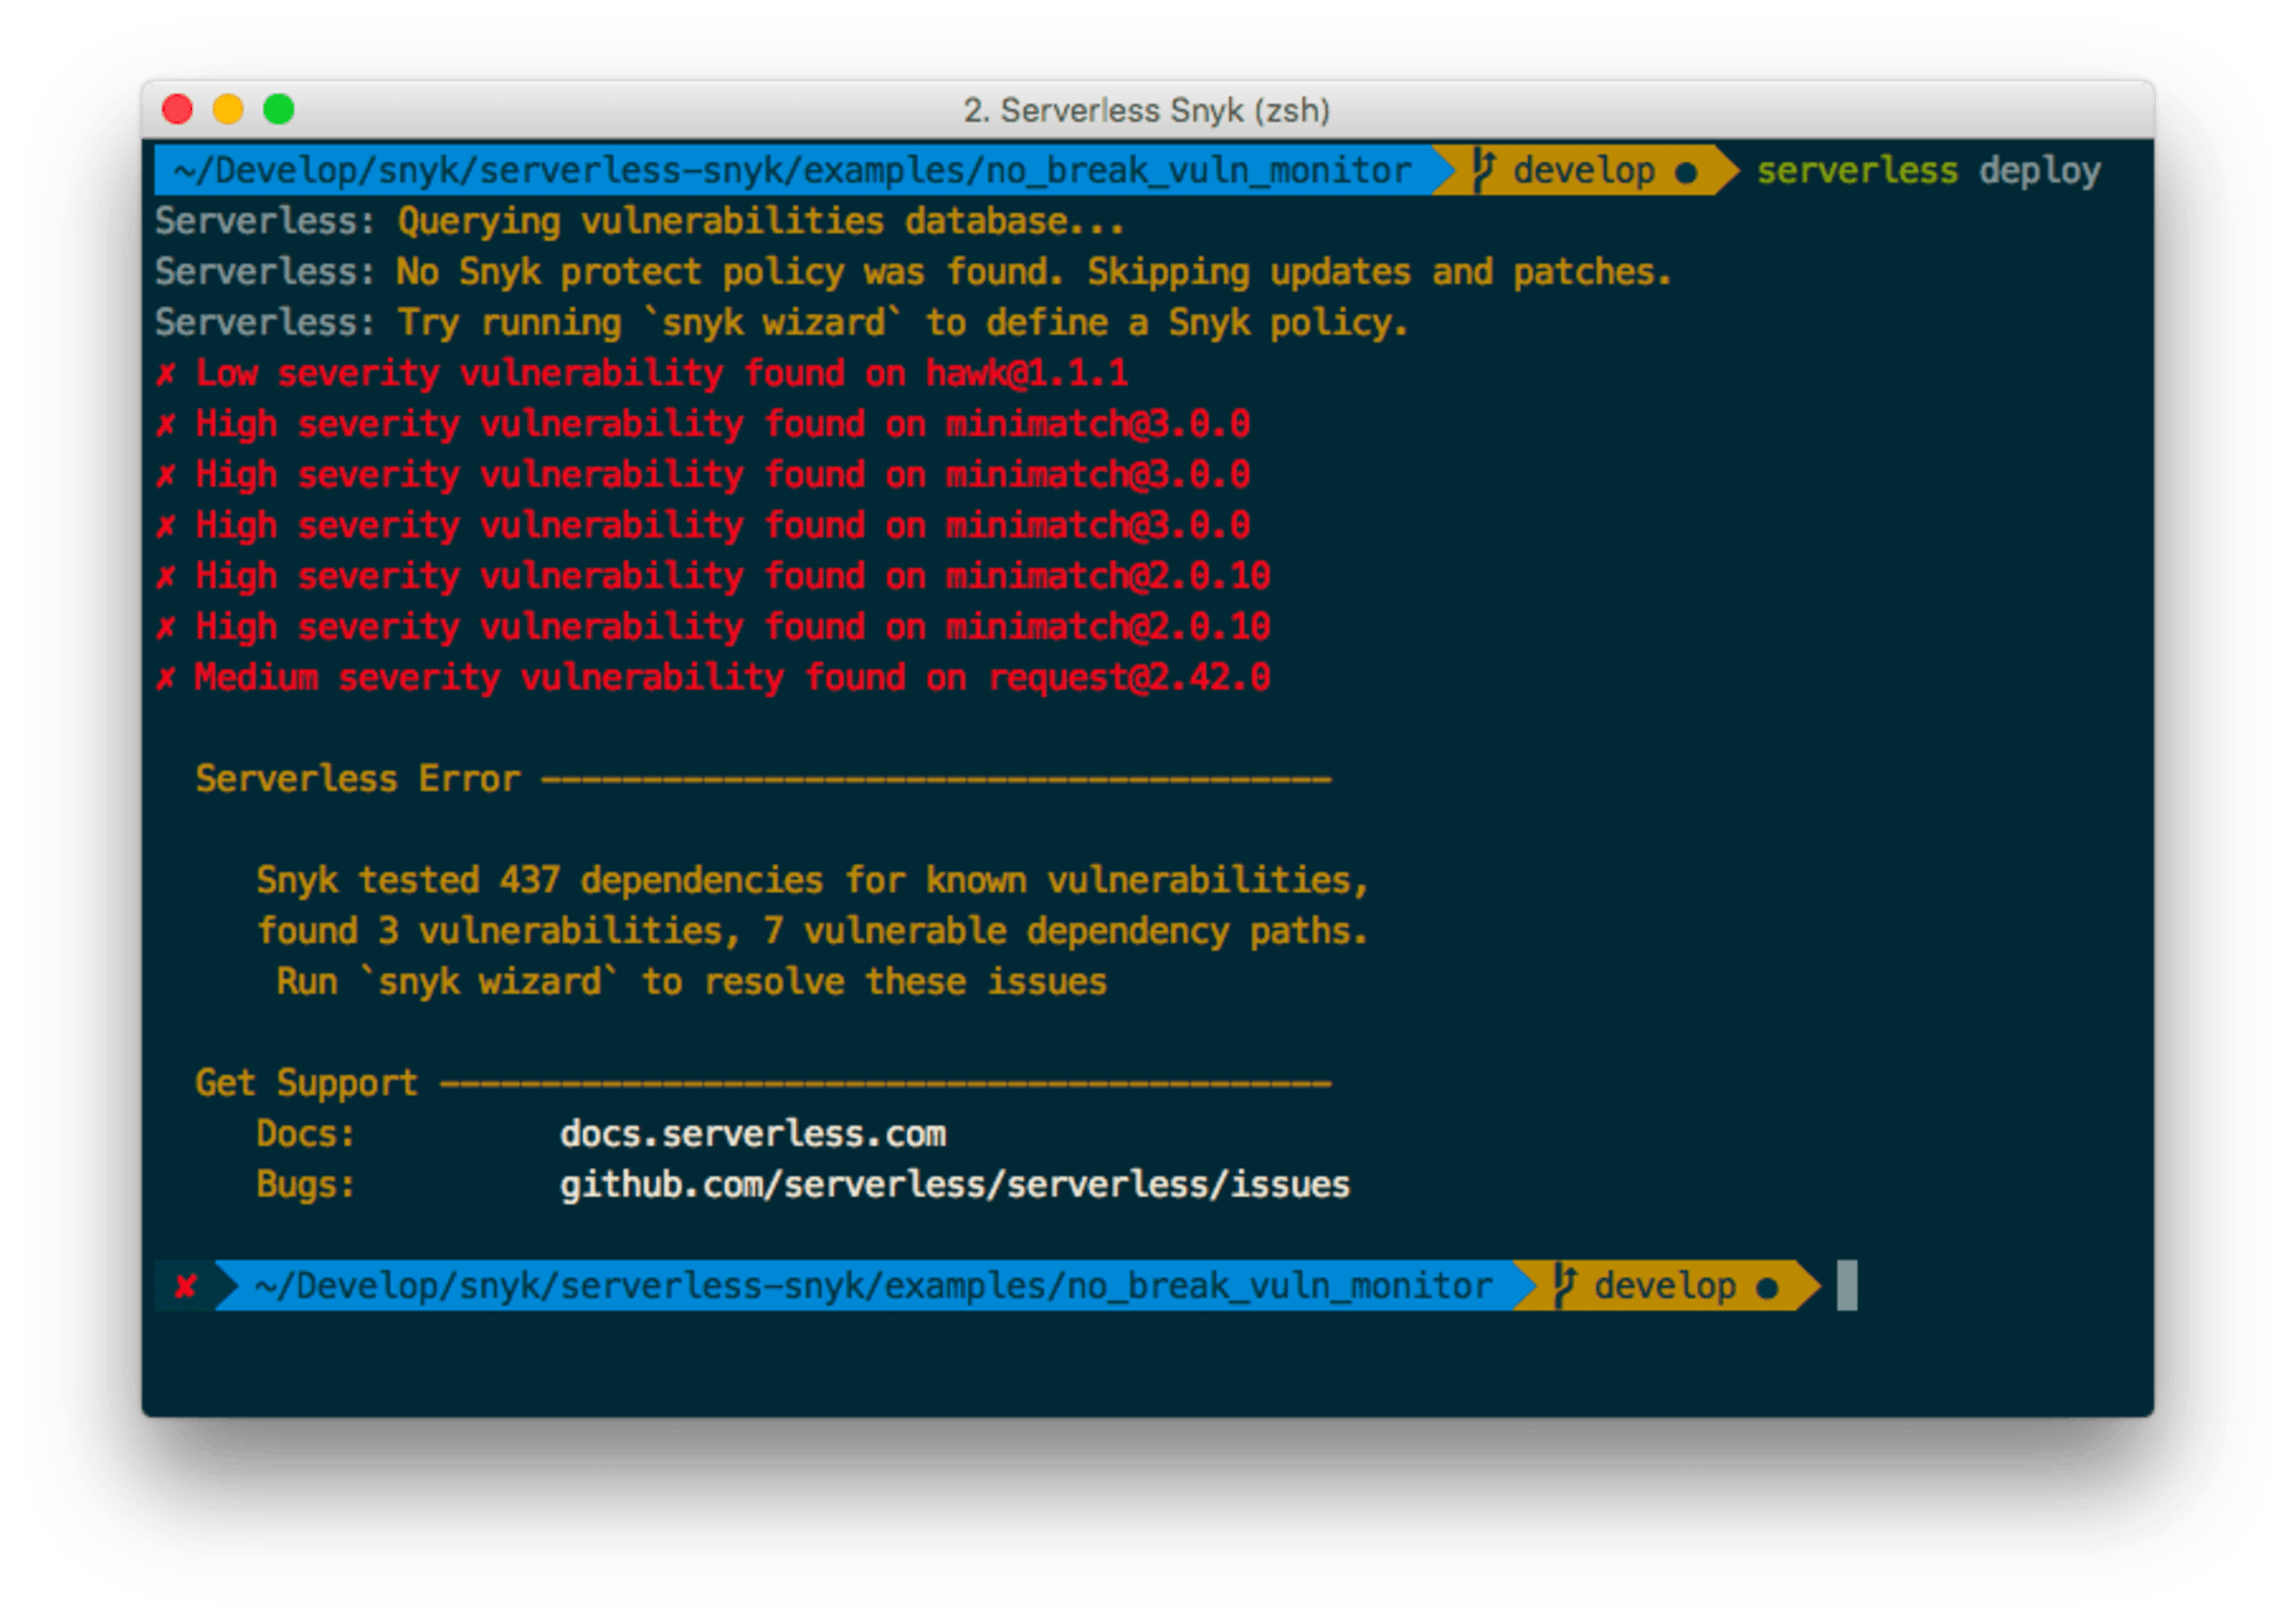
Para saber mais sobre como configurar o plugin Serverless do Snyk, criar snapshots de projetos para fluxos de CI/CD e monitorar seus projetos, confira esta publicação sobre como configurar o plugin do framework Serverless
2. Adote o princípio do menor privilégio
Como as funções são pequenas, podemos reduzir cada conjunto de permissões ao mínimo necessário, concedendo acesso apenas ao que cada função precisa para operar corretamente. Isso reduz significativamente os danos que um ataque bem-sucedido pode causar e diminui a superfície de exposição da integração como um todo. Por exemplo, provavelmente a maioria das funções não precisa acessar o banco de dados nem se conectar a servidores externos — ações comuns de invasores e usuários mal-intencionados após uma exploração bem-sucedida.
Siga o princípio do menor privilégio. Implante suas funções com o conjunto mínimo absoluto de permissões necessário para manter uma configuração segura e reduzir a superfície de ataque.
Concessão indevida de permissões além do necessário
Considere a seguinte configuração serverless.yml, que define uma única função de permissões para todas as funções implantadas com este projeto:
Um erro evidente na configuração acima é que a função do IAM implantada com as funções concede acesso a todas as ações de leitura e gravação no DynamoDB que se integram a elas, embora algumas funções precisem apenas ler e outras, excluir. Esse padrão padrão e ingênuo de projeto sem servidor amplia a superfície de ataque. Seria preferível implantar funções de forma granular, dividindo também as permissões conforme a necessidade.
Defina corretamente funções e permissões para cada função
O framework Serverless incentiva a configuração de papéis para cada função, como vemos no trecho de exemplo a seguir de um arquivo serverless.yml:
A partir da linha 7, duas funções são declaradas: func0 e func1. Cada uma recebe uma função específica, definida pela diretiva role nas linhas 9 e 12.
Diferentes definições de função podem oferecer acesso muito mais granular, concedendo somente o que cada função precisa. Por exemplo, uma função pode ter recursos de registro relacionados à AWS, enquanto outra pode ter acesso a um bucket do Amazon S3.
3. Mantenha perímetros isolados para cada função
Embora várias funções possam ser implantadas para compor um fluxo de trabalho completo, cada uma deve ser tratada como um perímetro independente. Assim, uma vulnerabilidade em uma função não se propaga nem compromete as demais.
Veja este cenário como exemplo:
A função subscribeToEmailNotification higieniza a entrada e, em seguida, a função sendNotification é acionada para processá-la e entregá-la. Você pode achar que não precisa higienizar a entrada de eventos da segunda função, já que a função “subscribe” já fez isso. Porém, se mais tarde for criada uma nova função subscribeToSMSNotification que não higieniza a entrada, a função sendNotification poderá novamente processar dados de eventos sem higienizá-los.
Siga estas orientações para manter as funções isoladas em seus próprios perímetros:
Não dependa da ordem de acesso e invocação das funções: não presuma que uma função só será chamada por outra ou que não poderá ser acessada por um gateway de API. A ordem e os meios de acesso às funções podem mudar com o tempo.
Cada função é seu próprio perímetro de segurança: cada função deve tratar toda entrada de evento como uma fonte de dados não confiável e sempre higienizá-la.
Use bibliotecas de segurança: invista tempo na criação ou adoção de bibliotecas de segurança padronizadas e exija seu uso em todas as funções.
4. Higienize as entradas de eventos para evitar injeções
As arquiteturas sem servidor costumam exigir diferentes formas de ingestão de dados para funções na nuvem: síncrona, assíncrona ou por streaming. Todas podem incluir dados controlados por usuários que circulam por diferentes armazenamentos de dados e funções.
Mesmo protegidas por gateways de API, firewalls e outros proxies, as funções usadas em serviços de API lidam com entradas de usuários como um servidor de API tradicional. Além disso, funções que processam dados de eventos de filas de mensagens e outros canais de comunicação não públicos ainda podem lidar indiretamente com entradas de usuários, mas o contexto e a origem dos dados ficam menos claros e mais difíceis de prever.
As arquiteturas sem servidor são, em sua maioria, orientadas a eventos. Por isso, a injeção de eventos se torna um vetor de ataque importante: funções são criadas intencionalmente para executar tarefas pequenas, como processar dados de uma fila de eventos. No entanto, se dados maliciosos conseguirem contornar uma função de higienização e chegar à carga útil do evento, a função de processamento poderá ficar vulnerável a ataques de injeção caso não valide os dados corretamente.
Veja a seguir exemplos de fontes de dados menos tradicionais que costumam acionar funções e, portanto, não devem ser consideradas confiáveis:
Armazenamento — nomes de arquivos ou diretórios em armazenamentos na nuvem, como buckets do S3, podem ser controlados por usuários e gerar entradas maliciosas para interpretadores.
Mensagens — as cargas úteis de eventos em mensagens assíncronas de serviços como SNS e SQS devem ser higienizadas e não devem ser consideradas confiáveis.
Fluxos de banco de dados — atualizações em um banco de dados, como a inclusão ou exclusão de um registro, podem acionar funções. Como esses eventos podem ter entradas de usuários como origem, eles devem ser higienizados.
Adote estas práticas recomendadas para todas as entradas de usuários processadas pela função e reduza o risco de ataques de injeção de eventos:
Valide os dados com base em esquemas e objetos de transferência de dados, verificando o tipo, o comprimento e o intervalo de valores esperados. Não serialize e desserialize objetos de dados sem verificar nem os encaminhe sem alterações.
Sempre use um ORM e aplique o escape correto ao trabalhar com bancos de dados SQL e não relacionais para evitar esses tipos de injeção.
Evite iniciar processos do sistema ou avaliar código dinâmico em tempo de execução usando dados de eventos, pois eles podem ter sido originados por entradas de usuários. Além disso, tenha cuidado com os serviços de terceiros integrados às suas funções, já que você tem pouco controle ou visibilidade sobre a origem dos dados e o escopo das entradas controladas por usuários. Ao iniciar processos ou executar código dinâmico, adote as contramedidas apropriadas, como codificação e sandboxing, respectivamente.
5. Use gateways de API como barreira de segurança
As funções na nuvem implantadas costumam ficar expostas e, portanto, podem ser acessadas por um endpoint HTTP gerado aleatoriamente, que recebe eventos, dados e o contexto correto para processar a carga útil. Uma boa prática para expor funções é usar gateways de API, que atuam como proxies reversos e criam uma camada de separação entre usuários e funções.
Como interface de API voltada aos consumidores, os gateways de API podem ser configurados para oferecer vários mecanismos de segurança que ajudam a reduzir a superfície de ataque das funções.
Gateway de API como filtro
Antes de expor suas funções, use um gateway de API como filtro para limitar as entradas com base em uma política do gateway. Quanto mais rigorosa a política, menor o risco de algo malicioso chegar às funções. O AWS API Gateway incentiva a declaração de mapeamentos de solicitações e respostas compatíveis com esquemas. Esse padrão é semelhante ao dos objetos de transferência de dados; no caso de funções e gateways, o mapeamento pode servir como uma regra estrita para as solicitações recebidas.
Veja a seguir um exemplo de esquema definido no nível do gateway de API para uma solicitação JSON recebida:
Gateway de API como camada de autenticação
Filtrar solicitações HTTP antes que cheguem às funções na nuvem é essencial para controlar o acesso dos usuários a recursos como autenticação e autorização. Configure um gateway de API e deixe que o provedor de nuvem e a infraestrutura dele cuidem das questões relacionadas às funções.
Depois que os usuários forem autenticados no gateway de API, você poderá aplicar medidas de proteção, como limitar a taxa de solicitações e definir cotas no gateway, tudo isso sem acionar funções.
Gateway de API para mitigar ataques DDoS
Um gateway de API protege contra ataques de negação de serviço (DoS) no nível do provedor de nuvem, permitindo limitar a taxa de todas as solicitações direcionadas às suas funções. O controle da taxa de solicitações deixa de ser responsabilidade das funções e da lógica de negócios — como deve ser — e passa a ser gerenciado inteiramente pela infraestrutura da nuvem. O uso de um gateway de API ajuda a evitar o esgotamento de recursos financeiros.
6. Monitore e registre as funções
As funções têm vida muito curta. Com muitas funções implantadas e um volume crescente de invocações à medida que você escala, fica fácil perder o rastro do fluxo de eventos e identificar a causa dos erros. À medida que uma organização adota mais soluções sem servidor, fica mais difícil monitorar fluxos inseguros e tentativas maliciosas de levar uma função a executar caminhos de código inseguros.
A AWS introduziu recentemente a possibilidade de adicionar tags às funções Lambda, facilitando o rastreamento e o agrupamento. Com o Serverless Framework, podemos adicionar tags às funções nos arquivos YAML, seja globalmente (para todas as funções no arquivo serverless.yml) ou individualmente.
Monitore funções em busca de vulnerabilidades de segurança
O Snyk se integra ao seu provedor de FaaS para monitorar as funções implantadas e mantê-las protegidas. Assim, você pode corrigir vulnerabilidades de segurança conhecidas ao longo do ciclo de vida do desenvolvimento de software, no que diz respeito às funções e ao uso que elas fazem de dependências de código aberto.
Na imagem a seguir, vemos o projeto do GitHub lirantal/bazz-serverless após a análise, com várias vulnerabilidades de gravidade alta, média e baixa. Esse é o código-fonte do meu projeto serverless, que implanta várias funções. Abaixo do repositório do projeto no GitHub, vemos as seis funções do AWS Lambda que implantei. São as funções reais, tal como são implantadas e executadas pela AWS.
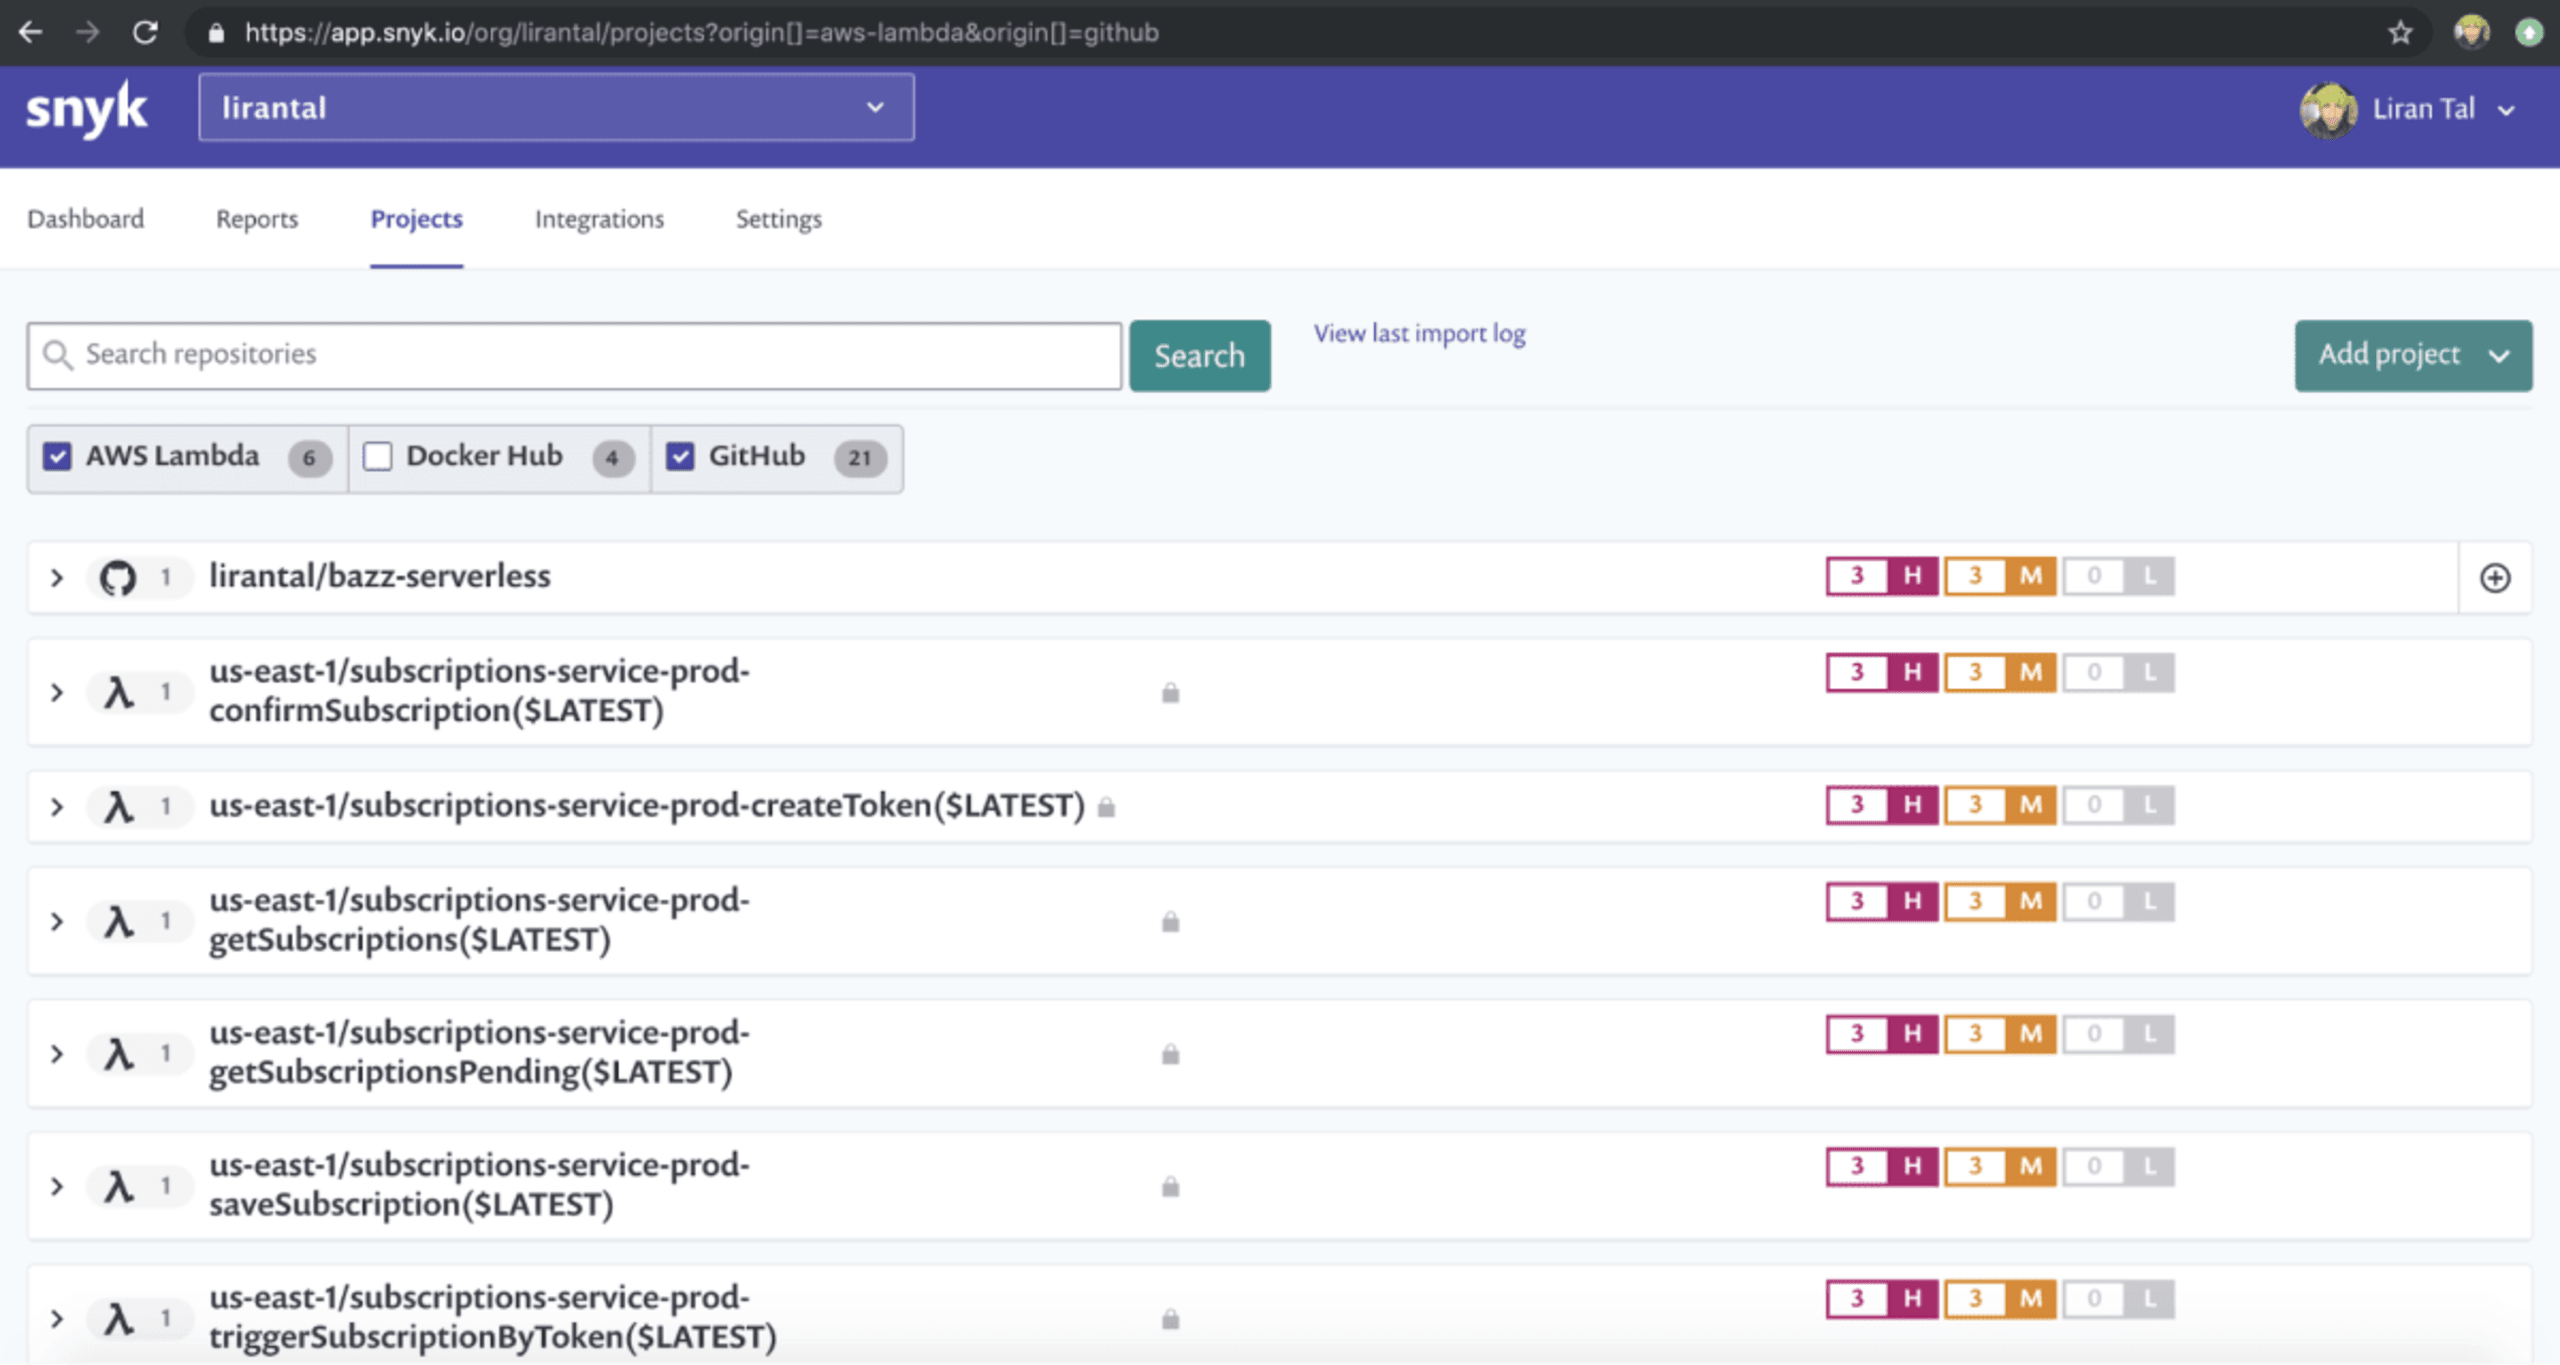
O Snyk analisou cada uma dessas funções em busca de vulnerabilidades de segurança conhecidas. Como todas usam a mesma árvore de dependências, vemos que foram implantadas com versões de bibliotecas vulneráveis.
Os provedores de nuvem costumam oferecer monitoramento integrado de recursos de aplicações e funções para fornecer esse tipo de informação. A Microsoft tem o Azure Monitoring, e a Amazon, o AWS X-Ray. O console do X-Ray da AWS, por exemplo, mostra como os dados fluem pelas funções e por outros recursos de nuvem, além de métricas como o tempo de execução.
7. Siga as convenções de codificação segura no código da aplicação
Uma grande vantagem da infraestrutura serverless é transferir a responsabilidade pelo sistema operacional subjacente do responsável pela aplicação para o provedor de nuvem, que deve mantê-lo e mantê-lo atualizado com patches de segurança. Isso, porém, significa que os invasores voltarão a atenção para as áreas que continuam expostas — e, em primeiro lugar, para o próprio código da aplicação.
O código da aplicação ainda está sujeito a vulnerabilidades. Por isso, os desenvolvedores devem seguir convenções de codificação segura e garantir que essas diretrizes sejam cumpridas em atividades como revisões de código, para detectar problemas de segurança no código da aplicação logo no início do processo de desenvolvimento de software. Exigir o uso de bibliotecas de segurança compartilhadas entre as equipes de desenvolvimento ajuda a garantir o cumprimento dessas diretrizes e evita que os desenvolvedores reinventem a roda, cometendo possíveis erros em questões de segurança que já têm soluções padronizadas.
O OWASP Top 10 é uma boa referência para identificar áreas do código da aplicação que exigem mais atenção à segurança. Alguns desses tópicos são:
Ataques de injeção, que ocorrem quando os dados não são filtrados ou codificados no contexto correto e acabam sendo interpretados como parte de uma execução confiável. Isso se aplica a áreas como injeções de SQL, execução de comandos do sistema e execução de código CSS e JavaScript. Para evitar completamente injeções maliciosas em qualquer contexto, impeça a entrada de dados do usuário sempre que possível, use uma lista de permissões segura e codifique todos os dados fornecidos pelo usuário no contexto correto.
Exposição de dados confidenciais, quando invasores podem explorar meios de comunicação inseguros para exfiltrar informações confidenciais ou usar algoritmos criptográficos inseguros em contextos de segurança. Entre as medidas de mitigação estão o uso de TLS como meio seguro de comunicação e a criptografia ou o hash de senhas e outras credenciais com algoritmos criptográficos seguros e apropriados.
Falhas no controle de acesso, que permitem que invasores acessem recursos aos quais não deveriam ter acesso. Para mitigar o problema, implemente mecanismos adequados de controle de acesso, como negar o acesso por padrão e adotar um modelo de autorização restritivo. Quando pertinente, aplique limitação de taxa para reduzir tentativas de força bruta e abusos do serviço.
Observação: para consultar a lista completa, veja o guia OWASP Top 10 2017.
8. Proteja e verifique os dados em trânsito
Como mostra o httparchive sobre o uso de HTTPS, a adoção de um meio seguro de comunicação na Web está crescendo à medida que as práticas recomendadas são aplicadas: o serviço informa que 77% de todo o tráfego monitorado usa HTTPS. As funções e os serviços com os quais elas se integram, sejam de terceiros ou estejam dentro dos perímetros da nuvem, também devem usar um meio seguro de comunicação.
Siga estas diretrizes para garantir a comunicação segura dos dados em trânsito:
Use HTTPS como meio seguro de comunicação tanto dentro do seu perímetro interno, entre funções ou serviços chamados, quanto com serviços fornecidos pela nuvem e serviços de terceiros hospedados fora do provedor de nuvem.
Verifique os certificados SSL para confirmar a identidade com a qual você está se comunicando e interrompa toda a comunicação se a identidade e a autenticidade do servidor não corresponderem ao certificado.
Ative as solicitações assinadas nos provedores de nuvem que oferecem suporte a esse recurso.
Trate as respostas de serviços de terceiros como entradas não confiáveis do usuário e sanitize-as.
Meio seguro de comunicação para serviços na nuvem
Sempre que possível, use um meio seguro de comunicação para acessar serviços e recursos locais à infraestrutura do provedor de nuvem. Por exemplo, quando uma função AWS Lambda se integra ao SNS, ela deve optar por se comunicar via SSL:
Solicitações assinadas
Ao usar ferramentas de provedores de nuvem, como o AWS SDK e a AWS CLI, para criar solicitações HTTP, elas incluem automaticamente uma assinatura no cabeçalho HTTP ou nos parâmetros de consulta, que identifica a solicitação HTTP. Isso protege ainda mais os dados em trânsito e ajuda a evitar ataques de repetição HTTP.
Por exemplo, em uma solicitação assinada da AWS, a assinatura é adicionada à mensagem HTTP como um cabeçalho Authorization:
9. Armazene segredos com segurança
Armazene seus segredos e credenciais confidenciais em um local seguro, compatível com os principais provedores de nuvem e FaaS. Como alternativa, você pode implantar suas próprias soluções, como o Vault da HashiCorp. Armazenar chaves em um repositório seguro de segredos reduz os riscos de manter informações confidenciais em arquivos estáticos de um repositório de código-fonte ou em variáveis de ambiente, além de diminuir bastante a possibilidade de exposição dessas informações.
O exemplo a seguir usa o AWS Systems Manager, projetado para buscar segredos criptografados com segurança pelo AWS Parameter Store. No exemplo, a variável SSM acessa um valor específico criado previamente e o disponibiliza para uma função por meio de uma variável de ambiente:
Observe que ${ssm:/github/api-key} retorna o valor criptografado dessa chave. Para descriptografar e retornar o valor real, precisamos especificar ${ssm:/github/api-key~true}.
Você encontra mais informações sobre o Parameter Store e o KMS na documentação da Amazon: https://docs.aws.amazon.com/kms/latest/developerguide/services-parameter-store.html
Para aumentar ainda mais a segurança e a flexibilidade no gerenciamento de segredos em aplicações, considere acessar os segredos e outras informações de configuração durante a execução, em vez de usar variáveis de ambiente, que exigem a reinicialização do processo para aplicar novas configurações.
Embora o armazenamento de segredos reduza a possibilidade de uma chave vazar, ele não a elimina por completo. Felizmente, se você armazena segredos na sua função, não importa qual é o valor real da chave... então você pode trocá-la regularmente! Assim, se a chave vazar ou for roubada, ela só será útil por um curto período.
10. Implante funções com granularidade mínima
Por princípio, espera-se que as funções sejam pequenas, assim como o código implantado com elas. Isso reduz a superfície de ataque e a quantidade de informações que podem vazar se a função for comprometida. Não é recomendável implantar funções em lote nem incluir mais código e funções do que o necessário.
Por padrão, as funções que fazem parte do mesmo projeto serverless compartilham as mesmas dependências. Por exemplo, projetos serverless de Node.js compartilham um único arquivo package.json, com dependências implantadas em todas as funções, embora nem todas sejam explicitamente necessárias para cada uma delas.
Como você provavelmente reutiliza bastante código padrão, pode ser útil usar modelos para estruturar projetos, por exemplo:
Baixe o guia rápido de boas práticas de segurança para Serverless para consultar sempre que precisar. Crie também uma conta gratuita no Snyk e comece a proteger seu código hoje mesmo!
Comece a participar de desafios de Capture the Flag
Aprenda a resolver desafios de Capture the Flag assistindo sob demanda ao nosso workshop virtual introdutório.