Snykのセキュリティ専門知識でコンテナセキュリティをシンプルに

Hadas Bloom
2022年3月8日
0 分で読めますオープンソースコードの最も素晴らしく、刺激的な点は、何と言ってもオープンソースであることです。オープンソースのパッケージは、エンジニアリングの世界で開発者同士が交換する贈り物のようなものです。他の人の成果から学び、自分の専門知識を提供し、専門能力を高めることができます。オープンソースへの貢献は大いに歓迎されます。こうしたプロジェクトの恩恵を受けるだけでなく、コミュニティに還元することも大切です。知識を共有し、パッケージを新たな技術の基盤とするコミュニティの協力によって、オープンソースは絶えず進化しています。
しかし、無料で利用できるライブラリやプロジェクトには、意図しないミスや悪意ある攻撃者によるリスクも伴います。だからこそ、Snykが必要なのです。
新たな、あるいは進化したLinuxディストリビューションやDockerのようなコンテナツールなど、オープンソース技術の進化に伴い、これらのオープンソースパッケージをまとめたイメージが次々と作成され、利用されています。基本的に、コンテナイメージとは、アプリケーションの実行に必要なコード、ライブラリ、依存関係、その他のツールやファイルを含むファイルです。そして、コンテナはそのイメージを実行したインスタンスであり、アプリケーションを実行・開発する「空間」を定義します。コンテナを使うと、コードを動かす環境を作成できます。その環境はイメージに依存し、実際にイメージから起動します。さらに、コンテナイメージの最も強力な特長の一つは、イメージを積み重ねて構築できることです。まず基本的なLinux要素だけを含むイメージ(Dockerのalpineなど)を用意し、その上に言語固有のツールやフレームワークを追加して言語固有のイメージを作成します。さらにその言語の開発ツールを重ね、最後に独自のコードを追加できます。
イメージが複数のパッケージをまとめたファイルにすぎないなら、どの脆弱性が影響するかを判断する際に、何が課題になるのかと疑問に思うかもしれません。オープンソースパッケージに脆弱性があり、そのパッケージがイメージで使われているなら、そのイメージにも脆弱性があると考えてよいのでしょうか。素晴らしい質問です。ありがとうございます。先ほどの例のalpineのようなベースイメージを使うと、さまざまなツールや機能を利用できますが、それぞれのパッケージが内部に脆弱性を持ち込む可能性もあります。つまり、独自のコード内の脆弱性を見つけるだけでは不十分です。ベースイメージと、ツールを重ねて作成するすべてのイメージが安全であることを確認する必要があります。
この記事では、イメージの最初の部分、つまり最初に選んで土台とする親イメージ(例のalpine)に焦点を当てます。このレイヤーには、Linuxの主要なパッケージの多くが導入され、Linuxのパッケージマネージャーも追加されます。また、他に追加するものと比べて、ベースイメージに何が含まれるかを自分で制御しにくいため、混乱が生じやすい領域でもあります。そこで、コンテナの脆弱性をめぐる課題を詳しく見たうえで、Snykがどのように解決を支援するのかを紹介します。
コンテナ環境におけるLinuxの脆弱性を理解する
パッケージ管理システム
Linuxディストリビューション(Alpine、Debian、Ubuntuなど)には、それぞれ独自のメンテナーがいます。いずれもLinuxのバージョンを提供しているため共通点はありますが、更新時の命名規則やバージョン管理方式は各自で決められます。そのため、上流の対応パッケージと同じ名前やバージョンが使われるとは限りません。特定の問題への修正やシステム全般のパッチの詳細を確認すると、ディストリビューションごとにユーザーへの案内が異なる場合があります。
例として、有名なlog4jパッケージにおけるCVE-2021-44228(Log4Shellとも呼ばれます)の修正を見てみましょう。Maven上でApacheチームが管理する上流パッケージの名前はlogging-log4j2で、この重大な脆弱性への修正はバージョン2.15.0でリリースされました。一方、Debianユーザー向けのパッケージ名はapache-log4j2で、現行安定版のDebian 11(「bullseye」)ではバージョン2.15.0-1~deb11u1で修正がリリースされました。Ubuntuでも名前はDebianと同様にapache-log4j2ですが、最新リリースのUbuntu 21.10での修正版は2.15.0-0.21.10.1です。
CVE-2021-44228の修正済みパッケージをまとめると、次のとおりです。
パッケージ名 | 修正バージョン | |
|---|---|---|
Java上流(Maven) | logging-log4j2 | 2.15.0 |
Debian 11(「Bullseye」) | apache-log4j2 | 2.15.0~deb11u1 |
Ubuntu 21.10(「Impish Indri」) | apache-log4j2 | 2.15.0-0.21.10.1 |
この比較的単純な例から、セキュリティアナリストが上流のオープンソースパッケージの脆弱性を発見、またはトリアージしたとしても、各Linuxディストリビューションでどのパッケージがそれに基づいているのか、影響を受けるバージョンは何か、あるいはそのディストリビューションが影響を受けるのかを、すぐに判断できないことがわかります。各イメージに取り込まれたパッケージには、それぞれ異なるトリアージプロセスが必要です。
命名とバージョン管理がこのように行われるのは、各Linuxディストリビューションのチームが独自のバージョンを追跡し、独自の形式に基づいて使用している上流バージョンを把握し、パッケージを管理しやすくするためです。各ディストリビューションは、エコシステム内で使用するパッケージのビルドやコンパイルのすべてを管理し、その責任を負います。独自のパッケージ名とバージョンを維持することで、パッチリリースやバックポートをシステム内で適切に管理できます。
最も正確な見方は、入手元に応じて、すべてのパッケージをそれぞれ別のものとして扱うことです。たとえPyPIやMavenなどで管理されるパッケージと同じ名前でも、特定のLinuxディストリビューションのパッケージマネージャーにあるパッケージは、異なるチームがその環境やニーズに合わせてコンパイルし、保守している別個のパッケージとして扱う必要があります。
データの用語と構造
Linuxディストリビューションごとにパッケージ名やバージョンが異なるだけでなく、各ソースが提供するセキュリティデータのさまざまな要素を定義する用語にも違いがあります。
たとえば、「Critical(重大)」の定義が異なる場合があります。あるチームは「Critical」を比較的広く使う一方、別のチームは通常「High(高)」を使い、非常に限られた状況でのみ脆弱性を「Critical」と分類するかもしれません。
反対に、異なる用語が実際には同じ意味で使われることもあります。たとえば「Moderate」と「Medium」は、チームによって同じ深刻度を表すために使われる場合があります。
また、チームがたとえば「Important(重要)」という用語を使う場合、問題修正の優先順位という観点での重要度と、脆弱性そのものの重要度(つまり、深刻度が比較的高いこと)を区別する必要があります。
この複雑さを説明するため、Debianに影響するCVE-2021-3507を見てみましょう。
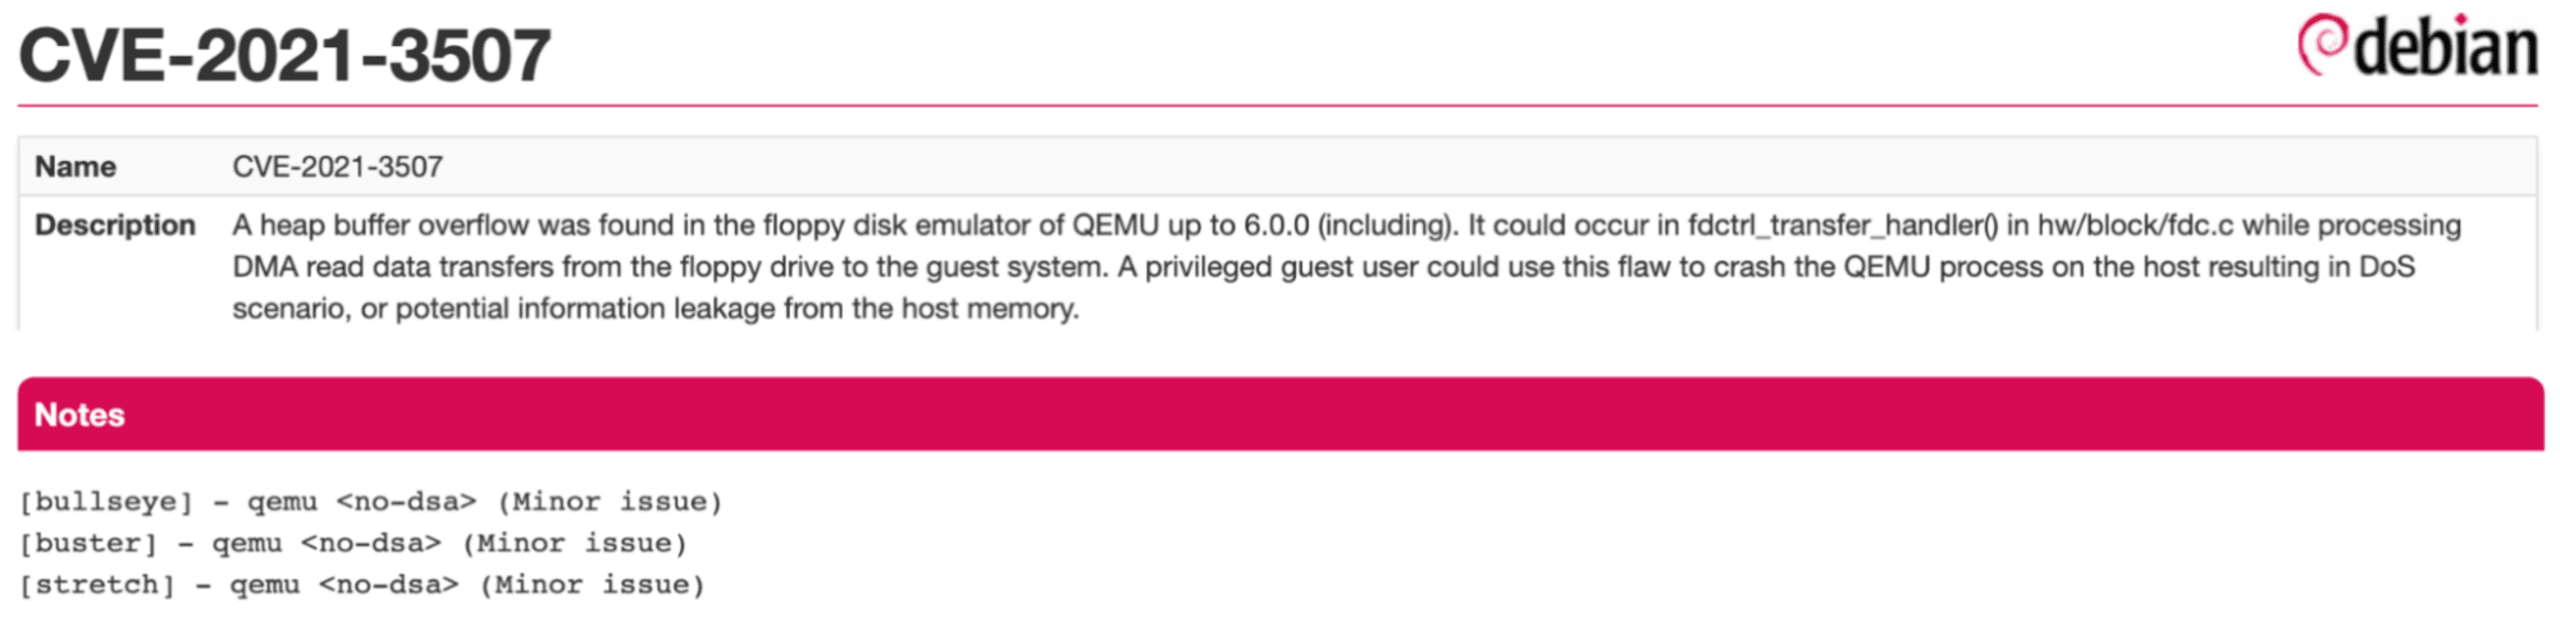
参照先のアドバイザリにあるとおり、このCVEはStretch(Debian 9)、Buster(10)、Bullseye(11)に対して<no-dsa> (Minor issue)と分類されています。これは、Debianのメンテナーが各バージョンでこの問題をどの程度深刻と見ているかを示しています。
一方、NVDはこのCVEに「Medium(中)」のCVSSスコアを付与しました。これは脆弱性をより広く分析した結果であり、とりわけ上流パッケージのqemuに関係しています。
膨大なデータ
各Linuxディストリビューションとその各リリースには、多数のパッケージが標準で含まれており、各ディストリビューションのリポジトリからさらに多くのパッケージをダウンロードできます。その結果、コンテナには複数の言語で書かれたパッケージに影響する脆弱性が、何百件も含まれる可能性があります。コンテナ環境における膨大な脆弱性データは、Snykやセキュリティチーム、コンテナを使う開発者にとって、個々の脆弱性をトリアージして理解し、対処方法を判断するうえで課題を複雑にします。そのため、脆弱性を一つひとつ詳しく調査するのは非常に困難です。
コンテナの脆弱性に固有のこうした問題は、コンテナ内の最も正確なデータを特定するという課題につながります。特定のコンテナに関係する脆弱性はどれか、そしてLinuxカーネルやコンテナ内で実行されるアプリケーションとの相互作用を踏まえた実際のリスクは何か。Snykのコンテナ脆弱性チームは、こうした問いにできる限り正確に答えるべく、継続的に取り組んでいます。さまざまな要素を考慮し、脆弱性を正確に特定して優先順位を付ける複雑なモデルを構築しました。
こうした課題をどのように解決するのか
課題の複雑さを明らかにしたところで、最も正確なデータを特定するための解決策を見ていきましょう。適切なコンテナ脆弱性を収集、分析し、提示するプロセスは、多数のソースから大規模なデータをスマートに自動処理でき、必要に応じて人による対応も促す、スケーラブルなパイプラインから始まります。セキュリティの専門知識と、欠けている補足情報を提供してくれる各Linuxディストリビューションのセキュリティチームとの連携を組み合わせた、深い知見が必要です。多くのソースから得た知見をもとに、最も関連性が高く有用な情報を収集し、選び出します。最後に、これらすべての要素と収集できるその他の外部データを踏まえ、脆弱性を個別の状況に即して優先順位付けし、関係のないノイズを減らします。Snykでは、これを次のように実現しています。
SnykはコンテナとLinuxの脆弱性をどのように分析するのか
コンテナセキュリティチームの主な目標は、次の問いに答えることです。どの脆弱性がコンテナに影響し、修正の優先順位はどうすべきか、そしてどのように対処できるのか。
この問いに、できる限り正確かつ網羅的に、タイムリーに答えるための取り組みを少しご紹介します。
タイムリーなデータ収集
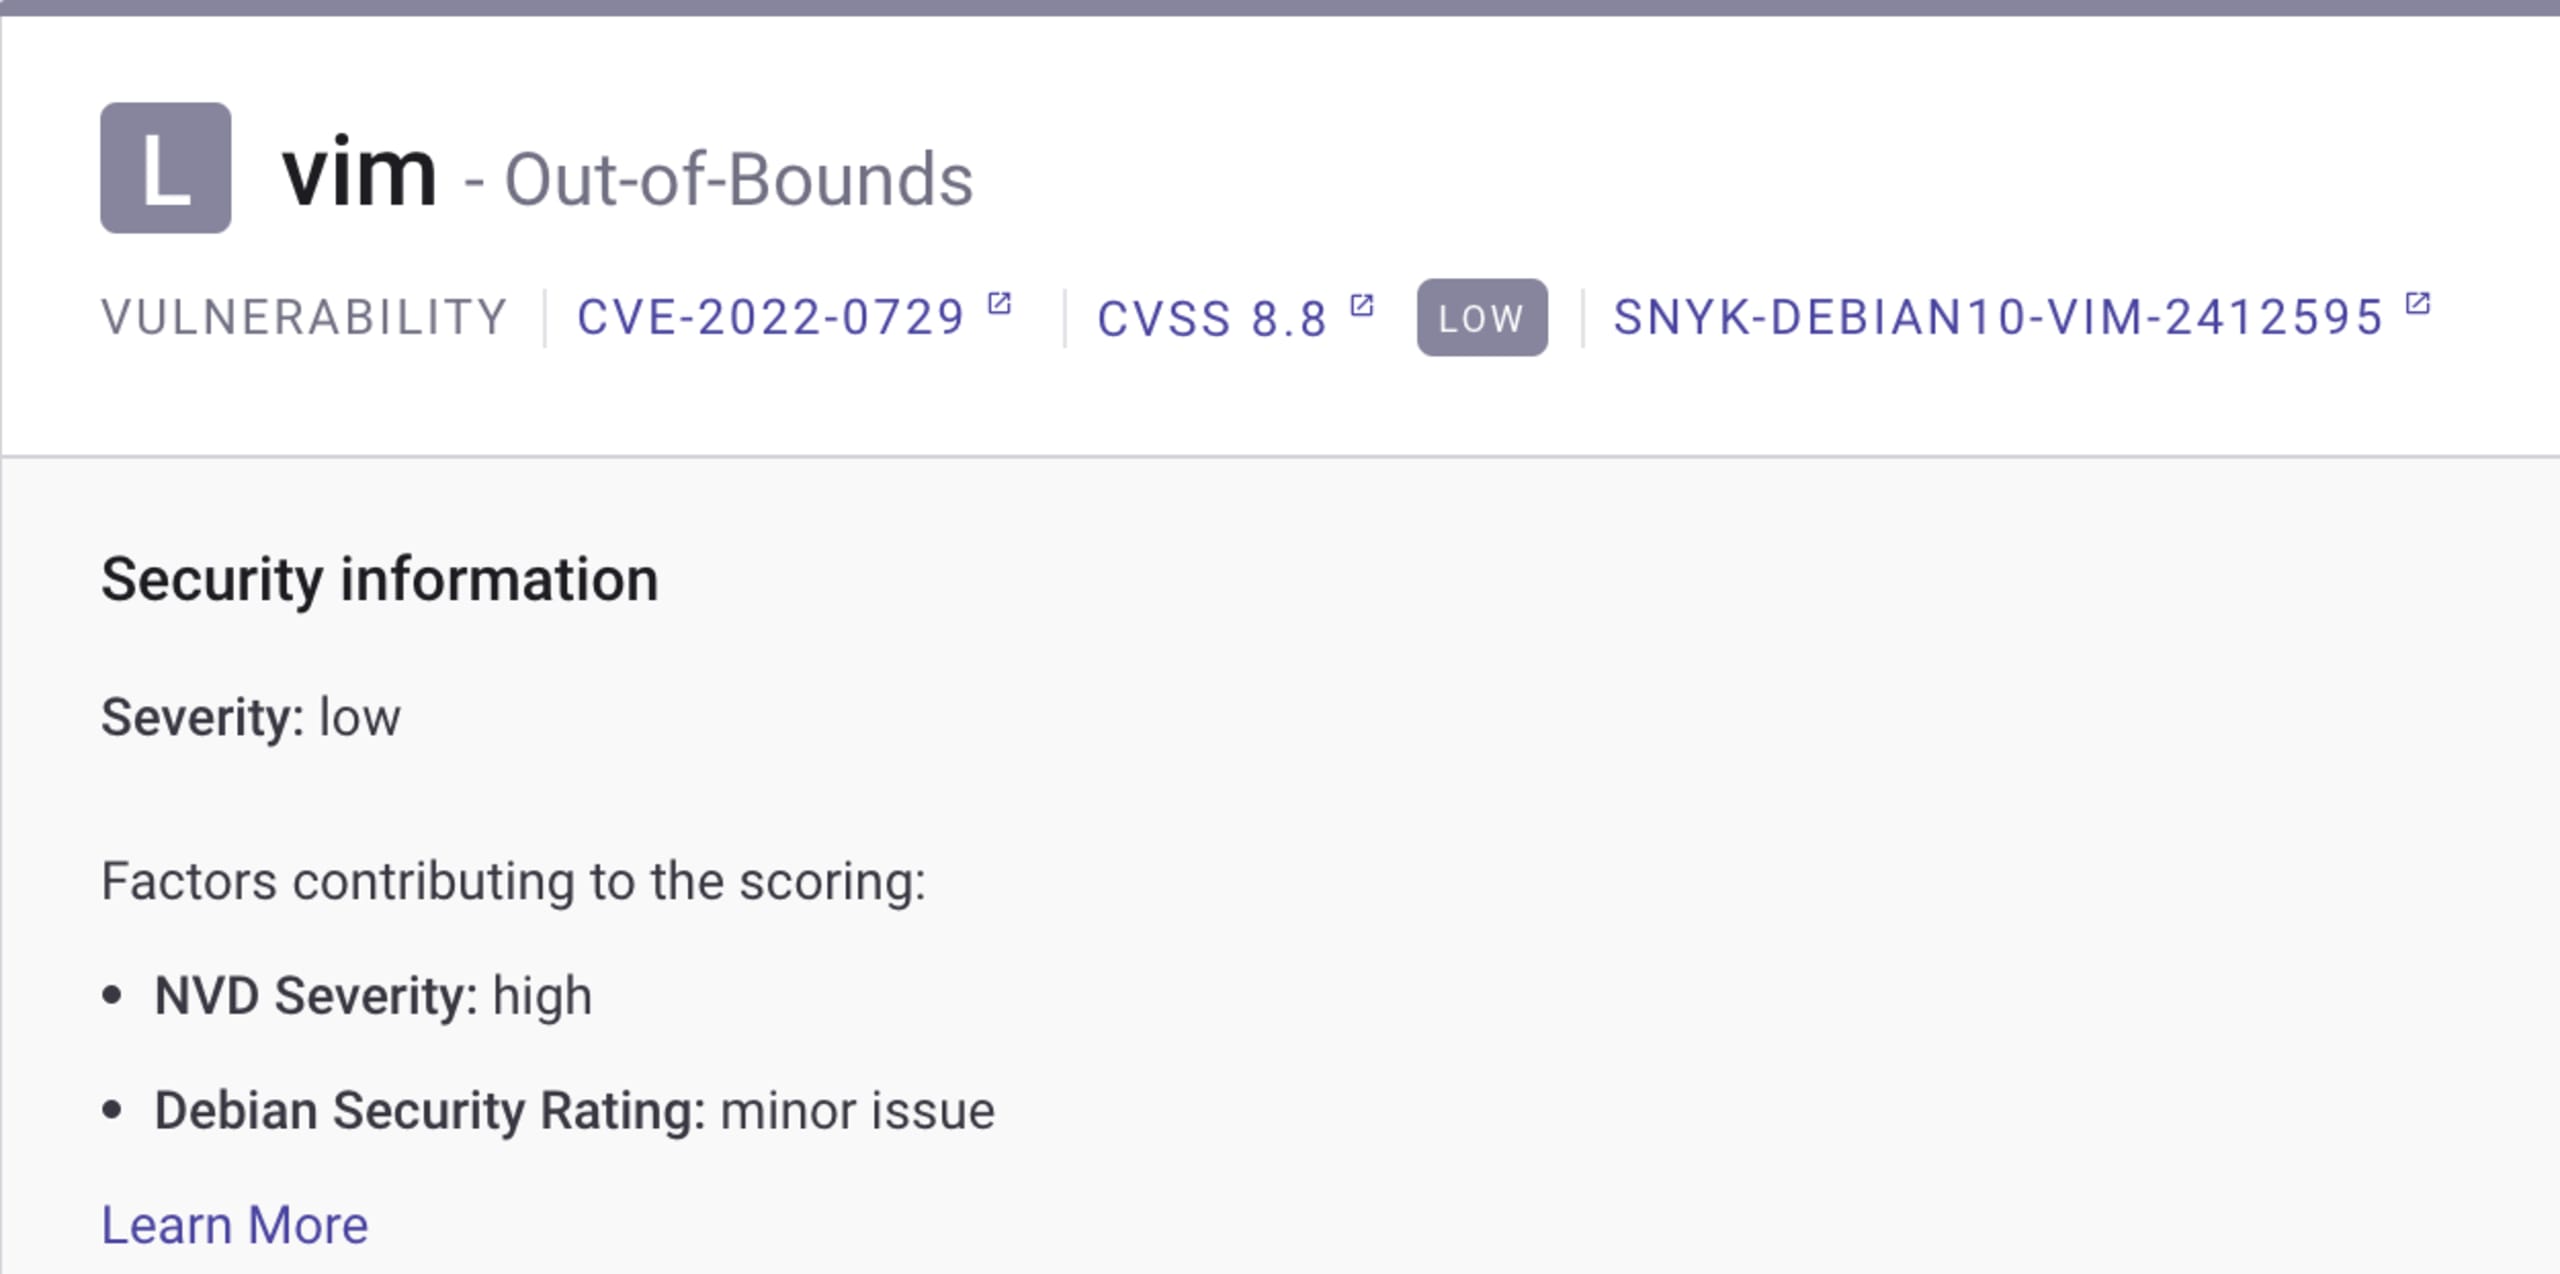
Linuxディストリビューションの各ソースから、セキュリティデータを独自に収集しています。パッケージの新しいリリースやアドバイザリ、ディストリビューションの新バージョンが更新されると、すぐに追跡します。Linuxディストリビューションのソースから新しい情報が得られたら、脆弱性データをただちに更新する必要があります。こうした更新の例は、Snyk Containerの結果で確認できる脆弱性の相対的な重要度です。これは、特定のイメージにおける深刻度を示します。以下の例では、元のCVSSスコアは8.8で、深刻度は「High(高)」とされています。しかし、DebianのメンテナーはDebian 10(このコンテナで使用されているバージョン)における脆弱性を分析し、「軽微な問題」と判断しました。その結果、Snykでは全体的な深刻度が「Low(低)」となっています。これは、数ある問題のうち何を先に対処すべきかを判断し、適切に整理するうえで非常に重要なデータです。
Linuxディストリビューションのエコシステムに関する連携と深い理解
各Linuxディストリビューションのセキュリティデータを把握するため、私たちは調査を行い、構成要素を理解し、データが網羅されていることを確認します。また、トリアージに活用できる可能性がある、各ディストリビューション固有の例外的なケースや追加データも特定します。たとえば、Red Hatのセキュリティ情報の改善に取り組んでいた際、公開されている脆弱性ページには、OVALストリームよりも多くの脆弱性情報が含まれていることに気づきました。たとえば、脆弱性がunder investigationなのか、Red Hatの特定の製品にはnot affectingのか、といった情報です。このことをRed Hatのセキュリティチームに伝えたところ、それ以降、私たちが公式なセキュリティデータソースとして利用しているOVALストリームに、この重要な情報が含まれるようになりました。
人間によるセキュリティの専門知識
前述の調査に基づく自動化中心のプロセスでは、特定の状況においてセキュリティ専門家の判断が必要なケースを特定し、専門家に判断を仰ぎます。たとえば、ディストリビューションによってアドバイザリが削除された場合、取り消す前にその判断が妥当かどうかを確認します。脆弱性に影響があるにもかかわらず自動システムが削除してしまうことを防ぎ、誤検知を避けて開発者の作業負担を軽減するためにも、洗練された取り消しプロセスは非常に重要です。
追加の情報拡充とデータソース
継続的に追加している外部ソースの情報を使って、脆弱性データを拡充しています。これには、NVDのデータ、エクスプロイト情報、Twitterのトレンド、そして最新の発表で紹介したSysdigのランタイムシグナルなどがあります。
コンテキストに応じた優先順位付け
これらすべての情報をもとに、独自の優先度スコアを使って脆弱性の優先順位を決め、深刻度を示し、状況の把握に役立つ追加データを加えます。そして、トリアージや理解に最も役立つ形で脆弱性情報を提示します。
Snyk Containerの脆弱性調査の未来を垣間見る
今後、コンテナの脆弱性に対処するために取り組むべきことは、まだたくさんあります。
その一例が、Snykのセキュリティインサイトです。すでにノイズの多い環境から、できる限りノイズを減らすことを目指しています。特定の状況や条件に関するセキュリティインサイトを提供することで、ある構成、環境、アプリケーションにおいて脆弱性が関係するかどうかをより適切に判断できるようになり、開発者と連携した脆弱性のトリアージにも役立ちます。
現在取り組んでいるSnyk Containerの脆弱性インサイトの例として、ビルド時のパッケージに脆弱性が存在する場合に、その脆弱性を無視するよう提案する機能があります。さらに、影響を受けるビルド時のパッケージを完全に削除することもできます(これにより、同じパッケージに含まれるほかの脆弱性も自動的に解消されます)。これは、ビルド時に脆弱性が悪用される可能性は低く、実行時のアプリケーションに影響する脆弱性をより優先すべきだという初期の仮説に基づく調査によるものです。Sysdig連携の反対の例と考えることができます。Sysdigは本番環境で実行中のものを示すため、脆弱性修正の優先度を高める一方、Snykのビルド時インサイトは、本番環境で実行されないビルドツールに脆弱性がある場合、修正の優先度を下げる(あるいは自動的に無視しやすくする)可能性があります。
さらに、優先順位付けと分析をより効率的に行えるよう、コンテナの脆弱性に追加のメタデータを加える取り組みも進めています。たとえば、脆弱性のfix state(修正される見込みはあるのか、修正がすでにマージされ、リリースを待っているのか)に関する情報や、深刻度やその他の脆弱性の状態をより詳しく把握するためのセキュリティノートなどです。もちろん、現在サポートしていないディストリビューションへの対応拡大にも継続的に取り組んでいます。
コンテナの脆弱性管理は複雑ですが、ひとりで取り組む必要はありません。業界をリードするSnykのインテリジェンスは絶えず改善・進化しているため、安全を維持するのに専門家である必要はありません。必要なのは無料のSnykアカウントだけです。
開発者ファーストのコンテナセキュリティ
Snykは、コンテナイメージとKubernetesワークロードの脆弱性を検出し、自動的に修正します。