リスクベースの優先順位付けを実現する、新しいSnyk Risk Scoreのご紹介


2023年8月17日
0 分で読めます新しいSnyk Risk Scoreのオープンベータ提供を開始しました!従来のPriority Scoreに代わる新しいRisk Scoreは、セキュリティ上の問題がもたらすリスクを正確かつ包括的に把握できるようにすることで、より効果的な優先順位付けを支援することを目的に開発されました。
Risk Scoreは、複数の客観的・状況依存のリスク要因を活用する新しいリスク評価モデルを基盤としています。脆弱性が悪用される可能性と、悪用された場合の影響の両方を測定します。新しいRisk Scoreでは、到達可能性、エクスプロイトの成熟度、EPSS、ソーシャルトレンド、CVSS、推移的依存関係の深さ、ビジネス上の重要度など、従来より多くのリスク要因を考慮し、より包括的で正確なセキュリティインテリジェンスを提供します。
有効にすると、新しいRisk ScoreがSnykのイシューカードに表示されます。カードにはスコアの算出方法の詳細が示され、イシューがもたらすリスクの把握に役立ちます。スコアはSnykのレポートとAPIからも利用できます。
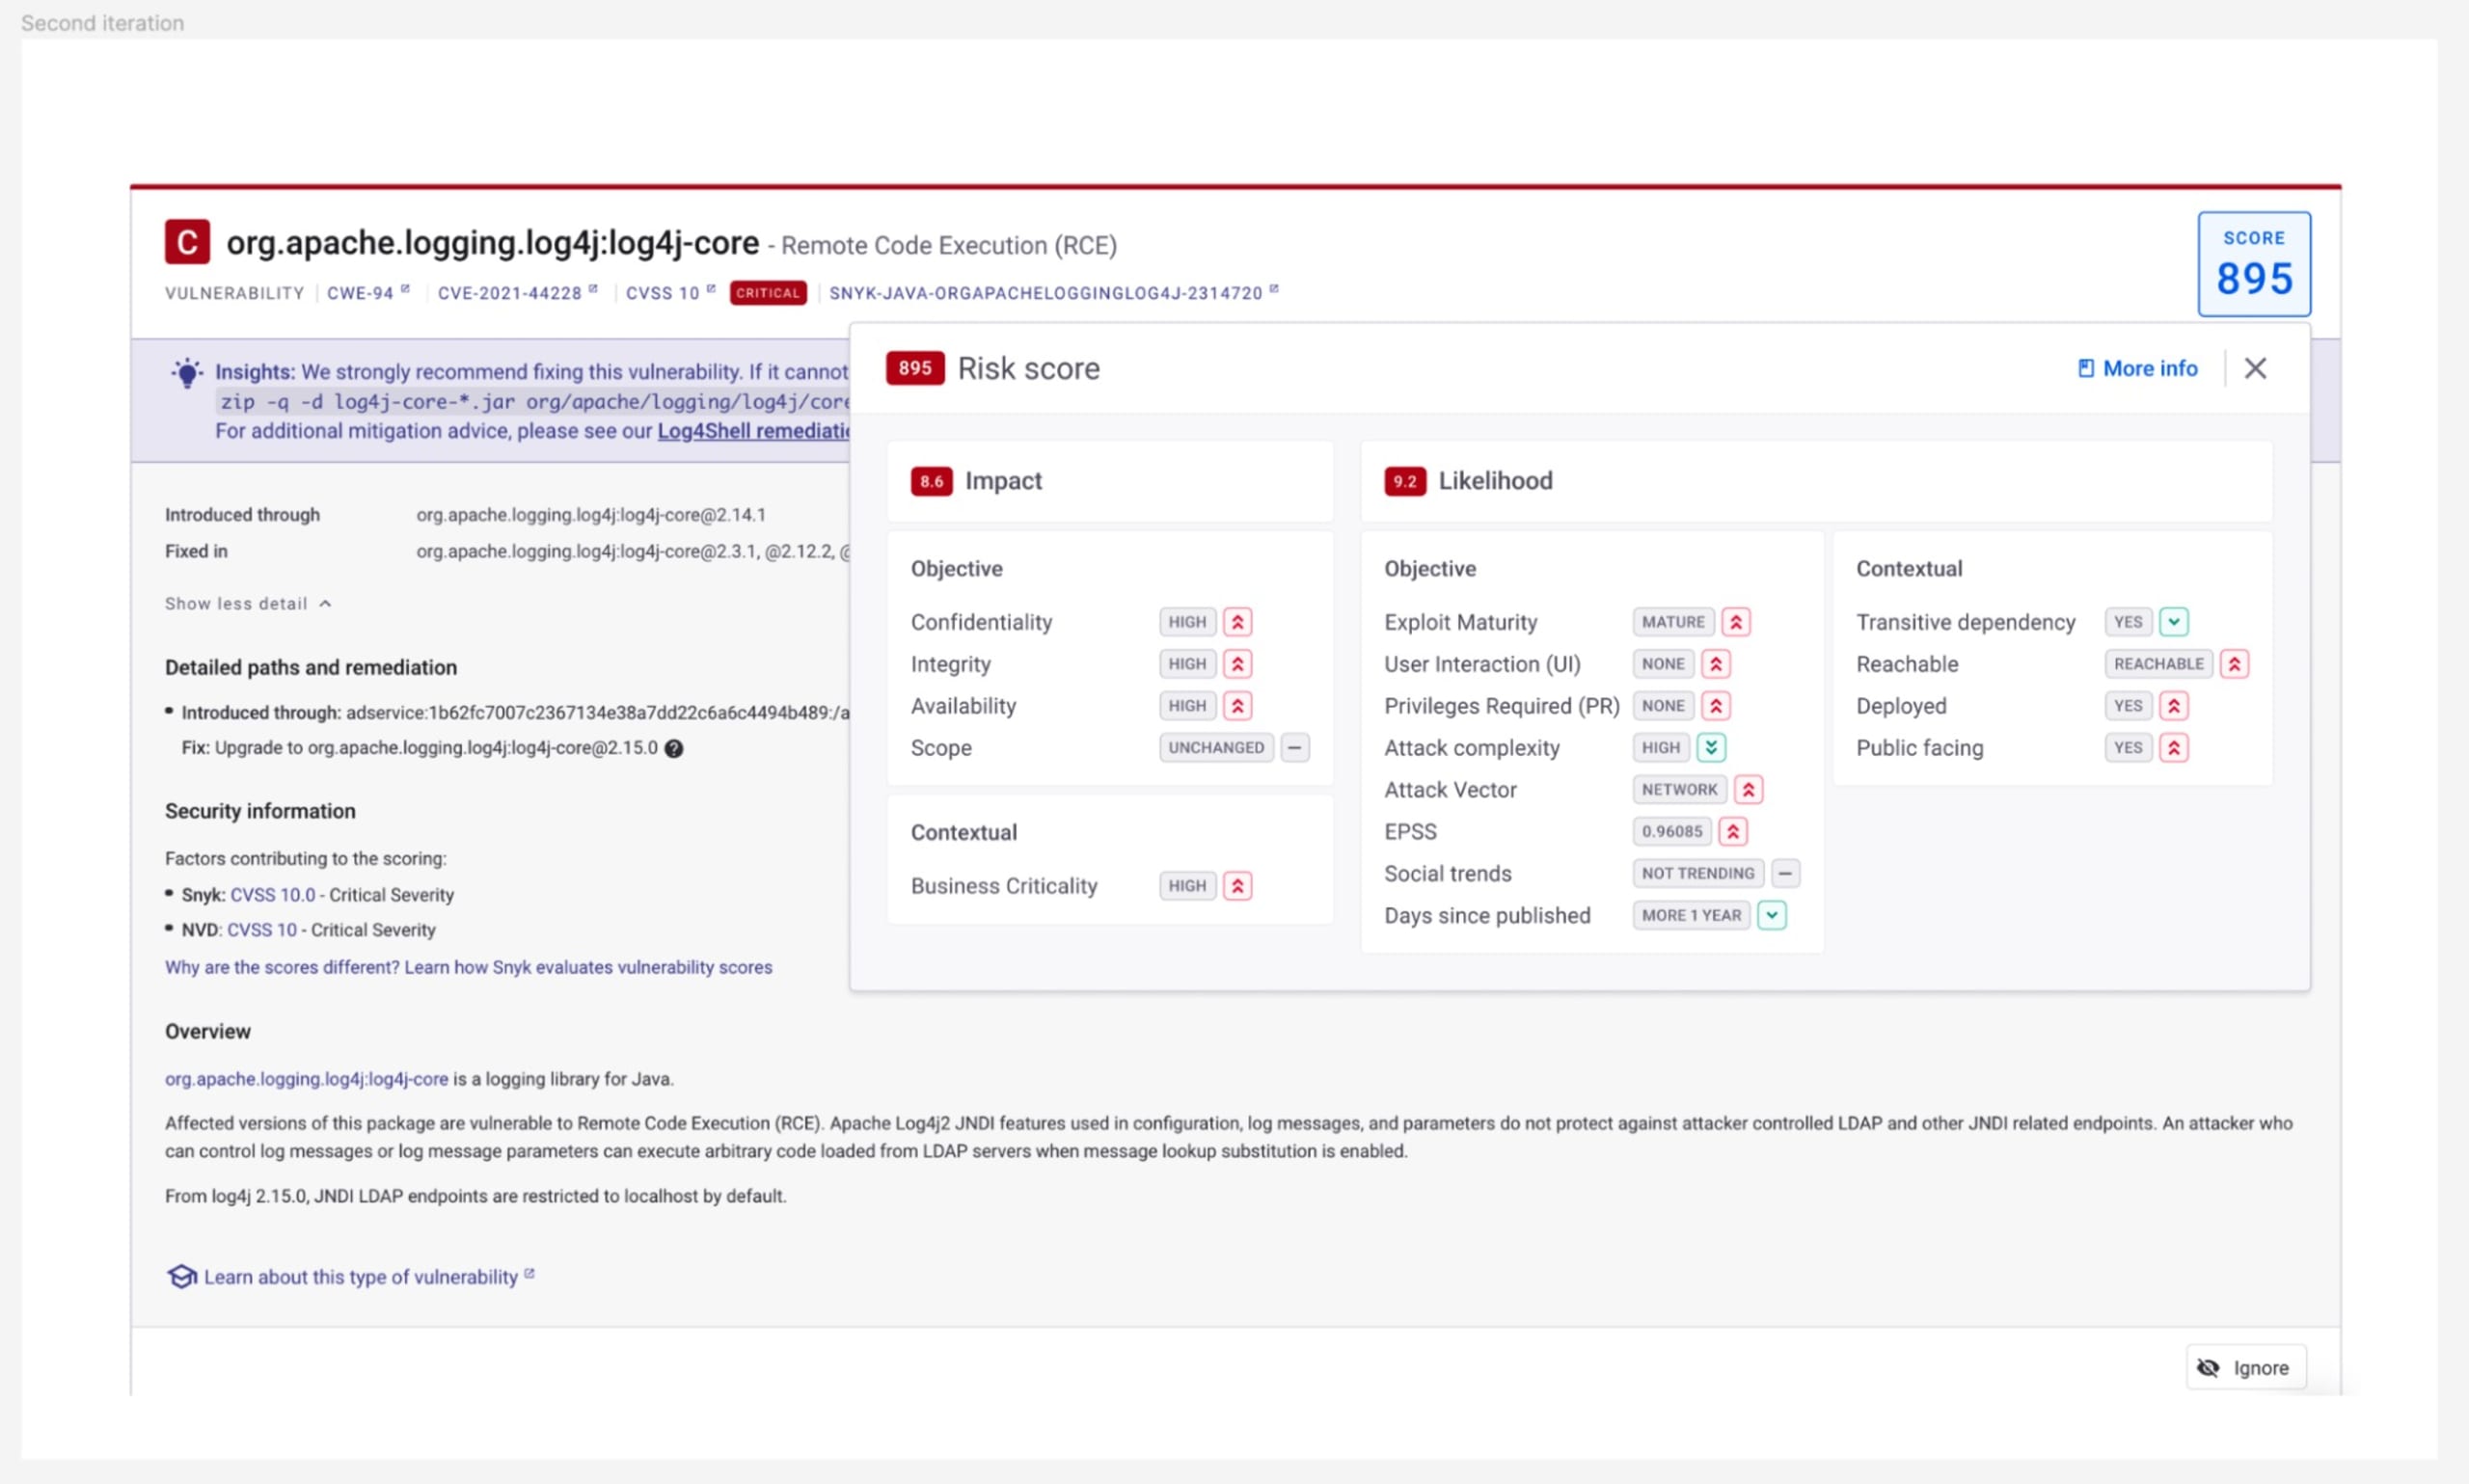
Risk ScoreはSnyk Previewから有効にできます。オープンベータとして、Freeを含むすべてのSnykプランで、Snyk Open SourceとSnyk Containerのイシューに利用できます。Risk Scoreの詳細や使い方については、オンラインドキュメントをご覧ください。
課題:ノイズの多いセキュリティバックログ
ソフトウェアのサプライチェーン全体を通じてソフトウェアを保護しようとする多くのセキュリティチームや開発チームが、現在直面している最大の課題の一つは、シグナルとノイズの比率です。
一方では、コード内で発見される脆弱性の数に終わりがないように思えます。
セキュリティツールはソフトウェアサプライチェーン全体にほぼ普及し、保護すべき脅威対象領域を大幅に拡大するとともに、これまで以上に多くのイシューを生み出しています。
人気のオープンソースライブラリやベンダー提供のソフトウェアでは、日々新たな脆弱性が発見され、トリアージ、優先順位付け、修正が必要な脅威の数は増え続けています。
ソフトウェアの複雑さは増す一方で、コードに破壊的変更を加えずにアップグレードや修正を自動化できるとは限りません。そのため、イシューのトリアージや修正はますます困難になっています。
一方で、すべての脅威が同じではなく、特定されたイシューの大半は当初の想定よりもリスクがはるかに低いことが分かってきています。その一例が、特定のCVEが実環境で悪用される脅威を予測する、FIRSTのEPSS脅威モデリングシステムです。
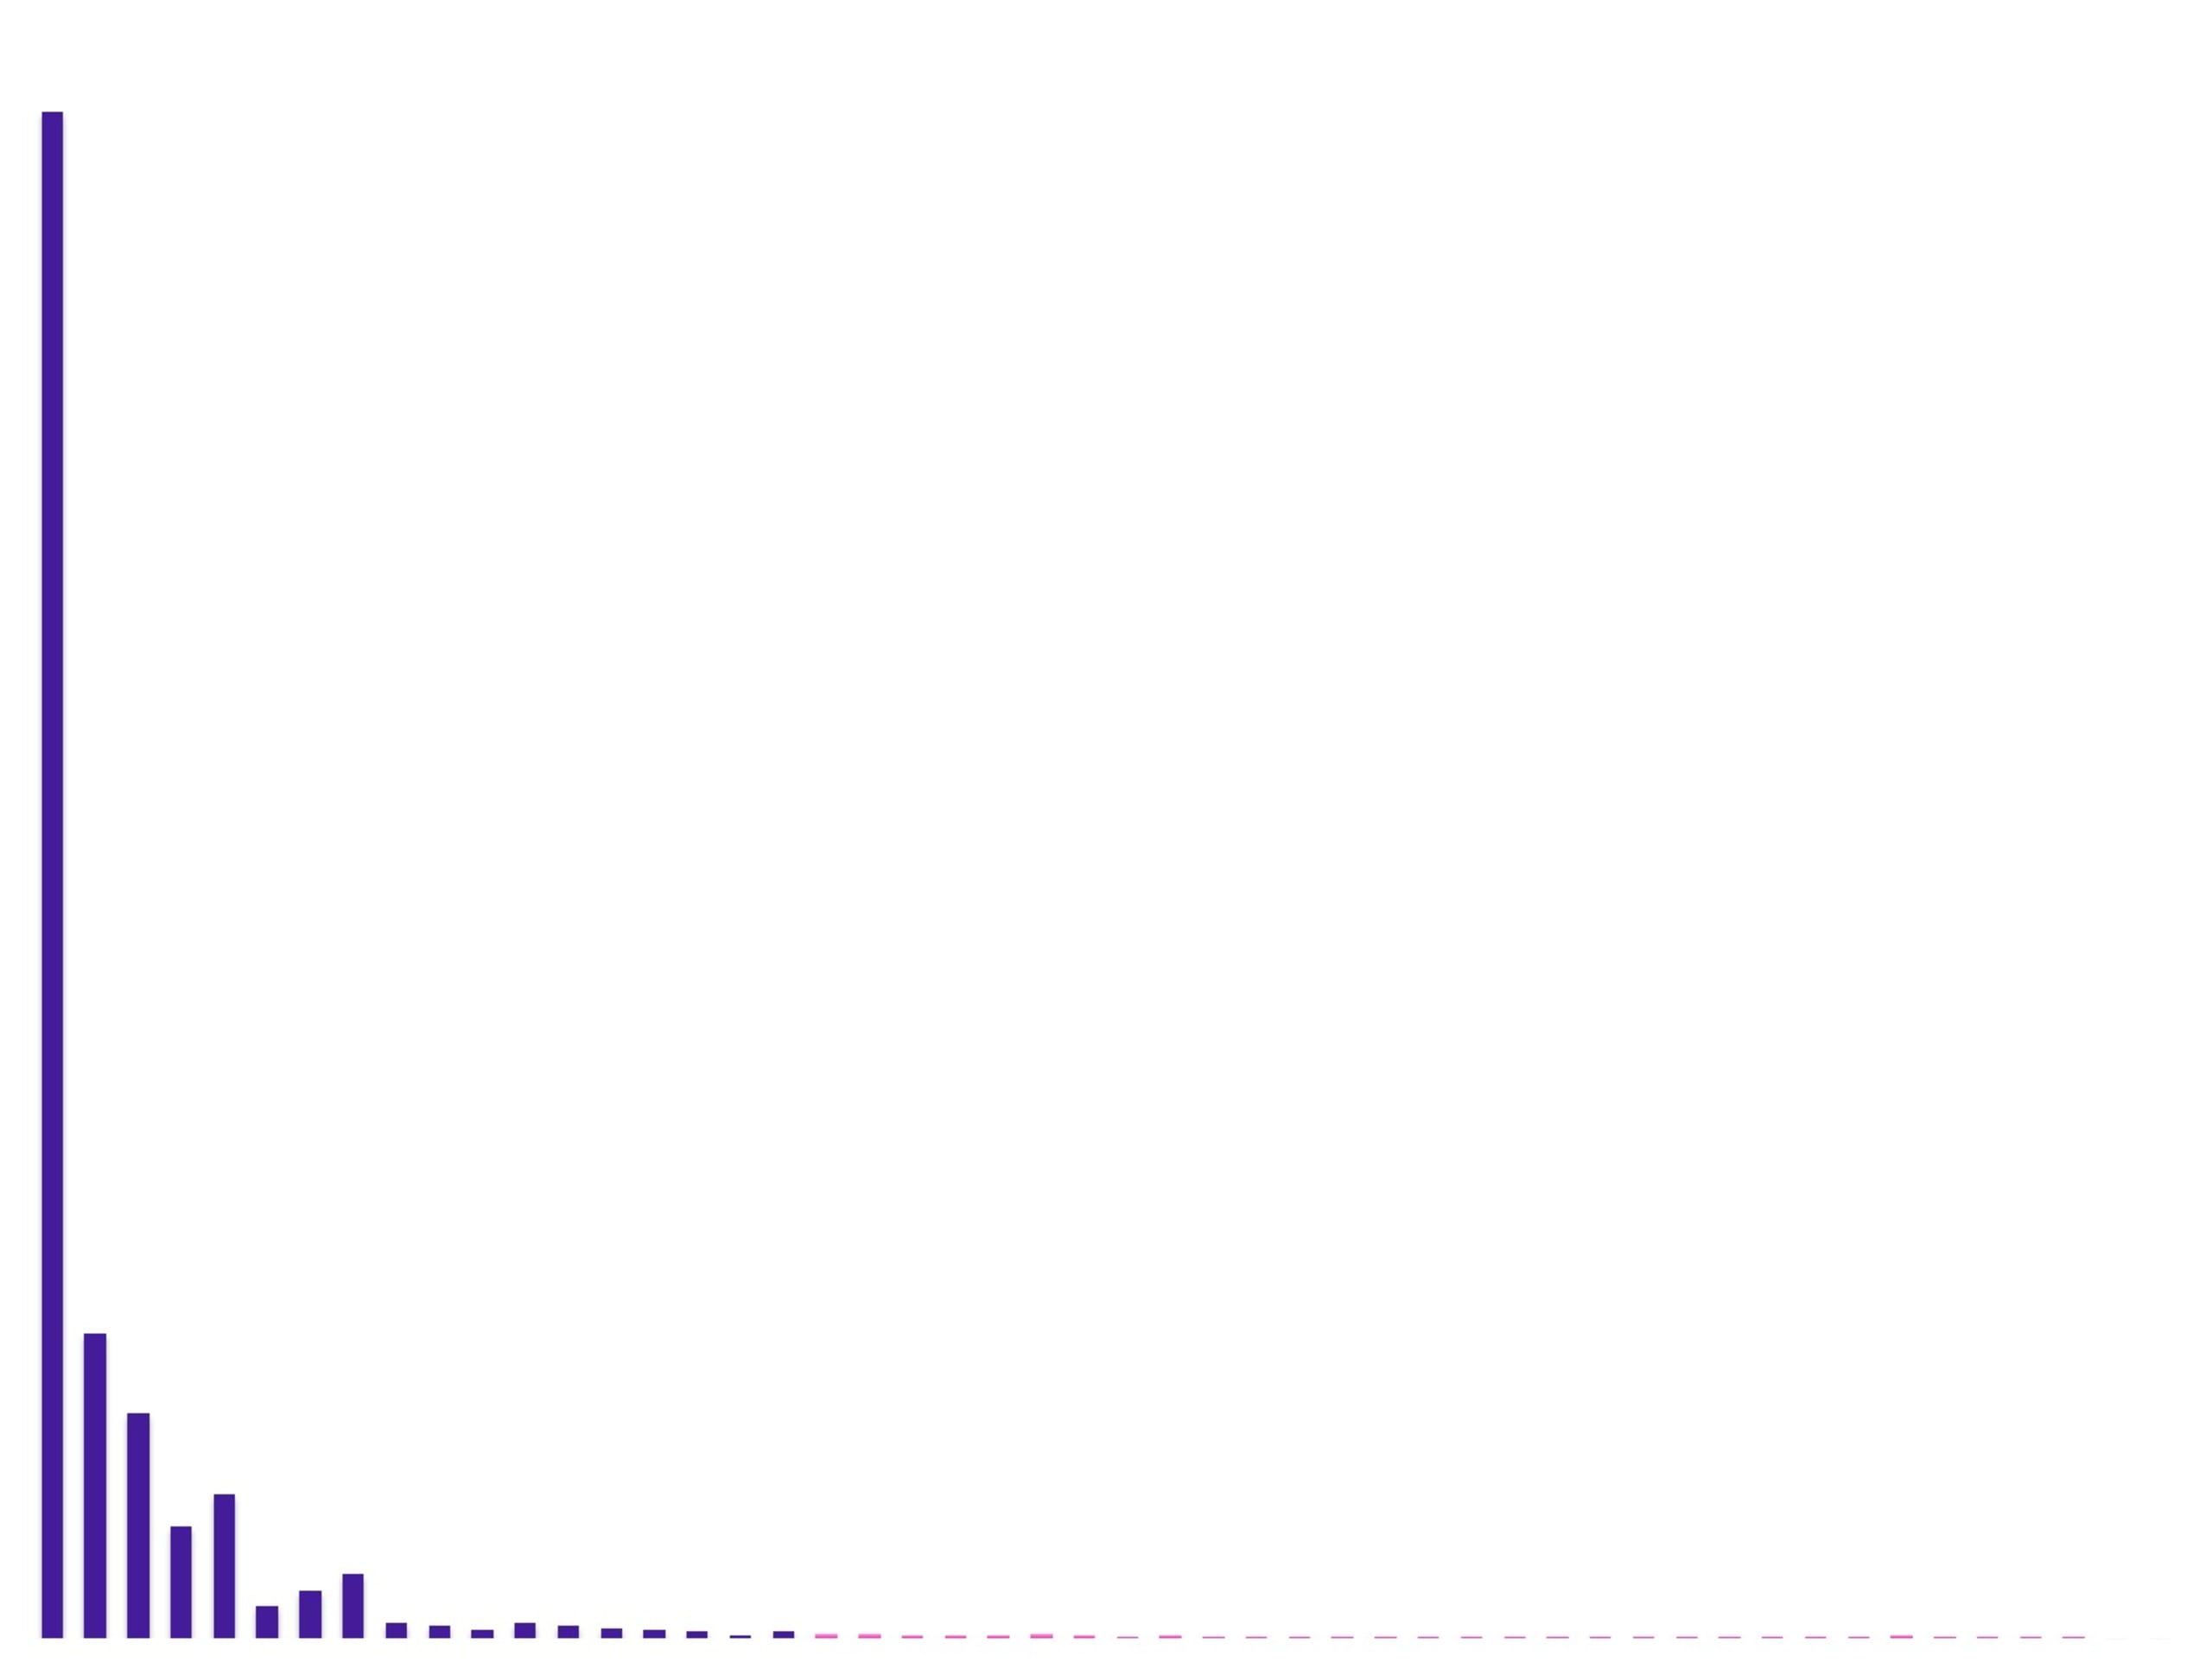
脆弱性の95%超は悪用される可能性がきわめて低く、本当に危険な脅威は99パーセンタイル付近に集中していることが分かります。
これを、セキュリティの専門家がリスク測定に最もよく用いる指標であるCVSS 3.1の深刻度別に脆弱性を分類した結果と比較してみましょう。こちらでは、はるかに多くの脆弱性が「High」から「Critical」の範囲に集中しています。
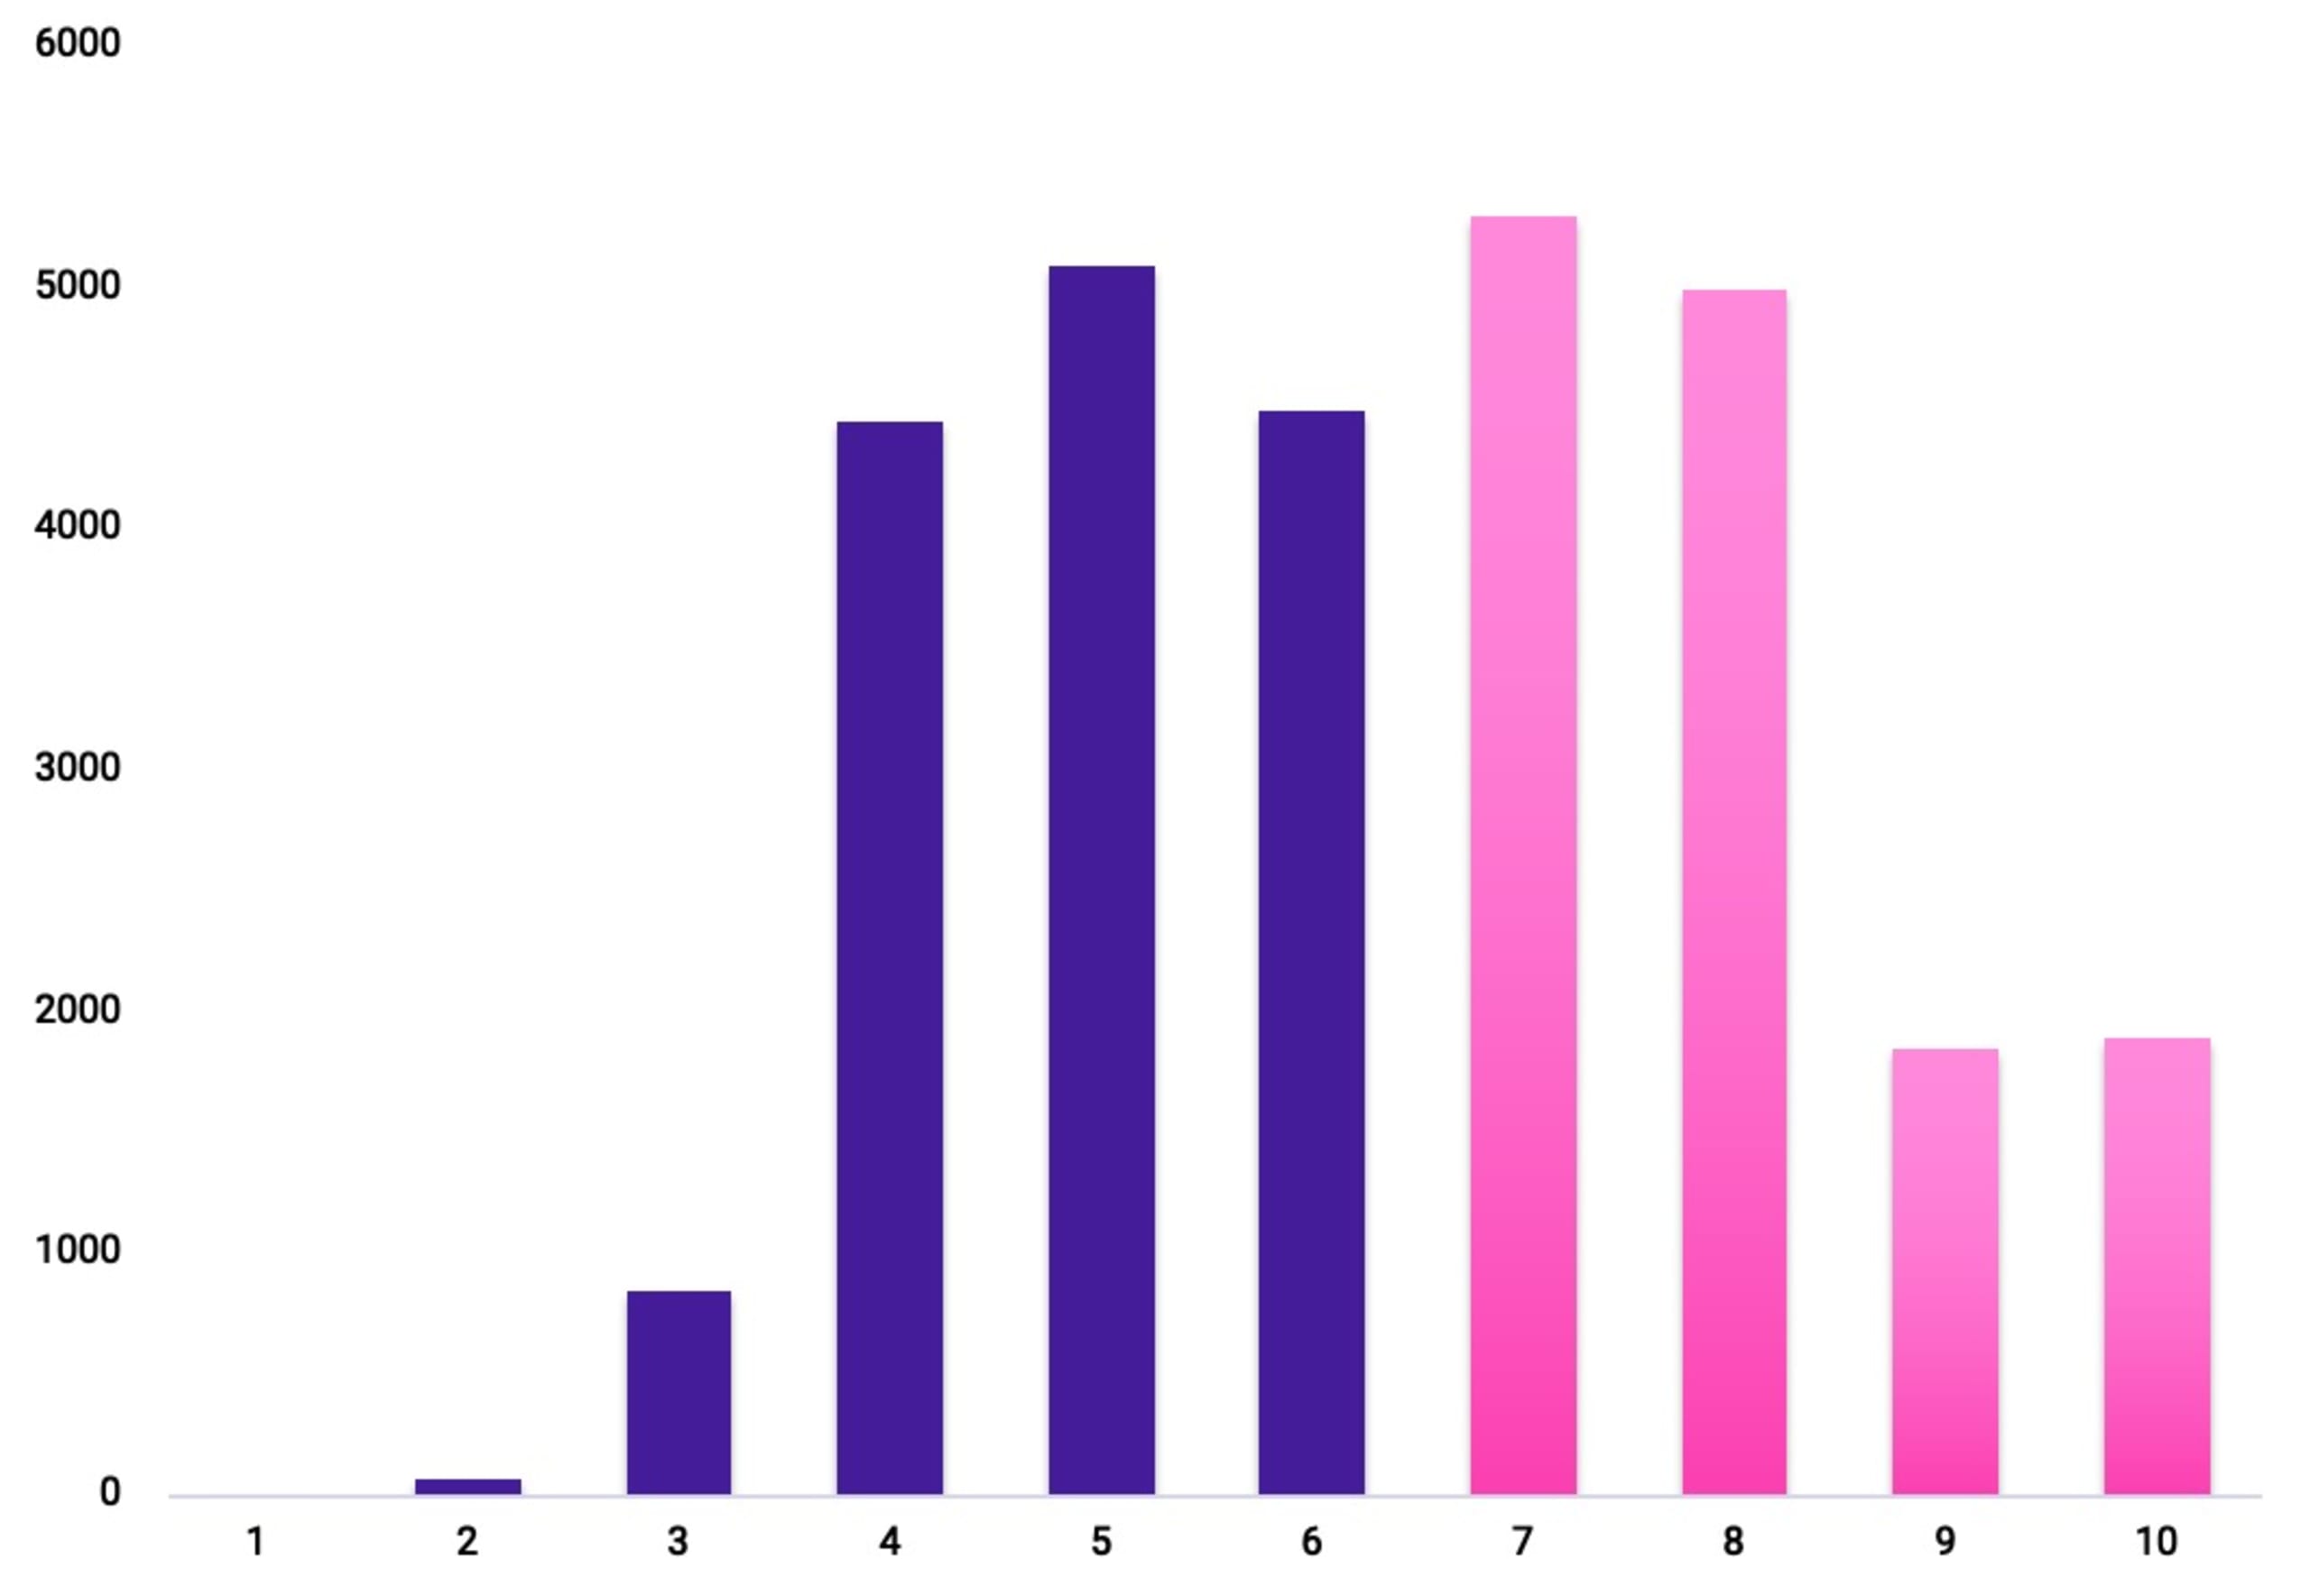
CVSS v4.0に期待しても、状況は変わりません。CVSSフレームワークでは、依然として自社環境に照らしてイシューを手動で分析する必要があり、作業負荷が大きすぎます。
リスクの優先順位付け:特効薬を求めて
当然、ほとんど起こりそうにないリスクを何千件もトリアージして対処するのではなく、最もリスクの高いイシューに時間を集中させるにはどうすればよいのか、という疑問が生まれます。この分野では、特定の脆弱性のリスクを即座に否定できる単一のリスク要因など、特効薬のような方法がいくつも提案されてきました。
エクスプロイトの成熟度またはEPSS - 攻撃が試みられ、成功するかどうかを客観的に予測しようとするものです。予測に基づくため、自社環境は考慮しません。
静的コードの到達可能性 - 使用中のコンポーネントと未使用のコンポーネントを区別しようとするものです。使用中のコンポーネントを見つけるには役立ちますが、それ以外を無視することはできません。また、この要因だけに頼ると、ネットワーク到達可能性やその他の悪用条件など、追加の状況が考慮されず、適切な評価になりません。
推移性 - 推移的依存関係のイシューは考慮不要だという考え方もあります。しかし、Log4Shellをはじめ数多くの脆弱性が、この前提が誤りであることを証明しました。
単純な二元的リスクモデルには、理解しやすいという魅力があります。実際に機能するなら、作業を大幅に減らせるでしょう。しかし、セキュリティやコードの問題は、単純に二分できるものではありません。こうした単純なモデルは、リスクを切り捨てることで危険な脆弱性を見逃すおそれがある一方、実際の脅威ではないものも多く含む一部の脆弱性に、依然として注力することになります。これらの要因を単独または組み合わせて使うには、提示される情報だけでなく、提示されない情報についても全面的に信頼できる必要があります。
Risk Scoreの新しいリスク評価モデルを開発
お客様が直面する優先順位付けの課題を理解したうえで、私たちは次の3つを主な目標として、新しいリスク評価モデルの開発に取り組みました。
二元的ではなく、真の確率的リスクモデルを構築する。
リスク評価に固有の複雑さを考慮し、反映するとともに、人が結果を理解して検証できるモデルを構築する。
個々のユーザー環境に関する状況依存の入力を取り入れ、状況要因をさらに拡充できるようにする。
新しいSnyk Risk Scoreで提供する評価モデルでは、次の2つのリスク要素を考慮します。
可能性 - 特定のリスクが顕在化する可能性、つまり、ユーザーのコード内にある脆弱性が悪用される可能性はどの程度か。
影響 - 悪用された場合、ユーザーにどのような影響が生じるか。
これらの要素はそれぞれ、次の2種類のリスク要因に分けられます。
客観的要因 - 対象のイシューについて客観的に定義され、脆弱性のある環境全般に関係するリスク要因。
状況依存の要因 - 脆弱性のあるアプリケーション環境に応じて定義されるリスク要因。
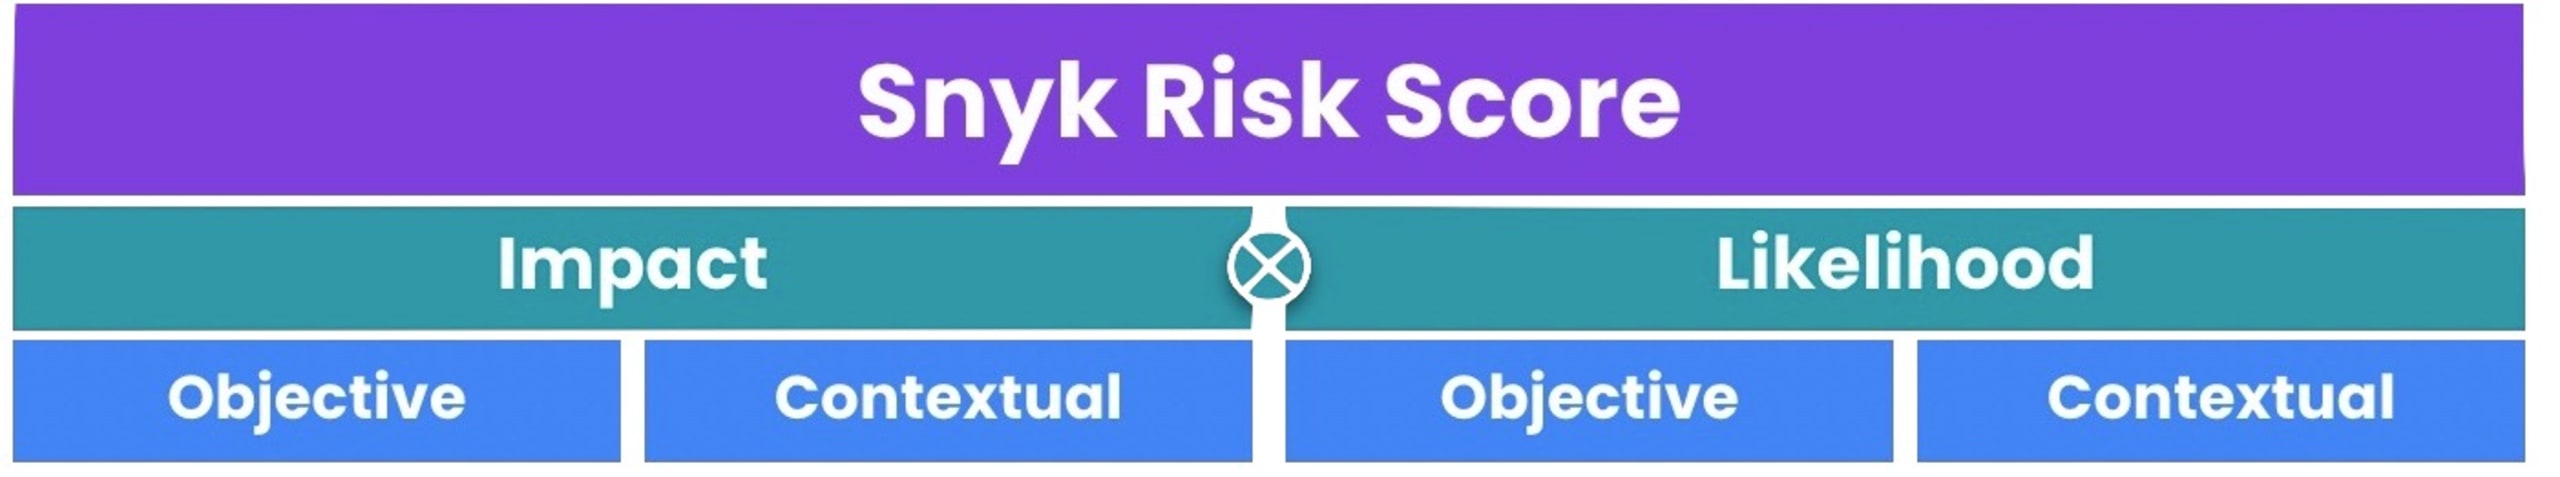
これらのリスク要因をリスク評価モデルのアルゴリズムで組み合わせて計算し、個々のイシューのリスクスコアを算出します。
悪用可能性を客観的に評価するには?
モデルに導入した各リスク要因について、アルゴリズムでの有用性と相対的な予測への寄与度を検証するため、2つの実験を実施しました。まず、Snyk独自の脆弱性データベースと、CISAが公開する実環境で悪用された脆弱性のデータを照合し、無作為に選んだ脆弱性が悪用される可能性の基準値を作成しました。次に、悪用される可能性に影響すると仮定した各リスク要因と、この基準値との相関を調べました。
しかし、相関関係は因果関係を意味しません。そこで、どのリスク要因が悪用可能性の予測に本当に役立つのかを適切に特定するため、さまざまな機械学習モデルを試し始めました。複数回の実験を経て、回帰モデルを使って悪用可能性に統計的に有意な影響を与えるリスク要因を特定し、その結果をアルゴリズムへの入力として活用しました。
最後に、モデルの出力を使って匿名化された数百のプロジェクトをテストし、前述の実際の侵害データから期待される傾向と、モデルが示す悪用可能性の内訳が一致するかを確認しました。
重要なのは状況です
グローバルな視点で悪用可能性を正確に予測できているように見えるのは喜ばしいことですが、個々のユーザー環境における状況依存のリスクも依然として重要です。そこで、社内独自のセキュリティ調査を深掘りし、複数の条件下で特定の脆弱性の悪用を試みました。こうして、到達可能性や推移性といった一見「二元的」な条件を取り入れ、断定的で(しかも不正確な)判断を下すのではなく、アルゴリズムへの確率的な入力として活用できるようになりました。
最後に、Snykでは透明性と信頼を業務の中心に据えています。そのため、イシューの詳細と公開ドキュメントの両方で、スコアにつながるすべての要因と根拠を明らかにしています。
Snykにおけるリスクスコアの今後
Snykでは、AppSecチームと開発チームが、自らの優先順位付けの方法を決められるべきだと考えています。企業によって、さまざまなアプローチが見られます。
リスク重視 - Snyk Risk Scoreのようなリスク分析モデルに基づくスコアで、イシューを絞り込み、並べ替える。
コンプライアンス重視 - コンプライアンス要件が厳しい場合、CVSSで定義された「High」または「Critical」のイシューすべてに対応する必要があります。前述のとおり、対象となるイシューは多くなるため、リスクスコアを使って重要度の高いものを並べ替え、絞り込むことができます。
対応のしやすさ重視 - 修正に必要な工数に応じてイシューを分類する。リスクスコアに工数を組み込むべきではありませんが、修正に必要な労力を優先順位付けの別の軸として加えることには意味があります。
独自のリスク許容度や知見をお持ちの場合もあるでしょう。今後、Snyk Risk Scoreではスコアをカスタマイズし、自社環境に関する知識を反映できるようにする予定です。予測モデルを活用してイシューを排除するのではなく、優先順位を付けられるようになります。
Risk Scoreを使い始めるには、今すぐSnyk Previewで有効にしてください!