Évaluation de la remédiation sécurisée et fonctionnelle : comment Snyk Agent Fix améliore de plus de 14 % le taux de correction des modèles de pointe


18 août 2026
0 minutes de lectureRésumé
Nous avons évalué la capacité des principaux modèles à produire des corrections de vulnérabilités à la fois sécurisées et fonctionnelles, sur environ 150 exemples de code réel vulnérable en JavaScript, Java et Python. Nous avons testé chaque modèle seul, puis avec Snyk Intelligence (la nouvelle architecture agentique Agent Fix). Principaux résultats :
Les modèles de pointe utilisés tels quels se regroupent entre 72 et 75 %. Gemini 3.1 Pro, Claude Sonnet 4.6 et Claude Opus 4.6 obtiennent des résultats à quelques points les uns des autres. Pour les corrections sécurisées et fonctionnelles, le choix du modèle change à peine le résultat.
Snyk Intelligence permet aux mêmes modèles de sortir de ce groupe. Opus 4.6 passe de 74,6 % à 85,4 %, soit un gain de 10,8 points (14,48 % d’exemples corrigés en plus). La variable déterminante est le contexte de sécurité, pas le modèle.
Le gain est le plus important là où le modèle est le moins performant. Opus seul ne corrige que 64 % des exemples Python ; avec Snyk Intelligence, ce chiffre atteint 88 %.
Introduction
Il existe des benchmarks d’agents de programmation pour la génération de tests unitaires, la correction de bogues de type SWE-bench et la complétion de code. Mais il n’existe pas de benchmark public largement utilisé pour la tâche qui intéresse réellement une équipe de sécurité : prendre du code présentant une vulnérabilité connue et produire une correction qui supprime la vulnérabilité tout en préservant le fonctionnement du code. Ce sont deux exigences indépendantes, et satisfaire l’une sans l’autre est une erreur fréquente et coûteuse. Une correction qui élimine une injection SQL, mais modifie le résultat de la requête, n’a aidé personne. Une correction qui semble propre, mais laisse l’injection en place, est pire encore, car elle ressemble à une solution.
Nous avons donc créé un benchmark qui évalue ces deux exigences pour chaque correction, et l’avons fait passer deux fois aux modèles de pointe : seuls, puis équipés de l’intelligence de sécurité de Snyk. En clair, nous voulions savoir : dans quelle mesure le contexte de sécurité de Snyk change-t-il ce qu’un modèle de pointe peut corriger, et dans quels cas ?
En bref : les modèles utilisés tels quels plafonnent autour de 72 à 75 %, et Snyk Intelligence leur permet de dépasser ce seuil. La suite de cet article présente les données et la méthode.
Notre méthode de mesure : le benchmark Golden Test
La plupart des benchmarks de code vérifient si le code s’exécute ou s’il résout un rapport de bogue. Ni l’un ni l’autre ne suffit pour la remédiation de sécurité, qui doit satisfaire simultanément une exigence de sécurité et une exigence fonctionnelle. Notre jeu d’évaluation, les Golden Tests, est conçu pour mesurer les deux. Sa conception s’inspire de SWE-bench, adapté à la sécurité.
Les exemples
Le jeu comprend environ 150 exemples de code réel vulnérable : 50 en Python, 54 en JavaScript et 39 en Java. Chaque exemple est un extrait de code contenant exactement une vulnérabilité, détectée par Snyk Code et confirmée par un expert humain en sécurité. Il est choisi de façon à pouvoir être corrigé à partir du code présenté au modèle, sans qu’il lui manque de contexte externe.
La notation
Chaque exemple est associé à deux tests unitaires vérifiés par des humains :
Un test qui échoue en présence de la vulnérabilité ;
Un test qui réussit si les fonctionnalités d’origine du code sont préservées (par exemple, une fonction auxiliaire censée renvoyer « hello world » renvoie toujours « hello world » après la correction).
Pour être considéré comme réussi, le modèle doit corriger le code afin que les deux tests réussissent, dès le premier essai, sans jamais voir l’un ou l’autre des tests. Le modèle ne voit jamais les tests unitaires eux-mêmes : un succès correspond donc à une correction réellement sécurisée et fonctionnelle, et non à une réponse adaptée à un test connu.
Prenons un exemple Python avec une injection SQL : le code construit une requête en concaténant les entrées de l’utilisateur. Le test de sécurité envoie une charge utile d’injection SQL et vérifie que la base de données ne divulgue pas toutes ses lignes ; le code vulnérable échoue au test. Le test fonctionnel envoie un nom d’utilisateur ordinaire et vérifie que le bon enregistrement est renvoyé ; le code d’origine réussit ce test. La correction n’est comptabilisée que si la réécriture du modèle réussit le test de sécurité tout en préservant le test fonctionnel, dès la première tentative et sans avoir vu les tests.
Ce que nous avons évalué
Six configurations : l’ancien modèle Agent Fix interne de Snyk, basé sur StarCoder ; trois modèles de pointe utilisés tels quels (Gemini 3.1 Pro, Claude Sonnet 4.6, Claude Opus 4.6) ; et Sonnet 4.6 et Opus 4.6, chacun exécuté avec Snyk Intelligence dans la nouvelle architecture agentique Agent Fix. Ici, « Snyk Intelligence » désigne le prompting dynamique few-shot : au moment de la correction, nous intégrons les corrections rédigées par des experts les plus pertinentes pour la faiblesse concernée, issues de la base de données Snyk qui recense plus de 35 000 vulnérabilités. (Cette approche s’appuie sur des travaux antérieurs, où elle a amélioré les performances de LLM prêts à l’emploi.)
Comment le benchmark Snyk Agent Fix se compare-t-il aux benchmarks précédents ?
Les Golden Tests s’inscrivent dans une lignée de travaux qui ont progressivement relevé le niveau d’exigence pour l’évaluation de l’IA sur le code. SWE-bench a établi la méthode consistant à évaluer les modèles avec des tests réels cachés, plutôt qu’en jugeant la plausibilité déclarée de leurs réponses. Du côté de la sécurité, Vul4J a introduit des vulnérabilités reproductibles accompagnées de tests de preuve de vulnérabilité et d’une suite de tests de régression fonctionnelle, ce qui constitue le précédent le plus proche de notre approche FAIL-to-PASS et PASS-to-PASS. Des travaux plus récents, comme BaxBench et SEC-bench, confortent notre hypothèse de départ : un code fonctionnellement correct reste souvent vulnérable. Un benchmark de remédiation crédible doit donc évaluer les deux propriétés simultanément. Ce qui distingue les Golden Tests, c’est l’application conjointe de ces deux critères à des exemples réels vérifiés par des humains, avec des tests invisibles pour le modèle, dans trois langages utilisés en production.
Résultats
L’indicateur principal est la part des Golden Tests pour lesquels la correction est à la fois sécurisée et fonctionnelle.
Configuration | Taux de corrections fonctionnelles et sécurisées |
|---|---|
StarCoder (ancien modèle Agent Fix) | 72,4 % |
Gemini 3.1 Pro | 74,2 % |
Claude Sonnet 4.6 | 72,4 % |
Claude Opus 4.6 | 74,6 % |
Claude Sonnet 4.6 + Snyk Intelligence | 82,5 % |
Claude Opus 4.6 + Snyk Intelligence | 85,4 % |
GRAPHIQUE 1 : Taux de corrections fonctionnelles et sécurisées.
Les modèles utilisés tels quels se situent dans une fourchette de trois points. L’ajout de Snyk Intelligence crée un écart de 8 à 11 points avec le même modèle : Opus 4.6 passe de 74,6 % à 85,4 %.
La comparaison d’Opus par langage montre que le gain n’est pas un simple effet de moyenne. Il se vérifie dans tous les langages testés et est le plus important là où le modèle utilisé tel quel est le moins performant.
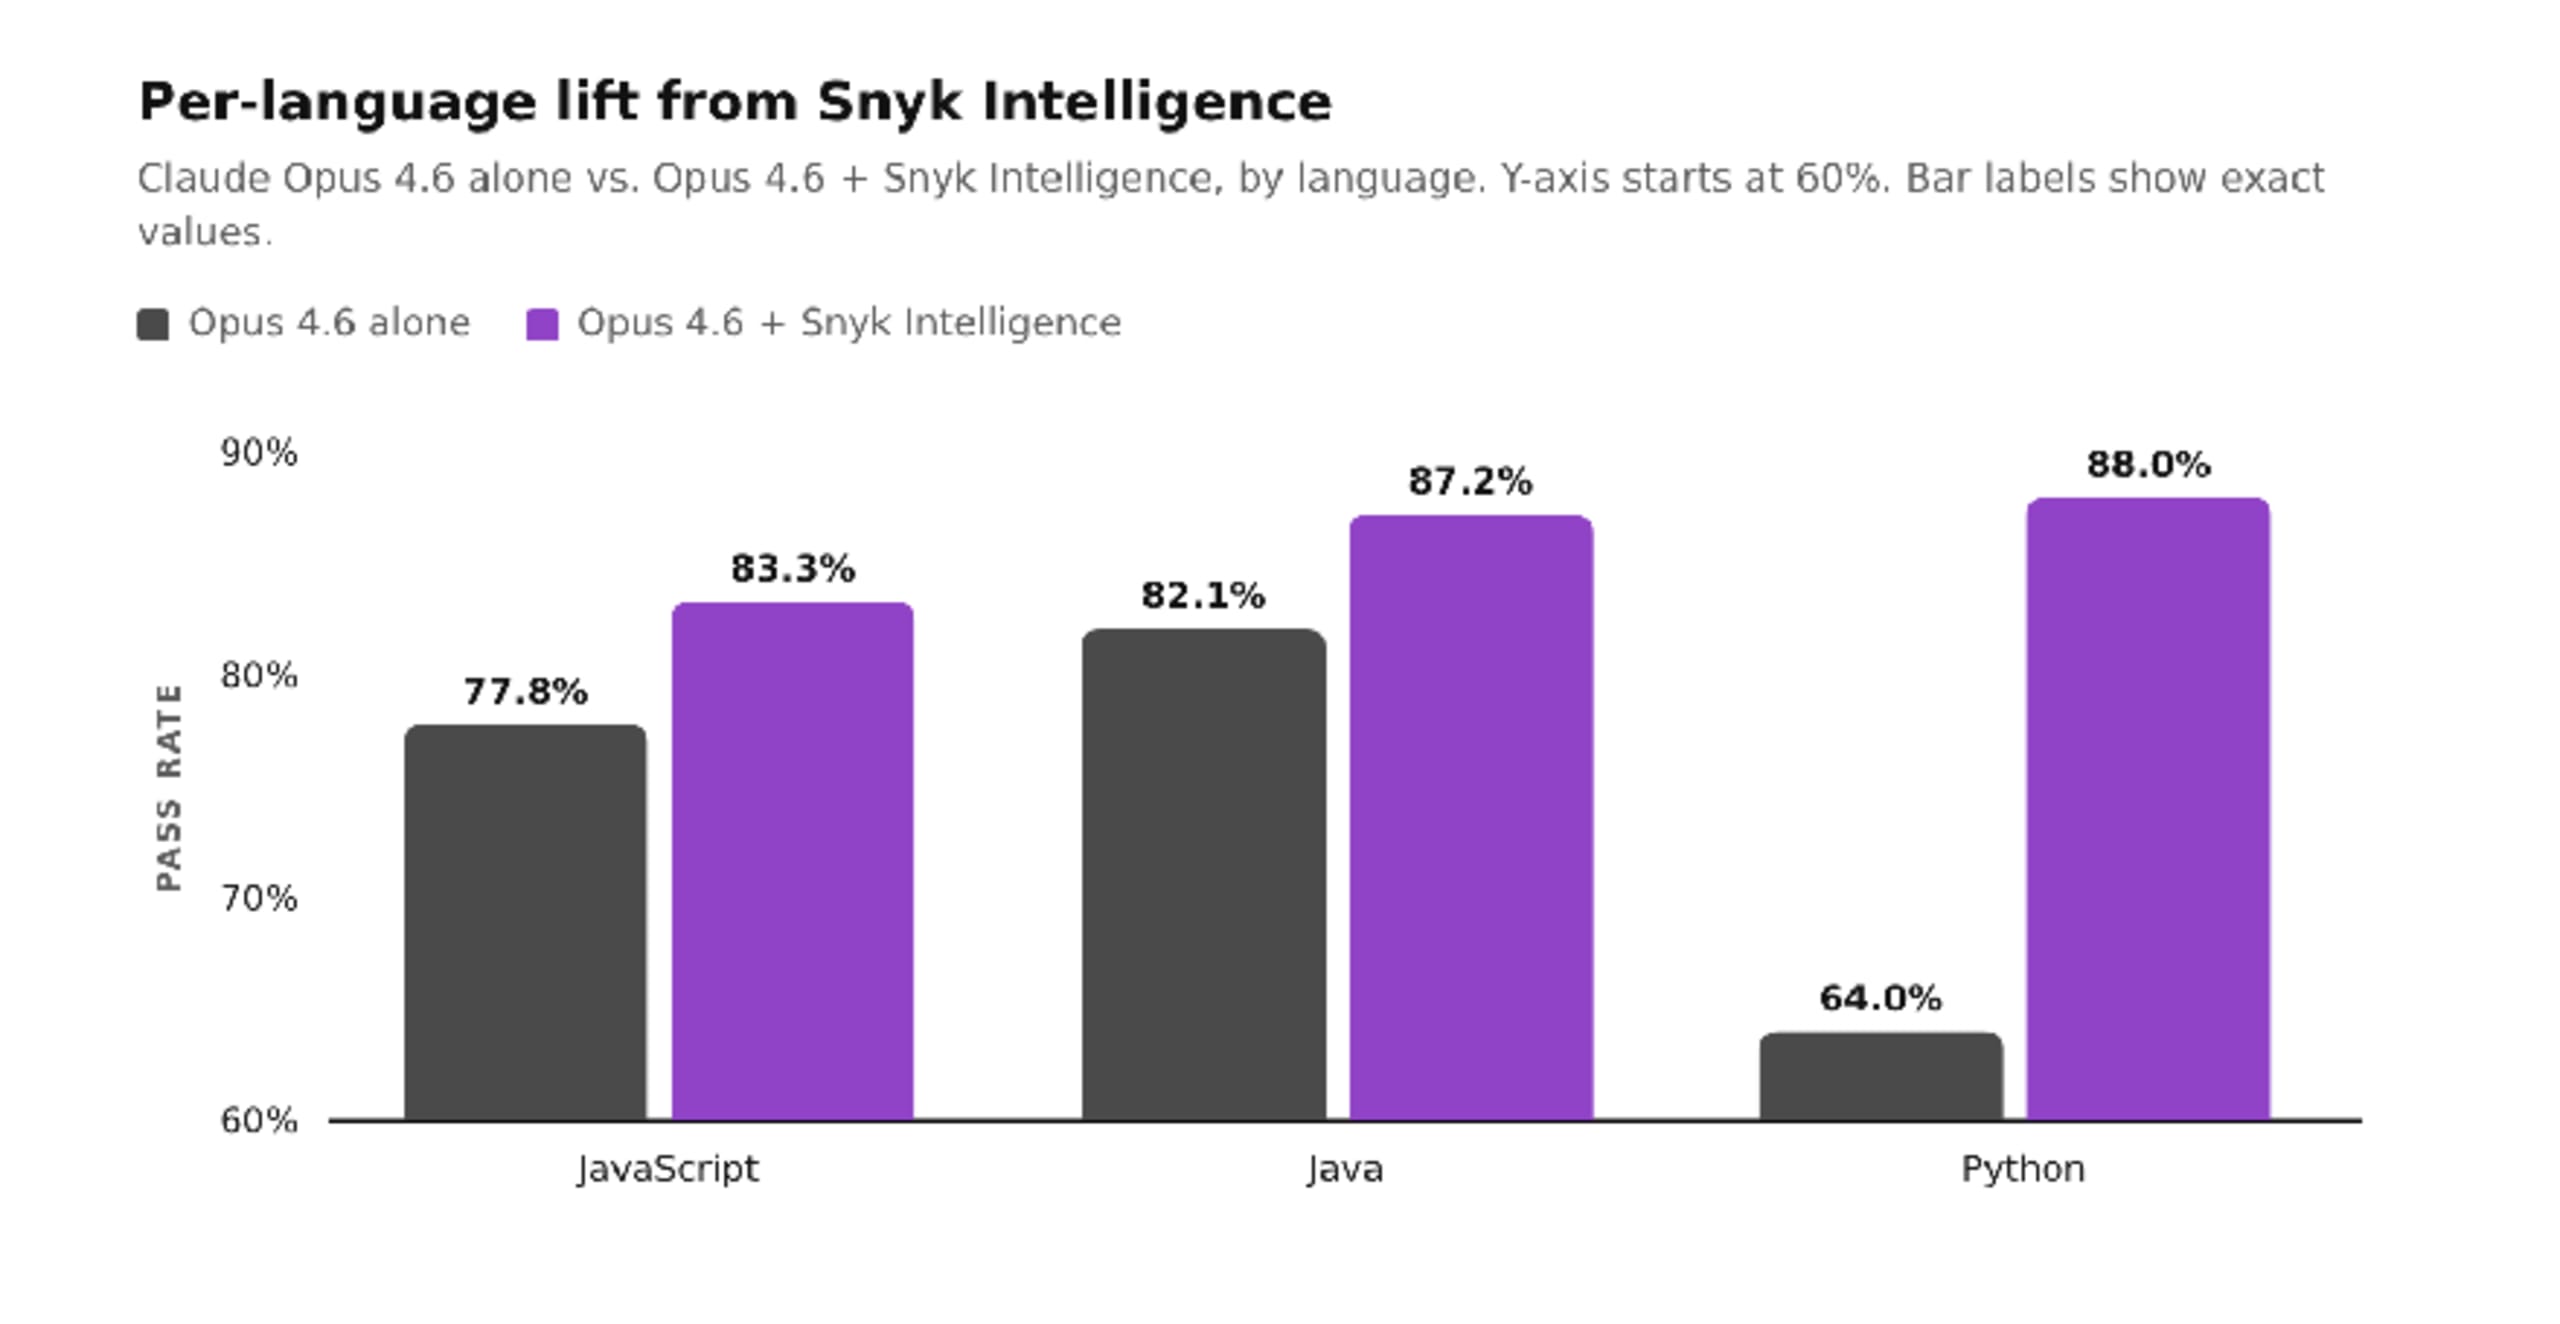
GRAPHIQUE 2 : Gain par langage
Python est le cas le plus frappant : Opus seul corrige 64,0 % des exemples, contre 88,0 % avec Snyk Intelligence. En JavaScript et en Java, où Opus est déjà performant au départ, le gain atteint cinq à six points.
Ce que signifient les chiffres
La taille brute des modèles plafonne pour les corrections sécurisées et fonctionnelles
Les trois modèles utilisés tels quels obtiennent des résultats de 72,4 % à 74,6 %, soit un écart de 2,2 points entre deux fournisseurs. Si un modèle plus gros ou plus récent était la clé pour cette tâche, nous nous attendrions à le voir ici. Ce n’est pas le cas. Cette tâche est difficile d’une manière à laquelle des capacités générales plus élevées ne répondent pas directement : le modèle doit savoir à quoi ressemble une correction sécurisée pour cette faiblesse, et pas seulement générer du code plausible.
Le levier, c’est le contexte de sécurité, pas un modèle plus gros
Opus 4.6 gagne 10,8 points (14,48 % d’exemples en plus) grâce aux seuls exemples de sécurité intégrés au moment de la correction. Comme cette approche est indépendante du modèle, chaque gain des modèles de pointe sous-jacents s’ajoute à l’effet de ce contexte, au lieu d’entrer en concurrence avec lui. L’atout durable, ce sont les plus de 35 000 corrections d’experts ; le modèle est un composant que nous pouvons remplacer au gré des progrès du domaine. C’est pourquoi Agent Fix en production associe désormais Snyk Intelligence à Claude Opus 4.7.
Le gain est le plus important là où le modèle est le moins performant
Opus seul n’a corrigé que 64 % des exemples Python, son langage le moins performant. Avec Snyk Intelligence, ce résultat atteint 88 %, son meilleur gain parmi les trois langages. Le contexte de sécurité ne fait pas qu’augmenter la moyenne : il relève le niveau plancher.
Le résultat résiste à un examen plus approfondi
Le résultat d’Opus avec Snyk est une moyenne des différentes exécutions (84,6 % et 86,0 % pour les deux exécutions agrégées) : le résultat phare de 85,4 % reflète donc des performances constantes d’une exécution à l’autre. La variation entre les exécutions sur ce jeu est d’environ un point. Il convient d’en tenir compte lorsqu’on compare des configurations dont les résultats diffèrent d’un ou deux points.
À suivre : Snyk VulnBench et la détection des vulnérabilités par les agents de programmation
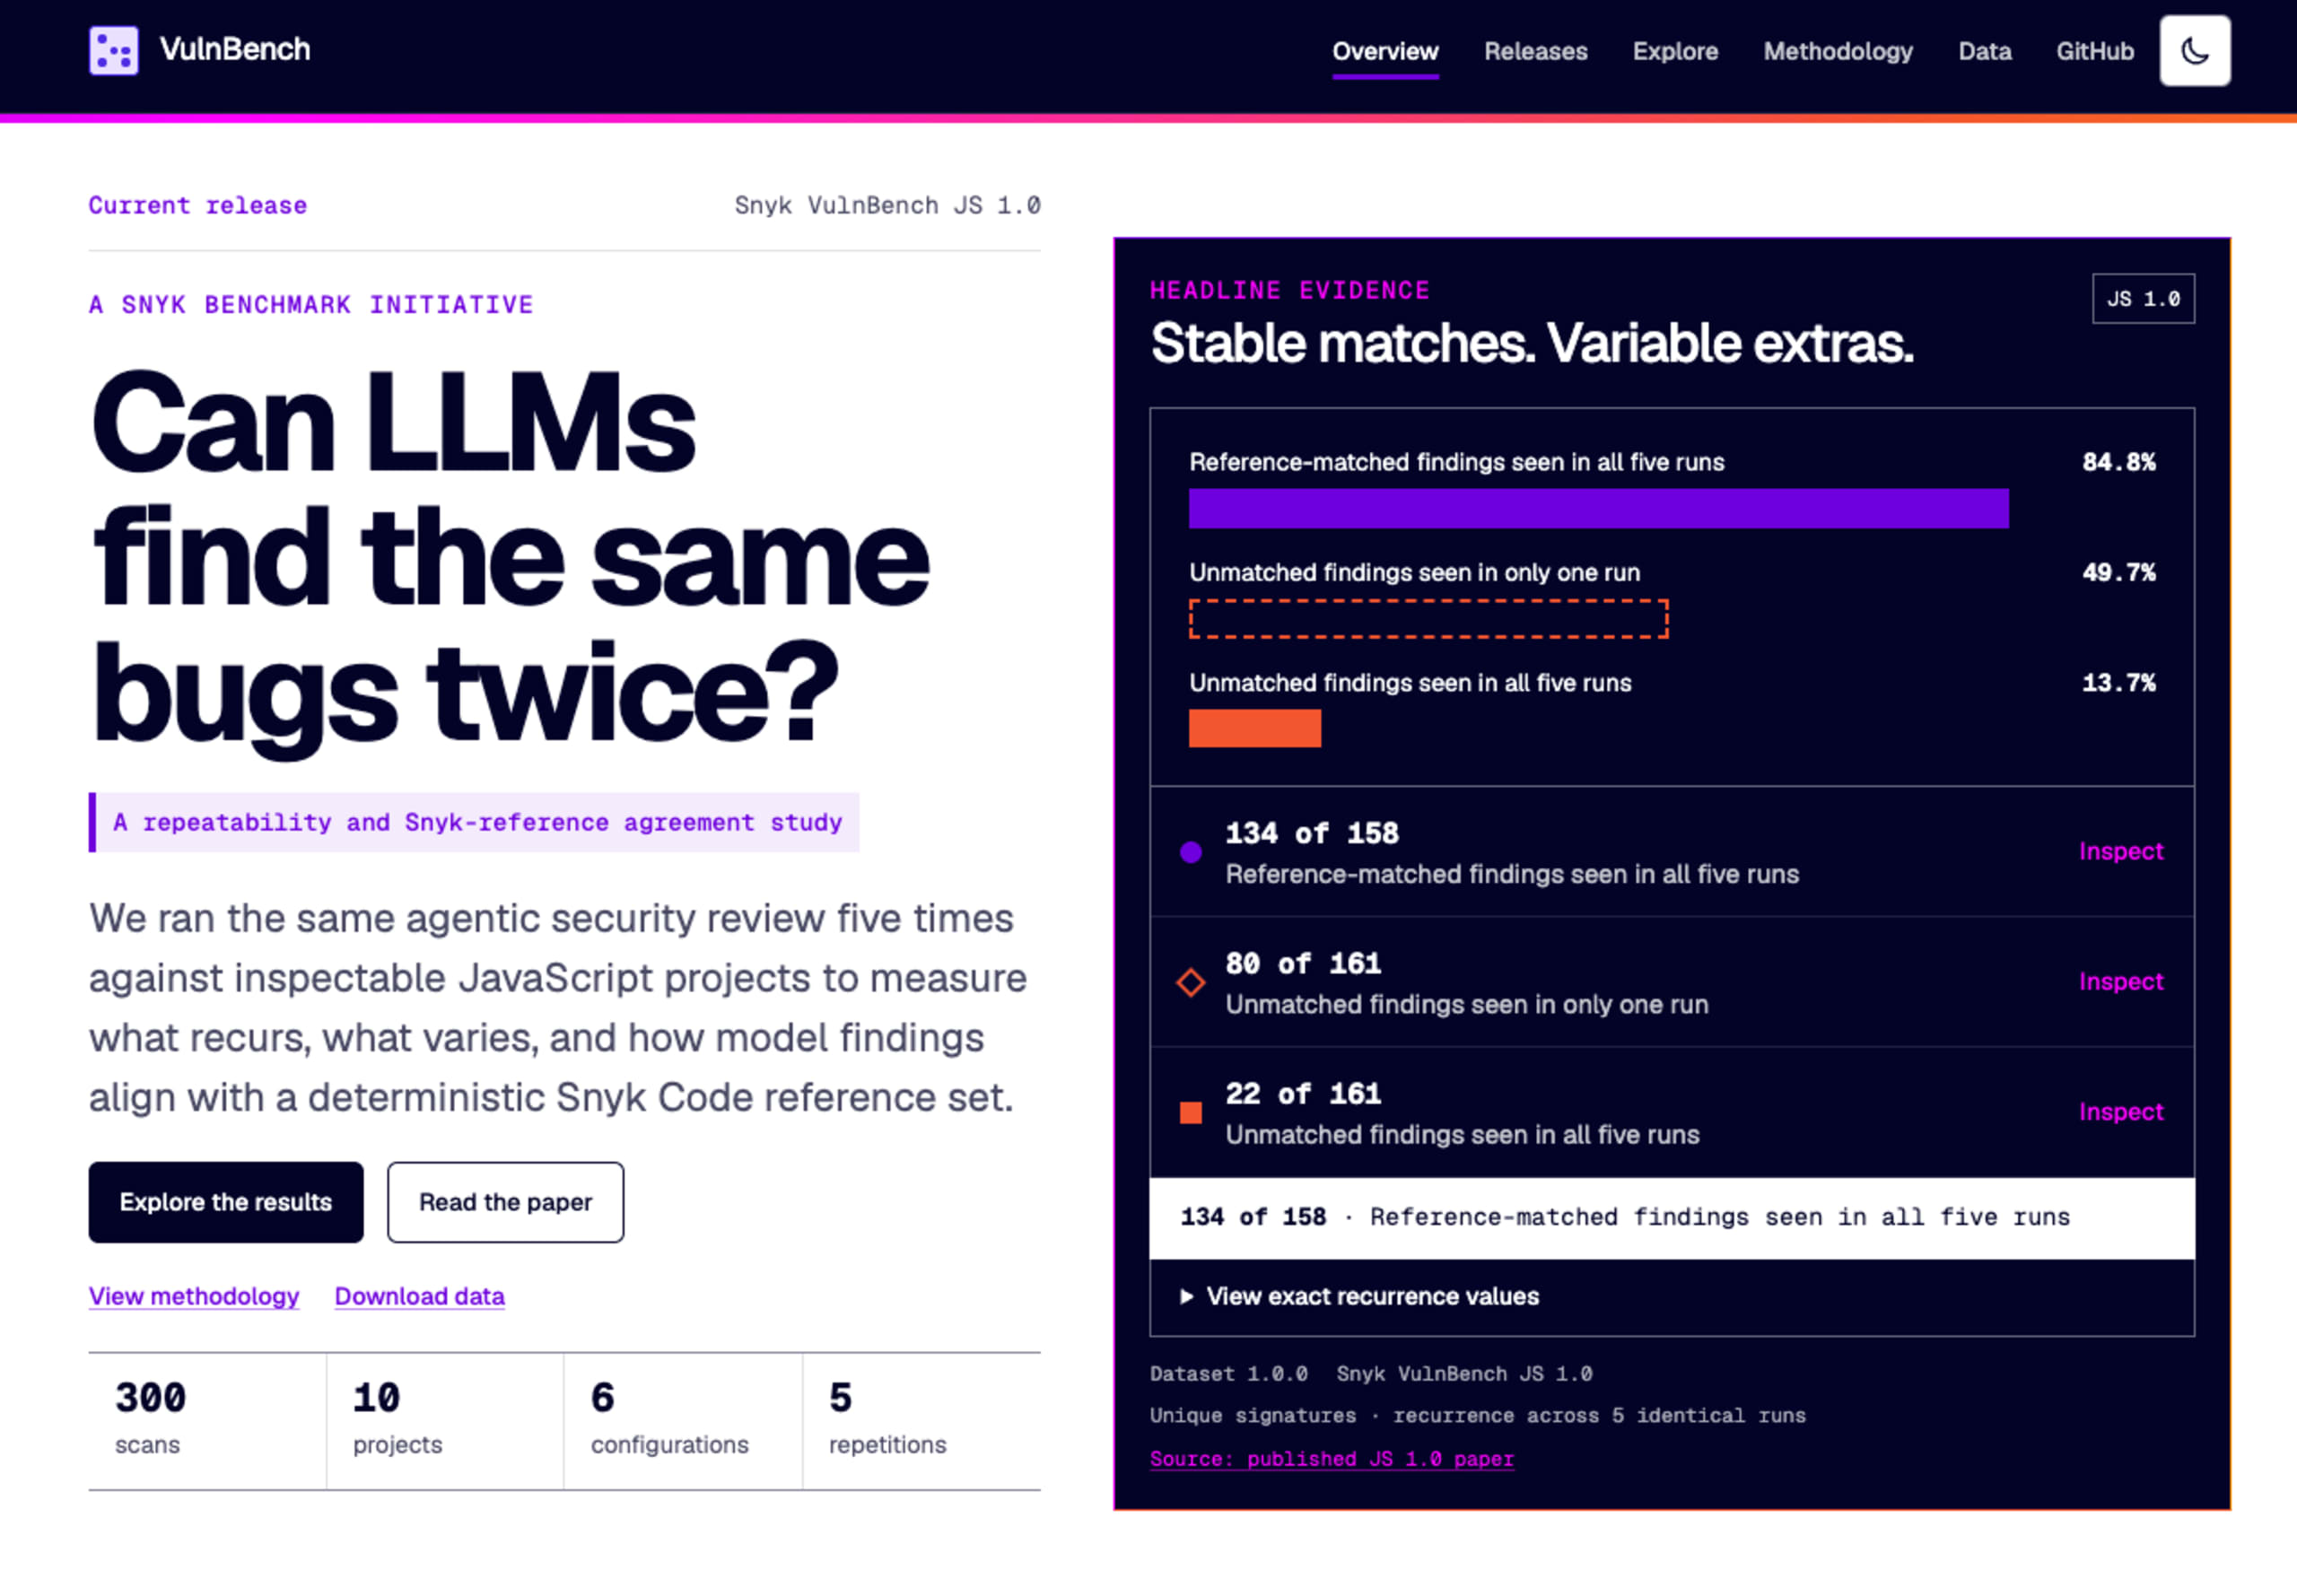
Corriger une vulnérabilité suppose de l’avoir détectée. En juin 2026, nous avons publié l’article Snyk VulnBench JS 1.0, qui visait à comparer Snyk Code, un moteur SAST déterministe et rapide, aux LLM pilotés par des agents de programmation (l’environnement Claude Code) pour détecter les vulnérabilités dans le code avant même qu’elles aient besoin d’être corrigées.
Nos conclusions sur Snyk VulnBench ont révélé que même les grands modèles de langage de pointe, tels que Claude Opus 4.7 avec son niveau de raisonnement maximal (alias max), et même lorsqu’ils sont pilotés par un environnement d’agent de programmation avancé (Claude Code lui-même), rencontrent des difficultés de reproductibilité et de déterminisme. Quelques résultats marquants :
Dans un cas, le modèle et l’agent de programmation ont signalé environ 50 % de résultats qui ne se sont pas reproduits lors de quatre des cinq exécutions suivantes, générant un arriéré de faux positifs et une lassitude face aux vulnérabilités chez les développeurs agentiques et les ingénieurs en sécurité de l’IA.
Dans d’autres cas, 13 % des agents de programmation ont signalé des vulnérabilités non détectées auparavant lors des cinq exécutions, générant une situation encore plus déroutante et une charge cognitive accrue dans l’arriéré de sécurité, avec des problèmes susceptibles de s’avérer être des faux positifs.
Nous vous invitons à examiner et à explorer le jeu de données Snyk VulnBench, désormais disponible publiquement à l’adresse https://vulnbench.com/
Limites
Quatre limites à prendre en compte avant de vous fier à ces chiffres :
Taille du jeu : environ 150 exemples (50 en Python, 54 en JavaScript, 39 en Java) suffisent à faire ressortir des tendances claires, mais pas à établir la significativité statistique de faibles écarts. Le modèle de référence StarCoder a été testé sur un échantillon environ 20 % plus petit (uniquement les règles prises en charge par Agent Fix et pour lesquelles des données d’entraînement existaient) ; sur l’ensemble des règles, son score est de 54,9 %. Il s’agit du modèle interne de Snyk, affiné, inclus à titre de référence et non comme modèle de pointe.
Extraits de code, pas applications entières : chaque exemple est un fichier unique contenant une vulnérabilité, corrigeable à partir du contexte local. Les bases de code réelles présentent un contexte qui s’étend à plusieurs fichiers et des problèmes qui interagissent entre eux ; ce benchmark ne les évalue pas.
Trois langages : nous avons évalué JavaScript, Java et Python. La nouvelle architecture prend en charge tous les langages pris en charge par Snyk Code, mais ce sont les trois seuls pour lesquels des Golden Tests sont actuellement disponibles.
Nombre limité d’exécutions pour évaluer la variance : nous avons agrégé deux exécutions pour les configurations optimisées par Snyk et n’avons pas effectué suffisamment de répétitions pour publier des barres d’erreur formelles pour chaque valeur. Considérez comme approximatifs les écarts inférieurs à deux points.
Nous présentons ces limites pour vous aider à évaluer la portée des affirmations, et non pour nuancer les résultats. L’écart de plus de 10 points obtenu avec Snyk Intelligence dépasse largement le bruit entre les exécutions ; ce n’est pas le cas de l’ordre des petits écarts par langage.
Et maintenant ?
Élargir la couverture linguistique : étendre les jeux Golden Test au-delà de JavaScript, Java et Python pour que le benchmark couvre tous les langages pris en charge par l’architecture.
Quantifier la variance : exécuter chaque configuration suffisamment de fois pour publier des barres d’erreur fiables plutôt qu’une moyenne sur deux exécutions.
Détection, pas seulement remédiation : ce benchmark mesure la capacité à corriger. Un projet complémentaire évalue dans quelle mesure les agents détectent les vulnérabilités par rapport à Snyk Code ; nous en publierons les résultats séparément.
Le nouvel Agent Fix agentique est désormais déployé. Il associe Snyk Intelligence à Claude Opus 4.7. Vous voulez voir comment la remédiation sécurisée et fonctionnelle s’applique à votre propre code ? Commencez avec Snyk Code et Agent Fix, et découvrez les détails techniques à l’origine de ces résultats.
Peut-on faire confiance au code généré par l’IA ? J’ai créé un scanner pour le vérifier
Annexe : méthodologie et agrégation
Structure de l’évaluation : Chaque test de référence comprend un échantillon de code contenant exactement une vulnérabilité, ainsi qu’un test unitaire de sécurité (qui échoue sur le code vulnérable) et un test unitaire fonctionnel (qui réussit sur le code d’origine). Une configuration ne réussit un test que si son correctif fait réussir les deux tests dès la première tentative, ceux-ci étant masqués au modèle.
Agrégation : Les taux indiqués correspondent à la proportion d’échantillons corrigés.
Le chiffre de 72,4 % pour le modèle précédent (StarCoder) correspond à la moyenne des taux par langage de programmation et ne tient compte que des règles prises en charge par Agent Fix ; pour l’ensemble des règles, il tombe à 54,9%.
Le chiffre de 85,4 % pour Opus 4.6 + Snyk Intelligence correspond à la moyenne des différentes exécutions (exécution 1 = 86,0 %, exécution 2 = 84,6 %). Les chiffres par langage de programmation du deuxième graphique proviennent d’une seule exécution représentative, ce qui explique pourquoi leur moyenne est légèrement supérieure (~86 %) au résultat global calculé sur plusieurs exécutions ; c’est ce résultat global qu’il convient de citer.
Configurations : StarCoder (ancien modèle d’Agent Fix) ; Gemini 3.1 Pro ; Claude Sonnet 4.6 et Claude Opus 4.6, chacun utilisé tel quel ou avec Snyk Intelligence dans le cadre de l’architecture agentique d’Agent Fix. Les données présentées ici ont été recueillies avec Opus 4.6 ; en production, Agent Fix est depuis passé à Claude Opus 4.7. Snyk Intelligence fournit, au moment de la génération, des correctifs rédigés par des experts pour la faiblesse concernée (prompting dynamique par few-shot).
Découvrez Snyk en action
Découvrez pourquoi les développeurs et les équipes de sécurité choisissent Snyk pour leur AppSec, et ce que la plateforme peut apporter à votre équipe.