Plus précis que GPT-4 : comment CodeReduce de Snyk améliore les performances des autres LLM

7 mai 2024
0 minutes de lectureDepuis le lancement de Snyk Code en 2021, Snyk fait figure de pionnier en cybersécurité basée sur l’IA. Pour la première fois, le moteur DeepCode AI a apporté une précision et une rapidité inégalées à la détection des problèmes de sécurité dans le domaine du SAST. Au cours des trois dernières années, nous avons assisté à l’essor de l’IA et des LLM, et Snyk a été à l’avant-garde de cette évolution avec le lancement de nouvelles fonctionnalités basées sur l’IA, telles que Snyk Agent Fix, notre fonctionnalité de correction automatique des vulnérabilités, ou notre fonctionnalité d’analyse de l’accessibilité des dépendances tierces.
Nous avons récemment annoncé d’importantes améliorations des modèles utilisés par Snyk Agent Fix, une fonctionnalité bêta qui corrige automatiquement les problèmes de sécurité détectés par Snyk Code. Snyk Agent Fix associe les dernières technologies d’IA à l’expertise de nos équipes pour générer des correctifs fiables. La correction des problèmes de sécurité est complexe. Pour en savoir plus sur notre approche, nous allons examiner en détail l’article de recherche qui présente les ingrédients clés de Snyk Agent Fix : la technologie CodeReduce et notre jeu de données de correctifs de sécurité soigneusement sélectionnés.
Automatiser les corrections de sécurité : un problème complexe
Les développeurs consacrent souvent beaucoup de temps à détecter et à corriger eux-mêmes les problèmes de sécurité. Avant DeepCode AI, Snyk Code les aidait à détecter les problèmes, mais l’étape suivante, leur correction, pouvait s’avérer difficile et chronophage, car les développeurs n’avaient souvent pas de formation en sécurité — et c’est encore le cas aujourd’hui. Pour corriger un problème de sécurité, ils doivent examiner le code manuellement, comprendre son fonctionnement prévu et le problème de sécurité dans le contexte du code, puis rechercher comment y remédier avant de pouvoir le corriger.
Depuis des années, de nombreuses entreprises cherchent à automatiser la correction des problèmes de sécurité, ou « correction automatique », afin de réduire considérablement le travail de remédiation. Cependant, malgré de nombreuses tentatives, il s’est avéré difficile de créer une solution produisant des correctifs précis. La plupart des outils de correction automatique se sont donc concentrés sur un petit nombre de problèmes, des changements simples ne portant que sur quelques lignes de code ou de simples problèmes de mise en forme.
Avec l’arrivée des LLM, nous avons entrevu la possibilité de créer une meilleure fonctionnalité de correction automatique grâce à cette nouvelle génération d’IA. Toutefois, même les LLM ont leurs limites pour remédier aux problèmes de sécurité lorsqu’ils ne sont pas suffisamment configurés pour obtenir les résultats souhaités. La plupart ont été entraînés sur une grande variété de données et de code, mais pas spécifiquement sur la remédiation des problèmes de sécurité. Deux problèmes majeurs se sont donc posés :
Pour automatiser la correction de problèmes de sécurité, une tâche très spécifique, les LLM ont besoin d’un jeu de données spécialisé contenant des correctifs de sécurité et sémantiques à partir desquels apprendre afin de générer des correctifs de code pertinents et précis.
Les hallucinations et la capacité limitée des LLM à traiter le contexte à chaque génération signifient qu’ajouter davantage de code aux prompts pour orienter un LLM « généraliste » (plutôt qu’un modèle spécifiquement entraîné pour la sécurité) vers des résultats plus précis ne garantit pas de meilleurs résultats.
Dépasser les limites des LLM pour générer de meilleurs correctifs
Nous avons estimé que les avantages des LLM justifiaient les efforts nécessaires pour remédier à leurs limites. Nous avons donc décidé de nous attaquer nous-mêmes à ces problèmes.
Jeu de données de correctifs
Nous avons constitué un vaste jeu de données de correctifs de sécurité open source afin d’obtenir les meilleurs résultats possibles. Nous avons d’abord largement annoté des commits open source et créé un jeu de données fiable de problèmes et de correctifs pour JavaScript. Depuis, nous avons fait de même pour d’autres langages, notamment Java, Python, C/C++, C#, Go et APEX. Ensuite, plutôt que d’ajouter manuellement des données annotées, nous avons utilisé les fonctionnalités d’analyse de programmes de Snyk Code, fournies par notre moteur DeepCode AI, pour obtenir efficacement le même effet quantitatif que l’annotation de données et constituer des jeux de données fiables.
Technologie CodeReduce (brevet en instance)
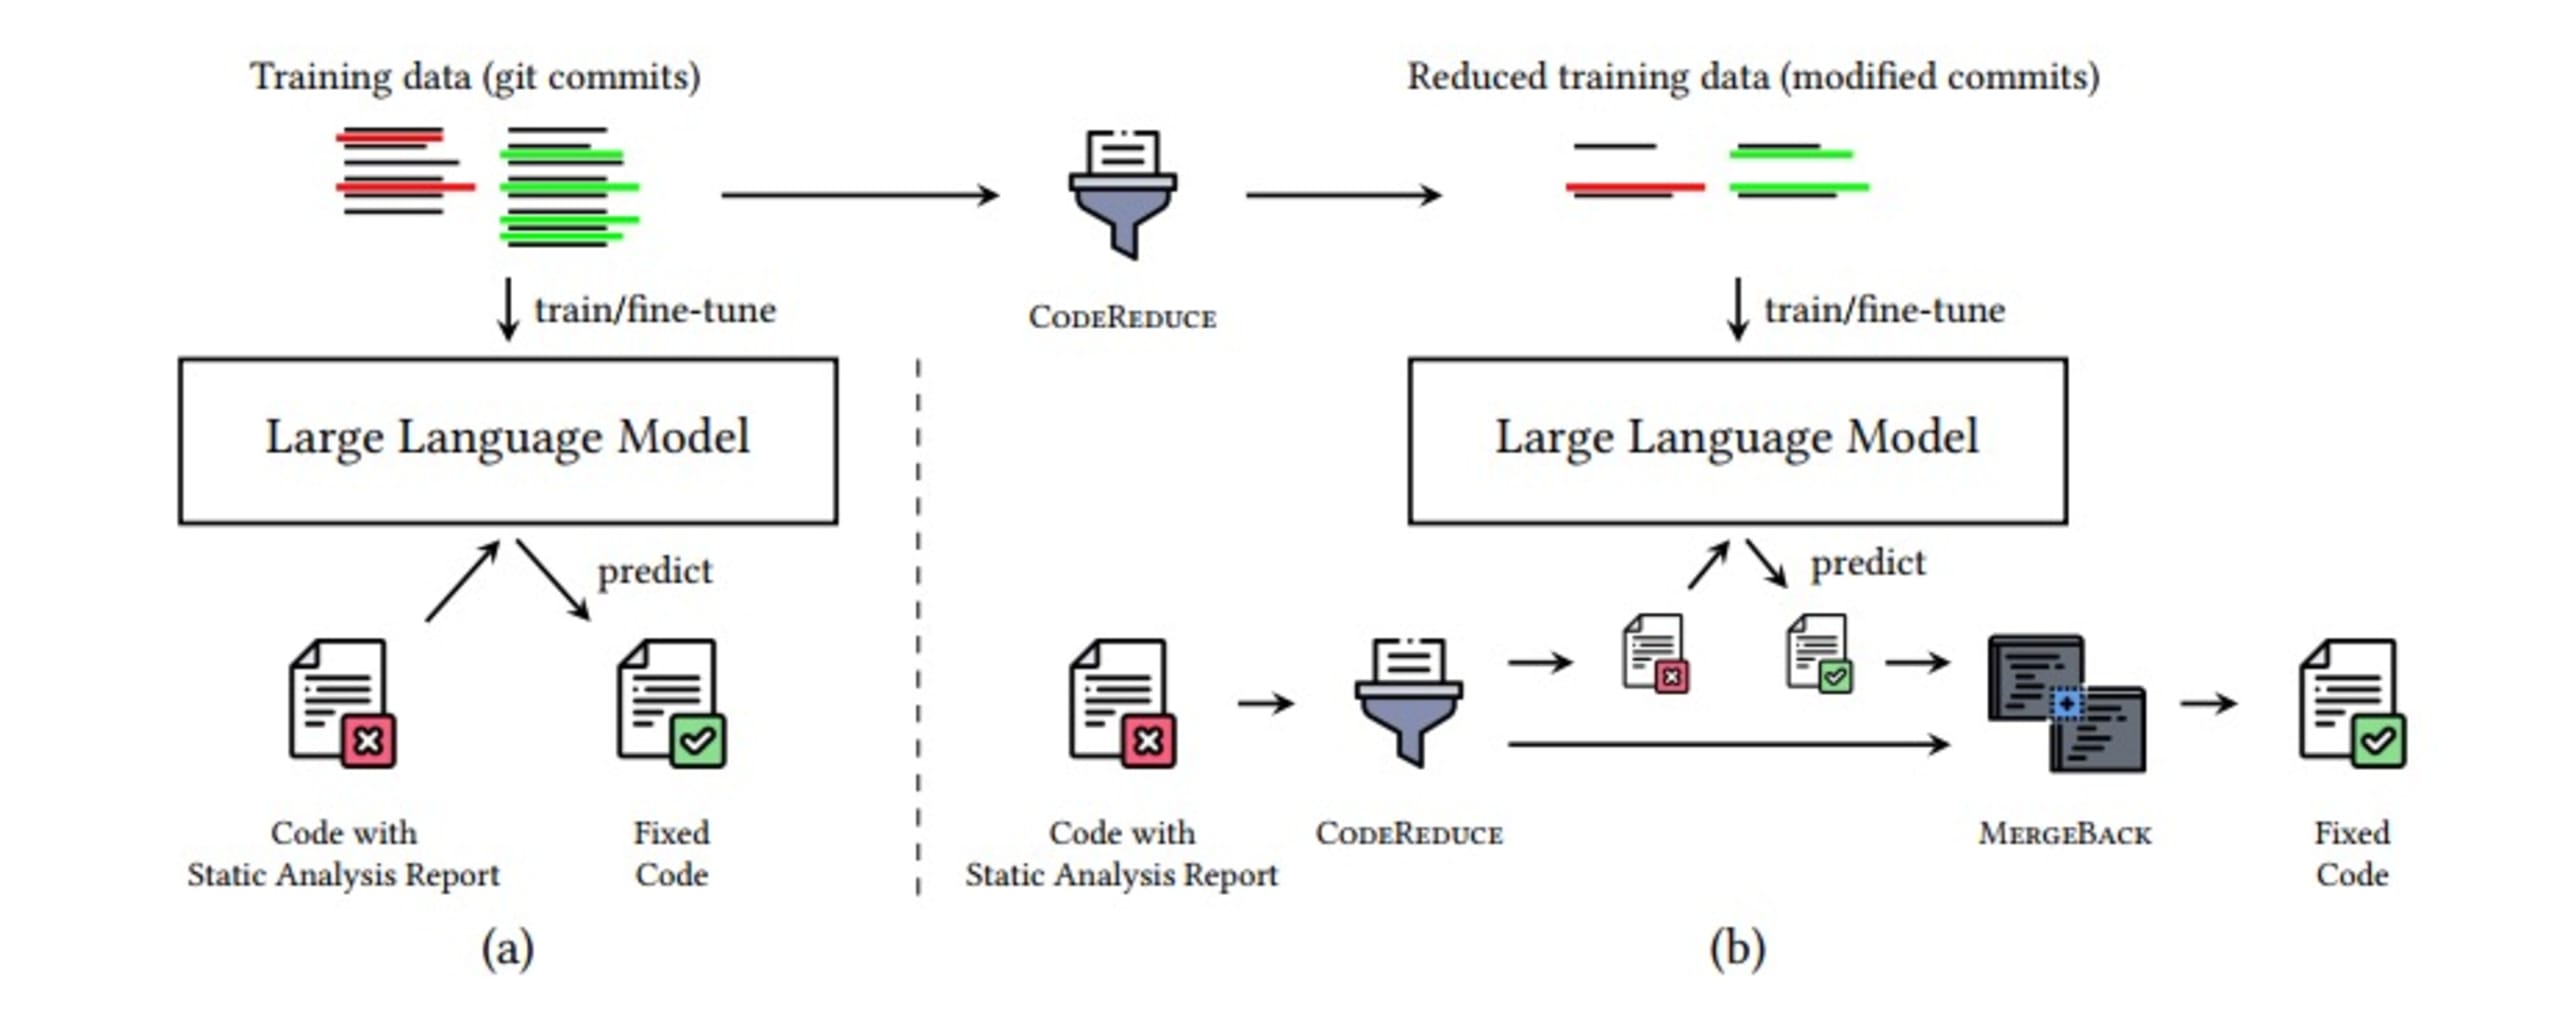
CodeReduce s’appuie sur l’analyse de programmes pour limiter le mécanisme d’attention du LLM aux seules parties du code nécessaires à la correction. Pour cela, le modèle se concentre sur un extrait plus court, qui contient le défaut signalé et le contexte nécessaire. Le volume de code que le LLM doit traiter s’en trouve considérablement réduit, ce qui améliore la qualité des correctifs générés par tous les modèles d’IA testés et réduit les hallucinations. De plus, le traitement d’une quantité moindre d’informations accélère le modèle. La génération de correctifs en temps réel devient possible : vous obtenez des correctifs plus précis et plus pertinents, mais aussi plus rapidement.
Le processus CodeReduce comprend les étapes suivantes :
Détecter le problème de sécurité
Réduire le code au minimum nécessaire, en conservant le contexte
Ajouter le code réduit par CodeReduce au prompt du LLM et générer un correctif
Appliquer le correctif
Utiliser les capacités d’analyse de Snyk Code pour vérifier que Snyk Agent Fix a corrigé la vulnérabilité et que le ou les correctifs n’ont introduit aucune nouvelle vulnérabilité
Réintégrer le correctif dans le code d’origine
L’image ci-dessous présente le processus de correction automatique des problèmes de sécurité. Grâce à des optimisations supplémentaires que vous pouvez découvrir dans l’article de recherche sur CodeReduce, l’ensemble du processus ne prend que quelques secondes.
Quels sont les résultats ?
Une fois ces problèmes résolus, nous devions tester l’efficacité de nos correctifs de sécurité automatiques. Nous avons donc créé un benchmark utilisable avec différents LLM.
Nous avons réalisé nos évaluations à l’aide des métriques « Pass@𝑘 » et « ExactMatch@𝑘 » pour les modèles utilisant CodeReduce (signalés par le symbole ‡ dans le tableau ci-dessous), et les avons comparés aux références TFix, un modèle fondé sur des fenêtres, ainsi qu’à différents modèles à grand contexte, comme GPT-3.5 et GPT-4.
La variable « k » dans « Pass@k » indique combien des 5 correctifs générés à chaque fois (d’au moins un à la totalité des 5) résolvent le problème de sécurité concerné sans en introduire de nouveau.
Nous avons également défini cinq catégories de problèmes de sécurité pour les tests :
AST : vulnérabilités nécessitant un arbre syntaxique abstrait, mais pas d’analyse dédiée du flux de données
Local : valeurs incorrectes transmises à des méthodes qui ne les acceptent pas
FileWide : problèmes de signature ou d’implémentation
SecurityLocal : utilisation d’API et suivi des appels de méthode
SecurityFlow : analyse complexe de la propagation des données contaminées, nécessitant une analyse complexe des flux de données
Nous avons également sélectionné plusieurs LLM pour les comparer : StarCoder, Mixtral, T5, GPT-3.5 et GPT-4. Voici les résultats :
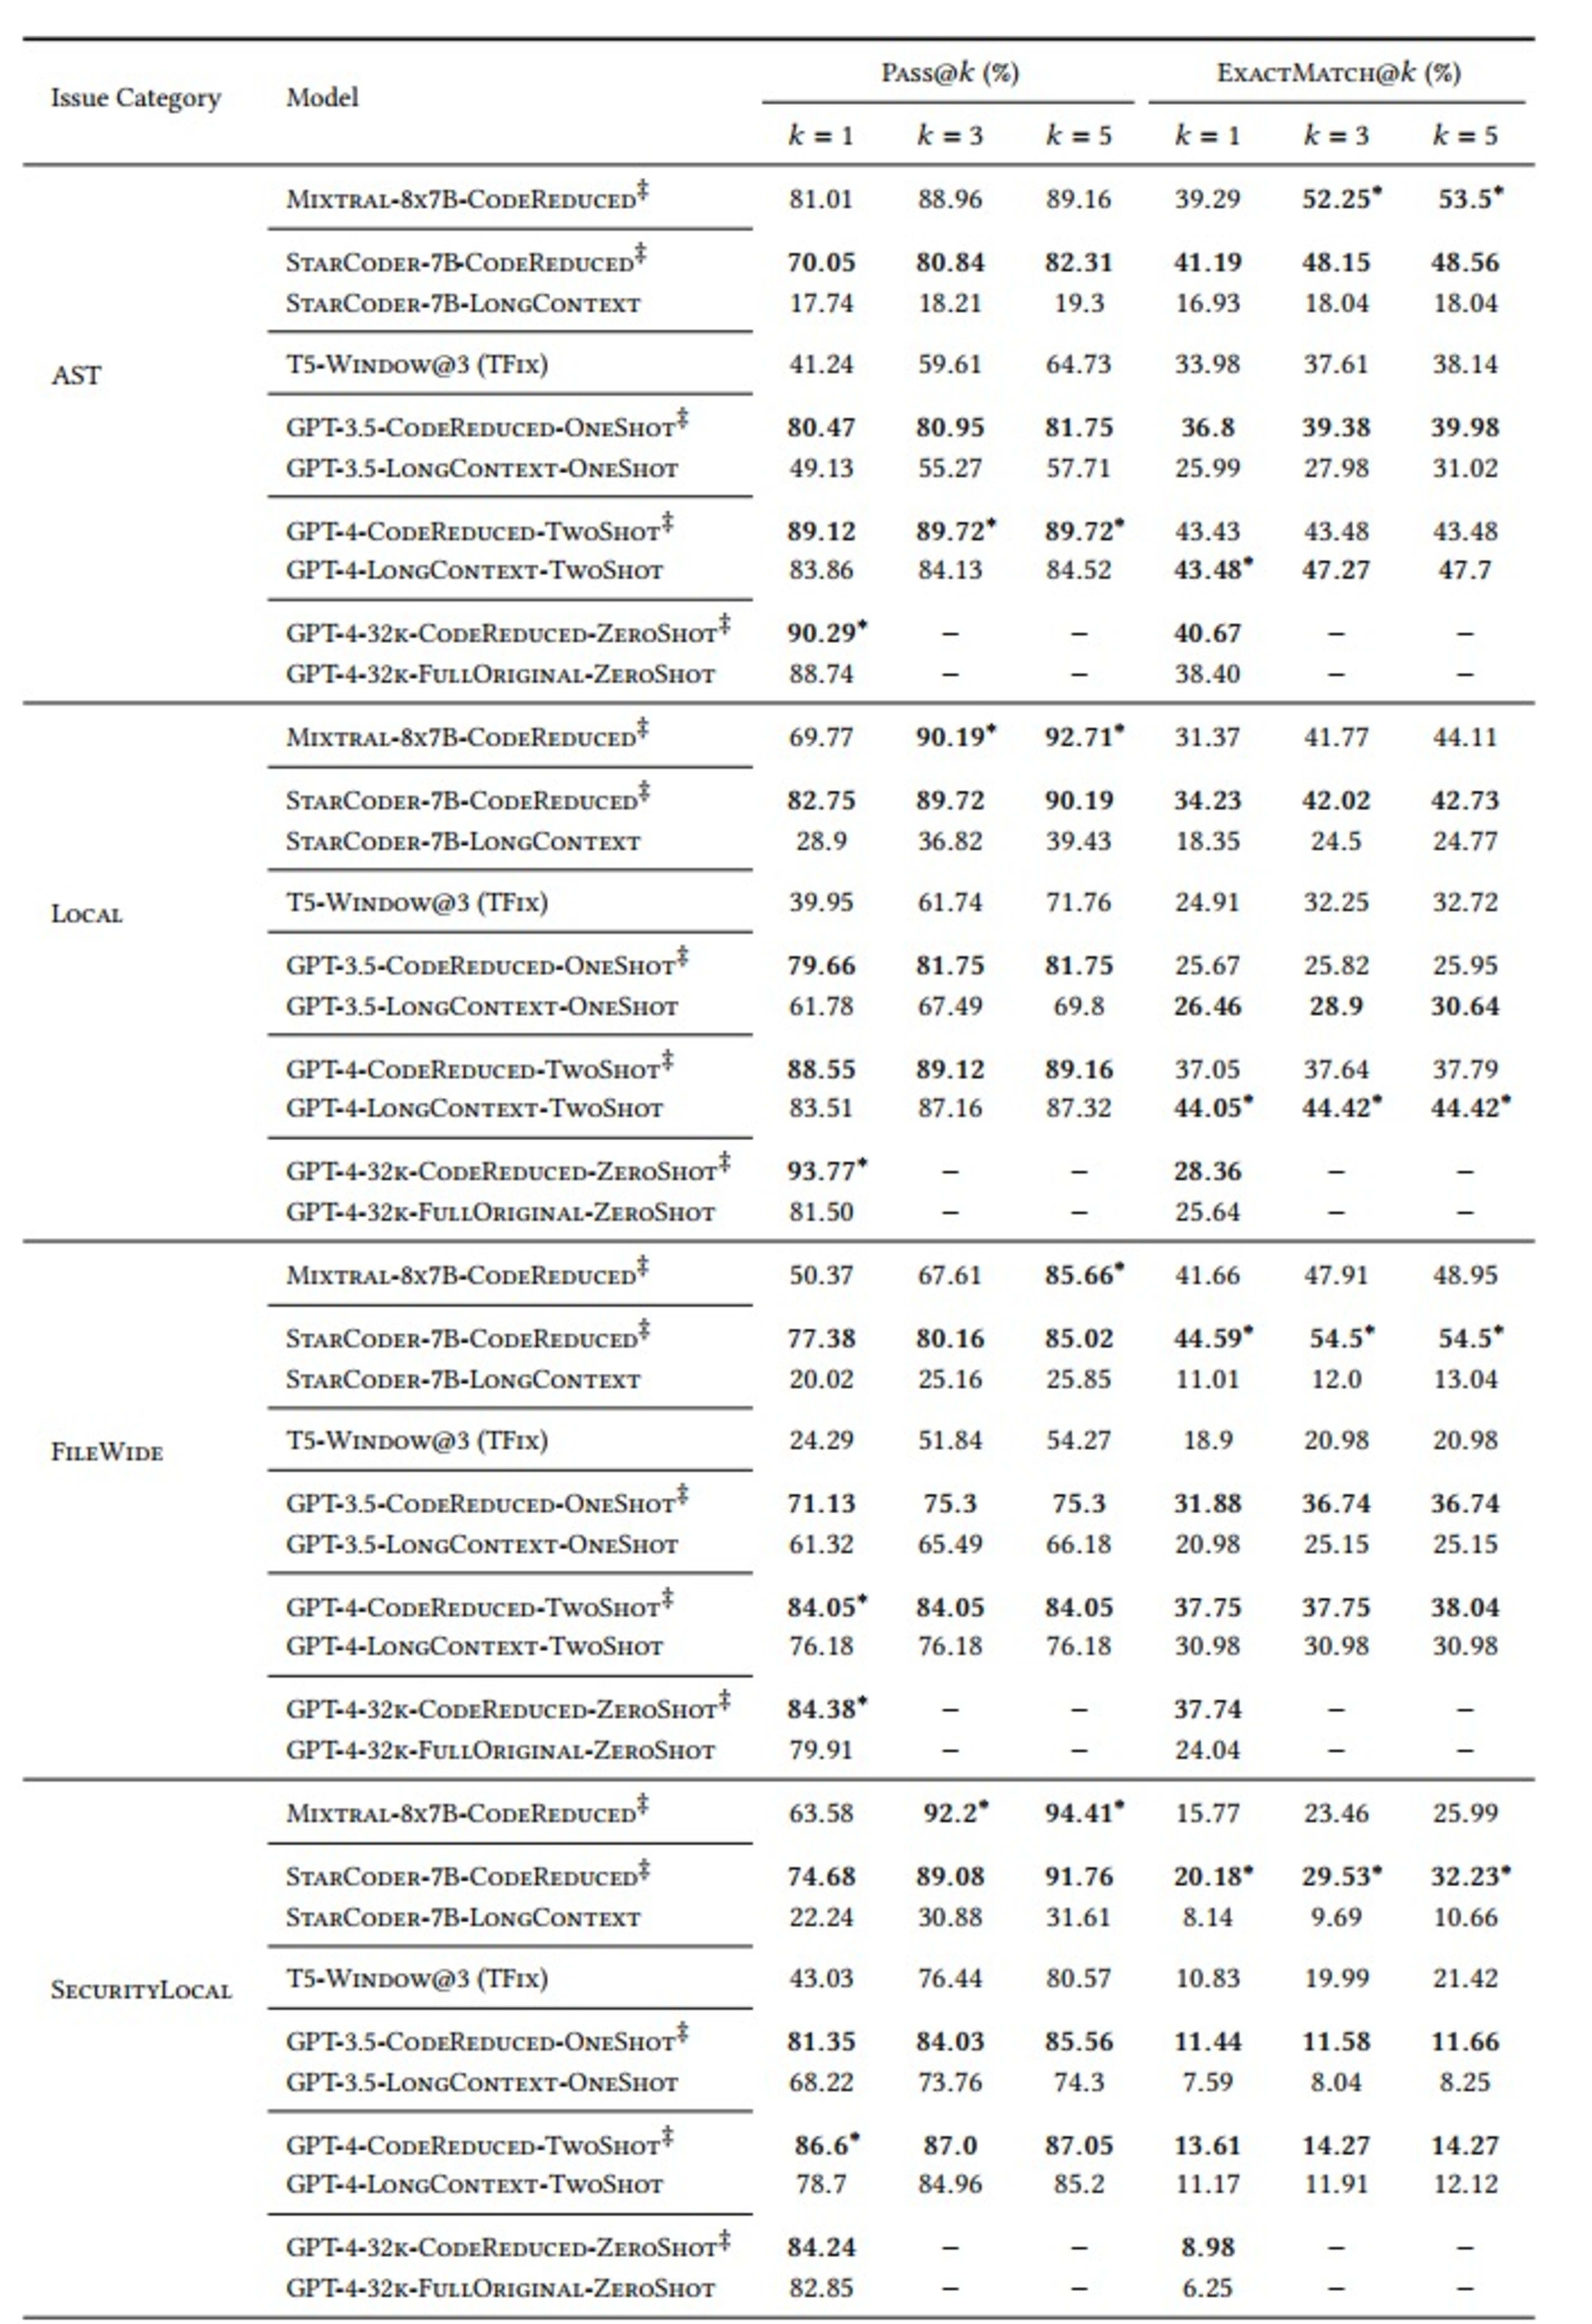
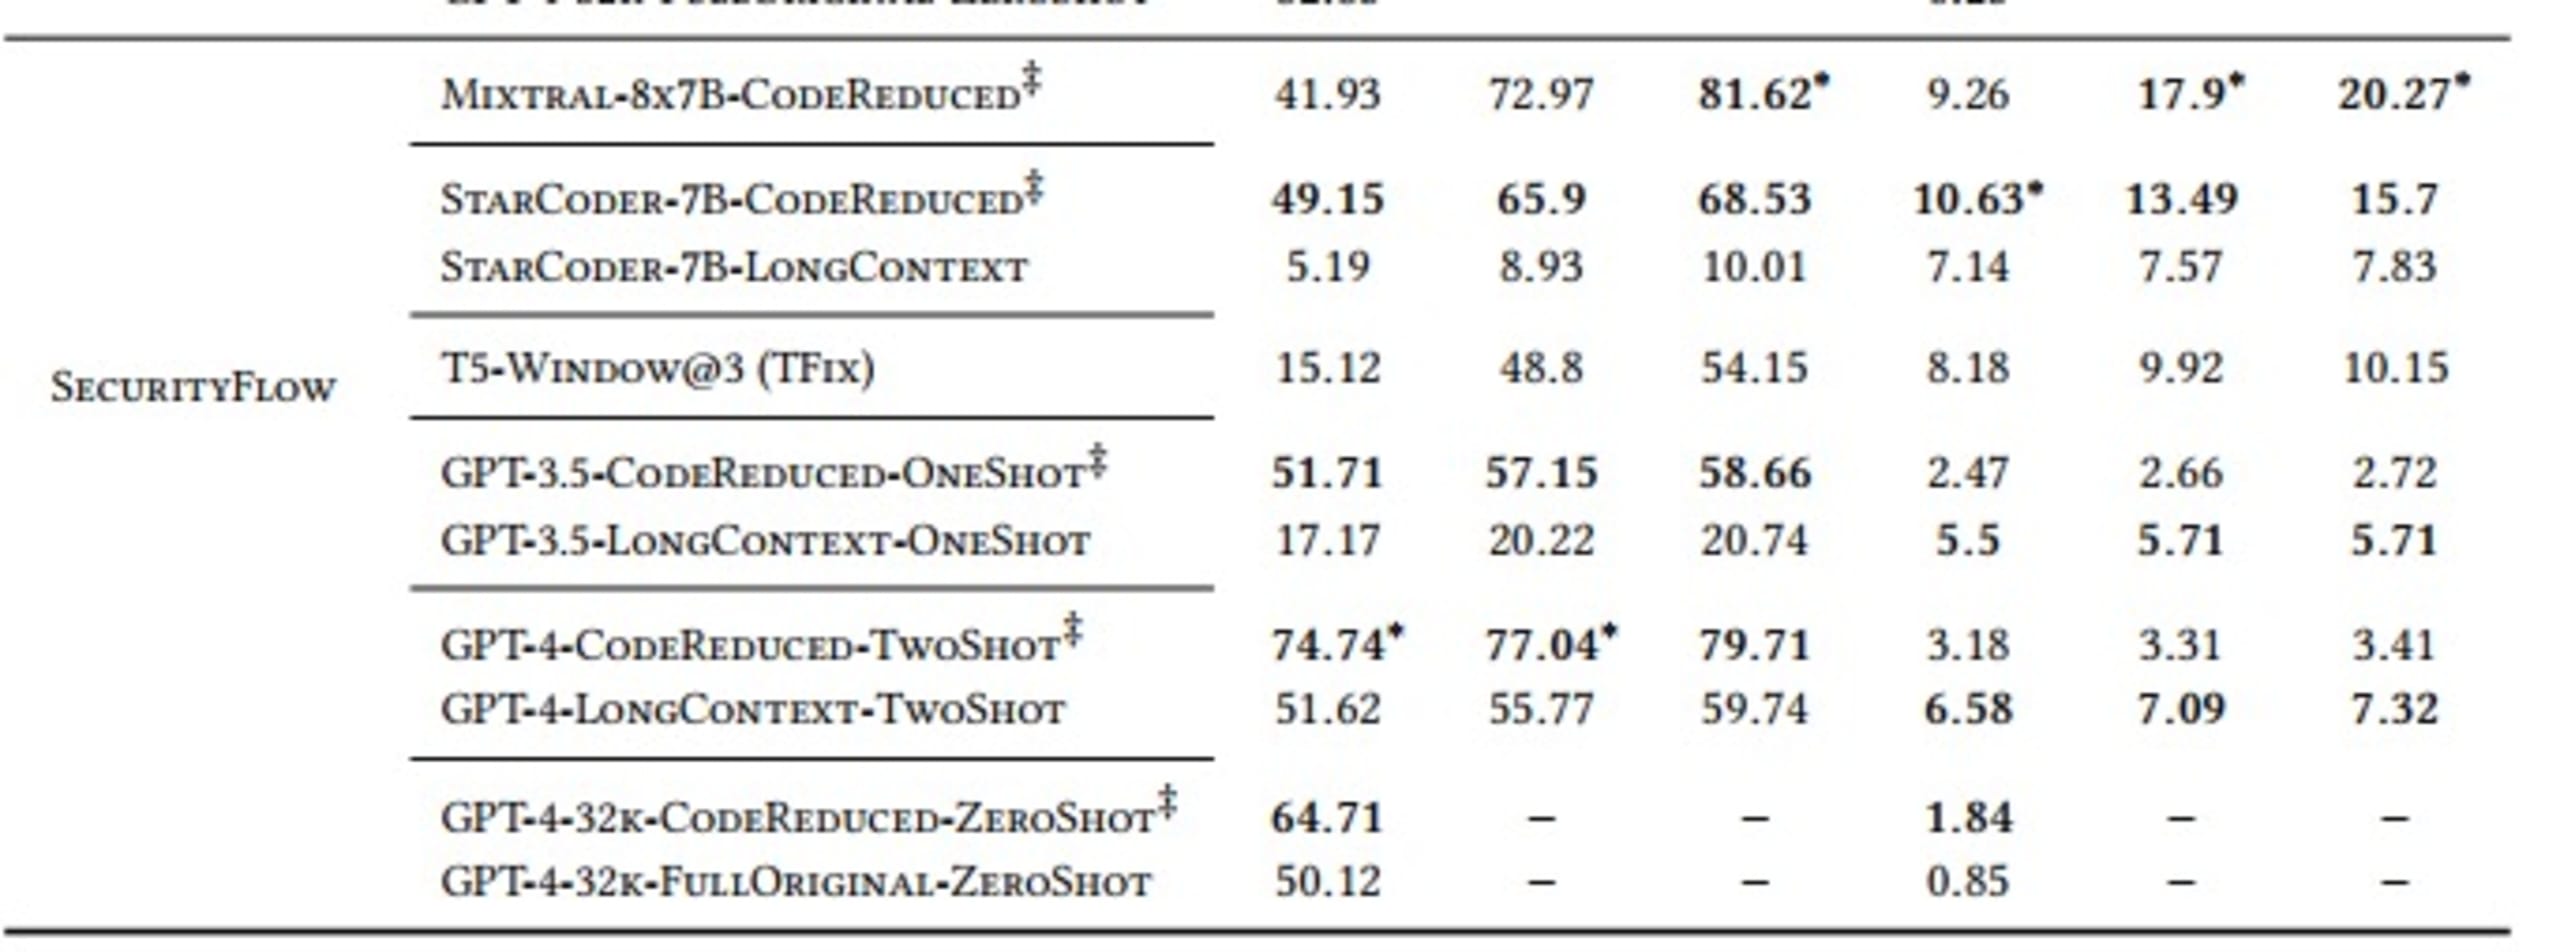
Comme le montre le tableau, les modèles qui apprennent habituellement les dépendances complexes à longue portée nécessaires pour générer un correctif correct obtiennent de bien meilleurs résultats lorsqu’ils utilisent le contexte de code extrait par CodeReduce que lorsqu’ils génèrent des correctifs sans son aide. L’amélioration spectaculaire du résultat Pass@5 pour la correction des problèmes AST avec le modèle StarCoder en est un bon exemple : le taux de réussite passe de 19,3 % sans CodeReduce à 82,31 % avec CodeReduce.
À retenir
Dans l’ensemble, Snyk Agent Fix a surpassé la référence de pointe précédente établie par TFix et a amélioré les performances de plusieurs modèles d’IA populaires dans différentes configurations. Snyk Agent Fix y parvient grâce à l’analyse de programmes et à la technologie exclusive CodeReduce de Snyk, qui gère les dépendances à longue portée et les flux de données. Snyk Agent Fix simplifie ainsi considérablement l’apprentissage des problèmes de sécurité pertinents en ciblant son attention, ce qui permet de générer des correctifs plus précis et plus pertinents.
Vous pouvez dès maintenant découvrir toute la puissance de Snyk Agent Fix dans votre IDE : inscrivez-vous à Snyk Code, puis activez « Snyk Code Fix Suggestions » dans les paramètres de Snyk Preview. Pour en savoir plus, consultez notre documentation, et contribuez à façonner l’avenir de Snyk Agent Fix en nous faisant part de vos commentaires sur les correctifs dans Snyk Code.
Lancez-vous dans les compétitions Capture The Flag
Apprenez à résoudre des défis Capture The Flag en regardant à la demande notre atelier virtuel d’initiation.