Simplifier la sécurité des conteneurs grâce à l’expertise de Snyk

Hadas Bloom
8 mars 2022
0 minutes de lectureCe qu’il y a de plus beau et d’inspirant dans le code open source, c’est justement qu’il est open source. Nous pouvons voir les packages open source comme des cadeaux que les développeurs s’échangent dans le monde de l’ingénierie : ils leur permettent de découvrir le travail des autres, d’apporter leur propre expertise et de développer leurs compétences professionnelles. Les contributions à l’open source sont très appréciées. Il est important de se rappeler qu’il faut non seulement tirer parti de ces projets, mais aussi y contribuer. Cette collaboration au sein de la communauté fait évoluer continuellement l’open source, les connaissances et les packages partagés servant de fondations à des technologies nouvelles et passionnantes.
Mais ces bibliothèques et projets gratuits comportent aussi des risques, qu’ils soient accidentels ou causés par des acteurs malveillants — et c’est précisément là que Snyk intervient, et pour cette raison.
Naturellement, avec l’évolution constante des technologies open source, comme les nouvelles distributions Linux et leurs évolutions, ainsi que les outils de conteneurisation tels que Docker, les images regroupant ces packages open source sont de plus en plus nombreuses à être créées et utilisées. En résumé, une image de conteneur est un fichier qui contient le code, les bibliothèques, les dépendances et les autres outils et fichiers nécessaires à l’exécution des applications. Un conteneur, quant à lui, est une instance en cours d’exécution de cette image. Il définit l’« espace » dans lequel l’application s’exécute et est développée. Un conteneur vous permet de créer un environnement dans lequel votre code peut fonctionner. Il s’appuie sur l’image et, en fait, est lancé à partir de celle-ci. Mieux encore, l’un des principaux atouts des images de conteneurs est qu’elles peuvent s’appuyer les unes sur les autres. Vous pouvez commencer par une image contenant uniquement les éléments Linux de base — par exemple alpine de Docker —, y ajouter des outils et des frameworks spécifiques à un langage pour créer une image adaptée à ce langage, puis des outils de développement pour ce langage, et enfin les éléments propres à votre code.
Si une image n’est qu’un fichier contenant un ensemble de packages, vous vous demandez probablement déjà comment déterminer quelles vulnérabilités les affectent. Ne peut-on pas supposer que si une vulnérabilité existe dans un package open source et que ce package est utilisé dans une image, alors l’image est vulnérable ? Excellente question, merci de l’avoir posée ! Tout comme l’utilisation d’une image de base, telle que alpine dans notre exemple ci-dessus, vous apporte de nombreux outils et possibilités, chaque package peut également introduire des vulnérabilités cachées. Dès lors, découvrir les vulnérabilités dans votre propre code ne suffit plus : vous devez aussi vous assurer que votre image de base et toutes les images créées à mesure que vous y ajoutez des outils sont sécurisées.
Dans cet article, nous allons nous concentrer sur la toute première couche de l’image : l’image parente que vous choisissez au départ comme base (alpine dans notre exemple). Cette couche contient généralement la plupart des packages Linux essentiels, ainsi que le gestionnaire de packages Linux. C’est aussi une source de confusion, car, contrairement aux autres éléments que vous pouvez choisir d’ajouter, vous avez très peu de contrôle sur ce que contient cette image de base. Examinons donc de plus près les défis liés aux vulnérabilités des conteneurs, puis voyons comment Snyk peut vous aider à les résoudre.
Comprendre les vulnérabilités Linux dans l’univers des conteneurs
Système de gestion des packages
Chaque distribution Linux (Alpine, Debian, Ubuntu, etc.) possède ses propres responsables de maintenance. Bien qu’elles proposent toutes une version de Linux, ce qui implique certains points communs, elles peuvent définir leurs propres conventions de nommage et de versionnement pour les mises à jour. Elles ne conservent donc pas toujours le même nom ou les mêmes versions que le package amont correspondant. Par conséquent, lorsqu’il s’agit de corriger un problème particulier ou d’appliquer des correctifs généraux au système, les recommandations destinées aux utilisateurs peuvent varier d’une distribution à l’autre.
Prenons par exemple le correctif de CVE-2021-44228, également connue sous le nom de Log4Shell, dans le célèbre package log4j. Le package amont, maintenu par l’équipe Apache dans Maven, s’appelle logging-log4j2, et le correctif de cette vulnérabilité critique a été publié dans la version 2.15.0. Si vous utilisez Debian, le package fourni par Debian s’appelle toutefois apache-log4j2et le correctif a été publié dans la branche stable actuelle, Debian 11 (« bullseye »), en version 2.15.0-1~deb11u1. Dans Ubuntu, le nom est similaire à celui de Debian : apache-log4j2. Mais la version corrigée dans la dernière version d’Ubuntu (21.10) est 2.15.0-0.21.10.1.
Récapitulatif des packages corrigés pour CVE-2021-44228 :
Nom du package | Version corrigée | |
|---|---|---|
Amont Java (Maven) | logging-log4j2 | 2.15.0 |
Debian 11 (« Bullseye ») | apache-log4j2 | 2.15.0~deb11u1 |
Ubuntu 21.10 (« Impish Indri ») | apache-log4j2 | 2.15.0-0.21.10.1 |
Cet exemple relativement simple montre que même si nos analystes de sécurité ont découvert ou évalué une vulnérabilité dans un package open source amont, nous ne pouvons pas présumer immédiatement de savoir quel package correspondant est utilisé dans les différentes distributions Linux, quelles versions sont concernées, ni même si une distribution donnée est touchée. Les packages intégrés aux différentes images nécessitent un processus d’évaluation distinct.
Ce mode de gestion des noms et des versions facilite le suivi des différentes versions par les équipes des distributions Linux, leur permet de déterminer la version amont utilisée à partir de leur propre format, et leur donne le contrôle de leurs packages. Chaque distribution gère et assume la responsabilité de tous les aspects de la compilation et de la création des packages utilisés dans son écosystème. Le fait de gérer leurs propres noms et versions de packages leur permet de contrôler correctement les correctifs et les rétroportages dans leur système.
La méthode la plus juste consiste à considérer chaque package comme une entité distincte, selon la source depuis laquelle nous pouvons le télécharger. Si le package est hébergé dans le gestionnaire de packages d’une distribution Linux donnée, nous devons le traiter comme un package distinct, même s’il porte le même nom qu’un package géré sur PyPi, Maven ou ailleurs. Il est alors maintenu par une autre équipe, qui l’a compilé spécifiquement pour répondre aux exigences et aux besoins de son environnement.
Terminologie et structure des données
Outre les noms et versions de packages propres à chaque distribution Linux, les termes utilisés pour définir les différents aspects des données de sécurité fournies par chaque source varient également.
Par exemple, la définition de la gravité « critique » peut varier. Une équipe peut employer le terme « critique » plus souvent et plus librement qu’une autre, qui utilise généralement la gravité « élevée » et ne qualifie une vulnérabilité de « critique » que dans des cas très précis.
À l’inverse, des termes différents peuvent en réalité signifier la même chose et être utilisés de la même manière. C’est le cas, par exemple, de « modérée » et « moyenne », que différentes équipes peuvent employer pour désigner le même niveau de gravité.
De plus, lorsqu’une équipe utilise le terme « importante », par exemple, il faut déterminer s’il désigne l’importance de la priorité à accorder à la correction du problème ou celle de la vulnérabilité elle-même (c’est-à-dire un niveau de gravité relativement élevé).
Pour illustrer cette complexité, examinons CVE-2021-3507, qui affecte Debian :
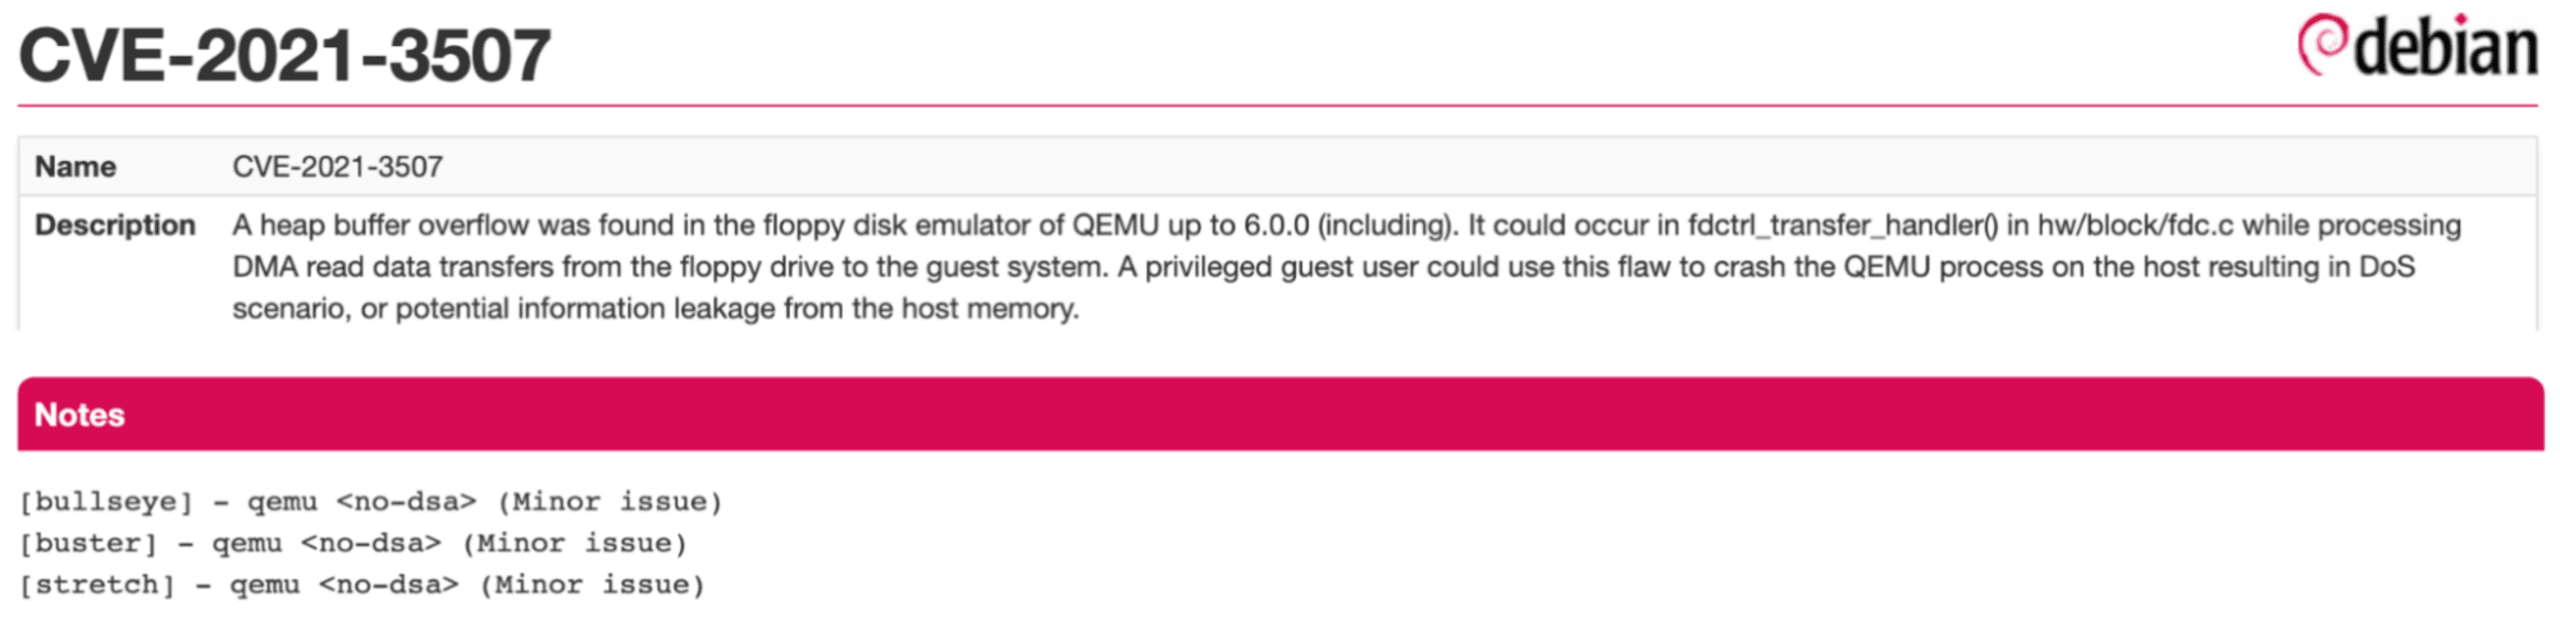
Comme l’indique l’avis cité, cette CVE est qualifiée de <no-dsa> (Minor issue) pour Stretch (Debian 9), Buster (10) et Bullseye (11). Selon les responsables de maintenance Debian, ces mentions indiquent le niveau de gravité du problème pour ces versions de Debian.
De son côté, NVD a attribué à cette CVE un score CVSS « moyen », qui reflète une analyse plus large de la vulnérabilité, particulièrement pertinente pour le package amont qemu.
Une multitude de données
Chaque distribution Linux et chacune de ses versions contiennent de nombreux packages par défaut, auxquels s’ajoutent beaucoup, beaucoup d’autres packages téléchargeables depuis le dépôt de la distribution concernée. Notre conteneur peut donc comporter des centaines de vulnérabilités touchant des packages écrits dans plusieurs langages. Cette multitude de données sur les vulnérabilités dans les conteneurs complique la tâche de Snyk, des équipes de sécurité et des développeurs qui utilisent des conteneurs : il leur faut évaluer et comprendre les vulnérabilités concernées, ainsi que les mesures à prendre. Par conséquent, examiner en détail chaque vulnérabilité représente un véritable défi.
Ces particularités des vulnérabilités des conteneurs rendent difficile l’identification des données les plus précises au sein d’un conteneur. Quelles vulnérabilités concernent exactement un conteneur donné, et quel est le risque réel dans le contexte de ses interactions avec le noyau Linux et l’application qui s’y exécute ? Notre équipe dédiée aux vulnérabilités des conteneurs chez Snyk s’efforce continuellement de répondre à ces questions avec la plus grande précision. Nous avons conçu un modèle complexe qui prend en compte de nombreux facteurs afin d’identifier ces vulnérabilités avec précision et de les prioriser.
Comment résoudre ces difficultés ?
Après avoir défini la complexité du problème, voyons comment identifier les données les plus précises. Le processus de collecte, d’analyse et de signalement des vulnérabilités pertinentes des conteneurs commence par un pipeline évolutif, capable de traiter intelligemment et automatiquement de grandes quantités de données issues de nombreuses sources, tout en faisant intervenir des experts au besoin. Il nécessite une connaissance approfondie, fondée sur une combinaison d’expertise en sécurité et de collaboration avec les différentes équipes de sécurité des distributions Linux, qui apportent le contexte complémentaire dont nous avons besoin. Forts de ces connaissances issues de nombreuses sources, nous pouvons recueillir et sélectionner les informations les plus pertinentes et utiles. Enfin, nous pouvons prioriser les vulnérabilités dans leur contexte spécifique en tenant compte de tous ces facteurs, ainsi que de tout autre élément externe disponible, afin de réduire le bruit non pertinent. Voici ce que cela signifie pour nous chez Snyk.
Comment Snyk analyse-t-il les vulnérabilités des conteneurs et de Linux ?
L’objectif principal de notre équipe Container Security est de répondre aux questions suivantes : Quelles vulnérabilités affectent un conteneur, quelle est la priorité pour les corriger et que puis-je faire à leur sujet ?
Voici comment nous veillons à répondre à ces questions avec la plus grande précision, de manière exhaustive et dans les meilleurs délais :
Collecte des données en temps voulu
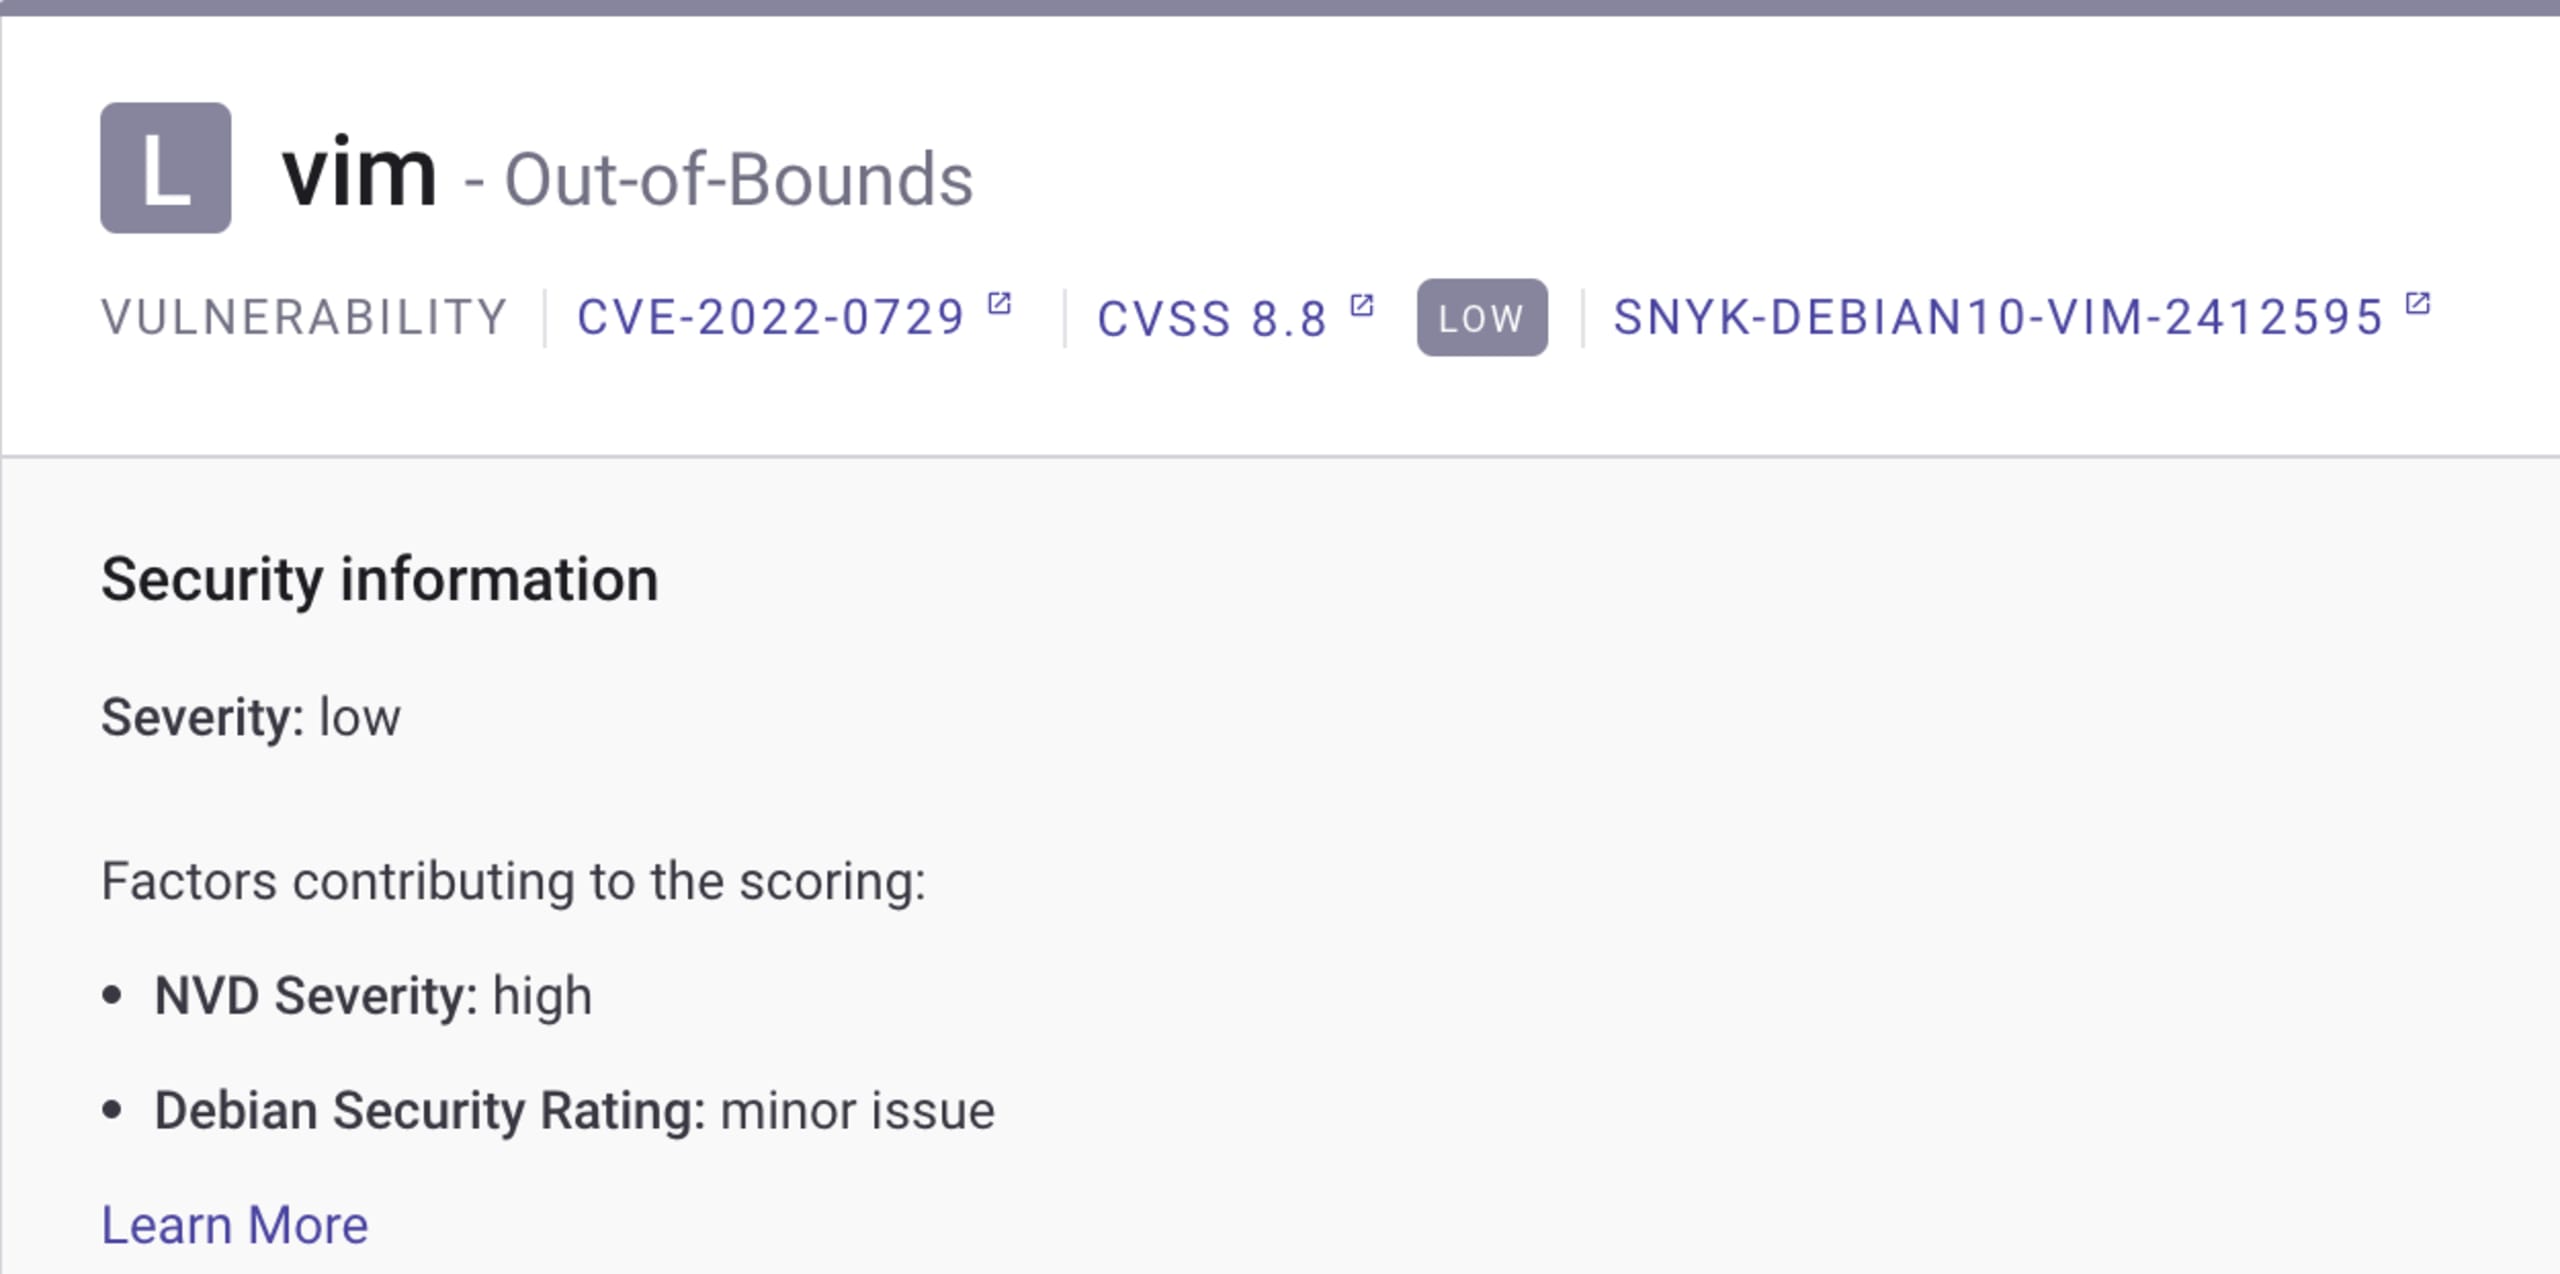
Nous collectons de manière indépendante les données de sécurité auprès des différentes sources des distributions Linux. Nous suivons ainsi les nouvelles versions et les avis de sécurité, qu’ils concernent des packages ou une nouvelle version complète de la distribution, dès leur publication. Nous devons donc mettre immédiatement à jour nos données sur les vulnérabilités à mesure que les sources des distributions Linux fournissent de nouvelles informations. Par exemple, nos résultats Snyk Container indiquent directement l’importance relative d’une vulnérabilité, qui détermine sa gravité dans le contexte de l’image concernée. Dans l’exemple ci-dessous, le score CVSS initial est de 8,8, ce qui correspond à une gravité « élevée ». Toutefois, les responsables de maintenance Debian ont analysé la vulnérabilité dans Debian 10 (la version utilisée dans ce conteneur) et l’ont considérée comme un « problème mineur », ce qui donne une gravité globale « faible » dans Snyk. Il s’agit d’une donnée très importante pour prioriser et évaluer correctement la vulnérabilité, car elle aide à déterminer lesquels des nombreux problèmes traiter en premier.
Collaboration et connaissance approfondie des écosystèmes des distributions Linux
Pour comprendre les données de sécurité de chaque distribution Linux, nous l’étudions, analysons ses composants et vérifions que les données sont complètes. Nous identifions également les cas particuliers et les éventuelles données supplémentaires fournies par la distribution, que nous pouvons utiliser pour le triage. Par exemple, en cherchant à améliorer les informations de sécurité sur Red Hat, nous avons remarqué que ses pages publiques sur les vulnérabilités contenaient plus d’informations que ses flux OVAL. Elles précisaient notamment si une vulnérabilité était under investigation ou not affecting sur un produit spécifique de Red Hat. Nous l’avons signalé à l’équipe de sécurité de Red Hat qui, depuis, a ajouté ces informations importantes à ses flux OVAL, la source officielle de données de sécurité que nous utilisons.
L’expertise humaine en sécurité
Dans notre processus largement automatisé, fondé sur les recherches décrites ci-dessus, nous sollicitons l’avis d’un expert en sécurité dans certaines situations. C’est le cas, par exemple, lorsqu’un avis est supprimé par la distribution et que nous voulons le vérifier avant de le révoquer. Notre processus de révocation sophistiqué est essentiel : il permet à nos systèmes automatisés de ne supprimer aucune vulnérabilité ayant un impact, tout en évitant les faux positifs et en facilitant le travail des développeurs.
Enrichissements et sources supplémentaires
Nous enrichissons nos données sur les vulnérabilités à partir de sources externes, que nous ajoutons régulièrement. Il s’agit notamment des données du NVD, d’informations sur les exploits, des tendances sur Twitter et, comme annoncé récemment, des signaux d’exécution de Sysdig.
Priorisation contextuelle
À partir de toutes ces informations, nous établissons la priorité des vulnérabilités à l’aide de notre score de priorité exclusif, évaluons leur gravité, ajoutons des données pour mieux les contextualiser et les présentons de la manière la plus utile pour le triage et la compréhension.
Un aperçu de l’avenir de la recherche sur les vulnérabilités des conteneurs avec Snyk Container
Nous avons de nombreux projets à venir pour mieux gérer les vulnérabilités des conteneurs.
Les informations de sécurité Snyk en sont un exemple. Elles visent à réduire au maximum le bruit dans un environnement qui en génère déjà beaucoup. En fournissant des informations de sécurité adaptées à des situations et à des conditions précises, nous aiderons à déterminer si une vulnérabilité est sans pertinence dans une configuration, un environnement ou une application donnée, et à collaborer avec les développeurs pour trier les vulnérabilités.
Parmi les informations sur les vulnérabilités de Snyk Container sur lesquelles nous travaillons, nous pourrions recommander d’ignorer une vulnérabilité présente dans un paquet utilisé au moment de la compilation, voire de supprimer entièrement le paquet concerné — ce qui éliminerait automatiquement les autres vulnérabilités de ce même paquet. Cette approche repose sur l’hypothèse initiale, étayée par nos recherches, qu’une vulnérabilité a peu de chances d’être exploitée au moment de la compilation et que les vulnérabilités affectant les applications en cours d’exécution doivent être nettement prioritaires. On peut y voir l’inverse de l’intégration Sysdig : Sysdig vous indique ce qui s’exécute en production, ce qui augmente la priorité de correction d’une vulnérabilité ; les informations de Snyk sur la compilation pourraient, elles, diminuer cette priorité, voire permettre d’ignorer facilement la vulnérabilité automatiquement, lorsqu’elle concerne des outils de compilation qui ne s’exécutent pas en production.
Nous travaillons également à ajouter des métadonnées aux vulnérabilités des conteneurs afin de fournir des informations plus pertinentes et de rendre la priorisation et l’analyse plus efficaces. Ces données supplémentaires incluent, par exemple, des informations sur l’fix state associé à la vulnérabilité (sera-t-elle un jour corrigée ? Un correctif a-t-il déjà été fusionné et attend-il sa publication ?), ainsi que des notes de sécurité qui précisent la gravité ou d’autres états de la vulnérabilité. Bien entendu, nous continuons aussi à étudier et à étendre la prise en charge d’autres distributions.
La gestion des vulnérabilités dans vos conteneurs est complexe, mais vous n’avez pas à vous en charger seul. Les informations de sécurité de pointe de Snyk s’améliorent et évoluent constamment : pas besoin d’être expert pour rester en sécurité, il vous suffit de créer un compte Snyk gratuit.
La sécurité des conteneurs, pensée pour les développeurs
Snyk détecte et corrige automatiquement les vulnérabilités dans les images de conteneurs et les workloads Kubernetes.