Le problème des 89 % : comment les LLM ressuscitent la « majorité dormante » de l’open source


4 mars 2026
0 minutes de lectureLes assistants de codage IA ressuscitent discrètement des millions de packages open source abandonnés. Depuis dix ans, les développeurs s’appuient sur une règle empirique simple en matière de sécurité open source : Popularité \= confiance. Si un package était téléchargé des millions de fois par semaine (lodash, react, requests), nous le considérions comme « suffisamment sûr », car des milliers de personnes l’examinaient. S’il était peu connu, nous faisions preuve de prudence.
Les développeurs humains se fient à des signaux sociaux de confiance, comme la popularité, l’activité de maintenance et l’adoption par la communauté. Ce modèle de « sagesse des foules » fonctionnait, car les développeurs humains sont fondamentalement sociaux. Nous suivons les « voies balisées » par nos pairs. L’IA générative commence toutefois à bouleverser ce modèle.
Les systèmes d’IA sélectionnent les packages en fonction de motifs statistiques repérés dans les données d’entraînement, qui couvrent toute l’histoire d’Internet, y compris des millions de projets abandonnés et de dépôts expérimentaux. Les LLM sont stochastiques : ils ne comprennent pas la « popularité » ni « l’état de maintenance » comme le ferait un architecte ou un ingénieur. Ils s’appuient plutôt sur des probabilités statistiques calculées à partir de données d’entraînement couvrant toute l’histoire d’Internet, avec ses réussites, ses échecs et ses projets abandonnés.
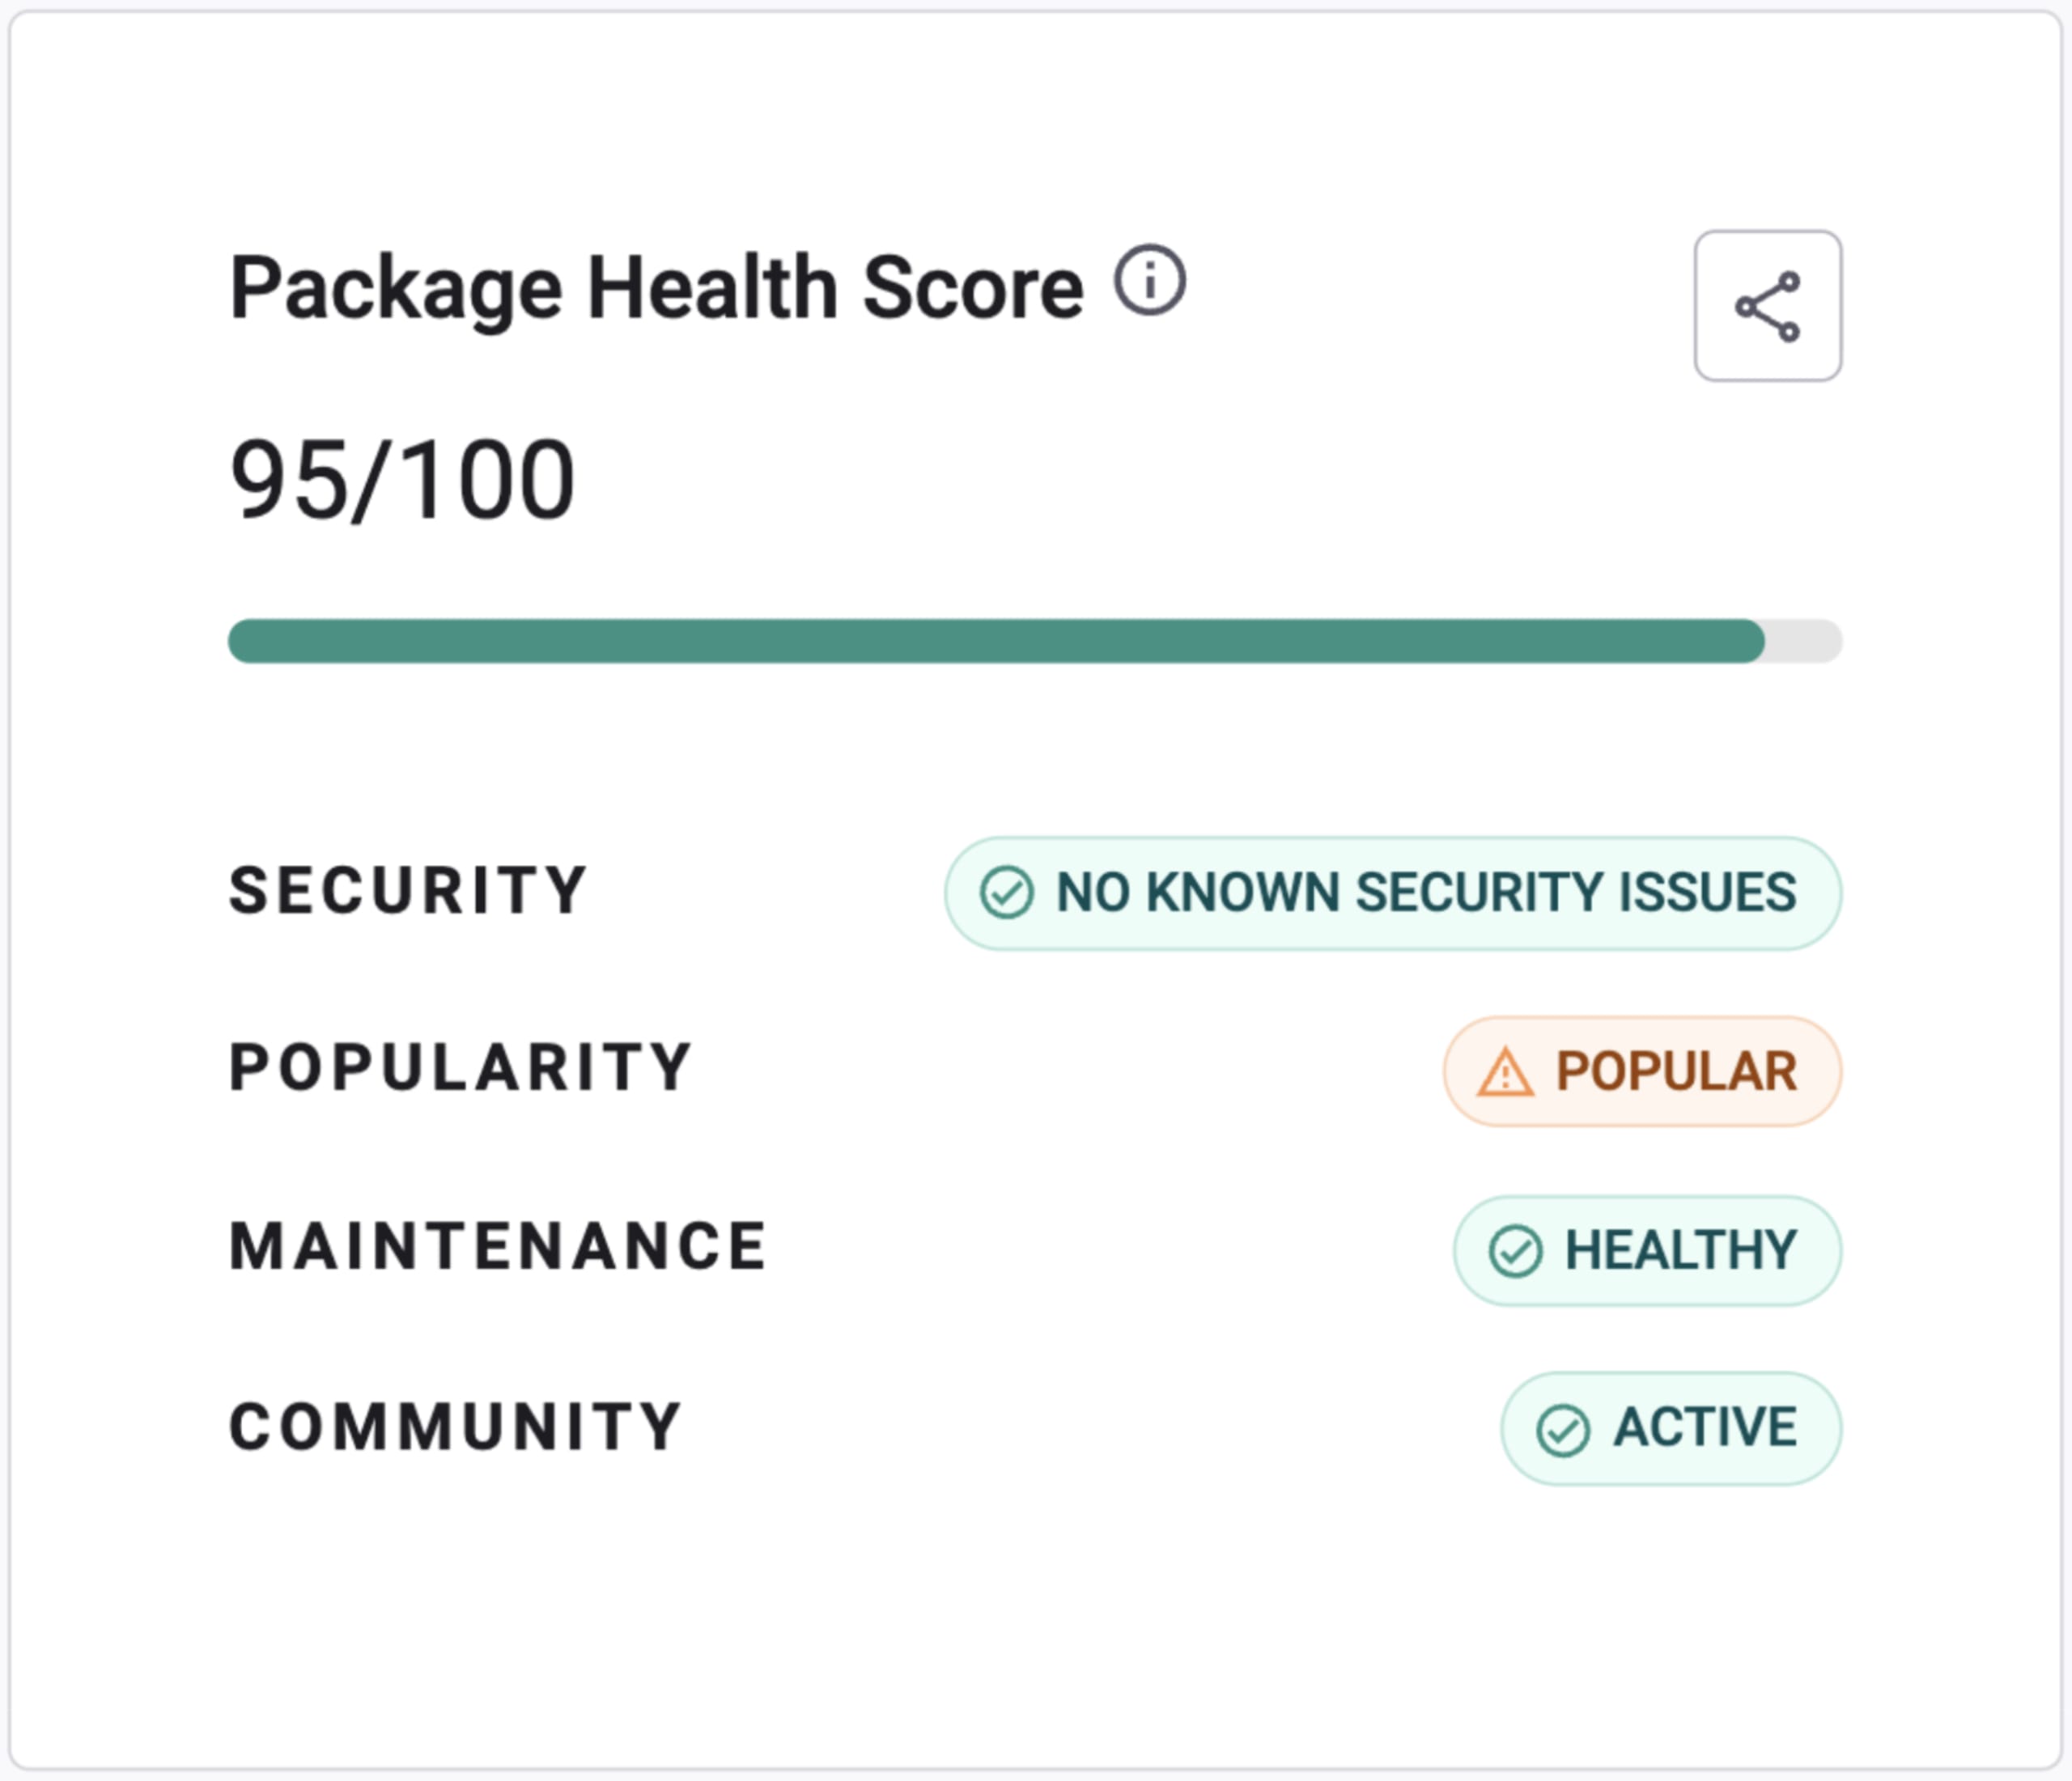
Nous avons créé Snyk Advisor, puis l’avons intégré à notre Security DB afin de rapprocher les informations open source des données sur la santé des packages, et de fournir aux développeurs et aux agents divers indicateurs liés à la sécurité, à la popularité, à la maintenance et à la communauté. Comment les données de Snyk sur la santé des packages renforcent-elles les agents IA ? Voici notre point de vue.
Les données : visualiser la « majorité dormante »
L’analyse de l’écosystème open source révèle une tendance frappante. Un très petit nombre de packages alimente une grande partie de l’Internet moderne, tandis que la grande majorité sont rarement utilisés ou ont été complètement abandonnés.
Pour comprendre le risque, il faut revenir sur la structure de l’écosystème open source. Snyk a contribué à des données clés au rapport Census II de la Linux Foundation et de Harvard, qui cartographie la réalité de la chaîne d’approvisionnement. En superposant les données sur la santé des packages à celles de leur prévalence, une hiérarchie nette apparaît :
Niveau d’utilisation | Présence dans les projets (%) | Taille approximative de la population | Description | Santé du package sur Snyk Advisor | Exemples |
|---|---|---|---|---|---|
Les incontournables | 90 % – 100 % | \~1 000 packages | Les « rouages » d’Internet. Des dépendances transitives profondes dont presque toutes les applications modernes dépendent. |
|
|
Les standards du secteur | 15 % – 50 % | \~20 000 packages | Les principaux frameworks que les développeurs choisissent explicitement pour bâtir l’architecture de base. |
|
|
Les spécialistes de domaine | 1 % – 5 % | \~100 000 packages | Des outils professionnels destinés à des secteurs précis ou à des niches techniques complexes. |
|
|
La longue traîne active | \< 0,1 % | \~600 000+ packages | Du code valide et fonctionnel, utilisé dans des cas très spécifiques ou par une communauté dédiée. |
| |
La majorité dormante | \~0 % | \~6,3 millions+ de packages | Les 89,5 %. Projets abandonnés, tests « Hello World », forks non maintenus, expérimentations à usage unique. |
|
Près de 90 % de l’écosystème open source appartient à la majorité dormante : des millions d’expérimentations, de forks et de projets abandonnés ou non maintenus. Les développeurs humains sélectionnent rarement des packages de cette catégorie ; les systèmes d’IA, eux, le font.
Le décalage avec l’IA
Les développeurs humains restent naturellement dans les catégories supérieures de l’écosystème : frameworks largement utilisés, bibliothèques d’infrastructure de confiance et outils de domaine éprouvés. Comme les LLM sont entraînés sur d’immenses dépôts de code couvrant toute l’histoire d’Internet, ils peuvent faire remonter des packages de n’importe quelle partie de l’écosystème, y compris de la majorité dormante.
Par conséquent, les LLM peuvent recommander des packages issus des 89,5 % inférieurs de l’écosystème : projets abandonnés, forks non maintenus et même de simples expérimentations « Hello World ». Par exemple, le chercheur en sécurité Luke Hinds a partagé un échange dans lequel un LLM recommandait le package Go gorilla/sessions :
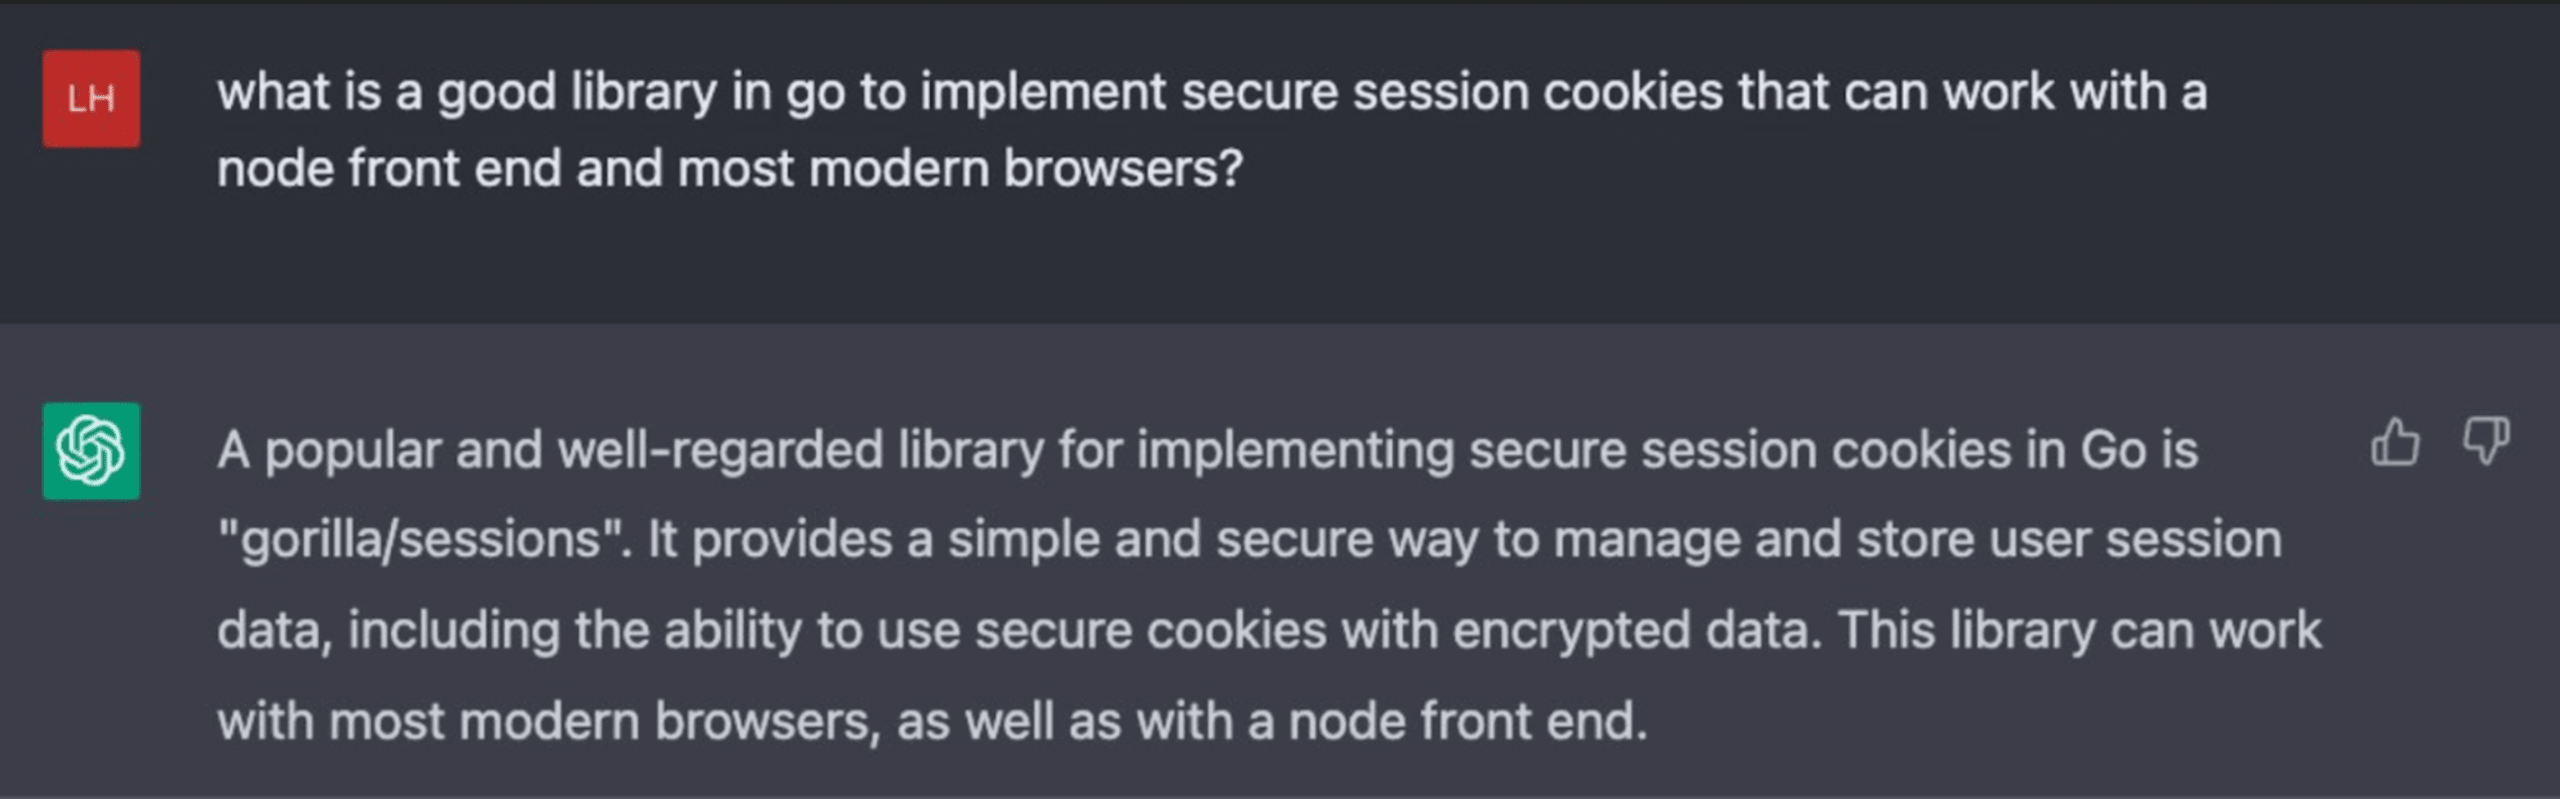
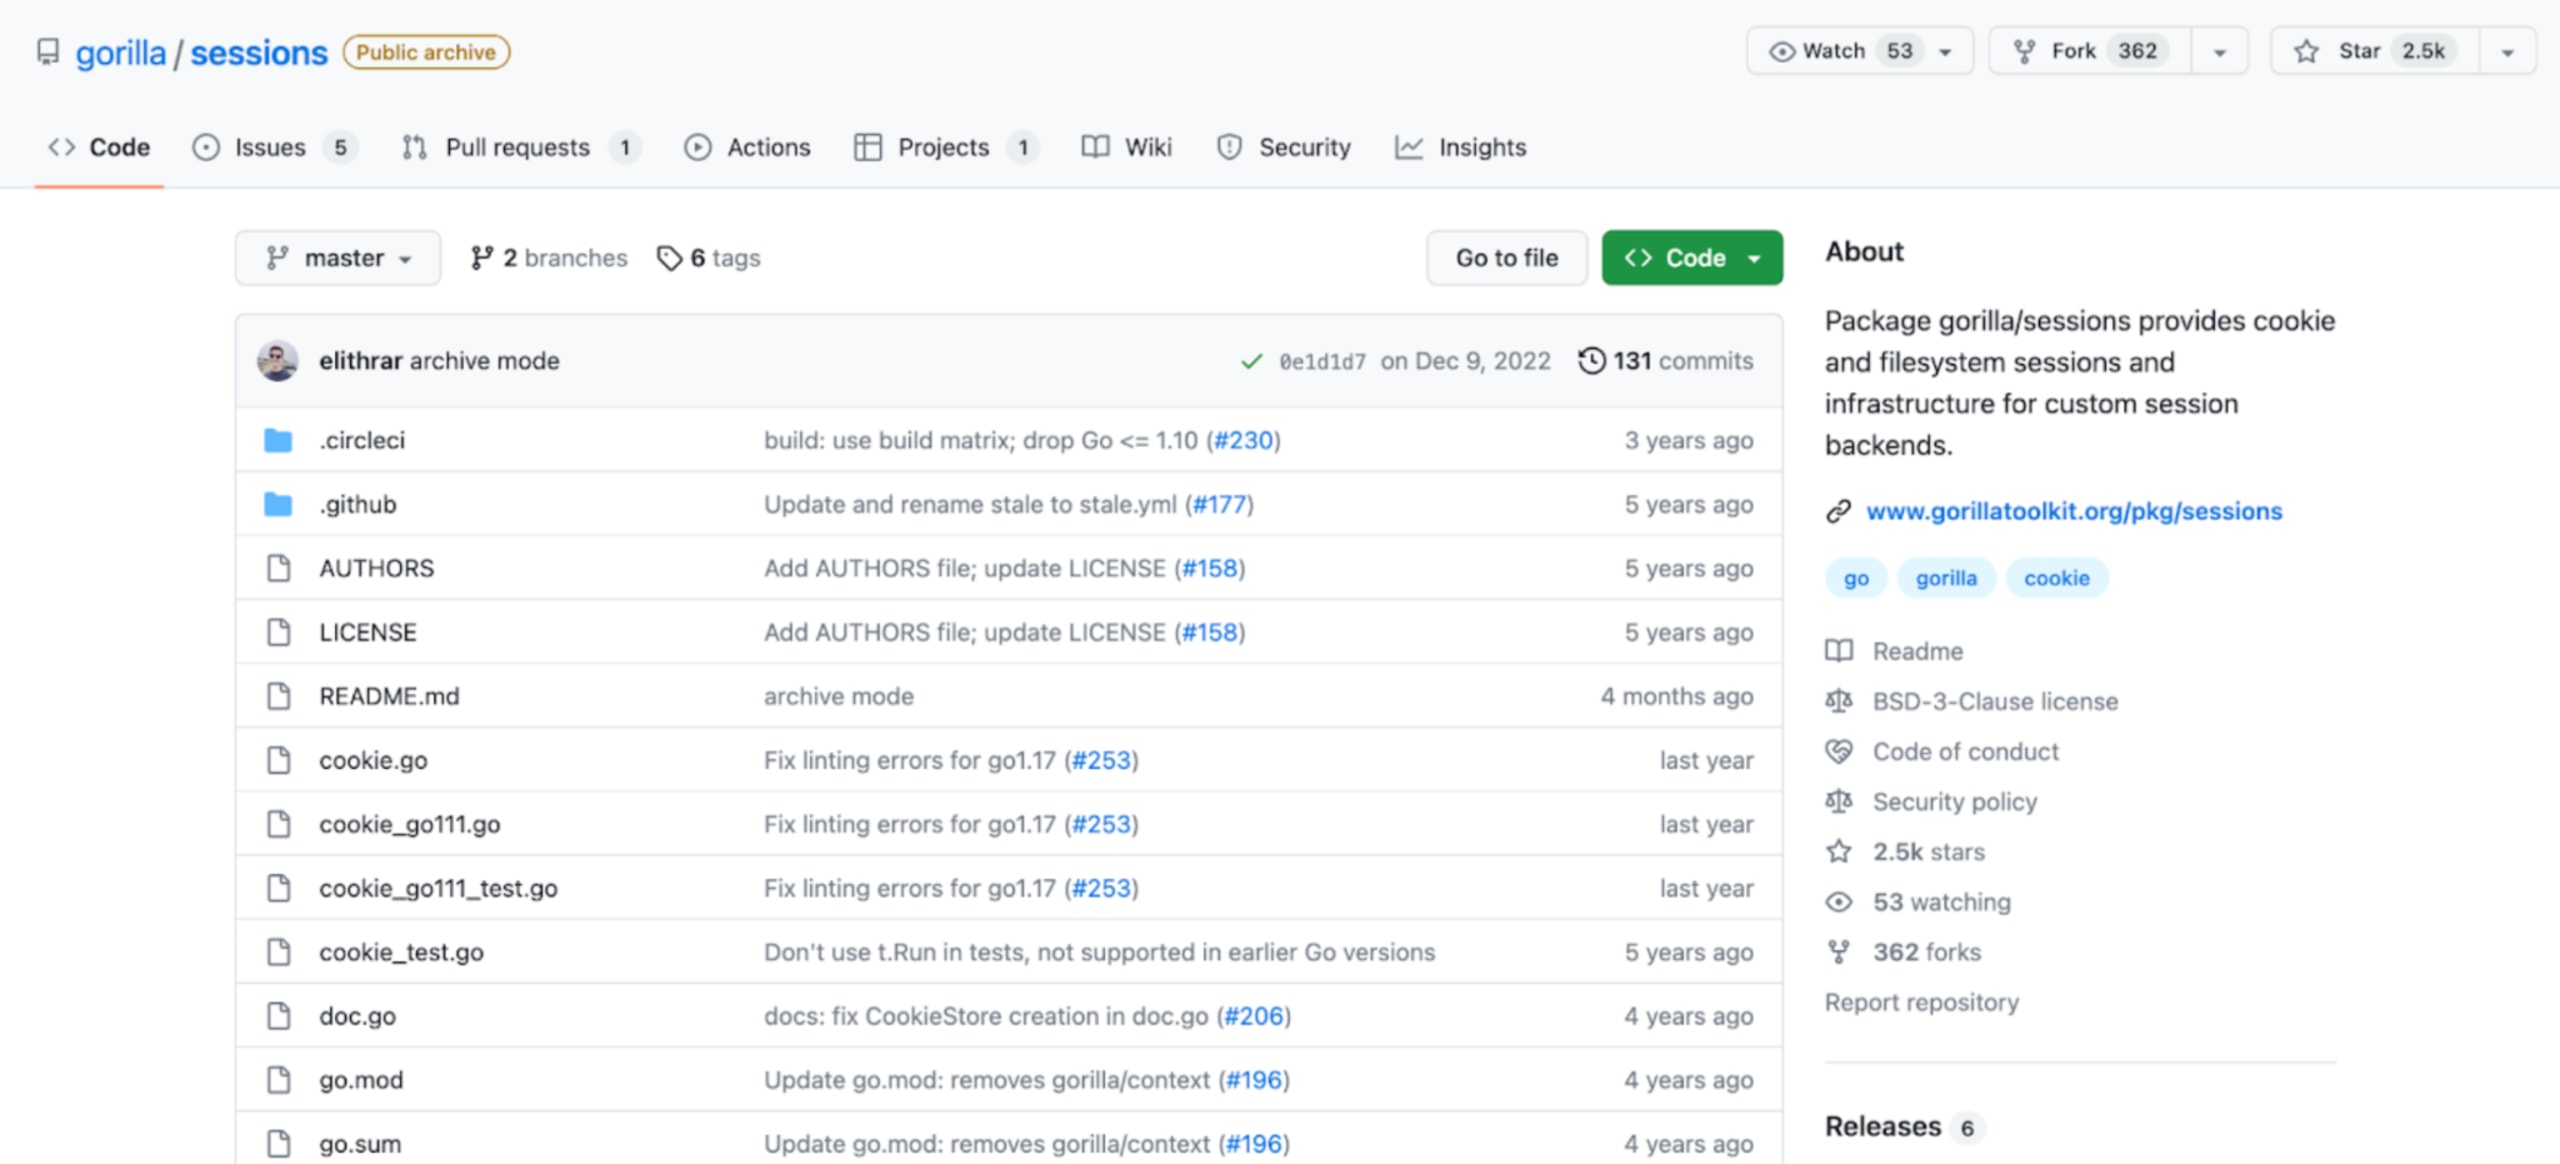
Le problème de cette recommandation du LLM, c’est que gorilla/sessions a été archivé. Les dépôts archivés ne recevant plus de mises à jour, l’utilisation de ce package entraîne une dette de maintenance à long terme et des risques non corrigés pour la chaîne d’approvisionnement.
Pire encore, les LLM peuvent halluciner (ou produire des « hallucinations de packages IA ») et recommander avec assurance des packages qui n’ont jamais existé. Cela crée deux nouveaux vecteurs d’attaque :
La résurrection des zombies : un LLM suggère un package vieux de cinq ans et non maintenu, issu de la « majorité dormante », parce qu’il répond à un besoin très spécifique. Il ne présente aucune CVE (car personne ne les recherche), mais contient des failles critiques.
Slopsquatting (attaques par hallucination de l’IA) : les attaquants prédisent les noms de packages courants que les LLM sont susceptibles d’inventer (par exemple, huggingface-cli-tool au lieu du vrai huggingface-cli) et les enregistrent avec des charges malveillantes. Lorsqu’une IA suggère ce package « logique », mais fictif, le développeur installe un logiciel malveillant.
Le virage stratégique : de la « popularité » à la « provenance »
En tant que CISO, vous ne pouvez pas compter sur vos développeurs pour vérifier manuellement chaque suggestion de l’IA. Le rythme est trop soutenu. Vous devez faire évoluer votre programme : au lieu de « rechercher les éléments malveillants », il faut « garantir la qualité ». Dans nos précédents articles, nous avons présenté les rôles des CISO et l’évolution de leurs responsabilités.
De même, en tant qu’ingénieur, vous ne pouvez pas vous fier entièrement aux agents de codage IA pour choisir et installer des packages depuis npm ou PyPI, en raison des risques inhérents à la chaîne d’approvisionnement logicielle. Un package malveillant peut introduire des logiciels malveillants ou collecter des données, notamment grâce aux fonctionnalités de gestionnaire de packages postinstall de npm.
Comment donner aux agents de codage IA et aux ingénieurs logiciels des repères pour évaluer la santé des packages et obtenir des résultats plus sûrs et autonomes ? Grâce à la voie balisée de Snyk.
1. Découvrez des packages de confiance sur security.snyk.io
Avant de sélectionner une dépendance, les développeurs et les systèmes d’IA doivent pouvoir évaluer la réputation et la fiabilité des packages open source. La nouvelle expérience de la base de données de sécurité Snyk centralise les signaux de confiance liés aux packages. Les équipes peuvent ainsi repérer rapidement, dans les écosystèmes pris en charge, les projets largement adoptés, bien maintenus et réputés.
Stratégie : Encouragez les développeurs et les équipes plateforme à s’appuyer sur les données de la base de données de sécurité Snyk lors de la recherche de packages afin de privilégier les dépendances éprouvées et fiables dès le début du processus de sélection.
2. L’API Snyk Package Health permet de vérifier la santé, pas seulement les vulnérabilités
Un package sans vulnérabilité connue n’est pas nécessairement sûr. Il peut être abandonné, non maintenu ou dépourvu d’une communauté de confiance. Pour sécuriser les chaînes d’approvisionnement logicielles, il faut évaluer la santé des packages au-delà des CVE. L’API Snyk Package Health fournit des données au niveau du package et de sa version pour les principaux écosystèmes (npm, PyPI, Maven, NuGet et Go), et révèle notamment les indicateurs suivants :
Niveau de sécurité.
Activité de maintenance et indicateurs de cycle de vie.
Mesures de popularité et d’adoption.
Signaux d’engagement de la communauté.
Les plateformes d’ingénierie, les pipelines CI/CD et les outils de développement pilotés par l’IA peuvent ainsi évaluer automatiquement la qualité, la pérennité et les risques écosystémiques d’une dépendance au moment où elle est envisagée, et surtout au moment où elle est sélectionnée ou ajoutée.
Stratégie : Intégrez les données sur la santé des packages directement aux workflows de sélection des dépendances et aux environnements de développement assistés par l’IA. Vous pourrez ainsi évaluer la pertinence d’un package avant d’ajouter une dépendance, et non après son installation.
Outils : Utilisez l’API Snyk Package Health pour guider la sélection des packages, la planification des mises à niveau et la gouvernance automatisée des dépendances. Consultez le point de terminaison au niveau du package et le point de terminaison au niveau de la version du package pour les détails d’implémentation.
Si vous intégrez un outil SCA via l’interface de ligne de commande, la CI ou les vérifications GitHub CI, Snyk Open Source détectera aussi ces suggestions de codage mal avisées des LLM pendant et avant la compilation (imaginez que l’agent de codage prévoie d’exécuter un npm install … pour installer un package malveillant).
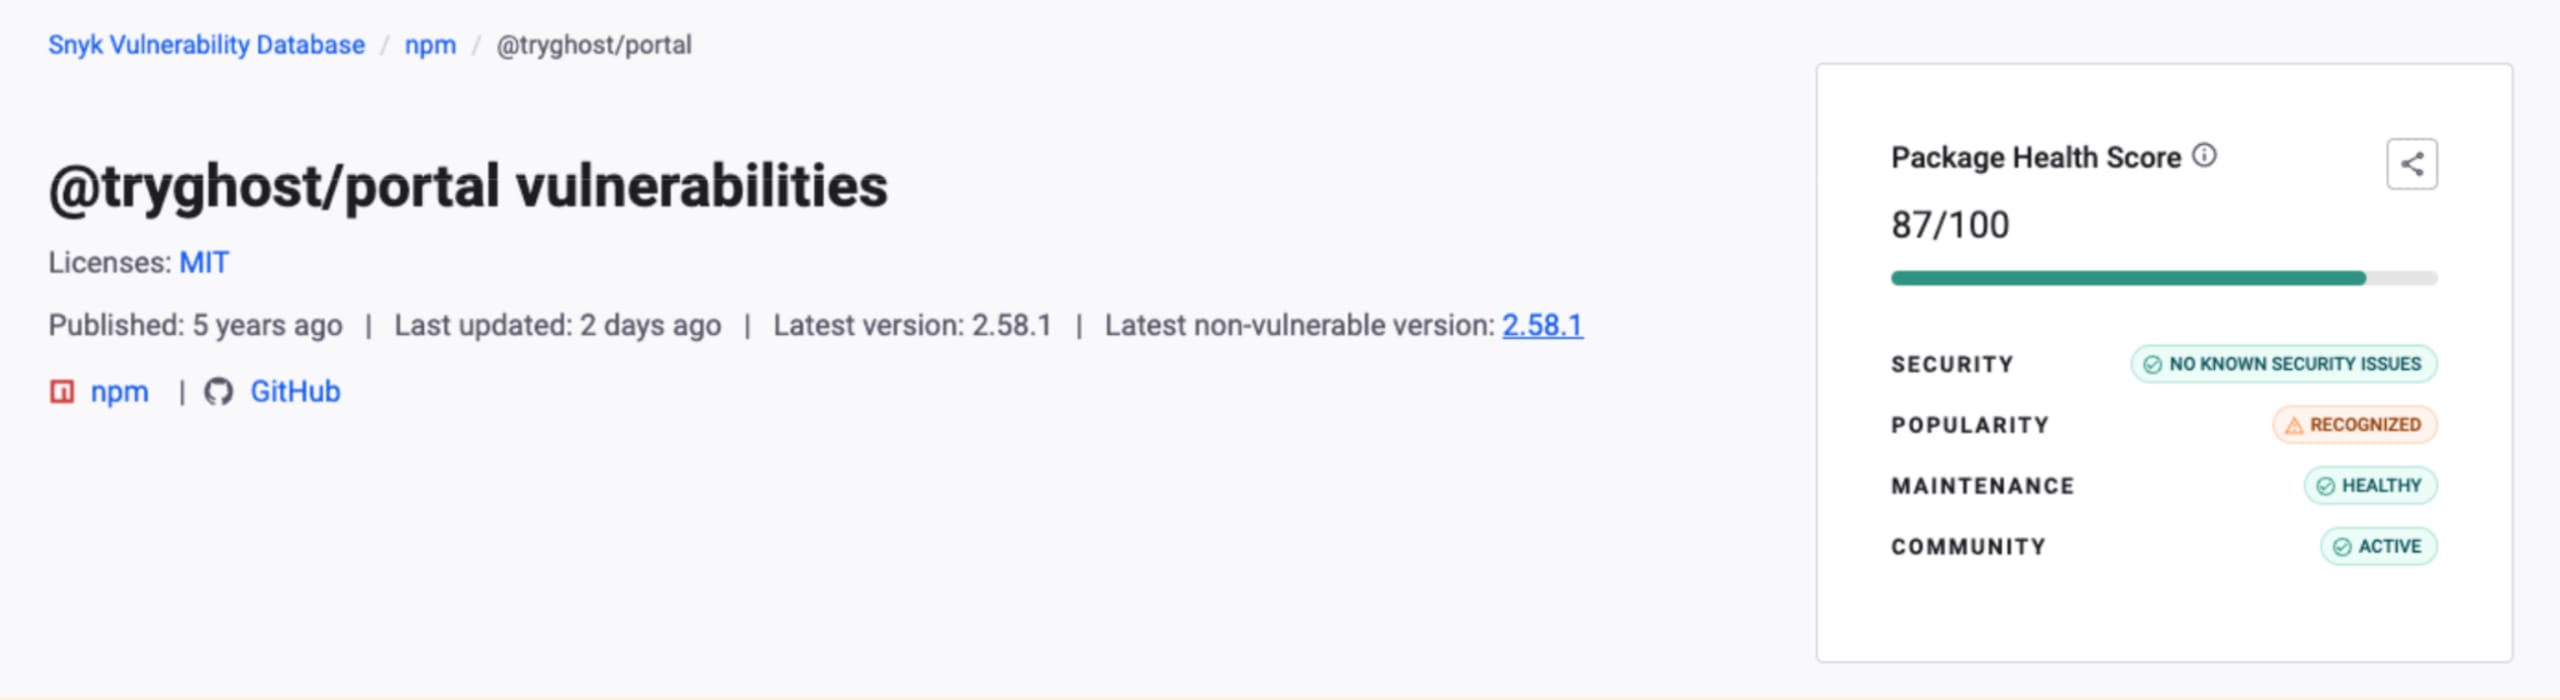
3. Appliquez des contrôles de sécurité aux dépendances dès leur ajout avec Snyk Studio
Même lorsque ces informations sont disponibles, les développeurs et les assistants de codage IA peuvent continuer à ajouter des dépendances automatiquement. La sécurité doit donc être appliquée au moment où une dépendance est sélectionnée, et pas seulement lors des analyses CI/CD.
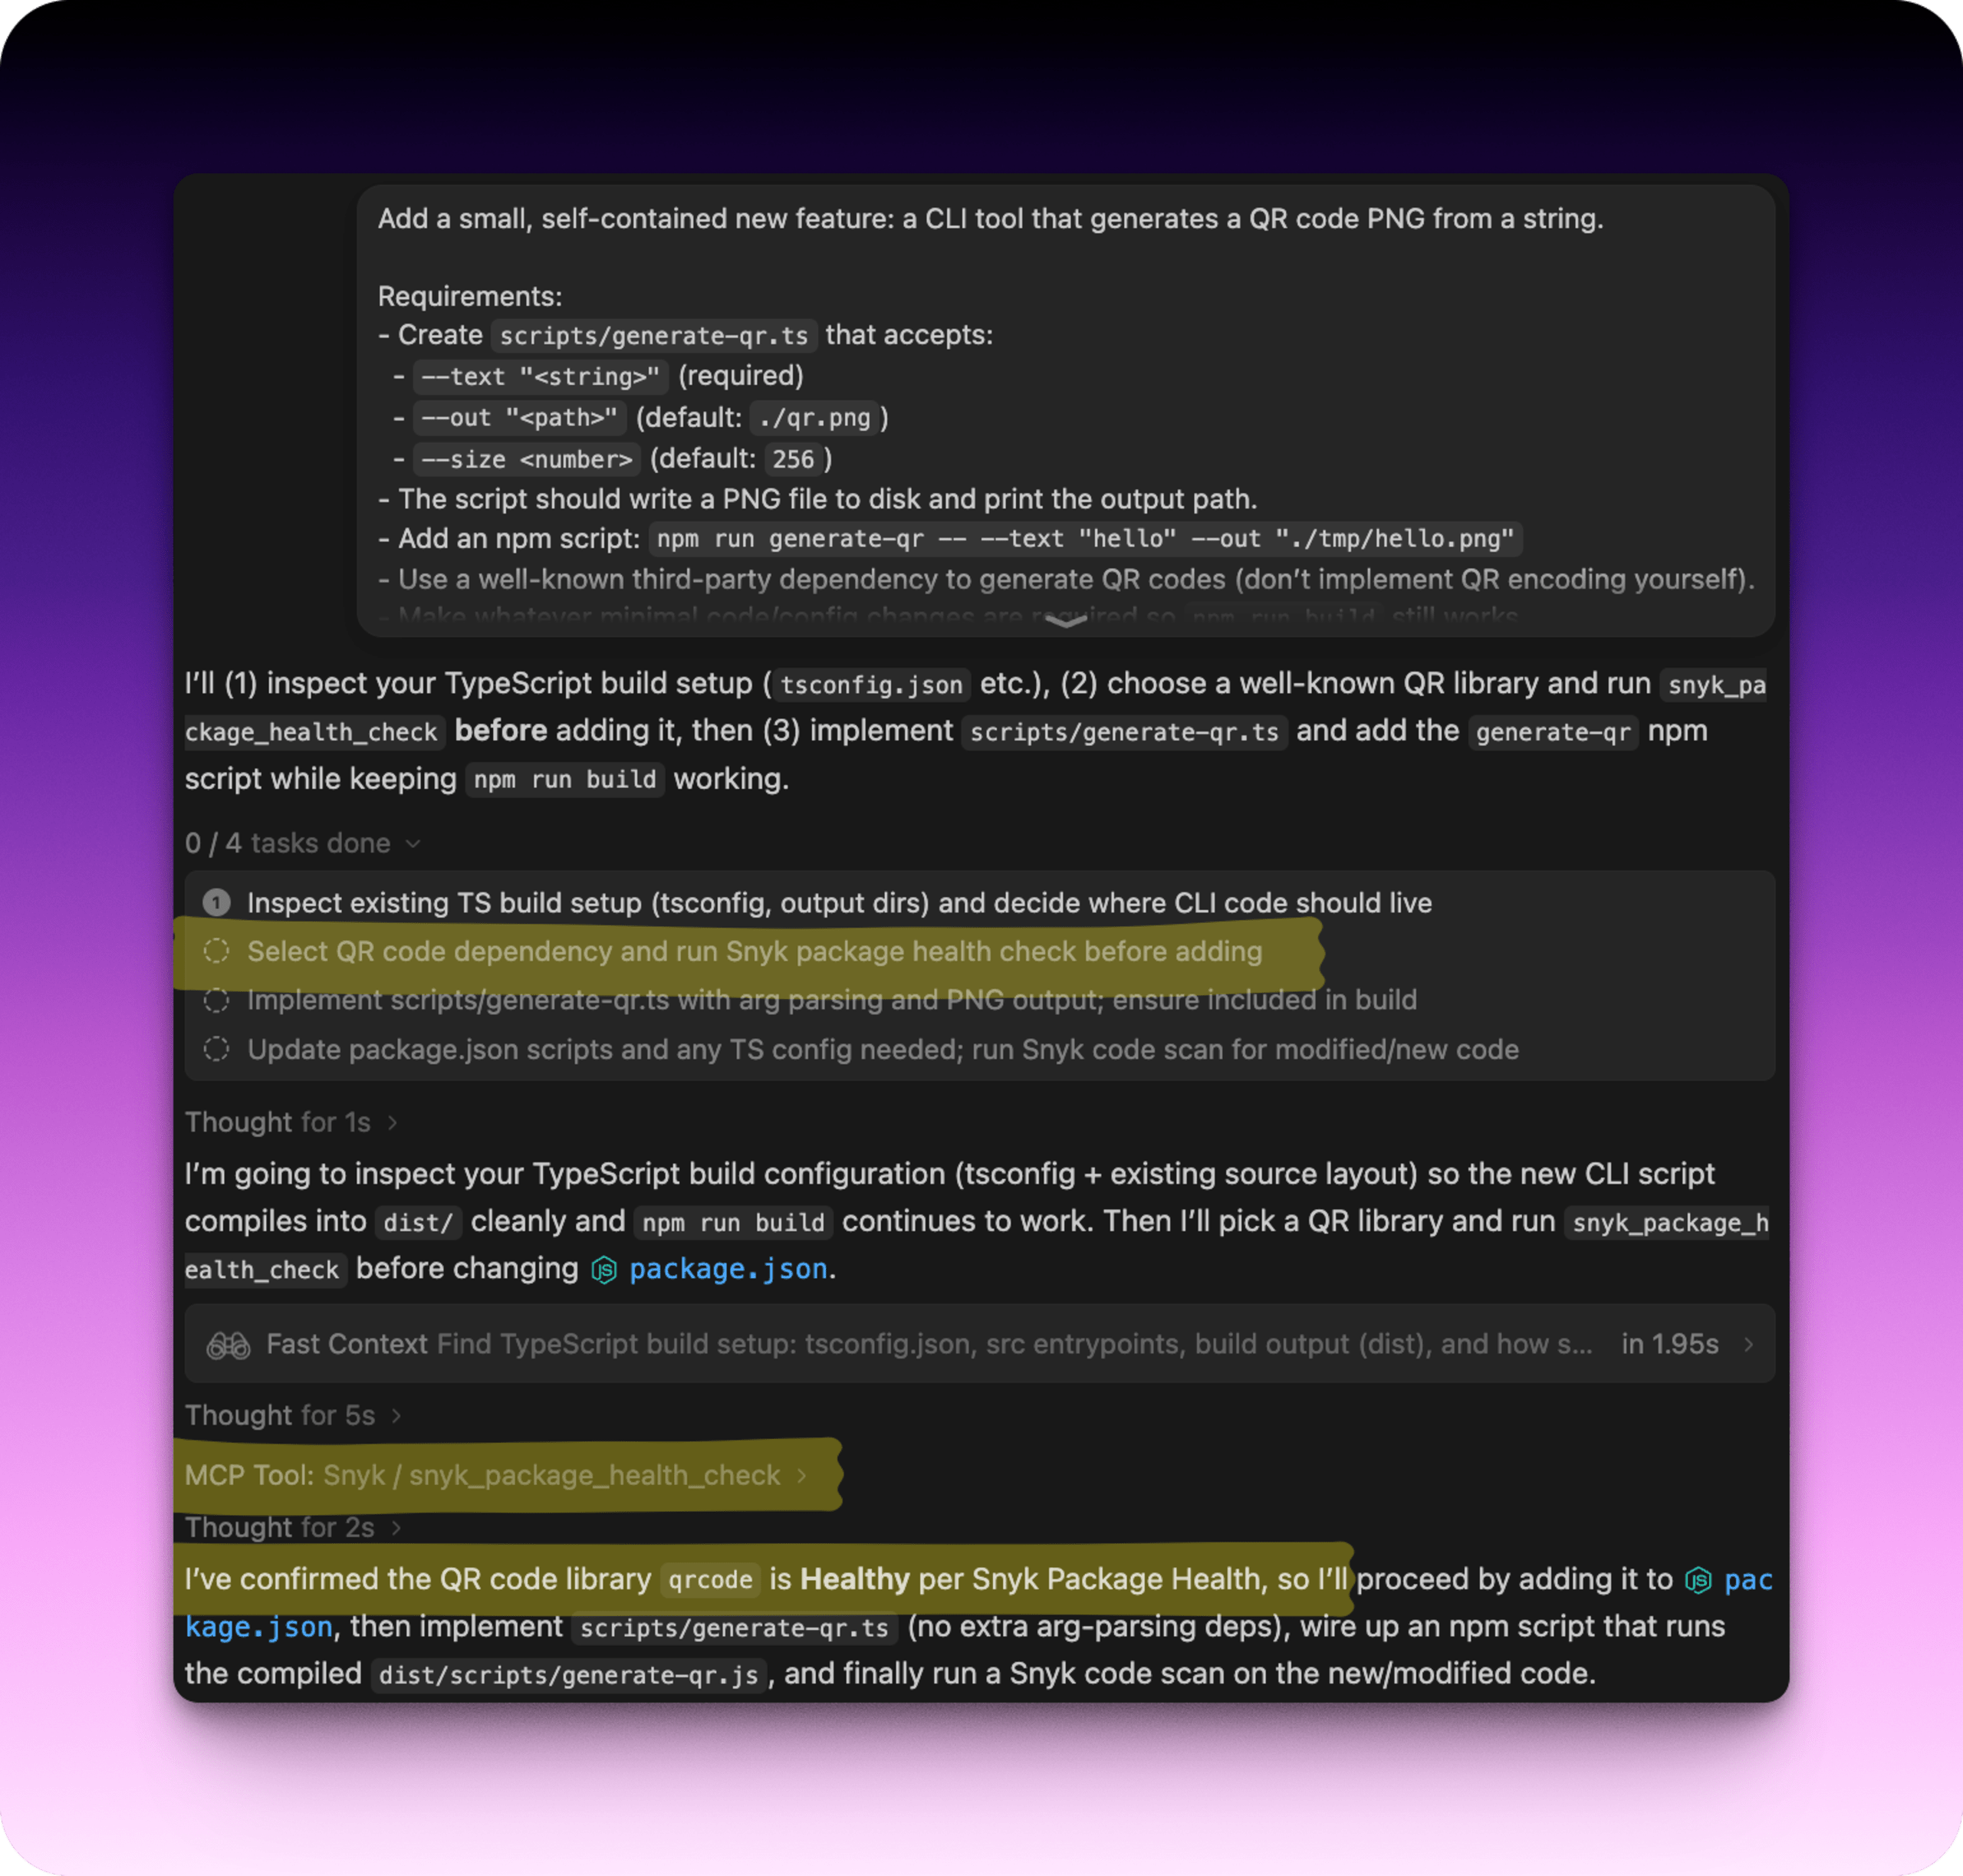
Le workflow Package Health de Snyk Studio intègre les données sur la santé des packages directement aux workflows de développement assistés par l’IA. Lorsqu’un assistant de codage IA propose d’ajouter ou de mettre à jour une dépendance, Snyk Studio peut lancer automatiquement une vérification de la santé du package avant son installation, afin d’évaluer les signaux de risque en temps réel. Les organisations peuvent ainsi empêcher les packages défaillants, non maintenus ou risqués d’entrer dans leur base de code dès que possible, au moment même où il faut « sécuriser dès la conception ».
Stratégie : Configurez les assistants de codage IA pour qu’ils vérifient automatiquement la santé des packages avant d’ajouter de nouvelles dépendances. En présence de signaux de risque, suspendez ou bloquez l’installation et exigez l’approbation explicite de l’utilisateur pour continuer.
4. Protégez-vous contre les hallucinations
Les assistants de codage IA peuvent parfois recommander des packages absents des registres publics. Ces événements « package introuvable » doivent être considérés comme des signaux potentiels de risque pour la chaîne d’approvisionnement, et non comme de simples erreurs de développeur : des attaquants pourraient ensuite enregistrer des packages aux noms similaires pour exploiter ces erreurs.
Stratégie : Traitez les échecs de résolution des dépendances (par exemple, « package introuvable ») comme des événements pertinents pour la sécurité. Examinez l’origine de la suggestion de dépendance et vérifiez la légitimité du nom du package avant de poursuivre.
L’image ci-dessous montre comment l’agent de codage Windusrf invoque Snyk Studio pour analyser la santé d’un package à l’aide de l’outil snyk_package_health_check, qui fait partie des autres outils de sécurité du serveur MCP Snyk. Une fois Snyk Studio installé, l’agent IA peut confirmer que le package est maintenable, ne présente aucun problème de sécurité et n’est pas malveillant.
La mission de Snyk : sécuriser le code généré par l’IA
Snyk a été fondé sur la conviction que seule une sécurité pensée pour les développeurs permet de changer d’échelle. À l’ère des agents de codage IA, c’est d’autant plus vrai. Les données de Census II montrent que l’écosystème open source est vaste et en grande partie dormant.
Notre mission consiste à aider vos équipes et vos IA à privilégier les catégories supérieures, saines et dynamiques, ces 10 % qui font tourner le monde, tout en automatisant la protection contre les 90 % chaotiques. Ne laissez pas votre IA vérifier la confiance. Vérifiez si l’IA mérite votre confiance.
Vous souhaitez en savoir plus sur la façon dont les assistants de codage IA transforment les risques liés à la chaîne d’approvisionnement logicielle ? Découvrez notre guide pour sécuriser Python à l’ère de l’IA.
LIVRE BLANC
La crise de la sécurité de l’IA dans votre environnement Python
Avec l’accélération fulgurante du développement, savez-vous vraiment à quoi votre environnement d’IA peut accéder ?