Découvrez le nouveau Risk Score de Snyk pour une priorisation fondée sur les risques


17 août 2023
0 minutes de lectureNous sommes ravis d’annoncer la disponibilité en bêta ouverte du nouveau Risk Score de Snyk ! En remplacement du Priority Score existant, le nouveau Risk Score a été conçu pour vous aider à mieux établir vos priorités en vous offrant une compréhension précise et globale des risques associés à un problème de sécurité donné.
Le Risk Score repose sur un nouveau modèle d’évaluation des risques qui exploite plusieurs facteurs objectifs et contextuels afin de mesurer à la fois la probabilité d’exploitation d’une vulnérabilité et son impact potentiel. Le nouveau Risk Score prend en compte davantage de facteurs de risque qu’auparavant, notamment l’accessibilité, le niveau de maturité des exploits, l’EPSS, les tendances sur les réseaux sociaux, le CVSS, la profondeur des dépendances transitives, la criticité métier et bien plus encore. Vous bénéficiez ainsi de renseignements de sécurité plus complets et plus précis.
Une fois activé, le nouveau Risk Score s’affiche sur les fiches des problèmes Snyk, accompagnées d’une explication détaillée de son calcul et de la manière dont il permet de comprendre les risques associés au problème. Le score est également disponible dans les rapports Snyk et via notre API.
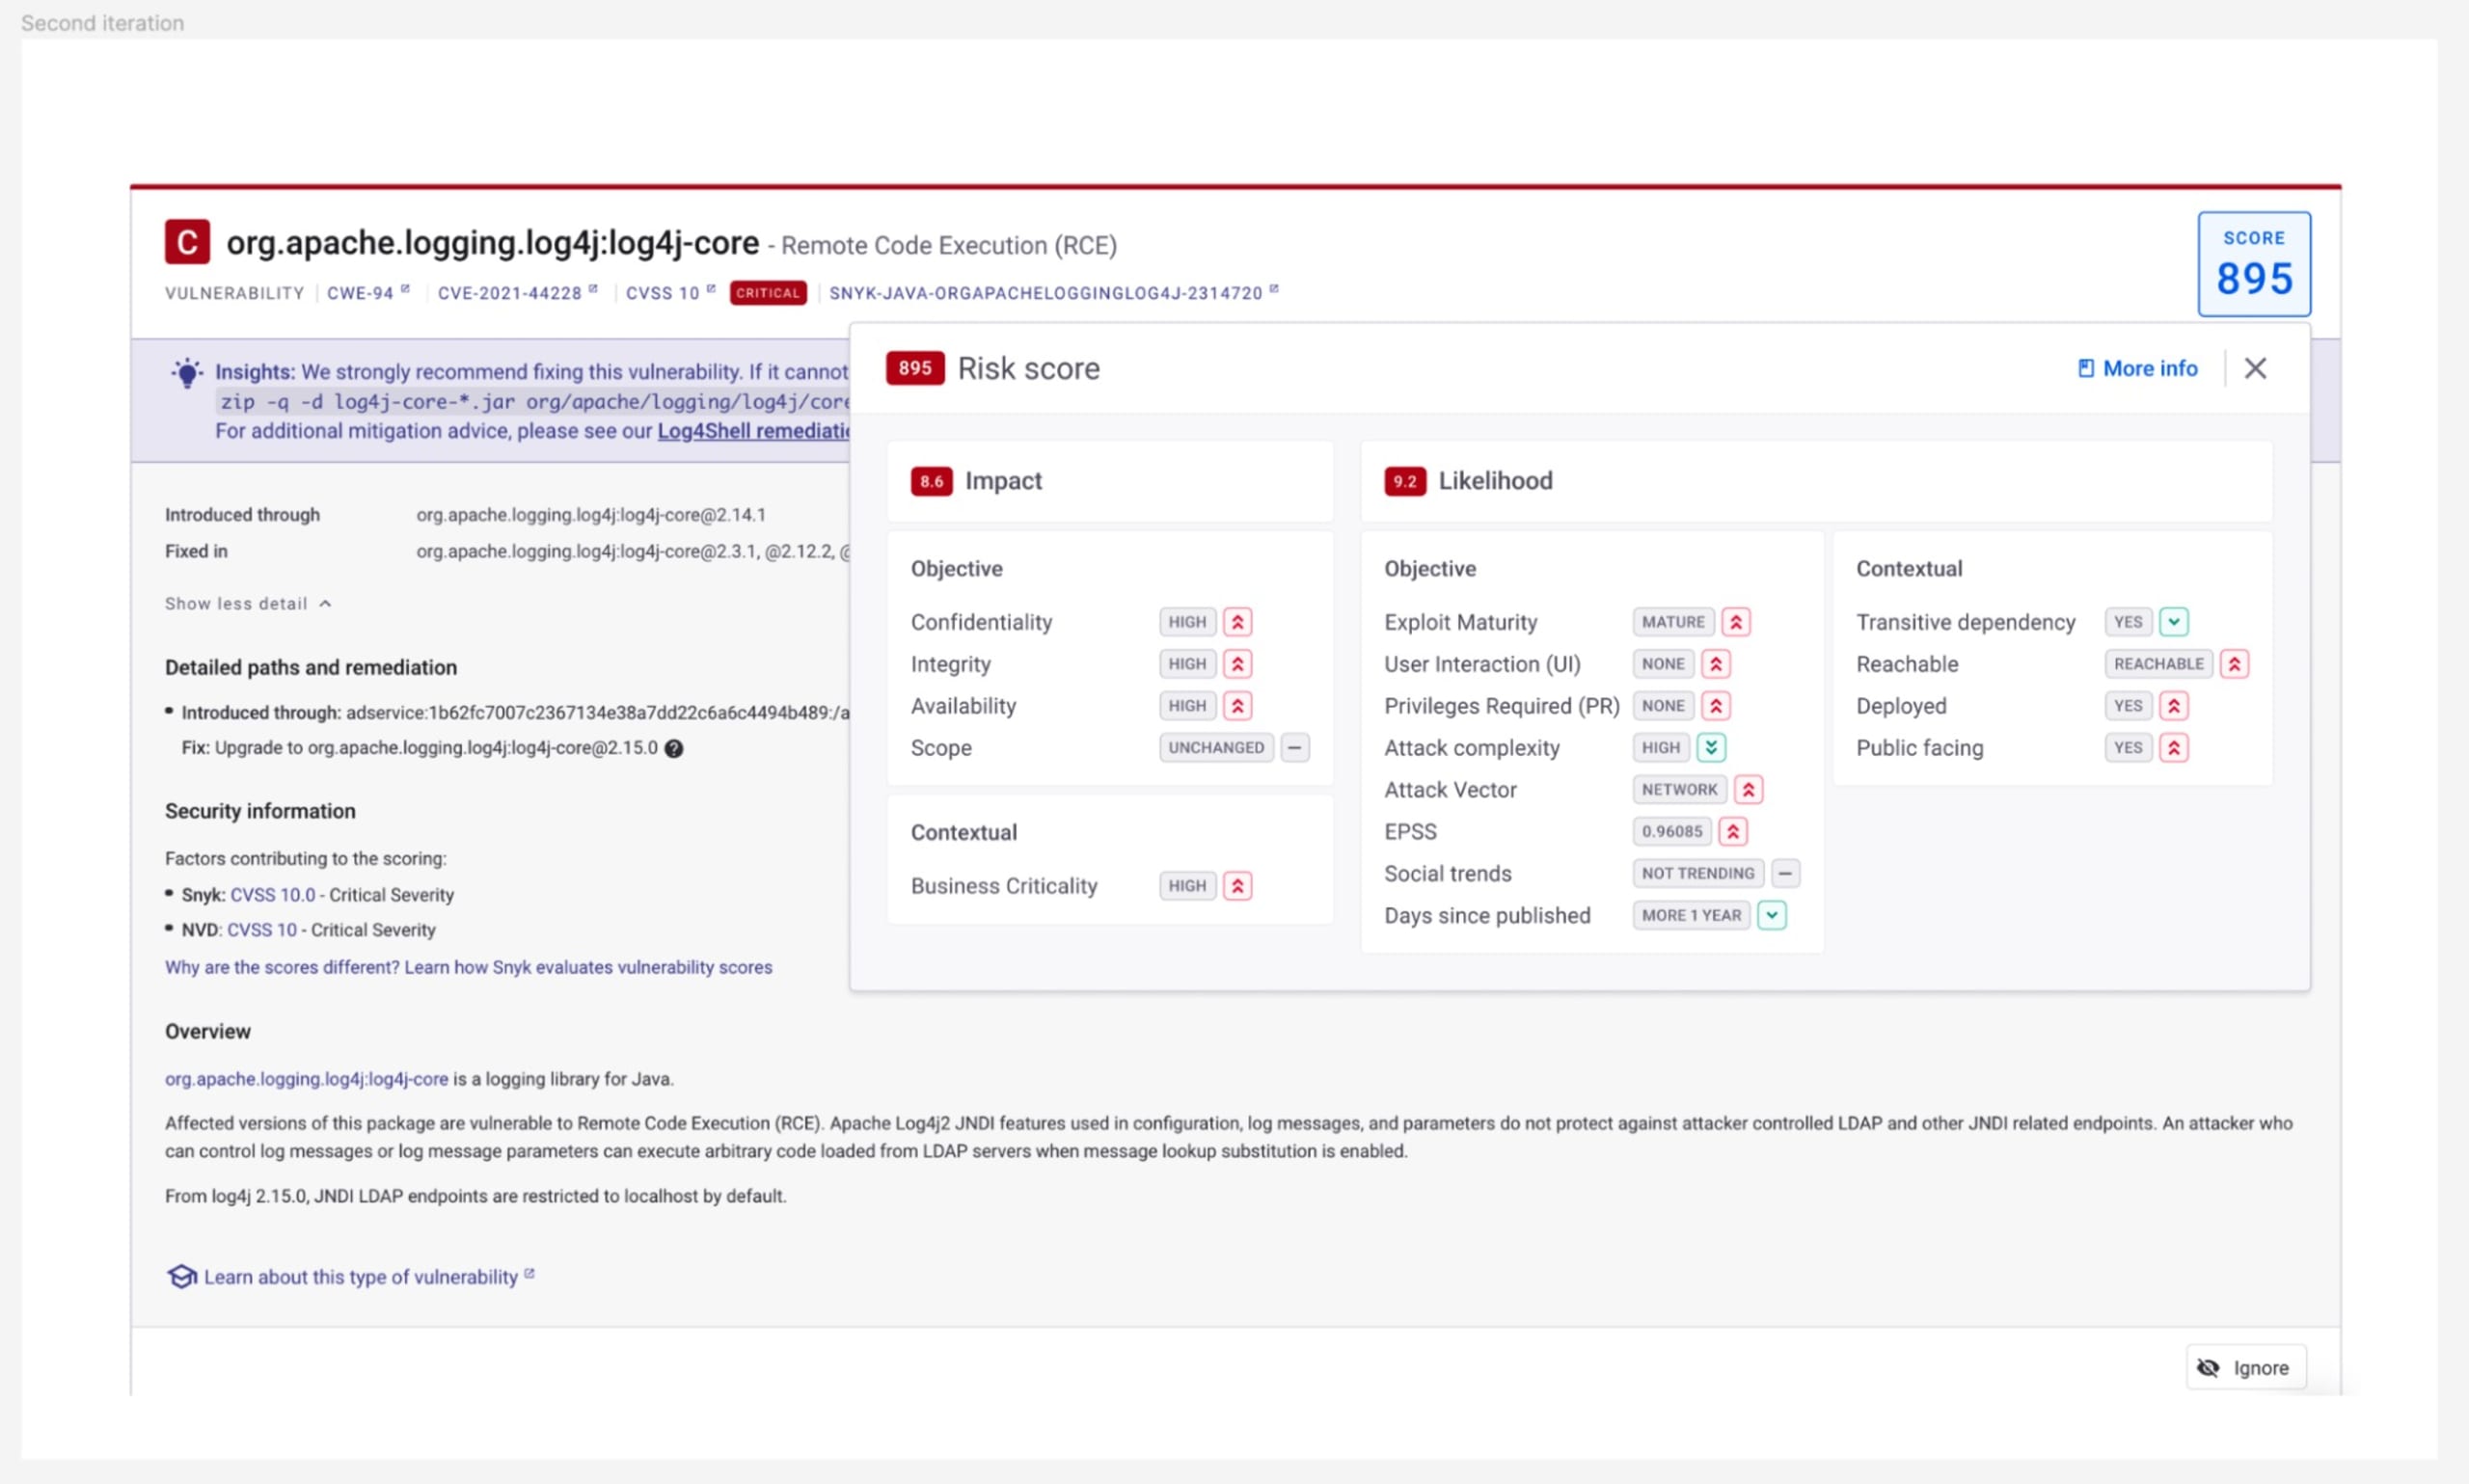
Risk Score peut être activé via Snyk Preview. Disponible en bêta ouverte pour les problèmes Snyk Open Source et Snyk Container, il est accessible avec tous les forfaits Snyk, y compris le forfait Free. Pour en savoir plus sur Risk Score et son utilisation, consultez notre documentation en ligne.
Le problème : des retards de sécurité submergés de bruit
L’un des principaux défis auxquels sont confrontées aujourd’hui la plupart des équipes de sécurité et de développement qui cherchent à sécuriser leurs logiciels tout au long de la chaîne d’approvisionnement logicielle est le rapport signal/bruit.
D’une part, le nombre de vulnérabilités découvertes dans leur code semble sans fin :
Les outils de sécurité sont devenus presque omniprésents tout au long de la chaîne d’approvisionnement logicielle, élargissant considérablement la surface de menace à protéger et générant plus de problèmes que jamais.
De nouvelles vulnérabilités sont découvertes chaque jour dans des bibliothèques open source populaires et des logiciels tiers intégrés, ce qui ne cesse d’augmenter le nombre de menaces à évaluer, à prioriser et à corriger.
La complexité des logiciels ne cesse de croître, et il n’est pas toujours possible d’automatiser les mises à niveau ou les correctifs sans introduire de changements incompatibles dans notre code, ce qui complique l’évaluation et la résolution des problèmes.
D’autre part, les utilisateurs constatent que toutes les menaces ne se valent pas et que la grande majorité des problèmes détectés présentent un risque bien moindre que prévu. Le système de modélisation des menaces EPSS de FIRST en est un exemple : il cherche à prédire la probabilité qu’une CVE donnée soit exploitée dans la nature.
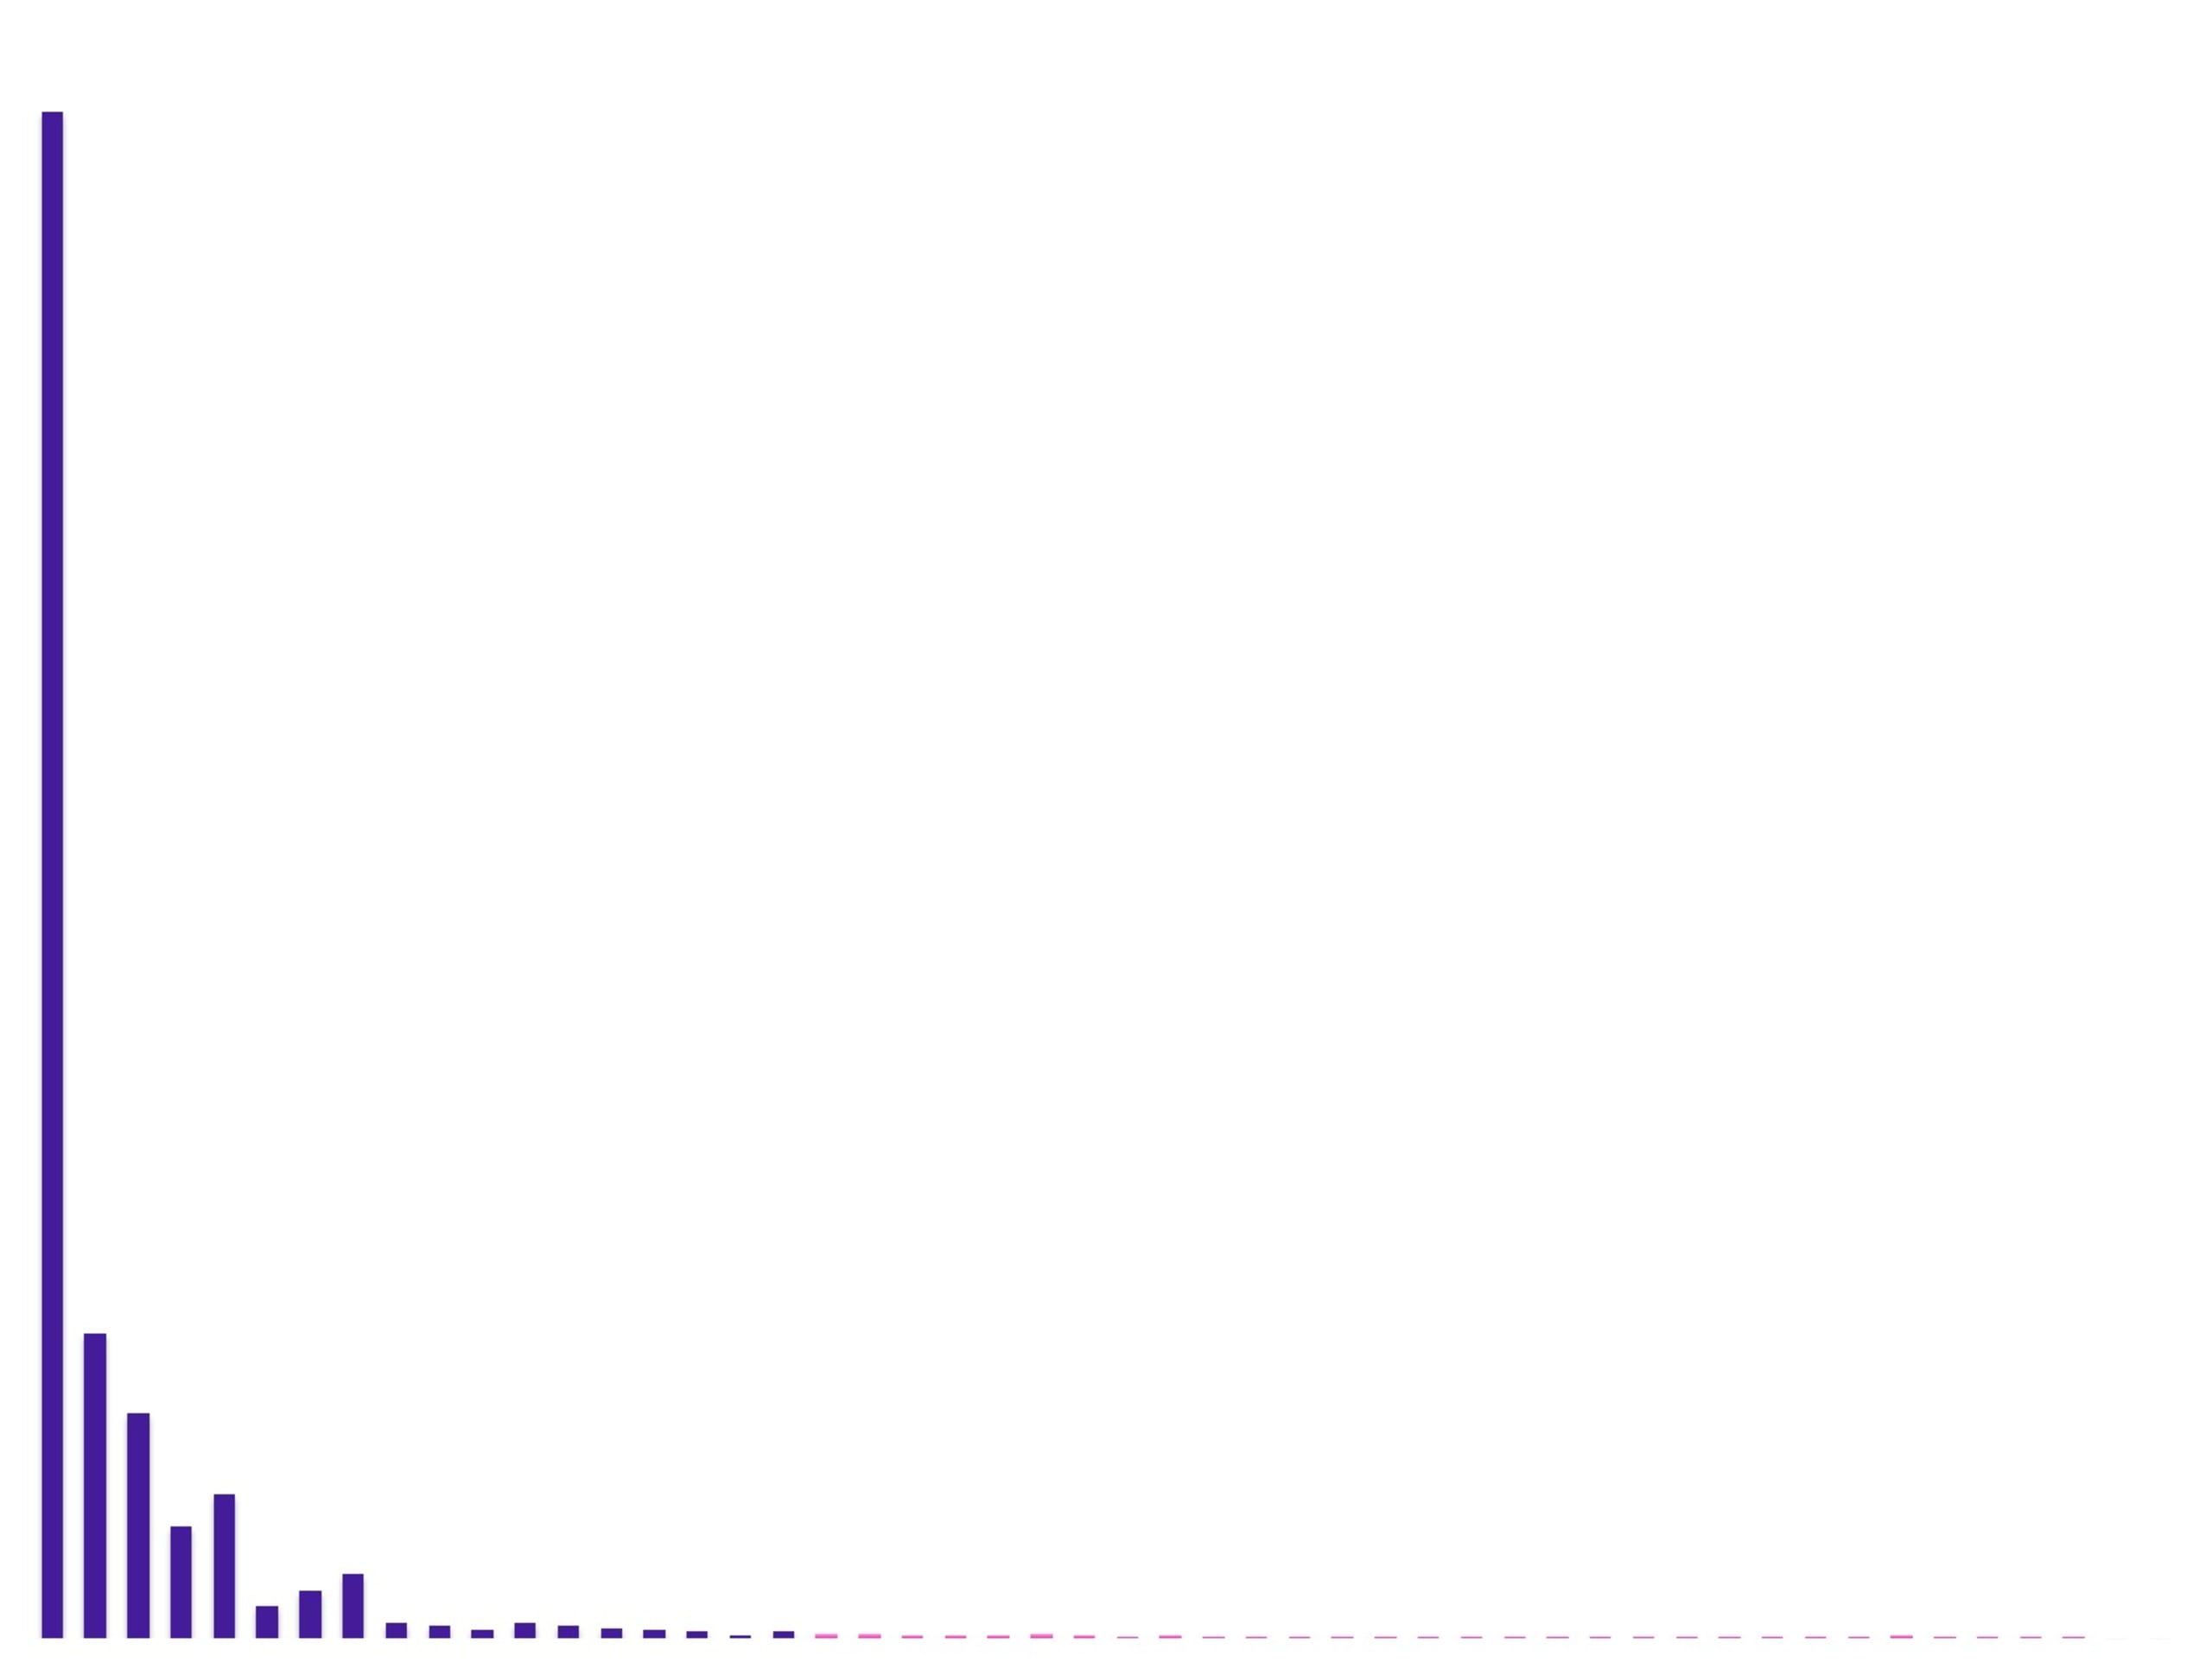
On constate que plus de 95 % des vulnérabilités ont très peu de chances d’être exploitées, les menaces réellement dangereuses se concentrant autour du 99e percentile.
Comparons cela à la répartition des vulnérabilités selon leur niveau de gravité CVSS 3.1, l’échelle la plus couramment utilisée par les professionnels de la sécurité pour mesurer les risques. Une proportion bien plus importante de vulnérabilités se situe dans la catégorie Élevé-Critique :
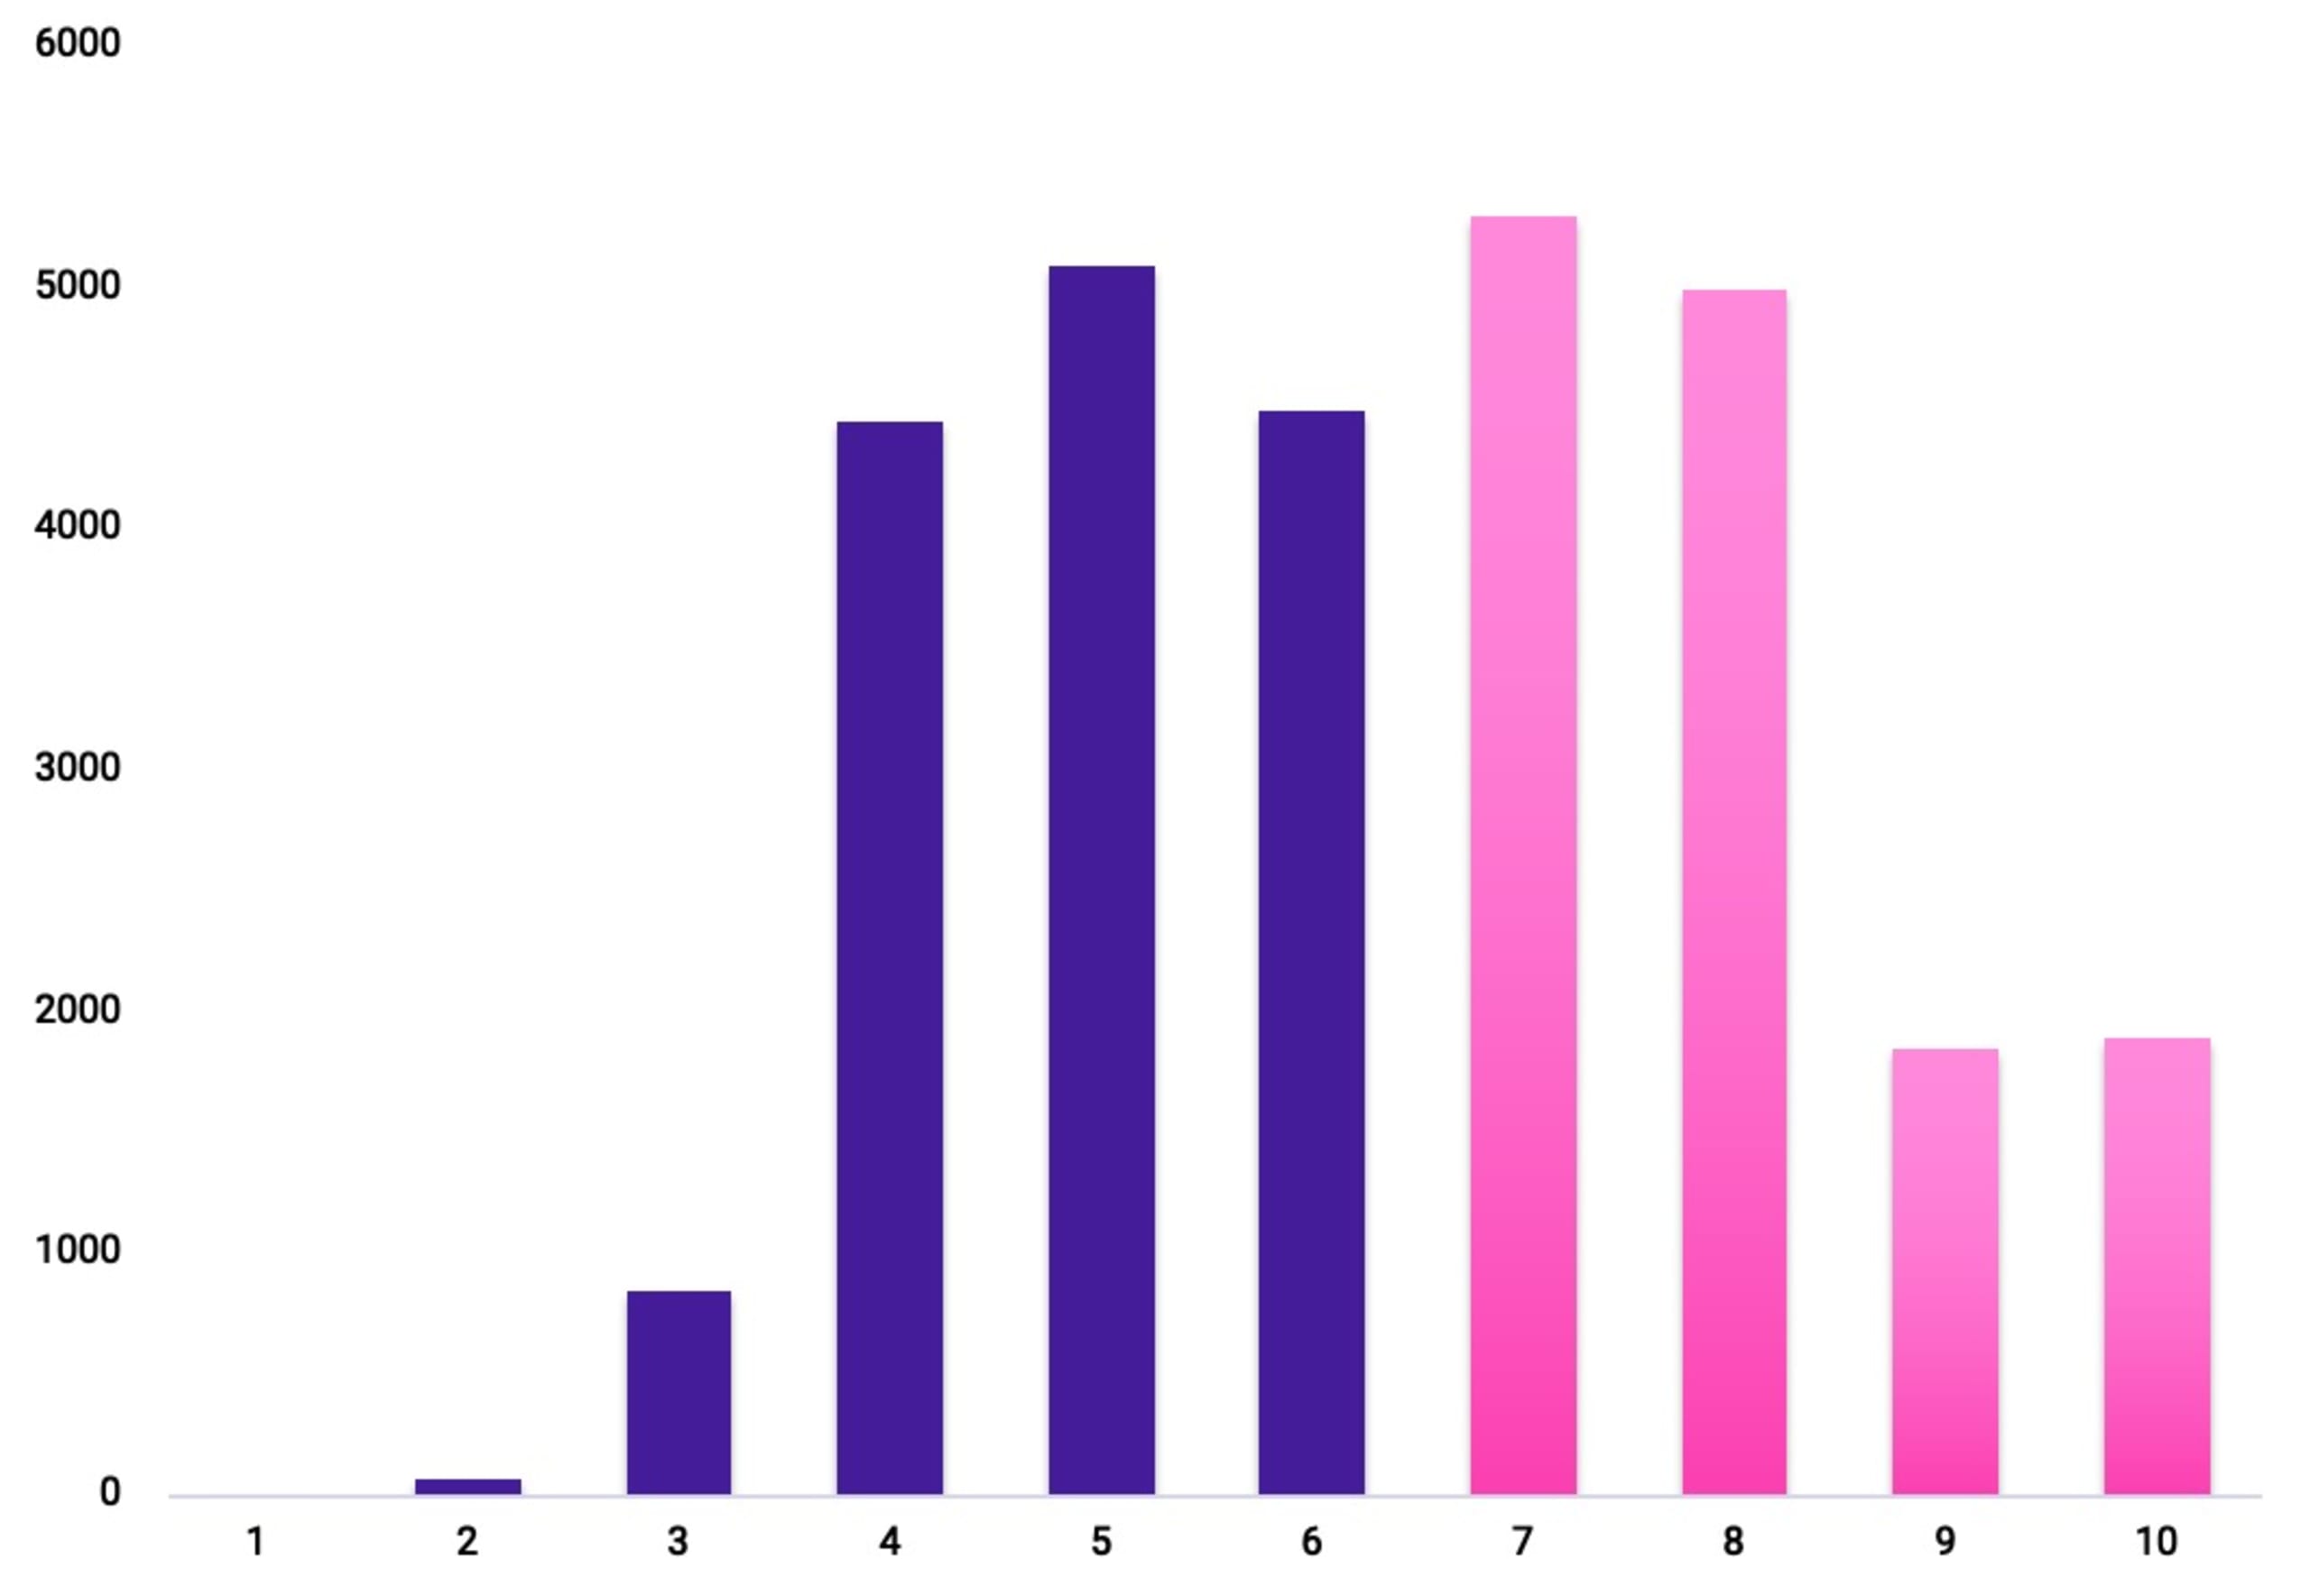
Se tourner vers CVSS v4.0 n’apporte pas non plus de solution. Par définition, le cadre CVSS exige toujours que vous analysiez manuellement les problèmes dans le contexte de votre environnement, ce qui représente une charge de travail trop importante.
Priorisation des risques : la quête d’une solution miracle
La question évidente est la suivante : comment passer d’un monde où nous tentons d’évaluer et de traiter des milliers de risques hautement improbables à un monde où nous pouvons consacrer l’essentiel de notre temps aux problèmes les plus risqués ? Plusieurs solutions miracles ont été proposées, reposant sur un facteur de risque unique permettant d’écarter immédiatement tous les risques liés à certaines vulnérabilités, par exemple :
Maturité des exploits ou EPSS - Cherche à prédire de manière objective si une attaque sera tentée et réussira. Cette approche est prédictive et ne tient pas compte de votre environnement.
Accessibilité statique du code - Cherche à distinguer les composants utilisés de ceux qui ne le sont pas. Cette méthode aide à repérer les composants utilisés, mais ne permet pas d’ignorer les autres en toute sécurité. Se fier uniquement à ce facteur de risque ne suffit pas non plus, car il ne tient pas compte d’autres éléments de contexte, comme l’accessibilité réseau et d’autres conditions d’exploitation.
Transitivité - Selon une école de pensée, il n’est pas nécessaire de tenir compte des problèmes dans les dépendances transitives. Log4shell, comme d’innombrables autres vulnérabilités, a prouvé que cette hypothèse était erronée.
Un modèle de risque binaire a évidemment de quoi séduire : il est facile à comprendre et, s’il fonctionnait vraiment, il réduirait considérablement notre charge de travail. Malheureusement, la sécurité et le code ne se résument pas à une opposition binaire. Ces modèles simplistes nous exposent dangereusement aux risques qu’ils écartent, tout en nous laissant concentrer nos efforts sur un sous-ensemble de vulnérabilités, dont beaucoup ne constituent pas de véritables menaces. Se fier exclusivement à l’un de ces facteurs, ou à une combinaison de ceux-ci, exige une confiance absolue dans les informations fournies, mais aussi dans celles qui ne le sont pas.
Créer un nouveau modèle d’évaluation des risques pour Risk Score
Conscients des difficultés de priorisation rencontrées par nos clients, nous avons entrepris de créer un nouveau modèle d’évaluation des risques avec trois objectifs principaux :
Créer un véritable modèle de risque probabiliste, plutôt qu’un modèle binaire.
Créer un modèle qui prend en compte et reflète les complexités inhérentes à l’évaluation des risques, tout en permettant aux humains de comprendre et de vérifier ses conclusions.
Intégrer des données contextuelles propres à chaque utilisateur et nous permettre d’enrichir davantage ces facteurs contextuels.
Le modèle d’évaluation proposé par le nouveau Risk Score de Snyk prend en compte deux vecteurs de risque :
Probabilité - Quelle est la probabilité qu’un risque donné se concrétise ? Autrement dit, quelle est la probabilité qu’une vulnérabilité soit exploitée dans le code d’un utilisateur ?
Impact - Si une vulnérabilité est exploitée, quel impact cela aurait-il sur nos utilisateurs ?
Chacun de ces vecteurs se décline en deux catégories de facteurs de risque :
Objectifs - Les facteurs de risque définis objectivement pour le problème concerné et pertinents pour tout environnement vulnérable.
Contextuels - Les facteurs de risque définis dans le contexte de l’environnement de l’application vulnérable.
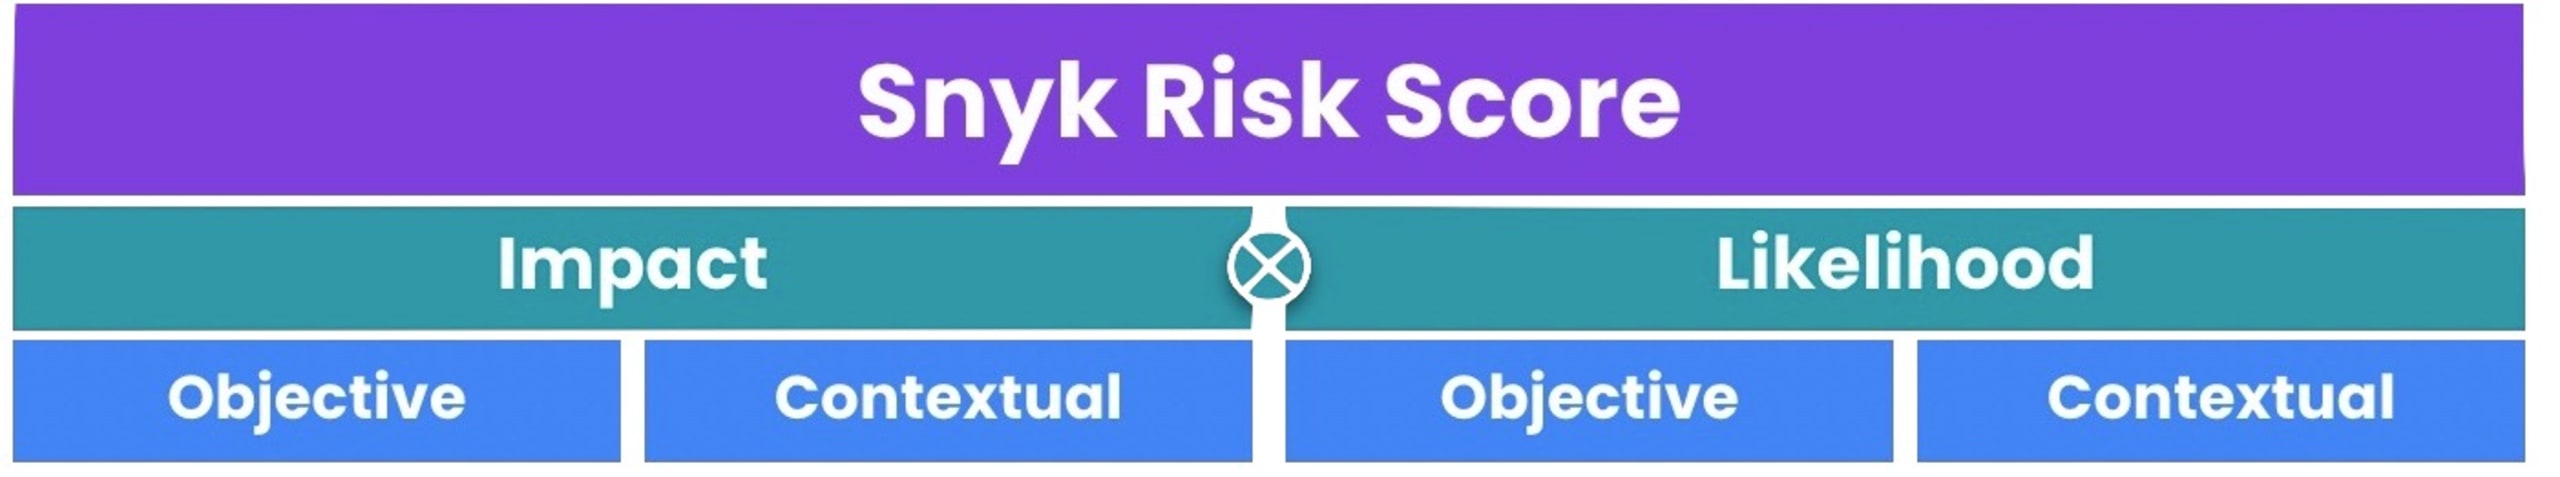
Les algorithmes de notre modèle d’évaluation des risques combinent ensuite ces facteurs pour calculer un score de risque pour chaque problème.
Comment évaluer objectivement la possibilité d’exploitation ?
Pour chaque facteur de risque intégré à notre modèle, nous avons mené deux expériences afin de vérifier son utilité dans notre algorithme et son poids prédictif relatif. Tout d’abord, nous avons établi une référence pour mesurer la probabilité qu’une vulnérabilité aléatoire soit exploitée, en croisant la base de données de vulnérabilités de Snyk avec les vulnérabilités exploitées dans la nature publiées par la CISA. Nous avons ensuite mesuré la corrélation de chaque facteur de risque que nous pensions susceptible d’influencer la probabilité d’exploitation avec cette référence.
Cependant, corrélation n’est pas causalité. Nous avons alors commencé à expérimenter différents modèles de ML pour déterminer correctement quels facteurs de risque permettaient réellement de prédire la possibilité d’exploitation. Après plusieurs séries d’expériences, nous avons utilisé un modèle de régression pour identifier les facteurs de risque ayant un impact statistiquement significatif sur la possibilité d’exploitation, puis intégré les résultats de ce modèle à notre algorithme.
Enfin, nous avons testé les résultats de nos modèles sur des centaines de projets anonymisés afin de vérifier si la répartition des possibilités d’exploitation obtenue par notre modèle correspondait à ce que nous attendions des données réelles sur les violations, comme indiqué plus haut.
Tout est une question de contexte
Même si nous sommes ravis que notre modèle semble prédire avec précision les possibilités d’exploitation à l’échelle mondiale, les risques contextuels propres à la configuration de chaque utilisateur restent essentiels. Nous avons étudié nos recherches internes exclusives en matière de sécurité et tenté d’exploiter des vulnérabilités spécifiques dans diverses conditions. Nous avons ainsi pu intégrer des conditions apparemment « binaires », comme l’accessibilité ou la transitivité, non pas pour formuler des affirmations catégoriques — et inexactes —, mais pour les utiliser comme données probabilistes dans notre algorithme.
Enfin, chez Snyk, la transparence et la confiance sont au cœur de notre travail. C’est pourquoi nous présentons tous les facteurs et les raisonnements qui mènent au score, à la fois dans les problèmes rencontrés et dans notre documentation publique.
L’avenir de l’évaluation des risques chez Snyk
Chez Snyk, nous pensons que les équipes AppSec et de développement doivent pouvoir définir leurs propres méthodes de priorisation. Nous avons constaté que les entreprises abordent cette question de différentes manières :
Axée sur les risques - Filtrez et triez les problèmes selon un score calculé à partir d’un modèle d’analyse des risques, comme Snyk Risk Score.
Axée sur la conformité - Si vos exigences de conformité sont élevées, vous devez traiter chaque problème Élevé/Critique selon la définition du CVSS. Comme indiqué, cela représente beaucoup de problèmes à traiter. L’évaluation des risques peut donc vous aider à les trier et à filtrer les plus importants.
Axée sur la facilité de résolution - Classez les problèmes selon l’effort nécessaire pour les corriger. Cet aspect ne devrait pas être intégré aux scores de risque, mais constitue une dimension supplémentaire pour comprendre l’importance de prendre en compte l’effort nécessaire à la résolution du problème.
Vous pouvez également avoir votre propre tolérance au risque et vos propres critères. À l’avenir, le Risk Score de Snyk vous permettra de personnaliser le score en y intégrant votre connaissance de votre environnement et d’exploiter le modèle prédictif pour prioriser les problèmes, plutôt que les éliminer.
Pour commencer à utiliser Risk Score, activez-le dès aujourd’hui via Snyk Preview !