Créer un outil automatisé de test de l’infrastructure cloud avec Terraform et PyTest

27 mars 2020
0 minutes de lectureNote de la rédaction
Cet article est paru à l’origine sur fugue.co. Fugue a rejoint Snyk en 2022 et constitue un élément clé de Snyk IaC.
Récemment, j’ai été chargé de créer un outil de test automatisé pour Fugue. Fugue surveille les ressources cloud afin d’en vérifier la conformité et la sécurité, et nous avions besoin d’un moyen de vérifier l’exactitude des résultats complets d’une analyse Fugue. Mon objectif était de créer un système automatisé qui s’exécute localement ou en CI, déploie une infrastructure configurable, l’analyse avec Fugue et vérifie les résultats. Cet article présente la conception et la mise en œuvre de ce qui est devenu autotest, notre outil interne de test automatisé.
Bien que cet exemple utilise précisément Terraform et l’API Fugue, la conception des fixtures s’applique à toutes les commandes CLI et à toutes les API. Ces idées peuvent donc facilement être adaptées à d’autres cas d’utilisation.
Conception
Avant de me lancer sérieusement dans le projet, j’ai consacré quelques jours à faire des recherches et à comprendre le problème. Après quelques recherches sur Google, j’ai décidé de baser mon outil sur le framework pytest. J’avais déjà utilisé pytest pour des tests unitaires, mais c’était l’occasion idéale de l’explorer en profondeur et de découvrir comment l’utiliser pour réaliser des tests fonctionnels.
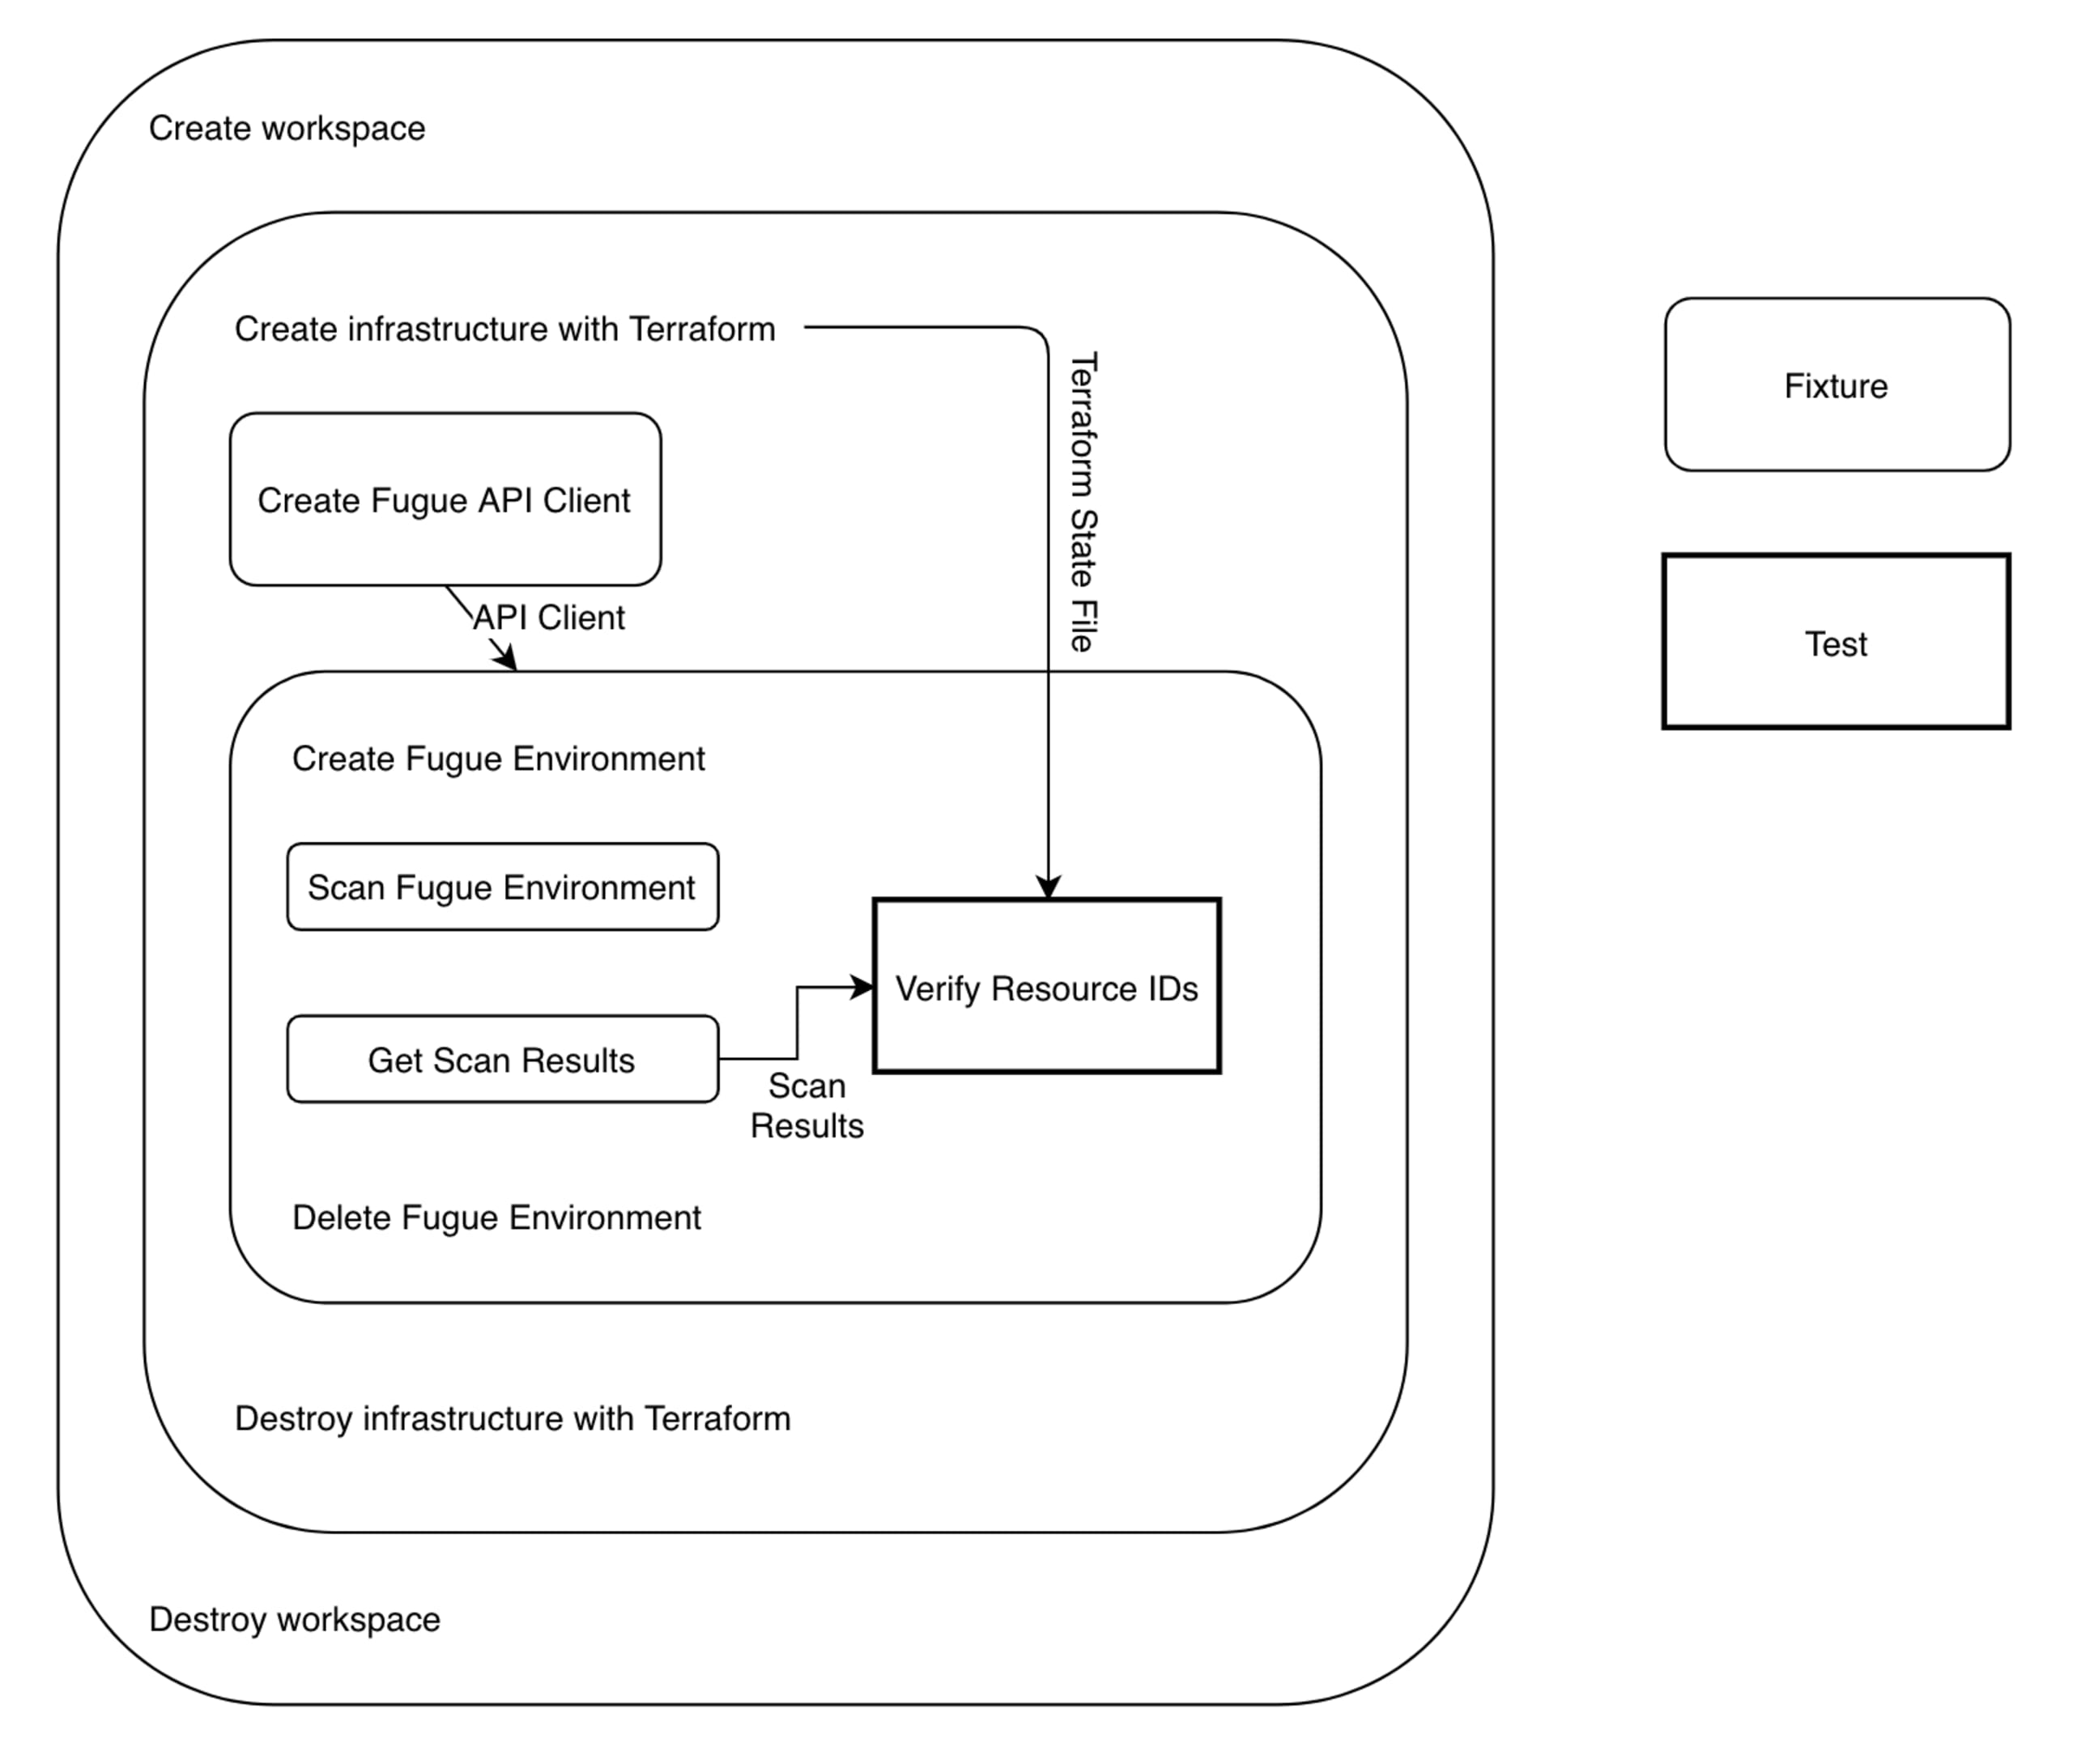
La procédure de test se décompose en trois étapes :
Déployer une infrastructure modulaire avec Terraform
Créer un environnement Fugue qui pointe vers cette infrastructure et l’analyser
Récupérer les résultats de l’analyse et les vérifier
Je savais que je voulais utiliser Terraform pour l’étape 1, car nous disposions déjà de plusieurs configurations Terraform pour tester l’infrastructure et que Terraform prend en charge AWS, Azure et de nombreux autres fournisseurs de services cloud. Pour l’étape 2, je savais que je pouvais utiliser l’API Fugue pour créer l’environnement et lancer une analyse. Enfin, à l’étape 3, je pouvais à nouveau utiliser l’API Fugue pour récupérer l’ensemble des résultats de l’analyse et les vérifier.
Une fois la conception générale définie, j’ai pu étudier pytest pour comprendre comment l’utiliser afin de la mettre en œuvre.
PyTest
pytest est un framework de test pour Python qui propose la découverte des tests, des assertions à l’aide de l’instruction intégrée <c>assert</c> de Python et des fixtures pour gérer les dépendances.
Les fixtures sont le secret de pytest. Ce sont des fonctions décorées qui gèrent le cycle de vie des dépendances des tests. Le code de configuration et de nettoyage, traditionnellement placé dans les méthodes setUp() et tearDown(), est intégré aux fixtures. Vous pouvez définir la portée d’une fixture afin de réutiliser ses résultats entre plusieurs classes, modules ou sessions.
Prenons un exemple. Ici, je définis et utilise une fixture pour accéder à une API. Dans un test unitaire, j’utiliserais un objet API simulé ; dans un test fonctionnel, je dois utiliser l’API réelle.
La fixture api_client est déclarée à l’aide du décorateur @pytest.fixture. Je peux définir la portée de la fixture à l’aide de l’argument scope du décorateur. Le client API peut être réutilisé en toute sécurité dans tous les tests ; je lui ai donc attribué une portée session. Les fixtures peuvent être définies dans le même module que les fonctions ou les classes de test, ou placées dans conftest.py, auquel cas elles seront accessibles à tous les modules de test.
Pour utiliser la fixture, il me suffit d’inclure son nom comme argument d’une fonction de test. Dans cet exemple, j’ai utilisé la fixture api_client dans deux tests. Comme je lui ai attribué une portée session, pytest veille à ce qu’elle ne soit appelée qu’une seule fois par session de test.
Vous avez peut-être remarqué que la fixture api_client prend un paramètre d’entrée, creds. Nous n’appelons jamais directement la fonction fugue_api ; comment creds reçoit-elle donc une valeur ?
Si vous avez deviné que creds est elle-même une fixture, vous gagnez une étoile : ⭐️. Les fixtures peuvent en appeler d’autres, ce qui permet de construire des dépendances complexes à partir d’une chaîne de fixtures. Voyons la définition de creds :
Je respecte les bonnes pratiques de sécurité : creds utilise credstash pour stocker et récupérer les valeurs secrètes. Le nom du secret est transmis sous forme d’option de ligne de commande à pytest. Ces options sont définies dans pytest_addoption et accessibles par l’intermédiaire de la fixture request. La fixture creds me permet d’abstraire facilement la manière dont les identifiants sont récupérés et de me concentrer sur les données nécessaires à un test ou à une fixture. Si je change ensuite la méthode d’accès aux identifiants, je n’aurai qu’à modifier creds.
Maintenant que nous connaissons les bases des fixtures pytest, voyons comment les utiliser pour mettre en œuvre notre conception.
Étape 1 : déployer l’infrastructure avec Terraform
La première étape de notre outil crée l’infrastructure qui sera analysée et servira de base aux vérifications des étapes 2 et 3. Je sais que je vais utiliser Terraform pour la déployer, mais comment cela va-t-il fonctionner exactement ?
Conception
Cet extrait montre la structure de nos configurations de test existantes. Vous pouvez déployer ces configurations manuellement en exécutant terraform apply depuis la racine aws/ ou depuis un sous-répertoire de service, comme aws/api_gateway. Je souhaite conserver cette modularité afin de pouvoir choisir les services à tester. Je pourrais appeler Terraform dans la structure existante, mais ce serait une mauvaise pratique : toutes les opérations sur le système de fichiers devraient être effectuées dans des répertoires temporaires distincts pour que les tests s’exécutent dans des environnements contrôlés. Il me faudra donc gérer des espaces de travail temporaires. Je devrai également appeler Terraform, enregistrer sa sortie et détecter les erreurs. Terraform créera une infrastructure réelle (et coûteuse) ; il est donc essentiel de gérer les erreurs en supprimant l’infrastructure en cas de problème.
En résumé, les exigences de la première étape sont les suivantes :
Créer et gérer des espaces de travail temporaires
Copier les configurations de test dans un espace de travail
Appeler Terraform et gérer les erreurs en supprimant l’infrastructure déjà créée
Il est clair que les points 1 et 2 peuvent être gérés dans une fixture. Mais une tâche aussi complexe et sujette aux erreurs que la création d’une infrastructure avec Terraform peut-elle également être gérée par une fixture ?
Si vous avez répondu OUI, vous gagnez une autre étoile : ⭐️. Voyons de plus près comment définir nos fixtures d’espace de travail et Terraform.
La fixture d’espace de travail
La fixture workspace fait beaucoup de choses en six lignes de code. Remarquez d’abord que workspace est définie comme une yield_fixture. Cela signifie que la fonction rend la main à son appelant avec yield plutôt qu’avec return. L’exécution de la fixture est alors suspendue et les gestionnaires de contexte restent ouverts. Lorsque la fixture reprend la main, le code situé après l’instruction yield s’exécute. Ici, le gestionnaire de contexte Workspace se ferme. pytest récupère la valeur renvoyée par une yield_fixture ; nous pouvons donc les utiliser comme des fixtures ordinaires. workspace est une fixture dont la portée est une classe : un nouvel espace de travail est créé pour chaque classe de test. Je peux ainsi séparer les tests AWS et Azure par classe et m’assurer qu’un nouvel espace de travail est créé pour chaque fournisseur.
On voit ensuite que workspace dépend de trois fixtures : tmpdir_factory, provider et services. tmpdir_factory est une fixture intégrée qui renvoie un répertoire temporaire unique. Vous pouvez définir manuellement le répertoire de base avec l’option --basetemp=DIRECTORY, ce qui est pratique pour le débogage. provider et services sont des fixtures que j’ai définies. Elles renvoient respectivement le fournisseur testé et la liste des services reçue en entrée.
L’un des aspects que je préfère dans les fixtures, c’est qu’elles encouragent la création d’abstractions claires. Les entrées d’un test ou d’une fixture sont définies par une interface, la définition de la fonction, tandis que les implémentations sont masquées dans la définition de la fixture. La modularité des fixtures me permet de créer rapidement et facilement une fixture distincte pour chaque entrée de workspace, sans être tenté de construire les valeurs dans workspace.
Enfin, notez que Workspace est une classe de gestionnaire de contexte. Elle ferme automatiquement l’espace de travail lorsque la fixture elle-même est finalisée. Comme je l’ai indiqué, l’instruction yield ne finalise le gestionnaire de contexte que lorsque la fixture reprend la main au moment de sa finalisation. J’ai utilisé ce modèle puissant tout au long de la conception d’autotest. La copie des configurations Terraform souhaitées dans l’espace de travail est gérée par initialize_workspace ; je vous laisse cet exercice.
La fixture Terraform
La fixture Terraform se compose en réalité de trois fixtures : terraform, infra et terraform_resources. La chaîne de fixtures renvoie un dictionnaire de ressources Terraform lu dans le fichier d’état Terraform. terraform initialise Terraform dans un espace de travail, infra exécute terraform plan et terraform apply pour créer l’infrastructure, et terraform_resources extrait la map des ressources.
L’initialisation et l’extraction de la map des ressources sont simples. Je précise toutefois que terraform_resources doit être une yield_fixture, car infra est une yield_fixture. Si terraform_resources renvoyait une valeur, cela fermerait le contexte laissé ouvert par infra et déclencherait le code de suppression de l’infrastructure.
Au lieu d’utiliser une classe de gestionnaire de contexte, infra utilise un gestionnaire de contexte basé sur une fonction, build_infra, défini ci-dessous :
build_infra utilise le paquet python-terraform pour appeler Terraform et récupérer sa sortie. Nous vérifions le code d’erreur de chaque opération et levons des exceptions personnalisées en cas d’erreur. t.plan et t.apply appellent respectivement terraform plan et terraform apply pour planifier et créer l’infrastructure. terraform apply peut échouer après n’avoir créé qu’une partie de l’infrastructure — terraform ne supprime pas automatiquement l’infrastructure déjà créée. Nous interceptons donc TerraformApplyError et appelons manuellement t.destroy avant de relancer l’exception d’origine.
build_infra est un générateur : il appelle yield au lieu de return, ce qui me permet d’utiliser le décorateur @contextmanager pour en faire un gestionnaire de contexte. Le bloc try...finally autour de yield garantit l’exécution du code de suppression, même si des exceptions sont levées dans le contexte appelant.
Enfin, remarquez la similitude entre le code du bloc except et celui du bloc finally. Les deux blocs ont le même objectif : garantir la suppression de l’infrastructure, quoi qu’il arrive pendant l’exécution. Comme le code d’un bloc finally s’exécute aussi bien lorsqu’une exception se produit que lorsqu’il n’y en a pas, nous pouvons regrouper les blocs try.
De plus, nous savons que t.plan ne crée pas de ressources ; nous pouvons donc le déplacer en dehors du bloc try. En règle générale, il est préférable de limiter autant que possible la portée des blocs try. Le gestionnaire de contexte build_infra final se présente ainsi :
Étape 2 : créer un environnement Fugue et l’analyser
La prochaine étape de notre conception générale consiste à utiliser l’API Fugue pour créer et analyser un environnement dans le compte où l’infrastructure a été créée à l’étape 1.
Conception
L’API Fugue est une API REST définie avec Swagger. Il est donc facile de générer un client qui permet d’y accéder à l’aide de fonctions et de types natifs, plutôt qu’avec des appels HTTP. Une fois que je dispose d’un client fonctionnel, je peux l’utiliser pour créer un environnement et l’analyser. L’opération se décompose en trois étapes :
Générer et configurer un client pour l’API Fugue
Utiliser le client pour créer un environnement
Utiliser le client pour lancer une analyse et attendre qu’elle se termine
Le client API Swagger
J’ai utilisé swagger-codegen pour générer un client à partir de la définition de l’API Fugue :
Cela a généré un package Python complet pour le client API, dont je n’avais pas besoin. J’ai donc copié directement le code du client dans autotest. J’ai ensuite initialisé le client comme suit :
Ici, creds est simplement un paramètre d’entrée, et non une fixture, car initialize_client n’est ni une fixture ni un test. Rappelez-vous que initialize_client est appelé depuis une fixture qui dépend de la fixture creds :
La définition de la fixture de l’API des environnements est simple, puisque les clients API n’ont pas besoin d’être finalisés. Le client généré par Swagger comprend un client API de base qui gère la connexion à l’API, ainsi que des classes distinctes pour chaque division de premier niveau de l’API. Les actions de l’API sont ensuite disponibles sous forme de méthodes dans chaque classe.
Quelques mots sur les abstractions : j’abstrais les détails du client Swagger au moyen du module api. Cela respecte le principe qui consiste à abstraire des deux côtés d’une interface et me donne la flexibilité nécessaire pour gérer les changements susceptibles d’affecter l’interface du client. Nous examinerons cela plus en détail lorsque je parlerai de la création d’un environnement à l’aide de l’API.
Créer un environnement et l’analyser
Ma première version d’une fixture d’environnement ressemblait à ceci :
Il s’agit d’une utilisation simple de la méthode create_environment de l’API des environnements. Je récupère les identifiants et les paramètres d’entrée depuis les fixtures aws_creds, survey_resource_types et services. La portée de la fixture est définie au niveau des classes, car j’organise les tests par fournisseur de cloud, dans des classes distinctes. Enfin, je yield l’environnement afin de pouvoir le supprimer automatiquement à la fin du test.
La conception de cette fixture est simple et répond à mes besoins. Je pourrais la laisser telle quelle et passer à la suite. Cette simplicité présente toutefois des inconvénients. L’entrée de create_environment est difficile à gérer, car elle comporte de nombreux champs, dont certains dépendent du fournisseur. Utiliser directement l’API des environnements dans la fixture limite ma flexibilité pour préparer les paramètres d’entrée de create_environment sans créer une fonction énorme et difficile à lire. Comme il était difficile de concilier lisibilité et réutilisabilité, j’ai fini par renoncer à cette dernière : j’ai codé en dur le fournisseur et dupliqué la fixture environment pour les environnements Azure. Ce n’était pas une bonne solution. Il me faut plutôt une couche intermédiaire entre le code de la fixture et l’API des environnements, qui encapsule la préparation fastidieuse des paramètres et gère la relation entre la fixture et l’API. Heureusement, le module api remplit précisément ce rôle.
J’ai isolé la préparation des paramètres et l’appel à l’API dans une fonction du module api :
Bien que cette fonction soit longue, elle prend en charge AWS et Azure, et permet de réduire la fixture environment à l’essentiel :
Je peux suivre la même approche pour lancer des analyses dans un environnement :
Inclure la fixture terraform_resources, même si je n’utilise pas sa sortie, garantit que les ressources sont créées avant le lancement de l’analyse. Puis, dans le module api :
J’ai maintenant des fixtures pour créer des ressources avec Terraform, ainsi que pour créer un environnement Fugue et l’analyser. Je suis donc presque prêt à écrire des tests.
Étape 3 : récupérer et vérifier les résultats de l’analyse
Avant d’écrire des tests, je dois pouvoir récupérer les résultats d’analyse depuis l’API Fugue. Ces résultats sont accessibles via le point de terminaison custom rules test input de l’API. La création de cette fixture consiste simplement à appliquer les concepts utilisés plus haut :
get_scan_resources ne fait que transmettre l’appel :
Pour les fonctions simples comme celle-ci, on peut être tenté de supprimer la couche d’abstraction et de placer directement l’appel à l’API dans la fixture. C’est d’ailleurs ce que j’ai fait dans la première version de cette fonction. Mais cela crée une abstraction qui fuit : une couche d’abstraction qui expose une partie des fonctionnalités sous-jacentes qu’elle est censée masquer. Ces abstractions qui fuient finissent par augmenter, plutôt que réduire, la charge cognitive liée à leur utilisation.
Maintenant que j’ai une fixture <scan_resources>, je dispose de toutes les entrées nécessaires à mon test. Après toute la préparation et les abstractions abordées dans les sections précédentes, le test lui-même ne demande que quelques lignes de code :
check est une fixture du plugin pytest qui fournit des assertions qui n’échouent pas. verify_resource_id est une simple fonction de vérification qui compare deux ressources et renvoie true si elles ont le même identifiant de ressource :
J’ai accès à toutes les informations détaillées sur les ressources si je souhaite écrire des tests plus poussés. Pour l’instant, mettre en place l’infrastructure et vérifier qu’elle est correctement analysée suffit. Voici le résultat de l’exécution du test :
Conclusion
Cet article a décrit la création d’autotest, un outil de test automatisé de l’infrastructure, avec pytest. J’ai présenté la puissance des fixtures modulaires de pytest, qui permettent de créer facilement des abstractions claires et performantes. J’ai également expliqué comment utiliser l’API Fugue pour créer des environnements et des analyses, et comment encapsuler ces opérations dans des fixtures. Ensuite, j’ai montré comment utiliser le point de terminaison custom rule test input de l’API Fugue pour télécharger une description complète des ressources d’une analyse. Enfin, j’ai réuni tous ces éléments dans un test.
Encore une chose…
Fugue, c’est la sécurité et la conformité du cloud. Conçu par des ingénieurs, pour des ingénieurs. Avec Fugue, vous pouvez :
Bénéficier d’une visibilité complète sur votre environnement d’infrastructure cloud et votre posture de sécurité grâce à des visualisations dynamiques et à des rapports de conformité.
Valider la conformité à chaque étape du cycle de vie du développement logiciel avec les référentiels CIS Foundations Benchmark, HIPAA, PCI, SOC 2, NIST 800-53, ISO 27001 et GDPR, ainsi qu’avec vos propres politiques.
Vous protéger contre les erreurs de configuration du cloud en appliquant des configurations de référence qui permettent à votre infrastructure cloud critique pour la sécurité de s’auto-réparer.
Une sécurité IaC pensée pour les développeurs
Snyk sécurise votre infrastructure en tant que code, du cycle de développement logiciel à l’exécution dans le cloud, grâce à un moteur unifié de politiques sous forme de code. Chaque équipe peut ainsi développer, déployer et exploiter ses applications en toute sécurité.


