Emplacements source automatiques avec Rego

12 février 2024
0 minutes de lectureChez Snyk, nous sommes de grands adeptes de Rego, le langage d’Open Policy Agent. Snyk IaC repose sur un vaste ensemble de règles écrites en Rego, et les clients peuvent également ajouter leurs propres règles personnalisées.
Nous avons récemment publié une série d’améliorations de Snyk IaC. Dans cet article, nous nous penchons en détail sur une fonctionnalité particulièrement intéressante : l’affichage automatique des emplacements dans le code source pour les violations de règles.
Lors de la vérification des fichiers IaC par rapport aux problèmes connus, la commande `snyk iac test` mise à jour indique précisément le fichier, la ligne et la colonne de chaque violation de règle. Cela fonctionne aussi pour les règles personnalisées, sans que l’utilisateur ait quoi que ce soit à faire.
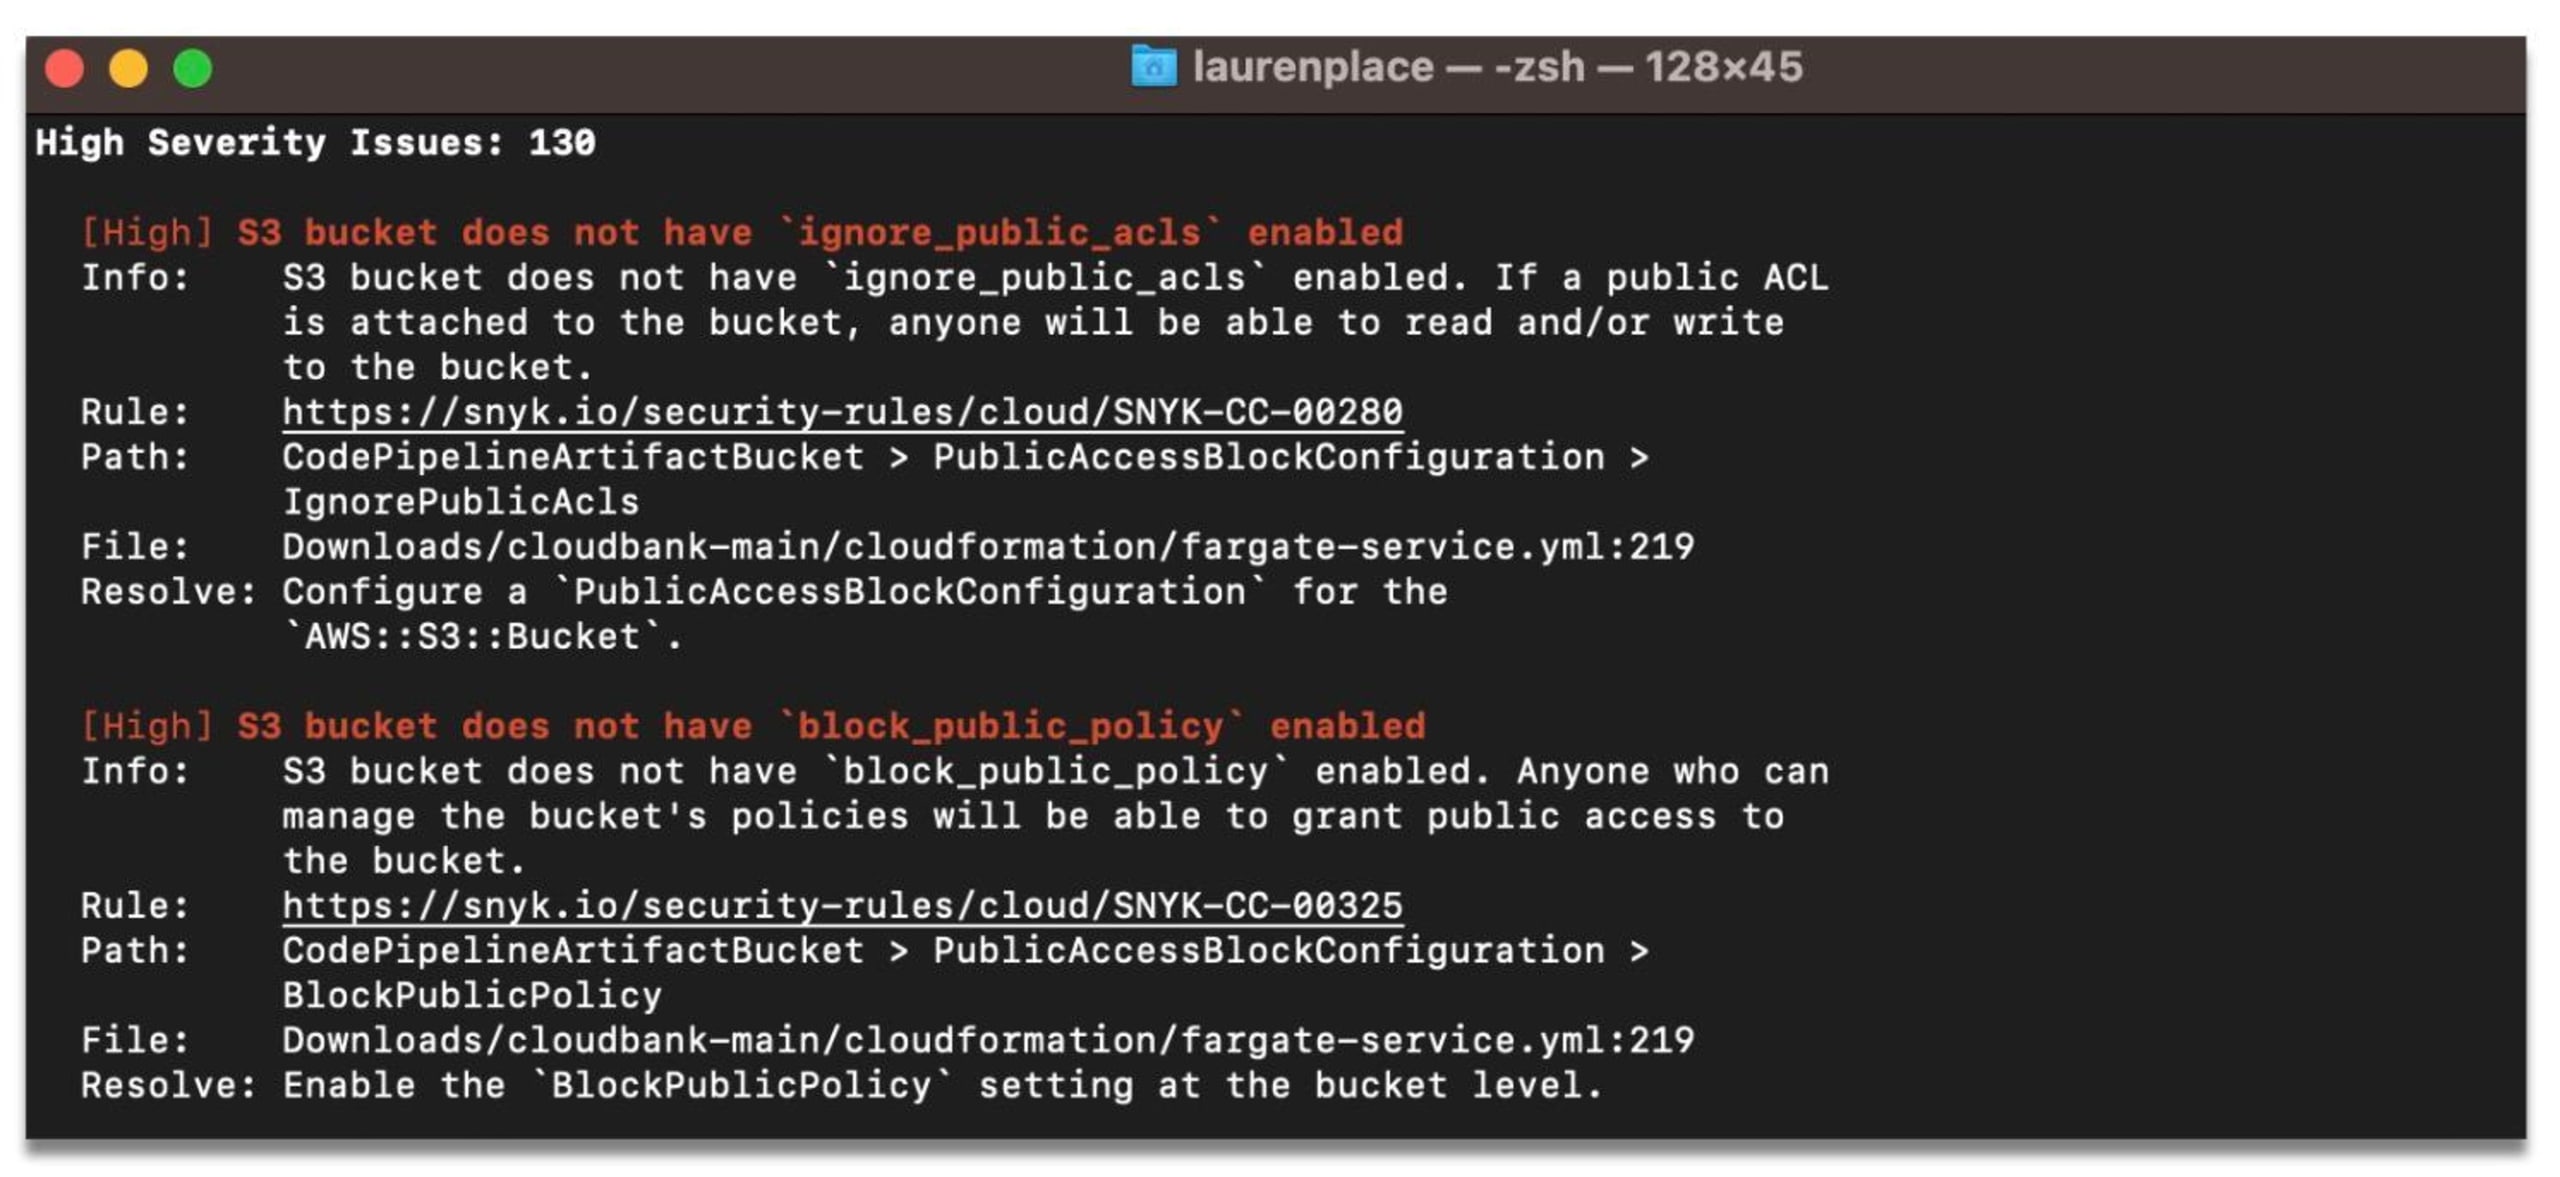
Avant de proposer une preuve de concept autonome de cette technique, nous allons devoir simplifier certains aspects. L’implémentation complète est disponible dans notre moteur de politiques unifié.
Commençons par examiner un exemple CloudFormation. Notre moteur IaC prend en charge de nombreux formats, avec un accent particulier sur Terraform. CloudFormation constitue un bon exemple, car nous pouvons l’analyser sans trop de dépendances (après tout, ce n’est que du YAML).
Nous voulons nous assurer qu’aucun sous-réseau n’utilise de bloc CIDR plus grand que `/24`. Écrivons donc une politique Rego pour cela :
Ainsi, `deny` génère un ensemble de ressources refusées. Nous n’entrerons pas dans les détails du fonctionnement de Rego, mais si vous souhaitez en savoir plus, nous vous recommandons l’excellent cours OPA by Example.
Nous pouvons diviser le problème en deux parties :
Nous devons déduire que notre politique utilise l’attribut `CidrBlock`.
Ensuite, nous récupérons l’emplacement dans le code source.
Commençons par le point (2), qui nous permettra de nous familiariser avec le code.
Récupération de l’emplacement dans le code source
Un emplacement dans le code source ressemble à ceci :
Nous allons également introduire un type auxiliaire pour représenter les chemins dans le YAML. En YAML, il existe deux types de documents imbriqués : les tableaux et les objets.
Pour pouvoir référencer n’importe quel sous-document, nous pourrions utiliser quelque chose de similaire aux chemins JSON. Dans l’exemple ci-dessus, [`"some_array", 1`] pointerait alors vers `"word"`. Mais comme nous ne prendrons pas en charge les tableaux dans notre preuve de concept, un simple tableau de chaînes nous suffira.
Un chemin pourrait par exemple ressembler à ceci :
Nous pouvons maintenant créer un type pratique qui charge le YAML et nous indique l’`Location` de certains `Paths`.
Pour trouver l’emplacement source d’un `Path`, il suffit de parcourir un arbre de nœuds YAML :
Ensembles et arbres de chemins
Maintenant que c’est fait, nous avons ramené le problème de la déduction automatique des emplacements dans le code source utilisés par une politique à la déduction automatique des chemins d’attributs.
C’est également important pour d’autres raisons. Par exemple, Snyk peut appliquer les mêmes politiques aux ressources IaC et aux ressources découvertes lors d’analyses cloud. Ces dernières n’ont pas vraiment d’emplacements source pertinents, mais elles ont des chemins d’attributs qui, eux, le sont !
Nous voulons donc définir des ensembles de chemins d’attributs. Comme les chemins sont représentés par des tableaux, nous ne pouvons malheureusement pas utiliser quelque chose comme `map[Path]struct{}` comme ensemble en Go.
Nous allons devoir les stocker dans un arbre récursif.
Cette représentation présente d’autres avantages. En général, seuls les chemins les plus longs utilisés par une politique nous intéressent, car ils sont plus spécifiques. Notre exemple de politique utilise `Path{"Resources", "PrivateSubnet", "Properties"}` ainsi que `Path{"Resources", "PrivateSubnet", "Properties", "CidrBlock"}` : seul le second nous intéresse.
Nous allons définir une méthode récursive qui insère un `Path` dans notre arbre :
…ainsi qu’un moyen d’en extraire une liste de Paths. Cette opération effectue quelques allocations superflues, mais nous pouvons nous en accommoder.
Nous savons maintenant comment stocker proprement les `Paths` utilisés par une politique et les convertir en emplacements dans le code source.
Analyse statique ou à l’exécution
La question suivante consiste à déterminer quels `Paths` d’une entrée donnée sont utilisés par une politique, puis à les ajouter à l’arbre avec `Insert`.
Ce n’est pas une question simple, car le code peut manipuler l’entrée de différentes façons avant d’utiliser les chemins. Nous devons examiner les fonctions définies par l’utilisateur ( `has_bad_subnet`) ainsi que les fonctions intégrées ( `object.get`), pour illustrer l’un des obstacles possibles :
Heureusement, nous ne sommes pas seuls face à cette question : les gens s’intéressent à ce que font les programmes depuis l’écriture du tout premier programme. Il existe généralement deux façons de répondre à une question de ce type sur un morceau de code :
Analyse statique : tenter de répondre en examinant l’arbre syntaxique, les types et d’autres informations statiques que nous pouvons récupérer (ou ajouter) à l’interpréteur OPA. L’avantage, c’est que nous n’avons pas besoin d’exécuter la politique, ce qui est appréciable si nous ne faisons pas confiance à ses auteurs. En revanche, les techniques d’analyse statique génèrent généralement des faux négatifs et des faux positifs.
Analyse à l’exécution : suivre l’exécution de politiques précises et déduire quels `Paths` sont utilisés à partir des informations disponibles à l’exécution. L’inconvénient, c’est que nous devons effectivement exécuter la politique, et que l’ajout de cette analyse peut ralentir son évaluation.
Nous avons essayé les deux approches, mais nous avons choisi la seconde, car elle nous a semblé beaucoup plus facile à implémenter de manière fiable, et son coût en performances était négligeable. Il faut également préciser que ces deux options ne s’excluent pas : vous pouvez adopter une approche hybride et les combiner.
OPA fournit une interface Tracer permettant de recevoir des événements sur les opérations de l’interpréteur. Les traceurs servent couramment à envoyer des métriques ou des informations de débogage vers un journal centralisé. Mais aujourd’hui, nous allons l’utiliser à autre chose.
Tracer l’utilisation des termes
Rego est un langage expressif. Même si certaines opérations de désucrage le ramènent à un format plus simple pour l’interpréteur, il reste un nombre assez important d’événements.
Deux d’entre eux seulement nous intéressent. Nous considérons qu’une valeur est utilisée si :
1. Elle est unifiée (vous pouvez considérer cela comme une affectation ; nous n’entrerons pas dans les détails) avec une autre expression, par exemple :
Cela couvre également `==` et `:=`. Comme il s’agit d’un test qui peut échouer, nous pouvons affirmer que le membre de gauche et celui de droite ont été utilisés.
2. Elle est utilisée comme argument d’une fonction intégrée, par exemple :
Bien que Rego emprunte certains concepts aux langages paresseux, les arguments des fonctions intégrées sont toujours entièrement résolus avant l’appel de la fonction. Nous pouvons donc dire que tous les arguments fournis à la fonction intégrée ont été utilisés.
3. Elle est utilisée comme expression autonome, par exemple :
Cette méthode sert souvent à évaluer des booléens et à vérifier l’existence d’attributs.
Il est maintenant temps de passer à l’implémentation. Nous identifions deux événements et déléguons leur traitement à une fonction spécifique, afin de rendre le code un peu plus lisible :
Nous gérerons l’insertion dans notre `PathTree` ultérieurement, dans une fonction auxiliaire appelée `used(*ast.Term)`. Pour l’instant, marquons comme utilisés les membres gauche et droit de l’unification :
`event.Plug` est une fonction utilitaire qui remplace les variables par leurs valeurs réelles.
Un événement `EvalOp` couvre les cas (2) et (3) mentionnés plus haut. Dans le cas d’une fonction intégrée, nous disposons d’un tableau de termes dont le premier élément est la fonction et les suivants, ses arguments. Nous pouvons vérifier qu’il s’agit bien d’une fonction intégrée en consultant `ast.BuiltinMap`.
Le cas d’une expression autonome est simple.
Annoter les termes
Lorsque nous essayons d’implémenter `used(*ast.Term)`, une question se pose : étant donné un terme, comment le faire correspondre à un `Path` dans l’entrée ?
Une possibilité serait de rechercher dans le document d’entrée les termes correspondants. Mais cela générerait beaucoup de faux positifs, car une chaîne telle que `10.0.0.0/24` peut apparaître de nombreuses fois dans l’entrée !
Nous allons plutôt annoter tous les termes avec leur chemin. Les termes d’OPA peuvent contenir des métadonnées, notamment l’emplacement dans le fichier source Rego. Nous pouvons réutiliser ce champ pour y stocker un `Path` d’entrée. C’est un peu bricolé, mais en y regardant de plus près, cela reste cohérent : ce champ est bien destiné à stocker des emplacements.
L’extrait suivant montre comment annoter les premières lignes de notre modèle CloudFormation :
`annotate` effectue un parcours récursif pour déterminer le `Path` de chaque nœud de la valeur. Pour aller à l’essentiel, nous ne prenons en charge que les objets, et laissons de côté les ensembles et les tableaux.
Une fois cette annotation en place, il est facile d’écrire `used(*ast.Term)`. Il faut simplement garder à l’esprit que toutes les valeurs ne sont pas annotées. Nous le faisons uniquement pour celles provenant du document d’entrée, et non, par exemple, pour les littéraux intégrés au code source Rego.
Pour conclure
Et voilà ! Nous avons passé sous silence de nombreux détails, notamment la prise en charge des tableaux et l’application de cette méthode à un langage IaC plus complexe comme HCL.
De plus, nous marquons également les attributs `Type` comme utilisés, puisque nous les vérifions dans notre politique. Ce n’est pas idéal. Nous essayons plutôt de proposer une API Rego axée sur les ressources. Mais cela dépasse le cadre de cet exemple.
Si vous souhaitez en savoir plus sur l’une de ces fonctionnalités, nous vous recommandons de consulter snyk/policy-engine pour accéder à l’implémentation principale, ou la version mise à jour de Snyk IaC, qui inclut cette fonctionnalité et bien d’autres, dont un ensemble exhaustif de règles.
Voici une fonction principale qui rassemble tous les éléments et affiche des informations de débogage. Elle se contente essentiellement d’assembler les primitives que nous avons définies jusqu’ici et de les exécuter sur un exemple. Mais ajoutons-la pour que cet article constitue un exemple autonome et reproductible.
Le code complet de cette preuve de concept est disponible dans ce gist.
Une sécurité IaC pensée pour les développeurs
Snyk sécurise votre infrastructure en tant que code, du cycle de développement logiciel à l’exécution dans le cloud, grâce à un moteur unifié de politiques sous forme de code. Chaque équipe peut ainsi développer, déployer et exploiter ses applications en toute sécurité.