Concevoir une application web sans serveur sur AWS
9 mai 2016
0 minutes de lectureNote de la rédaction
Cet article est paru à l’origine sur fugue.co. Fugue a rejoint Snyk en 2022 et constitue un élément clé de Snyk IaC.
Chez Fugue, l’équipe Web est une petite minorité pleine d’entrain, qui aime JavaScript, les 60 images par seconde et les pratiques DevOps simples. Nous apprécions l’expérimentation et les nouvelles approches informatiques qui privilégient le fond et l’élégance aux effets de mode et au clinquant. Depuis quelque temps, nous utilisons AWS Lambda avec des rubriques SNS et des votebots, mais nous n’avions encore rien tenté de vraiment ambitieux. Jusqu’à maintenant. Le framework Serverless nous a donné l’impulsion nécessaire. Notre objectif ? Alimenter une application utile à une fonction métier grâce à une API construite avec Lambda et API Gateway, sans mobiliser la moindre instance EC2.
Revenons un instant en arrière pour expliquer brièvement AWS Lambda. À l’instar d’IBM OpenWhisk, de Google Cloud Functions et d’Azure Functions, il s’agit d’un service « qui exécute du code en réponse à des événements spécifiques, comme le téléversement d’un fichier sur Amazon S3, un flux d’événements ou une requête vers une passerelle d’API ». Fintan Ryan, cité en partie, en propose une bonne présentation ici. Votre code s’adapte automatiquement au volume de requêtes. Ce type de calcul à la demande connaît une croissance fulgurante.
L’application
L’application web front-end que nous avons créée est simple. L’utilisateur se connecte et accède à des informations sur nos builds logiciels ainsi qu’à des URL de téléchargement sécurisées. L’application est hébergée sur S3. Nous créons une API REST pour alimenter cette expérience. Voici l’architecture de l’API :
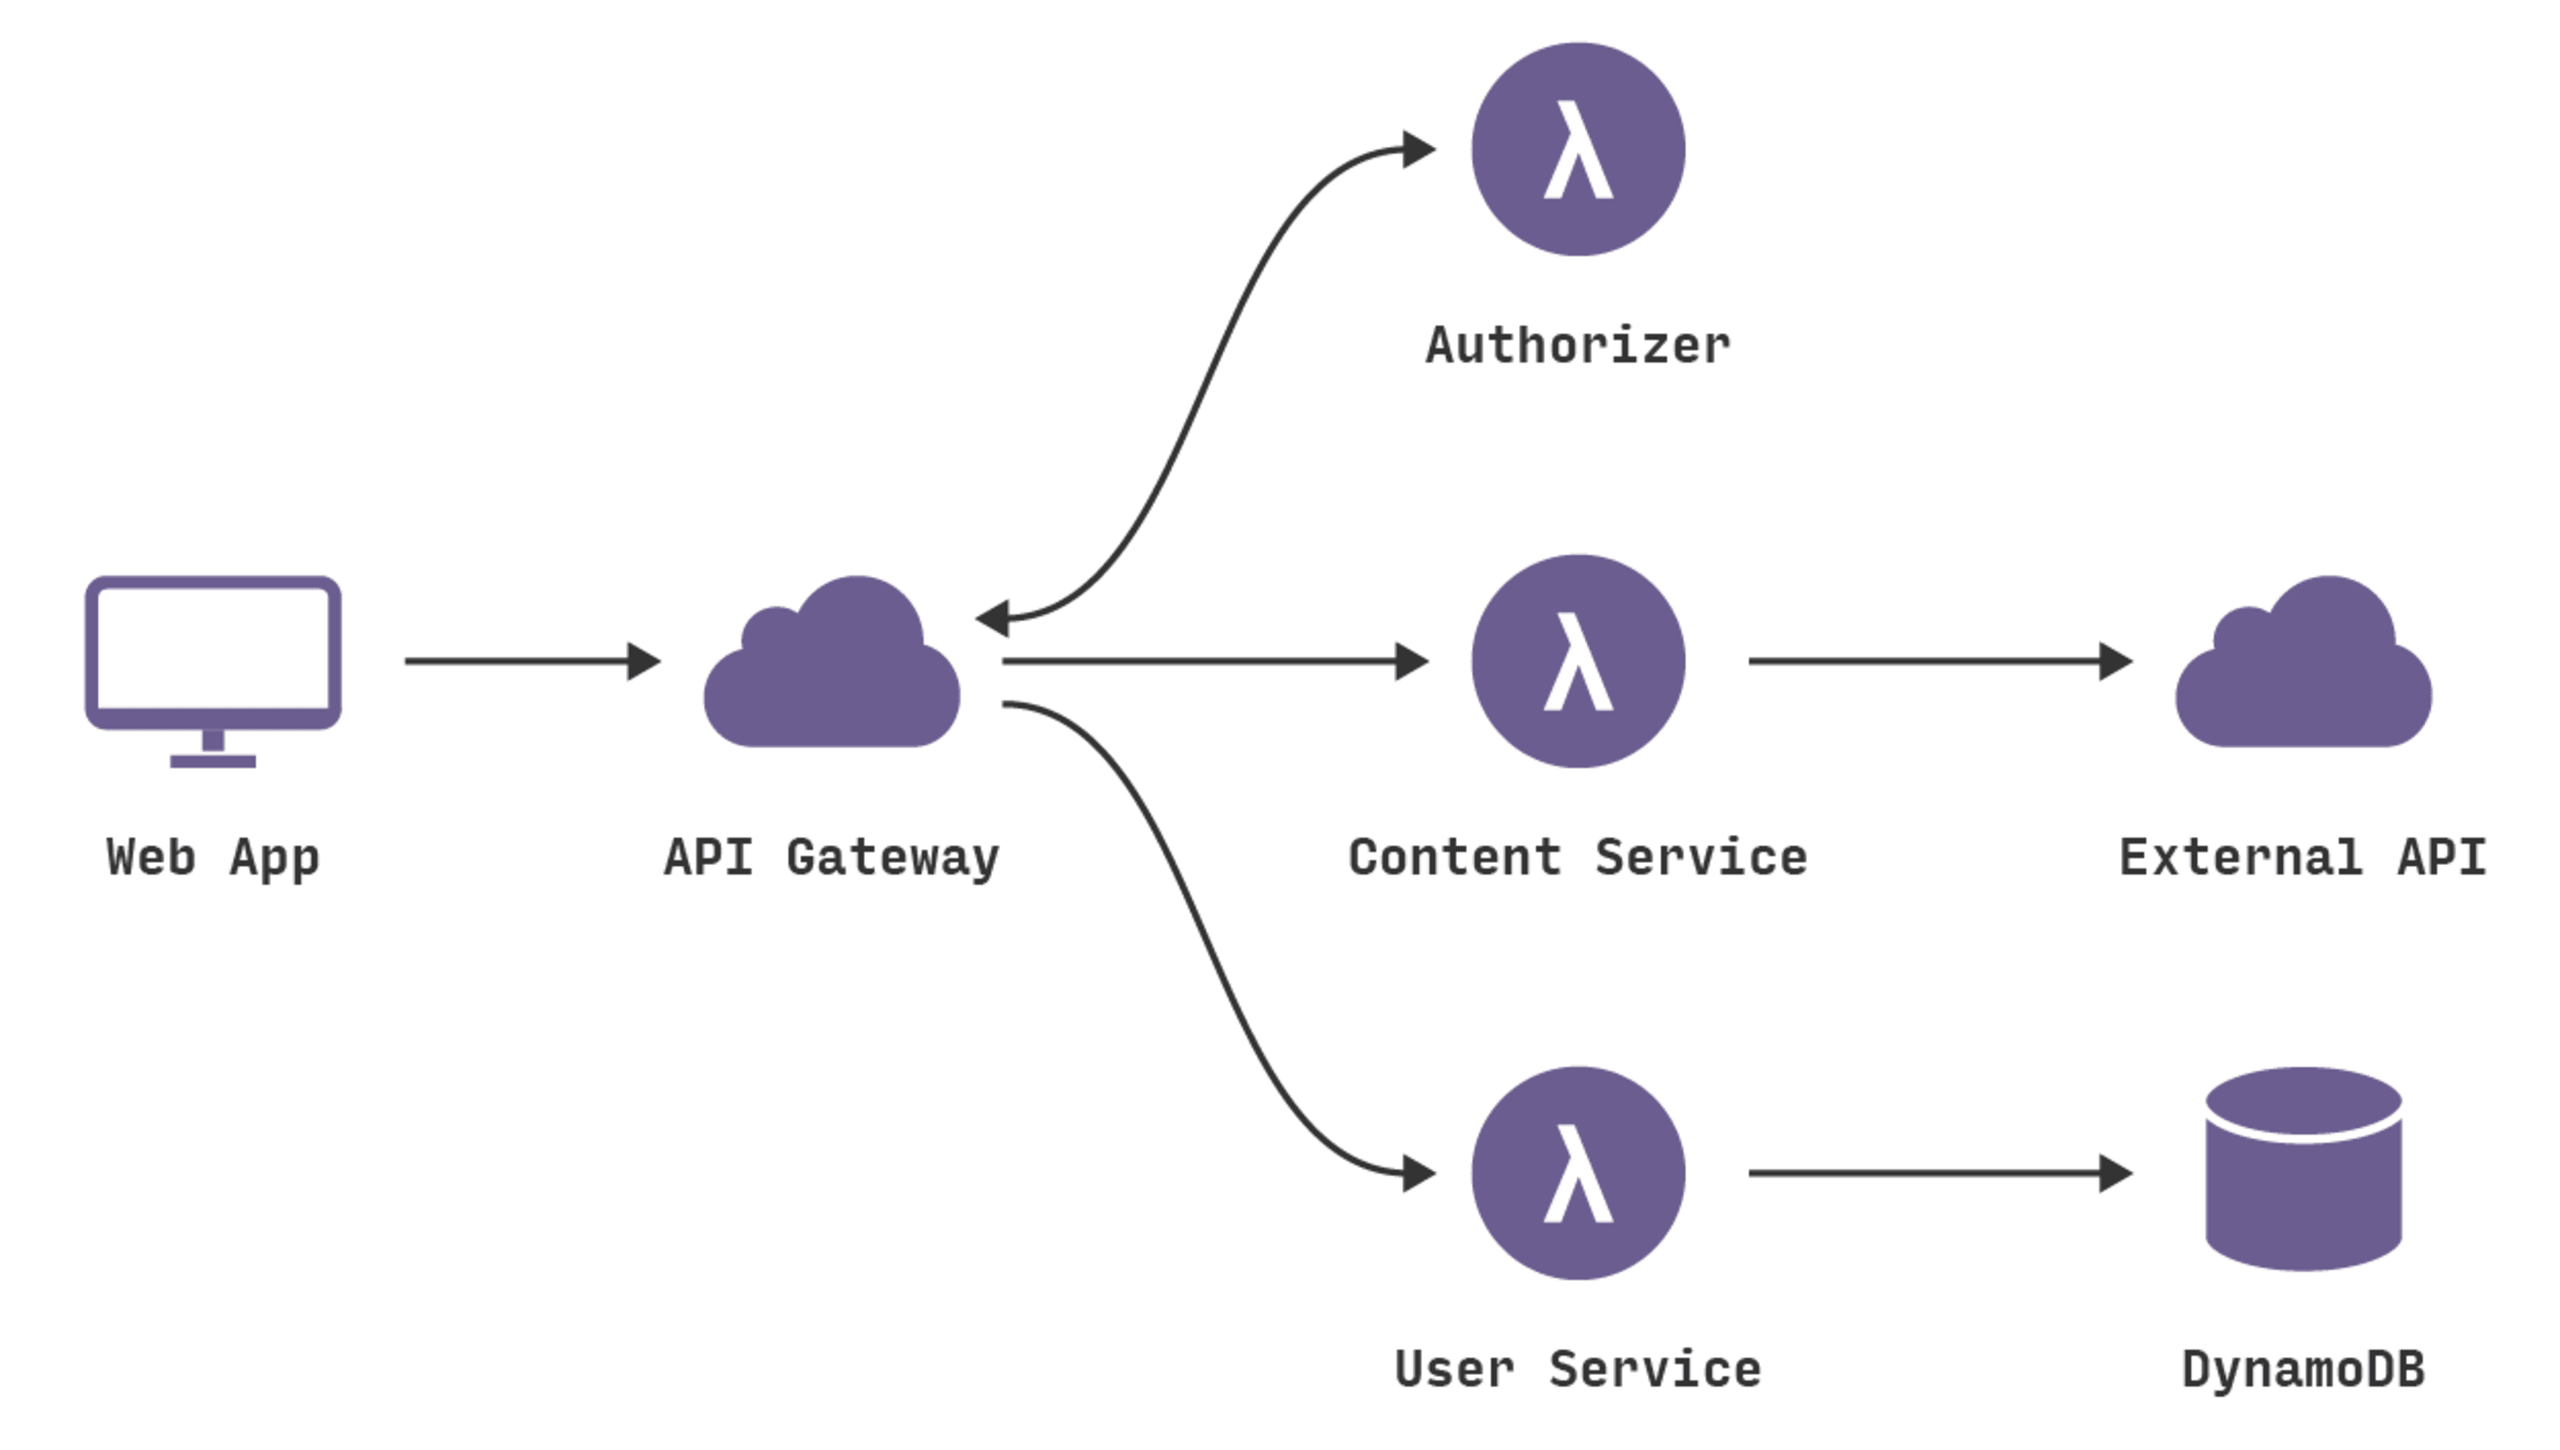
Comme vous pouvez le voir, plusieurs points de terminaison API Gateway déclenchent des fonctions Lambda. La fonction Lambda User Service stocke les données dans DynamoDB. La fonction Lambda Content Service se connecte à l’API de notre service de distribution pour récupérer le contenu, lui apporter quelques retouches de présentation, puis le renvoyer à l’application front-end. La fonction Lambda Authorization valide les jetons de session des utilisateurs et contrôle l’accès aux points de terminaison sécurisés.
Vous pourriez configurer manuellement tous ces services dans AWS, mais nous utilisons le framework Serverless comme outil de déploiement et pour donner une structure à notre projet.
Présentation de Serverless
Serverless est un framework permettant de créer des applications avec Lambda et API Gateway. Il permet également de gérer d’autres ressources AWS à l’aide de modèles CloudFormation. Il se présente sous la forme d’une interface de ligne de commande Node.js bien documentée.
Serverless est puissant, car il gère à la fois votre code et votre configuration AWS. Il impose une structure de projet spécifique, avec des fichiers de configuration JSON pour vos fonctions Lambda. Ces fichiers définissent notamment les points de terminaison API Gateway et les autres événements susceptibles de déclencher la fonction. Pour déployer votre projet, vous devez créer un utilisateur Serverless dans votre compte AWS et lui accorder les autorisations nécessaires pour les services utilisés. Vous pouvez ensuite effectuer le déploiement avec l’interface de ligne de commande : celle-ci configure les services AWS utilisés et publie le code de vos fonctions Lambda.
Résoudre les difficultés
Serverless répond efficacement à plusieurs difficultés rencontrées lorsque nous avons essayé de configurer ce type de projet dans AWS sans utiliser de framework :
1) Les fonctions Lambda sont autonomes et ne peuvent pas partager de code.
Si vous travaillez sur un projet qui comporte plusieurs fonctions, vous voudrez probablement partager du code entre elles, ne serait-ce qu’une bibliothèque utils. Les fonctions Lambda sont déployées dans des conteneurs isolés ; elles ne peuvent donc pas dépendre d’un répertoire de bibliothèques commun. Serverless résout ce problème en vous permettant de configurer le niveau de répertoire à inclure dans le package de déploiement. Vous pouvez ainsi inclure dans votre fonction du code provenant d’un dossier situé dans un répertoire parent, que d’autres fonctions peuvent également utiliser. Les fichiers inclus sont alors regroupés dans le package de déploiement.
2) Les fonctions Lambda ne prennent pas en charge les variables d’environnement.
Comment inclure de façon sécurisée des identifiants secrets, comme des clés d’API, dans votre fonction Lambda, sans les intégrer directement au code et les exposer aux utilisateurs de votre dépôt Github ? Serverless stocke les définitions des variables d’environnement dans des fichiers JSON d’un dossier _meta exclu de Git, puis insère leurs valeurs dans vos fonctions pendant le déploiement. Si vous travaillez en équipe, le plug-in Meta Sync synchronise ces définitions de variables de façon sécurisée via S3.
3) Faire communiquer API Gateway et Lambda est difficile.
Chaque point de terminaison API Gateway nécessite un modèle de requête qui spécifie les informations sur la requête auxquelles la fonction Lambda déclenchée pourra accéder. Votre fonction Lambda aura probablement besoin de connaître le chemin et la méthode de la requête, les paramètres d’URL et de requête, et peut-être un en-tête personnalisé ou le corps d’une requête POST. Sans modèle de requête, aucune de ces informations n’est disponible. De même, par défaut, API Gateway n’interprète pas la réponse d’une fonction Lambda. Si votre fonction renvoie une erreur, aucun code d’erreur HTTP ne lui est automatiquement associé. Vous devez ajouter un modèle de réponse pour associer les chaînes de message d’erreur de la fonction Lambda au code de réponse approprié. Serverless simplifie cette tâche en prenant en charge l’héritage des modèles de requête et de réponse. Vous pouvez ainsi définir des modèles génériques pour tous vos points de terminaison, puis les remplacer au cas par cas si nécessaire.
Structure du projet
Voici la structure des répertoires du projet Serverless de notre application :
s-project.json
Ce fichier contient le nom du projet, sa description et les plug-ins personnalisés utilisés.
s-resources-cf.json
Il s’agit d’un modèle CloudFormation qui décrit les ressources utilisées par le projet, en dehors de Lambda et d’API Gateway. Dans notre cas, il s’agit d’une table DynamoDB, ainsi que d’un rôle et d’une politique IAM permettant à la fonction Lambda de lire et d’écrire dans DynamoDB.
_meta
Ce dossier contient des fichiers JSON définissant les variables d’environnement du projet, éventuellement propres à l’étape de déploiement et à la région. Ce dossier est exclu de Git.
functions
Ce dossier contient un sous-dossier pour chacune de nos fonctions Lambda. Serverless n’impose aucune organisation particulière : vous pouvez imbriquer les fonctions dans les dossiers comme vous le souhaitez. Le dossier d’une fonction doit contenir un fichier avec le code de la fonction (dans notre cas, handler.js) et un fichier s-function.json, qui contient la configuration de la fonction et les points de terminaison susceptibles de la déclencher. Il peut également contenir un fichier event.json, qui contient un objet de test dont nous parlerons plus loin. Comme indiqué précédemment, nous avons un dossier lib situé à côté des dossiers des fonctions, que chacun de ces dossiers (par exemple, user et content) peut inclure.
Coup d’œil aux composants du projet Serverless
Notre projet Serverless repose sur trois composants architecturaux clés : les fonctions Lambda, une API REST API Gateway et d’autres ressources AWS, comme notre table DynamoDB et notre rôle IAM. Voyons de plus près comment nous utilisons ces composants.
Fonctions Lambda
À l’exception de la fonction Lambda authorizer, dont nous parlerons dans un instant, nous avons réparti notre code entre deux fonctions : content et user. Pourquoi ?
Techniquement, vous pouvez répartir votre code Lambda comme vous le souhaitez. Tous vos points de terminaison pourraient déclencher une seule fonction, qui analyserait la requête et déterminerait la réponse à renvoyer. Vous pourriez aussi créer des fonctions pour chaque point de terminaison et événement de votre projet. Nous avons opté pour une approche hybride, en regroupant le code dans des fonctions de microservices après avoir pris en compte plusieurs facteurs :
Organisation du code
Il est logique de regrouper les points de terminaison similaires dans une même fonction. Tout notre code lié aux utilisateurs utilise la même table de base de données et les mêmes bibliothèques externes. En regroupant ce code similaire dans une seule fonction, nous avons la certitude que les modifications du code s’appliqueront immédiatement à tous les points de terminaison.
Performances
La documentation Lambda indique que les fonctions plus petites sont plus performantes. La latence d’une fonction est bien plus élevée si elle n’a pas été invoquée récemment — d’après notre expérience, si aucune invocation n’a eu lieu depuis environ cinq minutes. Après la première invocation, la latence diminue considérablement. La latence initiale, ou « temps de démarrage à froid », est directement liée à la taille de la fonction. Les fonctions plus petites démarrent plus rapidement à froid. (Vous pouvez également réduire ce temps de démarrage à froid en augmentant la mémoire allouée à vos fonctions, ce qui augmente proportionnellement le processeur disponible.)
Ce démarrage à froid lent ne pose pas de problème pour les cas d’usage asynchrones de Lambda, mais il en pose un pour une API qui reçoit peu de trafic. Notre API doit répondre rapidement, sans quoi l’expérience utilisateur de l’application en pâtira.
Regrouper des fonctionnalités connexes dans des fonctions Lambda plus grandes permet de maintenir un certain niveau de préchauffage. Par exemple, lorsqu’un utilisateur se connecte à son compte puis consulte son profil, cela peut nécessiter deux appels d’API. Le premier peut être lent si la fonction n’a pas été invoquée récemment, mais le second sera forcément rapide si les deux points de terminaison déclenchent la même fonction.
Remarque : nous avons envisagé de maintenir nos fonctions préchauffées en envoyant simplement une requête ping à un point de terminaison toutes les cinq minutes. Cela fonctionnerait sans doute, mais nous n’avons pas jugé nécessaire de le mettre en place.
Gestionnaire de fonction
Dans notre fichier s-function.json, nous définissons le gestionnaire de fonction. Dans notre cas, il s’agit d’une fonction appelée handler dans handler.js. C’est cette fonction qui est appelée lorsque la fonction Lambda est invoquée. Voici à quoi ressemble le fichier handler.js de la fonction content :
Comme vous pouvez le voir, il sert essentiellement de routeur pour notre fonction. Tout le code important est abstrait dans /lib/download.js, qui ignore qu’il fait partie d’une fonction Lambda. Cela facilite l’écriture de tests unitaires pour notre code, car /lib/download.js est simplement un fichier JavaScript sans dépendance particulière à Lambda.
API REST API Gateway
Les points de terminaison sont configurés dans le fichier s-function.json. Voici un exemple de configuration de point de terminaison :
Ce point de terminaison sera accessible en GET sur /downloads.
Modèles de requête et de réponse
Vous avez vu $${requestTemplate} et $${responseTemplate} dans la configuration du point de terminaison ci-dessus. Cela signifie que le point de terminaison downloads héritera des modèles requestTemplate et responseTemplate définis dans un fichier de modèles global pour notre projet.
Les modèles de requête et de réponse sont représentés en JSON et utilisent des expressions JSONPath. Vous pouvez manipuler ces expressions à l’aide de Apache Velocity Template Language (VTL). La syntaxe est un peu délicate.
Serverless a récemment ajouté la prise en charge des modèles de requête et de réponse YAML, mais nous utilisons actuellement le format JSON. Voici notre modèle de requête :
Oui, le résultat semble un peu fou, comme c’est souvent le cas avec du JSON échappé à l’intérieur de JSON, mais il génère un objet d’événement pour la fonction Lambda qui contient toutes les informations dont nous avons besoin sur la requête :
body contient le corps JSON analysé de la requête
path correspond au chemin du point de terminaison demandé
method correspond à la méthode HTTP utilisée pour la requête
headers contient tous les en-têtes HTTP de la requête
params contient les paramètres de chemin de la requête
query contient les paramètres de requête
authorizedUser correspond au nom d’utilisateur autorisé, si le point de terminaison exigeait une autorisation
Voici maintenant notre modèle de réponse. Si la fonction Lambda s’exécute correctement, la chaîne de résultat est transmise à l’utilisateur au format JSON (à l’aide du fragment de modèle response200). Si la fonction échoue, les expressions régulières tentent de faire correspondre la chaîne de résultat. Nous renvoyons différents codes d’erreur HTTP selon le message d’erreur.
Gestion de l’autorisation
Pour gérer les autorisations de notre application, nous utilisons deux fonctionnalités d’API Gateway : les clés API et les fonctions d’autorisation personnalisées. Elles nous permettent de simplifier le code de l’application en retirant toute logique d’autorisation des fonctions Lambda principales.
Clés API
API Gateway vous permet de créer une clé API et de l’associer à des points de terminaison individuels. Nous l’utilisons pour protéger certains points de terminaison sensibles qui ne doivent pas être accessibles côté client, comme la gestion des utilisateurs. Pour toute requête adressée aux points de terminaison sélectionnés, API Gateway recherche un en-tête x-api-key et tente de faire correspondre sa valeur à la clé API que nous avons créée. Si l’en-tête est absent ou incorrect, la requête renvoie une erreur 403 et la fonction Lambda n’est jamais invoquée.
Autoriseurs personnalisés
API Gateway a récemment ajouté l’autorisation personnalisée, qui permet à une fonction Lambda de contrôler l’accès aux points de terminaison. Une requête entrante invoque la fonction d’autorisation personnalisée en lui transmettant un jeton d’autorisation provenant d’un en-tête de requête personnalisé spécifié. L’autoriseur personnalisé valide le jeton d’autorisation (dans notre cas, un JSON Web Token), puis renvoie une stratégie IAM pour autoriser la requête. Si la stratégie n’est pas valide pour la requête ou si l’autorisation échoue, API Gateway renvoie une erreur 403. Si la stratégie est valide, la fonction Lambda associée au point de terminaison est déclenchée.
Voici un exemple de stratégie IAM renvoyée par notre autoriseur personnalisé :
Comme notre application Web ne gère pas les autorisations de façon granulaire, nous accordons l’accès à tous les points de terminaison de l’API qui utilisent l’autoriseur personnalisé. API Gateway met en cache la stratégie IAM générée avec le jeton d’autorisation utilisé pour la créer. Les requêtes suivantes vers n’importe quel point de terminaison protégé, avec le même en-tête de jeton d’autorisation, reçoivent automatiquement cette stratégie et contournent l’autoriseur personnalisé pendant la durée de vie du cache (TTL) que vous avez définie.
Workflow du projet Serverless
Environnements
Notre projet doit au minimum disposer d’environnements distincts pour le développement, les tests et la production.
Serverless utilise le concept de « stages », implémentés de différentes façons selon les services AWS, mais qui, ensemble, fonctionnent comme un environnement.
Lambda : chaque modification du code d’une fonction Lambda entraîne automatiquement la création d’une nouvelle version. Les fonctions Lambda peuvent avoir des alias associés à leurs versions. Serverless utilise ces alias pour pointer vers différentes versions selon les stages. Par exemple, si le stage dev est publié et devient la version 1 de la fonction Lambda, Serverless crée également un alias dev qui pointe vers la version 1. Si le stage prod de la fonction est ensuite publié, le code de prod devient la version 2, mais l’alias dev pointe toujours vers la version 1.
API Gateway : une même API dans API Gateway peut comporter plusieurs stages. Chaque stage d’un point de terminaison d’API peut déclencher un alias Lambda différent. Le stage dev d’API Gateway peut donc utiliser l’alias dev de la fonction Lambda, quelle que soit la version vers laquelle il pointe. Le nom du stage est intégré au chemin du point de terminaison.
D’autres services AWS, comme les tables DynamoDB et les compartiments S3, existent séparément pour chaque stage.
Tests
Le dossier de chaque fonction Lambda peut contenir un objet événement fictif à utiliser pour les tests, dans un fichier event.json :
serverless function run exécute la fonction en utilisant event.json comme événement. C’est utile pour tester la fonction de bout en bout.
Plusieurs plugins Serverless simulent localement API Gateway à des fins de test, notamment Offline et Serve. API Gateway continuant d’ajouter des fonctionnalités, nous avons constaté que ces plugins ne les prenaient pas toujours toutes en charge. Nous avons donc effectué la majeure partie de nos tests API Gateway dans la console AWS.
Nous utilisons Jasmine pour les tests unitaires de nos fichiers JavaScript lib.
Déploiement
Trois éléments doivent être déployés pour que notre projet soit opérationnel : les fonctions, les points de terminaison et les ressources du projet (c’est-à-dire les ressources AWS répertoriées dans s-resources.json). Nous pouvons les déployer individuellement à l’aide des commandes CLI suivantes :
Nous pouvons également utiliser le tableau de bord interactif de déploiement, très pratique, avec la commande serverless dash deploy :
Avec l’une ou l’autre de ces options, nous pouvons effectuer des déploiements très ciblés et mettre à jour une seule fonction ou un seul point de terminaison sans rien modifier d’autre.
Le tableau de bord interactif est très pratique pour le développement et les tests en local, mais nous utilisons le premier ensemble de commandes avec les outils d’intégration continue. Par défaut, la CLI vous invite à renseigner les options manquantes, mais vous pouvez désactiver cette interaction en définissant sur true une variable d’environnement appelée CI. Nous utilisons Travis CI pour l’intégration continue et les déploiements. Travis exécute donc nos tests unitaires, puis utilise la CLI en mode CI pour déployer notre code sur AWS.
Consultez la référence de la CLI Serverless pour en savoir plus.
Pour conclure
Il y a quelques mois, notre CEO Josh a partagé ses réflexions sur AWS Lambda et l’évolution continue du cloud. Il a notamment déclaré :
Lambda impose une vision particulière de l’architecture des applications, contrairement aux offres PaaS traditionnelles. Le service ne cherche pas à imiter un ordinateur classique ou un cluster d’ordinateurs classiques. Lambda est plutôt piloté par les événements et impose que les fonctions soient sans état. Vous devrez donc réfléchir différemment à la composition d’une application. En contrepartie, vous bénéficiez d’une évolutivité quasi illimitée et de coûts très faibles par rapport aux instances de calcul ou aux conteneurs. Il faut toutefois consacrer du temps à l’apprentissage, mais vos expérimentations et vos recherches pourraient bien vous amener à inventer de nouveaux modèles.
Tout à fait. Le temps consacré à l’apprentissage et à la pratique en vaut la peine. Nous espérons que l’exemple présenté ici vous sera utile. D’autres frameworks comme Serverless devraient apparaître prochainement, mais celui-ci constitue une bonne introduction et permet de créer une application Web robuste.
Une sécurité IaC pensée pour les développeurs
Snyk sécurise votre infrastructure en tant que code, du cycle de développement logiciel à l’exécution dans le cloud, grâce à un moteur unifié de politiques sous forme de code. Chaque équipe peut ainsi développer, déployer et exploiter ses applications en toute sécurité.


