The Agent Baseline : 35 contrôles, mais par où commencer ?

Krysztof Huszcza


12 août 2026
0 minutes de lectureIl y a deux semaines, nous avons publié l’Agent Baseline avec Docker et Keycard. Nous y présentons six objectifs de sécurité, 35 contrôles et une architecture de référence ouverte pour exploiter des agents d’IA à l’échelle de l’entreprise. La semaine dernière, nous l’avons mise à l’épreuve : nous l’avons présentée à un panel à Black Hat et avons passé environ une heure à répondre à des questions difficiles.
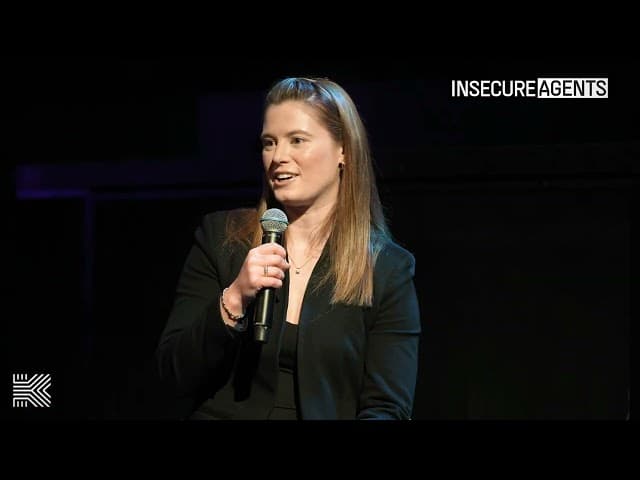
La question la plus utile est venue d’une personne qui l’avait déjà lue. En substance, elle a dit : « C’est bien, mais je ne sais toujours pas quoi faire lundi matin. »
Et c’est une remarque tout à fait juste. Elle mérite aussi une vraie réponse, car elle met le doigt sur un aspect que nous avons choisi de ne pas traiter dans le document. C’est également le genre de lacune que nous espérons voir les lecteurs relever tant que l’Agent Baseline est encore ouvert aux commentaires.
Le brouillard est bien réel, et nous sommes en plein dedans
Si vous cherchez de l’aide pour sécuriser les agents d’IA, vous allez très vite vous heurter à un mur d’affirmations, car tous les fournisseurs du marché (y compris Snyk) vous diront qu’ils résolvent le problème de la sécurité des agents. Chacun décrit une réalité, mais il est presque toujours difficile de savoir quelle partie du problème il aborde et comment sa solution s’articule avec les autres éléments dont vous avez encore besoin.
Il ne s’agit pas de malhonnêteté. C’est simplement le symptôme d’un marché qui s’est développé plus vite que son vocabulaire. Aujourd’hui, « gouvernance des agents » peut désigner au moins cinq choses différentes selon le fournisseur, et les acheteurs n’ont aucun moyen fiable de savoir si deux produits se recoupent, se complètent ou laissent entre eux une lacune dont personne n’a parlé (ou que personne n’a même identifiée, ce qui est plus inquiétant encore).
Cela vaut dans les deux sens. Les fournisseurs veulent expliquer clairement où ils apportent de la valeur et comment leur solution s’intègre au reste de l’architecture d’un client. Mais sans vocabulaire commun, leur discours finit par ressembler aux mêmes affirmations génériques que celles de tous les autres.
Et les équipes sur le terrain ont besoin de plus qu’un décodeur de discours commerciaux : la cartographie des six objectifs montre où vous devez chercher des solutions externes et où vous disposez déjà de solides compétences internes. C’est la question de l’achat ou du développement en interne, et il est beaucoup plus facile d’en parler quand les lacunes sont clairement nommées.
Prenons deux produits, tous deux présentés comme des solutions de gouvernance des agents, et dont les descriptions sont exactes.
Le premier se situe à la périphérie du réseau. Il surveille tous les appels qu’un agent adresse au monde extérieur, peut en inspecter le contenu et les bloquer selon des règles. Il vous indiquera qu’une requête contenant des données client a été envoyée à un endroit où elle n’aurait pas dû arriver. En revanche, il ne peut pas vous dire quel fichier de compétence a placé cette instruction dans la tête, au sens figuré, de l’agent, car rien de tout cela ne passe par lui.
Le second est une couche d’identité. Il fournit des identifiants à durée limitée et aux autorisations limitées au moment de leur utilisation, de sorte que chaque action permet de vérifier qui l’a déclenchée et avec quelle autorité. Il vous indiquera précisément que l’agent était autorisé à faire ce qu’il a fait. En revanche, il ne peut pas vous dire si c’était une bonne idée.
Maintenant, reportez les deux solutions sur les six objectifs : la première couvre des aspects de Constrain et Observe, la seconde couvre Authorize. Aucune n’exagère ses capacités, elles ne se recoupent pas et, ensemble, elles ne couvrent pas Validate. Personne n’a vérifié si l’agent se comporte de manière sûre en cas d’attaque, et personne n’a contrôlé ce qu’il a produit. Un acheteur qui possède les deux et croit, à juste titre, avoir réglé la question de la gouvernance des agents n’a jamais eu cette conversation, parce qu’elle n’a été abordée dans aucun des deux cycles de vente.
L’Agent Baseline a précisément été conçu pour permettre cette comparaison. Il définit le problème selon les objectifs de sécurité qu’une organisation doit atteindre, et non par catégorie de produit : Discover, Constrain, Authorize, Observe, Validate et Respond. En comparant n’importe quelle plateforme, n’importe quel produit ou développement interne à ces six objectifs, nous comprenons rapidement où ces solutions excellent, mais aussi où des solutions complémentaires pourraient être nécessaires.
Nous avons accordé trop peu d’importance à l’ordre des étapes, car six objectifs et 35 contrôles permettent de mesurer la couverture, mais mesurer la couverture ne constitue pas un plan. (Excusez ce petit Yoda, mais ce jeu de mots montre aussi l’importance de l’ordre des mots : le sens est là et compréhensible, mais un ordre maladroit demande une seconde de plus pour le saisir.)
Si vous lisez maintenant le document comme une liste de tâches, vous ne commencerez pas, car le point de départ ressemble à un programme de deux ans. Voici donc ce que nous vous devions : l’ordre des étapes.
La plupart des organisations n’ont pas encore d’usine logicielle
Nous étions convaincus d’une chose, que le panel de Black Hat a confirmée : très peu d’entreprises exploitent aujourd’hui des usines logicielles, et beaucoup ne cherchent pas à en construire une à grande échelle. Il est important de le dire clairement, car une architecture de référence peut donner l’impression de vous faire un reproche si vous n’en êtes pas encore là. Ce n’est pas le cas. Si vous êtes sur le point d’y arriver (et c’est le cas de la plupart des organisations), voici le cadre sur lequel vous appuyer. Il donne à la sécurité un rôle dans la préparation à cette automatisation et à ces gains de productivité, plutôt que dans une réaction après coup.
Le cas d’usage, l’axe manquant
Le document suit la courbe d’autonomie, d’un agent de développement sur un ordinateur portable à un service sans supervision qui applique des correctifs aux dépendances à 3 h du matin. C’est une bonne manière d’expliquer pourquoi ces contrôles existent, mais pas de décider lesquels mettre en place en premier, car la plupart des organisations ne suivent pas une seule courbe : elles font fonctionner plusieurs types d’agents en même temps et les appellent tous des « agents ».
Trois scénarios couvrent la plupart des cas que nous observons :
1. Agents de développement. Une personne de l’organisation télécharge un agent de développement et l’utilise sur un véritable dépôt de code.
2. Agents internes partagés. Un même agent est utilisé par de nombreux employés, par exemple un assistant RH, un agent d’approbation financière ou un copilote des opérations.
3. Agents de production. Ces agents agissent sur des clients, des transactions et des systèmes d’information de référence, souvent avec très peu de supervision humaine.
Vous avez donc 35 contrôles, mais l’ordre dans lequel ils s’appliquent est radicalement différent selon le cas. Le problème survient quand vous essayez de les traiter comme un seul programme : le contrôle le plus important pour le premier cas est presque sans pertinence pour le troisième, et inversement. Si vous vous trompez dans l’ordre, vous passerez des mois à créer un registre d’agents alors que votre véritable exposition se situe ailleurs.
Agents de développement : commencez par Constrain, puis affinez avec Discover
À première vue, on serait tenté de commencer par la découverte : il faut, pense-t-on, trouver tous les agents, puis décider quoi faire. Dans ce cas d’usage, c’est le mauvais point de départ. Le document l’explique en une phrase : un registre et un processus d’approbation ne servent à rien si l’agent s’exécute sur un hôte qui n’applique ni l’un ni l’autre.
Voici ce qui se passe vraiment : une personne développeuse installe un agent de développement, qui lui demande l’autorisation chaque fois qu’il doit lire un dossier ou exécuter une commande. Les demandes incessantes deviennent agaçantes. La personne autorise alors les commandes courantes, élargit l’accès au système de fichiers ou désactive même le bac à sable. L’agent devient alors un processus ordinaire, exécuté avec les droits de cette personne et pouvant accéder à tout ce que son interpréteur de commandes peut atteindre.
L’accès s’étend connexion après connexion : GitHub ouvre un flux OAuth, un outil cloud détecte une session existante, un serveur MCP demande un jeton, SSH utilise la clé déjà chargée sur la machine, et ainsi de suite. Vous voyez l’idée.
Chaque étape semble raisonnable en soi. Mais au final, l’agent dispose de vastes autorisations réparties entre des systèmes qui ne partagent aucune visibilité entre eux, et les journaux indiquent tous que c’est la personne développeuse qui a effectué les actions.
Commencez donc par définir la frontière. L’exécution isolée et les profils de capacités limités au cas d’usage (CON-03, CON-04) accordent à l’agent uniquement les accès nécessaires à son type de tâche. Ces profils sont définis de manière centralisée, versionnés et hors de portée de l’agent, qui ne peut pas les modifier. Vient ensuite le registre des composants (DIS-04) : serveurs MCP, compétences, extensions, modèles et outils, avec leur source et leur version. Puis, les tests à la sortie (VAL-03), car le code généré par un agent passe par les mêmes étapes de validation avant mise en production que tout le reste.
Ce qui surprend le plus, c’est que cela améliorera le quotidien des personnes développeuses, au lieu de le compliquer. Lorsque les identifiants sont fournis par un courtier au moment de leur utilisation et limités à la tâche, l’agent cesse de demander une approbation pour chaque commande « inoffensive », car ces commandes ne peuvent plus causer de dommages. Un même contrôle permet de réduire le nombre de demandes et de renforcer les limites, ce qui est assez rare pour mériter d’être souligné.
La découverte reprend alors sa place : non pas comme première étape, mais comme ce qui permet de rendre la première aussi efficace que possible.
La qualité d’un profil de capacités dépend de la qualité des informations sur lesquelles il repose. Si vous le rédigez sur la base de suppositions, vous risquez deux échecs : il sera trop permissif, et l’agent commencera à compter sur des accès dont la tâche n’a jamais eu besoin ; ou il sera trop restrictif, et la limite sera levée à force de cliquer sur « Toujours autoriser ». Dans les deux cas, la cause est la même : un profil rédigé sans examiner la situation.
Vous avez donc tout intérêt à examiner la situation. La cartographie des accès effectifs (DIS-06) vous indique quelles identités et quels identifiants un agent peut réellement utiliser, ainsi que les autorisations qu’ils lui confèrent. Le registre des composants vous indique quels serveurs MCP, compétences et modèles sont réellement utilisés, plutôt que ceux que vous supposez l’être.
Et cela ne s’arrête pas au premier jour : le rapprochement (DIS-07) vous indique si le profil a évolué, par exemple à l’ajout d’un nouveau serveur MCP ou au changement de fonctionnement d’une tâche. Le document est explicite : la découverte ne se limite pas à un registre statique, c’est une vue opérationnelle continuellement mise à jour par rapprochement.
Constrain est le point de départ pour appliquer des contrôles, et Discover permet de déterminer lesquels. Suivez ces étapes dans cet ordre, sans les dissocier : Discover est un élément essentiel pour définir les contraintes et doit donc être abordé dès le début.
Agents internes partagés : commencez par Authorize
Le bac à sable ne sert presque à rien ici, car le risque n’est pas l’étendue des dommages possibles sur un hôte, mais celui du « mandataire confus ». (C’est un problème d’autorité. Le concept remonte à Norm Hardy, en 1988 : un programme disposant légitimement d’une autorité est manipulé pour l’exercer au nom du mauvais principal. Rien n’est compromis, rien ne sort du périmètre de confinement, aucune vulnérabilité n’est exploitée, mais le mandataire ne peut tout simplement pas savoir au nom de qui il agit.)
L’intégration la plus rapide consiste à donner un compte de service à l’agent et à faire passer toutes les requêtes des utilisateurs par ce compte. Cela fonctionne immédiatement… et c’est justement le problème. Toutes les requêtes accèdent alors au même ensemble d’autorisations. Lorsqu’une requête arrive à l’API interne, la personne qui l’a envoyée n’est plus identifiable, et une invite fondée sur les données d’Alice peut exercer des autorisations prévues pour Bob. Demander au modèle de séparer leurs tâches est une consigne, pas une limite de sécurité.
Dans ce cas d’usage, l’autorité doit être intégrée à la structure : chaque partie prenante d’une action doit avoir une identité distincte et vérifiable, avec une attribution à la personne qui l’a initiée ou à une finalité autonome approuvée (AUT-01). L’autorité doit être limitée à la tâche plutôt qu’héritée du compte (AUT-02) : le principe du moindre privilège limite l’étendue des accès, tandis que la délégation en précise le motif, la portée et la durée. Enfin, l’autorité doit être réduite à chaque niveau de la chaîne (AUT-03), afin qu’un agent en aval ne reçoive jamais plus d’autorisations que l’appelant.
Vient ensuite la corrélation (OBS-02), car avec un agent multiutilisateur, la question de l’audit n’est pas « Quelque chose s’est-il passé ? », mais « Au nom de qui cela s’est-il passé ? ». Sans identifiant d’exécution reliant la requête à l’action, vous ne pourrez pas répondre après coup. Or, c’est justement après coup qu’on vous posera la question.
Agents de production : commencez par Respond et Validate
Pour les agents qui interagissent avec les clients et effectuent des transactions, les contrôles qui comptent sont ceux auxquels personne ne pense avant d’en avoir besoin. Alors, commencez par vous poser cette question : si vous deviez arrêter cet agent immédiatement, qu’adviendrait-il du travail en cours ?
Le problème, c’est que la plupart des équipes ne peuvent pas répondre à cette question, et c’est là que nous constatons une lacune. RES-01 indique que l’arrêt consiste à bloquer les nouveaux travaux, à interrompre les exécutions en cours et à révoquer les identifiants, autorisations, délégations accordées et sessions créés par ces exécutions, en suivant la chaîne de délégation plutôt que le processus visible. Supprimez le conteneur, mais laissez le jeton actif : vous n’avez rien arrêté. RES-02 ajoute un aspect véritablement nouveau : l’unité de mise en quarantaine est souvent un composant, et non un hôte. Un fichier de compétence empoisonné ou un serveur MCP compromis peut être partagé par des dizaines d’agents. Et comme il suffit parfois de placer un fichier dans un répertoire pour le rendre accessible, supprimer une copie ne règle rien.
Vient ensuite RES-04, le contrôle dont nous parions qu’il manque presque partout : une solution de repli sans agent pour les tâches qui ne peuvent pas attendre. Dès qu’un flux de travail dépend d’un agent, c’est l’agent, et non la plateforme, qui permet d’effectuer le travail. Arrêtez-le, et le travail reste en plan. Quels flux de travail nécessitent une procédure manuelle documentée, et quelle doit être cette procédure ? Ce sont des décisions à prendre avant l’incident.
Du côté de la validation, VAL04 : un agent peut réussir une action tout en obtenant un résultat erroné, car une autorisation ne garantit pas la justesse. Pour les actions irréversibles en particulier, validez le résultat envisagé avant de le rendre définitif, et non une fois l’action effectuée.
C’est sur cet aspect de l’architecture que nous travaillons chez Snyk. Il ne s’agit pas seulement de vérifier la fiabilité du code et des dépendances d’un agent, mais aussi de s’assurer qu’en cours d’exécution, son comportement reste dans les limites de son autorité : ce qu’il est autorisé à faire, au nom de qui, et ce qui se passe s’il dépasse ces limites. Une grande partie du Baseline ne relève pas de notre périmètre, ce qui est précisément l’intérêt d’un modèle indépendant des fournisseurs.
L’équilibre relève d’un choix de conception, pas nécessairement d’un compromis
Quand la situation devient préoccupante, le réflexe est de tout bloquer : interdire les outils, attendre que le marché se stabilise, se dire « on y reviendra l’année prochaine ».
Mais ça ne fonctionne pas, et pas pour la raison qu’on avance habituellement. Le problème ne tient pas seulement au fait que l’adoption dans l’ombre se poursuivra (car c’est bien le cas), mais aussi au fait que le blocage vous prive de visibilité sur ce qui vous inquiète, tandis que l’entreprise adopte ces outils quand même. Vous prenez donc le même risque, mais avec moins d’informations à son sujet.
Mais le réflexe inverse est encore pire : tout approuver, ajouter un peu de surveillance et appeler ça de la « gouvernance ». Surveiller un agent ne revient pas à lui fixer des limites.
Ce qui fonctionne vraiment ressemble moins à une décision qu’à une architecture. Les contrôles du Baseline sont conçus pour se situer en dehors du modèle, car ils ne peuvent pas dépendre du respect des consignes par l’agent. C’est ce qui permet d’aborder concrètement la question de la productivité : vous ne choisissez pas le degré de confiance à accorder à l’agent, mais le niveau d’autorité nécessaire au travail, puis vous imposez cette limite à un endroit où l’agent ne peut pas la contester. En deçà de cette limite, laissez-le fonctionner.
La gradation compte aussi. Un refus qui se limite à dire « Non » incite à réessayer et à contourner les règles. En revanche, un refus qui en explique la raison et indique la marche à suivre dans le cadre établi permet d’enregistrer le composant, de demander une élévation de privilèges limitée et justifiée, d’obtenir une approbation indépendante et de réorienter l’exécution dans les limites autorisées sans y mettre fin. Entre la réorientation et l’arrêt, on peut réduire sur-le-champ l’autorité de l’exécution, le temps qu’une personne prenne une décision. Si vous optez d’emblée pour un arrêt complet, chaque anomalie entraîne une interruption de service.
Ce qui ne figure pas encore dans le document
Deux éléments manquent au Agent Baseline. Nous préférons le dire clairement plutôt que de vous laisser le découvrir.
Tout d’abord, il n’y a pas de modèle de maturité. Les contrôles indiquent à quoi ressemble une bonne pratique, mais pas ce qui constitue un « bon niveau 1 » par rapport à un « bon niveau 3 ». Chaque organisation qui lit ces lignes se trouve à un stade différent. Un test de couverture qui traite de la même façon une entreprise de série B et une banque internationale n’est utile à aucune des deux. La priorisation par cas d’usage, comme celle présentée plus haut, n’est qu’un début : le travail est loin d’être achevé.
Ensuite, la perspective par cas d’usage ne figure pas du tout dans la version 1.0. Vous l’avez découverte ici parce qu’elle est issue de conversations comme celle que nous avons eue à Black Hat. C’est un signe encourageant que le processus de révision fonctionne, et une raison de plus de reconnaître que nous aurions sans doute dû la repérer plus tôt.
Lisez-le, puis contribuez
Nous sommes convaincus que c’est un excellent point de départ. Nous savons aussi que certaines personnes encadrent et évaluent ce travail depuis plus longtemps que le Baseline n’existe, et qu’elles ont des avis tranchés ainsi que des preuves à l’appui. C’est précisément leur point de vue que nous voulons entendre, et le moment est venu : le Baseline est ouvert aux commentaires jusqu’au 30 septembre et restera open source quoi qu’il arrive.
Le Baseline est un projet ouvert aux commentaires jusqu’au 30 septembre. Les contrôles disposent d’identifiants permanents : vous pouvez les citer dans un constat d’audit, un document de politique ou une réponse à un appel d’offres, et la référence restera valide à l’avenir.
Ouvrir une issue est un moyen durable d’exprimer votre désaccord. Si un contrôle est inefficace en pratique, si nous en avons oublié un ou si sa mise en œuvre coûte plus cher que le risque qu’il réduit, c’est exactement le type de retour que cette période de révision doit recueillir. L’objectif est de créer un modèle unique, indépendant des fournisseurs, que nous puissions tous commencer à mettre en œuvre et utiliser comme référence pour mesurer nos progrès.
Découvrez l’Agent Baseline, lisez le livre blanc et commentez sur GitHub pour contribuer.
RÉSERVER UNE DÉMO EN DIRECT
Sécurisez l’adoption de l’IA à grande échelle
Evo aide les organisations à adopter l’IA en toute sécurité et à grande échelle en offrant visibilité, gouvernance et sécurité pour le développement piloté par l’IA et les applications d’IA.