10 bonnes pratiques pour sécuriser le serverless



31 mai 2019
0 minutes de lectureDans ce nouvel épisode de notre série de fiches pratiques, nous passons en revue les bonnes pratiques pour sécuriser vos déploiements serverless.
Commençons donc par notre liste de 10 bonnes pratiques pour sécuriser le serverless.
Si ce n’est pas encore fait, pensez à télécharger cette fiche pratique dès maintenant et à l’afficher : vos décisions de demain seront ainsi plus sûres !
De nombreux exemples et cas d’usage font référence à AWS Lambda, mais s’appliquent aussi largement aux autres fournisseurs cloud et serverless. Consultez le paysage CNCF pour en obtenir une liste de référence.
Commençons donc par notre liste de 10 bonnes pratiques pour sécuriser le serverless.
1. Corrigez les dépendances de vos fonctions
Les plateformes de Function as a Service (FaaS) prennent en charge la correction des dépendances du système d’exploitation, mais ne sécurisent pas les dépendances de votre application, comme celles provenant de npm, PyPI, Maven et autres. Ces bibliothèques sont tout aussi répandues et vulnérables que les dépendances du système d’exploitation. En tant que propriétaire de l’application, c’est à vous de les mettre à niveau ou de leur appliquer des correctifs lorsqu’une vulnérabilité est divulguée.
Utilisez une solution comme Snyk pour rechercher les vulnérabilités connues dans les dépendances open source de vos projets serverless. Snyk va au-delà de la génération de rapports de vulnérabilités : la solution fournit également des conseils de correction et applique automatiquement les correctifs par le biais de mises à niveau de versions.
Avec les outils Snyk, vous pouvez protéger vos fonctions tout au long du cycle de développement. Commencez dans l’environnement de développement intégré (IDE) grâce à notre plugin pour VSCode ou IntelliJ, puis intégrez l’application GitHub. Snyk peut alors créer automatiquement des pull requests pour corriger les vulnérabilités dès leur détection, ou interrompre les builds d’intégration continue (CI) afin d’éviter tout déploiement lorsqu’une nouvelle vulnérabilité est introduite.
Imposez des déploiements sécurisés pour vos fonctions
En plus de la surveillance de la CI et des dépôts de code source, ainsi que de l’application proactive de correctifs aux vulnérabilités, le processus de déploiement d’une fonction doit également faire l’objet d’un examen de sécurité. Les déploiements doivent être interrompus lorsque des vulnérabilités sont détectées dans les fonctions concernées.
Le framework Serverless est un ensemble d’outils couramment utilisé pour développer et déployer des fonctions serverless. Son architecture de plugins permet d’intégrer des workflows personnalisés au cycle de vie des fonctions. Snyk propose un plugin Serverless open source qui s’intègre parfaitement au framework.
L’image ci-dessous montre comment le plugin protège activement une fonction en empêchant son déploiement lorsqu’il détecte des vulnérabilités dans ses dépendances open source :
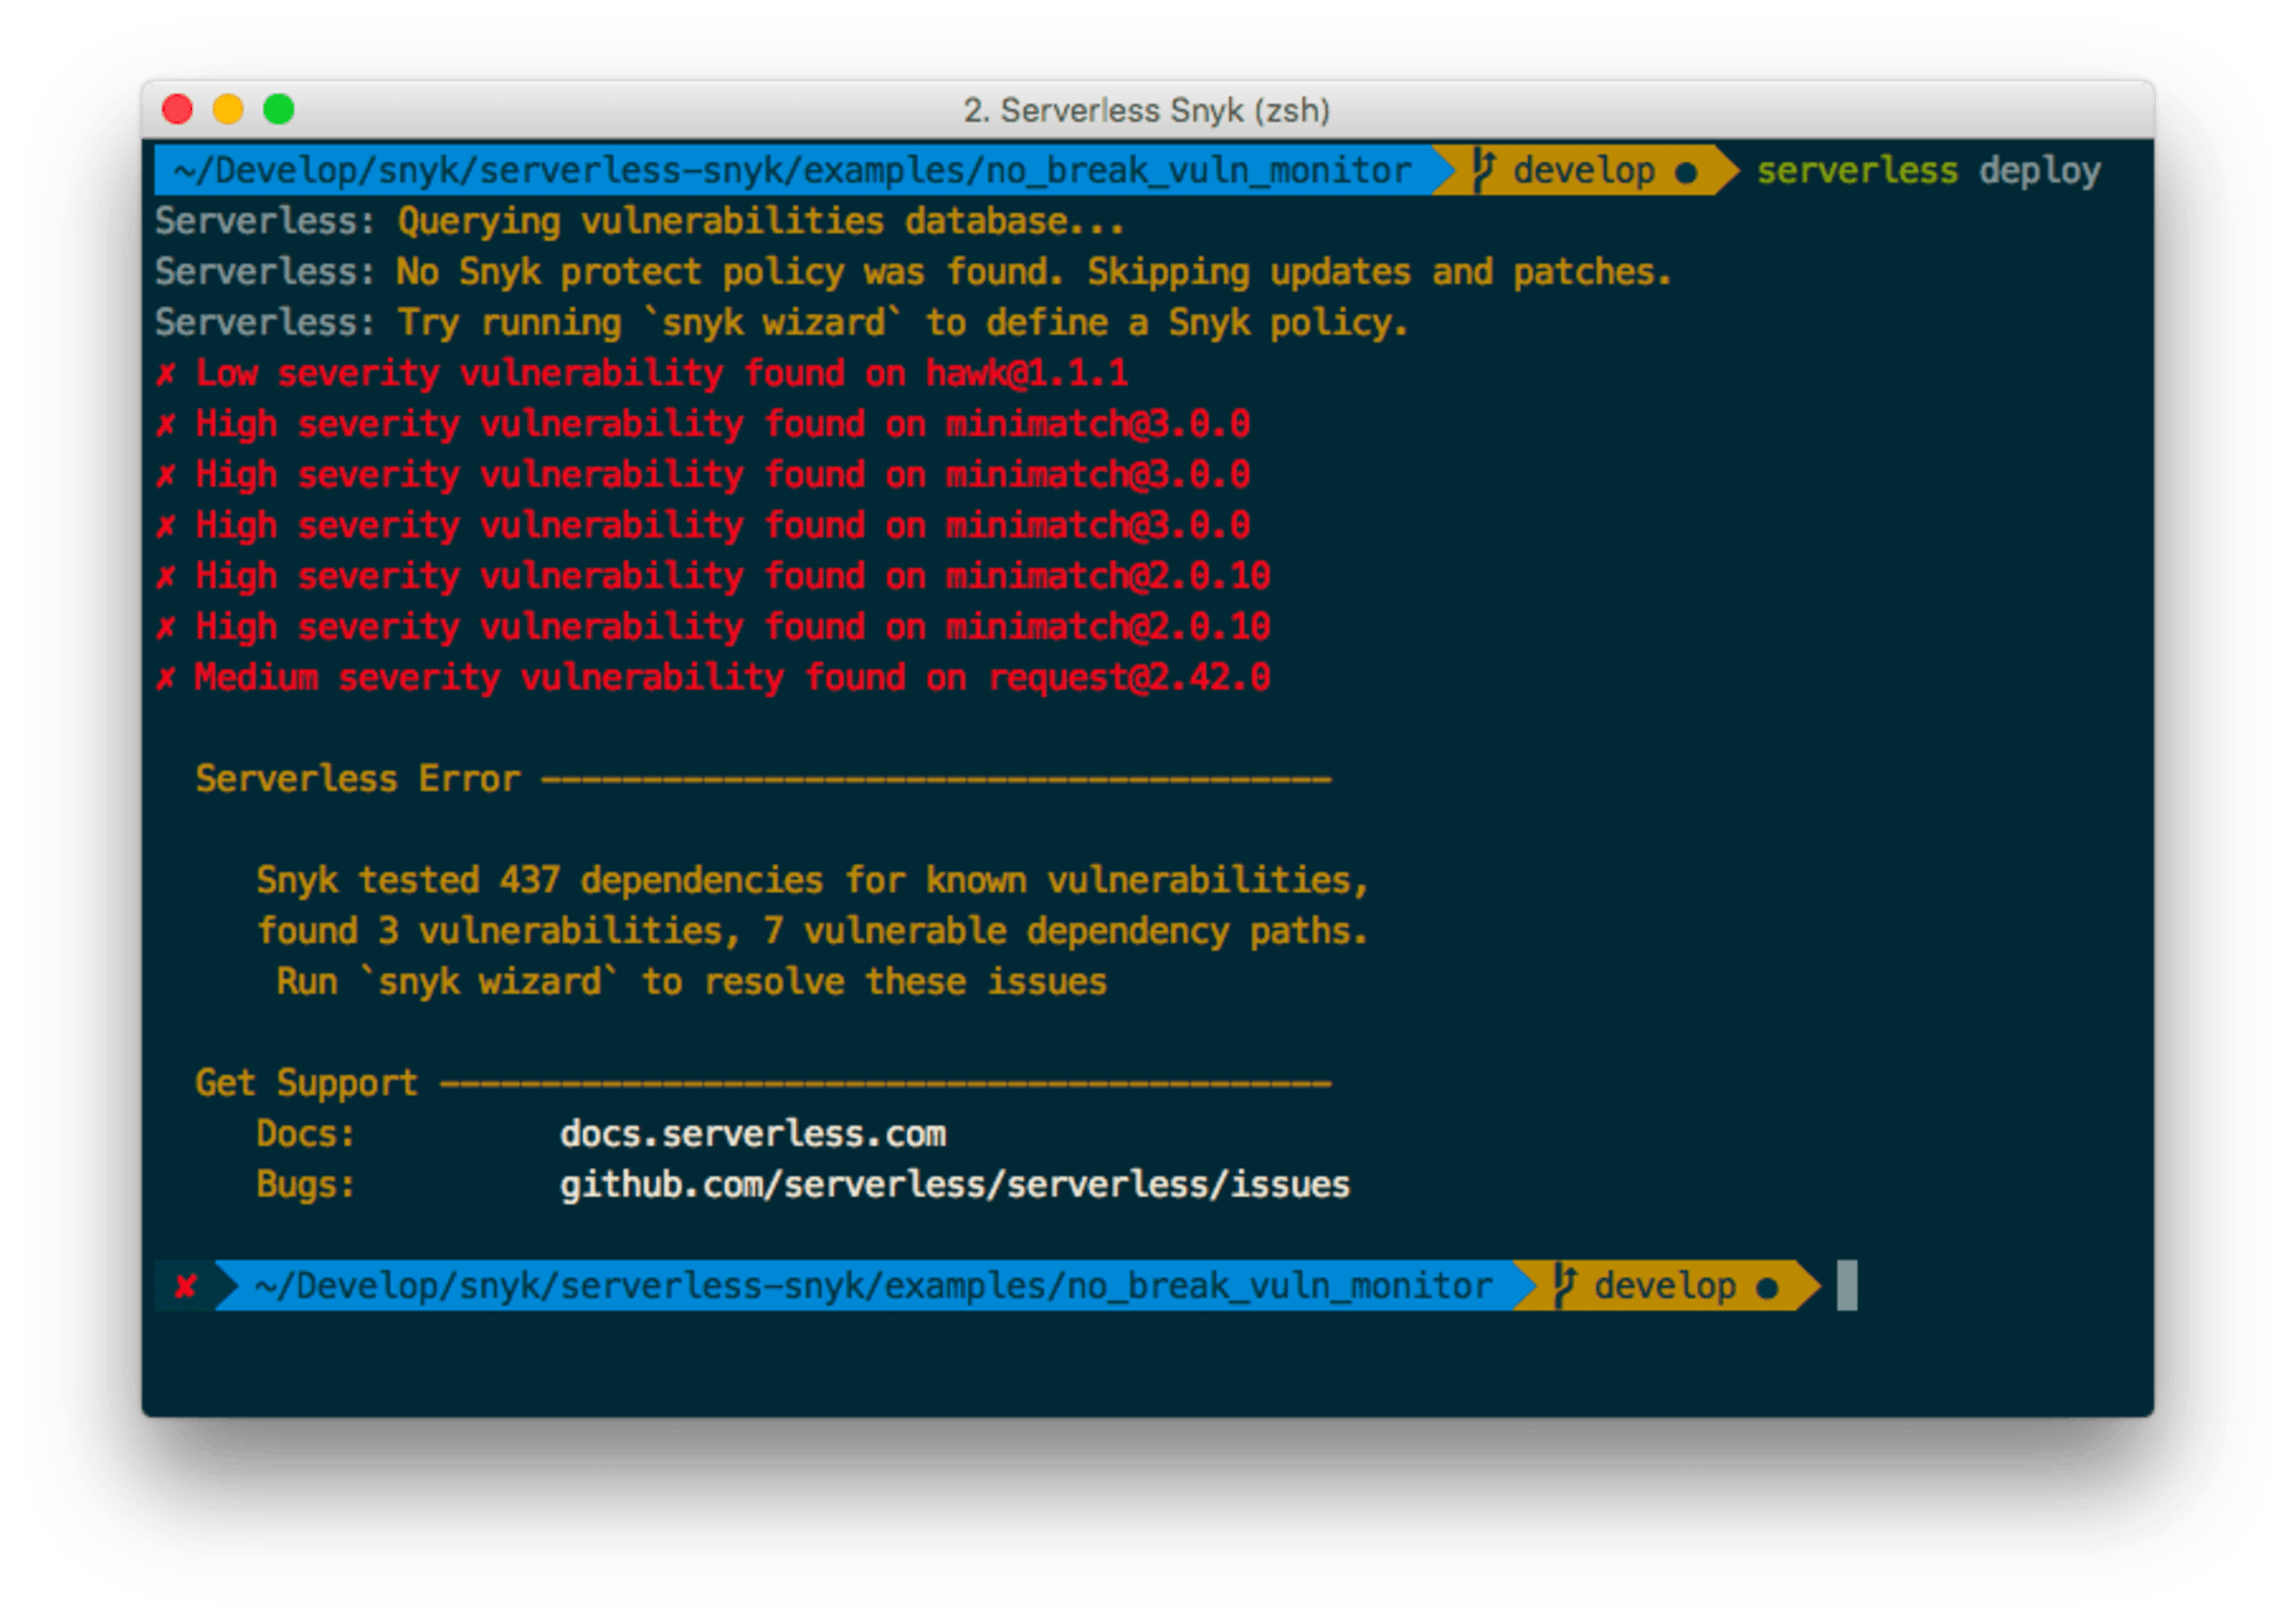
Pour en savoir plus sur la configuration du plugin Serverless de Snyk, la création d’instantanés de projets pour les workflows CI/CD et la surveillance de vos projets, configurez le plugin du framework Serverless en consultant cet article.
2. Adoptez le principe du moindre privilège
Les fonctions sont de petite taille, ce qui permet de réduire chaque ensemble d’autorisations au strict minimum : seul l’accès dont chaque fonction a besoin pour fonctionner correctement est accordé. Cela réduit considérablement les dégâts qu’une attaque réussie pourrait causer et limite la surface d’exposition de l’intégration globale de plusieurs fonctions. Par exemple, la plupart des fonctions n’ont probablement pas besoin d’accéder à la base de données ni de disposer d’autorisations pour se connecter à des serveurs externes. Pourtant, les attaquants et les utilisateurs malveillants effectuent souvent ces actions après avoir exploité une faille.
Respectez le principe du moindre privilège. Pour garantir la sécurité de votre configuration et réduire la surface d’attaque, déployez vos fonctions avec le minimum absolu d’autorisations nécessaires.
Accorder par erreur plus d’autorisations que nécessaire
Considérez la configuration serverless.yml suivante, qui définit un rôle d’autorisations unique pour toutes les fonctions déployées dans ce projet :
La configuration ci-dessus présente une erreur évidente : le rôle IAM déployé avec la fonction autorise toutes les opérations de lecture et d’écriture DynamoDB utilisées par ces fonctions. Or, certaines fonctions ont uniquement besoin de lire des données, tandis que d’autres doivent pouvoir en supprimer. Cette configuration par défaut simpliste d’un projet serverless élargit la surface d’attaque. Il serait préférable de déployer les fonctions de façon granulaire afin de définir également les autorisations en fonction des besoins.
Définissez correctement les rôles et les autorisations de chaque fonction
Le framework Serverless encourage la configuration de rôles par fonction, comme le montre l’extrait de fichier serverless.yml suivant :
À partir de la ligne 7, deux fonctions sont déclarées : func0 et func1. Chacune possède son propre rôle, défini par la directive role aux lignes 9 et 12.
Des définitions de rôles différentes permettent de définir des autorisations beaucoup plus granulaires, en accordant à chaque fonction uniquement les accès dont elle a besoin. Par exemple, une fonction peut disposer de capacités de journalisation liées à AWS, tandis qu’une autre peut accéder à un compartiment Amazon S3.
3. Isolez le périmètre de chaque fonction
Même si plusieurs fonctions peuvent être déployées pour constituer un workflow complet, chacune doit être considérée comme un périmètre distinct. Ainsi, une vulnérabilité dans une fonction ne pourra pas s’étendre aux autres et les compromettre.
Prenons le scénario suivant :
La fonction subscribeToEmailNotification assainit les données saisies, puis la fonction sendNotification est déclenchée pour les traiter et les transmettre. Après avoir assaini les données dans la fonction « subscribe », vous pourriez être tenté de ne pas assainir celles reçues par la seconde fonction. Mais si une nouvelle fonction subscribeToSMSNotification est créée ultérieurement sans assainir les données saisies, la fonction sendNotification pourra alors traiter des données d’événement non assainies.
Suivez ces recommandations pour maintenir chaque fonction dans son propre périmètre :
Ne vous fiez pas à l’ordre d’accès et d’invocation des fonctions : ne partez pas du principe qu’une fonction ne sera appelée que par une autre ou qu’elle ne sera pas accessible via une passerelle d’API. L’ordre d’appel et les modalités d’accès aux fonctions peuvent évoluer.
Chaque fonction constitue son propre périmètre de sécurité : chaque fonction doit considérer toute donnée d’événement reçue comme une source non fiable et toujours assainir les données en entrée.
Utilisez des bibliothèques de sécurité : consacrez du temps à créer ou à adopter des bibliothèques de sécurité standardisées, et imposez leur utilisation dans toutes vos fonctions.
4. Assainissez les données d’événement pour éviter les injections
Les architectures serverless nécessitent souvent différents types d’ingestion de données pour les fonctions cloud : synchrones, asynchrones ou en flux. Ces données peuvent toutes contenir des informations contrôlées par les utilisateurs et circuler entre différents magasins de données et différentes fonctions.
Même protégées par des passerelles d’API, des pare-feu et d’autres proxys, les fonctions utilisées dans des services d’API traitent les données saisies par les utilisateurs comme le ferait un serveur d’API traditionnel. De plus, les fonctions qui traitent les données d’événement issues de files de messages et d’autres canaux de communication privés peuvent également traiter indirectement des données saisies par les utilisateurs. Toutefois, le contexte et la source de ces données deviennent flous et plus difficiles à prévoir.
Les architectures serverless sont essentiellement pilotées par les événements. L’injection d’événements constitue donc un vecteur d’attaque important : les fonctions étant conçues pour traiter de petites tâches, comme les données d’une file d’événements, des données malveillantes peuvent atteindre la charge utile d’un événement si elles contournent une fonction d’assainissement. Si la fonction de traitement ne valide pas correctement les données, elle risque alors d’être vulnérable aux attaques par injection.
Voici quelques exemples de sources de données moins traditionnelles qui déclenchent souvent des fonctions et auxquelles celles-ci ne doivent donc pas faire confiance :
Stockage — les noms de fichiers ou de répertoires dans le stockage cloud, comme les compartiments S3, peuvent être contrôlés par les utilisateurs et transmettre des données malveillantes aux interpréteurs.
Messagerie — les charges utiles des événements transmis de manière asynchrone par des services comme SNS et SQS doivent être assainies et considérées comme non fiables.
Flux de base de données — les modifications apportées à une base de données, comme l’ajout ou la suppression d’un enregistrement, peuvent déclencher des fonctions. Tout événement de ce type peut provenir de données saisies par un utilisateur et doit donc être assaini.
Pour réduire les risques d’injection d’événements, appliquez les bonnes pratiques suivantes à toutes les données saisies par les utilisateurs et traitées par vos fonctions :
Validez les données à l’aide de schémas et d’objets de transfert de données. Vérifiez le type, la longueur et la plage de valeurs attendus, au lieu de sérialiser et désérialiser aveuglément des objets de données et de les transmettre tels quels.
Utilisez toujours un ORM et veillez à appliquer un échappement approprié lors de l’utilisation de bases de données SQL ou non-SQL afin d’éviter les injections.
Évitez de lancer des processus système ou d’évaluer du code dynamique à l’exécution à partir de données provenant d’événements, car celles-ci peuvent être issues de données saisies par un utilisateur. Soyez également attentif aux services tiers intégrés à vos fonctions, car vous avez peu de contrôle ou de visibilité sur leurs sources de données et sur la part de données contrôlées par les utilisateurs. Lorsque vous lancez des processus ou exécutez du code dynamique, appliquez des contre-mesures adaptées, comme l’encodage et le sandboxing.
5. Utilisez les passerelles d’API comme tampon de sécurité
Les fonctions cloud déployées sont souvent exposées et donc accessibles via un point de terminaison HTTP généré aléatoirement, qui peut transmettre des événements, des données et le contexte approprié pour traiter la charge utile. Pour exposer des fonctions, il est recommandé de passer par des passerelles d’API, qui agissent comme des proxys inverses et créent une couche de séparation entre les utilisateurs et les fonctions.
En tant qu’interfaces d’API destinées aux consommateurs, les passerelles d’API peuvent, avec une configuration minimale, fournir plusieurs mécanismes de sécurité qui contribuent à réduire la surface d’attaque des fonctions.
La passerelle d’API comme filtre
Avant d’exposer vos fonctions, utilisez une passerelle d’API comme filtre pour limiter les données qui leur sont transmises, en fonction d’une stratégie de passerelle. Plus cette stratégie est stricte, moins les fonctions risquent d’être exposées à des menaces. AWS API Gateway recommande de déclarer des mappages de requêtes et de réponses conformes à des schémas. Cette approche s’apparente aux objets de transfert de données : dans le cas des fonctions et des passerelles, le mappage peut imposer des règles strictes aux requêtes entrantes.
Voici un exemple de schéma défini au niveau de la passerelle d’API pour une requête JSON entrante :
La passerelle d’API comme point de contrôle de l’authentification
Le contrôle des requêtes HTTP avant qu’elles n’atteignent vos fonctions cloud est essentiel pour gérer l’accès des utilisateurs aux applications, notamment l’authentification et l’autorisation. Configurez une passerelle d’API et laissez au fournisseur cloud et à son infrastructure les aspects liés aux fonctions.
Une fois les utilisateurs authentifiés par la passerelle d’API, vous pouvez appliquer des contre-mesures, comme la limitation du débit et des quotas, directement sur la passerelle, sans déclencher d’invocation de fonction.
La passerelle d’API pour atténuer les attaques DDoS
Une passerelle d’API protège contre les attaques par déni de service (DoS) au niveau du fournisseur cloud et vous permet de limiter le débit de toutes les requêtes dirigées vers vos fonctions. La limitation du débit n’incombe donc plus à vos fonctions ni à votre logique métier, comme il se doit : elle est entièrement gérée par l’infrastructure cloud. L’utilisation d’une passerelle d’API vous aide à éviter l’épuisement des ressources financières.
6. Surveillez et journalisez vos fonctions
Les fonctions ont une durée de vie extrêmement courte. À mesure que vous en déployez davantage et que leur nombre d’invocations augmente, il devient facile de perdre le fil des événements et de ne plus savoir d’où viennent les erreurs. Avec l’adoption croissante du serverless dans une organisation, la surveillance des flux non sécurisés et des tentatives malveillantes visant à pousser une fonction vers un chemin d’exécution dangereux se complique.
AWS a récemment introduit la possibilité d’ajouter des balises aux fonctions Lambda afin de les suivre et de les regrouper facilement. Avec le framework Serverless, vous pouvez ajouter des balises aux fonctions dans leurs fichiers YAML, soit de manière globale (pour toutes les fonctions du fichier serverless.yml), soit individuellement.
Surveiller les fonctions pour détecter les vulnérabilités de sécurité
Snyk s’intègre à votre fournisseur FaaS pour surveiller les fonctions déployées et veiller à leur sécurité. Vous pouvez ainsi corriger les vulnérabilités de sécurité connues tout au long du cycle de développement logiciel, en ce qui concerne les fonctions et leur utilisation de dépendances open source.
L’image ci-dessous présente le projet GitHub lirantal/bazz-serverless après analyse, avec plusieurs vulnérabilités critiques, moyennes et faibles. Il s’agit du code source de mon projet serverless, qui déploie plusieurs fonctions. Sous le dépôt du projet GitHub, vous pouvez voir les six fonctions AWS Lambda que j’ai déployées. Ce sont les fonctions réellement déployées et exécutées par AWS.
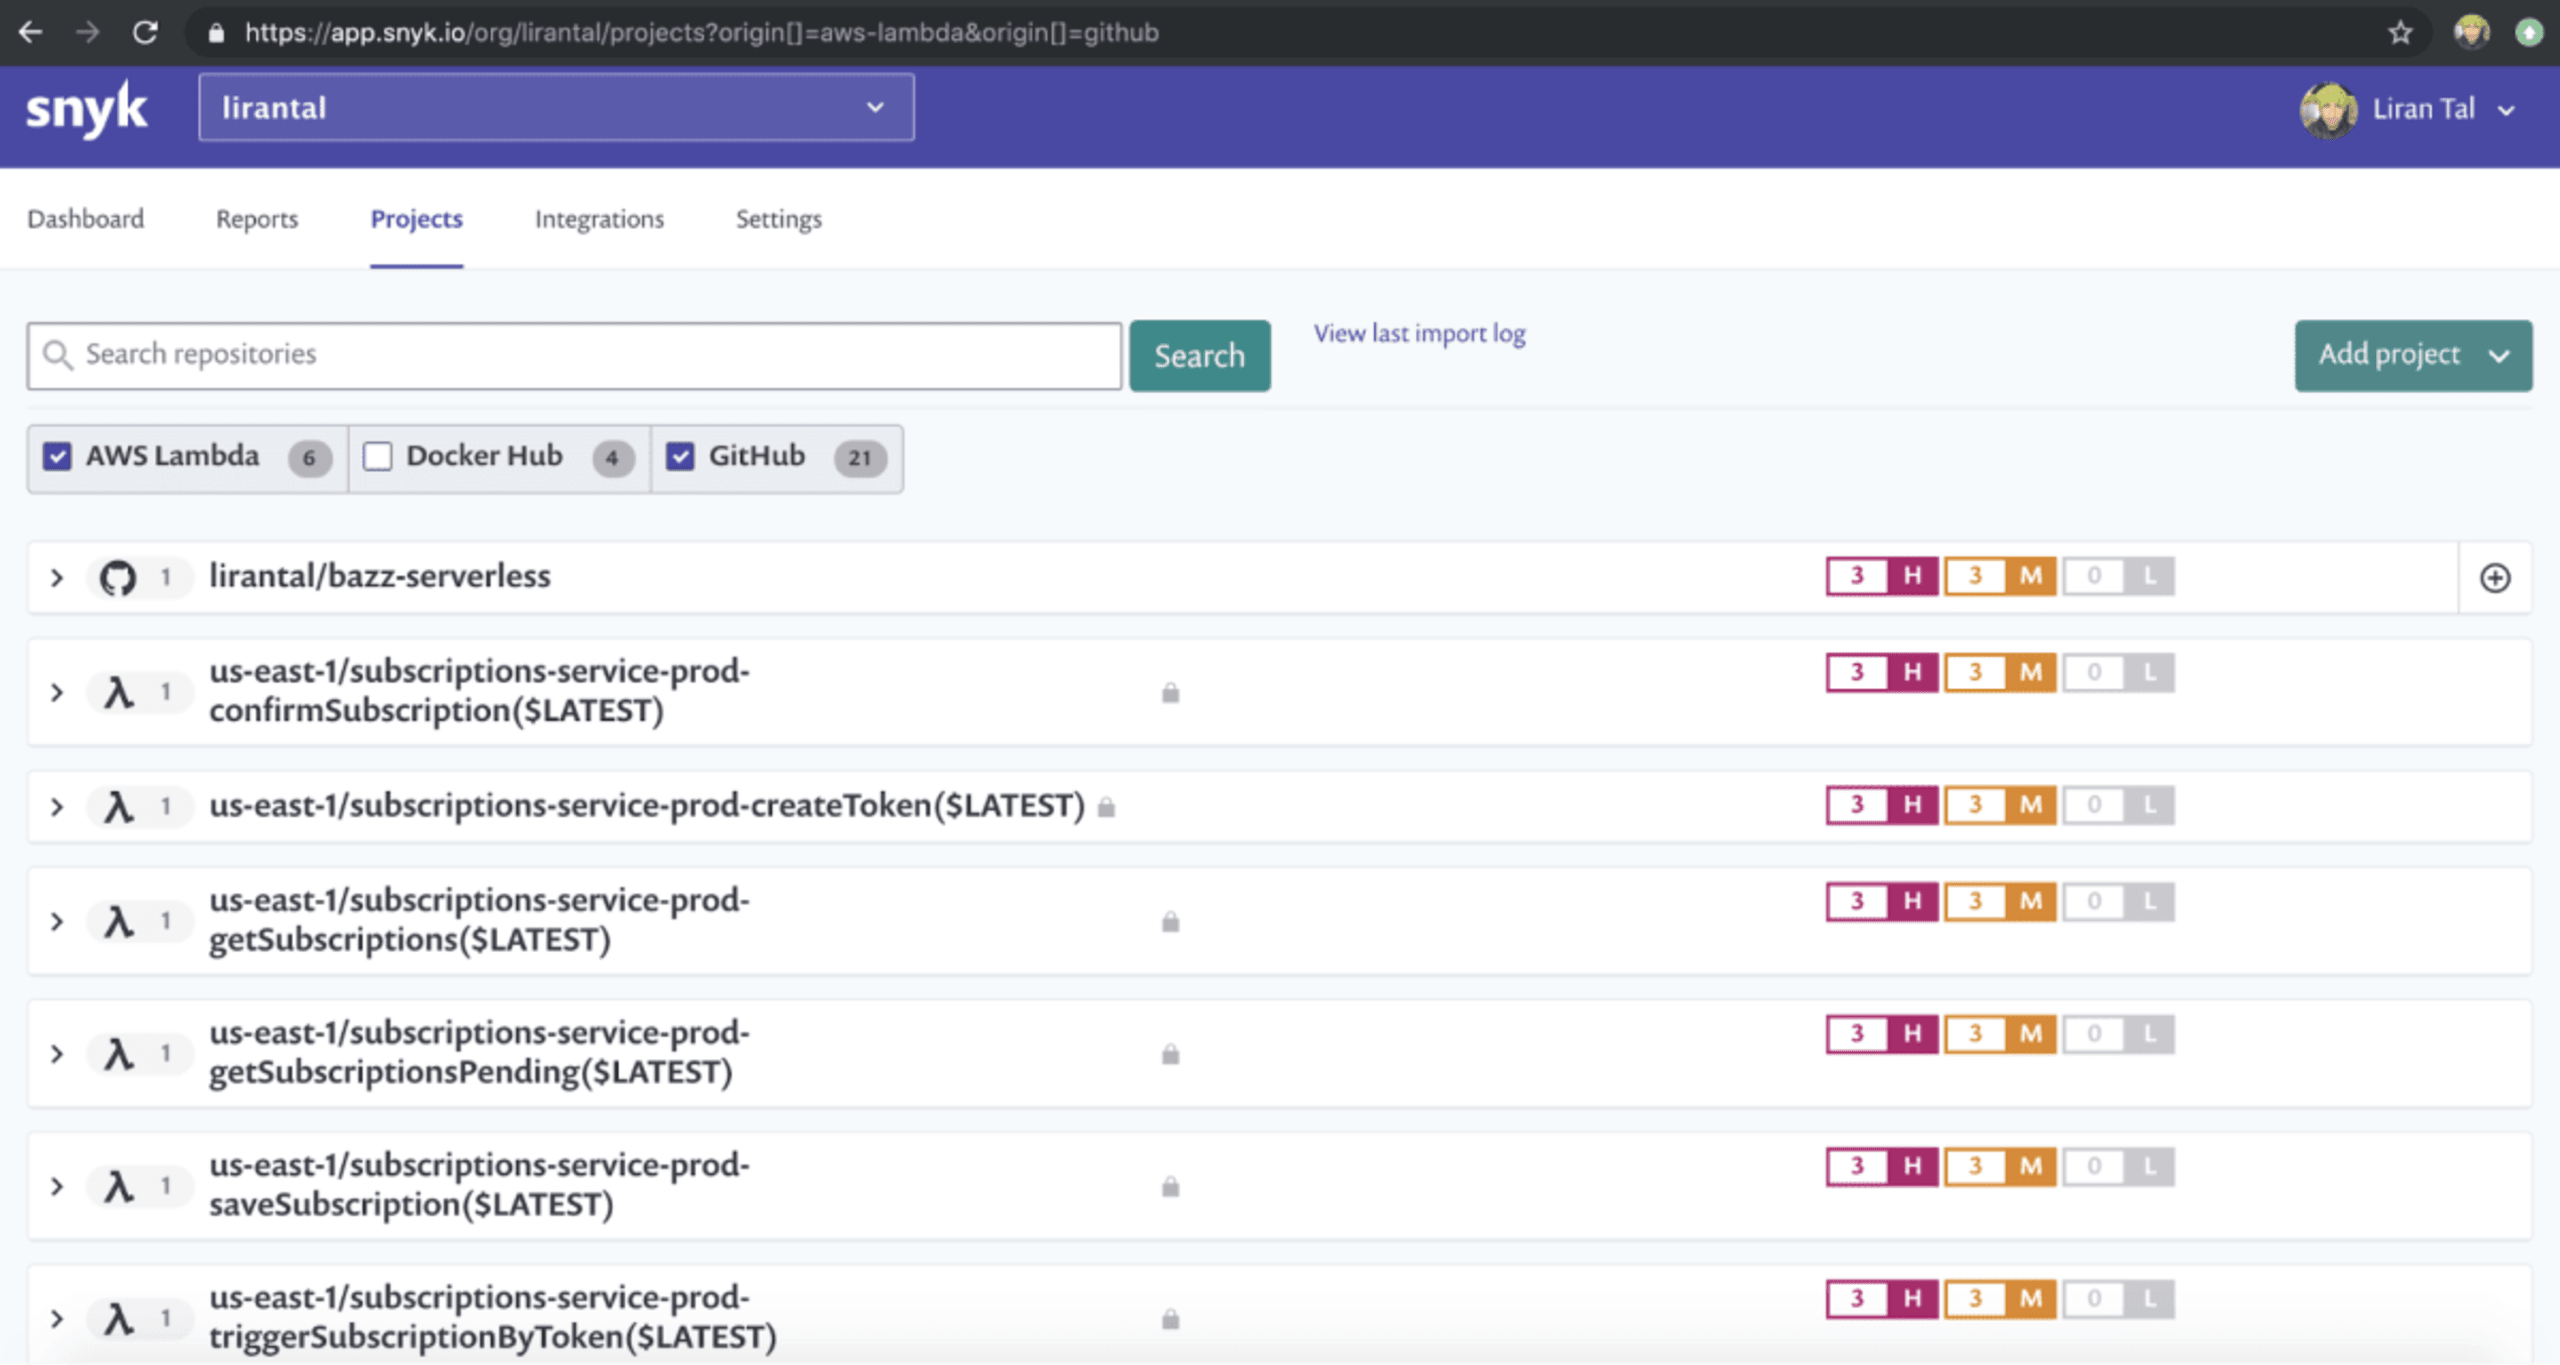
Snyk a analysé chacune de ces fonctions pour détecter les vulnérabilités de sécurité connues. Comme elles utilisent toutes le même arbre de dépendances, nous constatons qu’elles sont toutes déployées avec des versions de bibliothèques vulnérables.
Les fournisseurs de services cloud proposent souvent des outils de surveillance intégrés pour les applications et les ressources de fonctions, qui permettent d’obtenir ces informations. Microsoft propose Azure Monitoring et Amazon, AWS X-Ray. Par exemple, la console X-Ray d’AWS donne des informations sur le flux des données entre les fonctions et les autres ressources cloud, ainsi que des métriques comme leur durée d’exécution.
7. Respecter les conventions de codage sécurisé dans le code applicatif
L’un des grands avantages d’une infrastructure serverless est que la responsabilité du système d’exploitation sous-jacent passe du propriétaire de l’application au fournisseur cloud, chargé de le maintenir et de le mettre à jour avec les correctifs de sécurité. Cela signifie toutefois que les attaquants vont se concentrer sur les zones toujours exposées, au premier rang desquelles figure le code de l’application.
Le code applicatif reste vulnérable. Les développeurs doivent donc respecter les conventions de codage sécurisé et veiller à leur application, notamment lors des revues de code, afin de détecter les problèmes de sécurité au plus tôt dans le processus de développement logiciel. Imposer l’utilisation de bibliothèques de sécurité communes aux équipes de développement contribue à garantir le respect de ces recommandations et évite aux développeurs de réinventer la roue, au risque de commettre des erreurs dans des domaines pour lesquels il existe déjà des solutions standardisées.
L’OWASP Top 10 constitue une bonne référence pour les aspects du code applicatif qui méritent une attention particulière en matière de sécurité. En voici quelques-uns :
Les attaques par injection, qui se produisent lorsque les données ne sont pas filtrées ou encodées dans le contexte approprié et sont alors interprétées comme faisant partie d’une exécution de confiance. Cela concerne notamment les injections SQL, l’exécution de commandes système et l’exécution de code CSS et JavaScript. Pour éviter toute injection malveillante, quel que soit le contexte, bloquez autant que possible les entrées utilisateur, privilégiez une liste d’autorisation sûre et encodez toutes les données fournies par l’utilisateur dans le contexte approprié.
L’exposition de données sensibles, lorsque des attaquants exploitent un moyen de communication non sécurisé pour exfiltrer des informations sensibles ou recourent à des algorithmes cryptographiques non sécurisés dans des contextes sensibles. Pour réduire ces risques, utilisez TLS comme moyen de communication sécurisé et chiffrez ou hachez toujours les mots de passe et autres identifiants à l’aide d’algorithmes cryptographiques robustes.
Les contrôles d’accès défaillants permettent aux attaquants d’accéder à des ressources qui devraient leur être interdites. Pour atténuer ce problème, mettez en place des mécanismes de contrôle d’accès appropriés, par exemple en refusant l’accès par défaut et en appliquant un modèle d’autorisation restrictif. Lorsque c’est pertinent, imposez une limitation du débit afin de réduire les tentatives de force brute et les abus de service.
Remarque : consultez le guide OWASP Top 10 2017 pour obtenir la liste complète.
8. Sécuriser et vérifier les données en transit
Comme le montrent les données de httparchive sur l’utilisation de HTTPS, l’adoption de moyens de communication web sécurisés progresse à mesure que les bonnes pratiques se généralisent : le service indique que HTTPS représente 77 % de l’ensemble du trafic surveillé. Les fonctions et les services auxquels elles s’intègrent, qu’ils soient tiers ou situés dans le périmètre cloud, ne font pas exception : toutes les communications doivent utiliser un moyen sécurisé.
Suivez ces recommandations pour sécuriser vos communications et les données en transit :
Utilisez HTTPS pour sécuriser les communications, aussi bien au sein de votre périmètre interne entre les fonctions ou services appelés qu’avec les services fournis par le cloud et les services tiers hébergés en dehors de l’infrastructure du fournisseur cloud.
Vérifiez les certificats SSL pour confirmer l’identité de votre interlocuteur et interrompez toute communication si l’identité et l’authenticité du serveur ne correspondent pas au certificat.
Activez les requêtes signées chez les fournisseurs cloud qui les prennent en charge.
Considérez les réponses des services tiers comme des entrées utilisateur non fiables et assainissez-les.
Sécuriser les communications entre services dans le cloud
Dans la mesure du possible, les services et les ressources accessibles au sein de l’infrastructure du fournisseur cloud doivent communiquer via un moyen sécurisé. Par exemple, lorsqu’une fonction AWS Lambda s’intègre à SNS, elle doit opter pour une communication via SSL :
Requêtes signées
Lorsque vous utilisez des outils de fournisseurs cloud comme AWS SDK et AWS CLI pour créer des requêtes HTTP, ceux-ci ajoutent automatiquement une signature à l’en-tête HTTP ou aux paramètres de requête. Cette signature indique l’identité associée à la requête HTTP et contribue ainsi à mieux protéger les données en transit et à prévenir les attaques par rejeu HTTP.
Par exemple, dans le cas d’une requête signée AWS, la signature est ajoutée au message HTTP sous la forme d’un en-tête Authorization :
9. Stocker les secrets dans un espace de stockage sécurisé
Stockez vos secrets et vos identifiants sensibles dans un espace de stockage sécurisé pris en charge par les grands fournisseurs cloud et FaaS. Vous pouvez également déployer vos propres solutions, comme Vault de HashiCorp. Le stockage des clés dans un espace dédié réduit les risques liés à leur présence dans des fichiers statiques d’un dépôt de code source ou dans des variables d’environnement, et diminue considérablement la probabilité d’exposition d’informations sensibles.
L’exemple suivant utilise AWS Simple Systems Manager, conçu pour récupérer des secrets chiffrés de manière sécurisée avec AWS Parameter Store. Dans notre exemple, la variable SSM permet d’accéder à une valeur spécifique créée au préalable et de la rendre accessible à une fonction via une variable d’environnement :
Notez que ${ssm:/github/api-key} renvoie la valeur chiffrée de cette clé. Pour la déchiffrer et obtenir sa valeur réelle, il faut spécifier ${ssm:/github/api-key~true}.
Pour en savoir plus sur Parameter Store et KMS, consultez la documentation d’Amazon : https://docs.aws.amazon.com/kms/latest/developerguide/services-parameter-store.html
Pour renforcer la sécurité et la flexibilité de la gestion des secrets dans les applications, envisagez d’accéder aux secrets et aux autres informations de configuration au moment de l’exécution, plutôt que d’utiliser des variables d’environnement qui nécessitent le redémarrage d’un processus pour appliquer une nouvelle configuration.
Le stockage des secrets réduit les risques de fuite de clé, mais ne les élimine pas complètement. Heureusement, si vous stockez les secrets utilisés par votre fonction, peu importe la valeur réelle de la clé… vous pouvez donc la renouveler régulièrement ! Ainsi, si elle est divulguée ou volée, elle ne pourra être exploitée que pendant une courte période.
10. Déployer des fonctions avec une granularité minimale
Par principe, les fonctions sont censées être petites, tout comme le code qu’elles déploient. Cela réduit la surface d’attaque et la quantité d’informations susceptibles d’être divulguées en cas de compromission. Il est déconseillé de déployer des fonctions en masse ou de déployer inutilement plus de code et de fonctions que nécessaire.
Par défaut, les fonctions d’un même projet serverless partagent les mêmes dépendances. Par exemple, les projets serverless Node.js utilisent un seul fichier package.json contenant les dépendances déployées avec chaque fonction, même si elles ne sont pas toutes explicitement requises par chacune d’entre elles.
Comme vous réutiliserez probablement beaucoup de code standard, les modèles peuvent vous être utiles pour générer la structure de vos projets, par exemple :
Téléchargez la fiche de bonnes pratiques de sécurité serverless pour vous y référer facilement. Créez également un compte Snyk gratuit pour commencer dès aujourd’hui à sécuriser votre code !
Lancez-vous dans les compétitions Capture The Flag
Apprenez à résoudre des défis Capture The Flag en regardant à la demande notre atelier virtuel d’initiation.