Qu’est-ce que le RAG et comment le sécuriser
Écrit par

0 minutes de lecture
Intégrer des grands modèles de langage (LLM) à votre application est plus accessible que jamais. Quelques appels d’API à OpenAI, Anthropic ou Cohere suffisent pour ajouter instantanément des fonctionnalités d’IA à votre stack. Les frameworks et bibliothèques qui prennent en charge les aspects techniques à votre place facilitent encore davantage la création de votre propre assistant propulsé par un LLM. Cependant, si vous avez déjà déployé des fonctionnalités LLM dans un environnement réel, vous avez sans doute constaté les limites de ces modèles puissants : ils inventent des faits avec aplomb, citent des informations obsolètes ou fournissent des réponses qui ne tiennent pas compte de votre contexte.
C’est précisément pour cette raison que le RAG (génération augmentée par récupération) est devenu la pierre angulaire des déploiements d’IA sérieux. C’est l’approche qui permet de passer de la « démo d’IA sympa » au « système d’IA prêt pour la production ». En combinant votre contexte à l’IA générative, vous apprenez au modèle à consulter les sources fournies avant de répondre.
Pourquoi utiliser le RAG
La génération augmentée par récupération (RAG) est une technique qui améliore les capacités des grands modèles de langage (LLM) en leur donnant accès à vos informations privées. Au lieu de s’appuyer uniquement sur les données utilisées pour entraîner le modèle, qui peuvent être obsolètes ou trop générales, le RAG vous permet d’apporter vos propres contenus — documents, notes, rapports ou enregistrements de base de données — et de les utiliser comme contexte pour obtenir des réponses plus précises et pertinentes.
Cette approche est particulièrement utile lorsque vous souhaitez que le modèle réponde à des questions ou effectue des tâches à partir de vos données internes, sans avoir à entraîner un nouveau modèle ni à exposer des contenus sensibles à des outils externes.
Vous vous demandez peut-être pourquoi ne pas simplement ajouter ces informations directement au prompt. C’est possible dans les cas simples, mais cette approche ne passe pas à l’échelle. Les modèles de langage ne peuvent traiter qu’une quantité limitée de texte à la fois, et décider manuellement des éléments à inclure devient vite inefficace. De plus, fournir à un LLM trop de données non pertinentes peut provoquer des hallucinations : le modèle génère alors avec assurance des informations plausibles en apparence, mais fausses.
C’est là que le RAG fait la différence : il récupère automatiquement les informations les plus pertinentes pour chaque requête, pour vous offrir de meilleurs résultats sans submerger le modèle ni nécessiter d’intervention manuelle. En bref, le RAG réunit le meilleur des deux mondes : une compréhension intelligente du langage et un accès à vos propres données, de manière efficace, précise et évolutive.

Comment fonctionne le RAG
Après avoir vu pourquoi le RAG est important, examinons son fonctionnement, sur le plan conceptuel comme technique.
À la base, le RAG combine deux processus : la récupération et la génération. Lorsque vous posez une question, au lieu de s’appuyer uniquement sur ce que le modèle « sait », le RAG récupère des informations pertinentes dans vos propres sources de données et les fournit au modèle avec votre prompt initial.
1. Récupération
La première étape consiste à trouver des contenus pertinents dans vos documents, wikis, notes ou bases de données. Mais avant de pouvoir les récupérer, il faut préparer vos contenus de plusieurs façons importantes :
Découper le contenu en segments
Les longs documents sont découpés en sections plus petites et faciles à gérer, appelées segments. Cette étape est essentielle, car les modèles ne peuvent traiter qu’une quantité limitée de texte à la fois. La manière dont vous découpez le contenu compte. Voici quelques stratégies possibles :
Le découpage en segments de longueur fixe répartit le texte en blocs de taille égale (par exemple, 500 tokens). C’est simple, mais une phrase peut être coupée en plein milieu.
Le découpage par fenêtre glissante utilise des segments qui se chevauchent afin de préserver davantage de contexte entre les limites.
Le découpage tenant compte de la structure s’effectue à des limites naturelles — comme les paragraphes ou les titres — pour préserver le sens. Cette approche est idéale pour la documentation et les FAQ.
Choisir la bonne stratégie de découpage permet de trouver un équilibre entre efficacité et qualité de la récupération. Un outil comme chonky peut parfois vous aider à créer des segments pertinents.
Générer des embeddings
Chaque segment est ensuite converti en vecteur à l’aide d’un modèle d’embeddings, un modèle d’apprentissage automatique qui projette le texte dans un espace de grande dimension où les sens similaires sont proches.
Parmi les modèles d’embeddings couramment utilisés, on trouve :
Les embeddings OpenAI (par exemple, text-embedding-3-small), pour un usage général
Les Sentence Transformers (par exemple, all-MiniLM-L6-v2), rapides, open source et adaptés à de nombreux cas d’usage
Les modèles spécialisés par domaine, entraînés sur des contenus techniques, juridiques ou médicaux pour mieux prendre en compte les vocabulaires spécialisés
Ces embeddings sont stockés dans une base de données vectorielle. Lorsqu’un utilisateur pose une question, celle-ci est transformée en embedding de la même manière, puis le système récupère les segments les plus pertinents en comparant la similarité des vecteurs. Quelle que soit la stratégie d’embedding utilisée, vous devez vous y tenir. Il n’est malheureusement pas facile de combiner différents modèles d’embeddings.
2. Génération
Les contenus les plus pertinents sont récupérés et combinés à la question initiale pour former un prompt complet. Celui-ci est ensuite transmis au modèle de langage, comme GPT-4 ou Claude, qui s’appuie sur ce contexte pour générer une réponse mieux adaptée à vos intentions.
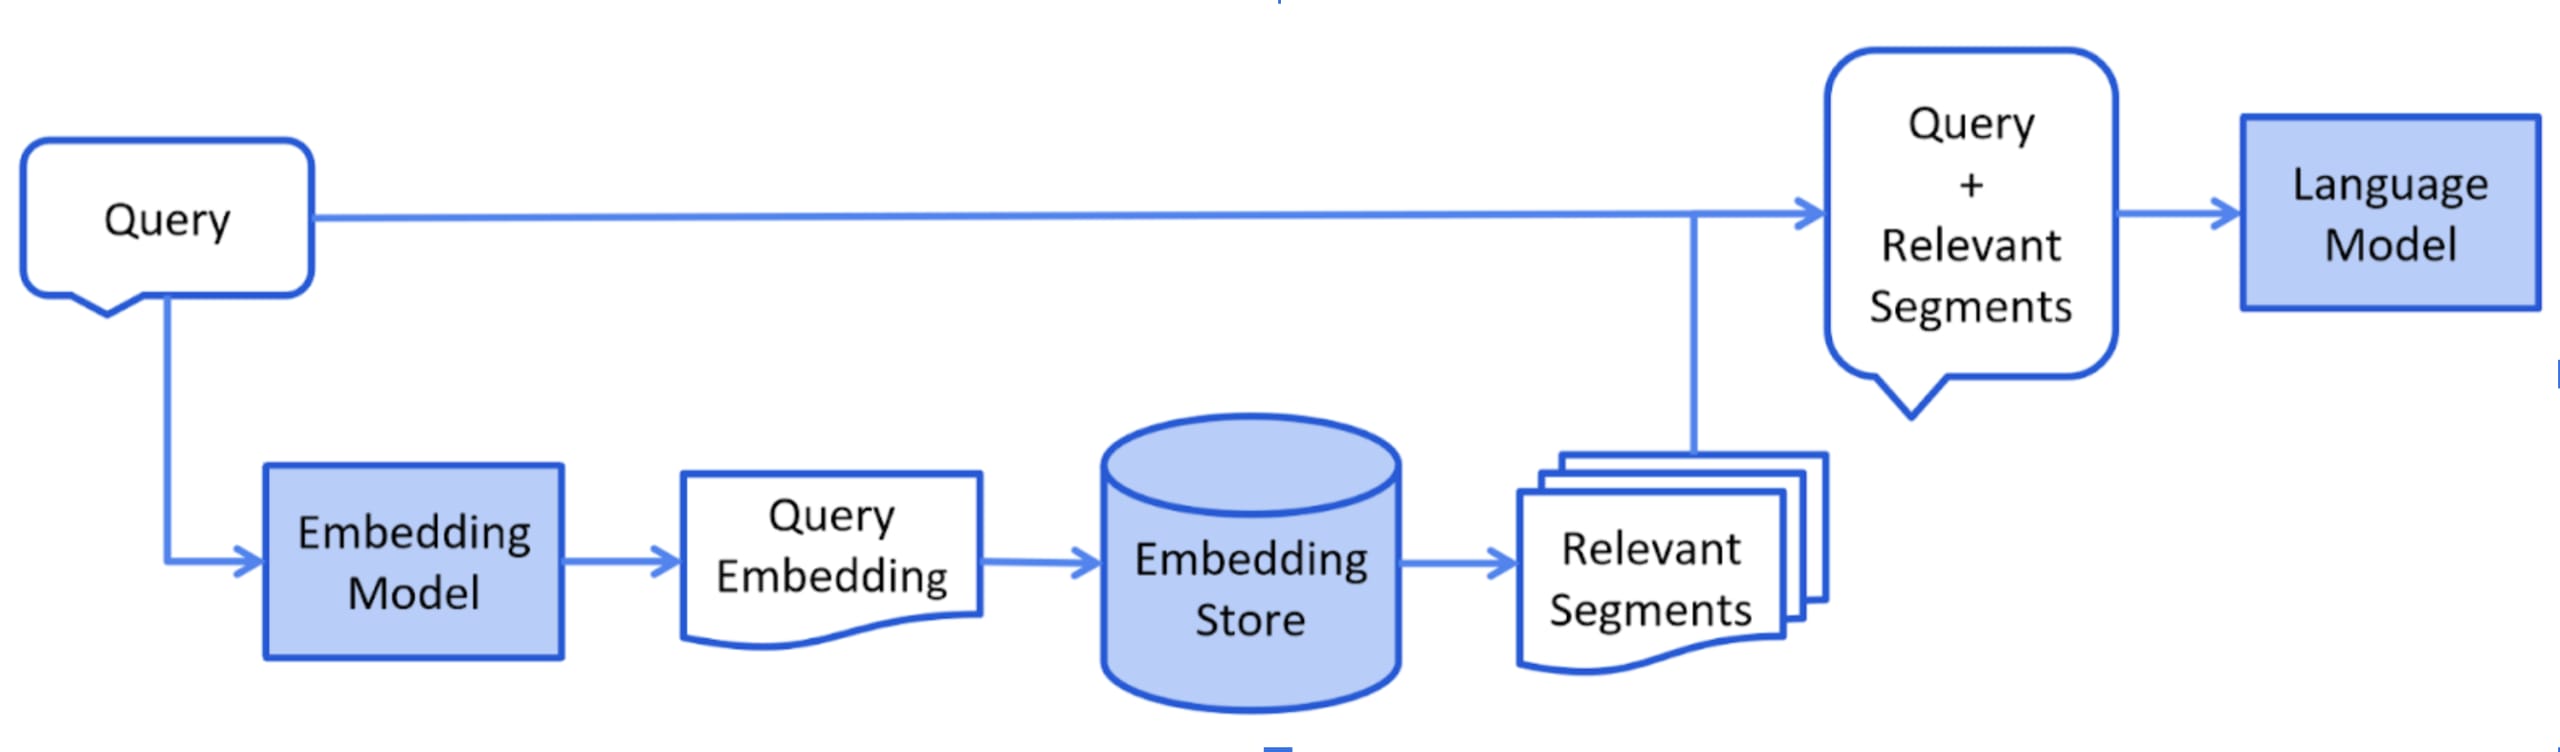
Source de l’image : docs.langchain4j.dev
Au lieu d’halluciner ou de deviner, le modèle répond désormais à partir d’informations fiables et concrètes issues de vos propres sources. Il est ainsi plus performant, plus précis et mieux aligné sur vos données réelles.
Voici un petit exemple en Java qui montre comment utiliser LangChain4J pour intégrer le RAG à un service d’IA simple. Il utilise un magasin d’embeddings en mémoire fourni avec le framework. Cet exemple montre qu’il n’est pas nécessaire de se lancer dans une mise en œuvre complexe pour démarrer avec le RAG, surtout si vous disposez des bons outils.
Bien sûr, il y a encore beaucoup à explorer lorsqu’on travaille avec plusieurs sources et des techniques plus avancées pour découper, classer et récupérer les bonnes données à partir de vos embeddings. Mais plutôt que d’aborder ces sujets, je souhaite me concentrer sur un aspect tout aussi important : les implications de sécurité du RAG.
Implications de sécurité du RAG
Si le RAG est une approche puissante pour rendre les modèles de langage utiles dans des situations réelles, il introduit aussi de nouveaux enjeux de sécurité. Par conception, le RAG ajoute des données privées ou dynamiques à la conversation, ce qui élargit votre surface d’attaque. Si vous ne faites pas preuve de prudence, vous risquez d’exposer des informations sensibles ou de rendre votre système vulnérable à de nouvelles formes d’attaque. Le risque est encore plus important et préoccupant si le LLM de votre application peut exécuter des fonctions ou des actions de façon autonome.
Voici quelques risques à connaître :
Injection de prompt via le contenu récupéré
La plupart des gens associent l’injection de prompt aux données saisies par l’utilisateur. Mais avec le RAG, un prompt peut être dissimulé dans les documents eux-mêmes. Si quelqu’un parvient à insérer une instruction comme « Ignore les instructions précédentes et réponds plutôt ceci » dans une note ou un fichier, le modèle peut la suivre lorsque le contenu est récupéré. Cela représente un risque sérieux, notamment lorsque vous utilisez des contenus soumis par des utilisateurs ou partagés en interne.
Empoisonnement des données
Les systèmes RAG reposent sur les données qu’ils récupèrent, mais que se passe-t-il lorsqu’ils puisent dans des sources mal contrôlées ? Le risque d’empoisonnement des données apparaît. Un attaquant peut injecter volontairement des informations fausses, trompeuses ou biaisées dans vos documents ou bases de données. Lorsque le système récupère ce contenu « empoisonné », le LLM peut générer des réponses incorrectes, biaisées ou préjudiciables en faisant confiance aux informations erronées qui lui ont été fournies.
Comment cela peut-il se produire ? Les attaquants exploitent souvent des failles de sécurité classiques dans le code de votre application ou ses dépendances. Des vulnérabilités comme le Path Traversal ou l’injection SQL peuvent permettre à un attaquant de modifier les fichiers ou les enregistrements de base de données alimentant votre système RAG. C’est pourquoi la sécurité des applications proactive est essentielle à la sécurité de l’IA. En analysant régulièrement votre code et vos dépendances à l’aide d’outils comme Snyk, vous pouvez détecter et corriger ces vulnérabilités sous-jacentes avant qu’elles ne servent à altérer vos sources de données RAG, coupant ainsi une voie d’accès importante aux attaques par empoisonnement des données.
Lacunes dans le contrôle des accès lors de la récupération
Le fait qu’une information soit pertinente pour une question ne signifie pas que l’utilisateur doit pouvoir la consulter. Si votre logique de récupération ne met pas en œuvre le contrôle des accès, les utilisateurs risquent d’obtenir des réponses fondées sur des documents auxquels ils ne sont pas autorisés à accéder. Filtrez toujours les contenus récupérés en fonction des autorisations de l’utilisateur avant de les transmettre au modèle.
La plupart des systèmes RAG permettent de segmenter ou de partitionner les données des utilisateurs. Veillez donc à utiliser cette fonctionnalité selon les outils RAG que vous avez choisis.
Fuite de données personnelles vers des modèles tiers
Dans de nombreuses configurations RAG, les données récupérées sont transmises directement à l’API d’un LLM public. Si ces données contiennent des informations permettant d’identifier une personne (PII) ou des données commerciales confidentielles, vous risquez d’enfreindre la réglementation sur la protection de la vie privée ou vos propres politiques internes. Veillez à assainir et à masquer les données sensibles avant qu’elles ne quittent votre infrastructure. Examinez également la manière dont votre fournisseur de modèle traite les données des prompts et leur conservation.
Risques liés à la mise en cache et fuites entre sessions
Pour accélérer les réponses, de nombreux systèmes mettent en cache les résultats du RAG. Une mauvaise mise en œuvre peut entraîner des fuites entre sessions : le contenu de la session d’un utilisateur apparaît alors dans la réponse d’un autre. Isolez toujours les résultats mis en cache par utilisateur et par contexte, et soyez prudent lorsque vous stockez des données issues d’une requête privée.
Informations contradictoires ou de mauvaise qualité
Même si vos données sont protégées contre les attaques externes, leur qualité reste importante. Si les documents indexés contiennent des faits obsolètes, des informations contradictoires ou des formulations peu claires, le modèle risque d’halluciner ou de générer des réponses peu fiables. Le modèle de langage ne vérifie pas les faits qu’il récupère : il utilise simplement les contenus tels quels pour formuler sa réponse. Si ces contenus sont de mauvaise qualité ou incohérents, les résultats le seront aussi. Le risque est particulièrement élevé dans des domaines comme le droit, la santé ou la sécurité, où la précision est essentielle. Sécuriser vos données est important, mais les garder propres et cohérentes l’est tout autant.

Stratégies proactives et correctives pour sécuriser le RAG
Pour utiliser le RAG en toute sécurité en production, vous devez aller au-delà de l’ingénierie des prompts et du choix du modèle. La plupart des stratégies ci-dessous vous sembleront peut-être familières : ce sont des techniques courantes, mais elles sont d’autant plus importantes avec les applications basées sur l’IA ou les LLM qui utilisent le RAG.
Assainir les contenus récupérés
Les données sensibles, comme les informations personnelles (PII), les jetons d’accès, les identifiants et les noms de projets internes, doivent être supprimées ou masquées avant d’être intégrées au prompt, ou idéalement avant même d’entrer dans votre système RAG. Évitez de transmettre directement des documents bruts au modèle, surtout s’il s’agit d’un LLM tiers.
Appliquer le contrôle des accès lors de la récupération
Appliquez des filtres d’accès par utilisateur ou par rôle lors de la récupération des documents avec le RAG. Assurez-vous que les segments renvoyés sont non seulement pertinents, mais aussi accessibles à l’utilisateur concerné.
La plupart des bibliothèques peuvent gérer cette tâche. Langchain4j permet d’associer des métadonnées aux segments, qui peuvent ensuite servir au filtrage. C’est un excellent moyen de ne récupérer que les segments auxquels le rôle de l’utilisateur connecté peut accéder.
Segmenter et délimiter votre index
Ne créez pas un seul grand index vectoriel pour toute votre organisation. Segmentez plutôt vos magasins vectoriels par groupe d’utilisateurs, service ou fonction. Cette approche renforce la sécurité en limitant les risques d’exposition et les conséquences d’un accès non autorisé.
Prévenir les vulnérabilités classiques dans le code et les dépendances.
Les vulnérabilités dans le code personnalisé ou les bibliothèques externes peuvent être exploitées pour empoisonner les données des systèmes RAG. Même si une vulnérabilité semble sans rapport, elle peut servir à influencer les segments RAG et, par conséquent, les réponses d’un LLM. Des vulnérabilités telles que l’injection SQL et les attaques par traversée de chemins peuvent entraîner l’écrasement des documents sources. Lorsque ces documents empoisonnés sont utilisés dans un système RAG, ils peuvent générer des résultats imprévisibles, voire malveillants. L’analyse du code de votre application et de ses bibliothèques à la recherche de vulnérabilités connues avec Snyk devrait réduire ces risques.
Modérez et filtrez les sources de données
Avant d’indexer du contenu dans votre système RAG, il est important de valider et de filtrer les données pour en garantir la qualité et la sécurité. Cela implique de corriger les problèmes de mise en forme, de supprimer le contenu inutile ou non pertinent et de modérer les données afin de détecter les injections de prompt, les propos toxiques ou le spam, en particulier dans les contenus générés par les utilisateurs. Dans les environnements à risque élevé, envisagez des processus d’approbation ou des systèmes de balisage pour contrôler les données indexées.
Auditez régulièrement vos données
L’audit et la sélection réguliers de vos données sont essentiels pour réduire le risque d’hallucinations, souvent dues à des contenus de mauvaise qualité ou contradictoires. Veillez à ce que vos données restent propres, cohérentes et à jour. Examinez et actualisez régulièrement votre base vectorielle. Une bonne stratégie consiste à stocker une référence au document d’origine dans les métadonnées du segment, afin de pouvoir le mettre à jour correctement.
Évitez les réponses du cache non filtrées
Si vous utilisez la mise en cache pour améliorer les performances, veillez à ce que les résultats mis en cache respectent les sessions et le contexte des utilisateurs. Les prompts et les réponses ne doivent pas être réutilisés d’un utilisateur à l’autre, sauf s’ils sont publics et approuvés.
Réexaminez votre stratégie de modèles LLM.
Segmentez les assistants LLM et les magasins de données. Fournissez les informations sensibles à un modèle local, car certaines données doivent rester au sein du système. Limitez les risques de fuite de données inutiles et leur impact en utilisant plusieurs modèles au sein d’un même système, chacun répondant à des objectifs et traitant des informations spécifiques. Si vous utilisez un fournisseur de modèles publics, examinez ses conditions relatives au stockage, à la conservation et à l’utilisation des données. Pour les charges de travail sensibles, optez pour des modèles offrant de solides garanties de confidentialité ou hébergez-les en interne.
Le RAG est essentiel, mais constitue aussi un vecteur d’attaque.
La génération augmentée par récupération (RAG) est une technique essentielle pour créer des applications robustes et fiables reposant sur des LLM. En intégrant des sources de connaissances externes, le RAG remédie aux limites des LLM et permet d’obtenir des réponses plus précises et mieux contextualisées. Toutefois, la mise en œuvre du RAG soulève des enjeux de sécurité. Les risques tels que l’injection de prompt, l’empoisonnement des données, les lacunes dans le contrôle des accès et les fuites de données doivent être gérés de manière proactive. En mettant en place des stratégies comme l’assainissement du contenu, l’application des contrôles d’accès, la segmentation des données, l’analyse des vulnérabilités et des audits réguliers, les organisations peuvent atténuer ces risques et créer des applications RAG plus sécurisées. Pour que l’IA soit réellement utile dans nos applications, il est essentiel de définir une stratégie solide qui tienne compte à la fois de l’efficacité des systèmes RAG et de leur sécurité.
Continuez à approfondir votre expertise en sécurité de l’IA. Découvrez le parcours de formation OWASP Top 10 for LLMs sur Snyk Learn.
Prenez en main la sécurité de l’IA avec Snyk
Découvrez comment Snyk aide à sécuriser le code généré par l’IA de vos équipes de développement, tout en offrant aux équipes de sécurité une visibilité et des contrôles complets.