5 bonnes pratiques pour créer des serveurs MCP
Écrit par

0 minutes de lecture
La création de serveurs MCP est devenue une solution courante pour exposer les fonctionnalités d’un produit aux applications d’IA et aux workflows pilotés par l’IA. Si vous débutez dans la création de serveurs MCP, comment adopter les bonnes pratiques et conventions pour tirer le meilleur parti de votre serveur MCP ? J’ai compilé une liste de bonnes pratiques, fruit de mon expérience dans la création de plusieurs serveurs avec Node.js.
Si vous avez suivi les précédents articles du centre de ressources de Snyk, vous nous avez probablement vus examiner 7 serveurs MCP pour les chefs de produit, expliquer aux développeurs comment ajouter des serveurs MCP à Cursor et sensibiliser aux risques de sécurité du vibe coding, qui peuvent entraîner des vulnérabilités dans les applications Node.js.
Ce guide rassemble quelques subtilités et éléments fondamentaux des modèles qui permettent aux serveurs MCP de fonctionner efficacement. Il aborde également l’expérience des développeurs avec les clients MCP et les capacités de débogage.
Bonne pratique 1 pour les serveurs MCP : respecter les conventions de nommage des outils
Les serveurs MCP exposent des outils avec un nom et une description, puis les présentent dans une liste d’outils en réponse aux clients MCP qui les utilisent.
Voici un exemple de définition d’outil simple, dont le nom est getNpmPackageInfo :
Clause de non-responsabilité sur la sécurité : le code d’exemple ci-dessus pour un serveur MCP est volontairement vulnérable à l’injection de commandes dans le cadre d’un article pédagogique sur les vulnérabilités de sécurité des serveurs MCP.
Vous auriez pu choisir l’un des noms d’outil suivants, parmi plusieurs possibilités :
getNpmPackageInfo(celui utilisé dans l’exemple ci-dessus)get-Npm-Package-Infoget.Npm.Package.Infoget Npm Package Information
J’ai constaté que lorsque vous vous écartez des conventions de fait en matière de nommage des outils — avec un tiret (-), un trait de soulignement (_) ou le format snake_case (getNpm…) — les clients MCP ne parviennent pas à proposer l’outil. Pour l’utilisateur final, l’outil ne sera alors pas appelé.
Ma recommandation : n’utilisez ni espace, ni point comme séparateur (.), ni parenthèses rondes ou crochets, comme ( ou ), dans le nom de l’outil. Cela crée de la confusion et perturbe complètement l’appel de l’outil MCP. Utilisez toujours la convention snake_case pour le nom de l’outil. GPT-4o gère particulièrement bien cette pratique lors de la tokenisation. Vous pouvez aussi utiliser un tiret ou un trait de soulignement comme séparateur.
La tokenisation par le LLM est essentielle pour le nom de l’outil
Cela dépend du modèle utilisé, de l’implémentation des clients MCP et des hôtes MCP qui s’appuient sur ces derniers, mais le processus de tokenisation du LLM est l’une des raisons possibles.
Prenons par exemple les différentes façons dont les modèles OpenAI, comme GPT-4o, tokenisent le texte :
nodeCryptoest analysé comme deux jetons.
node.Cryptoest analysé comme trois jetons.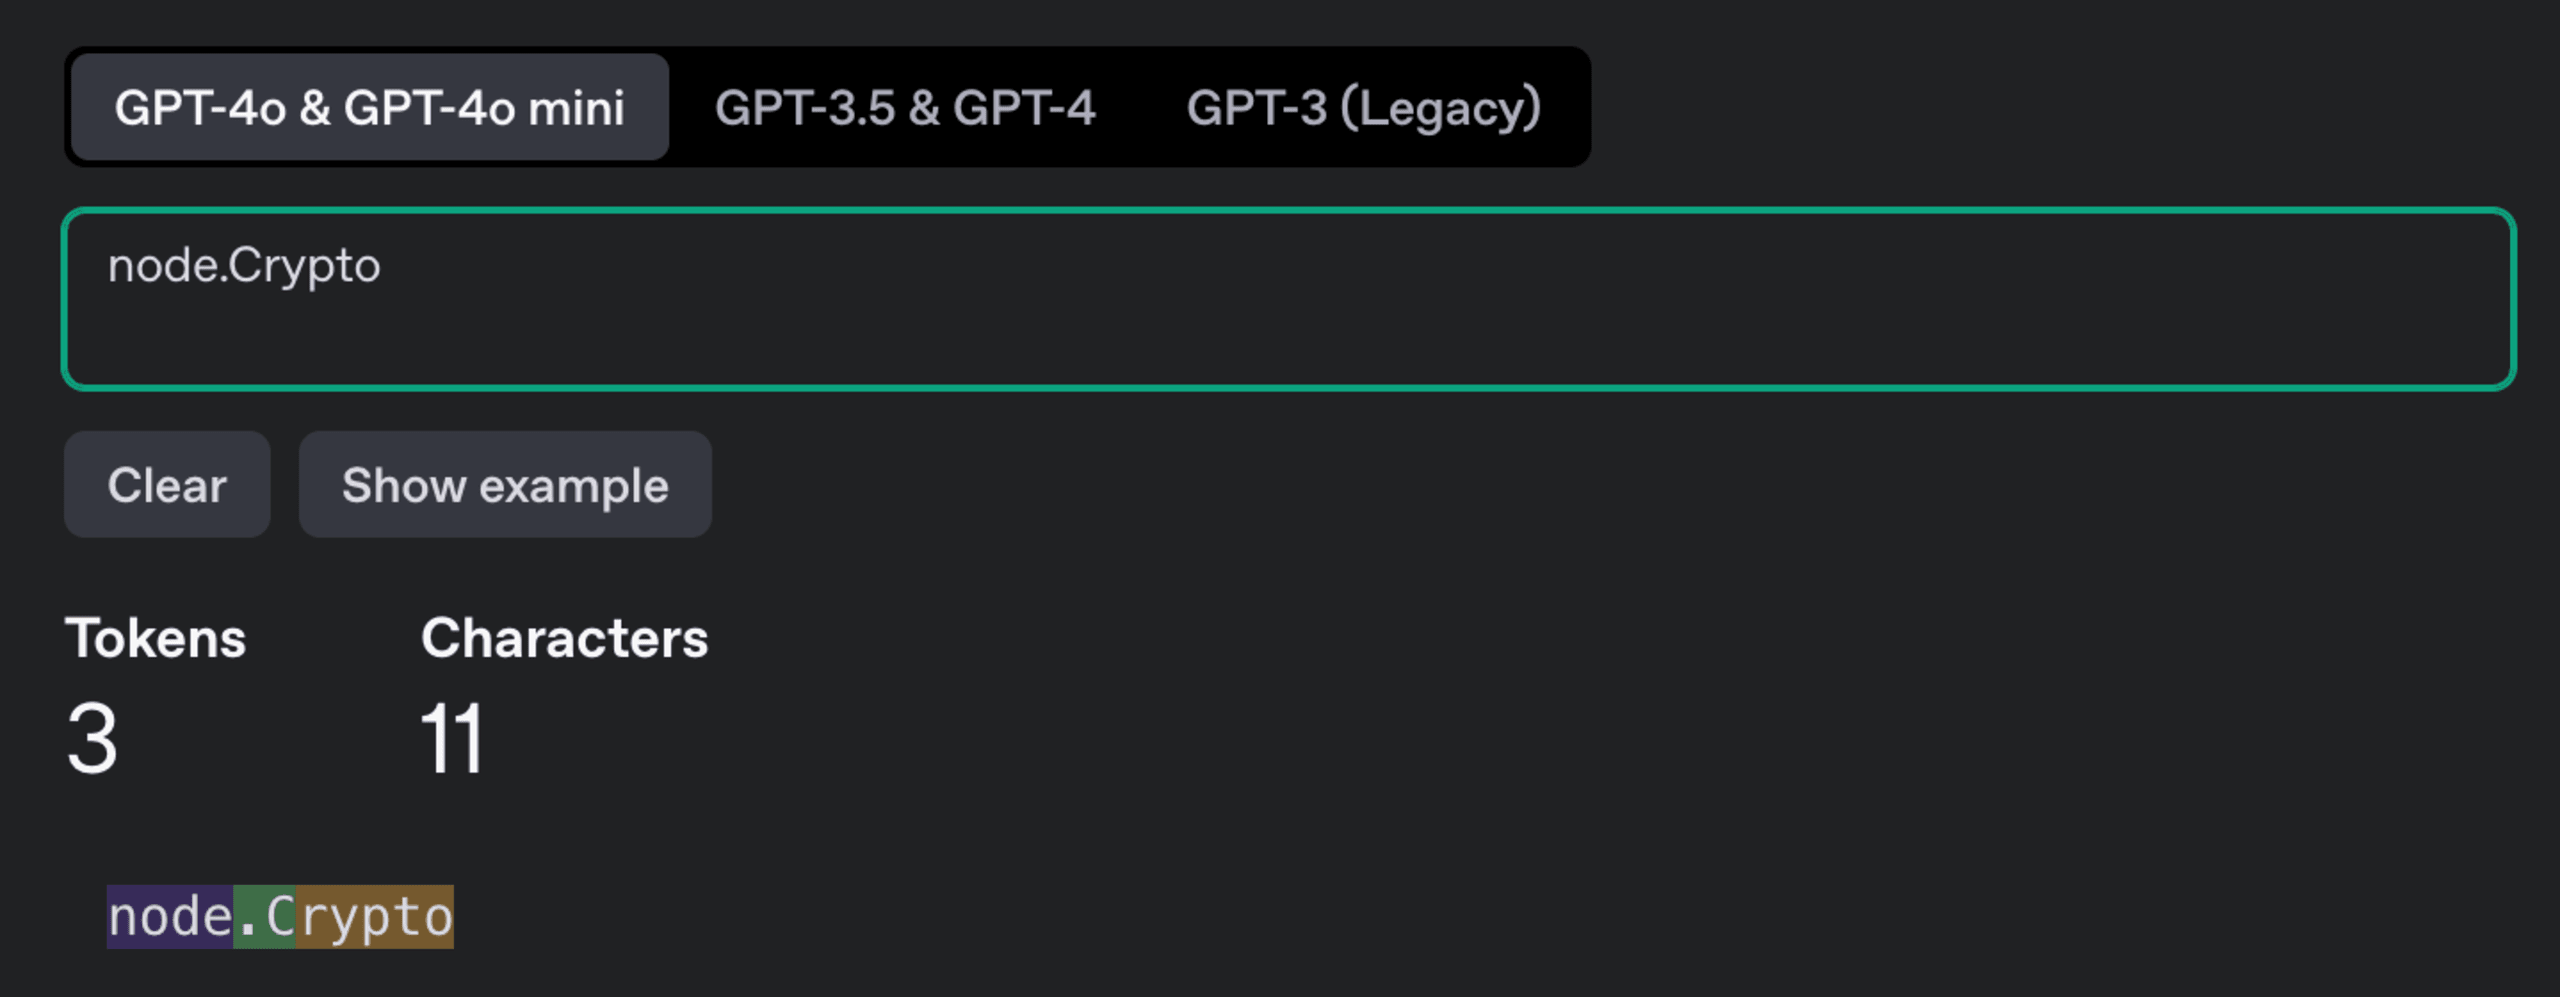
node_cryptoest analysé comme deux jetons.
npm_Utilsest analysé comme trois jetons.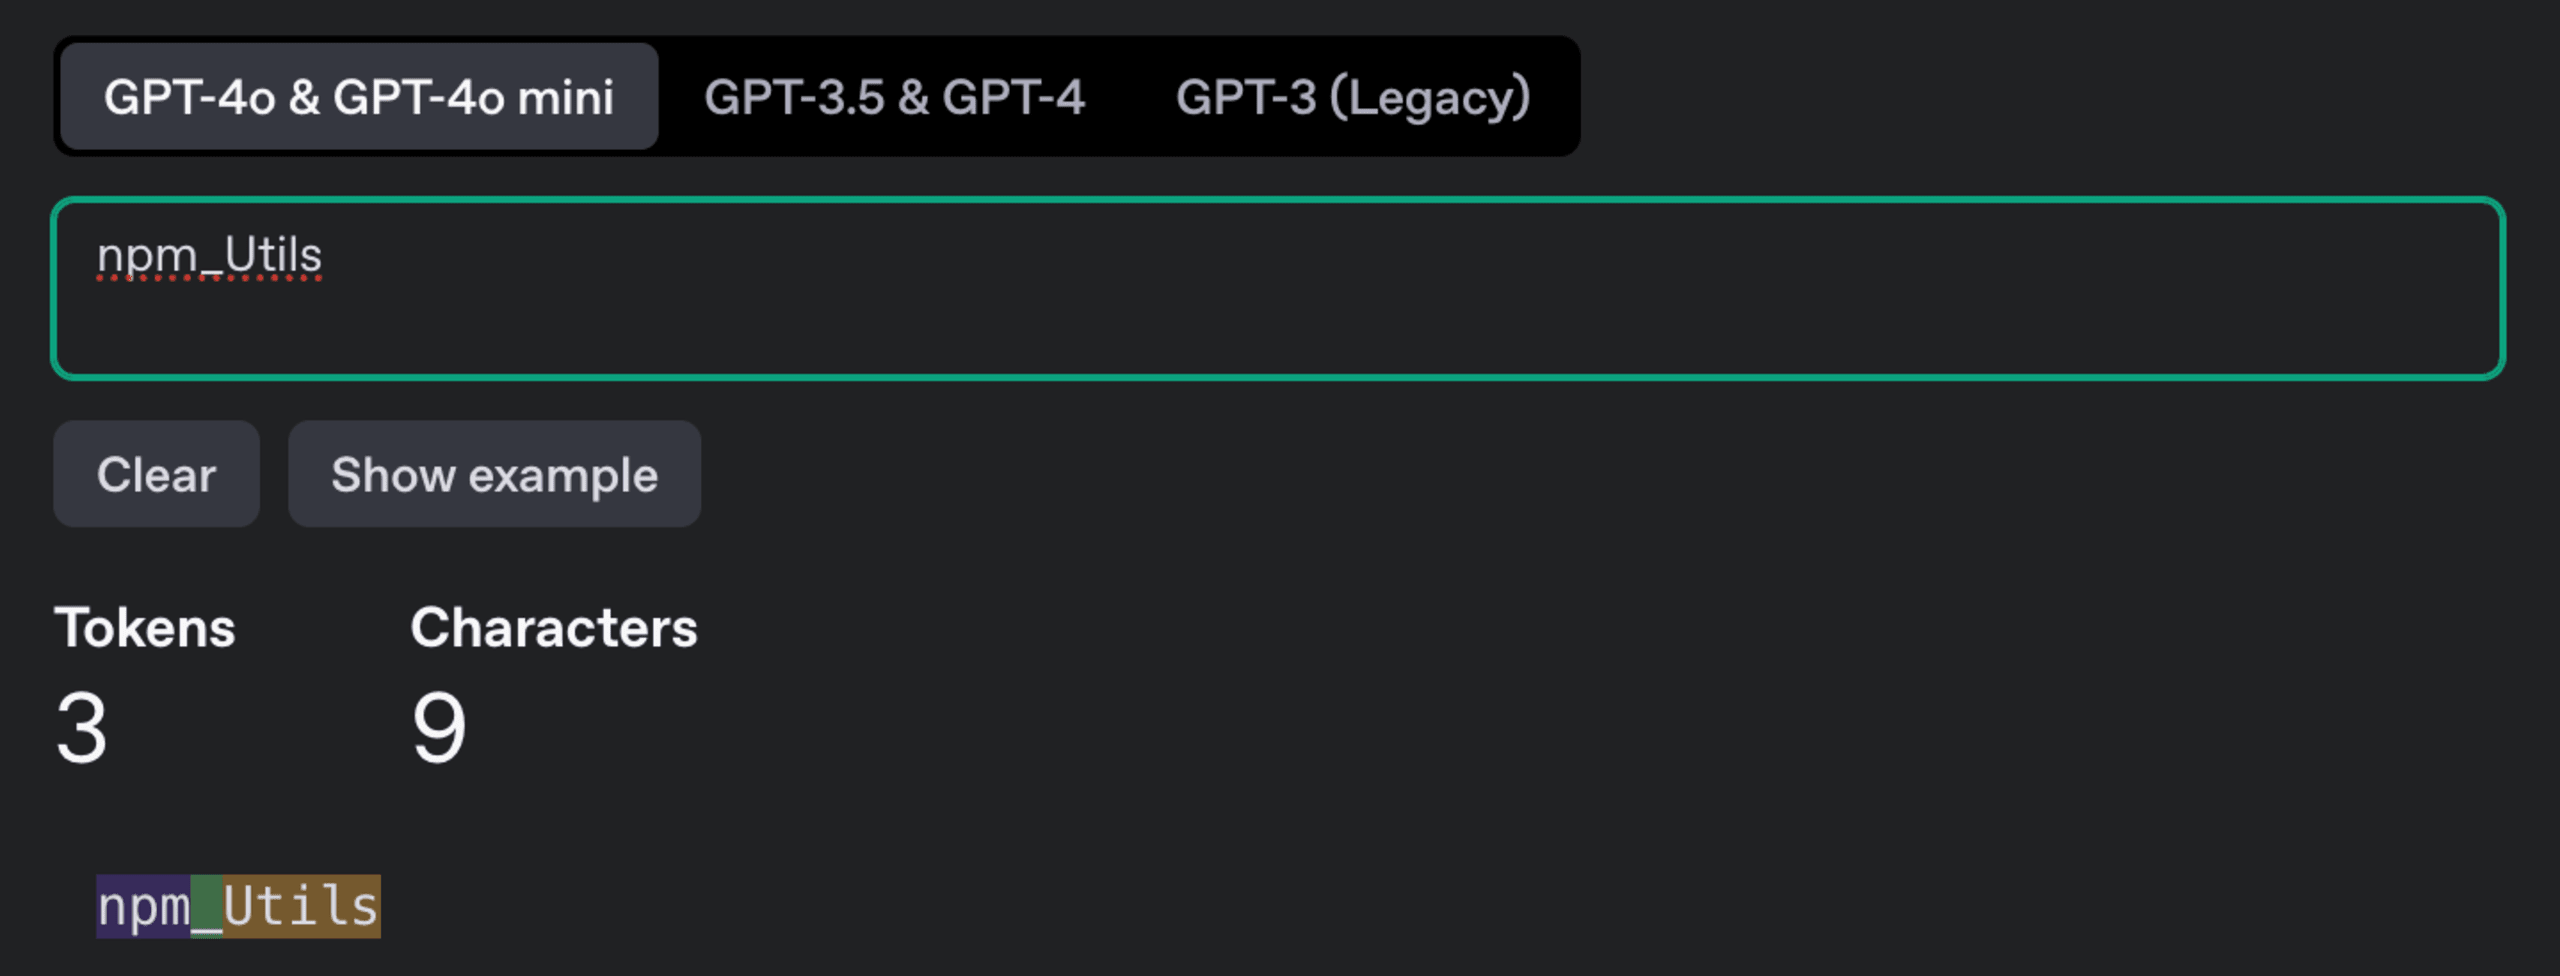
npm_Get_Package_Infoest analysé comme cinq jetons.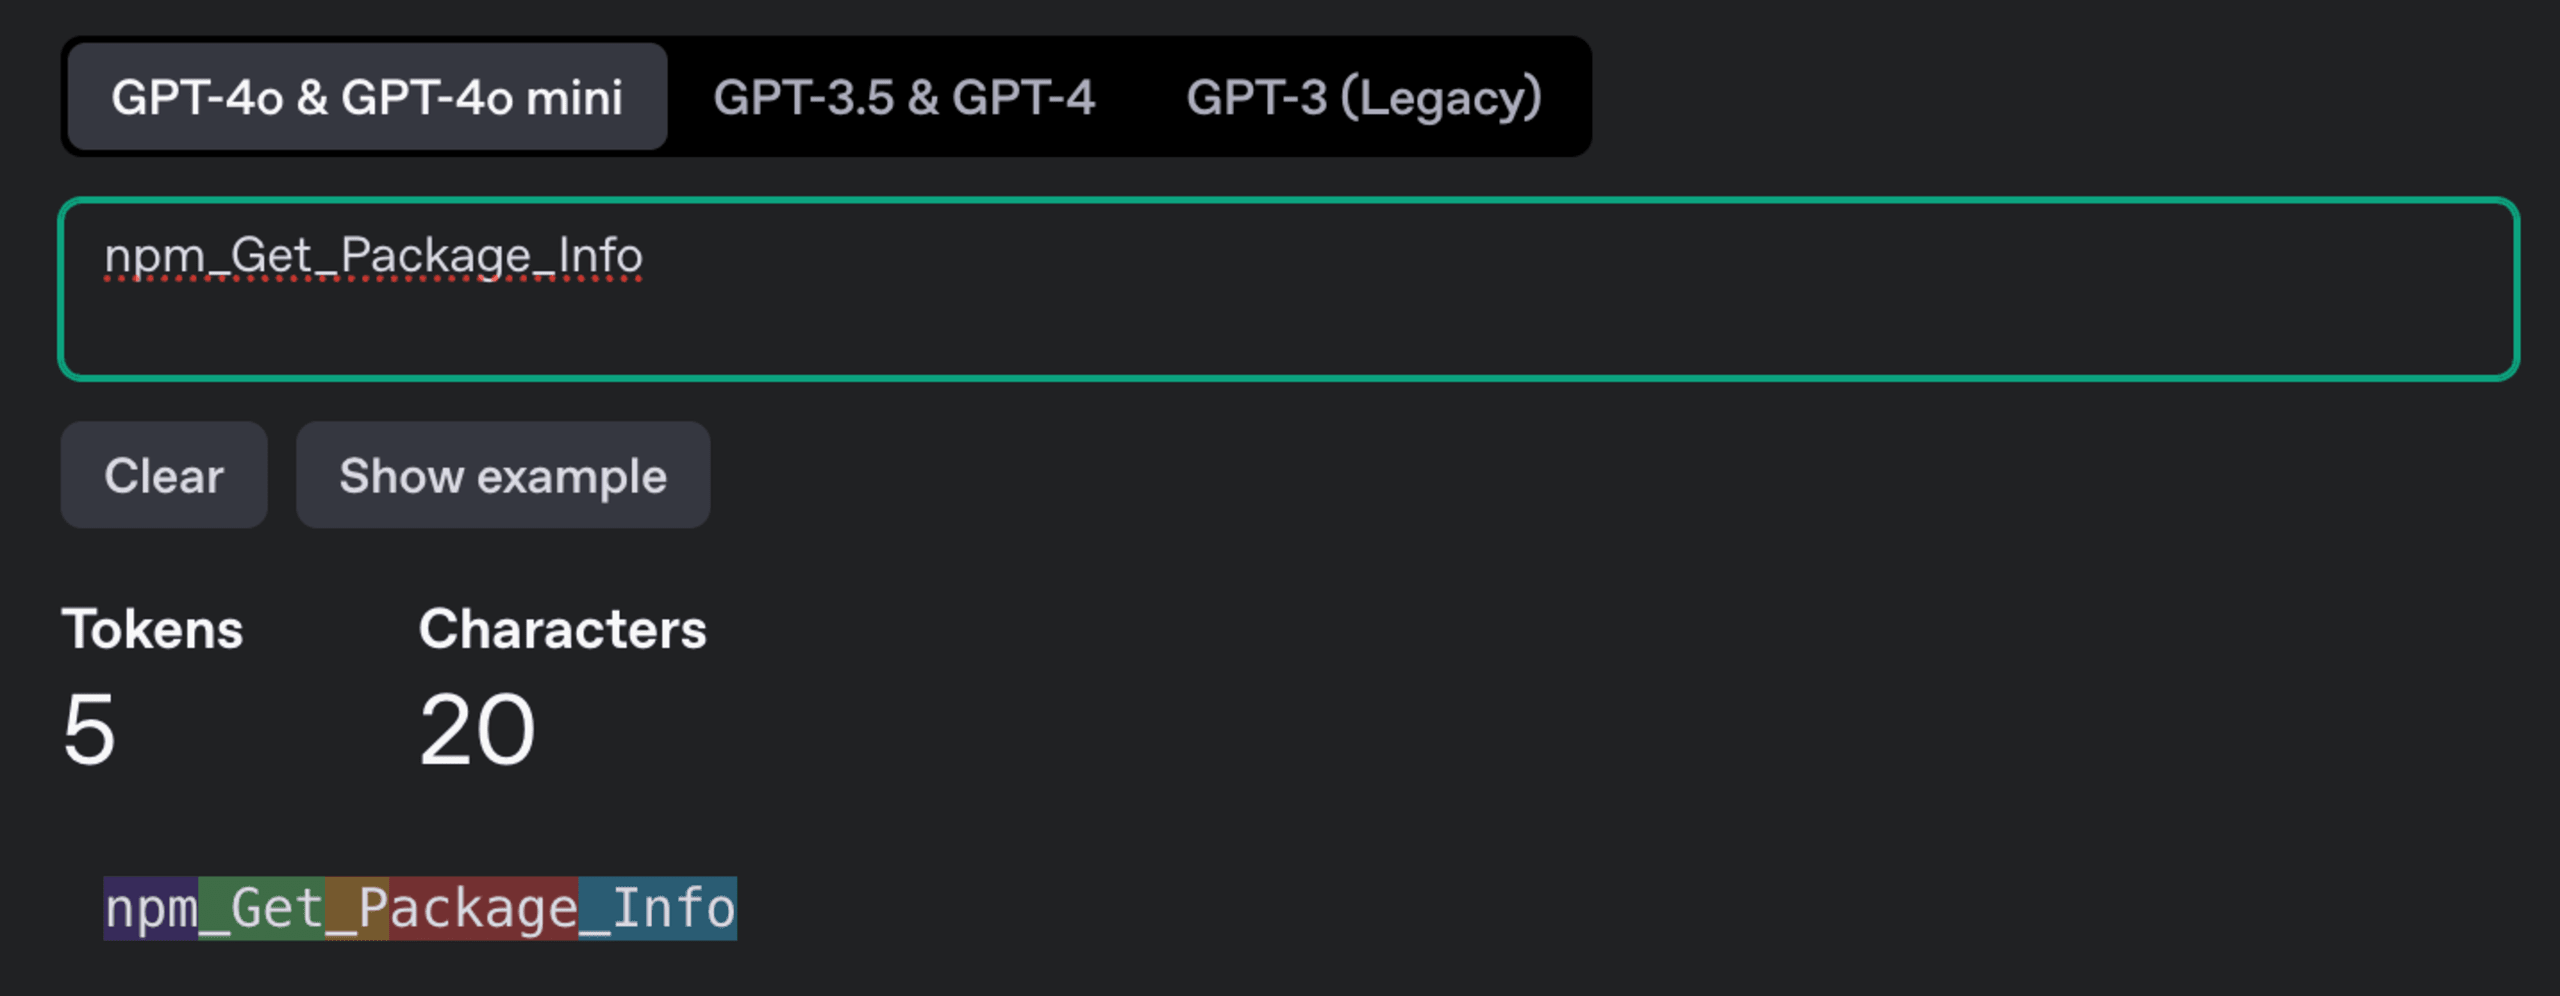
Bonne pratique 2 pour les serveurs MCP : journalisation
Comment savoir si l’interaction entre le client et le serveur MCP ne fonctionne pas correctement ? L’outil est-il appelé ?
Si vous avez essayé de créer un serveur MCP, en particulier un serveur simple qui s’appuie sur le STDIO du processus (entrée/sortie standard), vous avez remarqué que console.log() ne fonctionne pas très bien.
La journalisation dans la console ou le terminal n’est pas simple pour les serveurs MCP qui utilisent le STDIO, car ce canal de communication sert à échanger des informations entre les clients et les serveurs MCP.
Pour autant, renoncer complètement à la journalisation n’est pas une option. Une journalisation efficace est essentielle pour les serveurs MCP : elle offre une visibilité indispensable sur le fonctionnement du programme, afin de résoudre les problèmes liés aux appels d’outils et aux autres traitements effectués dans la logique de définition des outils. Vous devrez probablement dépanner efficacement vos serveurs MCP et obtenir une visibilité sur les informations clés nécessaires à l’exécution des workflows d’IA.
Ainsi, pour les serveurs MCP qui utilisent le transport STDIO du processus conformément à la spécification MCP, la solution la plus simple consiste à journaliser dans un fichier : les sorties sont alors enregistrées dans un fichier journal désigné pour une analyse ultérieure.
Ma recommandation : utilisez une bibliothèque de journalisation comme pino, qui simplifie l’implémentation dans Node.js. C’est un excellent choix, développé par des collaborateurs de longue date et de confiance de l’écosystème Node.js et par les auteurs des bibliothèques Fastify.
Voici un exemple d’utilisation de pino :
Cet exemple montre comment utiliser pino pour créer un enregistreur qui écrit les journaux dans /tmp/mcp-server.log.
Les entrées du journal, comme l’initialisation de l’enregistreur, peuvent ensuite être consignées de façon systématique. Cette pratique permet de surveiller précisément le déroulement du programme d’un serveur MCP et d’en avoir une visibilité complète.
Les serveurs MCP qui utilisent le transport HTTP peuvent gérer la journalisation autrement ; cette bonne pratique ne les concerne pas.
Bonne pratique 3 pour les serveurs MCP : éviter les réponses « introuvable »
Cette recommandation porte davantage sur le texte des réponses et la logique d’implémentation des appels d’outils. Elle repose sur mon expérience, certes limitée. Mes observations et mes essais semblent toutefois la confirmer.
Voici le principe : lorsque vous implémentez des appels d’outils comme « search », évitez de répondre par un message « introuvable ». Fournissez plutôt au LLM autant de données générales que possible.
J’en ai fait l’expérience en créant un serveur MCP pour la documentation de l’API Node.js et en implémentant un outil nodeSearch. Si les utilisateurs recherchent une méthode de l’API du runtime Node.js, il se peut qu’ils ne la trouvent pas du premier coup : l’implémentation de l’outil nodeSearch recherche les modules principaux de Node.js par leur nom, et non les méthodes de leur API sous-jacente.
Au départ, dans ce cas, j’avais choisi de renvoyer Module <xyz> not found. <here is everything I have>. Mais j’ai constaté que même si je fournissais l’ensemble des modules et des méthodes, le LLM se laissait guider par le message « introuvable » au début de la réponse et ne poursuivait pas sa recherche de la méthode dans l’un des modules principaux de Node.js pris en charge, parmi les données fournies.
Ma recommandation : ne renvoyez pas de message « introuvable ». Fournissez plutôt d’autres données pertinentes. Bien sûr, cela comporte des réserves : il n’est pas toujours possible de renvoyer toutes les données. Par exemple, lorsqu’il s’agit de rechercher des utilisateurs, cela pourrait être inapproprié, non sécurisé et constituer une atteinte à la vie privée.
Vous voulez voir cette pratique avant et après en action ? Regardez ci-dessous.
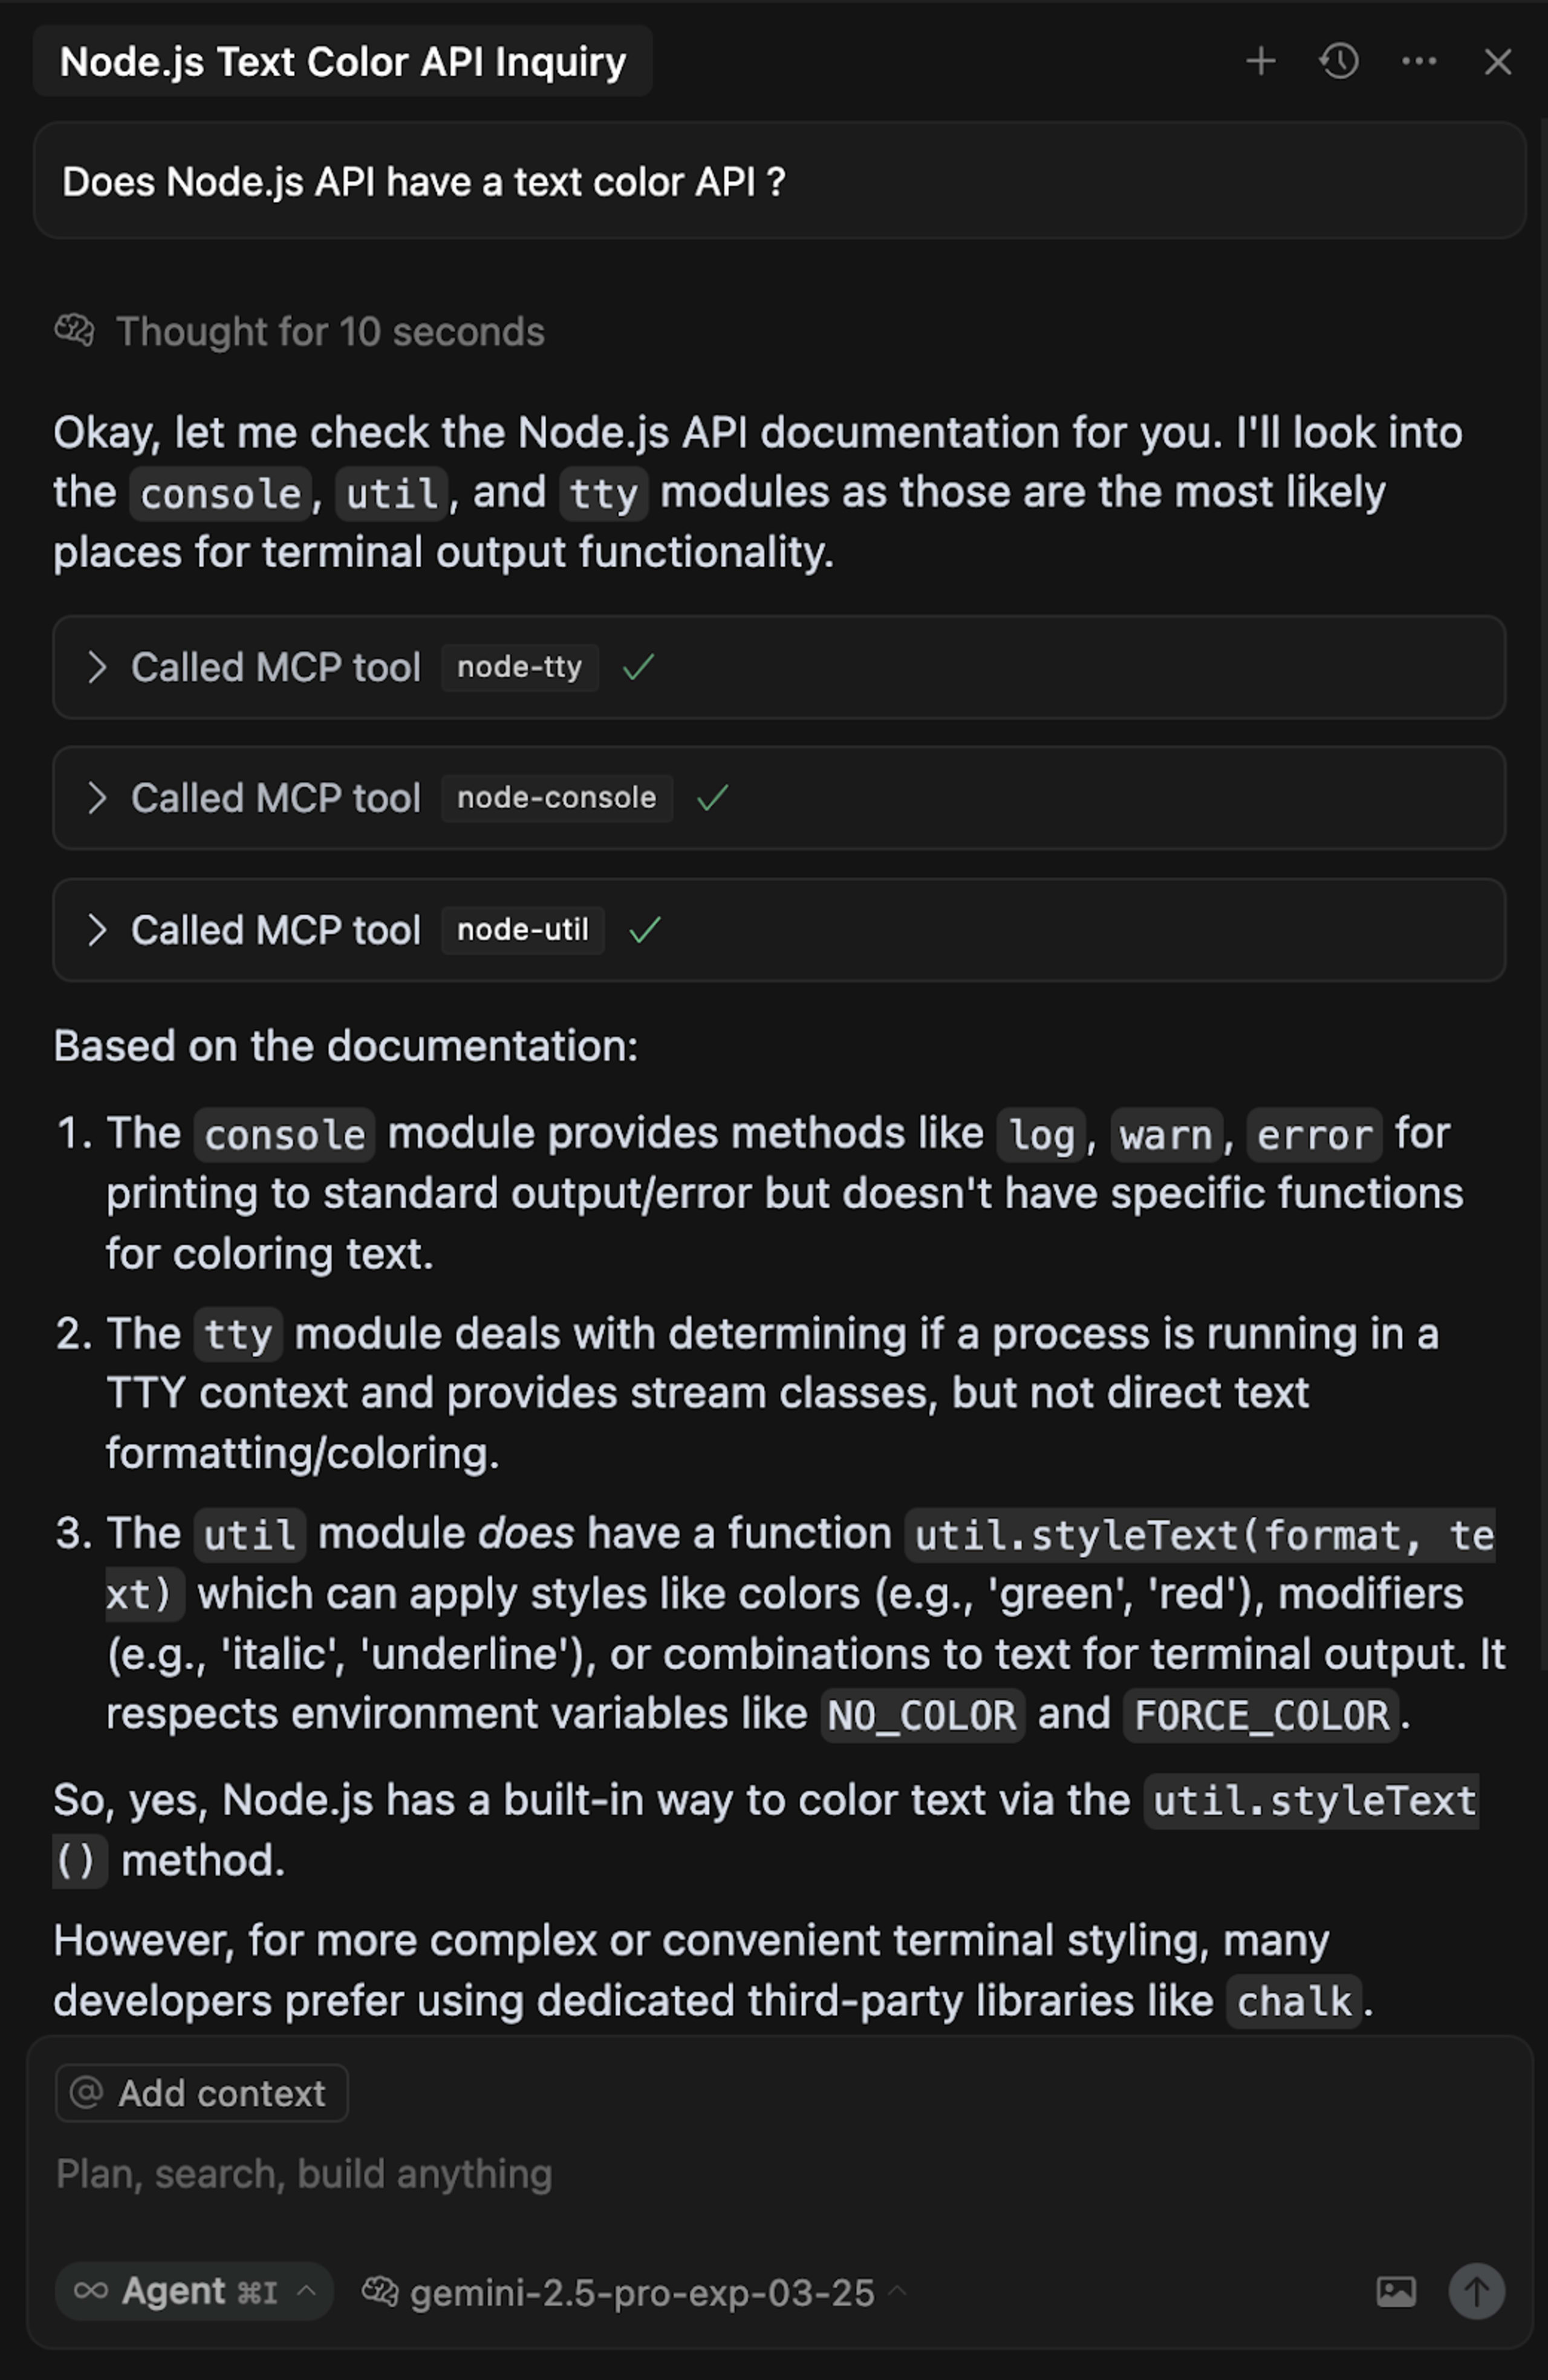
Voici un exemple d’échange avec le chat d’un IDE qui utilise un serveur MCP dont l’appel d’outil renvoie un message « introuvable ». Comme vous pouvez le constater, il ne parvient pas à trouver la bonne réponse :
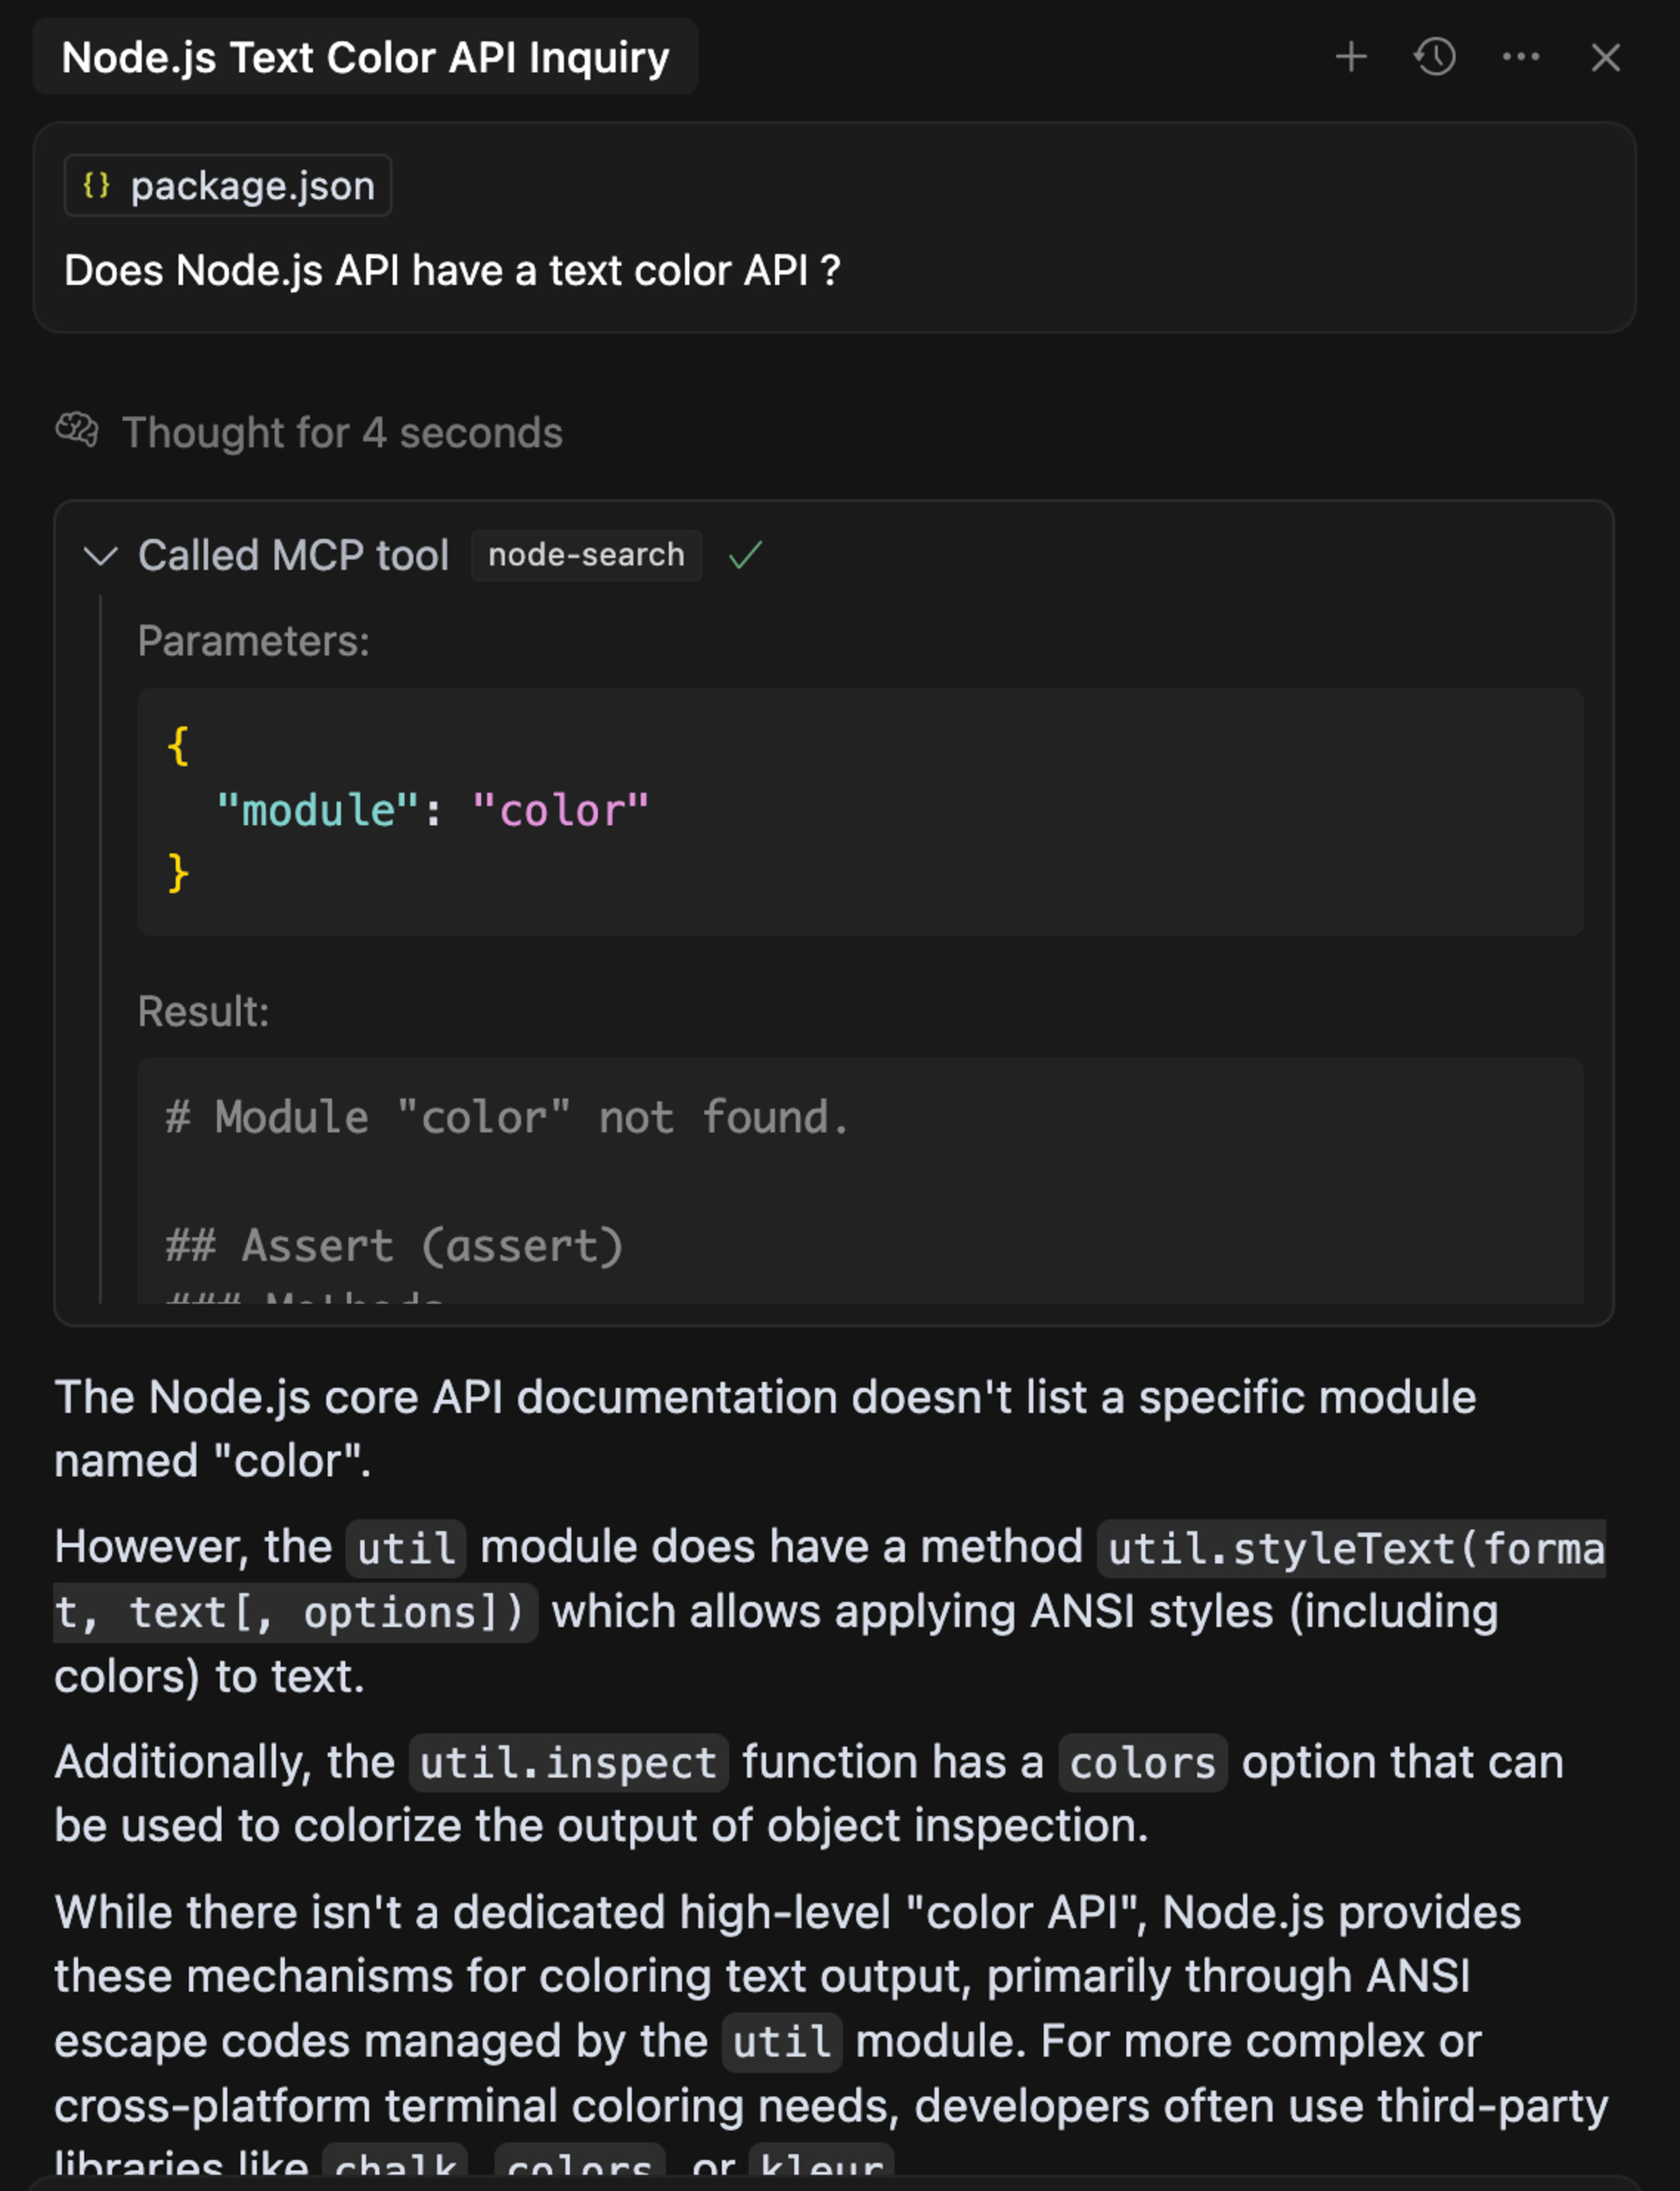
Cependant, lorsque nous supprimons le message # Module “color” not found en haut de la réponse et renvoyons tous les modules principaux de Node.js disponibles ainsi que leurs méthodes, le LLM peut examiner différentes possibilités et trouver une meilleure solution.
Ça fonctionne :
Bonne pratique 4 pour les serveurs MCP : éviter les composants tiers vulnérables
Dans une série consacrée aux bonnes pratiques, menée par une entreprise spécialisée dans la sécurité de l’IA comme Snyk, nous ne pouvons pas faire l’impasse sur la sécurité, n’est-ce pas ?
Pour être largement adoptés par les organisations et acceptés par les équipes d’infrastructure internes, les serveurs MCP doivent répondre à des exigences strictes en matière de sécurité et de conformité. Les équipes informatiques et de sécurité des produits connaissent bien les risques liés à l’introduction de dépendances potentiellement vulnérables dans leurs workflows. Ce n’est pas nouveau : ces enjeux font partie des exigences relatives aux SBOM prévues par le décret de Biden à la suite des conséquences de l’attaque SolarWinds.
Il est essentiel d’éviter les composants tiers vulnérables. Tout logiciel qui dépend de bibliothèques tierces ou contient du code présentant des vulnérabilités connues peut devenir un point d’entrée pour des acteurs malveillants. De par leur fonction, les serveurs MCP disposent souvent d’un accès étendu et de nombreuses capacités d’intégration, ce qui rend toute vulnérabilité particulièrement risquée.
Ainsi, s’assurer que vos serveurs MCP ne présentent aucune vulnérabilité n’est pas seulement une bonne pratique : c’est indispensable à leur mise en œuvre réussie.
Je vous recommande d’utiliser Snyk. Mais par où commencer pour sécuriser les serveurs MCP, et où chercher ?
Recherchez le code vulnérable : Snyk peut analyser votre base de code pour repérer les failles de sécurité et les modèles de code non sécurisés, puis proposer des corrections dans l’IDE ou d’autres workflows de développement.
Vérifiez la présence de dépendances vulnérables : La sécurisation des logiciels open source est l’un des points forts historiques de Snyk. Snyk analyse les dépendances du projet à l’aide d’une base de données complète des vulnérabilités connues et vous signale les risques ainsi que les versions vers lesquelles effectuer la mise à niveau.
Assurez la conformité : Les questions juridiques peuvent sembler ennuyeuses aux développeurs, mais elles sont essentielles pour les entreprises. Snyk vous aide, en tant que développeur, à éviter les problèmes de responsabilité juridique en repérant les vulnérabilités qui enfreignent les normes de sécurité et de licence.
Voici une démonstration pratique de l’utilisation de Snyk pour détecter les dépendances open source vulnérables :

Snyk détecte également le code vulnérable dans votre propre base de code, notamment les injections de commandes, les traversées de chemin et d’autres types de code non sécurisé que vous avez écrits — ou que le LLM a peut-être générés pour vous. Dans tous les cas, Snyk analysera le code.
Bonne pratique 5 pour les serveurs MCP : empaqueter le serveur MCP dans un conteneur Docker
La création de serveurs MCP présente de nombreux avantages, mais leur déploiement et leur gestion peuvent compliquer les choses pour les utilisateurs finaux.
Les serveurs MCP nécessitent souvent un environnement d’exécution spécifique, comme Python avec uv ou Node.js avec npm. Cette dépendance à un environnement de langage particulier peut compliquer leur utilisation. Les utilisateurs finaux doivent configurer leur environnement avec précision pour exécuter correctement le serveur MCP, ce qui peut entraîner des incohérences, des conflits de versions, des erreurs et une configuration complexe.
Une solution efficace consiste à empaqueter le serveur MCP dans un conteneur Docker. Les conteneurs Docker offrent un environnement standardisé et isolé, qui comprend toutes les dépendances, bibliothèques et composants d’exécution nécessaires au bon fonctionnement du serveur MCP. En distribuant le serveur MCP sous forme d’image de conteneur, il suffit aux utilisateurs d’installer Docker pour l’exécuter.
Docker a même créé un hub centralisé de serveurs MCP sous forme d’images de conteneur pour les serveurs MCP les plus populaires :
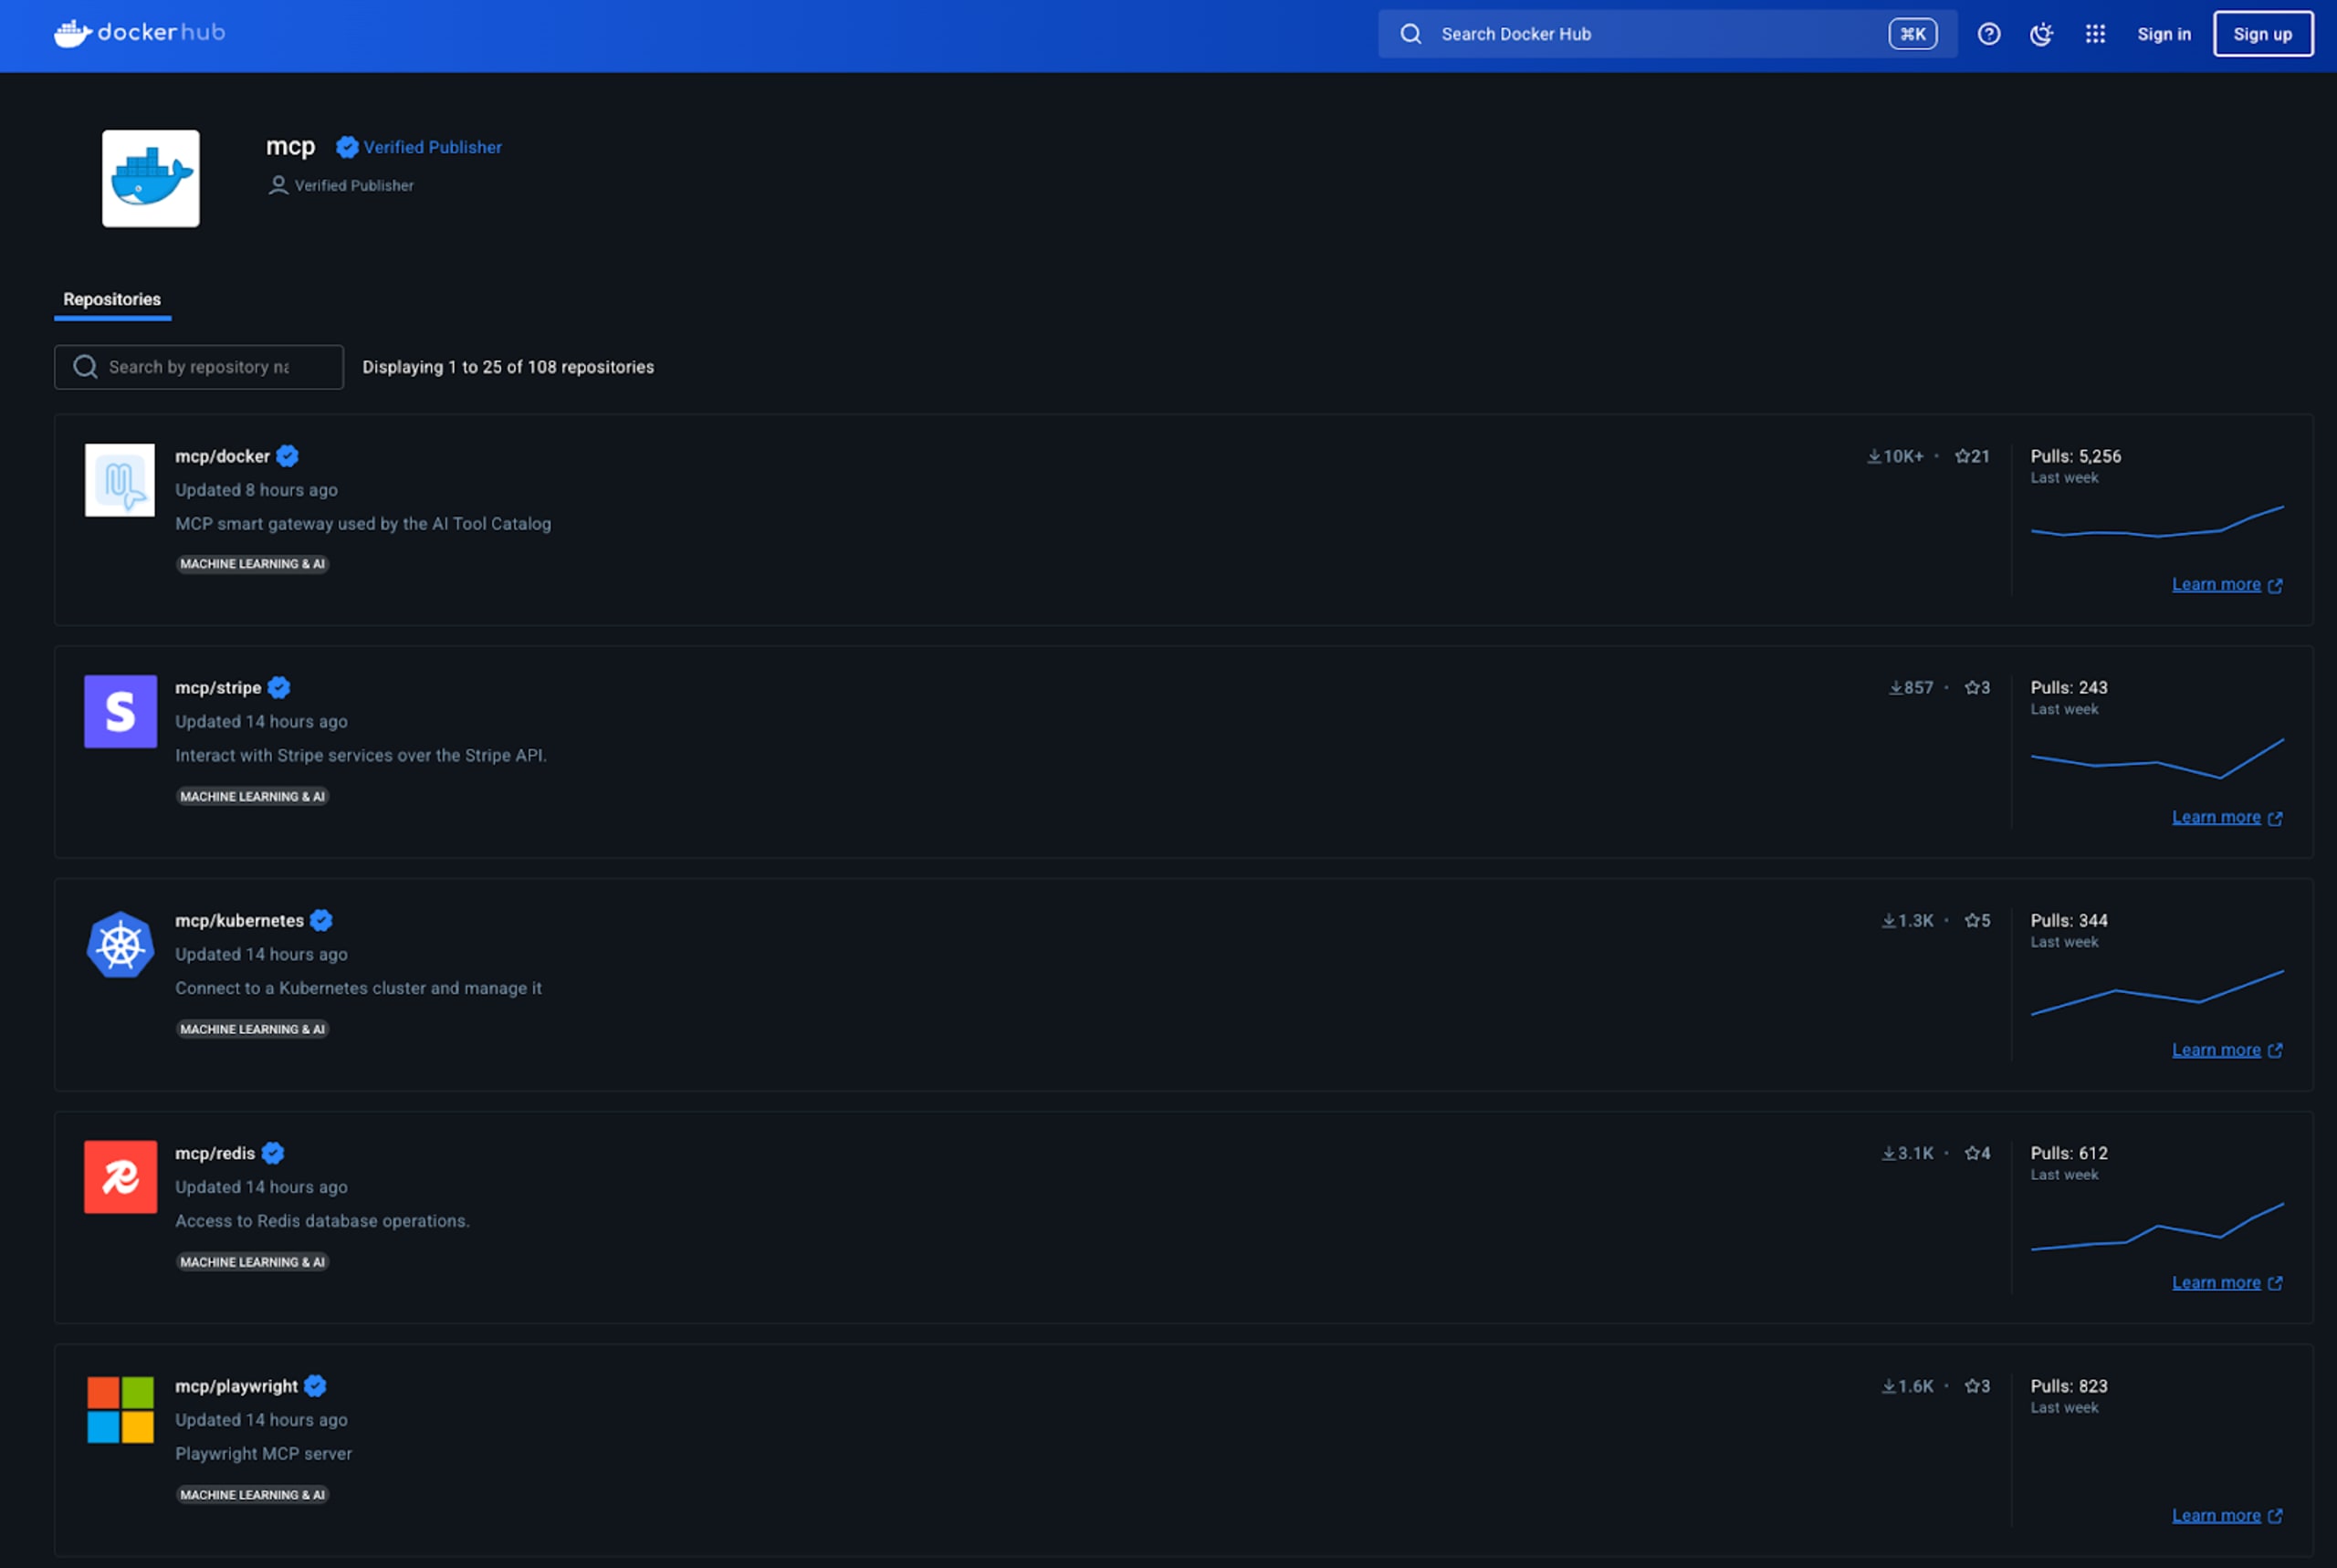
Docker constitue une couche d’abstraction reconnue par le secteur qui empaquette les applications et leurs dépendances dans un conteneur portable. Cette approche simplifie le déploiement, garantit la cohérence entre différents environnements et élimine le problème du « ça fonctionne sur ma machine ».
Voici quelques avantages à proposer des images Docker pour les serveurs MCP que vous allez créer :
Cohérence : garantit que le serveur MCP s’exécute de la même manière en développement, en test et en production.
Isolation : évite les conflits entre les dépendances du serveur MCP et les autres applications du système hôte.
Portabilité : facilite le déploiement du serveur MCP sur tout système compatible avec Docker.
Déploiement simplifié : réduit le nombre d’étapes nécessaires aux utilisateurs finaux pour démarrer le serveur MCP.
Gestion des ressources : Docker fournit des outils pour gérer les ressources comme le processeur, la mémoire et le réseau, afin de garantir le fonctionnement efficace du serveur MCP.
Bonnes pratiques pour développer avec l’IA en toute sécurité
10 conseils pour aider les développeurs et les professionnels de la sécurité à atténuer efficacement les risques potentiels tout en tirant pleinement parti du développement avec l’IA.