Vulnerabilidades de confusão de URL em ação: explorando inconsistências entre parsers

Snyk Security Research Team
Claroty Team82
10 de janeiro de 2022
0 minutos de leituraAs URLs mudaram para sempre a forma como interagimos com computadores. Concebidas em 1992 e definidas em 1994, as URLs (Uniform Resource Locators, ou localizadores uniformes de recursos) continuam sendo um componente essencial da internet, permitindo que as pessoas naveguem pela web usando endereços descritivos e compreensíveis. Mas a necessidade de torná-las legíveis para humanos também criou a necessidade de dividi-las em componentes que as máquinas pudessem usar; essa tarefa é realizada por parsers de URL.
Considerando a onipresença das URLs há décadas, seria de se esperar que os parsers de URL usados hoje tivessem chegado a um consenso sobre como interpretar URLs semelhantes (ou até idênticas). Embora isso fosse ideal, está longe de ser verdade. Essa falta de consenso contribuiu para uma classe de vulnerabilidade chamada confusão de URL, que vamos explorar nesta publicação.
Observação: O processo de desenvolvimento dos protocolos da internet (HTTP, HTML, URL etc.) usa documentos conhecidos como Requests for Comments, ou RFCs. Vamos fazer referência frequente a esses documentos nesta publicação.
Em nossa pesquisa conjunta, analisamos diversas bibliotecas de parsing de URL em várias linguagens de programação e identificamos inconsistências na forma como cada uma dividia as URLs fornecidas em seus componentes básicos. Classificamos os tipos de inconsistência em quatro categorias e buscamos fluxos de código problemáticos tanto em aplicações web quanto em bibliotecas de código aberto. Esse trabalho revelou inúmeras vulnerabilidades, a maioria com uma destas causas principais:
Há vários parsers de URL em uso
Ao longo do tempo, foram publicados vários RFCs relacionados a URLs, e diferentes parsers implementaram RFCs diferentes
Nesta publicação, vamos conhecer a história das URLs, explorar possíveis causas de confusão entre parsers de URL, demonstrar uma prova de conceito de exploração e, em seguida, apresentar recomendações para proteger você contra ataques baseados em confusão de URL. Use o índice abaixo para ir direto à seção desejada:
A pesquisa realizada pelas equipes de pesquisa de segurança da Claroty e da Snyk foi inspirada em trabalhos anteriores de Orange Tsai, intitulados “A New Era of SSRF”, e em uma comparação entre WHATWG e RFC 3986 feita por Daniel Stenberg, criador do cURL. Agradecemos a eles por suas pesquisas inovadoras.
O que são URLs e como chegamos até aqui?
Quando pensamos em uma URL, imaginamos algo como https://snyk.io. Basicamente, ela indica para onde ir (my-site.com) e como chegar lá (por HTTPS). Além desses componentes, também encontramos outros elementos, como caminhos (https://my-site.com/about), símbolos de cerquilha seguidos por uma sequência de caracteres (fragmentos, por exemplo: https://my-site.com#contact) ou pontos de interrogação seguidos por parâmetros (consultas, por exemplo: https://my-site.com?source=li&device=mobile).
Generalizando e combinando os elementos acima, podemos dividir uma URL em string nos seguintes componentes principais:
scheme://authority/path?query#fragment
Por exemplo, uma URL pode ter esta aparência: https://example.com:8042/over/there?name=ferret#nose
Em nossa pesquisa, analisamos como vários parsers implementaram diferentes RFCs. Embora o formato de URL acima pareça relativamente simples, os RFCs que o definem mudaram bastante desde 1994. Essas adições e revisões levaram à forma atual da URL que conhecemos.
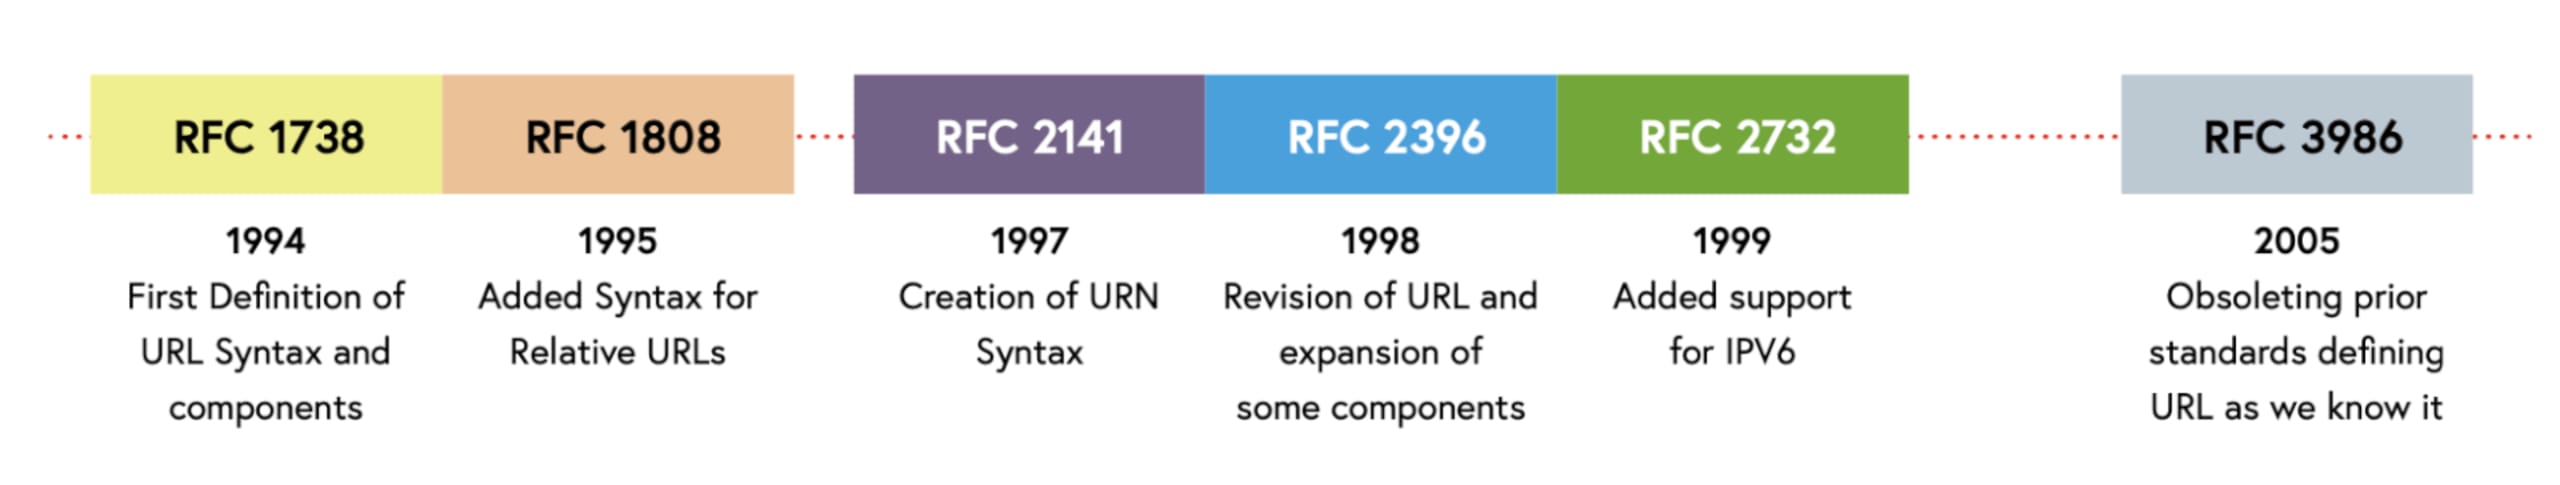
Saiba mais: RFC 1738, RFC 1808, RFC 2141, RFC 2396, RFC 2732, RFC 3986
Para entender onde os parsers se confundem, primeiro precisamos analisar (rapidamente) o significado de cada componente da URL completa e como ele é definido.
Esquema
A seção de esquema define o protocolo (por exemplo, HTTP, HTTPS, FTP, Gopher etc.). Os RFCs especificam quais caracteres podem aparecer nesse componente e determinam que o esquema atual deve seguir o padrão ALPHA *( ALPHA / DIGIT / "+" / "-" / "." ). Veja como isso funciona:
Primeiro caractere:
a–ZDemais caracteres:
a–Z,0–9,+,-,.
Isso significa que 1http não é um esquema válido (pois começa com um número), mas h2ttp é (pois o primeiro caractere precisa ser uma letra). Além disso, diferentemente dos outros componentes de uma URL, o esquema é o único obrigatório.
Autoridade (anteriormente Netloc)
Esse componente era chamado de “Netloc” (localização na rede) e passou a se chamar Autoridade. Ele é composto por três subcomponentes internos: informações do usuário, host e porta. De forma geral, uma autoridade tem esta estrutura: authority = [ userinfo "@" ] host [ ":" port ]. O subcomponente userinfo também pode ser dividido em seus componentes principais: username[:password]. Isso contempla URLs no formato scheme://user:password@domain:port/. Vale observar que, a partir da RFC-2396, o uso de user:password em texto simples passou a ser desaconselhado e foi descontinuado na RFC-3986.
Caminho
Esse componente indica quais recursos o solicitante quer acessar no servidor. Ele pode conter qualquer sequência de caracteres (exceto /,;,=,?), dividida em segmentos delimitados por /.
Embora pareça o componente mais simples, foi também o que mais mudou ao longo dos anos. A RFC-1738 e a RFC-1808 vinculavam a estrutura e as regras do componente de caminho ao componente de esquema. Depois, a RFC-2396 estabeleceu que cada segmento do caminho poderia usar ponto e vírgula (;) para definir parâmetros. Porém, pouco depois da RFC-2396, veio a RFC-3986, que descontinuou a sintaxe de parâmetros com ponto e vírgula.
Confuso? Pois os parsers também ficam!
Consulta
As consultas são pares de chave e valor transmitidos pela URL ao recurso solicitado. Os parâmetros da consulta vêm depois do primeiro ponto de interrogação (?) e terminam no sinal de cerquilha (#).
Em um componente de consulta, ponto e vírgula (;), barra (/), ponto de interrogação (?), dois-pontos (:), arroba (@), e comercial (&), sinal de igual (=), sinal de adição (+), vírgula (,) e cifrão ($) são caracteres reservados e serão codificados na URL quando usados.
Veja um exemplo de codificação de caracteres especiais em uma URL:
Fragmento
O fragmento é usado para identificar e acessar um segundo recurso dentro do primeiro recurso obtido, especificado pelo componente de caminho. Um componente de fragmento é indicado pela presença de uma cerquilha (#) e termina no fim da URI.
... e esses são todos os componentes!
URLs relativas
O último tópico desta seção são as referências relativas em URLs. Como as URLs são hierárquicas por natureza, uma URL pode ser relativa a outra. Por exemplo, dada uma URL “base” https://example.com/ e um segmento de string de URL iniciado pelo caminho, como /foo/bar, o parser vai resolvê-los como https://example.com/foo/bar. No entanto, primeiro é necessário fornecer a URL “base”.
Isso significa que os parsers precisam saber interpretar referências relativas. A RFC-3986 define três tipos de referências relativas:
Referência de caminho de rede — começa com
//, por exemplo,//example.comReferência de caminho absoluto — começa com
/, por exemplo,/etc/passwdReferência de caminho relativo — não começa com
/, por exemplo,foo/bar
Tipo de referência | Exemplo |
|---|---|
Caminho de rede | //snyk.io |
Caminho absoluto | /etc/passwd |
Caminho relativo | app/login.js |
Os dois últimos tipos precisam de uma URL base para serem resolvidos, enquanto a referência de caminho de rede precisa apenas que o esquema esteja presente. Portanto, se um parser usar HTTPS como esquema padrão, //example.com se transformará em https://example.com.
Onde os parsers de URL se confundem?
Depois de analisar todos os componentes de uma string de URL e revisar as mudanças nos RFCs ao longo dos anos, decidimos investigar parsers de URL e encontrar casos extremos que os levem a produzir resultados de parsing incorretos ou inesperados.
Durante nossa pesquisa, analisamos 15 bibliotecas (escritas em várias linguagens de programação), ferramentas para buscar conteúdo de URLs (por exemplo, curl e wget) e navegadores.
Encontramos muitas inconsistências entre os parsers e as classificamos em quatro categorias principais. Com as categorias descritas abaixo, podemos enganar a maioria dos parsers e criar vários comportamentos imprevisíveis, possibilitando uma ampla variedade de vulnerabilidades.
As categorias que definimos são:
Sem mais delongas, vamos analisá-las!
Confusão de esquema
Quase todos os parsers de URL existentes ficam confusos quando o componente de esquema está ausente. A confusão surge porque a RFC 3986 determina que o esquema é a única parte obrigatória da URL, enquanto a RFC 2396 e as anteriores não fazem essa exigência. Implementar parsers que também tentem manter a compatibilidade com versões anteriores diante dessas nuances não é simples — e é daí que vem a confusão.
Para demonstrar isso, veja quatro bibliotecas Python diferentes às quais foi fornecida a URL google.com/abc:

Como mostrado acima, a maioria dos parsers informa que o componente de host está vazio quando recebe a string google.com/abc. A Urllib3, porém, indica que o host é google.com e o caminho é /abc. Já a httptools afirma que essa URL é inválida. Em resumo, quase todos os parsers interpretam essa URL incorretamente, pois ela não segue as especificações dos RFCs.
Ainda assim, alguns parsers recorrem ao esquema padrão, como o curl neste caso:

Nesse caso, invasores podem explorar a diferença entre os parsers para contornar a validação. Se um parser de URL tentar validar hosts específicos, mas não conseguir interpretar a URL corretamente para extrair o host, enquanto a biblioteca subjacente conseguir interpretar a URL corretamente (ou recorrer ao esquema padrão), o contorno acontece. Por exemplo:

No exemplo acima, o urllib (mais especificamente, a função urlsplit) interpreta a URL como se não tivesse netloc, então a verificação é aprovada. Já o urllib3 recorre ao protocolo padrão http e busca o recurso proibido.
Confusão com barras
O próximo tipo de confusão envolve um número não padrão de barras na URL. A RFC 3986 determina que o componente de autoridade da URL deve vir depois de dois-pontos e duas barras, ://, e se estende até o fim da linha (EOL) ou até que um delimitador seja encontrado. Nesse caso, um delimitador pode ser uma barra (que indica o componente de caminho), um ponto de interrogação (componente de consulta) ou uma cerquilha (componente de fragmento).
Durante a pesquisa, observamos vários comportamentos dos parsers ao tentarem interpretar uma URL que não segue a sintaxe acima. Dada a URL http:///google.com, os parsers se comportaram de maneira interessante:

Como você pode ver, a maioria dos parsers afirmou que essa URL não tem host e interpretou /google.com como um caminho em uma URL sem host — o que é esperado de acordo com a RFC 3986. Conseguimos reproduzir esse comportamento com qualquer quantidade de barras depois do esquema. No entanto, encontramos um grupo de parsers que tentava “corrigir” a URL, ignorando barras extras ou ausentes (até certo ponto). Por exemplo, a função nativa fetch do JavaScript trata essas URLs como se estivessem corretas:

E isso também vale para curl:

Diferenças nos resultados de análise criam uma ampla superfície de ataque. Assim como na ideia de ataque anterior (confusão de esquema), e se fosse possível contornar as verificações porque o primeiro parser interpreta a URL de forma diferente do componente que busca o recurso? Veja este exemplo:

Mais uma vez, vemos uma asserção de netloc para um domínio bloqueado e, novamente, o netloc estará vazio devido à análise, então a verificação será aprovada. Mais adiante no código, o curl interpretará a URL de outra forma e tentará buscar o recurso inesperadamente. Isso pode levar a SSRFs e ao acesso a outros hosts não permitidos.
Confusão com barras invertidas
Uma variação da confusão com barras é a confusão com barras invertidas. Essa confusão pode ocorrer quando uma URL usa uma barra invertida (\) no lugar de uma barra (/), criando assim uma URL malformada. De acordo com a RFC 396, uma barra invertida é diferente de uma barra e deve ser interpretada de outra forma, fazendo com que http://google.com seja diferente de http:\\google.com. Seguindo a RFC, a maioria dos parsers de URL programáticos realmente interpreta essas duas URLs de maneira diferente:

O Chrome, porém, opta por interpretar a barra invertida como se fosse uma barra:

Ele acessará a URL como se ela fosse válida. Levando isso ao extremo, esse comportamento também ocorre com https:/\google.com, e o Chrome disponibilizará o recurso, como (in)esperado.
Confusão com codificação de URL
A última categoria de confusão é a confusão com codificação de URL. Ela ocorre quando uma URL contém um trecho codificado que não deveria estar ali.
Em geral, a codificação de URL é uma forma de incluir caracteres não imprimíveis nas URLs. Isso é feito usando o valor hexadecimal do caractere, precedido pelo símbolo %. Assim, um g é representado como %67 quando codificado em URL. Esse método permite que as URLs permaneçam totalmente textuais e legíveis, independentemente dos caracteres usados. Embora seja voltado a caracteres não imprimíveis, também é possível codificar caracteres imprimíveis em URLs — e é aí que surge a confusão.
A RFC 3986 estabelece que todos os componentes de uma URL, exceto o esquema, podem ser codificados. Na prática, porém, muitos parsers não analisam o componente netloc.
Estes são os resultados da análise quando fornecemos aos parsers a URL http://google.com na versão codificada:

Embora os resultados acima pareçam esperados, tanto o urllib quanto o requests do Python demonstraram um comportamento interessante ao receber uma URL codificada:

Nos dois casos acima, uma solicitação foi enviada inesperadamente para 127.0.0.1.
Diante disso, essa discrepância cria mais uma superfície de ataque, já que padrões simples de Regex não identificam essas strings e, assim, talvez seja possível contornar as verificações novamente.
Prova de conceito da exploração (e CVEs emitidos)
Agora que entendemos onde está a confusão, vamos ver como explorar esses problemas e as falhas que encontramos. Vamos detalhar uma CVE, mas a lista completa de CVEs está abaixo.
Clearance (Ruby): CVE-2021-23435: vulnerabilidade de redirecionamento aberto
Vulnerabilidades de redirecionamento aberto ocorrem quando um aplicativo web aceita uma entrada controlada pelo usuário que especifica a URL para a qual ele será redirecionado após uma ação, como o login. Para visualizar melhor o ataque, veja este diagrama:
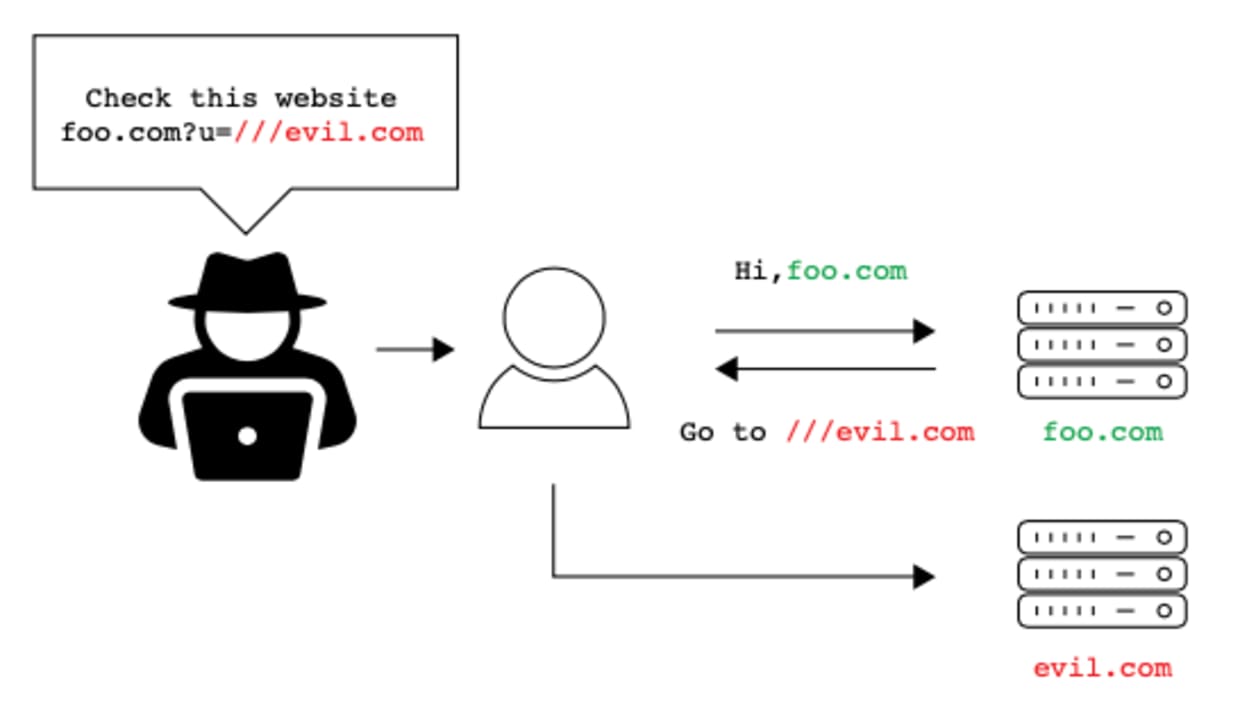
Como você pode ver, o invasor fornece à vítima uma URL para que ela a acesse. Com a configuração correta, o servidor redirecionará o usuário para um site controlado pelo invasor.
Clearance é uma gem do Ruby que aprimora o mecanismo de autenticação do framework Rails adicionando autenticação por email-and-password. Após o login ou logout, ela redireciona o usuário usando uma URL obtida de uma solicitação anterior (ou seja, o recurso solicitado antes da página de login).
O código vulnerável está dentro da função return_to (o callback executado após o login/logout):
Embora a função return_to tenha sido criada pensando em redirecionamentos abertos, ela não permite que os usuários forneçam livremente uma URL return_to. No entanto, se um usuário solicitar um recurso auth-required sem estar conectado, o sistema chamará store_location e redirecionará o navegador para a página de login. Portanto, se um invasor conseguir convencer uma vítima a clicar em um link como http://target.com/////evil.com, a vulnerabilidade será acionada.
Por que ocorre um redirecionamento aberto? Por causa de vários parsers!
Como vimos, store_location armazena o caminho completo da URL (isso também acontece porque o Ruby ignora várias barras consecutivas em URLs). Isso significa que ele armazena /////evil.com no cache. Quando URI.parse é chamado, ele remove duas barras extras, resultando em ///evil.com. Quando um navegador, como o Chrome, recebe essa URL, ele a trata como uma referência de caminho de rede e redireciona o cliente para http://evil.com.
Hoje, os navegadores tendem a “perdoar” esses erros em URLs e tentar corrigi-los porque, ao longo dos anos, precisaram lidar com muitas URLs imperfeitas ou incompatíveis com a RFC. Para serem resilientes a erros de clientes e desenvolvedores, eles passaram a omitir ou adicionar barras em erros comuns.
Este é um trecho do código-fonte do projeto Chromium:
Outras vulnerabilidades
Veja outras vulnerabilidades causadas por diferenças entre parsers:
Flask-security (Python, CVE-2021-23385)
Flask-security-too (Python, CVE-2021-32618)
Flask-User (Python, CVE-2021-23401)
Flask-unchained (Python, CVE-2021-23393)
Belledonne’s SIP Stack (C, CVE-2021-33056)
Video.js (JavaScript, CVE-2021-23414)
Nagios XI (PHP, CVE-2021-37352)
Clearance (Ruby, CVE-2021-23435)
Recomendações para evitar confusão com URLs
Como os problemas discutidos nesta publicação são causados pelo uso de vários parsers e pela forma como eles funcionam, é importante saber quais parsers estão presentes no seu aplicativo ao construí-lo. Isso se torna mais complexo nas arquiteturas atuais, como microsserviços e malhas de serviços, e pode levar algum tempo para entender por completo quais componentes fazem a análise no seu aplicativo e como uma solicitação percorre o sistema.
Depois de mapear os parsers, é essencial que os desenvolvedores entendam bem as diferenças entre a lógica de análise de cada um, para que possam trabalhar com eficiência sem comprometer o aplicativo.
Em geral, recomendamos o seguinte:
Use o menor número possível de parsers diferentes. Assim, você reduz a superfície de “confusão” e diminui a quantidade de problemas de análise possíveis.
Use um único ponto de análise em sistemas descentralizados. Se uma solicitação passar repetidamente por vários componentes do sistema, há uma boa chance de diferentes parsers serem acionados, por exemplo, devido a serviços desenvolvidos em linguagens diferentes. Para reduzir esse risco, você pode analisar a URL uma única vez no ponto de entrada das solicitações e encaminhar a solicitação já analisada. Dessa forma, apenas um parser será usado durante todo o percurso da solicitação.
Entenda as diferenças entre os parsers usados pela lógica de negócios. Como às vezes precisamos analisar URLs como parte do código ou da lógica de negócios, é importante que os desenvolvedores que trabalham no recurso entendam as variações entre os parsers, conforme explicado acima.
Leia o white paper sobre confusão de URLs
Entenda melhor os diferentes tipos de confusão de URLs lendo o white paper.