RPM Package Manager: verificação de segurança de pacotes RPM com o Snyk

Ivan Stanev
13 de novembro de 2020
0 minutos de leituraAo verificar imagens de contêiner, o Snyk consegue detectar várias informações, como a distribuição do sistema operacional, o gerenciador de pacotes de software, os aplicativos instalados e todas as dependências deles. O RPM é um dos gerenciadores de pacotes mais comuns no ecossistema Linux e tem suporte completo no Snyk.
O que é o RPM Package Manager?
O RPM é usado em muitas distribuições Linux, incluindo Red Hat Enterprise Linux, Fedora, CentOS e outras. Ele surgiu no Red Hat Linux e, originalmente, era a sigla de RedHat Package Manager. Hoje, porém, é um acrônimo recursivo que significa RPM Package Manager. RPM pode se referir tanto ao gerenciador de pacotes quanto ao formato de arquivo rpm usado para distribuir aplicativos.
Qual formato de dados o RPM usa?
É particularmente desafiador trabalhar com o RPM Package Manager porque ele não lista as dependências em um formato legível por humanos, como JSON ou XML. Em vez disso, os pacotes são armazenados em formato binário em um banco de dados BerkeleyDB. Assim, não é possível ler esses pacotes sem conhecer o formato binário e a estrutura corretos tanto do banco de dados quanto de suas entradas.
Havia código de código aberto disponível para ler o banco de dados RPM, mas não podíamos usá-lo facilmente no Snyk, pois nossa pilha tecnológica é baseada em Node.js e TypeScript. É possível compilar e usar vínculos em C para BerkeleyDB, mas queríamos evitar o trabalho extra de compilação cruzada e manutenção. Além disso, precisávamos apenas de uma biblioteca para ler pacotes RPM, um subconjunto minúsculo dos recursos oferecidos pelo RPM e pelo BerkeleyDB.
Graças à magia do código aberto, a licença do BerkeleyDB usada no RPM nos permitia ler e modificar o código livremente. Por isso, optamos por recriar essa funcionalidade por conta própria. No fim, resolvemos o desafio e lançamos uma biblioteca TypeScript totalmente de código aberto, que você encontra no nosso repositório Snyk rpm-parser no GitHub.
Nesta publicação, quero compartilhar como fizemos isso e explicar o processo de análise dos componentes internos do banco de dados RPM. Prepare-se para mexer com bits e bytes em baixo nível! ?ï¸
Qual é a aparência de um banco de dados RPM?
Sabemos que o BerkeleyDB é um banco de dados binário. Então, como podemos extrair conteúdo relevante? Em geral, detectamos formatos de arquivo binário examinando o início do arquivo, onde pode haver um marcador especial (por exemplo, um “número mágico”) que indica o tipo do arquivo. A melhor forma de descobrir isso é ler o código-fonte e testar com uma cópia do banco de dados RPM. O banco de dados BerkeleyDB criado pelo RPM fica em /var/lib/rpm/Packages, então nosso primeiro passo é inspecionar o conteúdo desse arquivo. O código-fonte do BerkeleyDB mostra que os primeiros bytes do arquivo contêm o seguinte:
O BerkeleyDB oferece suporte a vários tipos de banco de dados: B-Tree, Hash (HStore) e Queue, além de outros tipos nas versões mais recentes. Cada tipo de banco de dados tem um número mágico diferente: 0x053162 para B-Tree, 0x061561 para Hash e 0x042253 para Queue. Descobrimos que todo banco de dados RPM que abrimos é do tipo Hash, pois encontramos o número mágico 0x061561 a partir do byte 12 do arquivo /var/lib/rpm/Packages. Além disso, o campo type armazena o valor 0x08, que as definições de tipos do código-fonte listam da seguinte forma:
O campo pagesize e o campo last_pgno (número da última página) que vem em seguida, na definição do tipo, indicam que o banco de dados é dividido em páginas de mesmo tamanho. Isso também significa que itens individuais podem se estender por várias páginas e que elas provavelmente não estão em ordem (como veremos mais adiante, ao analisá-las).
Esse metadado genérico do banco de dados é compartilhado por todos os tipos. Por isso, a seção inicial _dbmeta33 é ampliada conforme o tipo de banco de dados. Como estamos interessados apenas no banco de dados Hash, temos os seguintes dados adicionais:
O campo nelem (número de elementos) também nos permite saber quantos elementos há no banco de dados. Já iv (vetor de inicialização) e chksum (soma de verificação) sugerem que talvez haja criptografia.
Se lermos esses bytes e os armazenarmos em um objeto JavaScript que possamos imprimir depois, teremos algo assim:
Descobrimos que o RPM não usa criptografia no banco de dados, pelo menos não por padrão. Portanto, podemos ignorar completamente esse caso.
Até aqui, temos a seguinte representação da estrutura do banco de dados:
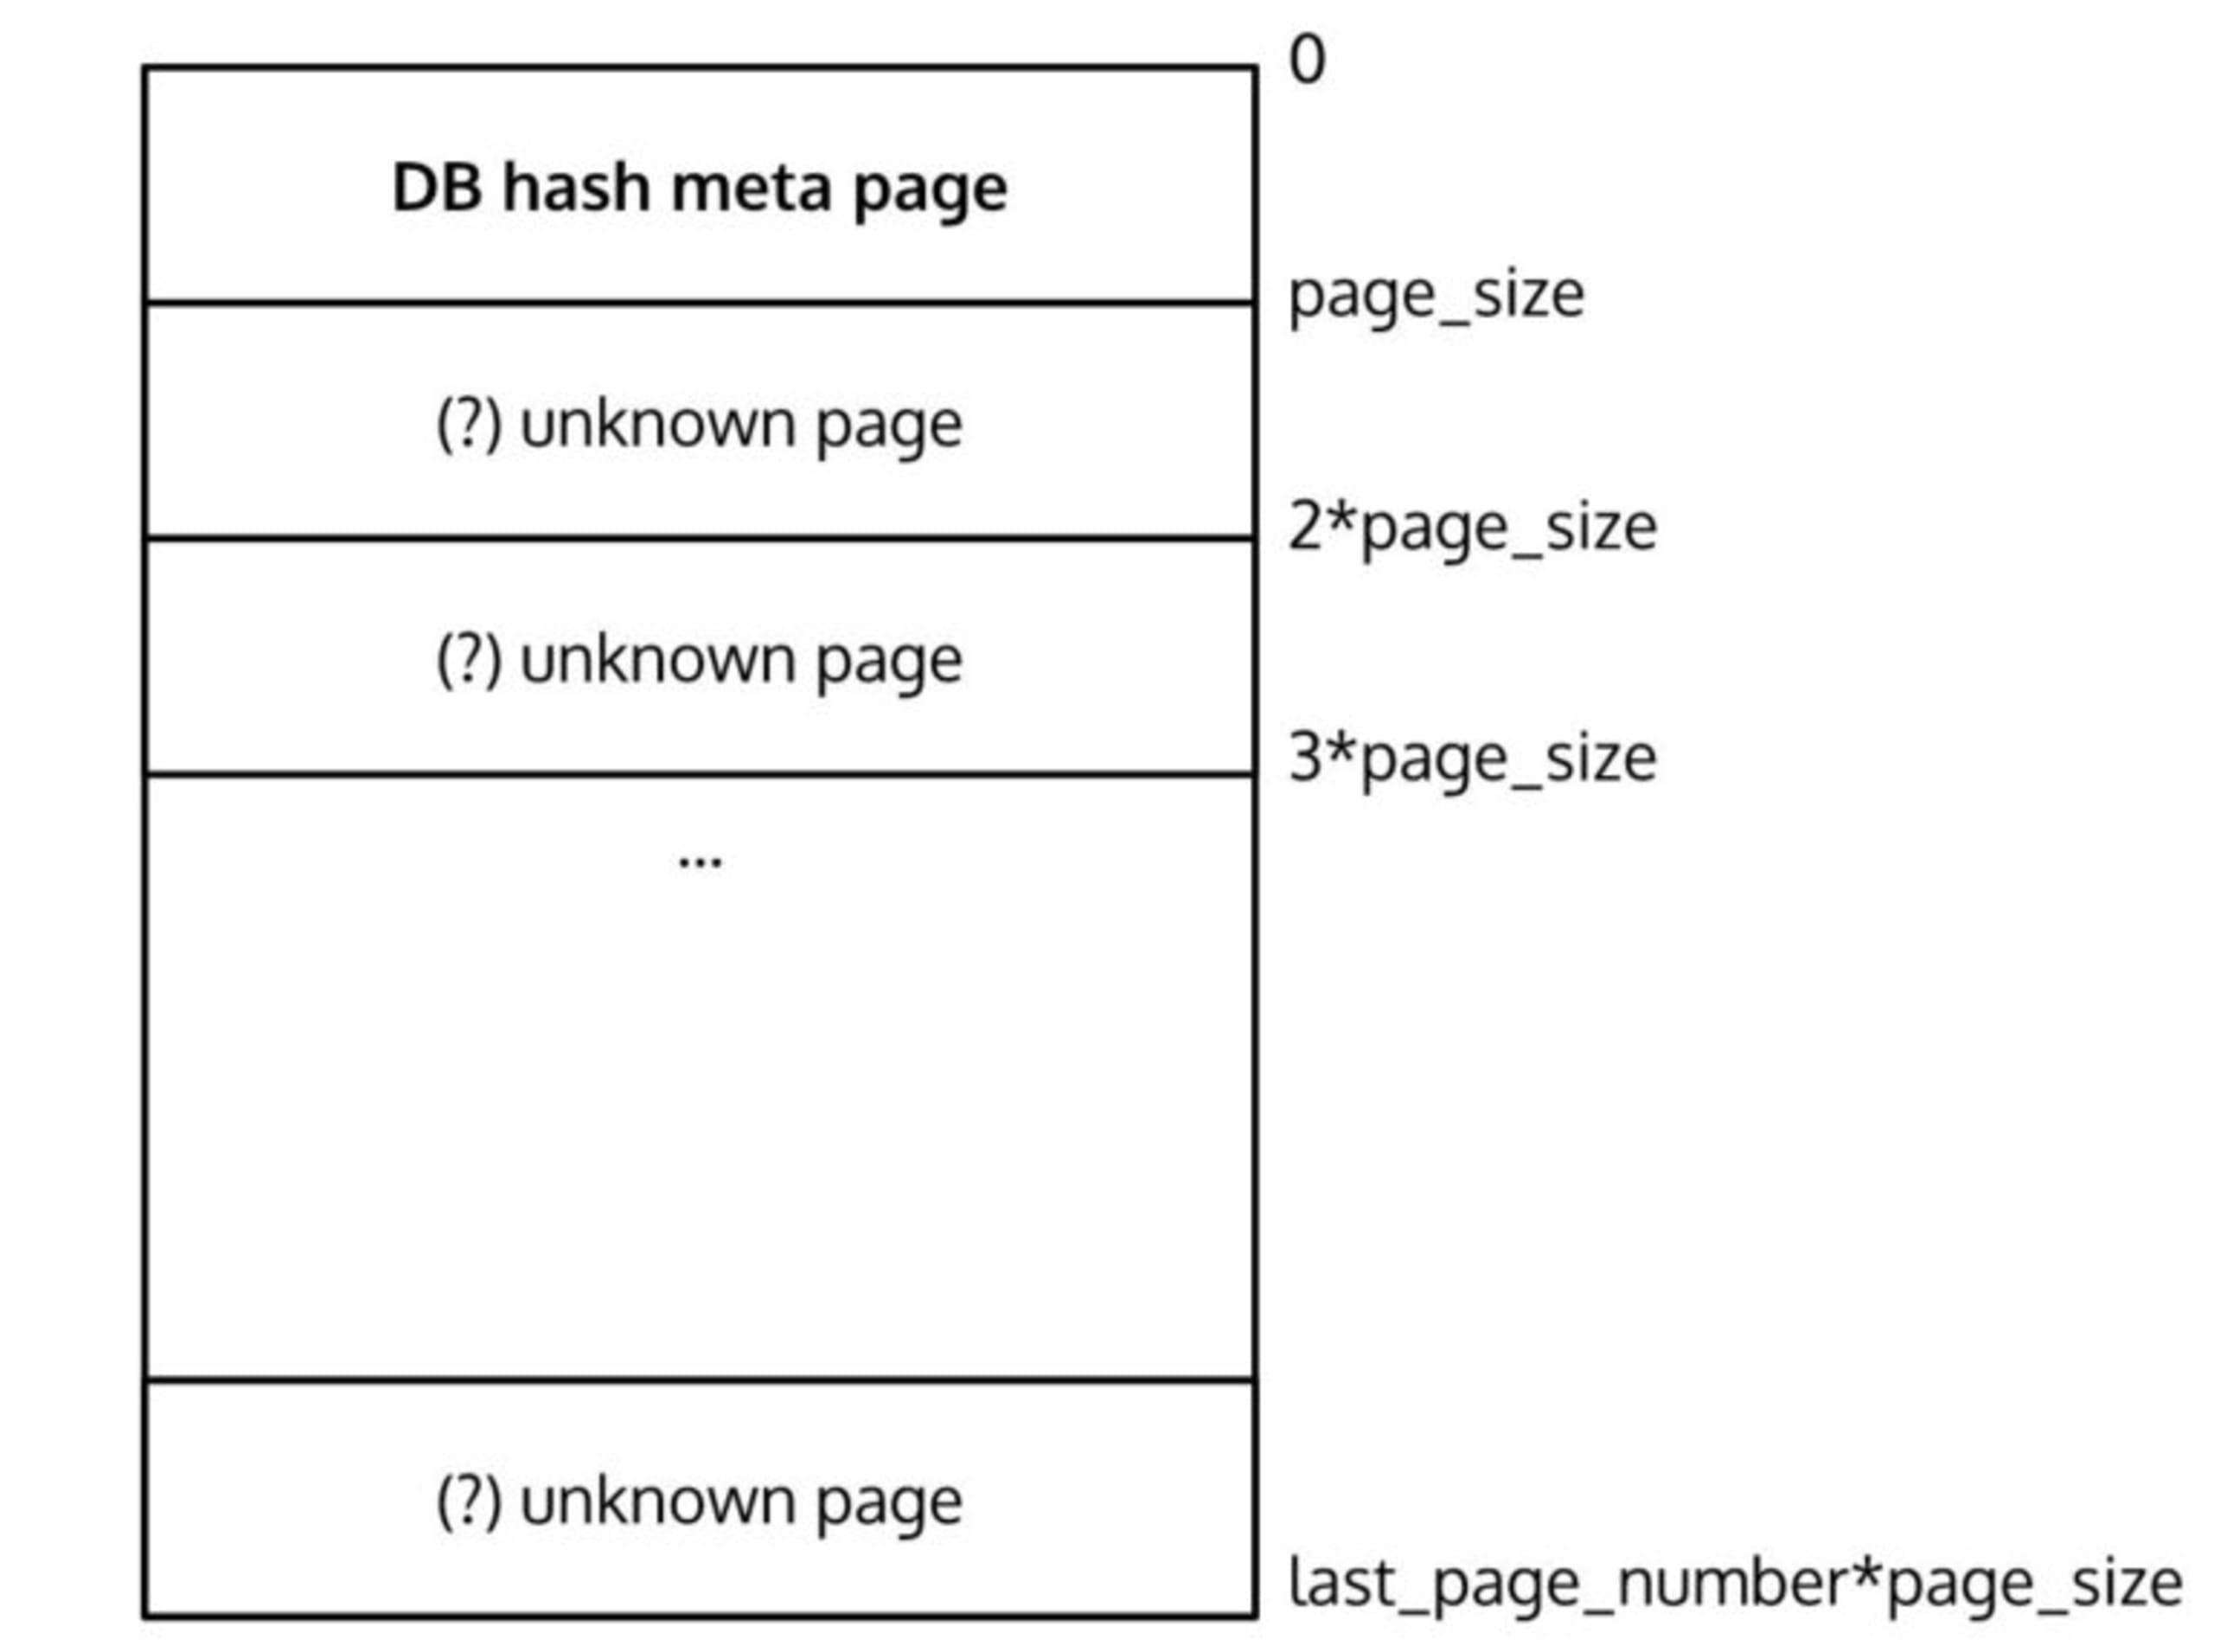
Como uma página tem 4096 bytes e a primeira página contém os metadados do banco de dados, vamos para a página seguinte e ver que tipo de dados podemos esperar. O código-fonte do BerkeleyDB também é muito útil e indica que devemos esperar a seguinte estrutura:
As definições de tipos informam o tamanho de cada uma dessas entradas. Assim, lendo a quantidade certa de bytes, podemos mapeá-los para um objeto JavaScript e obter o seguinte:
Observe type: 13, que indica um tipo de página totalmente novo, listado assim nas definições de tipos:
Os campos prev_pgno e next_pgno estão definidos como 0. Isso significa que os dados (seja lá o que forem) estão todos armazenados nesta página e não precisamos buscar outras páginas para reuni-los.
Observe o valor de hf_offset. Ao analisar todos os dados armazenados na página, vemos que os bytes próximos à posição ~2850 estão zerados, o que corresponde ao valor de hf_offset. Isso significa que hf_offset aponta para onde os dados terminam na página. Isso será especialmente útil mais adiante, quando lermos itens de dados distribuídos por várias páginas e precisarmos saber onde os dados começam e terminam.
Assim, cada página começa com um cabeçalho genérico de 26 bytes, e os 4070 bytes restantes são preenchidos parcial ou totalmente com dados. A página do tipo Hash contém um índice com entradas que apontam para determinados bytes ou deslocamentos na página atual. Esses deslocamentos indicam dados na extremidade oposta da página. A forma como esses dados são armazenados na página Hash lembra a estrutura de uma pilha e de um heap:
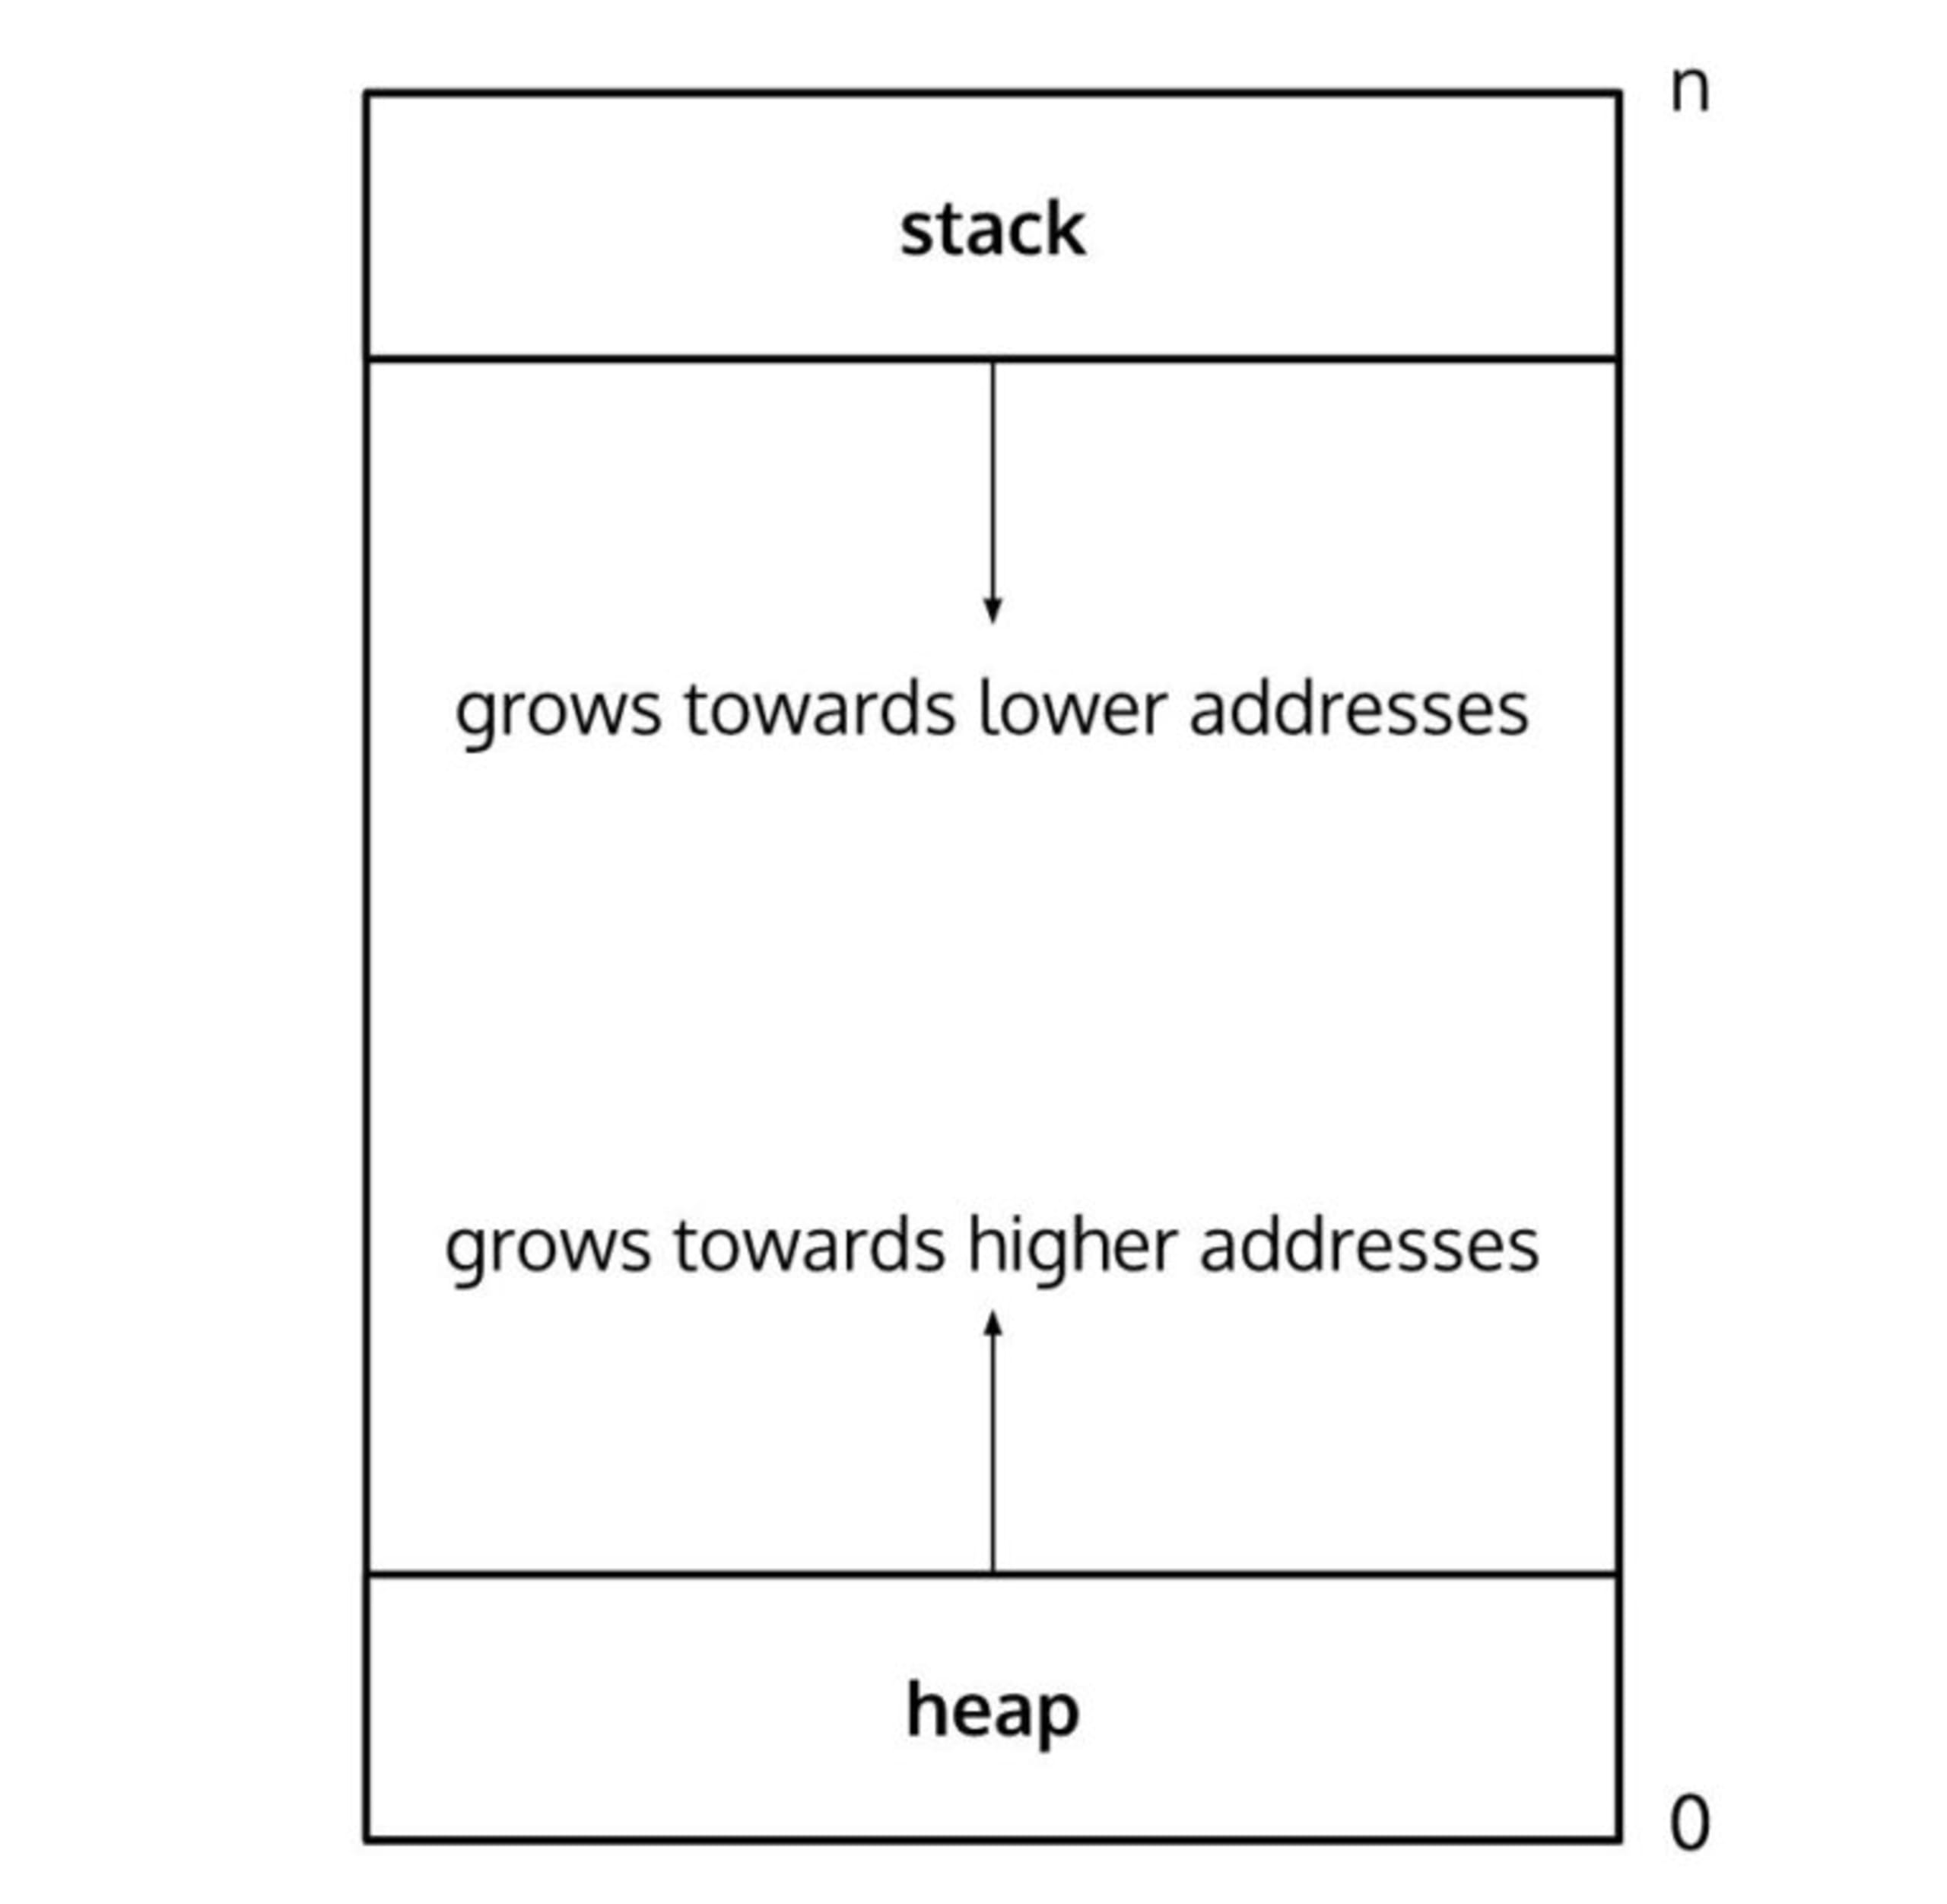
O índice fica na região do heap da página, enquanto os dados (apontados pelos deslocamentos do índice) ficam na região da pilha.
O índice contém entradas organizadas em pares de chaves e valores, uma após a outra. A chave é um identificador interno do banco de dados; o valor aponta para um deslocamento dentro da página atual. Podemos encontrar uma definição de tipo que nos ajuda a interpretar o que está armazenado em cada deslocamento:
Com esses dados, podemos determinar onde esse item está armazenado no BerkeleyDB ou, pelo menos, onde começa. Os dados começam em um número de página específico e podem ocupar várias páginas se o comprimento ultrapassar o tamanho de uma página (lembra do pagesize que lemos na página 0?).
Até aqui, temos a seguinte representação do banco de dados:
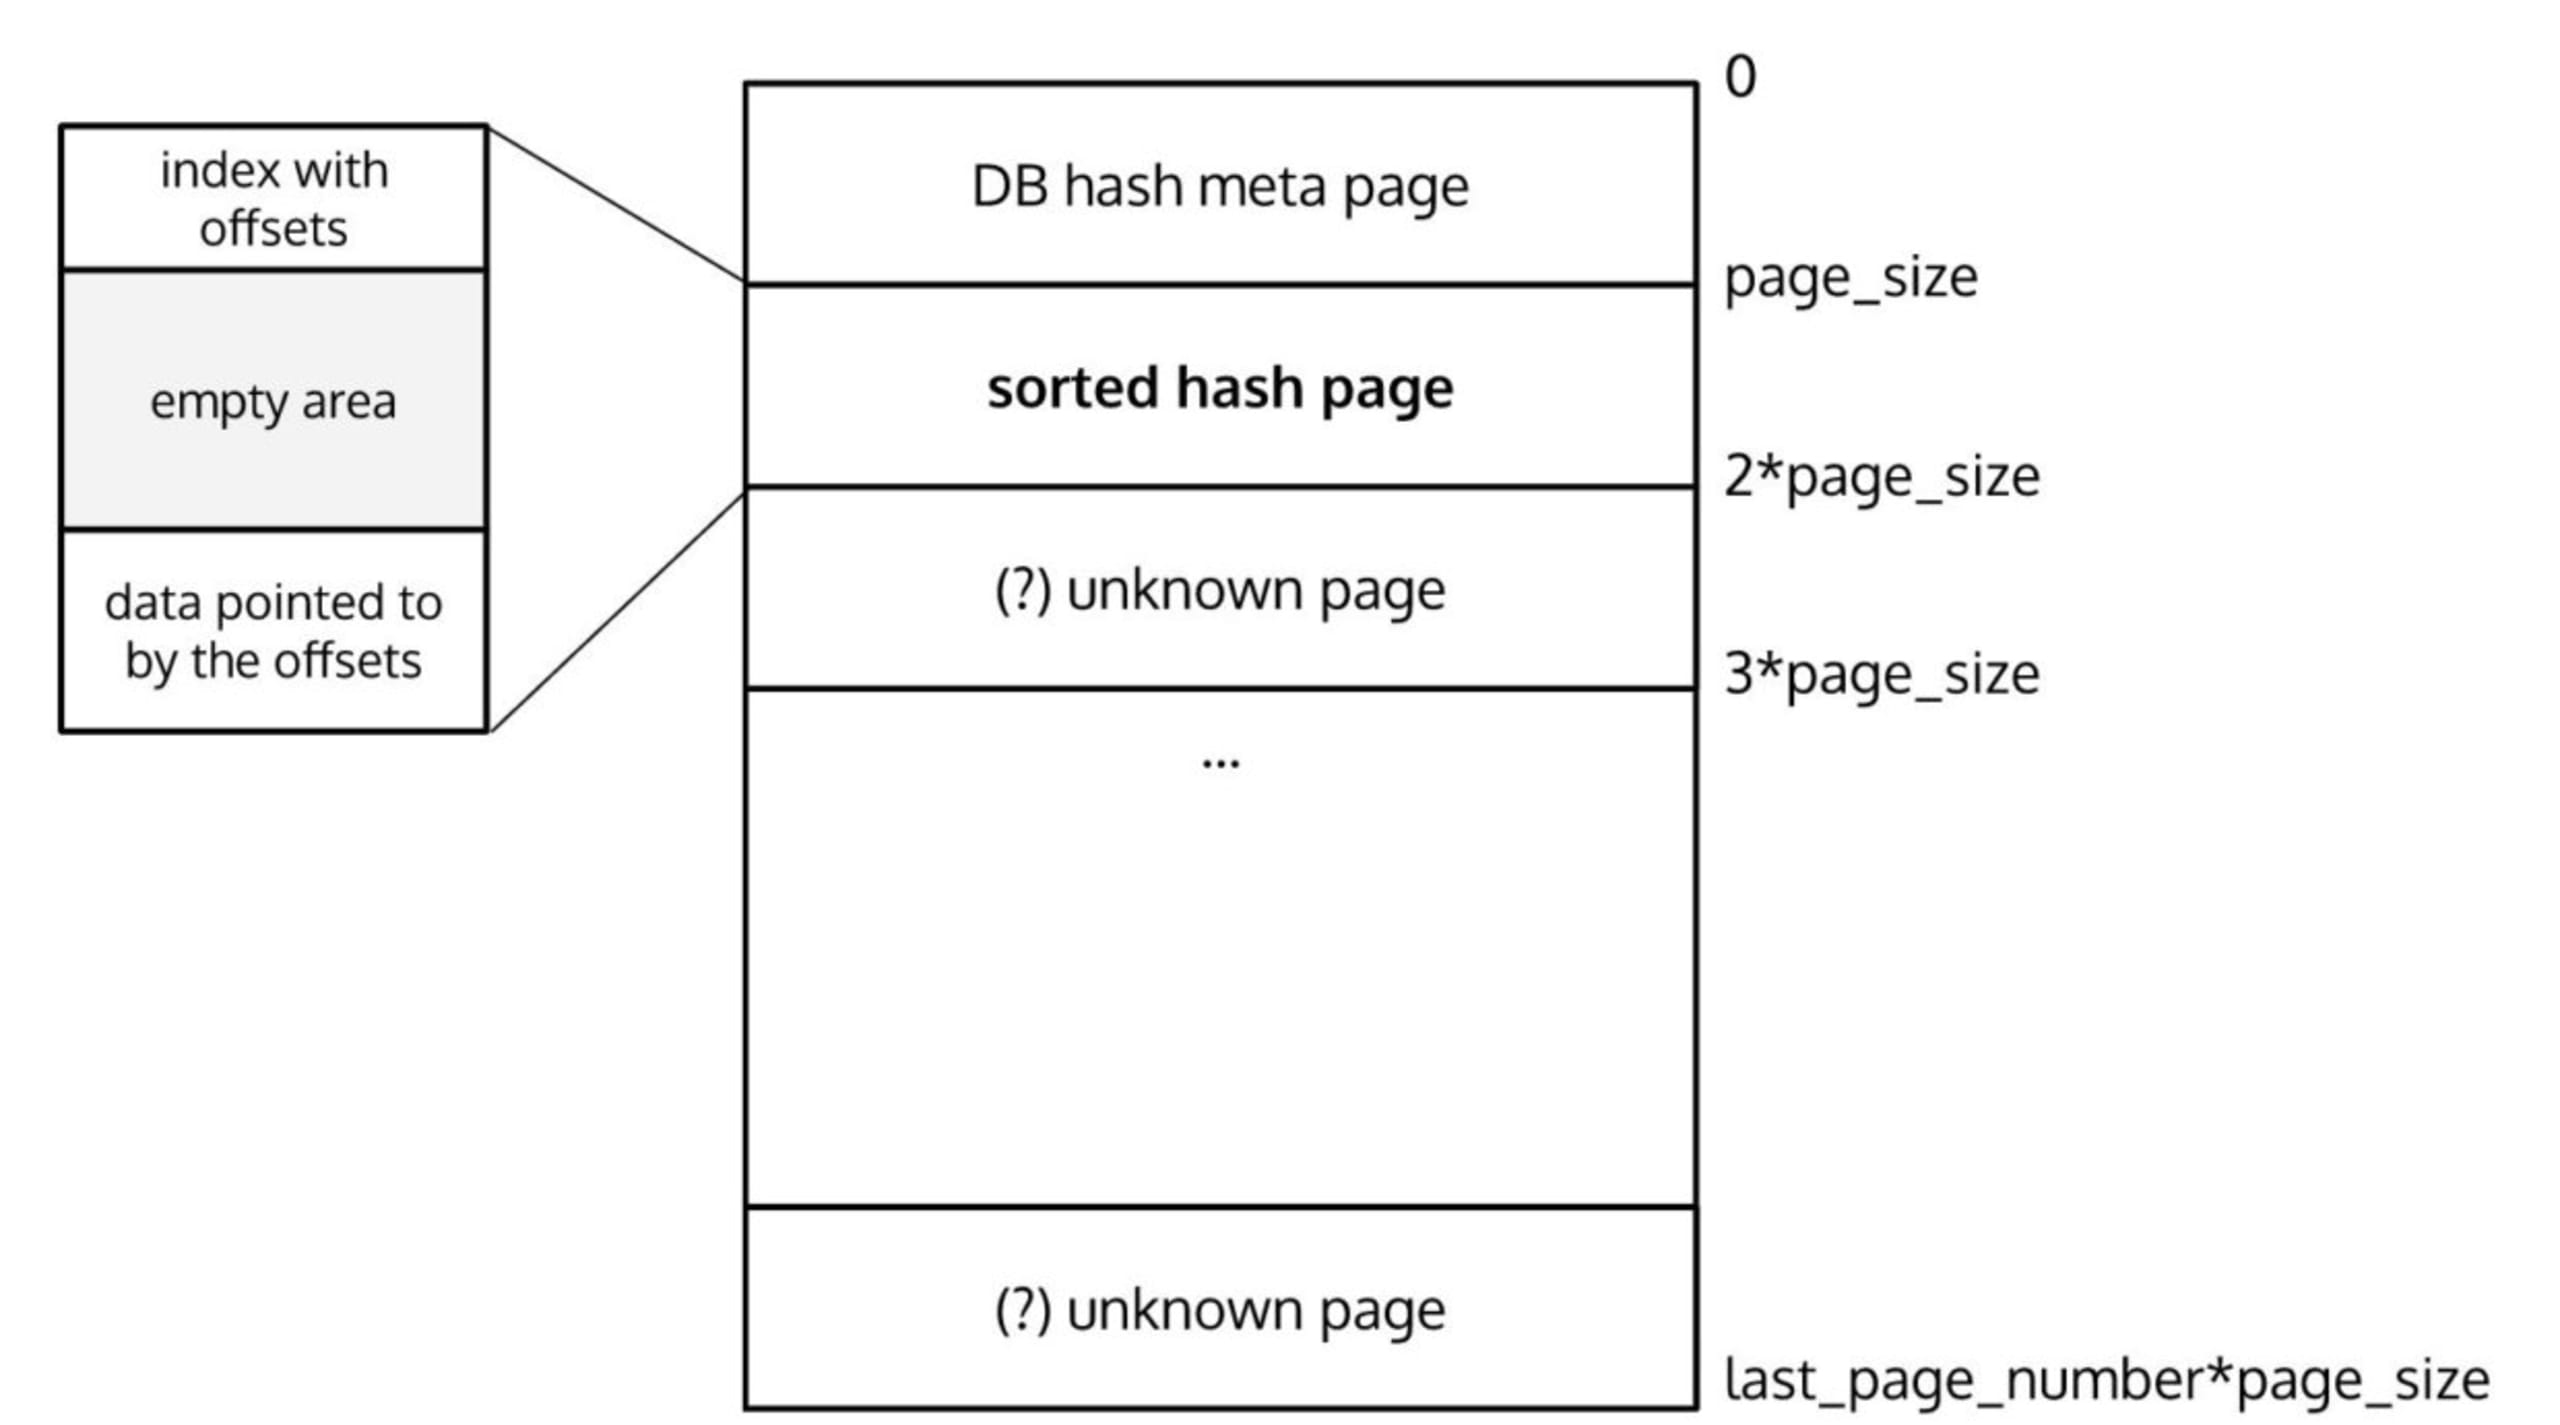
Agora, vamos pegar uma entrada do índice de dados (representada por struct __hoffpage) e examinar a página para a qual ela aponta. Podemos carregar essa página, já que sabemos seu número e o tamanho de cada página, e ver o conteúdo:
Observe que next_pgno tem um valor e aponta para a próxima página, que contém o restante dos dados. hf_offset tem o valor 4070, o que significa que esta página está totalmente preenchida com dados (são 4070 bytes porque o tamanho da página é 4096 bytes menos os 26 bytes do cabeçalho genérico). Portanto, para obter todos os dados, precisamos percorrer várias páginas seguindo next_pgno e reunir todos os bytes.
A representação final do banco de dados fica assim:
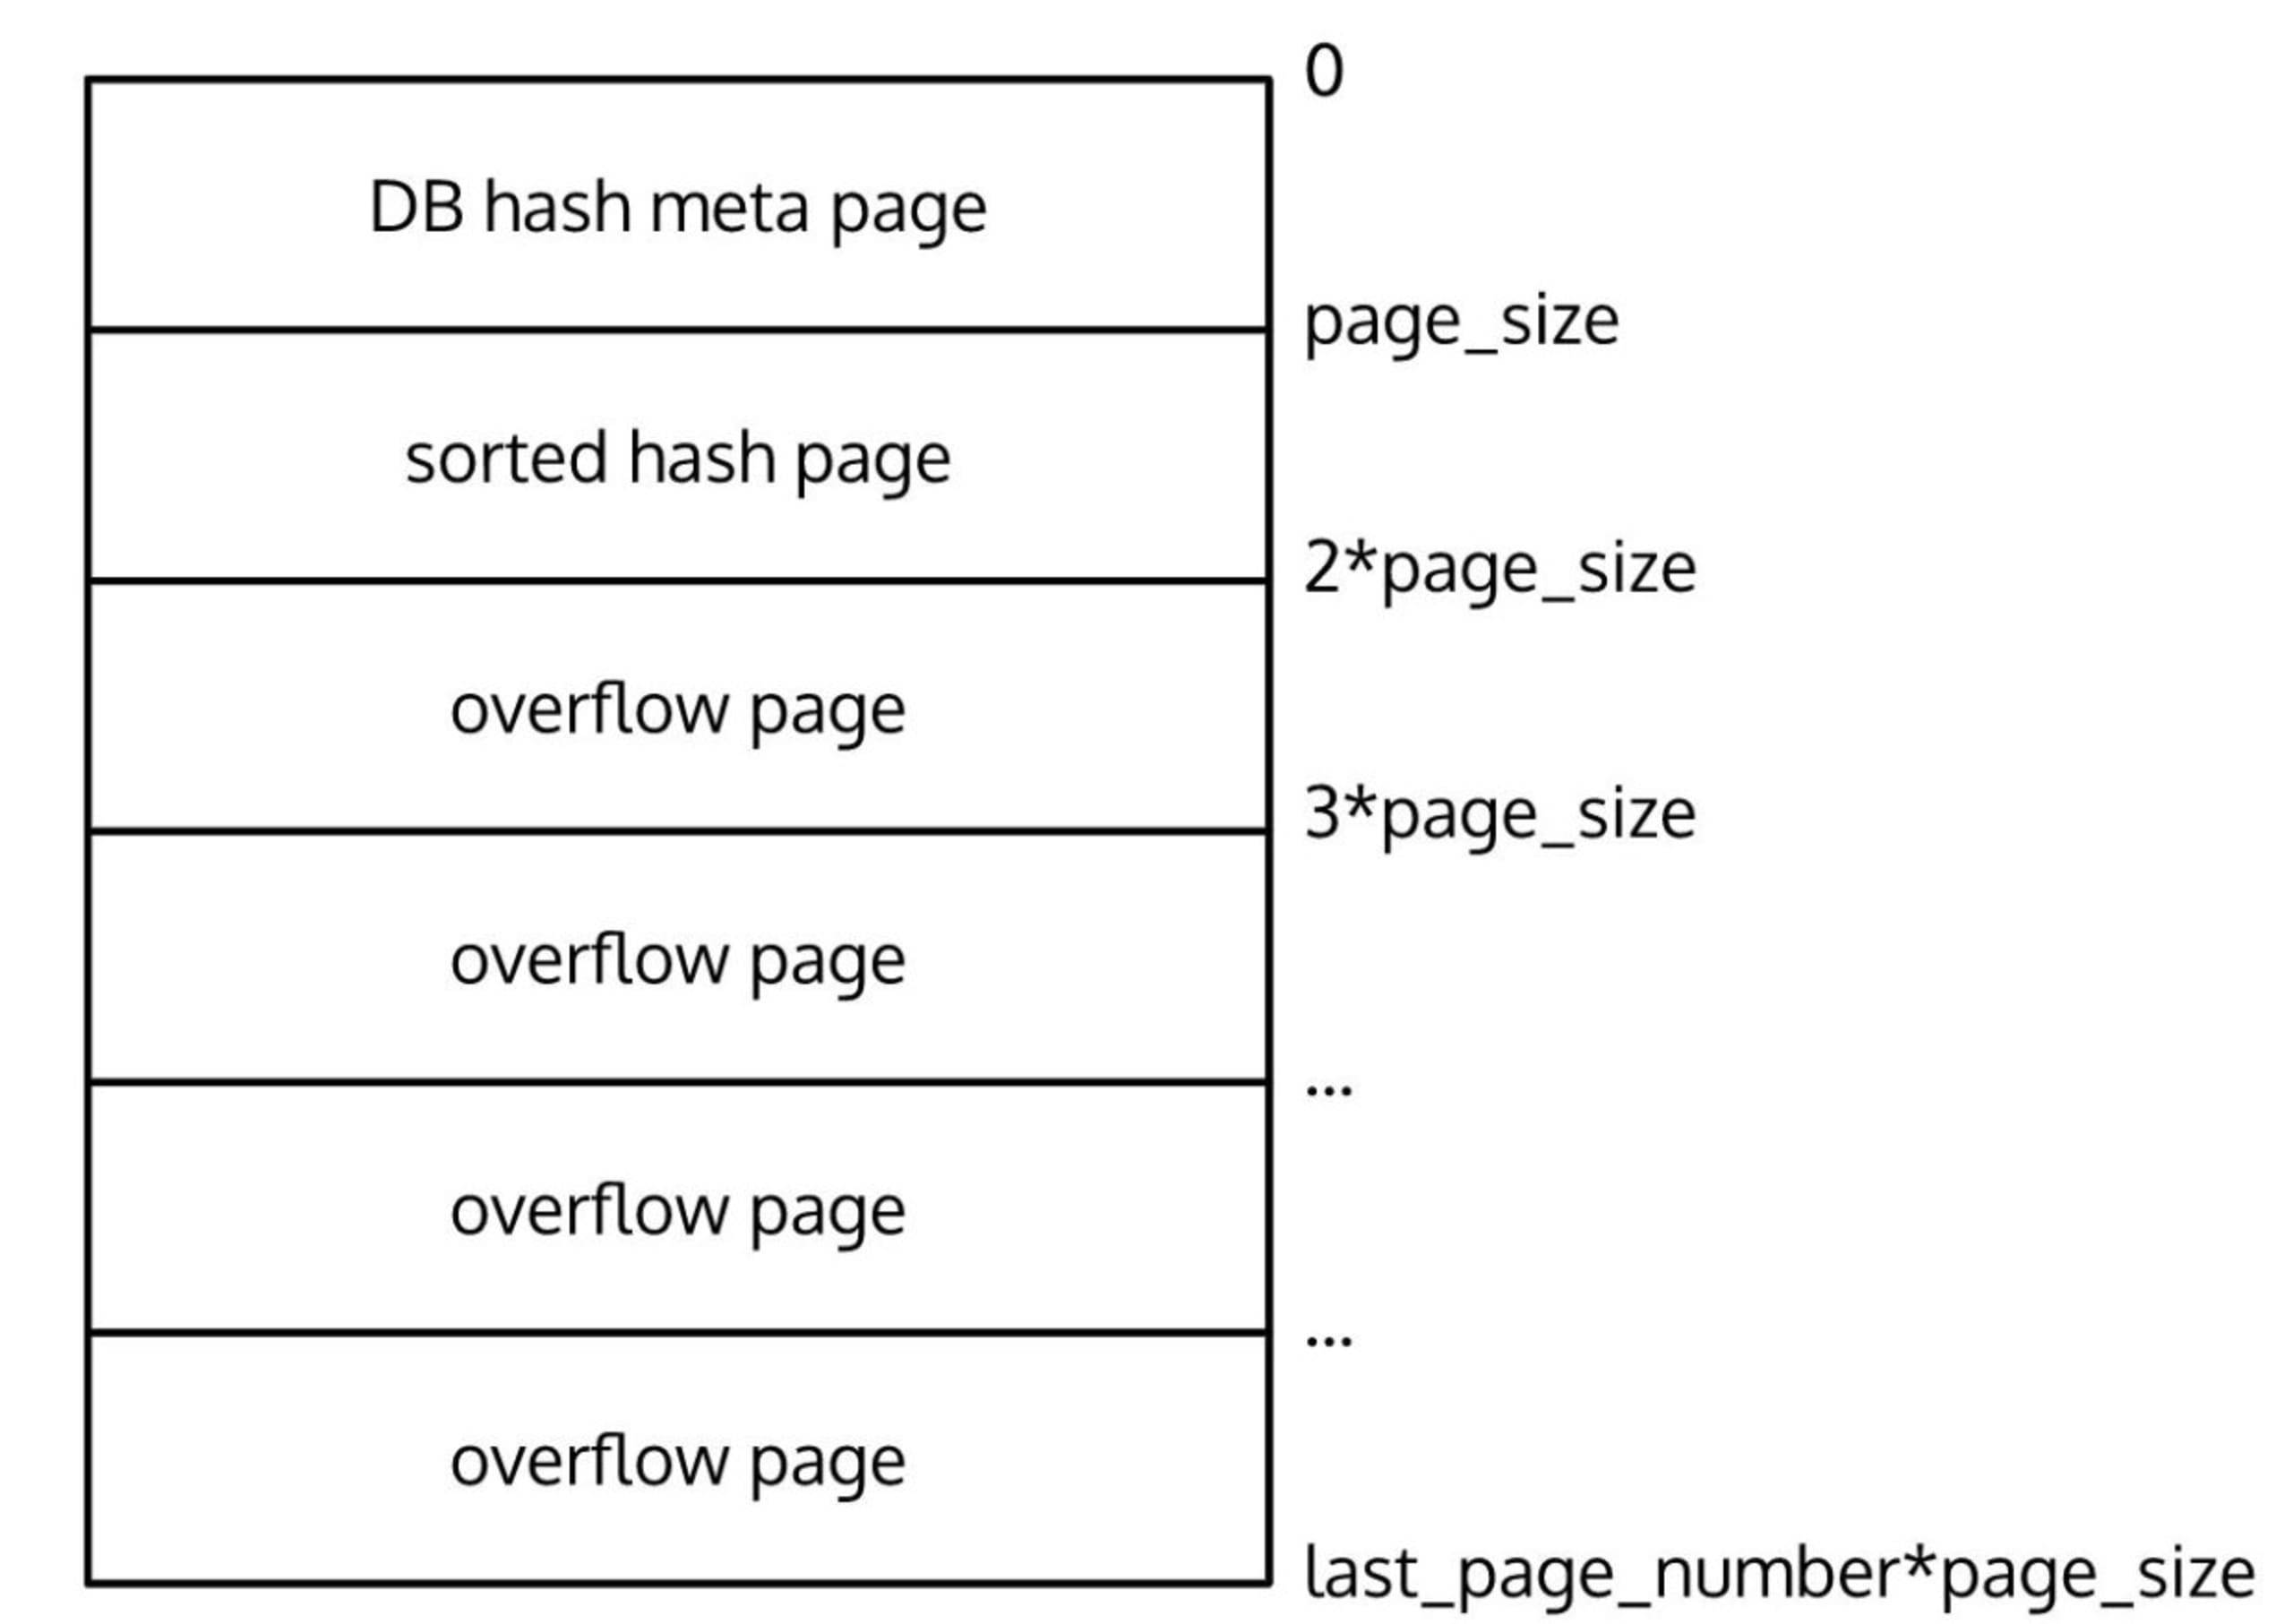
Com isso, já sabemos tudo o que precisamos para ler os dados! Depois de percorrer todas as páginas de overflow conectadas, reunimos uma lista de blobs binários, que correspondem aos pacotes RPM. O próximo passo é ler os pacotes para extrair informações como nome, versão, arquitetura e outros dados.
Análise dos metadados de pacotes RPM
Agora deixamos o contexto do BerkeleyDB e passamos ao formato dos pacotes RPM e de seus metadados. Para entender a estrutura de um pacote RPM, consultamos a documentação do formato de arquivo RPM.
Um arquivo rpm é composto por quatro seções: um lead, um cabeçalho de assinatura, um cabeçalho de payload e um payload (os dados em si). As duas seções de cabeçalho têm o mesmo formato, descrito nas seções a seguir. Elas aparecem uma após a outra no arquivo, sem informações adicionais antes, entre ou depois delas.
Após algumas tentativas, descobrimos que o BerkeleyDB armazena nos blobs binários, na verdade, estes dois itens: um cabeçalho parcial de payload e um payload completo. O lead e o cabeçalho de assinatura são totalmente omitidos. Na documentação do RPM, vemos que a estrutura do cabeçalho de payload é assim:
Descobrimos que todas as entradas HMx (header magic), a versão e os bytes reservados também estão ausentes! Em vez disso, recebemos um cabeçalho parcial que inclui o indexcount (número de entradas no índice do cabeçalho), o storesize (tamanho do repositório de dados em bytes), as entradas do índice e o repositório de dados.
Vale observar que os dados são armazenados no formato big-endian, então cada entrada precisa ser lida e interpretada explicitamente dessa forma.
Até aqui, os blobs binários que coletamos do BerkeleyDB podem ser representados assim em pseudocódigo:
Podemos ler facilmente os dois primeiros itens, mas, para ler index_entries, precisamos entender sua estrutura. A documentação do formato de arquivo RPM explica o seguinte:
Cada index_entry tem 16 bytes. Com essa informação e o valor de indexcount, podemos coletar todas as entradas do cabeçalho RPM.
Agora podemos ler todas as entradas do índice em JavaScript e gerar uma lista parecida com esta:
Na documentação do RPM, encontramos uma tabela com o significado de cada valor de tag. As tags especificam informações do pacote, como nome (1000), versão (1001), arquitetura (1022) e assim por diante. A documentação do RPM também informa o type. Entre as entradas, encontramos tipos como string (6), int32 (4) e até o tipo null (0).
Agora, usando o offset, podemos ir até o início dos dados de cada entrada, lembrando de incluir também o indexcount no cálculo do deslocamento para chegar à posição correta. E, com base no valor de type, podemos processar de uma forma específica a sequência de bytes seguinte. Por exemplo, para tipos string, podemos ler os bytes até encontrar um byte 0, que marca o fim da string (como é comum em softwares escritos em C). Já para um tipo int32, sabemos que devemos ler apenas 4 bytes.
Com todas essas informações, podemos percorrer todas as entradas do índice e extrair dados suficientes do pacote para criar uma dependência. Veja um exemplo de entrada:
Repetindo o mesmo processo para todos os blobs do BerkeleyDB, extraímos as informações de todos os pacotes e geramos a lista de dependências.
Resumo
Analisamos a fundo o funcionamento interno do RPM Package Manager para entender a estrutura binária dos dados e como as informações sobre os pacotes instalados são representadas internamente. É exatamente assim que o Snyk lê e interpreta a lista de dependências nas imagens de contêiner. O Snyk é gratuito, e você pode criar uma conta. Também confira nossa biblioteca de código aberto, o RPM parser no GitHub, que faz todo esse trabalho pesado!
Comece a resolver desafios de capture the flag
Aprenda a resolver desafios de capture the flag assistindo sob demanda ao nosso workshop virtual introdutório.