Desempenho no OPA Rego: avaliação bottom-up e top-down

29 de abril de 2021
0 minutos de leituraNeste post, vamos falar um pouco sobre como funciona a avaliação do Rego e como ela afeta o desempenho. Rego é uma DSL para criar políticas. Ela não se limita a um único tipo de política (por exemplo, RBAC): é bastante genérica, o que permite compartilhar políticas entre diferentes serviços e stacks. Descobrimos que o Rego é ideal para a segurança da infraestrutura em nuvem no Fugue e para a segurança de infraestrutura como código no nosso projeto de código aberto, Regula.
O Rego é baseado em Datalog, uma linguagem declarativa. Em termos intuitivos, isso significa que o programador especifica os resultados desejados, mas não necessariamente como eles são calculados. Isso contrasta com linguagens imperativas, como JavaScript e Python, nas quais o programador sempre fornece o algoritmo exato.
Essa distinção nem sempre é clara: a maioria das linguagens declarativas tem alguma forma de indicar como algo deve ser calculado (como mostraremos neste post), e é possível criar DSLs declarativas em linguagens imperativas. De qualquer forma, o Rego está bem mais próximo do lado declarativo do espectro.
Como o programador não precisa especificar como um resultado é calculado, o compilador ou interpretador tem mais liberdade. Para linguagens como Rego, há duas estratégias importantes: bottom-up e top-down.
Com um exemplo simples, vamos explicar as duas estratégias e falar sobre suas vantagens e desvantagens.
Um exemplo
Imagine que estamos escrevendo uma política para garantir que as permissões de gravação sejam definidas de forma granular. Nossa entrada poderia ser parecida com esta:
Algumas dessas funções têm o que vamos chamar de permissões de gravação perigosas: write: *. Na nossa política, queremos exibir um erro para cada usuário ao qual uma função perigosa foi atribuída.
Definimos duas regras:
dangerous_roles:um conjunto que contém todas as políticas comwrite: *deny: um conjunto com todas as mensagens de erro
Veja a política completa:
Podemos verificar se o resultado esperado aparece usando opa eval:
Com esse exemplo em mente, vamos analisar a avaliação bottom-up e top-down.
Bottom-up
Acho mais fácil entender a diferença entre essas duas estratégias de avaliação visualizando a árvore de dependências das regras:
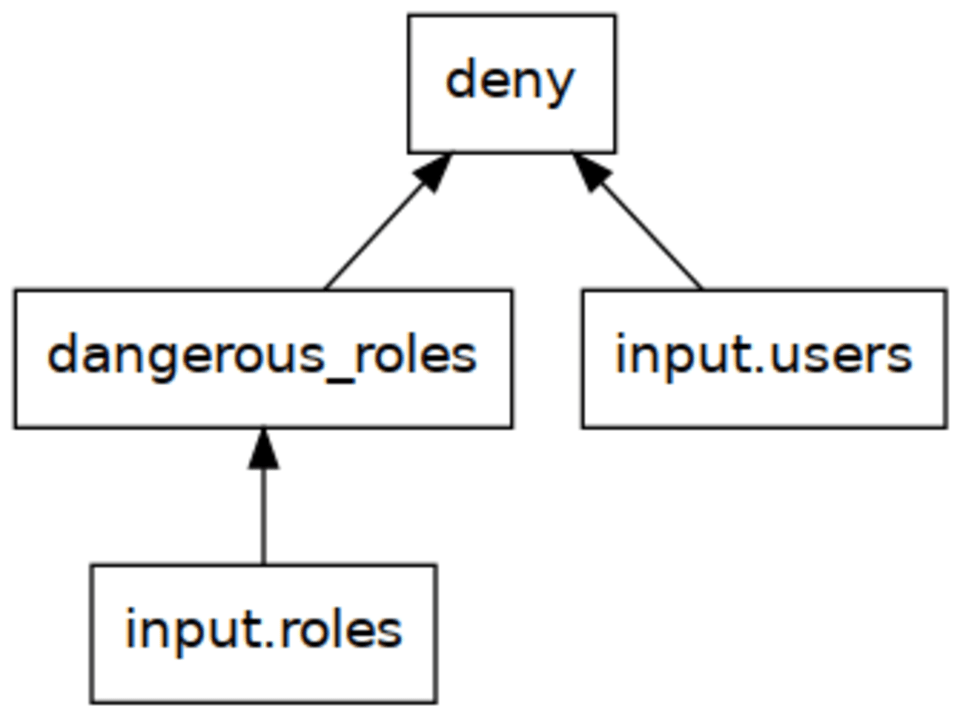
deny depende de dangerous_roles, e ambas dependem do documento de entrada. Uma estratégia bottom-up começa avaliando essa árvore de baixo para cima.
O documento de entrada não precisa de mais avaliações. Acima dele está o conjunto dangerous_roles: começamos calculando esse conjunto. No nosso exemplo, ele será {"temporary_hack"}.
Depois que conhecemos dangerous_roles, todas as dependências da regra deny são conhecidas. Então, continuamos avaliando esse segundo conjunto, que se transforma em {"Please remove role temporary_hack from user bob"}.
Uma estratégia bottom-up é simples de implementar, mas tem uma grande desvantagem: muitas vezes calcula coisa demais! Suponha que, em vez de listar todas as mensagens de deny, quiséssemos apenas verificar se temporary_hack é uma função perigosa. Com uma estratégia bottom-up, dangerous_roles["temporary_hack"] calcularia o conjunto inteiro (que pode ser grande), em vez de parar assim que descobrisse que temporary_hack realmente faz parte dele.
Uma estratégia top-down resolve esse problema.
Top-down
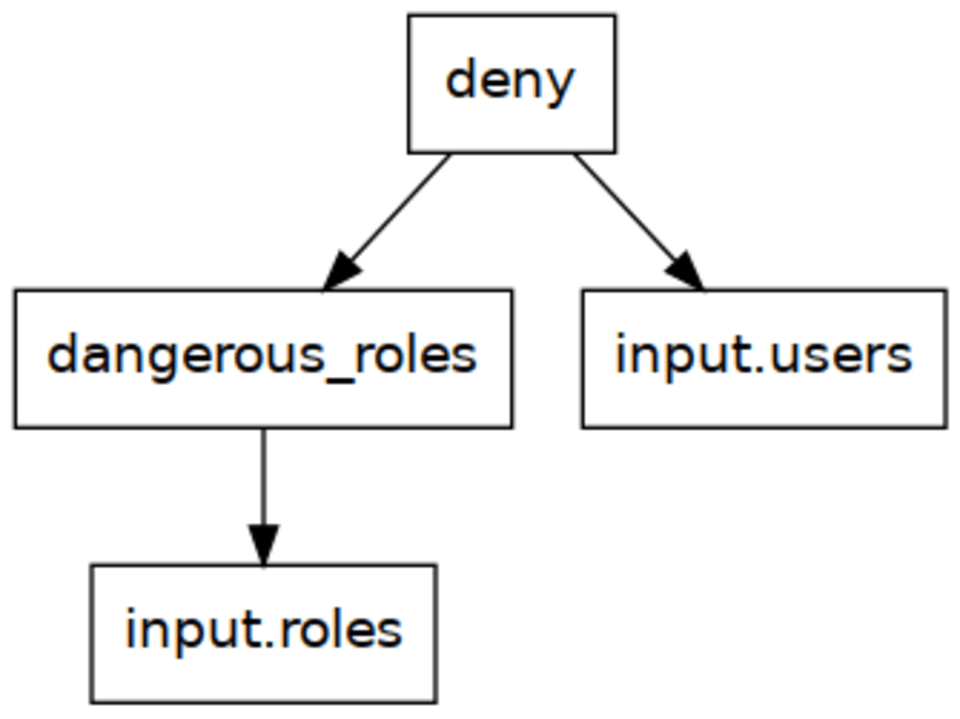
A estratégia top-down funciona no sentido inverso: avalia as regras conforme necessário, começando pelo topo. Isso é muito parecido com chamar funções na maioria das linguagens.
Começamos avaliando deny, já que esse é o valor solicitado. Essa regra percorre os usuários, atribui um valor a role_name e, em seguida, chama dangerous_roles[role_name]. Pela analogia com funções, você pode pensar nisso como dangerous_roles(role_name).
dangerous_roles não chama mais nenhuma “função”; em vez disso, percorre as políticas no documento de entrada.
Podemos ver que isso produz o comportamento desejado ao avaliar dangerous_roles["temporary_hack"]: em vez de criar um conjunto, agora percorre as políticas na entrada e retorna quando encontra uma função perigosa com esse nome.
O OPA usa uma estratégia top-down para avaliar o Rego.
Quadrático sem querer
Mas essa abordagem top-down também tem desvantagens! Em pseudocódigo, a avaliação bottom-up executa internamente dois loops:
Isso é diferente da avaliação top-down. Se pensarmos em dangerous_roles novamente como uma chamada de função, temos:
Isso parece suspeitamente com algo que tem tempo de execução quadrático!
E é mesmo: ao gerar uma entrada com 1.000 usuários e 1.000 políticas, opa leva 3,47 segundos para avaliá-la. Se aumentarmos esse número para 10.000, o tempo passa de 4 minutos!
Isso pode parecer um exemplo artificial, mas é análogo a um problema real que encontramos no Fugue! Analisamos muitos recursos para verificar a conformidade, então esses tempos de avaliação podem se acumular.
Top-down e bottom-up
É só isso? Vamos ficar presos a consultas lentas? Felizmente, não!
Há uma solução simples: se sabemos que queremos avaliar uma regra “de uma só vez”, podemos fazer isso usando uma compreensão de conjunto. Assim, dangerous_roles se torna uma regra completa, com um único valor.
Sintaticamente, fica assim:
Com esse truque simples (os analistas de consultas odeiam), o tempo cai para menos de 0,4 segundo com 10.000 usuários!
Conclusão
Uma linguagem declarativa facilita o foco no que você quer calcular, em vez de como quer fazer isso. No entanto, não podemos esquecer completamente o modelo de execução, especialmente quando ele pode elevar muito o tempo de execução e causar timeouts!
Felizmente, a correção é simples e rápida. Ao escrever regras Rego, vale pensar se uma regra deve ser representada como uma função ou como um conjunto calculado uma única vez, e usar uma compreensão ou uma regra incremental de acordo com o caso.
Neste post, falamos apenas de conjuntos, mas o mesmo vale para objetos.
Uma pergunta óbvia que ainda não respondemos é se isso pode ser corrigido sem precisarmos alterar o código — de uma forma realmente declarativa.
Armazenar em cache os resultados de chamadas a dangerous_roles[role] parece uma abordagem interessante, e foi o que explorei primeiro. No entanto, para evitar recomputações, é preciso armazenar em cache tanto os itens que fazem parte do conjunto quanto os que não fazem. Isso é um problema, pois talvez não haja memória suficiente para os últimos; além disso, em qualquer caso, seria necessário algum tipo de remoção LRU, o que complicaria o código.
Nem sempre é possível para um compilador simplesmente determinar se uma regra arbitrária deve ser calculada de forma bottom-up ou top-down. Mas isso não pode nos impedir de tentar. Criei um protótipo de uma etapa de otimização no fregot, nosso mecanismo experimental de Rego, que identifica regras candidatas à avaliação bottom-up analisando padrões de atribuição e verificando se o argumento pode ser usado para interromper a avaliação antecipadamente. Ele identificou todos os casos que estavam causando timeouts, então é uma direção promissora!
Segurança de IaC pensada para quem desenvolve
A Snyk protege sua infraestrutura como código do ciclo de vida do desenvolvimento de software até a execução na nuvem, com um mecanismo unificado de políticas como código para que todas as equipes possam desenvolver, implantar e operar com segurança.