Fluxos de trabalho orientados por desenvolvedores: análise de imagens criadas com Dockerfile, priorização e correção

26 de março de 2021
0 minutos de leituraAo implantar aplicações em contêineres, os desenvolvedores precisam assumir responsabilidades relacionadas à segurança no nível do sistema operacional. Muitas vezes, esses assuntos são novos para eles e, em muitos casos, antes eram tratados pelas equipes de operações e segurança. Embora esse novo domínio possa parecer desafiador, existem diversas ferramentas e práticas que você pode incorporar ao seu fluxo de trabalho para garantir que os problemas sejam identificados e corrigidos antes de chegarem à produção. Neste artigo, você vai aprender a identificar, priorizar e corrigir problemas nas imagens de contêiner da sua aplicação usando diversas ferramentas, além de entender melhor como essas correções podem afetar suas aplicações durante a implantação.
Se quiser, você pode acompanhar o artigo e fazer experimentos com a aplicação de exemplo. Ela está no GitHub em https://github.com/snyk-snippets/dev-driven-workflows.
Sumário
10 maneiras de otimizar e proteger sua aplicação em contêiner
Imagens de contêiner bem estruturadas são fundamentais
A base de qualquer contêiner que você implanta é definida, em grande parte, pela imagem Docker/OCI em que ele se apoia. Por isso, é importante entender o que é uma imagem de contêiner e como ela funciona.
O que é uma imagem de contêiner?
Em essência, uma imagem é apenas um conjunto de arquivos compactados do sistema de arquivos e definições de metadados. Cada elemento contém uma parte do sistema de arquivos e configurações de ambiente que definem o estado inicial de um contêiner. As camadas são empilhadas logicamente, e o conteúdo de cada uma é aplicado ao da camada anterior, às vezes chamada de camada pai. Cada camada recebe um hash criptográfico para garantir sua integridade, e a imagem mantém um manifesto dessas camadas, além do próprio hash, chamado digest da imagem.
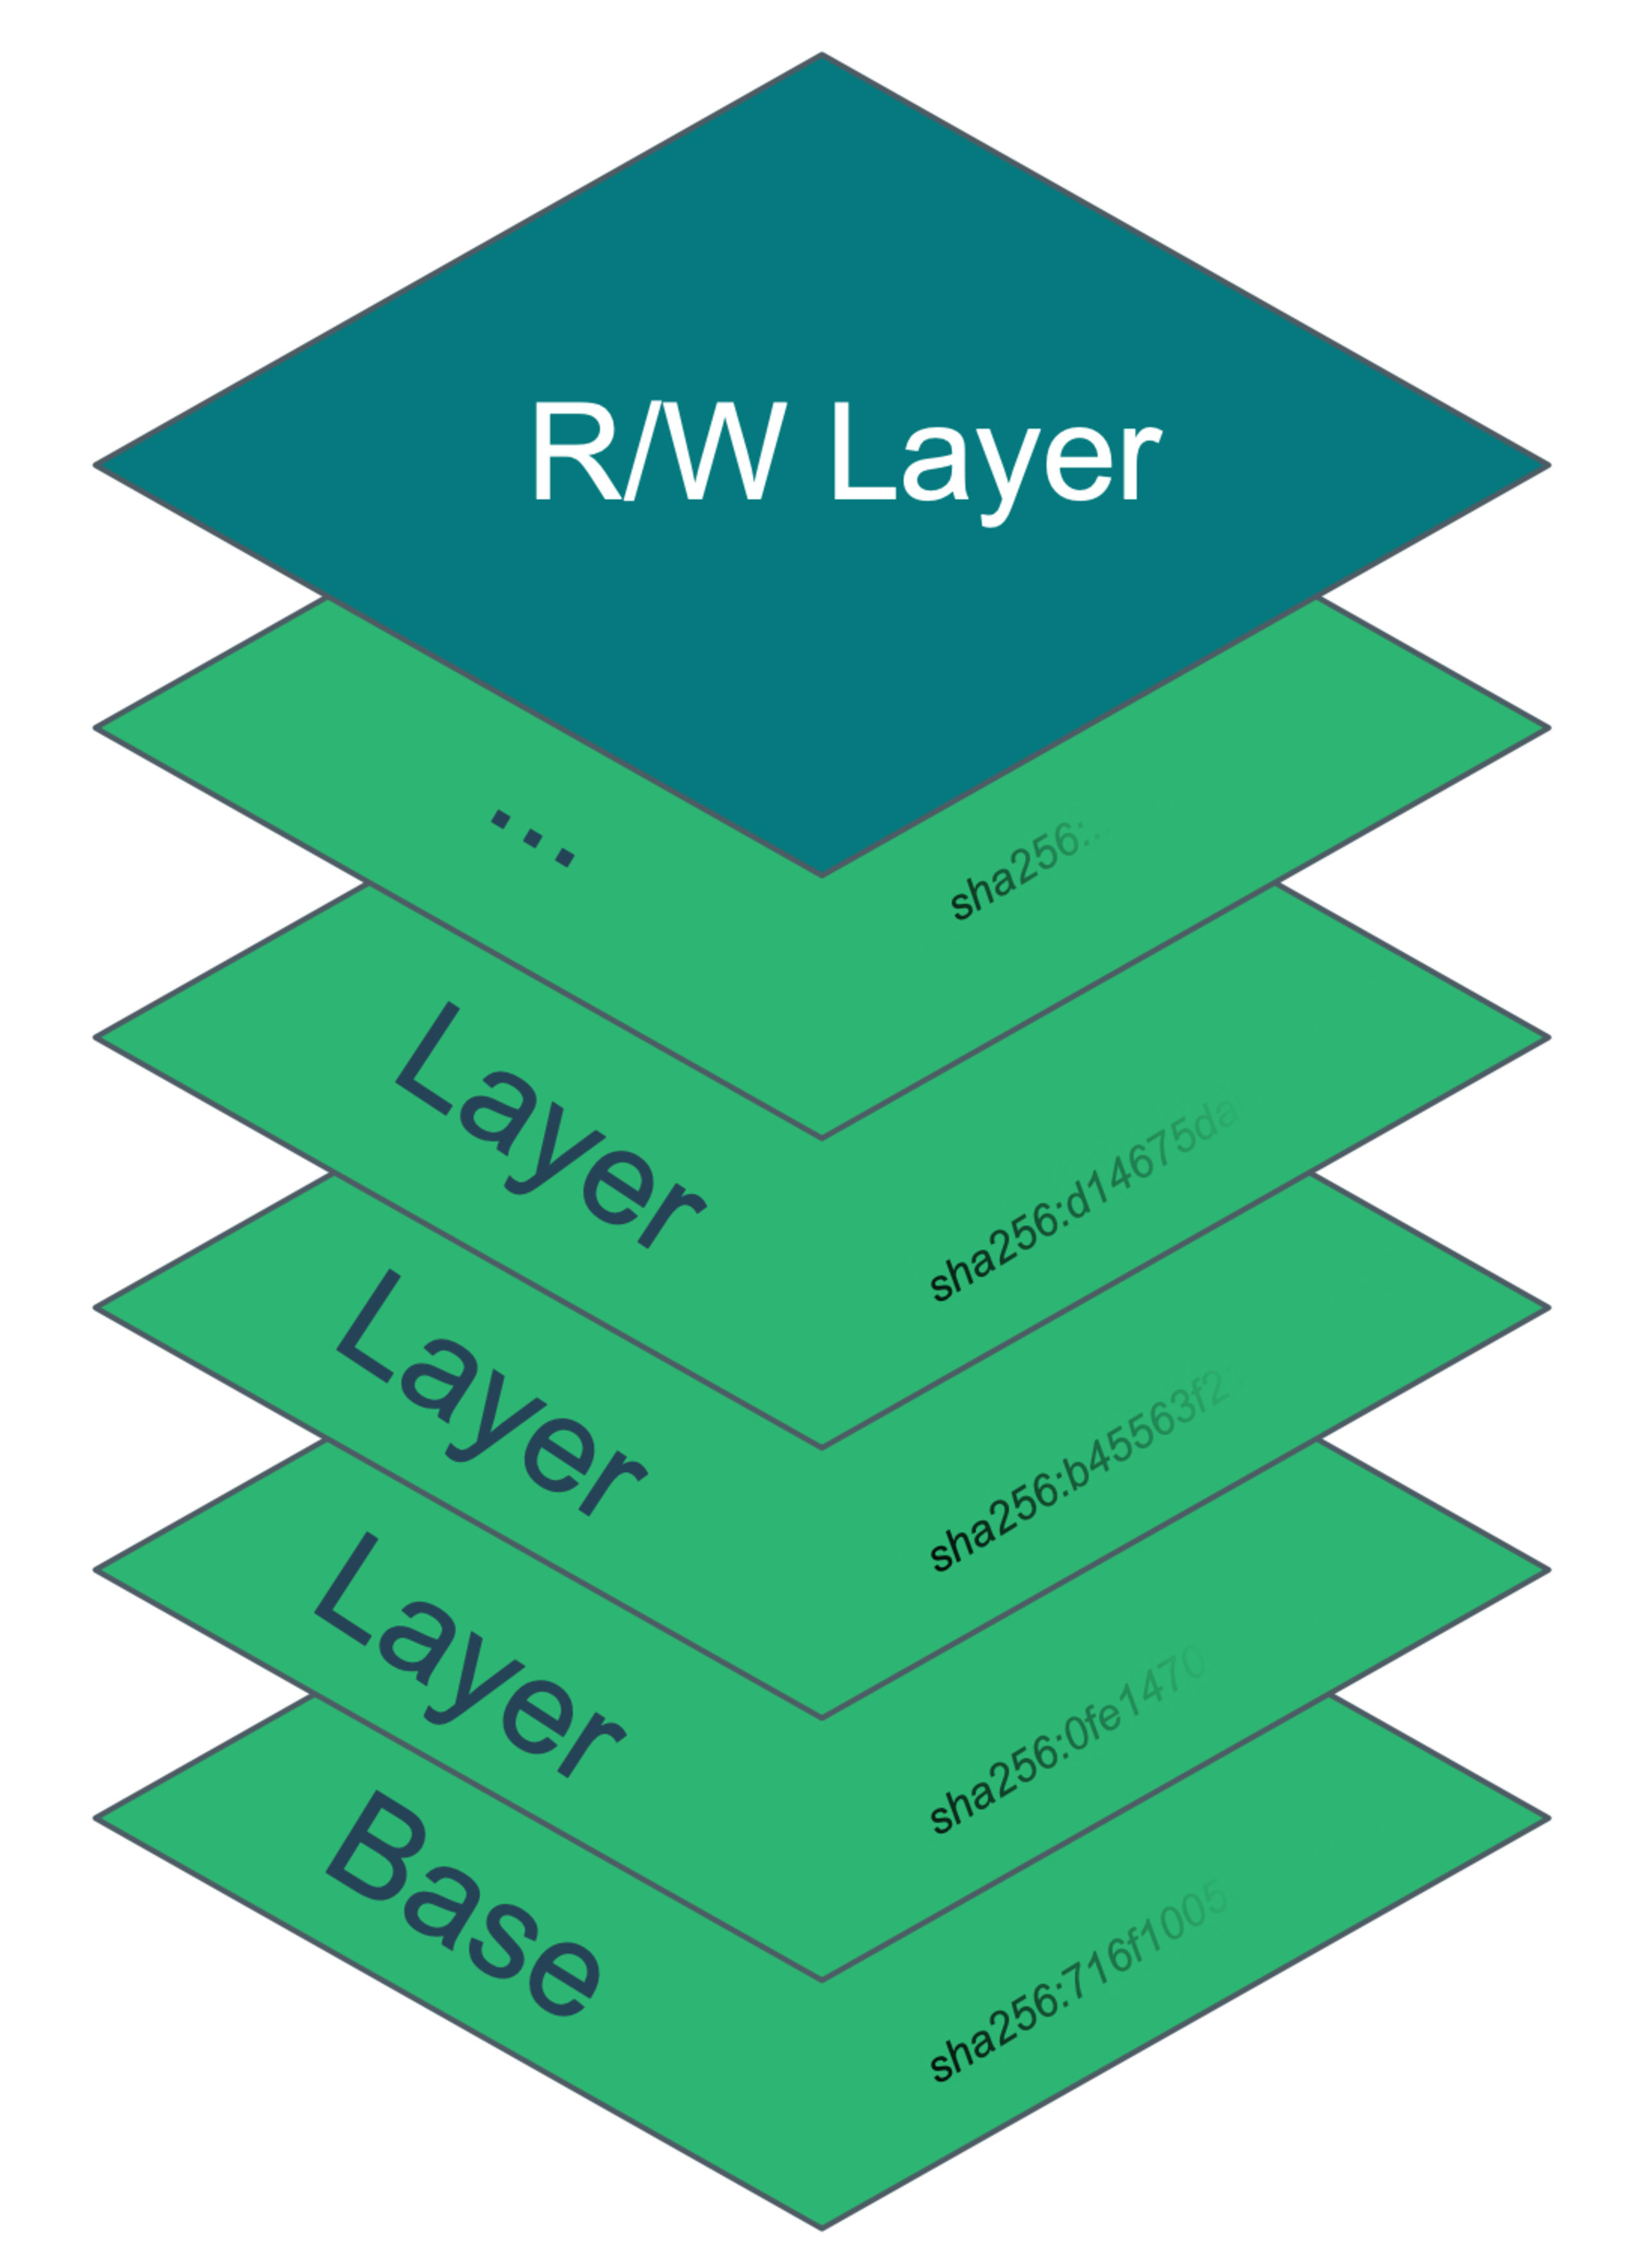
Quando um contêiner é criado, o sistema de arquivos que ele recebe é uma combinação das camadas da imagem com uma camada opcional de leitura e gravação aplicada por cima. Todos os arquivos gravados pelo contêiner ficam na camada de leitura e gravação, pois as próprias camadas da imagem são imutáveis. Se um arquivo que já existe nas camadas da imagem for alterado, ele primeiro será copiado para a camada de leitura e gravação e, então, modificado nela — esse comportamento é chamado de copy-on-write.
O que é um Dockerfile?
Um Dockerfile é uma lista simples de instruções que descreve o que deve ser incluído em cada camada de uma imagem de contêiner.
Exemplo de Dockerfile
No exemplo a seguir, você pode ver as camadas sendo criadas a partir de uma imagem base node:14.1.0. Cada camada subsequente consiste nos metadados ou nas alterações do sistema de arquivos causadas pelas instruções de cada linha do Dockerfile. Esse exemplo está no repositório do GitHub mencionado acima e tem o nome Dockerfile-initial.
Se executássemos um comando docker build usando este Dockerfile de exemplo, ele criaria uma camada com o diretório /usr/src/goof e, em seguida, outra camada com o novo diretório /tmp/extracted_files.
A camada seguinte copia o conteúdo do diretório atual da máquina de build — indicado pelo . no comando de build — incluindo seus subdiretórios, para o diretório /usr/src/goof na nova camada.
O build continua adicionando novas camadas até o fim do arquivo.
Cada camada de uma imagem se baseia na camada pai, mas, depois de criada, é imutável. Mesmo que adicionássemos uma linha para excluir um arquivo de uma etapa anterior, o conteúdo desse arquivo continuaria na hierarquia; a alteração para removê-lo seria apenas o delta da nova camada. Isso é semelhante ao funcionamento de repositórios de código-fonte como o git, em que um commit que remove um arquivo não o apaga dos commits históricos. Assim, se um arquivo de 1 MB for adicionado a uma camada e removido em uma camada posterior, a imagem ainda conterá esse 1 MB, embora ele fique invisível para o contêiner.
Instruções RUN compostas
É comum encontrar instruções compostas com uma etapa de limpeza no final, para evitar que arquivos temporários permaneçam no sistema de arquivos da camada. Nosso Dockerfile não tem uma dessas instruções, mas este é um exemplo representativo de um padrão muito usado na instalação de pacotes do sistema operacional com apt, yum etc.
Neste exemplo, instalamos uma versão específica do curl em uma imagem Ubuntu e garantimos que nenhum cache do apt seja armazenado na camada.
Nosso Dockerfile de exemplo representa as etapas imperativas usadas para criar e executar esta aplicação antes da migração para contêineres. Ele é semelhante ao que você pode encontrar em aplicações legadas simplesmente migradas para contêineres. Há bastante espaço para otimização e reforço da segurança, então vamos analisar o caso.
Além de precisar de otimizações, este Dockerfile contém um erro que faz o comando docker build falhar. Vamos analisar o problema e ver como podemos usar a automação para ajudar a corrigi-lo.
10 maneiras de otimizar e proteger sua aplicação em contêiner
1. Use um linter para Dockerfile
Um primeiro passo comum para melhorar nossos Dockerfiles é usar um linter. Os linters analisam estaticamente o conteúdo de um arquivo e sugerem possíveis problemas que podemos corrigir. Como mencionamos acima, há um bug no Dockerfile atual que está fazendo o build falhar.
O Hadolint é um linter de código aberto popular para Dockerfiles. Ele analisa as etapas e dá recomendações sobre sua estrutura.
Vamos analisar os problemas encontrados:
Use COPY em vez de ADD para arquivos e pastasIsso é válido para copiar arquivos locais que não sejam arquivos compactados, conforme descrito nas práticas recomendadas para Dockerfiles do Docker. Vale a pena corrigir, mas não é a causa do erro no build.
Use 'cd ... || exit' ou 'cd ... || return' caso o comando cd falhe.Tecnicamente, a recomendação está correta, mas não é o problema aqui. Vamos deixar isso de lado por enquanto.
Use WORKDIR para mudar de diretórioAí está! Essa é a causa. O efeito da linha
RUN cd /usr/src/gooffica restrito à camada criada por essa instrução. Na prática, essa linha não faz nada em relação ao build da imagem. O comandoWORKDIRdo Dockerfile é o que devemos usar, pois ele define explicitamente o diretório de trabalho atual dali em diante, inclusive em tempo de execução. A ausência dele é o motivo pelo qual a linhaRUN npm…não encontra o arquivopackage.json.Use a notação JSON para os argumentos de CMD e ENTRYPOINTTambém conhecida como forma “exec”, essa questão gera opiniões diferentes, mas a documentação do Docker recomenda o uso da notação JSON nesse caso.
Depois de corrigirmos todos esses problemas, nosso novo Dockerfile — chamado Dockerfile-hadolint-fixes no repositório de exemplo — não apresenta mais problemas de lint e agora é compilado com sucesso.
2. Execute o linter como um hook de commit para evitar que problemas no Dockerfile entrem na sua base de código
Ferramentas leves como hadolint são ótimas opções para hooks de pré-commit, evitando que problemas no Dockerfile entrem na sua base de código. A seguir, temos um exemplo simples de script git que você pode adicionar ao repositório neste caminho: .git/hooks/pre-commit. Se você ainda não conhece os hooks do git, consulte a documentação do Git-SCM para saber mais.
Veja um exemplo desse hook sendo executado no Dockerfile original, antes de aplicarmos as correções.
Observação: se estiver testando isso no nosso repositório de exemplo, copie Dockerfile-initial para Dockerfile e coloque o arquivo no stage do repositório para acionar o problema do hook.
3. Teste sua imagem localmente de forma iterativa
Já trabalhamos para criar uma imagem, corrigimos um erro de build e resolvemos algumas práticas inadequadas durante o processo. Agora precisamos garantir que a imagem realmente contenha tudo o que é necessário para executar a aplicação.
O exemplo “goof” é uma aplicação simples de duas camadas: um frontend em Node.js que depende de um backend MongoDB para persistência. Para executar essa aplicação localmente, vamos fazer o seguinte:
Faça uma verificação rápida da imagem com
docker run. (Isso geralmente é feito de forma iterativa enquanto você trabalha no Dockerfile.) A aplicação vai falhar porque não tem um banco de dados ao qual se conectar, mas, se chegar até esse ponto, você já sabe que o contêiner está iniciando.Execute um cluster Kubernetes local que possa acessar a imagem criada. Há várias opções de cluster; estas são algumas das mais populares:
Kubernetes no Docker DesktopBasta ativar essa opção no painel do Docker Desktop e aguardar a inicialização.
Kubernetes no Docker (KinD)Consulte o guia de início rápido do KinD para começar e não se esqueça de carregar sua imagem no cluster. Além disso, se você estiver executando o KinD no Docker Desktop, será necessário configurar mapeamentos de host no cluster para corresponder à NodePort do goof-service. Disponibilizamos um arquivo
kind-config.yamlde exemplo que você pode usar no repositório.MiniKubeConsulte o documento de introdução do MiniKube para começar e a página do manual sobre como armazenar sua imagem em cache no cluster.
Um cluster Kubernetes remotoQualquer cluster disponível para você e que possa receber imagens também deve funcionar. Talvez seja necessário enviar sua imagem para um registry do qual o cluster possa baixá-la. Se não tiver certeza de como fazer isso, consulte a equipe de operações do cluster.
Testes com Docker
Enquanto trabalha no Dockerfile, você deve garantir que a imagem esteja sendo criada corretamente. A maneira mais simples de fazer isso é executar um contêiner de vez em quando e verificar alguns pontos.
Por exemplo, supondo que queiramos executar a imagem criada anteriormente com a tag goof, usaríamos docker run --rm -it -p3001:3001 goof.
Esse comando cria e inicia um contêiner com base nessa imagem, vinculando a porta 3001 da sua estação de trabalho à porta 3001 do contêiner para encaminhar o tráfego. A opção --rm simplesmente instrui o Docker a remover o contêiner depois que ele for interrompido, e -it o executa em modo interativo com um tty, para que possamos ver a saída e usar CTRL-C para encerrá-lo.
Você verá várias mensagens enquanto a aplicação Node.js tenta iniciar, incluindo um erro de conexão com o banco de dados. Depois, o contêiner será interrompido e removido quando a aplicação for encerrada. Se aparecer qualquer outro erro, como a ausência do npm, saberemos que há problemas na própria imagem.
Testes no Kubernetes local
Vamos implantar a aplicação usando os arquivos de manifesto que estão na pasta manifests do repositório de exemplo.
goof-deployment.yaml
Uma explicação completa das APIs do Kubernetes está fora do escopo deste artigo, mas, em linhas gerais, vamos declarar dois Deployments para implantar e gerenciar Pods, onde serão executados nosso contêiner e o banco de dados.
Também vamos implantar o arquivo goof-services.yaml, que expõe os pods por meio dos Services do Kubernetes e permite a descoberta de serviços para essa instância do MongoDB. Se você estiver executando o Kubernetes na sua máquina local com Docker Desktop, KinD ou MiniKube, será necessário adicionar imagePullPolicy: Never à especificação do contêiner goof, como neste exemplo:
Se você estiver usando um cluster remoto, isso não será necessário, mas será preciso enviar sua imagem para um registro e alterar as tags image: nestes arquivos YAML de acordo. Se tiver dúvidas, consulte os operadores do cluster.
Com o cluster do Kubernetes em execução e a configuração do kubectl pronta, basta executar kubectl apply -f manifests/ e aguardar os pods entrarem no status Running, verificando com kubectl get pods.
Por fim, vamos testar o aplicativo abrindo o navegador em:
Docker Desktop ou KinD: http://localhost
MiniKube execute
minikube service goofe use a primeira URL exibidaOutrosSe
kubectl get service gooflistar um IP externo, use-o. Você também pode tentar o IP de um dos nós do cluster na porta 32301. Caso contrário, peça ajuda ao operador do cluster.
Você deverá ver algo parecido com isto no navegador:
Se quiser, adicione uma nota TODO e salve-a pressionando Enter. Se tudo estiver funcionando, ela será adicionada a uma lista na página.
Repita o processo: pratique o desenvolvimento e os testes locais de forma iterativa
Agora que o aplicativo está no ar, você pode continuar desenvolvendo-o de forma iterativa, reconstruir a imagem e enviá-la ao cluster. Há provavelmente centenas de maneiras de fazer isso, dependendo do tipo de aplicativo que você está criando e da distribuição do Kubernetes que usa, mas, em geral, o fluxo de trabalho será parecido com este:
O código é alterado
Uma nova imagem é criada com o comando
docker builde/ou as ferramentas da sua linguagemA imagem é enviada ao cluster ou ao registro, se necessário
O pod do Kubernetes em execução é atualizado para usar a nova imagem. Para isso, costumo simplesmente excluir o pod em execução e deixar o cluster iniciar outro com a nova imagem, mas você também pode usar
kubectl set image, desde que a nova imagem tenha uma nova tag.Teste o novo pod quando ele estiver no ar e pronto
Como reforçar ainda mais a segurança da imagem
Além de corrigir alguns bugs no Dockerfile original, ainda não cuidamos de fato da segurança dele. Agora que temos uma maneira de executar e testar o aplicativo, vamos analisar alguns dos problemas de segurança mais interessantes da nossa imagem.
4. Não use o usuário root como padrão na imagem
Se você acessar o contêiner do nosso aplicativo e verificar, verá que o processo node está sendo executado como usuário root.
Embora o processo esteja sendo executado dentro de um contêiner, com um namespace de processos Linux que o isola do restante do host, não é recomendável executá-lo com UID 0 por alguns motivos. Os problemas mais comuns surgem de configurações incorretas durante a implantação, como montar no contêiner um volume do host que expõe mais informações do que deveria. O usuário do contêiner terá os mesmos privilégios nesse sistema de arquivos que teria com o mesmo UID no host. Por exemplo, se o diretório /etc do host for montado no contêiner, um processo executado como root nesse contêiner terá acesso total para ler e gravar qualquer arquivo na pasta /etc do host.
Lembra que mencionamos que as camadas são imutáveis e que remover um arquivo de uma camada não apaga de fato o conteúdo das camadas anteriores? Isso pode ser explorado se um processo dentro do contêiner conseguir ler os arquivos das camadas da imagem de contêiner do host, por exemplo, porque alguém montou o caminho /var/lib/docker no contêiner. É nesse caminho que todas essas camadas ficam disponíveis, então um processo malicioso só precisaria procurar softwares vulneráveis nelas. (Ou em /var/lib/containerd ou onde quer que o ambiente de execução de contêineres armazene esses arquivos.) Felizmente, os mantenedores das imagens oficiais do node já criaram para nós um usuário node com UID 1000. Para usá-lo, basta adicionar ao Dockerfile uma linha com USER 1000. Usamos o UID em vez do nome do usuário porque algumas ferramentas, como o Kubernetes, não conseguem associar o nome de usuário padrão de uma imagem ao respectivo UID antes de iniciar o contêiner, e talvez precisem fazer isso para aplicar políticas sobre usuários root. Veremos esse tipo de aplicação de políticas mais adiante neste artigo.
Se a imagem base escolhida não tiver um usuário criado previamente, você também precisará criar um adicionando a linha RUN necessária — isto é, adduser — e, em seguida, a linha USER para mudar para esse UID. Configure as permissões e a propriedade dos arquivos na imagem conforme necessário para que o aplicativo seja executado como esse novo usuário. Também é comum que executáveis e outros arquivos pertençam ao root, mas possam ser lidos e executados por outros usuários. Isso ajuda a impedir que um processo acidental ou malicioso os modifique durante a execução.
Depois de criar a imagem e atualizar o pod, a situação já está bem melhor.
5. Aplique controles para usuários root durante a implantação
Agora que a imagem foi alterada para ser executada como um usuário sem privilégios de root, vamos garantir que continue assim alterando o manifesto de implantação do Kubernetes para impor essa configuração. Primeiro, vou executar o arquivo goof-deployment.yaml no scanner do Snyk IaC.
Como você pode ver, há vários problemas e, como era de se esperar, um dos itens de gravidade média é que o contêiner está sendo executado sem controle para usuários root. A correção é simples: basta adicionar runAsNonRoot: true ao securityContext de pod:spec ou container:spec. Prefiro fazer isso no nível do pod, pois a configuração se aplica a todos os contêineres do pod, a menos que seja explicitamente substituída. Se outro contêiner for adicionado ao pod, a configuração também será aplicada automaticamente.
Agora estamos protegidos contra quem tentar reverter a imagem para executá-la como root, porque a implantação falhará quando isso for testado. No repositório de exemplo, essa alteração foi aplicada ao arquivo manifests/good-deployment.yaml-nonroot.
6. Especifique um usuário durante a execução (quando apropriado)
Quem tem olhar atento talvez tenha notado que a segunda implantação, goof-mongo, já inclui o securityContext e também especifica um UID.
Estamos adicionando o campo runAsUser nesse caso porque usamos a imagem base oficial e sem alterações do mongo no Docker Hub, então não temos outro Dockerfile para incluir a linha USER. Confiamos que o UID da imagem oficial do mongo não mudará. No caso da imagem do nosso aplicativo goof, como controlamos esse UID pelo Dockerfile, não há vantagem em declará-lo novamente no manifesto de implantação — além de isso contrariar o princípio de software DRY.
Vale observar que a documentação da imagem do mongo no Docker Hub não menciona esse usuário nem o UID (até a data em que este artigo foi escrito). Para descobrir, executei docker run --rm -it mongo id e confirmei que ele estava sendo executado como root. Em seguida, executei docker run --rm -it --entrypoint cat mongo /etc/passwd e encontrei mongodb:x:999:999 no fim do arquivo. Testes preliminares mostraram que executar como esse usuário funciona, mas, em uma situação real, seria preciso pesquisar mais antes de usar uma alteração não documentada como essa.
7. Remova recursos se o aplicativo não precisar deles
Ao analisar essa verificação de IaC, o outro problema de gravidade média apontado foi que estamos executando o contêiner com o conjunto padrão de recursos. Nosso aplicativo é simples e não precisa chamar funções do kernel, como alterar a propriedade de arquivos, nem controlar aspectos da rede do host. Podemos restringir o ambiente de execução do contêiner para remover todos esses recursos. Essa é outra maneira de dificultar um pouco mais a vida de qualquer agente malicioso que consiga invadir nosso contêiner. Para isso, basta adicionar um bloco à especificação do contêiner para remover todos os recursos.
Aplique o novo manifesto e teste o aplicativo novamente. No repositório de exemplo, essas alterações foram aplicadas ao arquivo manifests/good-deployment.yaml-nonroot-dropcapabilities.
Mais uma vez, você verá que a implantação goof-mongo também já tem a mesma alteração, pois o banco de dados tampouco precisa desses recursos.
As configurações de securityContext do Kubernetes podem ser complexas. Para saber mais, confira nosso guia rápido: 10 configurações de contexto de segurança do Kubernetes que você precisa conhecer.
A verificação do Snyk IaC também encontrou vários outros problemas de baixa gravidade — não mostrados acima — que devem ser corrigidos, mas estão fora do escopo deste artigo.
Agora vou confirmar as alterações e enviá-las ao GitHub, pois corrigi o problema de build e não quero acumular mais mudanças em um único commit. Como o Snyk já monitora meu repositório do GitHub, ao abrir um Pull Request da minha branch para a main, fazemos uma rápida verificação de vulnerabilidades nas alterações que apliquei ao Dockerfile. Neste caso, minhas alterações não adicionaram vulnerabilidades de segurança nem problemas de licenciamento, então os testes foram aprovados.
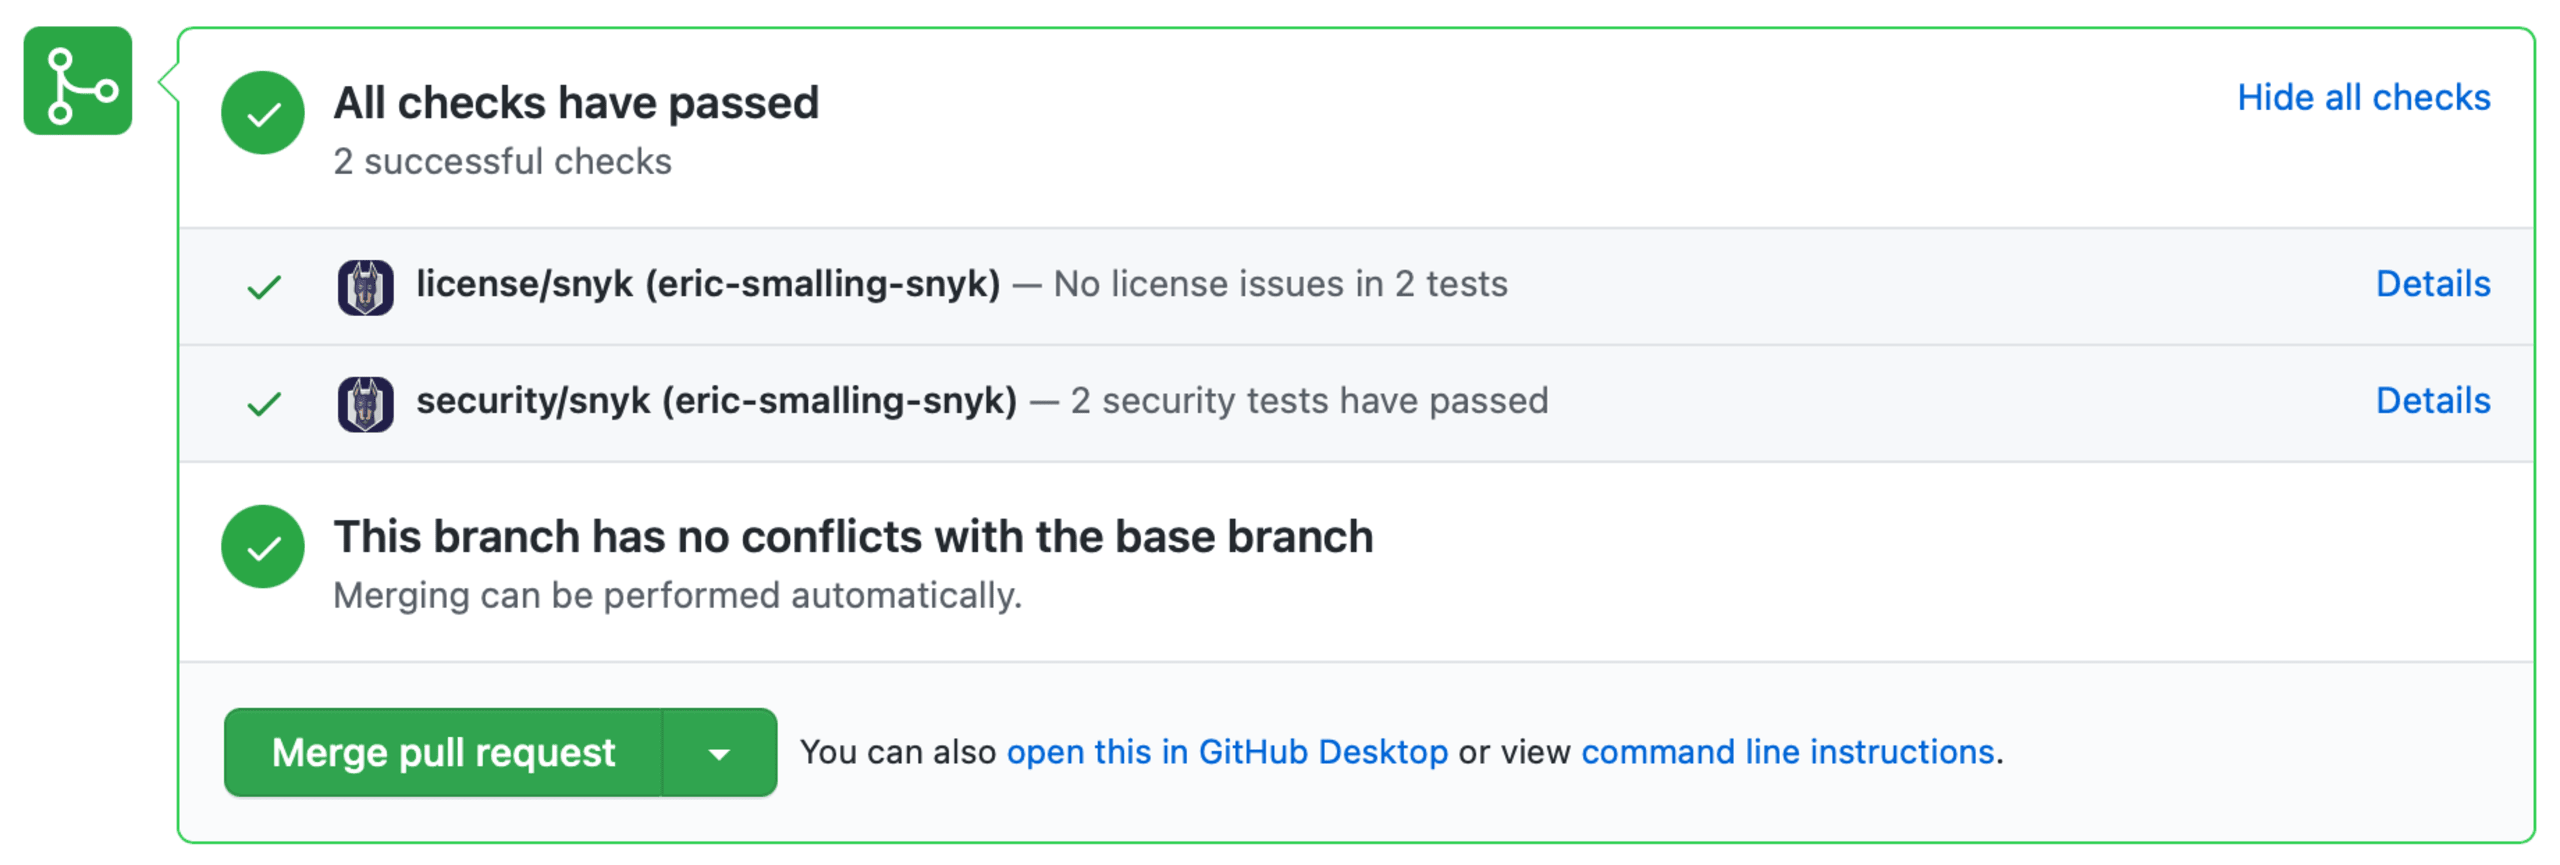
Vamos mesclar essas alterações. Isso nos leva ao próximo tópico para proteger nossa imagem: a verificação de vulnerabilidades.
8. Use um scanner de vulnerabilidades de imagens
Agora que resolvemos os problemas de segurança relacionados à configuração, vamos nos concentrar na parte da imagem que não controlamos diretamente: os pacotes herdados da própria imagem base ou os que talvez adicionemos. Para identificar possíveis explorações na imagem, vamos executar um scanner de vulnerabilidades e procurar CVEs conhecidos nos pacotes instalados.
Uma verificação do Snyk Container encontra 825 problemas nessa imagem, com diferentes níveis de gravidade.
O relatório mostra que todos vêm da imagem base node:14.1.0 sobre a qual estamos criando a nossa. Isso faz sentido, já que não estamos instalando nenhum pacote adicional com apt-get ou algo parecido no Dockerfile.
Quando encontramos tantos problemas, costuma ser mais fácil definir prioridades na interface web do Snyk. Como meu repositório já está sendo monitorado, vamos conferir a verificação acionada pela mesclagem do Pull Request que acabamos de fazer.
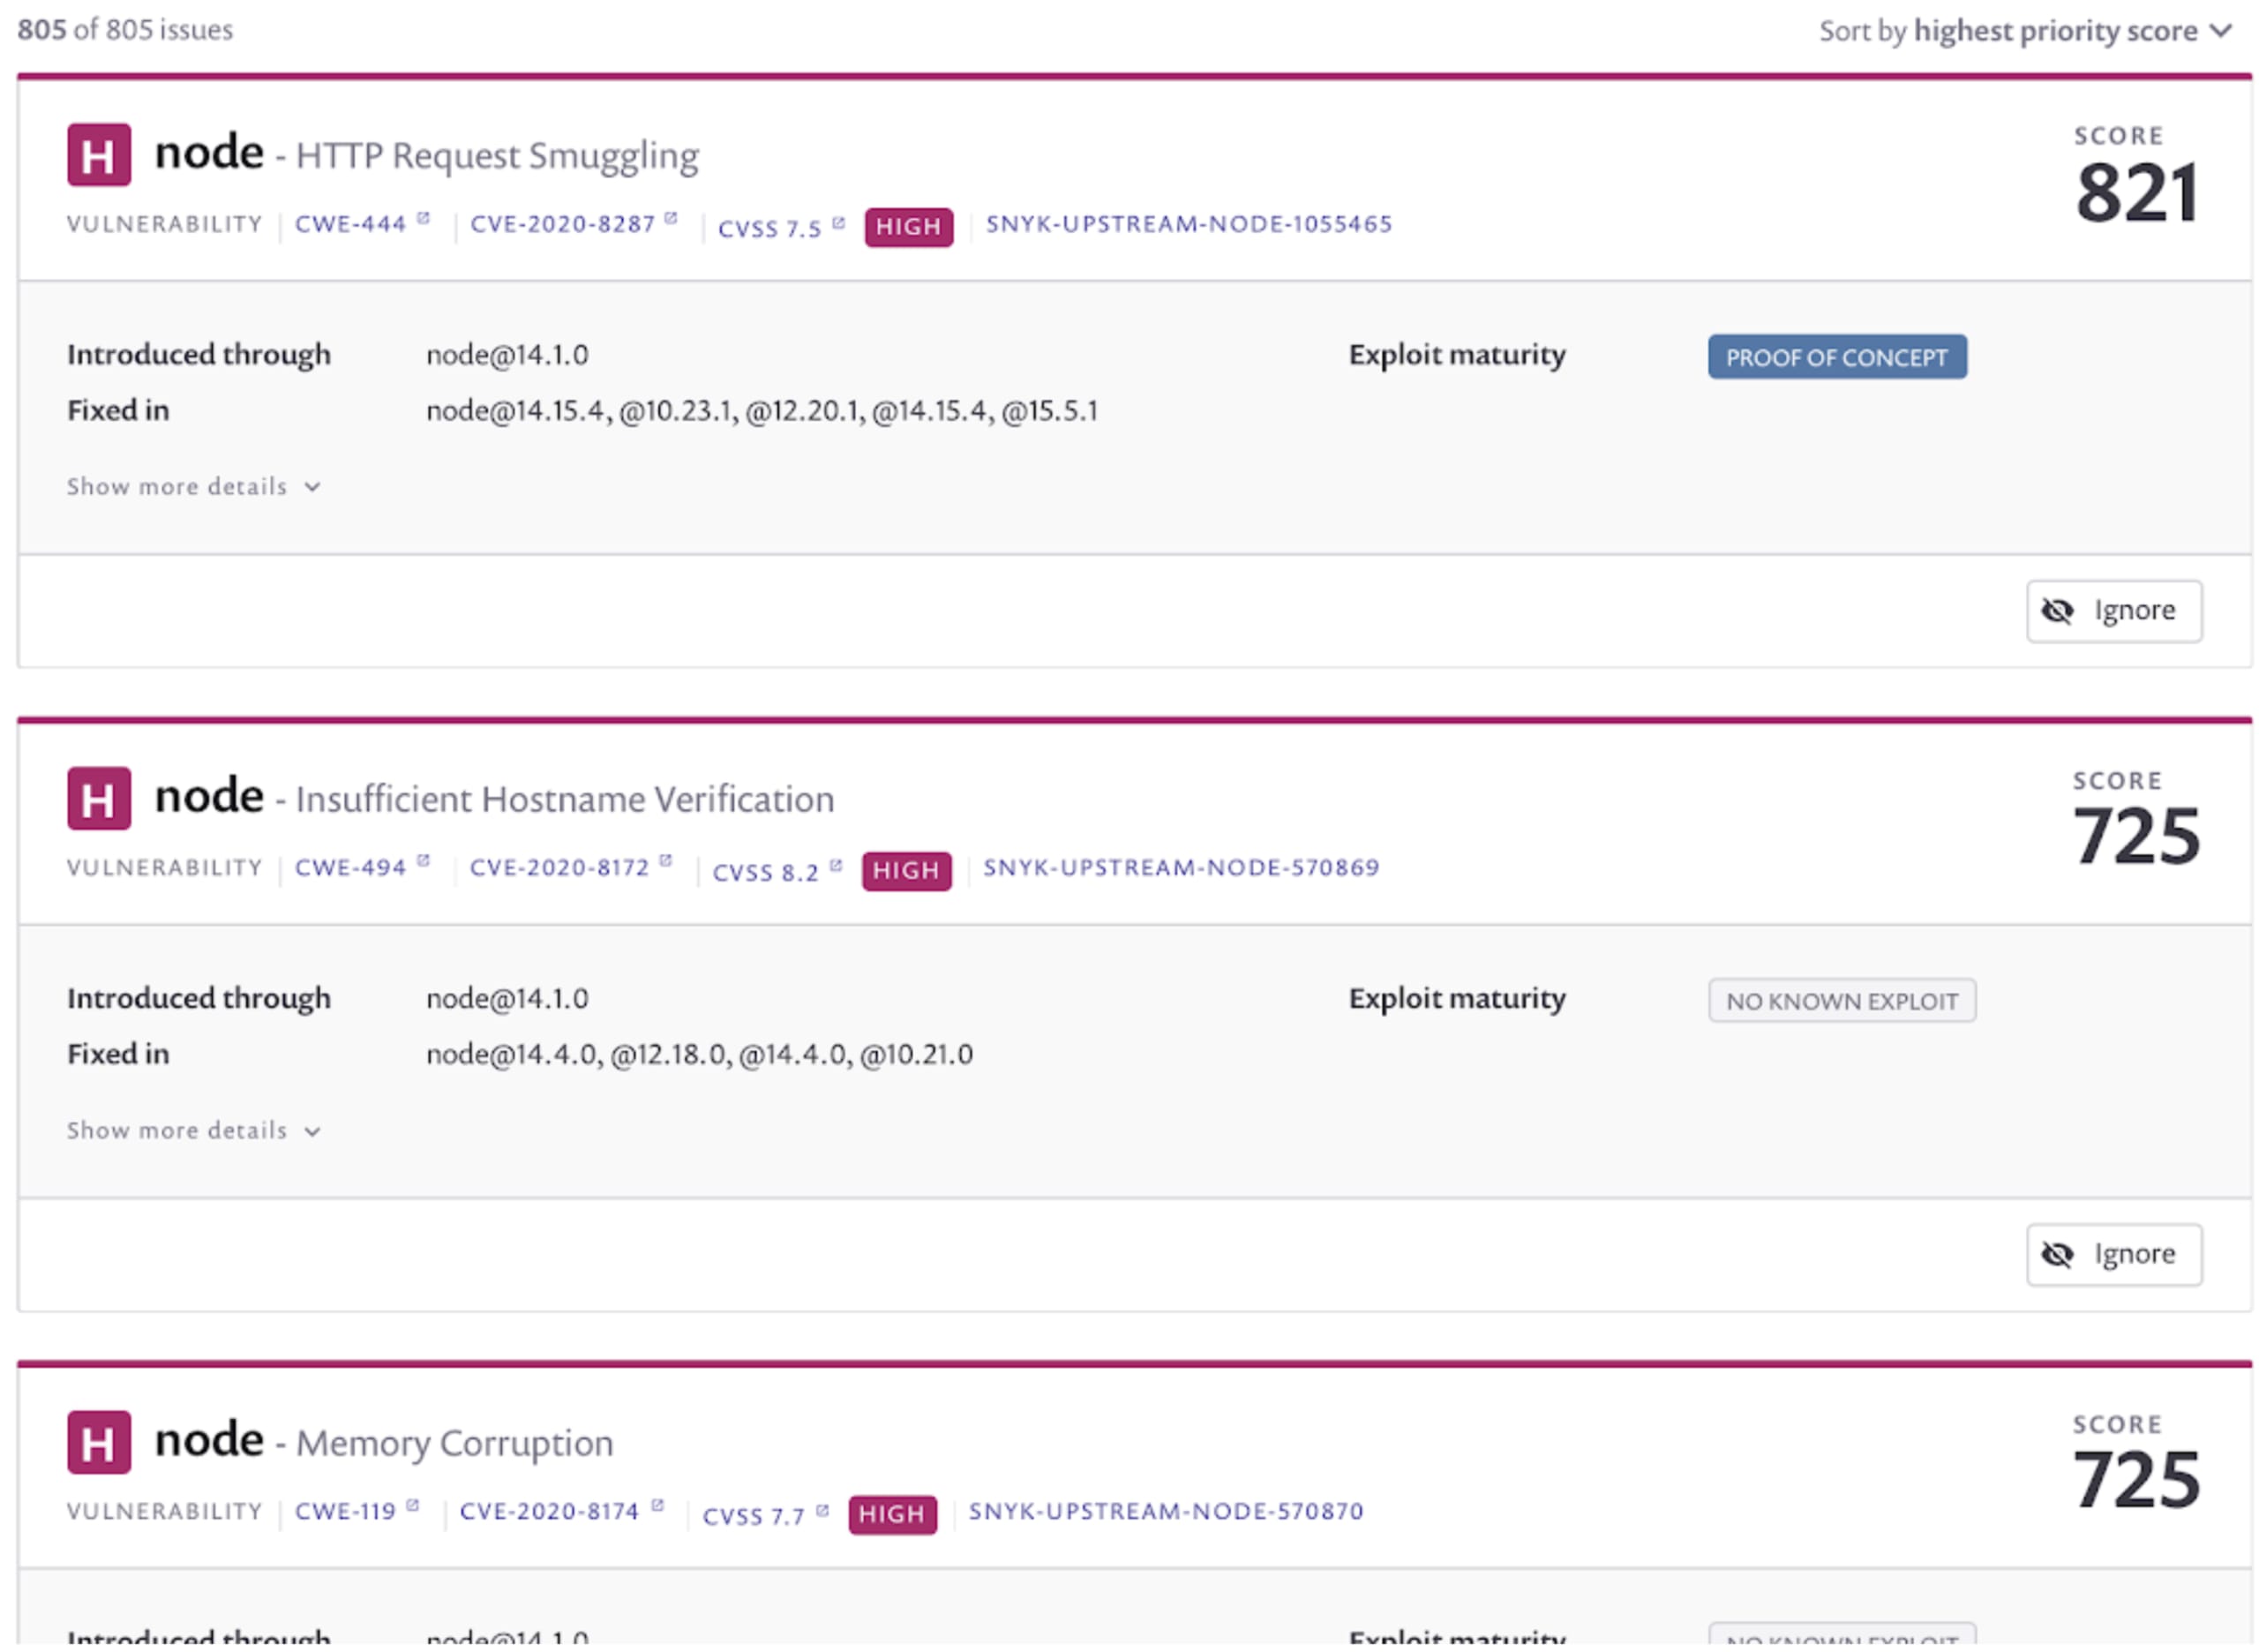
Aqui vemos uma tabela priorizada das vulnerabilidades encontradas, ponderadas por métricas como a pontuação CVSS, a maturidade da exploração e a disponibilidade atual de correções. Além disso, os relatórios da CLI e da interface web recomendam imagens base alternativas com menos vulnerabilidades conhecidas.
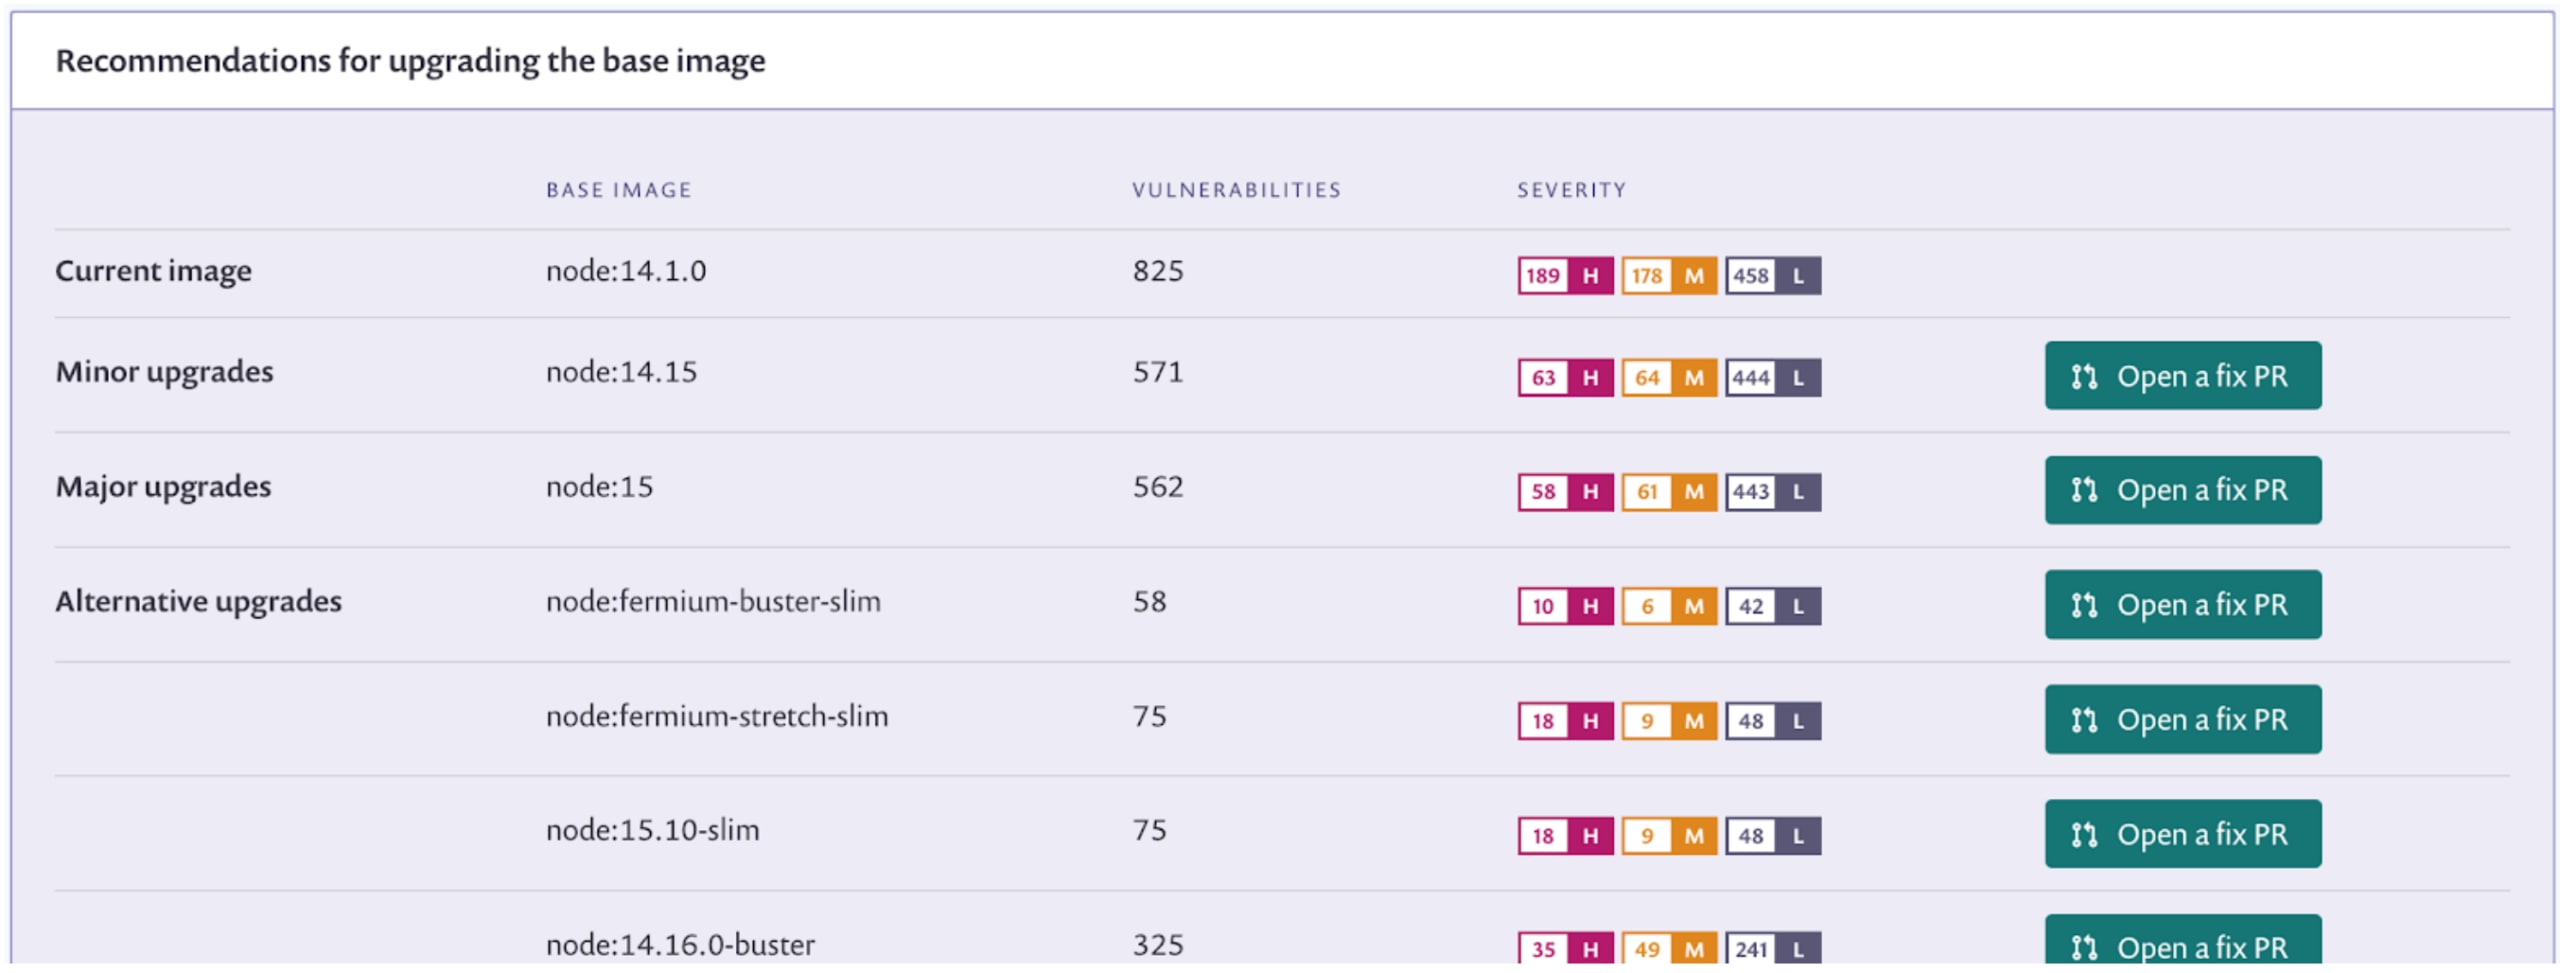
Neste caso, atualizar nossa imagem base para a opção node:fermium-buster-slim parece ser a melhor alternativa e a mais compatível. Vale lembrar que as imagens com a tag “slim” são reduzidas, então teste a compatibilidade caso seu aplicativo use pacotes que não estejam incluídos nelas.
Poderíamos fazer essa alteração no código, mas a interface web também oferece uma correção automatizada pelo botão “Open a fix PR” ao lado de cada recomendação. Vamos usar esse recurso.
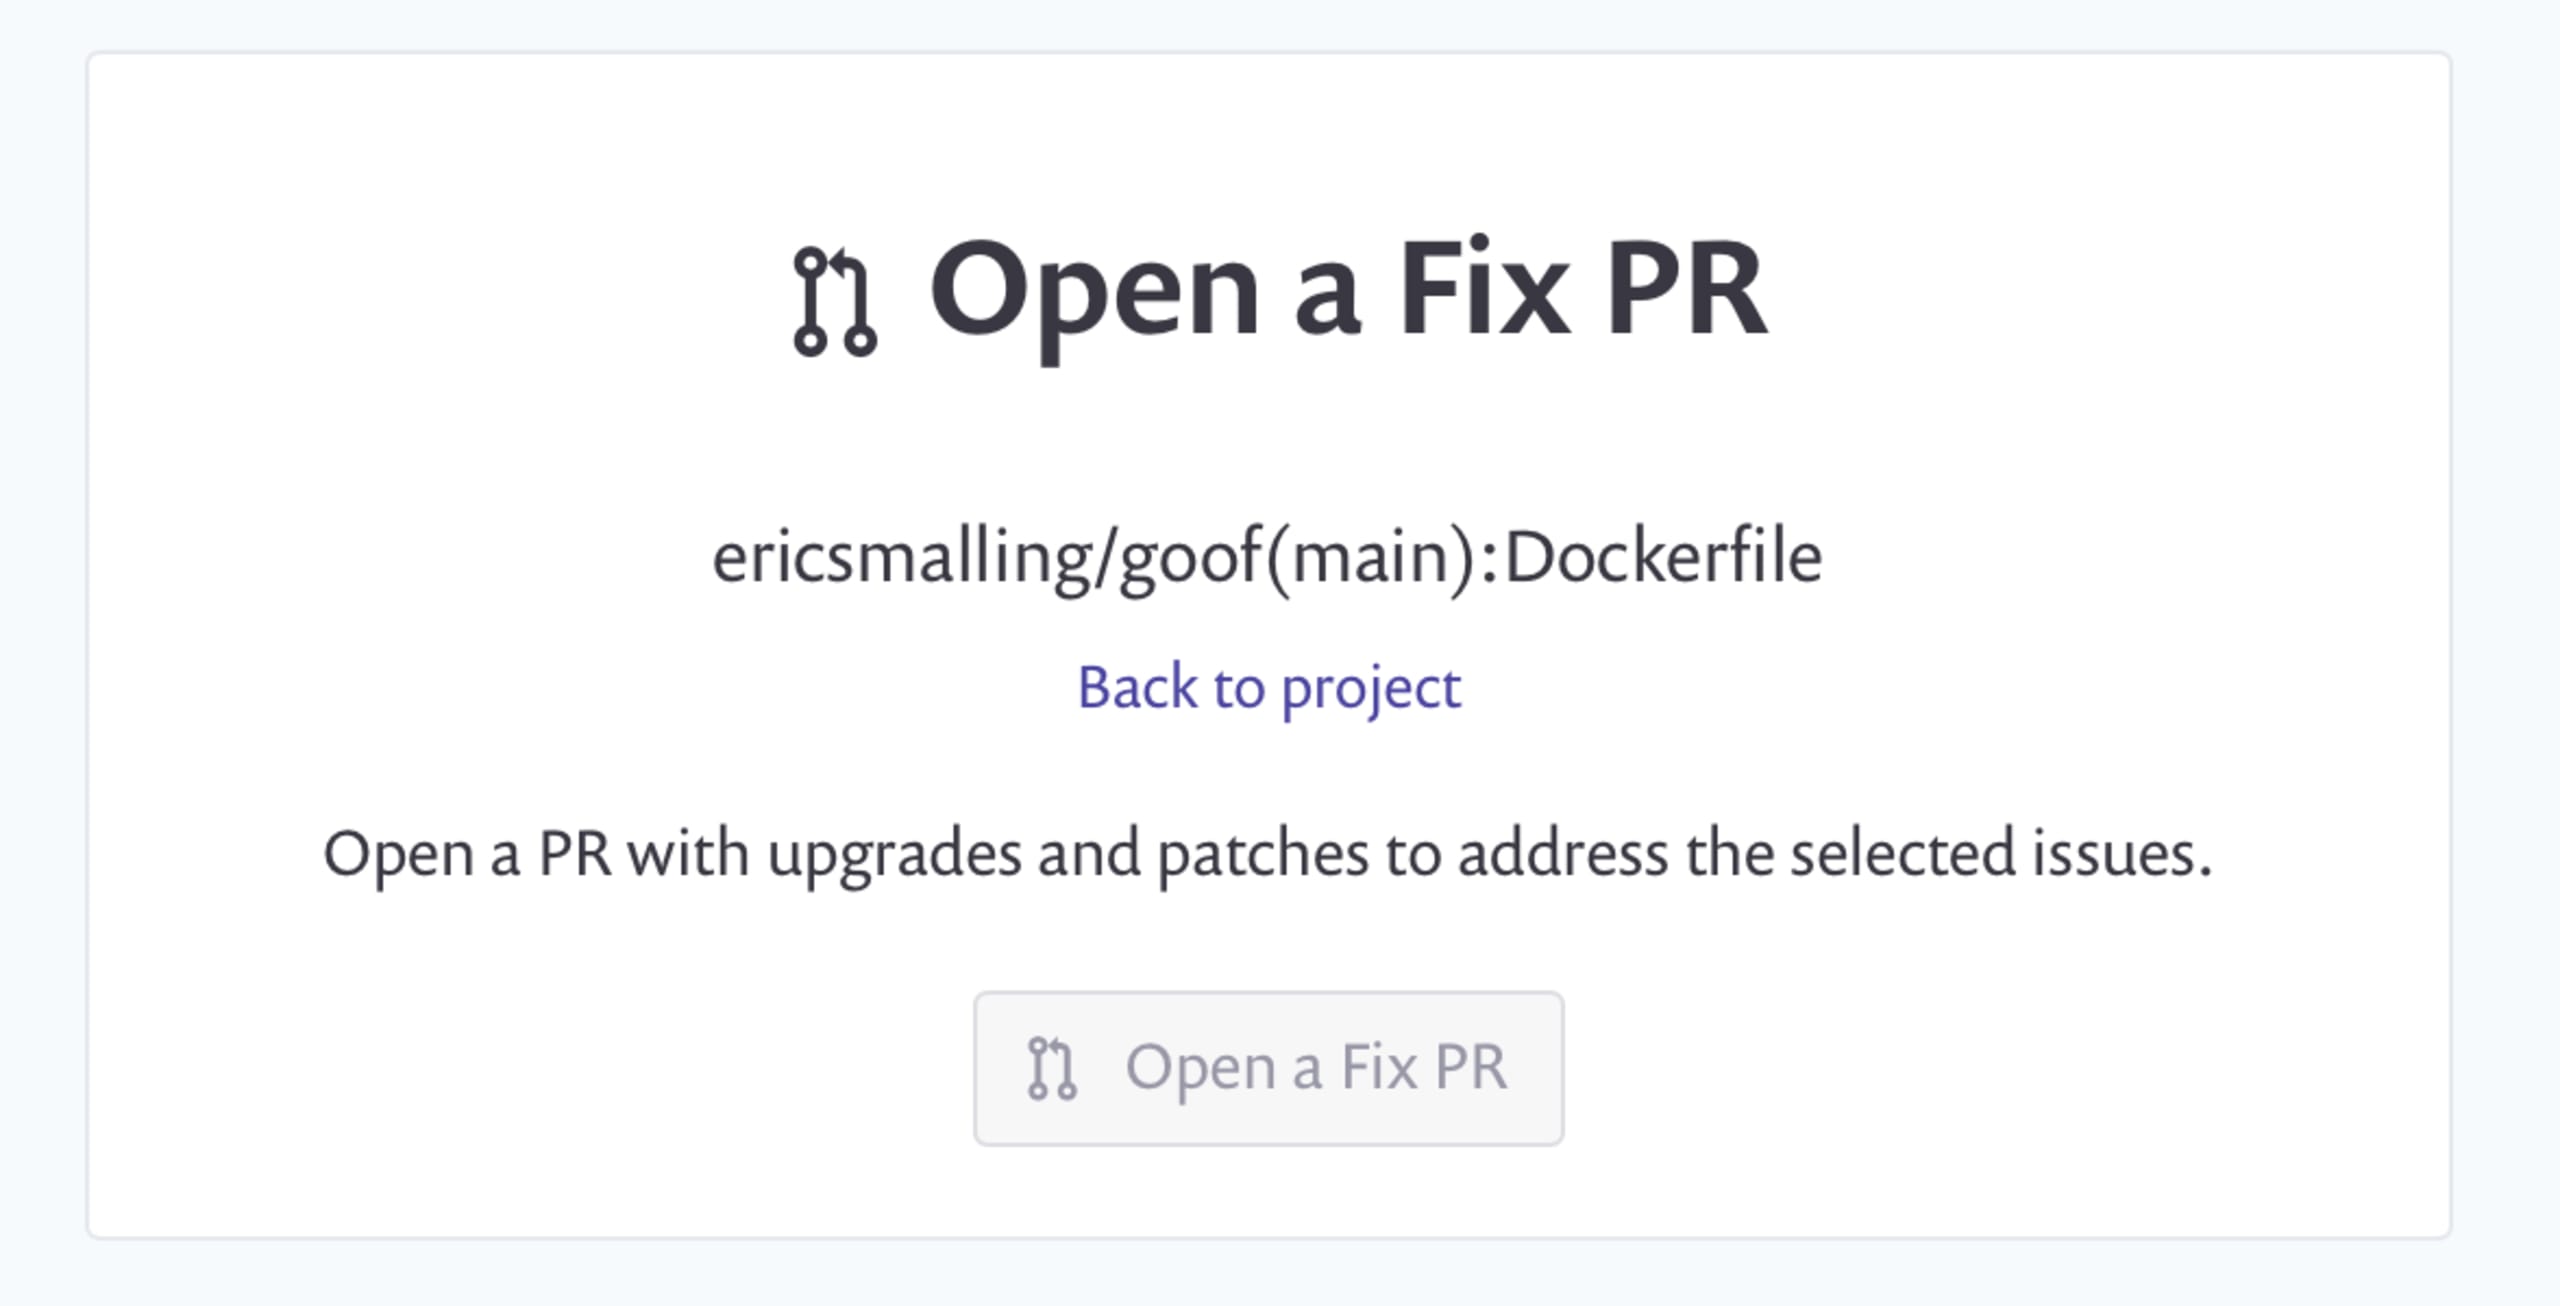
Uma página de confirmação será exibida com os detalhes da alteração. Em seguida, você será direcionado diretamente à página do Pull Request no GitHub.
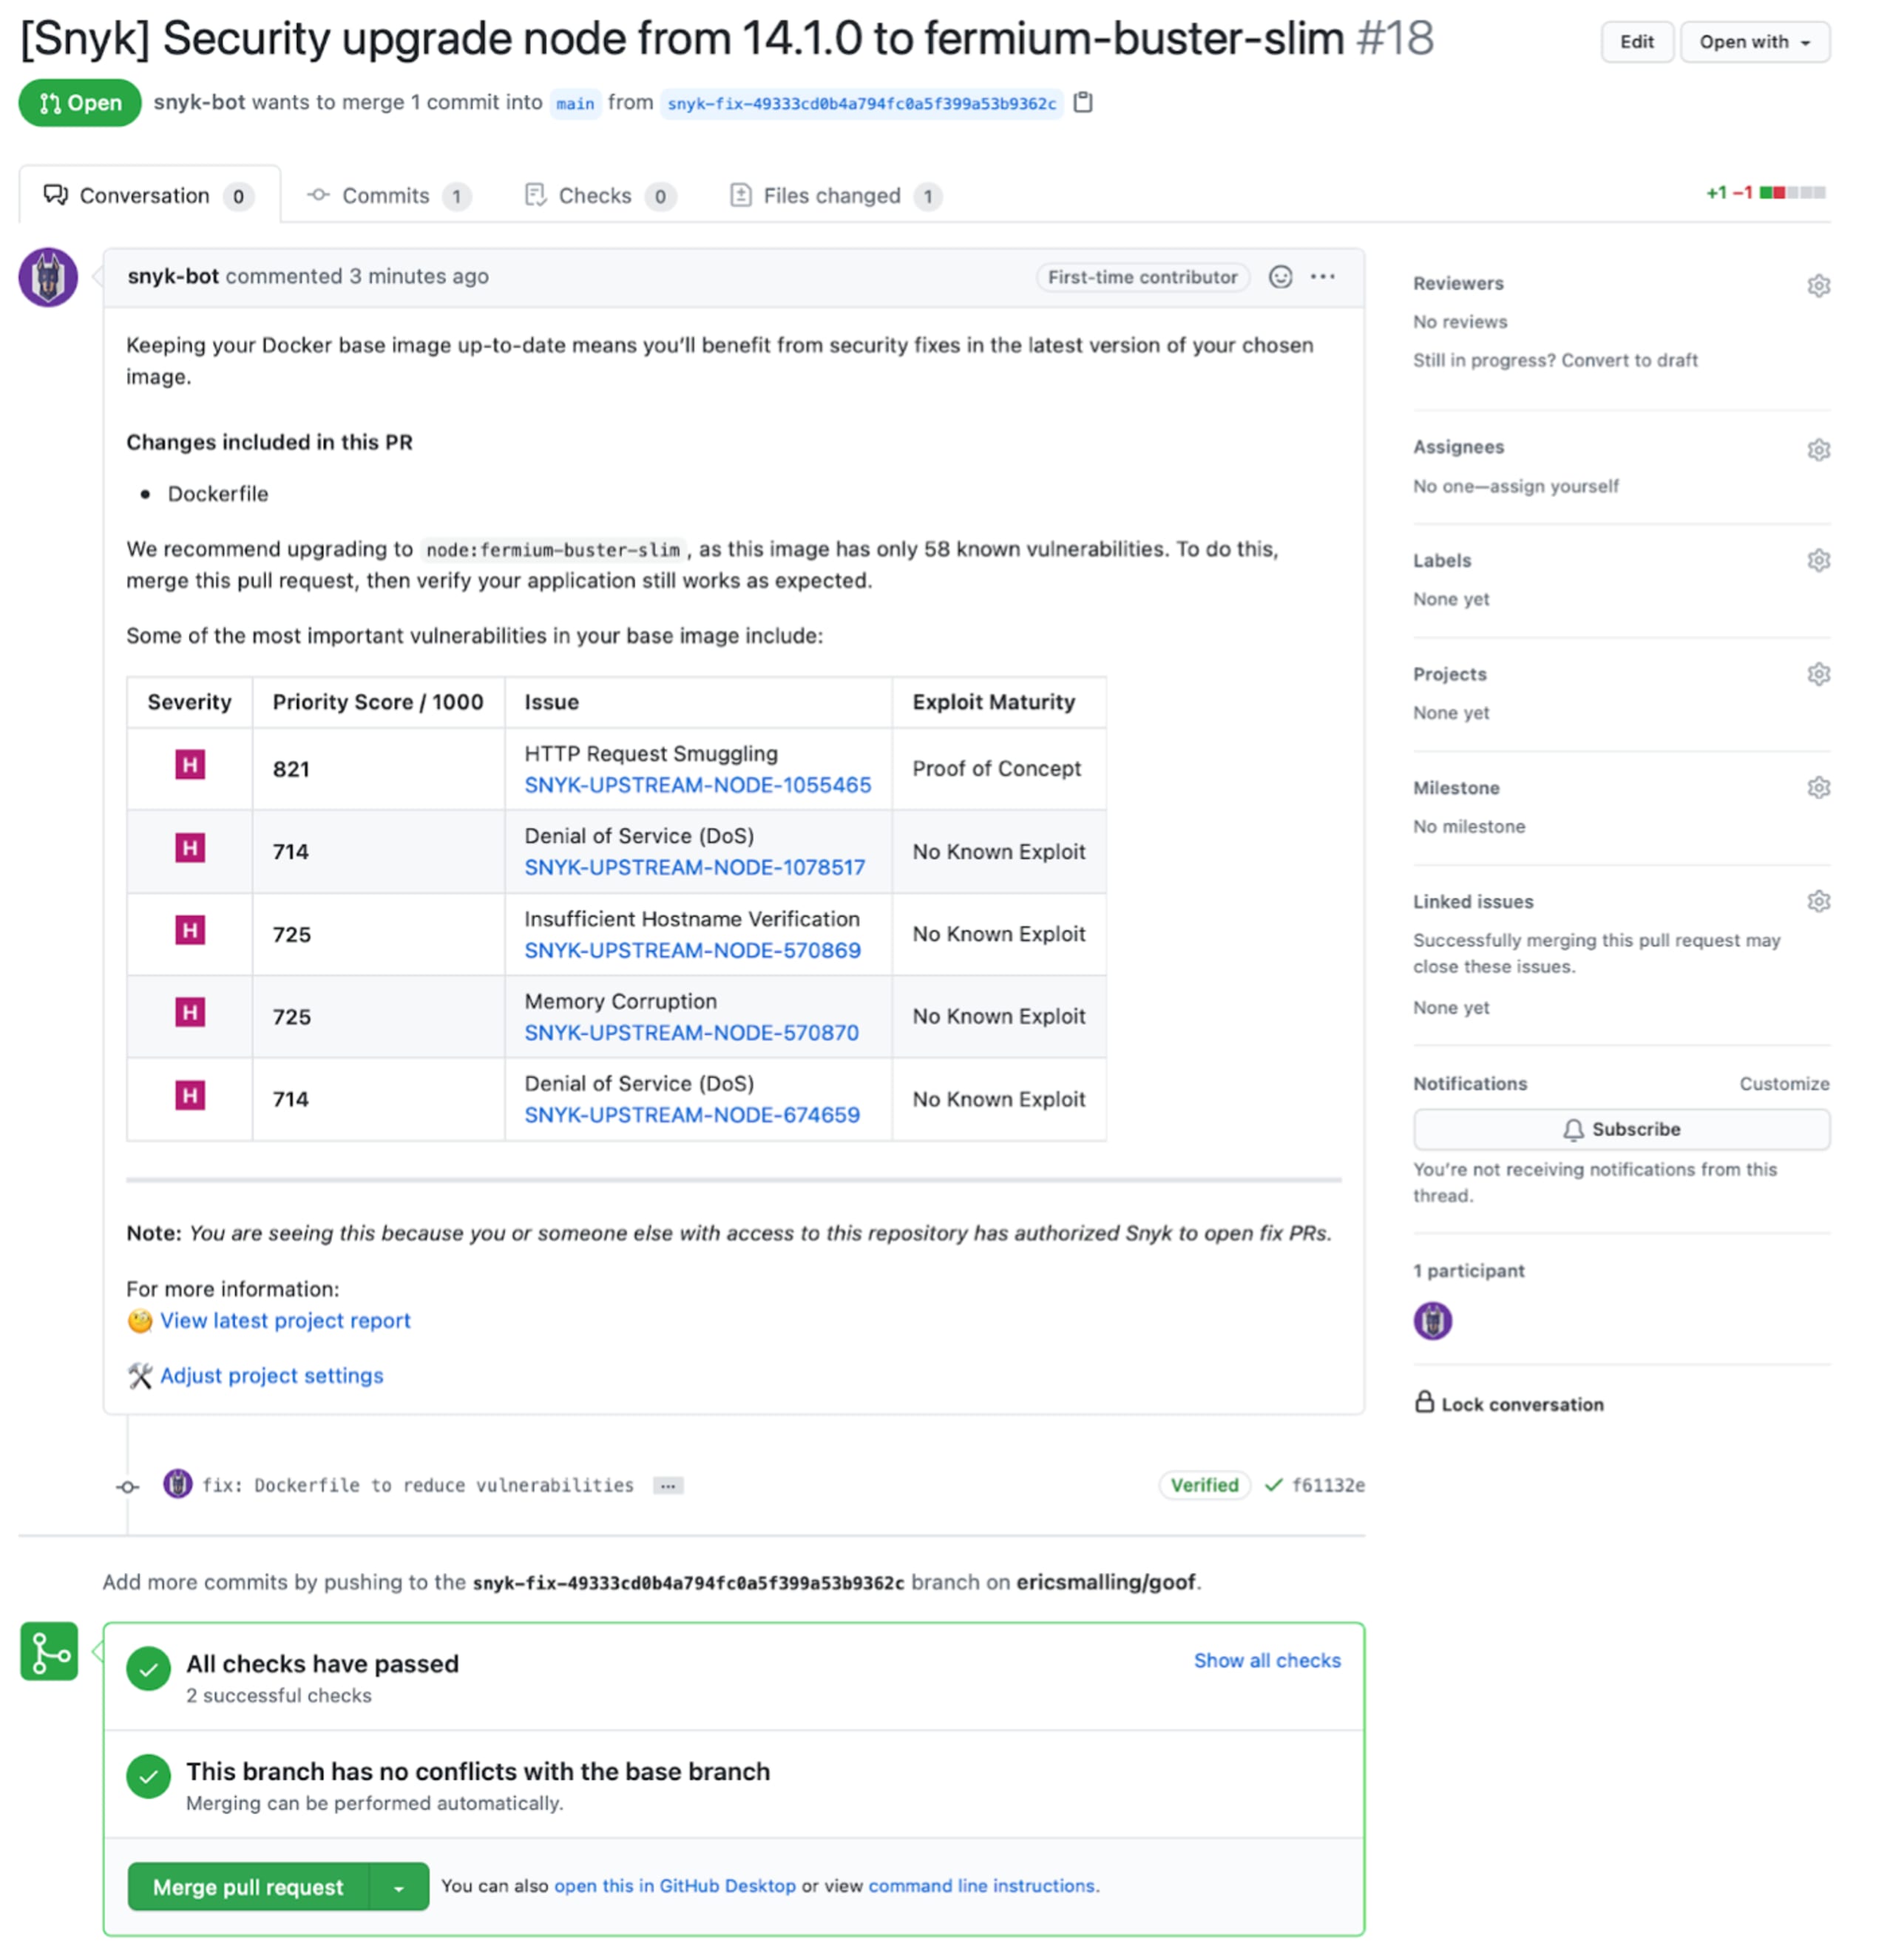
Em uma situação real, esse Pull Request passaria pelos mesmos processos de revisão de código e testes do aplicativo que qualquer outra alteração. Por enquanto, vamos mesclar essa alteração.
Ao baixar essas alterações para meu repositório git local, reconstruir e verificar minha imagem, vemos que o número de vulnerabilidades caiu para 58! Além disso, ao mudar para a imagem base “slim”, menor, reduzimos o tamanho total de 1,03 GB para apenas 261 MB!
9. Considere reduzir ainda mais o tamanho da imagem
Um dos princípios fundamentais do paradigma de contêineres é minimizar o ambiente em que um processo é executado. Já avançamos bastante na redução e na proteção da nossa imagem, mas ainda estamos empacotando muito mais do que precisamos para a implantação em produção. Poderíamos começar a dissecar a imagem para eliminar todos os arquivos e pacotes desnecessários incluídos pela distribuição base Debian, mas há soluções mais simples… com algumas concessões.
Imagens baseadas em Alpine
Uma das soluções mais simples é considerar outro sistema operacional base, projetado para oferecer segurança e ocupar pouco espaço: Alpine. As imagens baseadas em Alpine são conhecidas por ocuparem pouco espaço, principalmente porque vêm com poucos pacotes pré-instalados. Isso é bom do ponto de vista da segurança, já que arquivos inexistentes não podem ser explorados. Vamos reconfigurar nosso Dockerfile para usar a imagem base node:14-alpine.
Como você pode ver, reorganizei algumas coisas e movi o app para outro diretório, seguindo os padrões da imagem base Alpine. Como esperado, a criação dessa versão da imagem reduziu drasticamente seu tamanho.
Vamos ver o que a verificação do Snyk Container encontra na nossa nova imagem:
Nenhum caminho vulnerável encontrado! Melhor que isso, impossível!
Então, por que não usar sempre imagens baseadas em Alpine? Segundo a documentação da imagem Node:
O principal ponto de atenção é que ela usa musl libc em vez de glibc e bibliotecas relacionadas, então o software pode apresentar problemas dependendo do grau de dependência ou das premissas que adota em relação à libc. Veja esta discussão nos comentários do Hacker News para saber mais sobre os possíveis problemas e conferir algumas comparações dos prós e contras de usar imagens baseadas em Alpine.
Em muitos casos, isso funciona perfeitamente, especialmente em plataformas como Node, que são compiladas para várias plataformas. Mas, às vezes, a mudança para um conjunto completamente diferente de bibliotecas C de baixo nível pode prejudicar os aplicativos. Por esse motivo, ao verificar uma imagem baseada em glibc, os scanners de vulnerabilidades talvez não recomendem o Alpine como forma de reduzir a contagem de vulnerabilidades. As migrações para Alpine costumam falhar em aplicativos legados que dependem de bibliotecas pré-compiladas, como um aplicativo Java que usa chamadas JNI ou um aplicativo Go que usa cgo. De qualquer forma, se você estiver migrando de outra imagem baseada em Linux para Alpine, faça testes funcionais e de desempenho completos no seu aplicativo, pois, em certo sentido, você estará mudando de sistema operacional.
Imagens Distroless
Se o Alpine não for uma opção viável, existe um projeto do Google chamado Distroless, que oferece imagens geralmente baseadas em Debian, mas reduzidas ao mínimo necessário — muitas vezes, sem nem mesmo incluir um shell para executar comandos. Essas imagens são mantidas pela equipe do Google Distroless. Mais detalhes estão disponíveis no repositório do GitHub.
Imagens baseadas em Scratch feitas por você
A imagem base scratch não é, na verdade, uma imagem. É um token reservado na especificação do Dockerfile que inicia a criação da imagem com um sistema de arquivos completamente vazio. Sem shell, sem gerenciador de pacotes, nada. Tudo o que você quiser adicionar a esse tipo de imagem precisará ser copiado por conta própria. Em geral, você verá scratch usado como estágio final de um Dockerfile com compilações multistage, um recurso que permite usar várias linhas FROM, sendo a última delas a base da imagem final. O uso mais comum de compilações multistage é ter um estágio de “build”, no qual ocorre a compilação, e depois copiar o artefato gerado para o estágio final. No caso de um estágio final scratch , você precisaria copiar tudo o que é necessário para executar o programa. Por isso, esse recurso não costuma ser usado com linguagens interpretadas ou que precisam de um ambiente de execução, como Node.js, Java ou Python. As linguagens mais adequadas a esse padrão são as que compilam para um único arquivo ou para um pequeno conjunto de arquivos. Aplicativos em C, C++ e Go são exemplos comuns de uso de imagens scratch.
10. Pesquise ferramentas de criação de imagens que não usam Dockerfile
Ao longo deste documento, focamos no processo de criação de imagens baseado em Dockerfile, de longe a ferramenta mais usada para essa finalidade. No entanto, há outras formas de criar imagens sem usar Dockerfiles. Algumas das opções mais populares são Bazel, jib e Buildah com scripts. A própria Docker também oferece suporte a outras técnicas de criação com scripts por meio do projeto BuildKit, um builder opcional incluído no cliente do Docker.
Conclusão e links para continuar a leitura
O exemplo que vimos é relativamente simples, já que JavaScript é uma linguagem interpretada. Mas, se você trabalha com linguagens que têm fases de compilação e execução mais bem definidas, vale conferir os Dockerfiles multistage mencionados acima. Com eles, você pode continuar fazendo compilações no Dockerfile sem incluir o compilador e o código-fonte na imagem final que será implantada.
Para saber mais sobre como executar Node.js em contêineres, confira 10 práticas recomendadas para conteinerizar aplicações web Node.js com Docker. Também temos uma versão desse documento para aplicativos Java: 10 práticas recomendadas para criar um contêiner Java com Docker.
Segurança de contêineres que prioriza os desenvolvedores
O Snyk encontra e corrige automaticamente vulnerabilidades em imagens de contêiner e workloads do Kubernetes.
Se você usa as ferramentas alternativas de contêiner da RedHat, confira nossa publicação no blog sobre Ferramentas de linha de comando para contêineres: usando Snyk com Buildah, Podman e Skopeo.
Por fim, como mencionamos acima, pode ser difícil configurar as APIs de contexto de segurança do Kubernetes. O artigo 10 configurações de contexto de segurança do Kubernetes que você precisa conhecer explica essas configurações e ajuda você a fazer escolhas seguras para o seu aplicativo. Uma opção poderosa disponível nessas configurações é forçar o contêiner a ser executado em modo somente leitura. Isso pode oferecer uma excelente proteção contra alterações maliciosas no sistema de arquivos do contêiner. Saiba mais neste guia de referência rápida.
Quer se aprofundar nas imagens Docker? Adam Gordon Bell publicou um excelente artigo que explica em detalhes como as imagens são criadas. Além disso, durante o 2º webinar Docker Community All-Hands, alguns Docker Captains fizeram ótimas apresentações sobre imagens Docker:
Práticas recomendadas para a criação de imagens - Michael Irwin
Entenda o design de imagens - Brandon Mitchel
Adesão ao buildx bake --push - Kevin "CrazyMax" Alvarez
Esperamos que este guia tenha ajudado você a entender melhor como funcionam as imagens de contêiner e como usar ferramentas para proteger e manter seus aplicativos conteinerizados.